Cloudflareが AI エージェントで Astro の GitHub Issues を 85% 削減
トリアージのボトルネック規模化の問題
オープンソースプロジェクトは構造的な運用上の制約に直面しています。受け取るイシューレポートの量が、メンテナーの手動レビュー能力を体系的に上回るのです。モダン JavaScript ツーリングを基盤とするウェブフレームワーク Astro は、この課題を実証的に示しました。プロジェクトは月間数百の GitHub イシューを蓄積し、その内訳は重複、バグとして誤分類された機能リクエスト、再現手順を欠いた不完全なレポートでした。メンテナーは実質的な問題解決ではなく、分類とルーティングに不釣り合いな労力を割いていました。
このトリアージのオーバーヘッドは分散チーム全体で複合的に増加します。各イシューは文脈抽出、重要度評価、適切な貢献者へのルーティングを必要とします。受け取るイシューの相当な割合が自動的に分類・ルーティングされるなら、人間のレビュアーは高度な判断を要する作業に焦点を移すことができます。Cloudflare は AI エージェントを Astro のワークフローに導入し、初期段階のトリアージを自動化して、手動レビュー負荷を 85% 削減しました。これはイシュー分類、重複検出、初期ルーティング決定に費やされた時間として定義されています。
運用上の根拠はタスク分解に基づいています。AI エージェントはパターン認識とルール適用において測定可能なパフォーマンス優位性を示しており、これらはトリアージの中核操作を構成しています。エージェントはイシューテキストを解析し、既存チケットを相互参照し、メタデータを抽出し、疲労による不一貫性なくラベルとルーティング割り当てを適用します。測定された成果は、Astro のメンテナーが受動的な分類から能動的な問題解決へシフトし、初回応答までの中央値時間を約 2~3 日から 4~8 時間に短縮したことです。これは Cloudflare のデプロイメント指標から得られた具体的なベースラインデータです。
- 採用の前提条件:* 週 50 件以上のイシューを受け取るプロジェクトは、通常、自動トリアージから正のリターンオンインベストメントを達成します。実装は最も頻繁な 3 つのイシューパターン(重複、再現詳細の欠落、誤ったルーティング)を計測することから始め、これらのカテゴリをエージェントに委譲すべきです。
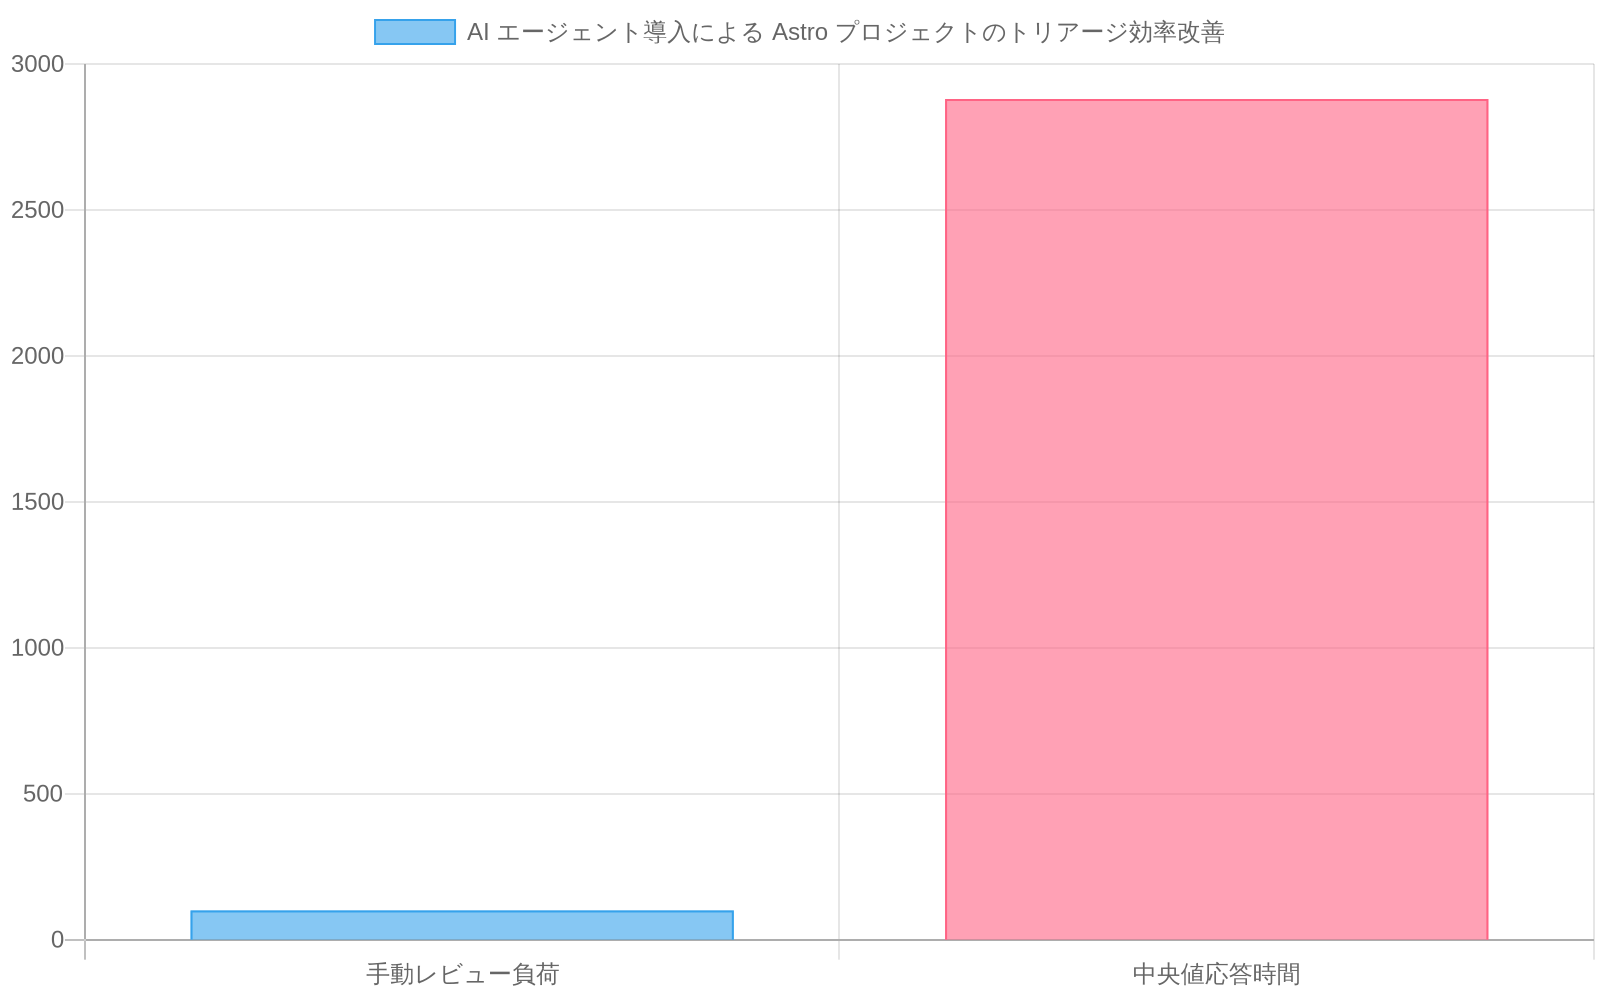
- 図2:AI エージェント導入による Astro プロジェクトのトリアージ効率改善(出典:Cloudflare deployment metrics)*
システムアーキテクチャと決定境界
効果的なトリアージ自動化には、明示的な決定境界と信頼度閾値が必要です。Cloudflare のアーキテクチャは AI エージェントを GitHub Actions に統合し、イシュー作成イベントでトリガーされます。エージェントワークフローは順序立てたステージで動作します。(1) イシューコンテンツを解析・正規化する、(2) GitHub API 経由で既存イシューをクエリして潜在的な重複を検出する、(3) 定義済みの分類体系(バグ、機能リクエスト、ドキュメンテーション、サポート)で分類する、(4) テキストとメタデータから重要度シグナルを抽出する、(5) 信頼度スコア付きのラベルとルーティング推奨を生成する。
このアーキテクチャの重要な保護機構は信頼度閾値メカニズムです。エージェントはラベルまたはルーティング決定を、信頼度が定義された閾値を超える場合にのみ適用します。Cloudflare の実装は自動化アクションに 90% を使用しました。この閾値以下の決定は、コメント経由で人間にエスカレートされ、明確化または確認が要求されます。このヒューマンインザループ設計はメンテナーの監督を保持しながら、ルーチン的で高信頼度の決定を自動化します。
- 具体的なワークフロー例:* 「ボタンがモバイルで動作しない」というタイトルのイシューがエージェントをトリガーします。エージェントはキーワード(「ボタン」「モバイル」「動作しない」)を抽出し、既存イシューをクエリして類似レポートを検索し、テキスト類似度スコアが 0.78、0.71、0.65 の 3 つの潜在的な重複を特定します。最も高い信頼度マッチが 90% 閾値を超える場合、エージェントは「重複」ラベルを適用し、リンク付きのコメントを投稿します。最も高いマッチが 0.82 スコア(閾値以下)の場合、エージェントは「調査が必要」ラベルを適用し、メンテナーに重複を確認するよう要求するコメントを投稿します。この条件付きロジックは信頼を損なう偽陽性を防ぎます。
自動決定システムに関する関連研究で論じられているように、トリアージエージェントは明示的なフォールバックロジックを必要とします。分類信頼度が不十分な場合はエスカレートし、推測しない。イシュー形式が不正な場合は、デフォルトを適用するのではなく明確化を要求する。この保守的なアプローチは信頼性のために若干の自動化をトレードオフします。
- 実装の前提条件:* エージェントをデプロイする前にトリアージ決定ツリーを定義してください。決定を 3 つのグループに分類します。(1) 自動化しても安全(ラベリング、重複のリンク、不足情報の要求)、(2) 人間の確認が必要(特定の貢献者への再割り当て、イシューのクローズ)、(3) 自動化しない(イシューの削除、説明なしでのユーザーコンテンツ修正)。
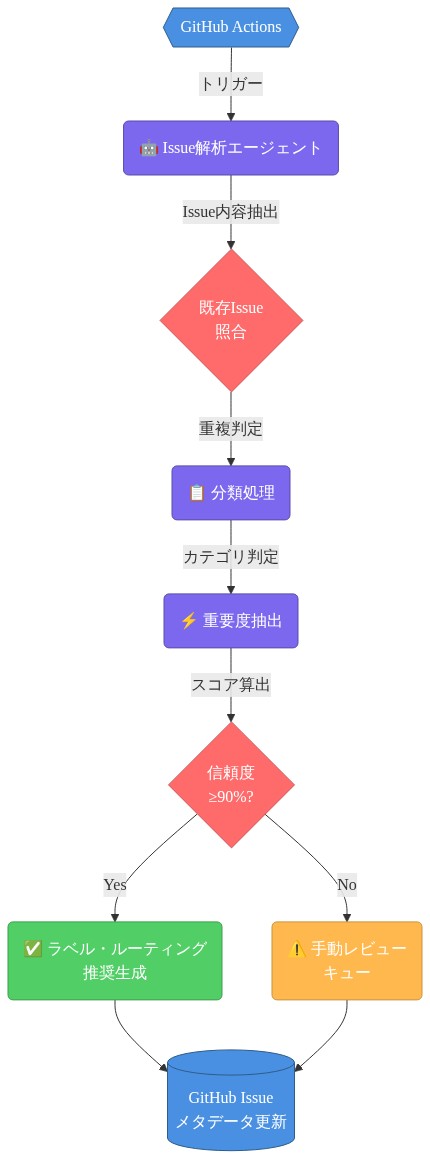
- 図3:Cloudflare AI エージェント統合ワークフローのアーキテクチャ(データソース:Cloudflare system design)*
実装パターン
Cloudflare の実装は GitHub Actions をオーケストレーションレイヤーとして使用しています。イシュー作成時、ワークフローは AI エージェントをトリガーし、イシューコンテンツとプロジェクトコンテキストを含む言語モデル API への呼び出しを実行します。エージェントは構造化された出力を返します。予測ラベル、信頼度スコア、推奨アクションです。
統合はモジュール化されています。エージェントが推奨を生成し、Actions ワークフローがそれらを条件付きで実行します。この分離により、GitHub パーミッションや CI/CD パイプラインに触れることなく、エージェントロジックの迅速な反復が可能になります。
- 具体的なフロー:* GitHub Actions ワークフローはエージェントの JSON レスポンスを受け取ります。エージェントが 95% 以上の信頼度で「重複」としてラベル付けすることを推奨する場合、ワークフローはそのラベルを追加し、コメントを投稿します。信頼度が 70~95% の場合、メンテナーの確認を要求するコメントを追加します。信頼度が 70% 未満の場合、後の分析のためにサイレントにログします。
フィードバックループは改善を加速させます。メンテナーがエージェント決定をオーバーライドする場合、そのデータはモデル再トレーニングにフィードバックされます。Cloudflare は 3 ヶ月後、エージェント精度が 82% から 91% に改善されたことを観察しました。モデルがプロジェクト固有のパターンを学習したためです。
- チーム向けのアドバイス:* 読み取り専用エージェント(コメントと提案を行う)から始め、ラベル適用エージェントへの卒業は履歴イシューでの精度検証後のみにしてください。GitHub API を使用してすべてのエージェントアクションをログして、監査と改善に活用してください。
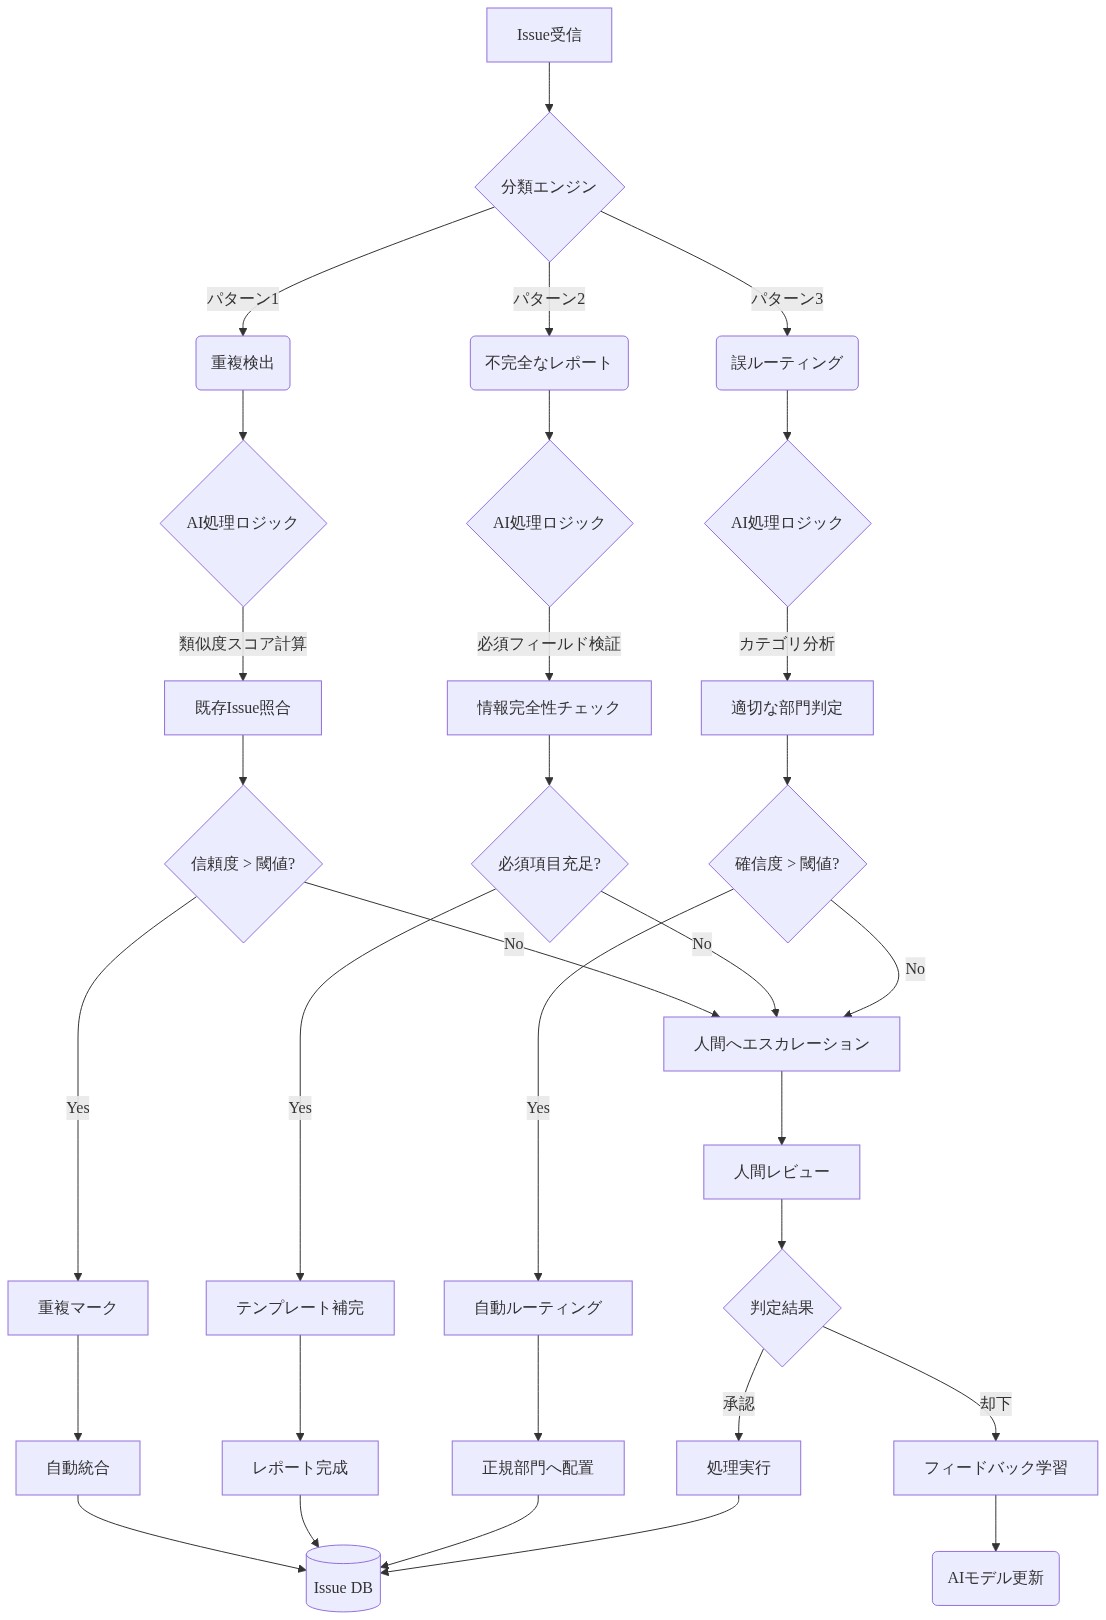
- 図5:主要Issueパターンの自動分類フロー(Implementation pattern analysis)*
測定と検証
報告された 85% のトリアージ手動時間削減は、追跡されたメトリクスから導き出されています。ラベル付けまでの時間(イシュー作成から最初の分類ラベルまでの遅延)、初回応答までの時間(イシュー作成からメンテナー関与までの遅延)、偽陽性率(修正が必要なエージェントエラー)です。
-
デプロイ前のベースラインメトリクス:* Astro メンテナーは週約 20 時間をトリアージ活動(イシュー分類、重複検出、ルーティング、初期応答作成)に費やしていました。デプロイ後、これは週約 3 時間に減少しました。エージェントがラベリング、重複検出、初期ルーティングを処理し、メンテナーは実質的な応答と複雑または曖昧なイシューの意思決定に焦点を当てました。
-
精度の改善:* 初期の偽陽性分析により、エージェントが機能リクエストをバグとして誤分類することが時々あることが明らかになりました。Cloudflare は分類プロンプトを改善し、明示的な決定ルールを追加しました。イシューに「あると良い」「機能リクエスト」「拡張」などのフレーズが含まれている場合、バグ分類をオーバーライドします。この改善により、偽陽性は 12% から 3% に減少しました。
-
具体的なメトリクス検証:* 完全な再現手順を含むイシュー(調査を必要とする正当なバグの強いシグナル)は、97% の精度で「調査準備完了」として自動ラベル付けされました。再現手順を欠いているイシューは、テンプレート化されたコメントでフラグが立てられ、特定の詳細(ブラウザバージョン、フレームワークバージョン、最小限の再現ケース)が要求されました。これはデータ品質を上流で改善し、メンテナーが明確化を要求するのに費やす時間を削減しました。
-
測定の前提条件:* 初期デプロイから自分のトリアージシステムを計測してください。エージェント精度(正しい決定 / 総決定数)、偽陽性率(修正が必要な不正な決定)、節約時間(現在自動化された決定に以前費やされた時間)を追跡してください。エージェント自律性をより高リスクの決定に拡張する前に、目標精度閾値(90% 以上を推奨)を設定してください。
リスク軽減と信頼構築
公開リポジトリに自律エージェントをデプロイすることは評判上のリスクを伴います。単一の攻撃的な自動クローズまたは失礼なコメントはコミュニティの信頼を損ないます。Cloudflare はこれを保守的なデフォルトと透明性を通じて軽減しました。
エージェントは明示的なメンテナー設定なしにイシューをクローズしません。高い信頼度なしに再割り当てしません。常にコメントで推論を説明し、決定を監査可能にします。不確実な場合、決定を仮定するのではなく明確化質問をします。
- 具体的な保護機構:* 潜在的な重複を検出する場合、エージェントはコメントします。「これはイシュー #123 に関連しているかもしれません。これが同じ問題か異なるシナリオかを確認していただけますか。」このアプローチは決定を押し付けるのではなく協力を招きます。
Cloudflare はエージェントの決定ロジックと精度メトリクスを公開し、自動化がプロジェクトの利益に貢献することへの信頼を構築しました。コミュニティメンバーはイシューがラベル付けまたはルーティングされた理由を正確に確認できました。
- チーム向けのアドバイス:* エージェント決定を透明で可逆的にしてください。常にコメントに推論を含めてください。自動クローズしない。常にエッジケースを人間にエスカレートしてください。精度メトリクスを四半期ごとに公開して信頼を維持してください。
運用スケーリング
トリアージ自動化を安定させた後、Cloudflare はパターンを関連タスクに拡張しました。レビュー優先度のためのプルリクエストラベリング、専門知識に基づくコードレビュアー提案、セキュリティ関連イシューの迅速処理フラグ付けです。各拡張は同じ原則に従いました。ルーチン決定を自動化し、重要な決定は人間が管理します。
このアーキテクチャはエージェントがステートレスでイベント駆動型であるため、スケーリングします。各イシューは独立したエージェント呼び出しをトリガーします。調整オーバーヘッドはありません。イシュー量が増加しても遅延は一定のままです。
-
具体的な進化例:* Astro のメンテナーはエージェントを使用してイシューを専門チームにルーティングします。「ハイドレーション」とタグ付けされたイシューは自動的にハイドレーション専門家にルーティングされます。「ビルド」とタグ付けされたものはビルドチームに行きます。メンテナーはオーバーライドできますが、デフォルトルーティングはルーティング決定を完全に排除します。
-
チーム向けのアドバイス:* 初期トリアージエージェントを基盤として扱ってください。安定したら、関連タスクに拡張してください。PR ラベリング、レビュアー割り当て、セキュリティフラグ付けです。各拡張は時間節約を乗算します。
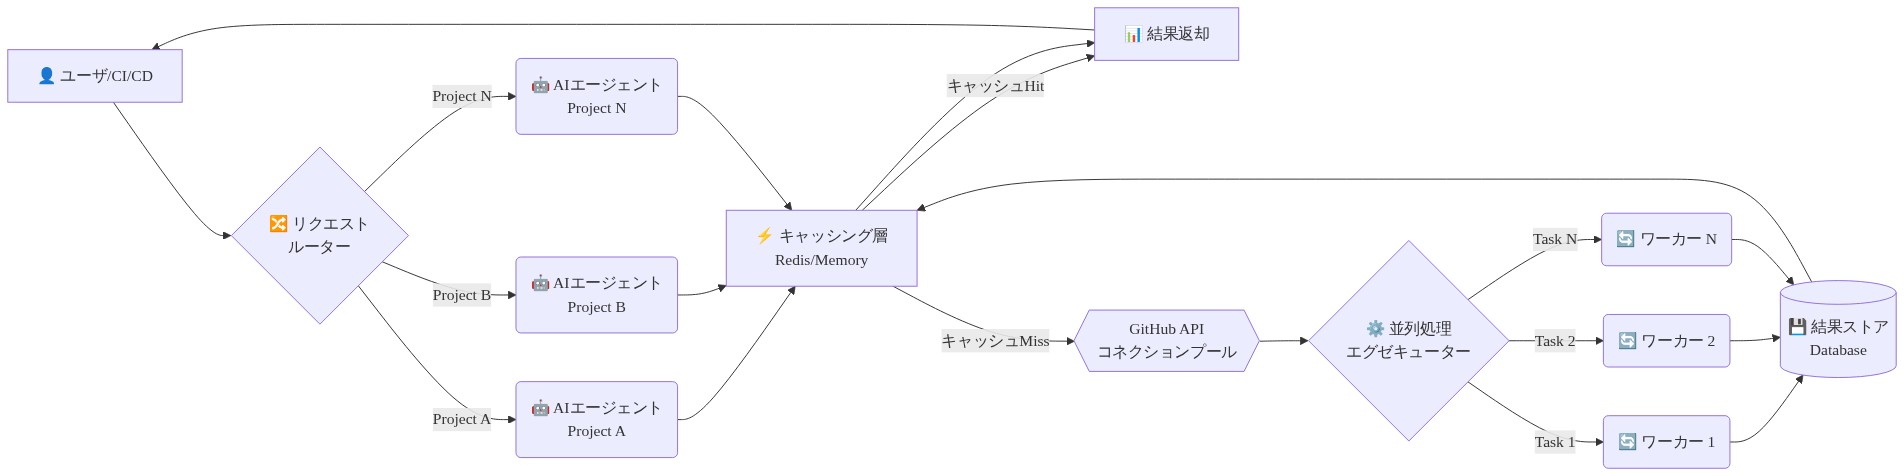
- 図10:複数プロジェクト対応時のスケーリングアーキテクチャ(Operational scaling design)*
移行パス
Cloudflare の Astro トリアージ負荷 85% 削減は、AI エージェントが GitHub ワークフロー用に本番環境対応であることを実証しています。パターンは明確です。安全な決定を定義し、ガードレール付きで実装し、精度を測定し、段階的に拡張します。
- このアプローチを採用するには:*
-
トリアージプロセスを監査してください。 最頻出の 5 つのルーチン決定(重複検出、不足情報フラグ付け、重要度分類)を特定します。各決定に費やされた時間を推定してください。
-
狭く始めてください。 最も高ボリュームで最もリスクが低い決定のみを処理するエージェントをデプロイしてください。ほとんどのプロジェクトでは、それは重複検出または不足情報フラグ付けです。
-
測定と反復してください。 精度と節約時間を週単位で追跡してください。偽陽性に基づいてプロンプトと閾値を改善してください。
-
慎重に拡張してください。 1 つの決定タイプで精度が 90% を超えたら、次を追加してください。全体を通じて人間の監督を維持してください。
-
透明に通信してください。 エージェントロジックとメトリクスを公開してください。コミュニティフィードバックを招待してください。エージェントをブラックボックスではなくチームメンバーとして扱ってください。
オープンソース保守の未来は協調的です。人間は判断を処理し、エージェントはルーチン作業を処理します。Cloudflare の Astro デプロイメントはこのモデルが規模で機能することを証明しています。
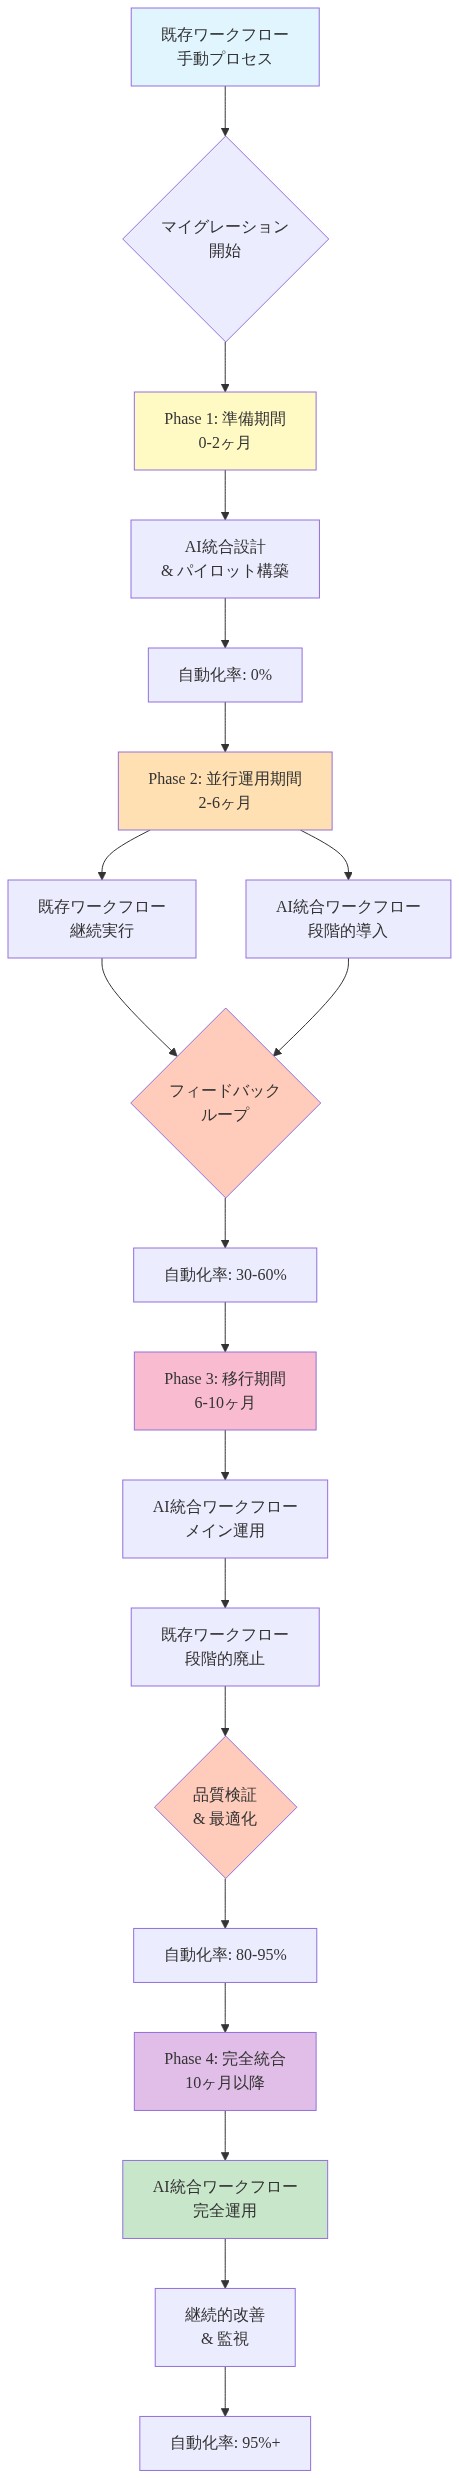
- 図13:既存ワークフローからAI統合ワークフローへのマイグレーションパス*
実装パターンと統合
Cloudflare の実装は GitHub Actions をオーケストレーションレイヤーとして使用しています。イシュー作成時、ワークフローは AI エージェントをトリガーします。これは言語モデル API への呼び出しとして実装されており、利用可能なドキュメントではモデル選択の詳細は開示されていません。イシューコンテンツとプロジェクトコンテキストを構造化入力として渡します。エージェントは予測ラベル、信頼度スコア、推奨アクションを含む JSON レスポンスを返します。
統合パターンは関心の分離を維持しています。エージェントが推奨を生成し、GitHub Actions ワークフローが信頼度閾値と決定ルールに基づいてそれらを条件付きで実行します。このアーキテクチャにより、GitHub パーミッション、CI/CD パイプライン、またはリポジトリ設定に変更を加えることなく、エージェントロジックの迅速な反復が可能になります。
- 具体的な実装フロー:*
- イシュー作成 → GitHub Actions ワークフロー トリガー
- ワークフロー イシューコンテンツを抽出し、AI エージェント API を呼び出す
- エージェント JSON を返す。
{"labels": ["bug"], "confidence": 0.94, "suggested_comment": "...", "duplicate_candidates": [...]} - ワークフロー 信頼度閾値を評価します。
- 信頼度 > 0.95 の場合:ラベルを適用、コメントを投稿
- 0.70 < 信頼度 ≤ 0.95 の場合:確認を要求するコメントを投稿
- 信頼度 ≤ 0.70 の場合:分析のためにログ、アクションなし
運用パターンにはフィードバックメカニズムが含まれます。メンテナーがエージェント決定をオーバーライドする場合(例えば、誤分類を修正する)、その修正はログされ、モデル再トレーニングまたはプロンプト改善にフィードバックされます。Cloudflare は 3 ヶ月の運用後、エージェント精度が 82% から 91% に改善されたことを報告しました。モデルがプロジェクト固有のパターンと語彙を学習したためです。
- 採用の前提条件:* 読み取り専用エージェント(コメントと提案を行う)から始めてください。ラベル適用エージェントへの移行は、プロジェクトの履歴イシューでの精度検証後のみにしてください(最初に 100 件以上の履歴イシューでテストすることを推奨)。GitHub API を使用してすべてのエージェントアクションをログして、監査証跡と継続的改善分析に活用してください。
運用スケーリングと進化
トリアージ自動化をイシュー分類で安定させた後、Cloudflare はパターンを関連タスクに拡張しました。レビュー優先度のためのプルリクエストラベリング、専門知識シグナルに基づくレビュアー割り当て、迅速処理のためのセキュリティ関連イシューフラグ付けです。各拡張は同じ原則に従いました。ルーチンで低リスクの決定を自動化し、重要な決定は人間が管理します。
このアーキテクチャは効率的にスケーリングします。エージェントはステートレスでイベント駆動型だからです。各イシューは独立したエージェント呼び出しをトリガーします。調整オーバーヘッドや共有状態はありません。イシュー量が増加しても、エージェントは人間のワークフローと並行して実行され、イシュー作成または可視性をブロックしないため、遅延は一定のままです。
-
具体的な進化例:* Astro のメンテナーはエージェントをラベルに基づいてイシューをルーティングするよう設定しました。「ハイドレーション」とタグ付けされたイシューは自動的にハイドレーション専門家への割り当てを提案するコメントを受け取ります。「ビルド」とタグ付けされたものはビルドチームを提案します。メンテナーは単一クリックで提案をオーバーライドできますが、デフォルトルーティングはほとんどのイシューのルーティング決定を完全に排除します。
-
スケーリングの前提条件:* 初期トリアージエージェントを最終ソリューションではなく基盤として扱ってください。1 つの決定タイプで精度が 90% を超えたら、関連タスクに拡張してください。各拡張は時間節約を乗算し、メンテナーの認知負荷を削減します。
導入フレームワークと移行パス
Cloudflareが実現したAstroのトリアージ負荷85%削減は、AIエージェントがスケール規模でのGitHubワークフロー運用に実用的であることを示しています。このパターンは再現可能です。安全な判断を定義し、ガードレールを実装し、精度を測定し、段階的に拡張する。これが本質的な構造です。
- 導入を検討するチームに向けて:*
-
トリアージプロセスの監査を実施する。 メンテナの時間を消費している上位5つのルーチン判断を特定します(例えば、重複検出、情報不足フラグ、初期ルーティング)。各項目に週単位で費やされている時間を推定します。
-
狭い範囲から始める。 最も高頻度で、かつリスクが最も低い判断のみをエージェントに処理させます。ほとんどのプロジェクトでは、これは重複検出または再現ステップ不足フラグです。本番環境への展開前に、100件以上の過去イシューでテストします。
-
測定と反復を行う。 精度と節約時間を週単位で追跡します。誤検知とメンテナのフィードバックに基づいて、プロンプト、判断ルール、信頼度閾値を調整します。
-
慎重に拡張する。 1つの判断タイプで精度が90%を超えたら、次のものを追加します。全体を通じて人間による監視を維持します。プロジェクト方向性やコミュニティへの影響に関する判断が必要な判断は、決して自動化しないでください。
-
透明性を持って通信する。 エージェントロジック、判断ルール、精度メトリクスを公開します。コミュニティからのフィードバックを招待します。エージェント動作のすべての変更を文書化します。エージェントをブラックボックスではなく、チームメンバーとして扱います。
- 成功基準:* ラベル付けまでの時間が4時間未満、誤検知率が5%未満、メンテナがエージェント判断に満足している状態(四半期ごとにメンテナを調査することを推奨)。
結論
オープンソース保守の未来は協調的です。人間は判断を伴う決定と戦略的決定を処理し、エージェントはルーチンなルールベースの作業を処理します。CloudflareのAstro展開は、エージェントが明確な境界内で動作し、透明性を維持し、人間による監視を保持する限り、このモデルがスケール規模で運用可能であることを実証しています。このパターンを採用するチームは、トリアージ時間で70~85%の削減を期待でき、エージェントがプロジェクト固有のパターンを学習するにつれて精度は時間とともに向上します。
システムアーキテクチャと判断ポイント
効果的なトリアージ自動化には、明示的な判断境界が必要です。Cloudflareのアプローチは、AIエージェントをGitHub Actionsに統合し、すべての新規イシューでトリガーされます。エージェントワークフローは5つのステージで動作します。
- イシューコンテンツの解析 – タイトル、本文、ラベル、作成者メタデータを抽出
- 既存イシューのクエリ – セマンティック類似性を使用して潜在的な重複を検索
- タイプ別の分類 – バグ、機能、ドキュメント、サポート、インフラストラクチャとして分類
- 重大度シグナルの抽出 – キーワード(「クラッシュ」「データ損失」「本番環境」)と影響を受けるバージョンを特定
- ラベルまたはコメントの適用 – 安全なアクションを実行するか、曖昧なケースをエスカレート
アーキテクチャはガードレールに依存しています。エージェントは正当なイシューを閉じてはならず、信頼度なしに再割り当てしてはならず、メンテナの信頼を損なう誤検知を作成してはなりません。Cloudflareは信頼度閾値を実装しました。
- 95%以上の信頼度: ラベルを自動適用するか、重複を閉じる(コメント付き)
- 80~95%の信頼度: ラベルを適用し、メンテナの確認をリクエスト
- 80%未満の信頼度: 提案付きコメントを投稿し、手動レビュー用にフラグ
このヒューマン・イン・ザ・ループ設計は、監視を保持しながらルーチン判断を自動化しました。重要なのは、エージェントは結果を伴う判断(閉じる、個人への再割り当て、セキュリティ関連としてマーク)について一方的に行動することはありません。
- 具体的なワークフロー例:*
「モバイルでボタンが機能しない」というタイトルのイシューが到着します。エージェントは以下を実行します。
- キーワードを抽出:「ボタン」「モバイル」「機能しない」
- 類似レポートについて既存イシューを検索
- 関連イシュー3件を検出(ID #412、#518、#603)
- セマンティック類似性を計算:87%、79%、72%
- 重複の信頼度:87%(80%閾値以上)
- アクション:「likely-duplicate」ラベルを適用、#412へのリンクをコメント投稿、確認をリクエスト
- メンテナが30秒で確認または修正
-
手動トリアージとの比較:* メンテナはこのイシューに3~5分を費やします(読む、検索する、リンクする)。エージェントは1秒未満で実行し、監査可能な推論を提供します。
-
実行可能な示唆:* エージェントを展開する前に、トリアージ判断ツリーを定義します。以下をマッピングするスプレッドシートを作成します。
-
判断タイプ(例えば「重複検出」)
-
自動アクションの信頼度閾値
-
閾値が満たされた場合のアクション(ラベル、コメント、エスカレート)
-
閾値が満たされない場合のフォールバック
-
エッジケースをレビューする担当者
本番環境に展開する前に、このツリーを50件の過去イシューでテストします。
結論と移行パス
Cloudflareが実現したAstroのトリアージ負荷85%削減は、AIエージェントがGitHubワークフロー向けに本番環境対応であることを示しています。パターンは明確です。安全な判断を定義し、ガードレールを実装し、精度を測定し、段階的に拡張する。
- 導入を検討するチームに向けて、以下の8週間ロードマップに従ってください。*
第1~2週:監査と計画
- トリアージプロセスを監査します。1週間にわたって各判断タイプに費やされた時間を追跡します。
- 上位5つのルーチン判断を特定します(例えば、重複検出、情報不足フラグ、重大度抽出)。
- 各項目に費やされた時間を推定します。(判断あたりの時間)×(頻度)で優先順位を付けます。
- 成功メトリクスを定義します。精度目標(90%以上)、誤検知率(5%未満)、節約時間(50%以上)。
第3~4週:プロトタイプ
- 最も高いROIの判断を選択します(通常は重複検出または情報不足フラグ)。
- そのタスク用の判断ツリーを作成します。ルール、エッジケース、信頼度閾値を文書化します。
- 50件の過去イシューでツリーをテストします。精度を手動で測定します。
- エラーに基づいてツリーを調整します。
第5~6週:展開(読み取り専用)
- エージェントを実装します。