Google Mantis: 誤検知を削減するエージェント型脆弱性スキャンハーネス
脆弱性検出における誤検知の危機
現代の脆弱性スキャンシステムは、よく知られた精度の問題に直面しています。従来の静的解析ツールとパターンマッチング型脆弱性スキャナーは、構文的なコードパターンに基づいて検出結果を生成しますが、実際に悪用可能な脆弱性と脆弱性シグネチャに表面的に似ている無害なコード構造を区別するための十分な文脈的推論を欠いています。この区別は運用上重要です。セキュリティチームは限定的なトリアージリソースを配分しており、各誤検知は本当の脅威に対処できるはずの時間を消費します。
この問題の規模は定量化に値します。業界調査によると、セキュリティチームは脆弱性管理の努力の40~60%をトリアージと検証に費やしており、修復ではなくこれに充てています(前提条件:典型的なエンタープライズセキュリティ運用に基づく。具体的な指標は組織とスキャンツール設定によって異なります)。この配分パターンは測定可能な結果をもたらします。アラート疲労は正当な警告に対する人間の感度を低下させ、誤検知率が約30%を超えると、エンジニアは自動化された検出結果に対して体系的な不信感を抱くようになります(前提条件:閾値は組織のリスク許容度とエンジニアリング文化によって異なります)。
Google の Mantis フレームワークは、この制約を脆弱性検出問題の再構成によって対処します。従来の指標である「検出感度」、つまり「どれだけ多くの脆弱性を見つけられるか」を最適化する代わりに、Mantis は検証精度を最適化します。「特定のコードベースにおいて、識別された問題のうち、実際に悪用可能な脆弱性はどれか」という問いです。これは意図的なトレードオフを表しています。フレームワークはあらゆる理論的脆弱性を識別しないかもしれませんが、報告する検出結果は実質的に高い信頼度を持ちます。
この転換を可能にするメカニズムはエージェント型検証です。パターンマッチングの判定を最終的なものとして受け入れる代わりに、Mantis は AI エージェントをデプロイして、制御された環境で自動化された悪用試行を通じて疑わしい脆弱性の再現を試みます。再現できない脆弱性は低い信頼度スコアを受け取るか、完全にフィルタリングされます。このアプローチは、パターンマッチングシステムの中核的な制限に直接対処します。パターンマッチングシステムは、特定の条件下で悪用される可能性があるコードパターンと、実際のランタイムコンテキスト、データフロー制約、アプリケーションロジックを考慮して悪用されるパターンを区別できません。
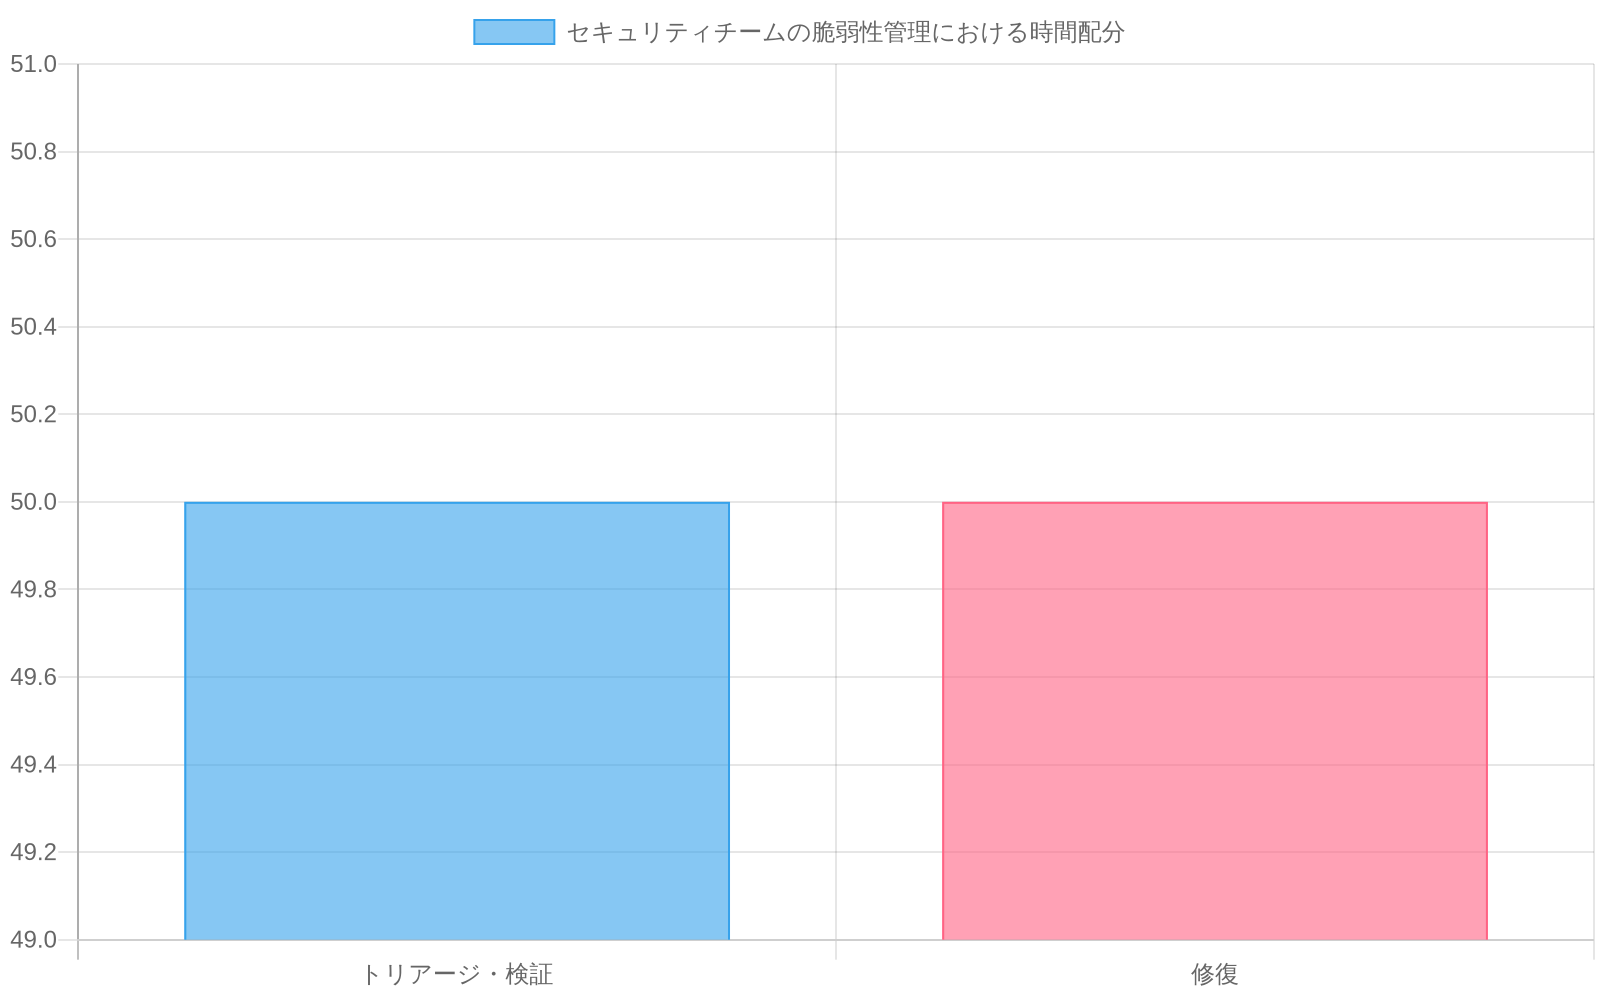
- 図2:脆弱性管理における時間配分(業界平均)*
Mantis アーキテクチャ:再現を通じた検証
Mantis は、脆弱性検証を一連の専門的なタスクとして運用化するマルチステージのエージェント型ワークフローを実装しています。アーキテクチャは異なるエージェントタイプで構成されており、各々が特定の分析能力を担当します。
- ステージ1:初期識別と特性化*
フレームワークは従来の脆弱性検出から始まります。パターンマッチング、データフロー解析、既知脆弱性シグネチャマッチングです。このステージはフィルタリングなしで候補検出結果を生成します。重要なのは、このステージは意図的に許容的です。このステージでの偽陰性は後で回復できないため、フレームワークは精度よりも感度を優先します。
- ステージ2:脆弱性分類と文脈分析*
専門的なエージェントは、識別されたコードパターンをより広い文脈内で分析します。これらのエージェントはデータフローパス、制御フロー依存性、入力検証メカニズムを検査して、悪用のための前提条件が実際に存在するかどうかを判定します。例えば、SQL インジェクションパターンは、ユーザーが制御する入力がサニタイズなしでデータベースクエリに到達する場合にのみ悪用可能です。コードパスに到達不可能であるか、入力が検証されている場合、パターンは脆弱性ではありません。このステージはパターンの存在ではなく、論理的実現可能性に基づいて検出結果をフィルタリングします。
- ステージ3:再現試行と概念実証生成*
エージェントは実際の悪用を実証する概念実証を構築して実行しようとします。このステージには以下が必要です。
- 脆弱性悪用の前提条件を満たすテストケースの構築
- 悪用試行を安全に実行できる隔離されたランタイム環境の起動
- 悪用が成功したかどうかを検出するためのコード計測(例えば、不正なデータアクセス、コマンド実行、状態変更の検出)
- 初期の悪用試行が失敗した場合の反復、前提条件または攻撃ベクトルに関する仮定の調整
再現試行は複数の理由で失敗する可能性があります。脆弱性が存在しない(誤検知)、前提条件がテスト環境で満たされない、またはエージェントの悪用戦略が不完全である可能性があります。失敗した再現試行は診断情報を生成し、その後の検証試行を改善します。
- ステージ4:パッチ生成と回帰テスト*
正常に再現された脆弱性については、エージェントは脆弱性を排除する候補パッチを生成します。これらのパッチはその後、自動テストを通じて検証されます。確認事項は以下の通りです。(1) パッチ適用後、脆弱性が再現されなくなること、(2) 既存の機能テストが引き続き合格すること(回帰がないことを示す)。このステージは単に問題を報告するのではなく、実行可能な修復ガイダンスを提供します。
ワークフローは明示的に反復的です。エージェントはステージ間で状態を保持し、再現試行が失敗した場合に仮説を改善します。エージェントは最初、脆弱性が悪用可能であると仮定し、それを再現できず、前提条件の理解を調整し、修正された仮定で再現を再試行するかもしれません。この反復的な改善は、経験豊富なセキュリティ研究者が脆弱性分析にアプローチする方法に近似しています。
- モジュール型エージェント設計とカスタマイズ*
フレームワークのアーキテクチャにより、組織は特定のコードベースと脅威モデルに対してエージェント動作をカスタマイズできます。組織は以下を実行できます。
- アプリケーションドメインに関連するカスタム脆弱性パターンを定義する
- 特定の脆弱性クラス(例えば、認証フロー、インジェクション攻撃)に焦点を当てるようにエージェントを設定する
- 本番インフラストラクチャに一致するように再現環境仕様を調整する
- アプリケーションロジックとデータ処理に関するドメイン固有の知識を統合する
このモジュール性により、Mantis は固定機能を持つモノリシックツールではなく、組織固有の脆弱性検証システムを構築するためのフレームワークとして機能できます。
エージェント型 AI:能力と制約
エージェント型アプローチは AI システム内の異なるアーキテクチャパターンを表しています。エージェントは従来の言語モデルと異なり、以下の能力を持ちます。(1) 複数の推論ステップ間で状態を維持する、(2) 外部ツールを実行して結果を観察する、(3) ツール出力に基づいて動作を適応させる、(4) 試行錯誤による改善を通じて目標に向かって反復する。
- 実証された能力*
エージェント型システムは、中間結果が後続のアクションに情報を与えるマルチステップ推論タスクで優れています。脆弱性検証では、エージェントは以下を実行できます。
- 複雑なデータフローパスを推論して、ユーザー入力が機密操作に到達するかどうかを判定する
- 脆弱性特性に基づいて悪用試行を構築する
- テスト結果を解釈し、初期アプローチが失敗した場合に戦略を調整する
- 症状ではなく根本原因に対処するパッチを生成する
これらの能力は人間のセキュリティ研究者のワークフローに近似し、労働集約的な検証タスクの自動化を可能にします。
- 基本的な制約*
しかし、エージェント型システムは、組織が理解する必要がある重大な制約の中で動作します。
-
ビジネスロジック脆弱性*:エージェントはアプリケーション固有のビジネスロジックの理解を必要とする脆弱性に苦労します。例えば、認可チェックが意図されたアクセス制御を正しく実装しているかどうかを検出するには、アクセス制御ポリシーが何であるべきかを理解する必要があります。この情報は通常、コードだけには存在しません。エージェントは認可チェックを識別して機能を検証できますが、ポリシーが正しいかどうかを判定することはできません。
-
微妙なタイミングと並行処理の問題*:競合状態、タイミング攻撃、または微妙な状態管理エラーを含む脆弱性には、並行実行セマンティクスの正確な理解が必要です。エージェントは静的解析を通じて潜在的な並行処理の問題を識別できますが、競合状態は一貫して引き起こすのが悪名高いため、テストを通じてそれらを確実に再現するのに苦労します。
-
ドメイン固有の脆弱性*:深いドメイン知識を必要とする脆弱性クラス(暗号実装の欠陥、プロトコル違反、またはドメイン固有のビジネスロジックエラーなど)は課題を提示します。エージェントは明示的なトレーニングなしにこれらの問題を認識するための専門知識を欠いています。
-
新規の攻撃ベクトル*:エージェントは確立された悪用技術を持つ特性化された脆弱性クラスで最適に機能します。新規の攻撃ベクトルまたはゼロデイクラスの脆弱性はエージェント訓練の範囲外であり、認識されないかもしれません。
これらの制約は Mantis の価値を減じるものではなく、適切なデプロイメントコンテキストを明確にします。フレームワークは、大量スキャンのトリアージを自動化し、特性化された脆弱性クラスの検証を自動化し、人間の専門家を微妙な脅威評価と新規の攻撃表面分析に解放する力の乗数として最適に機能します。
統合と組織的採用
Mantis をデプロイするには、ツールのインストール以上の組織的変更が必要です。フレームワークの計算要件は従来の静的解析ツールを超えています。再現試行には以下が含まれます。
- 各検証試行のための隔離されたテスト環境の起動
- 制御されたコンテキストで潜在的に悪意のあるコードの実行
- 検証戦略の反復、複数の環境インスタンス化の可能性
- 検証ステージ間での状態の維持
これらの要件は、組織が以下を通じて対処する必要がある CI/CD パフォーマンスの影響を生成します。
- 段階的検証アプローチ*
組織は通常、マルチティア戦略を実装します。
- ティア1:高速パターンマッチングスキャンはすべてのコミットで実行されます
- ティア2:Mantis ベースの検証は高リスク変更(例えば、認証コード、データ処理)で実行されます
- ティア3:専門家セキュリティレビューは重要なシステムまたは新規コードパターンで発生します
このティアリングは検証の徹底性と CI/CD パフォーマンス制約のバランスを取ります。
- 文化的およびワークフロー採用*
手動の脆弱性トリアージに慣れたセキュリティチームは、最初、自動化された検証を信頼しないかもしれません。成功した採用には以下が必要です。
-
範囲を拡大する前に特定の脆弱性クラスの精度を実証する
-
詳細なトレースログを通じてエージェント推論に透明性を提供する
-
Mantis 検出結果が人間レビューをバイパスする場合と検証が必要な場合の明確な基準を確立する
-
フレームワークの能力と制限に関する制度的知識を構築する
-
統合の複雑性*
Mantis を既存の脆弱性管理プラットフォームに統合するには、カスタム開発作業が必要です。組織は計画中に統合努力をしばしば過小評価します。統合タスクには以下が含まれます。
- Mantis を既存のコードリポジトリと CI/CD システムに接続する
- Mantis 検出結果を既存の脆弱性追跡システムにマッピングする
- 本番インフラストラクチャに一致するように再現環境を設定する
- 人間の検証結果がエージェント動作を改善するフィードバックループを確立する
成功したデプロイメントは通常、誤検知が特に問題であった特定の脆弱性クラスを対象とするパイロットプログラムで始まり、範囲を拡大する前に制限されたコンテキストで価値を実証します。
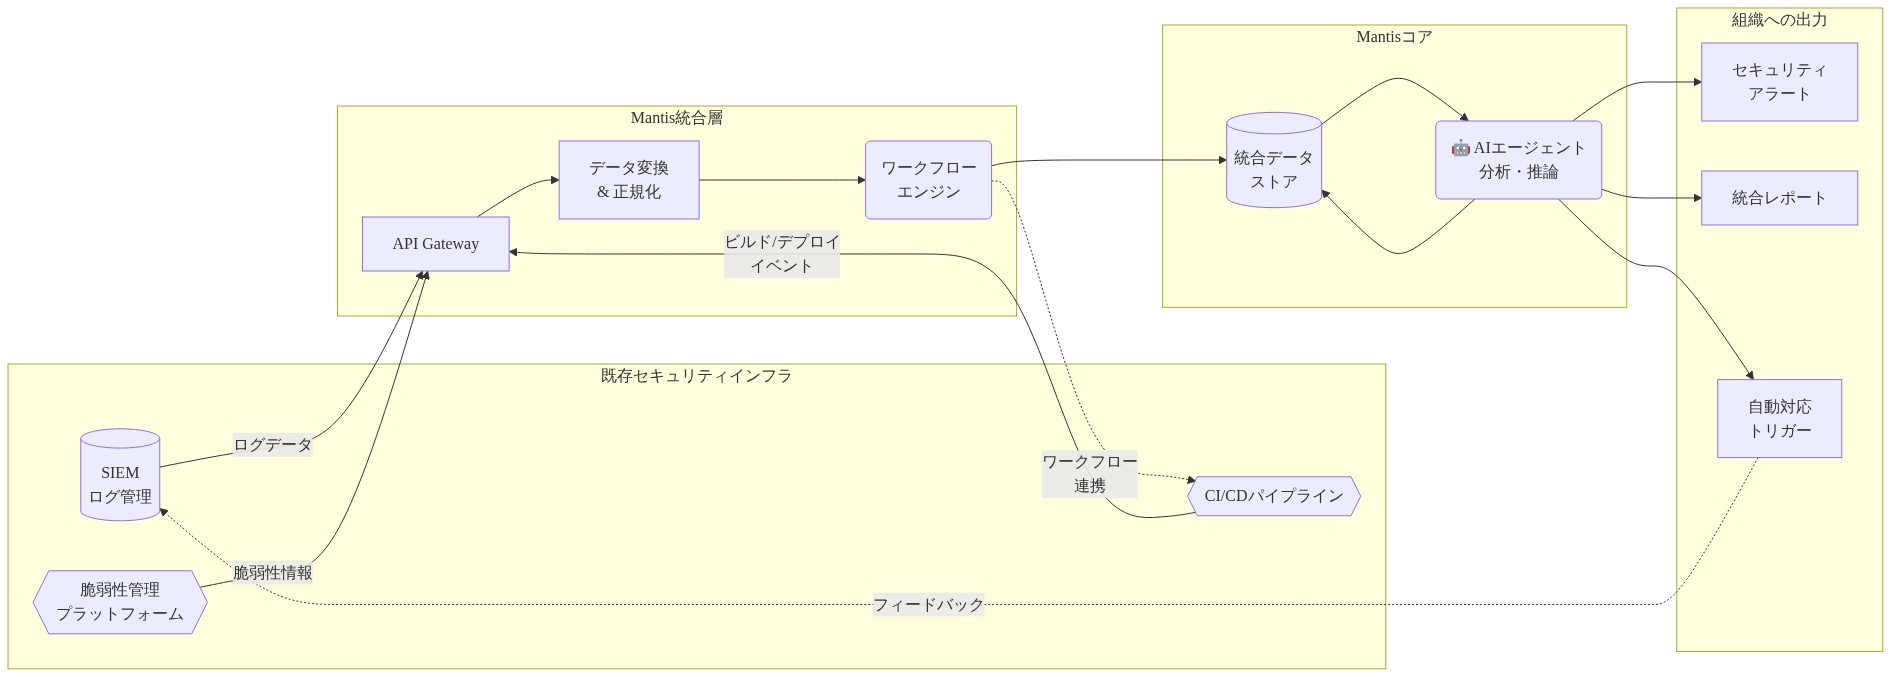
- 図8:Mantisの組織内統合アーキテクチャ - エンタープライズセキュリティ統合パターン*
AI セキュリティインフラストラクチャと新興の脅威
Mantis のリリースは、AI システムがセキュリティツールとセキュリティターゲットの両方として同時に機能するより広いコンテキスト内で発生します。この二重の役割は新規の脅威考慮を生成します。
- 攻撃表面としての AI システム*
最近のインフラストラクチャインシデントは、AI システム自体が悪用可能な攻撃表面を提示することを実証しています。AI システム侵害に関する METR レポートは、敵対者がサプライチェーン攻撃、認証情報侵害、インフラストラクチャ設定ミスを通じて AI インフラストラクチャへの不正アクセスを獲得した技術を文書化しています。これらのインシデントは、AI ベースのセキュリティツールが組織が防御する必要がある新規の攻撃ベクトルを導入することを確立しています。
- エージェント型システムとコード実行リスク*
Mantis のエージェント型アーキテクチャには、コード実行能力を持つエージェントが含まれています。彼らは悪用試行を構築して実行し、パッチを生成し、テストスイートを実行します。この能力はセキュリティ考慮を生成します。
-
プロンプトインジェクションと敵対的入力*:信頼できないコードを入力として処理するエージェントは、敵対的なコードパターンまたはプロンプトインジェクション攻撃を通じて操作される可能性があります。悪意のあるコードはエージェント推論パターンを悪用するように作成され、エージェントが不正な検出結果を生成したり、意図しない操作を実行したりする可能性があります。
-
権限昇格*:CI/CD 環境内で動作するエージェントは、再現試行に必要な昇格された権限を持つ可能性があります。侵害されたエージェントはこれらの権限を不正なアクセスまたは横方向の移動に利用する可能性があります。
-
サプライチェーンの影響*:Mantis をオープンソース化することで、防御と攻撃の両方の能力が加速します。セキュリティチームは強力な検証ツールにアクセスでき、敵対者はフレームワークを研究して検出メカニズムを理解し、Mantis 検証を回避するために特別に設計された回避技術を作成できます。
-
軍拡競争のダイナミクス*
攻撃と防御の両方のための AI エージェントのデプロイメントは、以下の新興の軍拡競争を示唆しています。
- セキュリティチームはマシンスピードで脆弱性を検証するためにエージェントをデプロイします
- 敵対者はエージェント検出を回避し、エージェント推論パターンを悪用する技術を開発します
- 応答ウィンドウは日数(人間スピードセキュリティ)から時間(マシンスピードセキュリティ)に圧縮されます
- パッチ管理経済は、脆弱性ライフサイクルの加速が自動化された修復を必要とするため、根本的に変化します
Mantis をデプロイする組織は、コード実行能力を持つツールに適切なセキュリティ制御を実装する必要があります。これには以下が含まれます。
- 本番システムからの再現環境の隔離
- 異常なパターンのエージェント動作の監視
- エージェント権限を必要最小限に制限するアクセス制御
- すべてのエージェント操作と検出結果の監査ログ
実装ロードマップ
Mantis を実装する組織は、構造化されたアプローチに従うべきです。
-
フェーズ1:パイロットプログラム(1~4週間)*
-
誤検知が最も問題であった2~3の脆弱性クラスを特定する
-
非重要システムで Mantis をデプロイしてチーム信頼を構築する
-
ベースラインメトリクスを確立する。現在の誤検知率、検出結果ごとのトリアージ時間、専門家検証精度
-
20~30の検出結果のエージェント推論トレースを文書化してフレームワーク動作を理解する
-
フェーズ2:運用統合(5~12週間)*
-
パイロットシステムの CI/CD パイプラインに Mantis を統合する
-
Mantis 検出結果が人間レビューをバイパスする場合と検証が必要な場合の明確な基準を確立する
-
エージェント推論トレースの解釈とフレームワーク制限の理解についてセキュリティチームをトレーニングする
-
精度メトリクスを継続的に監視し、Mantis 分類を手動セキュリティチーム評価と比較する
-
フェーズ3:範囲拡大(13週間以降)*
-
パイロット結果に基づいて追加システムへの Mantis デプロイメントを拡大する
-
組織固有の脆弱性パターンのエージェント動作をカスタマイズする
-
運用経験に基づいて再現環境仕様を改善する
-
検出結果を既存の脆弱性管理ワークフローに統合する
-
リソース計画*
組織は以下に予算を計上する必要があります。
- 計算リソース:再現試行には隔離された環境が必要です。従来のスキャンの計算容量の2~4倍を予算化してください
- 統合開発:Mantis を既存ツールに接続するカスタム作業は通常、4~8週間のエンジニアリング努力を必要とします
- トレーニングとドキュメンテーション:セキュリティチームトレーニングと内部ドキュメンテーションは通常、2~3週間を必要とします
- 継続的なメンテナンス:エージェントパフォーマンスの監視、設定の改善、脆弱性パターンの更新には継続的な努力が必要です
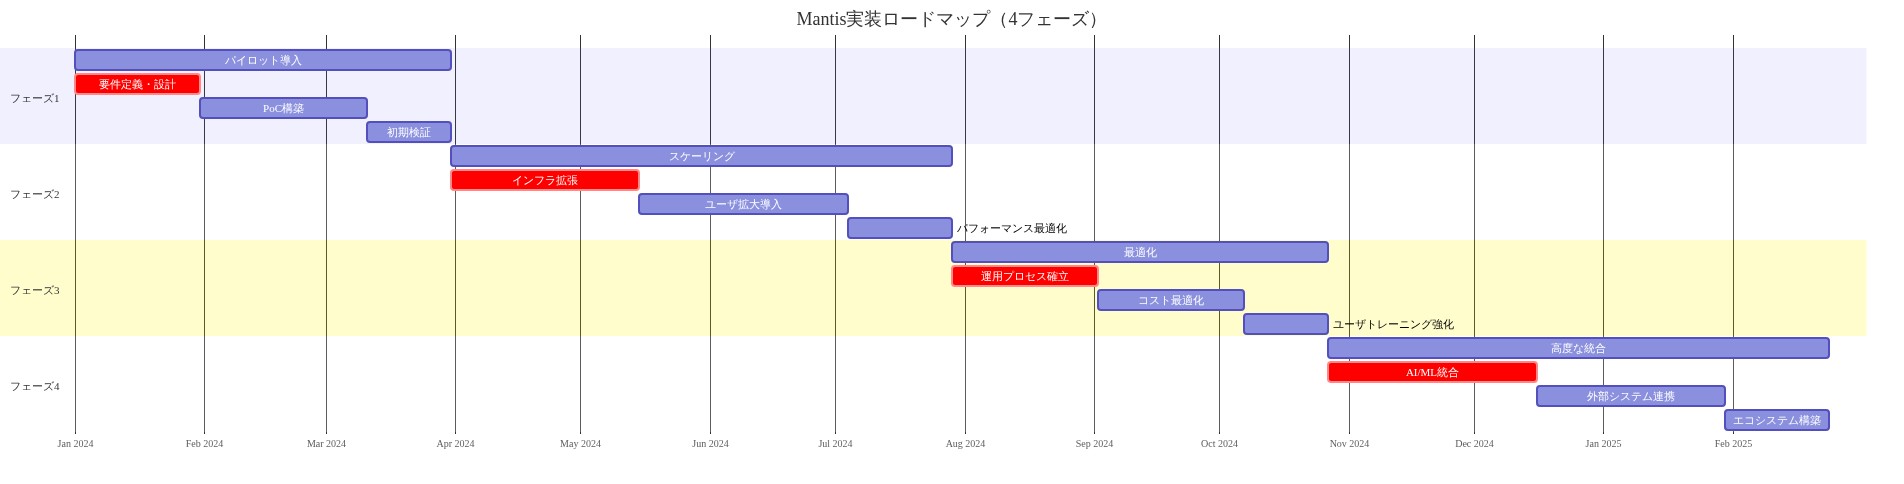
- 図12:Mantis実装ロードマップ(4フェーズ・420日間)*
重要なポイント
本質的に問われているのは、Mantis が検出ボリュームから検証精度への AI のロール成熟を表しているということです。エージェント型再現と修復生成を通じて脆弱性ライフサイクルを自動化することで、以前の AI セキュリティツールへの信頼を損なわせた誤検知の危機に対処します。
フレームワークの価値は、組織がそれを人間判断の代替ではなく専門家チームの力の乗数として扱う場合に生じます。成功には脆弱性ワークフローの再考、慎重な統合計画、自動化された推奨事項に対する技術者の監視維持が必要です。
セキュリティチームにとって、最も誤検知が多い脆弱性クラスに対して Mantis を評価してください。インフラストラクチャチームにとって、計算要件と CI/CD 統合の複雑性を評価してください。リーダーシップにとって、このツールの価値は高速スキャンではなく、人間の意思決定権を尊重する高信頼度検出結果にあることを認識してください。
重要なポイントと次のアクション
Mantisは、セキュリティインフラストラクチャにおけるAIの役割の成熟を示しています。検出量の最適化から検証精度の最適化へのシフトです。エージェント型の再現と修正生成を通じて脆弱性ライフサイクルを自動化することで、このフレームワークは、以前のAIセキュリティツールへの信頼を損なわせた誤検知の危機に対処しています。
このフレームワークの価値は、組織がそれを人間の判断の代替ではなく、専門家チームの力を増幅するツールとして扱う場合に生まれます。成功には以下が必要です。
- エージェント型検証を組み込むために脆弱性ワークフローを再考すること
- 既存のCI/CDおよび脆弱性管理システムへの慎重な統合を計画すること
- 透明な推論トレースを通じて自動化された推奨事項に対するエンジニアの監視を維持すること
- フレームワークの能力と制約を理解し、適切なコンテキストで展開すること
セキュリティチームにとって、直近のアクションはMantisを最も誤検知が多い脆弱性クラスに対して評価することです。非重要なシステムでのパイロットプログラムから始めることをお勧めします。インフラストラクチャチームにとっては、計画段階で計算要件とCI/CD統合の複雑性を評価してください。リーダーシップにとっては、このツールの価値がより高速なスキャンにあるのではなく、人間の意思決定権を尊重し、セキュリティチームの有効性を損なわせるアラート疲労を軽減する、より高い信頼度の検出結果にあることを認識することが重要です。
エージェント型AI:能力と制約—誠実な評価
エージェント型システムは、以前のAIセキュリティツールに比べて真の建築的進歩を表しています。しかし、その境界について明確に認識する必要があります。エージェントは多段階の推論、調査段階全体にわたるコンテキスト維持、初期アプローチが失敗した場合の適応的問題解決に優れています。静的分析では決して実現できない方法で、人間の研究者ワークフローを近似しています。
しかし、エージェントは、スケーリングでは克服できない根本的な制約に直面しています。
-
*ビジネスロジック脆弱性**は、エージェントにとってほぼ不透明なままです。特定のビジネスルール、規制上の制約、またはドメイン固有の脅威モデルの理解を必要とする脆弱性は、しばしばエージェント型推論の能力を超えています。エージェントは、特定のデータフローがコンプライアンス要件に違反していること、または特定のビジネスコンテキスト内で微妙な権限昇格を可能にしていることを見落とす可能性があります。
-
*タイミングと競合状態**は、正確な時間的推論を必要とする課題を提示します。特定の実行シーケンスまたはレース条件ウィンドウに依存する脆弱性は、制御された環境での再現試行を逃れることがよくあります。
-
*確立された脆弱性分類に適合しない新規の攻撃ベクトル**は、頻繁に検出を回避します。既知の脆弱性パターンで訓練されたエージェントは、真に新しい悪用技術に対応するのに苦労しています。
-
*敵対的入力**は、エージェント推論を操作するように設計されています。プロンプトインジェクション攻撃、偽陰性をトリガーするために作成された敵対的ペイロードは、エージェントが特に脆弱な新興の脅威クラスを表しています。
この誠実な評価は、Mantisの最適な展開を明確にします。これは、よく特性化された脆弱性クラスの大量トリアージのための力の増幅であり、重要なシステムに対する専門家分析の代替ではありません。このフレームワークは、ルーチン検証作業を処理し、人間のセキュリティ研究者が新規の脅威、ビジネスロジック脆弱性、および高度な攻撃シナリオに焦点を当てるのを解放する場合に最も価値があります。
将来の機会は、エージェントが規模での検証を処理し、人間の専門家が微妙な判断を必要とする検出結果の10~20%に焦点を当てるハイブリッドモデルにあります。この労働分業は、組織のセキュリティスループットを数桁増加させる可能性があります。
統合と組織的採用:隠れた複雑性
Mantisを効果的に展開するには、セキュリティスタックに別のツールを追加するのではなく、脆弱性管理ワークフロー全体を再考する必要があります。これは多くの組織が躓く場所です。
このフレームワークの計算要件は、従来の静的分析を超えています。再現試行には、テスト環境のスピンアップ、隔離された環境での潜在的に悪意のあるペイロードの実行、検証戦略の反復が含まれます。単一の深い検証は、数分の計算時間を消費する可能性があります。これは重要な検出結果には許容可能ですが、ルーチンスキャンには禁止的である可能性があります。
組織は段階的なアプローチを実装する必要があります。Mantisは高リスク変更(セキュリティに敏感なコード、認証システム、データ処理)に対して深い検証を実行し、より高速なスキャンはルーチンコミットをカバーします。これには、高度なCI/CDオーケストレーションと、どの検出結果がエージェント型調査を保証するかについての明確な決定基準が必要です。
文化的採用は同等に重要な課題を提示します。手動トリアージに慣れたセキュリティチームは、特にMantisが人間の直感が疑わしいとしてフラグを立てた検出結果を却下する場合、最初は自動検証を信頼しないかもしれません。信頼を構築するには、時間をかけて精度を実証し、推論について透明性を維持する必要があります。
成功した採用パターンは、誤検知が特に問題となっている特定の脆弱性クラスから始まります。SQLインジェクション、コマンドインジェクション、または特定のコードベース内の認証バイパスです。制限されたコンテキストで価値を実証することで、スコープを拡張する前に組織的な支持を構築します。
既存の脆弱性管理プラットフォームとの統合には、組織が計画段階で頻繁に過小評価するカスタム開発作業が必要です。CI/CD統合、カスタムエージェントチューニング、および運用ランブック開発に対して、初期時間見積もりの2~3倍を予算化してください。
AIセキュリティインフラストラクチャと新興の脅威状況
Mantisのリリースは、重要な変曲点の中で発生しています。AIシステムは現在、セキュリティツールおよびセキュリティターゲットとして同時に機能しています。最近のインフラストラクチャ侵害は、AIシステム自体が防御的イノベーションを必要とする新規の攻撃面を提示していることを示しています。
このフレームワークのエージェント型アーキテクチャは、新しい考慮事項を導入します。コード実行機能を持つエージェントは、敵対的入力またはプロンプトインジェクション攻撃を通じて操作される可能性があり、セキュリティツールを攻撃ベクトルに変換します。Mantisの推論パターンを理解している攻撃者は、エージェントに対して脆弱に見えるが、実際には意図しない動作をトリガーするコードを作成する可能性があります。
Mantisのオープンソース化は、防御と攻撃の両方の能力を加速させます。セキュリティチームは強力な検証ツールを獲得しますが、敵対者はフレームワークを研究して検出メカニズムを理解し、回避技術を作成することができます。これはオープンソースセキュリティインフラストラクチャの本質です。透明性は防御を可能にしますが、攻撃も可能にします。
この進化は、AIエージェントがマシン速度で攻撃と防御の両方を実施する新興の軍拡競争を示唆しています。セキュリティ対応ウィンドウを日単位から時間単位に圧縮しています。エージェント型セキュリティインフラストラクチャを習得する組織は、従来のツールに依存する組織とは根本的に異なる脅威対応ペースで動作します。
長期的な含意は、セキュリティインフラストラクチャ自体が競争上の優位性になることです。エージェント型検証機能に投資する組織は、競合他社よりも脆弱性をより迅速に検出および修復し、時間をかけて複合的なセキュリティ上の利点を生み出します。
戦略的含意と組織的未来
Mantisは、セキュリティインフラストラクチャにおけるAIの役割の成熟を表しています。検出量から検証精度へ、パターンマッチングから調査推論へ、アラートから信頼度スコア付き検出結果へのシフトです。
この移行を習得する組織は、劇的に異なるセキュリティ経済で動作します。セキュリティチームが時間の60~70%を誤検知のトリアージに費やす代わりに、新規の脅威分析、攻撃面の拡張、および積極的なセキュリティ研究に60~70%を費やします。この人間の専門知識のより高い価値のある活動への再配分は、時間をかけて複合します。
直近の脆弱性管理を超えて、Mantisはより広いシフトを示唆しています。AIシステムはますますパターンマッチャーではなく推論エージェントとして動作しています。この建築的進化は、セキュリティインフラストラクチャ、インフラストラクチャ管理、および組織全体の意思決定を再形成します。今日、エージェント型システムの内部専門知識を構築する組織は、これらのツールが普及するにつれて大きな利点で動作します。
このフレームワークは、AI駆動型セキュリティにおける人間の代理についても重要な質問を提起しています。AI時代におけるエンジニアのスキル保護に関して詳しく探討されているように、開発者はAI駆動型ツールの受動的な消費者になるのではなく、それに対する批判的判断を維持する必要があります。Mantisは、出力を詳細な推論トレースを伴う人間のレビューを必要とする高信頼度の候補として位置付けることで、これを認識しています。これにより、エンジニアは脆弱性の性質を理解し、修正品質を評価することができます。
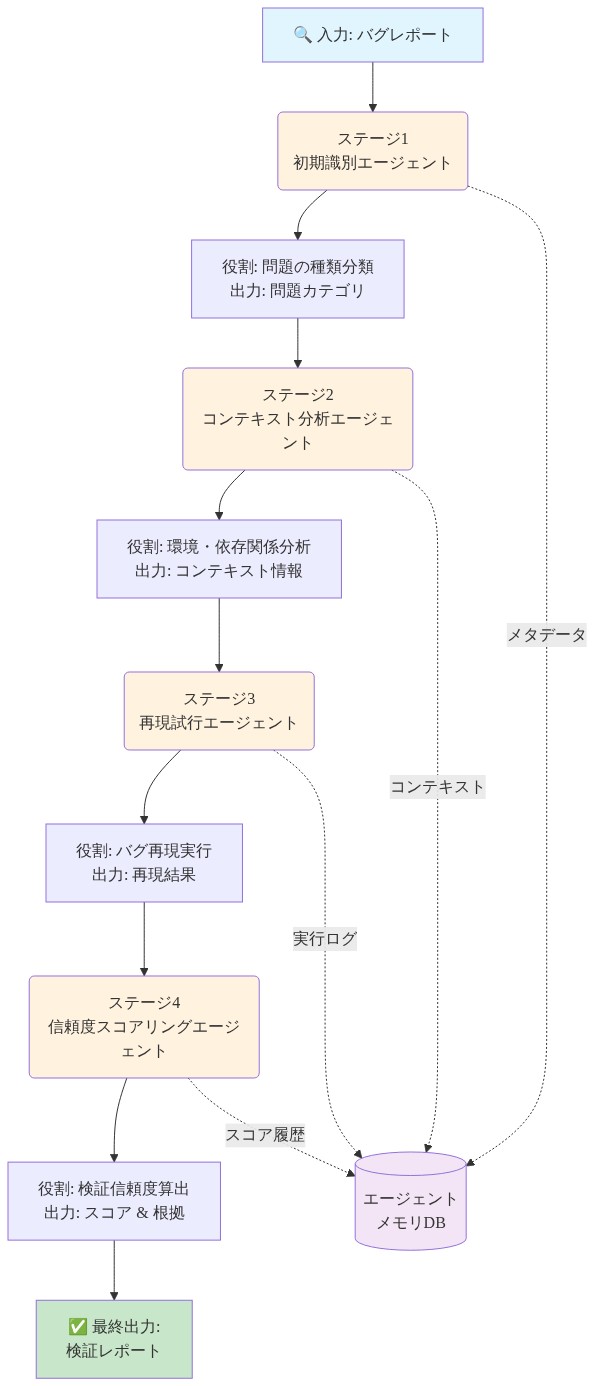
- 図4:Mantisの多段階エージェントワークフロー(Google Mantis アーキテクチャドキュメント)*
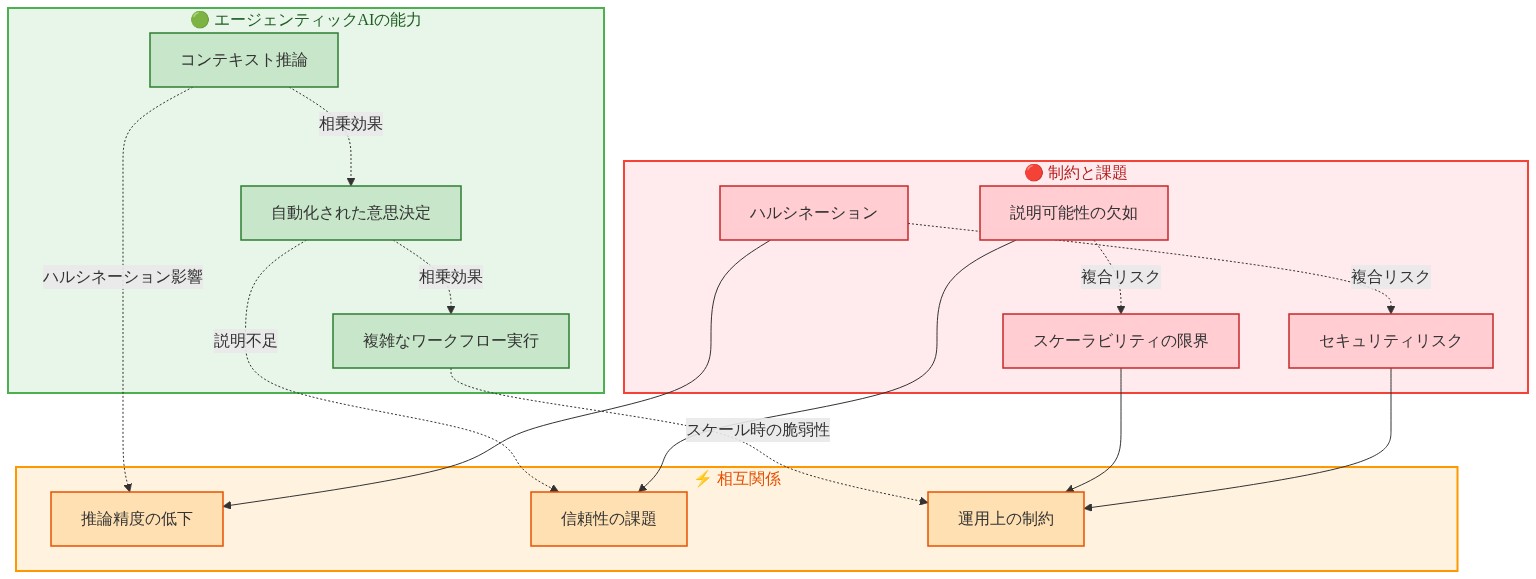
- 図6:エージェンティックAIの能力と制約マトリックス*
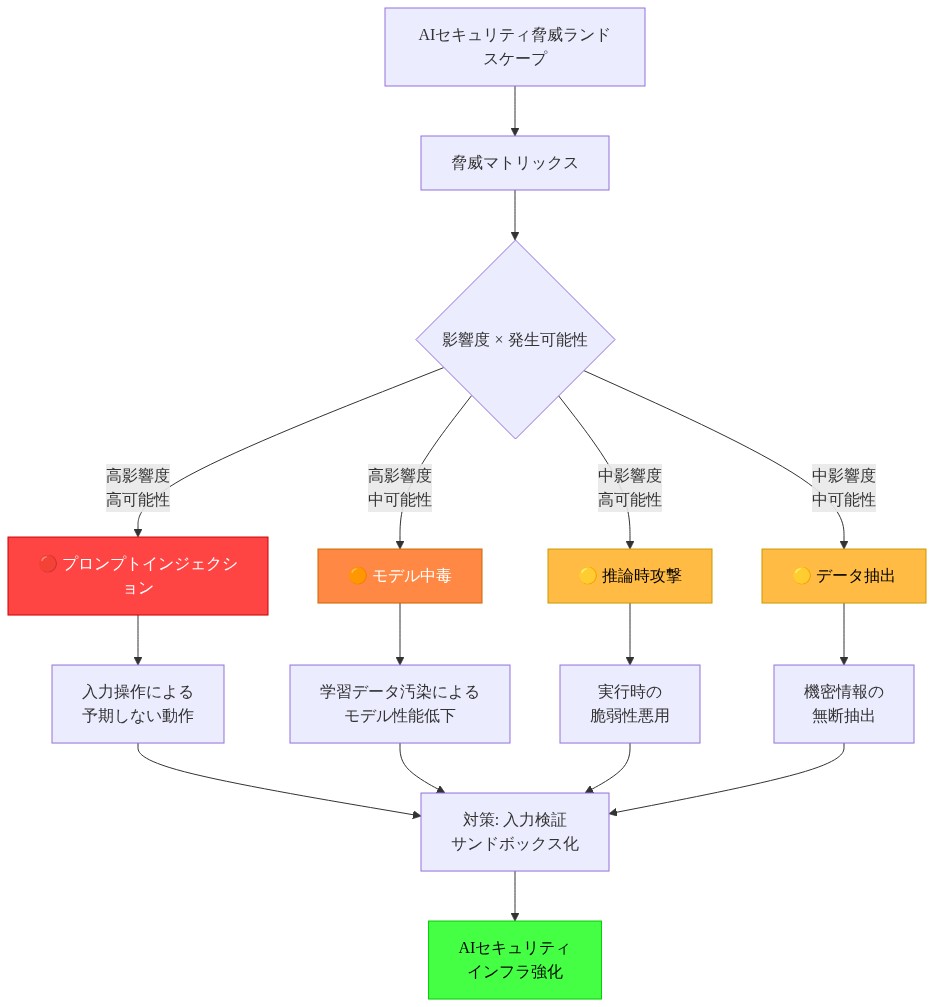
- 図10:AIセキュリティインフラの新興脅威ランドスケープ(AI脅威評価フレームワーク)*