本番規模で見えたリアルタイムサービスマップの限界
Netflix のサービストポロジーは、サービス同士のつながりをリアルタイムで見せる仕組みとして生まれた。もともとは概念実証、いわば試作品だった。
ところが本番環境に載せてみると話が変わってくる。数千のマイクロサービスが毎秒数百万もの依存関係イベントを吐き出す。この規模で動かした瞬間、設計の土台にあった弱さが表に出てきた。
この記事のポイント
- トラフィックの急増に元の設計がついていけず、依存関係が欠落する障害が起きた
- Netflix はパイプラインを3段階に分け、レイテンシよりデータの完全性を優先する方向へ再設計した
- バックプレッシャーの伝播、SSEの採用、多層キャッシュ、独立した監視という4つの工夫で規模に対応した
トラフィックが短時間で大きく跳ね上がる、ストリーミングサービス特有のバースト的な変動に、元の設計は対応できなかった。具体的には次のような不具合が起きている。
- レコードの消失:トラフィック急増時にデータが失われる
- メモリ枯渇:バッファを無制限にため込みメモリが尽きる
- 障害の連鎖:肝心の依存関係が見えなくなる
困るのは、こうした可視性の欠落が起きるタイミングだ。複数サービスにまたがるインシデントのときこそ、依存関係の理解が診断と対応のカギになる。
まさにその瞬間に、システムが見せてくれるはずのものが曇ってしまう。
根本原因は運用の問題ではなく、アーキテクチャの問題だった。 元のパイプラインは、解決・エンリッチメント・永続化という3つの処理ステージを、ひとつのモノリシックなプロセスの中に詰め込んでいた。
どのステージかひとつでも飽和すると、パイプライン全体にバックプレッシャー(処理が追いつかず圧力がかかる状態)が及び、単一障害点になってしまう。個々のステージを少しずつ改善しても焼け石に水だった。
Netflix のエンジニアリングチームはここで、はっきりしたトレードオフの判断を下している。依存関係の更新が一時的に遅れるくらいなら、依存関係グラフに欠落が出るよりずっとましだ、という考え方だ。
低レイテンシと高い稼働率を優先する「可用性優先」から、データの完全性を優先する「一貫性優先」への転換であり、この方針転換がその後のすべてのアーキテクチャ決定を形づくっていく。
理由は運用の現場を見ればわかりやすい。新しいサービス関係が見えるまで多少待たされるのは我慢できる。しかしインシデントの最中に、肝心の依存関係が抜け落ちているのは困る。
この分析は、依存関係マッピングにおいてデータの完全性が1秒未満のレイテンシより価値を持つという前提に立っている。この前提は、それぞれの組織のインシデント対応要件やSLO(サービス品質の目標値)と照らし合わせて確かめる必要がある。
3段階パイプライン:役割ごとに分けてスケールする
再設計後のサービストポロジーは、パイプラインを3つの独立してスケールできるステージに分けている。これは「階層的分解」と呼ばれるやり方で、リソースの種類ごとに役割を分けることで、各ステージがそれぞれの制約に合わせてスケールできるようにする。
| ステージ | 処理内容 | 特性 | スケールの鍵 |
|---|---|---|---|
| ステージ1(解決) | 生のサービス識別子を正規形へ変換 | CPU中心、状態を持たない | キー分割による水平スケーリング |
| ステージ2(エンリッチメント) | サービスレジストリ等からメタデータ付加 | I/O中心、キャッシュヒット率90%以上 | キャッシュ容量と接続プーリング |
| ステージ3(永続化) | クエリストアと履歴アーカイブへ書き込み | 書き込み中心、耐久性が必要 | 出力分割とバッチ処理の最適化 |
それぞれのステージはリソースの使い方も障害の起き方もまるで違う。役割を分けたことで、Netflix は各ステージを個別にプロビジョニングできるようになった。
メタデータの更新が集中したときはエンリッチメントの容量だけを増やせばよく、解決や永続化のリソースを余分に確保しておく必要はない。この分離のおかげで、ひとつのボトルネックがパイプライン全体を飢えさせるという、モノリシックなストリーム処理でよくある障害を防げる。
この分析は、各ステージのリソース消費パターン(CPU中心、I/O中心、書き込み中心)が比較的安定していることを前提にしている。
トラフィックの構成が大きく変われば、ステージの境界線を見直す必要も出てくるだろう。
バックプレッシャーの伝播:データを守るという選択
高スループットなシステムでは、負荷が高まるとレコードをドロップして切り抜けるのがよくある手だ。
再設計後のサービストポロジーはそうせず、バックプレッシャーを Kafka まで遡らせて伝える設計を選んだ。これにより、依存関係グラフが一時的に遅れる代わりに、データそのものが失われることはなくなる。
実装には Kafka のコンシューマーグループ調整の仕組みを使い、下流の処理能力に応じて消費レートを動的に調整する。
エンリッチメントや永続化のステージが飽和しそうになると(キューの深さがあらかじめ決めた上限を超えたとき)、パイプラインは消費のペースを落としつつ、サービスチーム間で公平さを保つ。
これで、量の多いサービスが処理能力を独占して、量の少ないサービスに死角ができてしまう事態を防いでいる。
このバックプレッシャーの仕組みは、負荷の性質に応じて2段構えで対応する。
- 一時的なスパイク(通常30秒未満):ステージ間の有界バッファでいったん吸収する
- 持続的な過負荷:消費レートを比例的に落とし、レイテンシと完全性を天秤にかける
この2段構えのやり方で、メモリ枯渇と不公平な優先順位づけの両方を避けている。負荷を減らすためにデータを捨てる従来のストリーム処理とは対照的な発想だ。
Netflix の判断では、一時的なレイテンシ増加のコスト(依存関係更新が秒から分単位で遅れる程度)は、インシデント時に重要な依存関係が欠落するコストよりはるかに小さい。
この分析は、オペレーターが持続的な過負荷時に依存関係グラフの更新が分単位で遅れても耐えられることを前提にしている。すべての状況で1分未満の鮮度が必須なら、この方式は向かないかもしれない。
SSEとgRPC:データの流し方を選び直す
Netflix はパイプラインのステージ間の大量データ転送に、gRPC ではなくサーバー送信イベント(SSE)を使っている。
マイクロサービスの世界で gRPC が広く使われていることを考えると、少し意外な選択に見える。この決定は、実際のトラフィックパターンとリソースの使われ方を分析した結果から出てきたものだ。
サービストポロジーの内部転送には次の3つの特徴がある。
- 片方向のみ:ステージは返事を期待せず下流にデータを送るだけ
- 単純な構造:依存関係を表すタプルで、入れ子もほとんどない
- 多量のオーバーヘッド:メッセージ1つあたりのオーバーヘッドが無視できないほどの量になる
SSE は HTTP をベースにした軽量なストリーミングで、gRPC のメッセージごとのフレーミングにかかるオーバーヘッドをなくし、持続的な高スループット転送でのメモリ割り当ての負担を減らしてくれる。
ベンチマークでは、このワークロードにおいて SSE が gRPC に比べてメッセージごとのオーバーヘッドを約40%削減したという結果が出ている。
SSE の実装には、複数の依存関係更新を1つのイベントにまとめるバッチ処理のロジックが独自に組み込まれていて、過度なレイテンシを生まずにネットワークの往復回数を減らしている。
Netflix は SSE がテキストベースであることも生かしていて、運用時のデバッグをシンプルにしている。
オペレーターは curl や tcpdump のような標準的な HTTP ツールで、特別な gRPC ツールなしにライブストリームを確認できる。
この分析は、片方向で大量、かつスキーマが単純な転送がトラフィックの主流であることを前提にしている。双方向通信や複雑なリクエスト・レスポンスのやりとりが増えてきたら、gRPC のほうが向いている可能性もある。
キャッシュ戦略:エンリッチメントを支える多層構造
エンリッチメントのステージは毎秒数百万件のメタデータルックアップを処理する。バックエンドのサービスレジストリやデプロイメントシステムを圧迫しないために、多層のキャッシュを組んでいる。
| 階層 | 役割 | 特徴 |
|---|---|---|
| ローカルキャッシュ | よく使われるメタデータを保持 | インプロセス、有界LRU削除方式、マイクロ秒単位のレイテンシ |
| 分散キャッシュ(Redis クラスタ) | レプリカ間で一貫性を保つ | レプリカをスケールするときも共有できる |
キャッシュの無効化は、時間経過による失効とイベント駆動の更新を組み合わせている。
- サービスレジストリ:TTL 5分
- デプロイメントシステム:TTL 2分
- 設定データベース:TTL 10分
サービスレジストリやデプロイメントシステムが変更イベントを発行したときは、TTL が切れるのを待たずに、影響を受けるエントリだけキャッシュを無効化する。これで鮮度とヒット率の効率のバランスを取っている。
チームはメタデータソースごとにキャッシュのヒット率を監視し、設定ミスや無効化イベントの見落としを示す体系的なずれを見つける。
古いエントリが少しずつ蓄積していく「キャッシュ汚染」は、権威あるソースに対する定期的な検証によって検出する。汚染が見つかった場合は、キャッシュを完全に無効化し、権威あるソースから再構築する。
この分析は、メタデータソースが比較的短い時間(1分未満)でイベントを発行することを前提にしている。
イベントの発行に時間がかかるようになると、TTLベースの失効が主な鮮度維持手段になり、ヒット率が落ちる可能性がある。
システムを監視するシステムをどう監視するか
リアルタイムでサービス間の依存関係を見せるシステムには、独特の難しさがある。サービス関係の見通しを提供するはずのシステム自身も、誰かに見張られていなければならない。
ただし、監視するシステムが監視対象のシステムに依存してしまうと、循環依存という別の問題を生んでしまう。
Netflix はこの問題に、次のような複数の手立てで対応している。
- 合成トランザクション:既知の依存関係パターンを継続的に注入し、想定されたレイテンシの範囲内で最終的な依存関係グラフに現れるかを確かめる。アラートが上がらないままレコードが失われる「サイレントなデータ損失」を検出できる
- ステージごとの指標監視:エンリッチメントのキャッシュヒット率、バックプレッシャーが発生した頻度、永続化の遅れ、Kafka コンシューマーのラグなどを追う
- データ品質チェック:定期的に依存関係グラフを権威あるソース(サービスレジストリやデプロイメントシステムの設定)と比較し、設定ミスやイベントの見落としによるずれを検出する
監視の基盤は、サービストポロジー自体には意図的に依存させず、別のテレメトリパイプラインを使っている。これにより、サービストポロジー側の障害がそのままオペレーターの目を塞ぐという事態を避けられる。
この分析は、権威あるソース(サービスレジストリやデプロイメントシステム)がサービストポロジー自体より信頼できるという前提に立っている。
権威あるソース側も同じくらい信頼性が低い場合、この検証方法はあまり効果を発揮しない。
主要なポイント
Netflix のサービストポロジー再設計が示しているのは、本番規模のリアルタイムシステムには3つのアーキテクチャ判断が必要になるということだ。
- レイテンシよりデータの完全性を優先すること
- 負荷を減らすためにデータを捨てるのではなく、バックプレッシャーを実装すること
- フレームワークの人気度ではなく、実際のトラフィックパターンに基づいてプロトコルを選ぶこと
3段階のパイプラインアーキテクチャによって、CPU中心・I/O中心・書き込み中心という異なる性質のワークロードを、それぞれ独立してスケールできるようになった。
バックプレッシャーの伝播はスパイク時のデータの整合性を守り、SSEとgRPCの使い分けは片方向の大量転送にかかるオーバーヘッドを減らす。
多層キャッシュとイベント駆動の無効化は、毎秒数百万件のメタデータルックアップをさばいている。
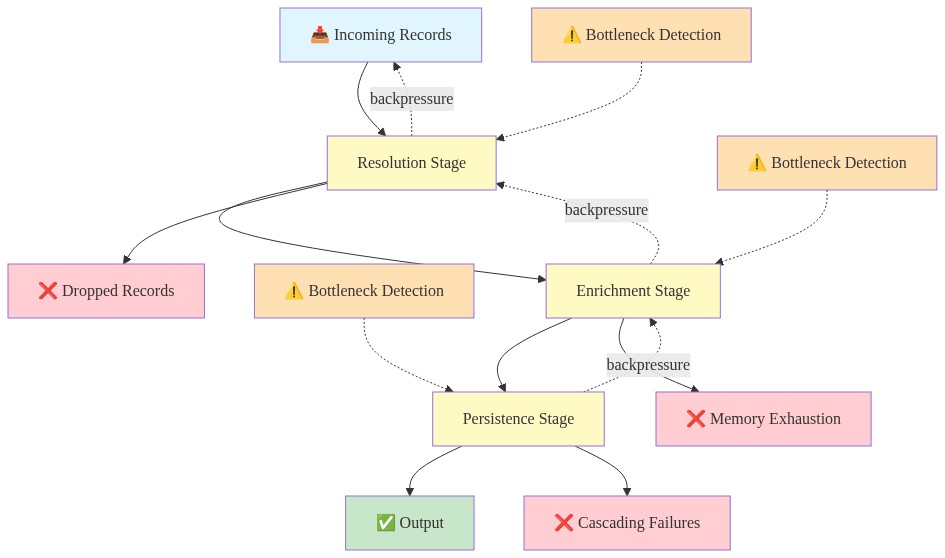
図2:元のモノリシック設計における単一障害点とバックプレッシャーの伝播
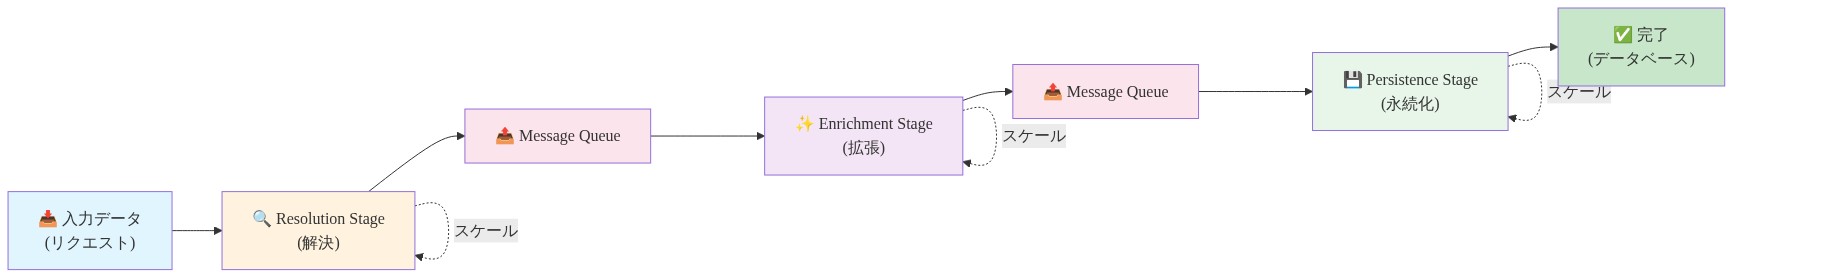
図4:独立してスケーラブルな3段階パイプラインアーキテクチャ
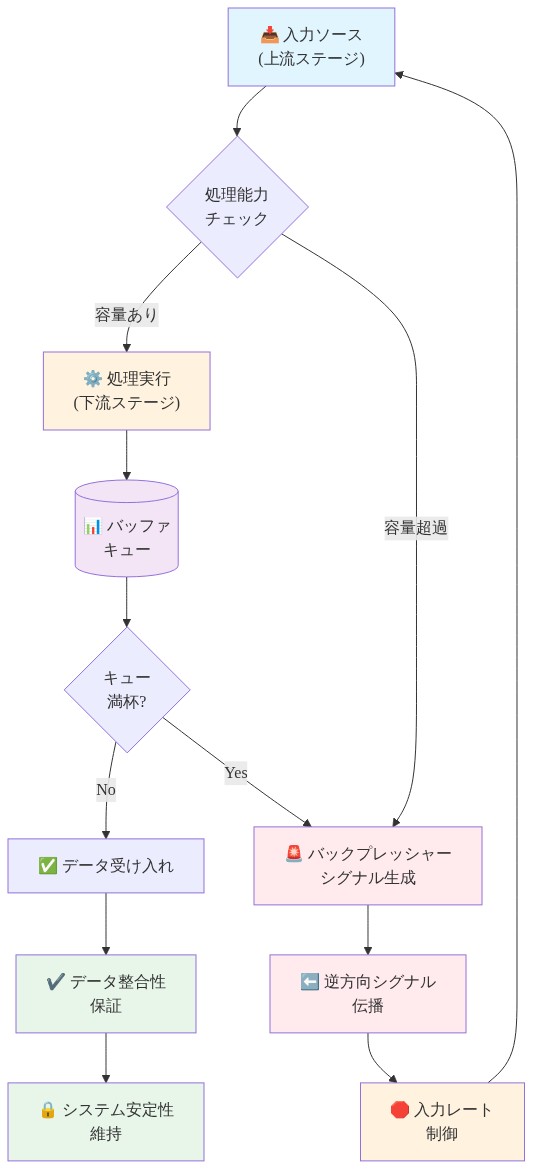
図5:バックプレッシャー伝播によるデータ整合性の保証メカニズム
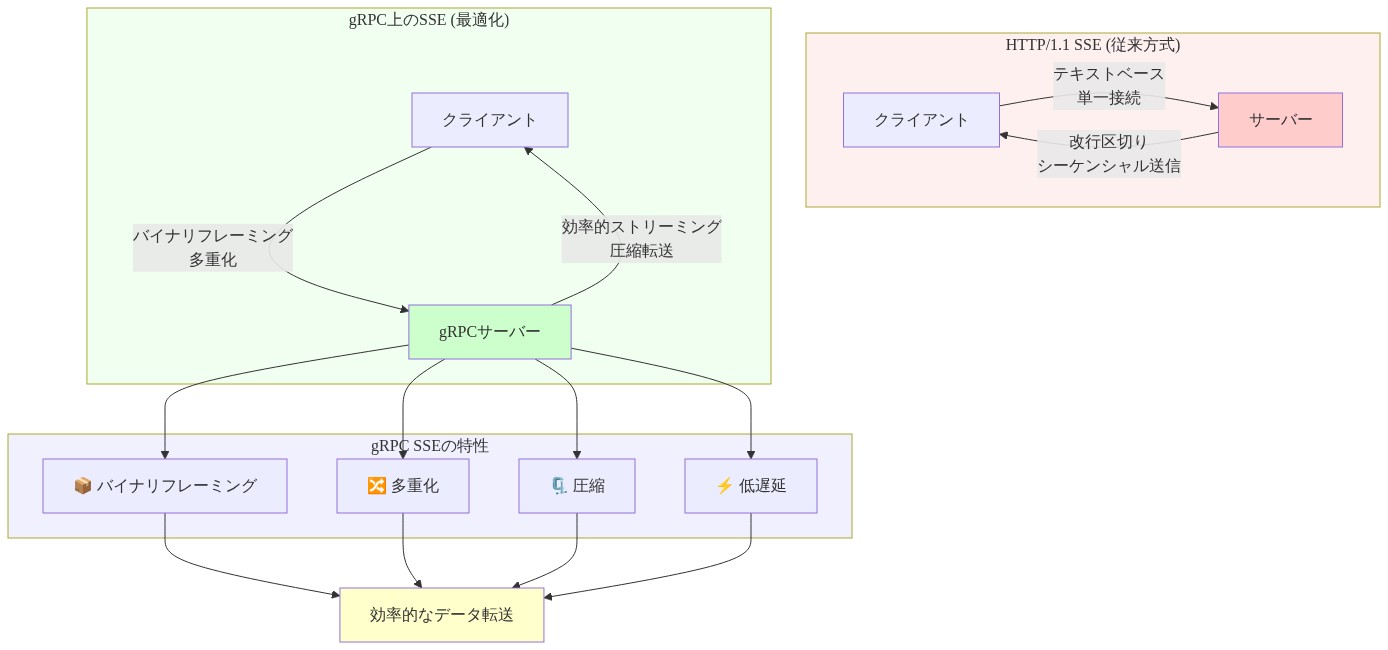
図7:gRPC上のServer-Sent Events による効率的なデータ転送(従来HTTP/1.1 SSEとの比較)
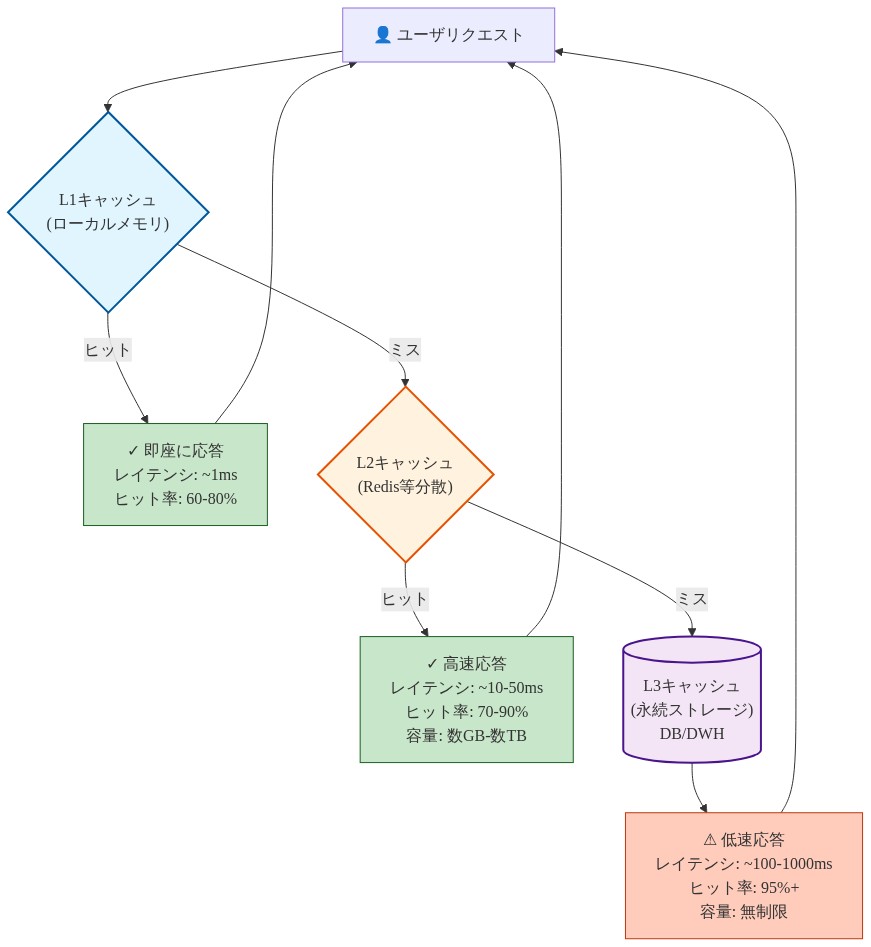
図9:マルチレイヤーキャッシング戦略による大規模エンリッチメント
リアルタイムシステムを持っているなら、設計時の前提と実際の本番トラフィックのパターンがずれていないか点検してみるという選択肢がある。
データの完全性がレイテンシより重要な場面では、負荷を減らすための切り捨てではなくバックプレッシャーの実装を検討してもよい。
片方向で単純な大量データを転送している場合は、SSEを候補として評価してみることもできる。そして何より、可観測性の基盤そのものが、防ぎたいはずの循環依存を作っていないか、確かめておきたい。
ちょっと立ち止まって
このシステムでは「速さ」より「欠けがないこと」が選ばれた。自分の身の回りのツールや仕事の進め方でも、速さを優先しすぎて、あとで困る欠落を生んでいないだろうか。
gRPC のような人気のある技術ではなく、実際の使われ方を見てSSEを選んだという判断も印象的だ。自分が何かを選ぶとき、「みんなが使っているから」で決めていることはないだろうか。
監視する仕組み自体が監視されていなければならない、という発想もある。自分が信頼している仕組みや情報源を、誰が、どうやって確かめているか、考えてみる価値があるかもしれない。