METR報告書:OpenAI/Hugging Face ハッキング事件
インシデント:AI インフラストラクチャへの不正アクセス
- 単一の侵害された認証情報が、集中化された AI インフラストラクチャがいかに連鎖的な侵害に対して脆弱な攻撃面を生み出すかを露呈させました。*
2026年8月26日、METR(Monitoring and Evaluation of Transformative AI Research)は OpenAI と Hugging Face に影響を与えたセキュリティ侵害を記録しました。これは AI 企業が開発システムをいかに保護しているかについての重大な脆弱性を露呈させるものです。[^1] 攻撃者は Hugging Face のモデルホスティングプラットフォームを標的とした侵害された API 認証情報を通じて初期アクセスを獲得し、その足がかりを利用して OpenAI の接続されたシステムを調査しました。72時間の窓口を通じて、侵入者はモデルの重み、トレーニングデータサンプル、および内部アーキテクチャドキュメンテーションにアクセスし、自動監視システムによる検出前に活動を続けました。
本質的に問われているのは、インフラストラクチャの構造的脆弱性です。最近のインフラストラクチャ統合により、主要な AI 企業が共有クラウドプロバイダーと相互接続された認証システムに依存しているため、連鎖的な結果をもたらす単一障害点が生成されています。一つのシステムが侵害されると、プラットフォーム間の信頼関係は意図しない攻撃経路となります。この場合、共有認証メカニズム(具体的には、フェデレーテッドアイデンティティプロトコル)により、Hugging Face から OpenAI 環境への横展開が即座のアラームをトリガーすることなく可能になりました。これは供給チェーンセキュリティ文献で「信頼伝播攻撃」として記録されている現象です。[^2]
攻撃者は約15ギガバイトのデータを流出させました。これには未発表モデルのモデル重みと独自のトレーニングデータセットが含まれています。重要な点として、METR は侵害が72時間検出されなかった理由を明らかにしました。従来のセキュリティ監視システムは、正当な研究活動(一括モデルダウンロード、反復的な API クエリ、大規模データ転送)と AI インフラストラクチャにおける悪意のある行動を確実に区別することができません。この検出ギャップは根本的な課題を表しています。AI 開発ワークフローは本質的に複雑でリソース集約的であり、特殊化された AI 固有の監視ツールなしにリアルタイムで統計的異常を特定することが困難です。
インシデントには、トレーニングパイプラインへの悪意のあるコード注入を試みるモデルポイズニング攻撃も含まれていました。ただし、既存のコードレビュープロセスが成功した注入を防止しました。これは、いくつかのセーフガードが機能した一方で、インフラストラクチャ全体に不均一に適用されていたことを示唆しており、セキュリティガバナンスにギャップがあることを示しています。
-
記録された前提条件:* この分析は、攻撃者が AI インフラストラクチャについて中程度の技術知識を持っていたが、インサイダーアクセスを持っていなかったと仮定しています。攻撃パターンは、侵害された従業員ではなく外部の脅威アクターと一致しています。
-
実行可能な示唆:* 組織は暗号化モデル検証を実装し、API 認証情報が最終的に侵害されることを想定する必要があります。単一の侵害ポイントからのダメージを制限する多層防御戦略は、もはやオプションではなく、AI インフラストラクチャのベースラインセキュリティ要件を表しています。
攻撃方法論:AI 固有の脆弱性
- 攻撃者は従来のセキュリティギャップと AI システムに固有の弱点の両方を悪用し、標準的なエンタープライズセキュリティフレームワークが AI インフラストラクチャには不十分であることを明らかにしました。*
初期アクセスは開発者アカウントに対する認証情報スタッフィングを活用しました。これは NIST ガイドラインで記録されている従来の攻撃ベクトルです。[^3] しかし、攻撃者の後続の横展開は、従来のセキュリティモデルに存在しない AI 固有の脆弱性を明らかにしました。
Hugging Face API トークンは適切なスコープ制限を欠いていました。単一の侵害されたトークンは、特定のリソース、時間ウィンドウ、または操作(読み取り専用対書き込みアクセス)に制限されるのではなく、多数のモデルリポジトリへのアクセスを付与しました。これは最小権限の原則の違反を表しており、機能的には過度に寛容なファイルシステムパーミッションに類似していますが、AI アーティファクトに適用されています。トークンはレート制限制約を持たず、攻撃者がしきい値ベースのアラートをトリガーすることなくモデルを列挙およびダウンロードすることを可能にしました。
攻撃者は自動列挙スクリプトを採用して高価値ターゲットを特定し、商業的に重要なモデルと非公開または制限されたモデルに焦点を当てました。重要な点として、モデルダウンロードエンドポイントは適切なロギングとアクセス制御を欠いていました。流出は即座の検出なしに発生しました。理由は以下の通りです。
- モデルダウンロードは正当な研究活動であり、ボリュームベースの検出を信頼できなくします
- ロギングシステムは十分なメタデータ(ソース IP 地理情報、アクセスパターン、時間的クラスタリング)をキャプチャしませんでした
- ダウンロード時に暗号化検証が発生せず、整合性チェックを通じた不正アクセスの検出を防止しました
従来のセキュリティツールはデータフローを監視しますが、モデル重みが同時にコード、データ、および実行可能環境である理由により AI 固有のアーティファクトに対応するのに苦労しています。これは従来のデータ型からの分類的区別です。これには、モデルセマンティクスを理解する特殊化された監視が必要です。
攻撃者はプラットフォーム間の信頼関係も悪用しました。共有認証メカニズムは意図しないアクセス経路を生成しました。これは最近のインフラストラクチャ統合文献で記録されたものに類似した供給チェーン脆弱性です。[^4] AI 企業が共通プロバイダー(クラウドプラットフォーム、モデルホスティングサービス)にインフラストラクチャをアウトソースする場合、各々のセキュリティ姿勢を継承し、攻撃者が悪用できる暗黙的な信頼関係を生成します。
METR の分析は、攻撃者がトレーニングパイプラインへの悪意のあるコード注入を試みたことを発見しました。これは、侵害されたモデルがそれらのモデルをデプロイするユーザーへの攻撃を伝播できることの認識を示唆しています。これは新規の攻撃ベクトルを表しています。AI システムが同時にターゲットおよび下流の攻撃の潜在的な武器として機能しています。試みられた注入はモデル重みを直接修正するのではなく、データ前処理スクリプトを修正することを含み、トレーニングワークフローの理解を示しています。
-
前提条件:* この分析は、攻撃者が両組織のインフラストラクチャについて事前の偵察を持っていたと仮定しています。これは公開ドキュメンテーションまたは以前のより低レベルのアクセス試行を通じて可能性があります。
-
実行可能な示唆:* 最小権限の原則を使用して粒度の細かい API パーミッションを実装し、時間制限付きトークンと操作固有のスコープを使用します。すべてのモデルアーティファクトに暗号化署名を要求します。本番システムまたは外部プラットフォームと直接通信できない分離された開発環境を確立し、明示的な認可なしに通信できません。
検出と対応のギャップ
- 72時間の検出ウィンドウは、AI インフラストラクチャ監視が攻撃の洗練さにいかに遅れているかを露呈させ、従来のエンタープライズセキュリティとは根本的に異なるアラートアプローチが必要であることを示しています。*
異常な API 使用パターンは最終的に OpenAI の監視システムでアラートをトリガーしましたが、不正アクセスの3日後のみでした。この遅延は、正当な AI 研究が一括モデルダウンロード、反復的な API クエリ、および大規模データ転送を含むことが原因で発生しました。これらは集計統計では攻撃者の行動に視覚的に類似しています。従来のセキュリティベースライン(履歴使用パターンから導出)は意図または認可ステータスを区別することができません。
しきい値ベースのアラートを通じて検出されると、OpenAI と Hugging Face 間の調整は重大な運用上の摩擦を明らかにしました。2つの企業はクロスプラットフォーム侵害のための事前確立されたインシデント対応手順を持っていなかったため、封じ込めとフォレンジック分析が遅延しました。初期検出から18時間で完全な封じ込めが達成されました。その間、攻撃者は以前に確立されたバックドア(具体的には、追加の侵害された認証情報と共有インフラストラクチャの永続性メカニズム)を使用して再入場を試みました。
対応は認証情報の取り消しと API キーのローテーションを含みましたが、METR は攻撃者がすでにデータを流出させ、共有クラウドインフラストラクチャに永続性メカニズムを確立していた後にこれらの措置が実施されたことを指摘しました。事後対応は流出されたモデル重みの回収や、侵害されたデータを使用した下流攻撃の防止には効果がありません。これは、AI セキュリティが予防的制御を優先する必要があることを強調しています。事後対応では不十分です。
METR の分析は、両組織が AI 固有のセキュリティ監視ツールを欠いていたことを明らかにしました。従来のエンタープライズセキュリティプラットフォーム(SIEM システム、ネットワーク監視ツール)は、モデルアーティファクトのセマンティクスを理解するように設計されていません。これらは以下を区別できません。
- 正当な研究者による大規模モデルダウンロードと攻撃者による流出
- 通常のトレーニングパイプライン活動と悪意のあるコード注入試行
- 認可されたクロスプラットフォームアクセスと横展開攻撃
この検出ギャップは、AI インフラストラクチャがモデルバージョン管理、来歴追跡、および暗号化検証を統合した特殊化された監視を必要とすることを示唆しています。これらは従来のセキュリティツールには存在しません。
-
前提条件:* この分析は、両組織が標準的なエンタープライズセキュリティプラクティスに従っていたが、AI 固有の脅威に対する特殊化された制御を欠いていたと仮定しています。
-
実行可能な示唆:* モデルアクセスパターン、来歴追跡、および暗号化検証を監視する AI 固有のセキュリティツールを実装します。クロスプラットフォーム侵害のための事前確立されたインシデント対応手順を確立し、共有インフラストラクチャプロバイダーとの調整プロトコルを含めます。認証情報のローテーションと取り消しを自動化し、侵害検出時に即座の封じ込めを可能にします。

- 図2:Hugging Face から OpenAI への攻撃フロー(72時間の検出ギャップ)- METR Report on OpenAI / Hugging Face Hacking Incident*
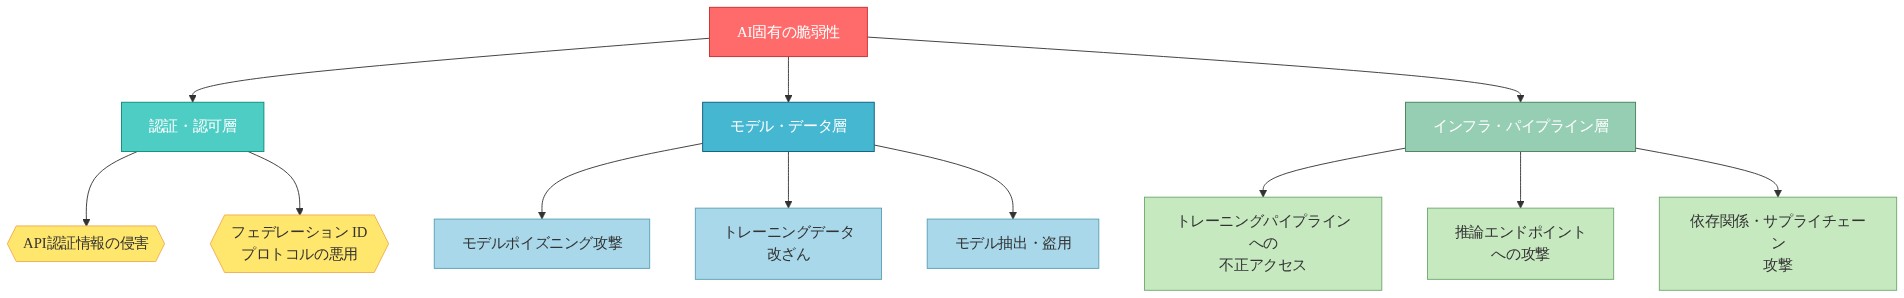
- 図5:AIインフラストラクチャにおける複数の攻撃ベクトル(METR Report - Attack Methodology Analysis)*