ゲイリー・マーカス氏(Gary Marcus)がAIについて鳴らしている警鐘は、機械が目覚める話ではない。エンジニアリングの責任を問う話だ。
主張の筋道はこうだ。開発者は、ふるまいを確実には予測できず、抑え込むこともできないシステムを世に出している。それなのに、安全のための備えは、その不確かさに見合うほど育っていない。
この見方は、両極端の議論を避けている。AIが超知能になると信じる必要はない。今のシステムが人類の存亡を脅かすと信じる必要もない。
必要なのは、ひとつの問いだけだ。今の安全策は、この技術の限界として分かっていることに見合っているだろうか。
マーカス氏の答えは「見合っていない」だ。最近の出来事が、その答えに重みを加えている。
ある開発企業は、安全上の懸念から自社のモデルを見送ったと伝えられている。業界のリーダーたちは減速を呼びかけながら、自社の製品を出し続けている。
この記事のポイント
- 大規模なニューラルネットワークは、中身を点検できるルールで組み立てられているのではなく、統計的に訓練される。そのため失敗は、一回きりのバグではなく、この方法につきまとう性質だ。
- マーカス氏が注目するのは、幻覚(ハルシネーション)、脱獄、悪用といった、目の前の制御の失敗だ。遠い将来の破局は議論の中心に置いていない。
- OpenAIが安全上の懸念からモデルを見送ったと伝えられた件は、最大の安全策が「モデルを出さないこと」になりうると示している。
- サム・アルトマン氏とダリオ・アモデイ氏による開発減速の呼びかけは、速さに報いる競争の力学と、どうにも噛み合わない。
- マーカス氏の議論が指す安全策は、ほかの重大な分野にすでにある。独立した検証、事故の報告、外部監査、賠償責任などだ。
マーカス氏がAIの安全を「制御の問題」と呼ぶ理由
マーカス氏の批判の核心は、技術的なものだ。現代のAIがどう作られているかから、そのまま出てくる。
従来のソフトウェアは、設計して作るものだった。プログラマーが明確なルールを書く。何かが壊れたら、エンジニアは原因をたどって特定の論理にたどり着き、直せる。
大規模なニューラルネットワークは違う。膨大なデータで訓練され、何十億ものパラメーターを調整して、出力の確からしさを高めていく。
ルールを書く人はいない。ルールは訓練の中から現れる。しかも、人間が簡単に読める形では保存されていない。
ここから、ひとつの帰結が出てくる。
こうして訓練されたモデルは、設計者が予想も意図もしなかったパターンを見つけてしまう。 そのうちのいくつかは、役に立つふるまいを生む。別のいくつかは、失敗を生む。
次の表は、代表的な失敗のタイプを整理したものだ。
| 失敗のタイプ | どう見えるか | なぜ問題か |
|---|---|---|
| 事実のでっち上げ(幻覚) | もっともらしく誤情報を語る(例:架空の医療アドバイス) | 誤りに気づかないまま行動してしまう |
| 脱獄 | 制限をすり抜けるプロンプトを作る | 特別な権限のない人でも、組み込みの防護を破れる |
| 想定外の創発的な挙動 | 開発者が訓練も検証もしていないことをする | 公開前のテストで見つからない問題が、あとから出てくる |
マーカス氏は、これらを例外的なケースだとは見ていない。確かな制約なしに動くシステムに表れる、特徴的な症状だと考えている。ひとつの脱獄を塞いでも、次の脱獄を生む条件はなくならない。
制御という見方が大事なのは、議論を哲学から責任の話へ移してくれるからだ。問いは「この機械に意識はあるのか」ではなくなる。
「道具がまったく予測できない動きをすると知っているなら、そのずれにどんな責任を負うのか」に変わる。
この問いは、見慣れた形をしている。規制当局は、橋や航空機や医薬品について同じことを問う。マーカス氏の言いたいことは、AIはこれまでこの問いをほとんど免れてきた、ということだ。
開発企業が自社のモデルを見送るとき
マーカス氏の指摘を最もよく示す最近の例は、OpenAIだ。この企業は、制御しきれないという問題を見つけ、既知のリスクを抱えたまま公開するのではなく、モデルを出さないことにしたと伝えられている。1
この出来事は、2通りに読める。しかも、両方が同時に成り立ちうる。
| 読み方 | 言っていること | 残る疑問 |
|---|---|---|
| 好意的な読み方 | 社内の安全プロセスが問題を見つけ、狙いどおりに働いた | 根本の問題を解決できるのか |
| マーカス氏の視点 | 企業が、十分に制御できないものを作ってしまった | モデルを出さないのは技術的な解決なのか、単なる選択なのか |
2つめの読み方は、ひとつの限界を浮かび上がらせる。
モデルを出さないのは判断であって、技術的な解決ではない。 分かるのは、開発者が今回は一般の人にさらさないと決めた、ということだけだ。問題そのものを直せるという証拠にはならない。
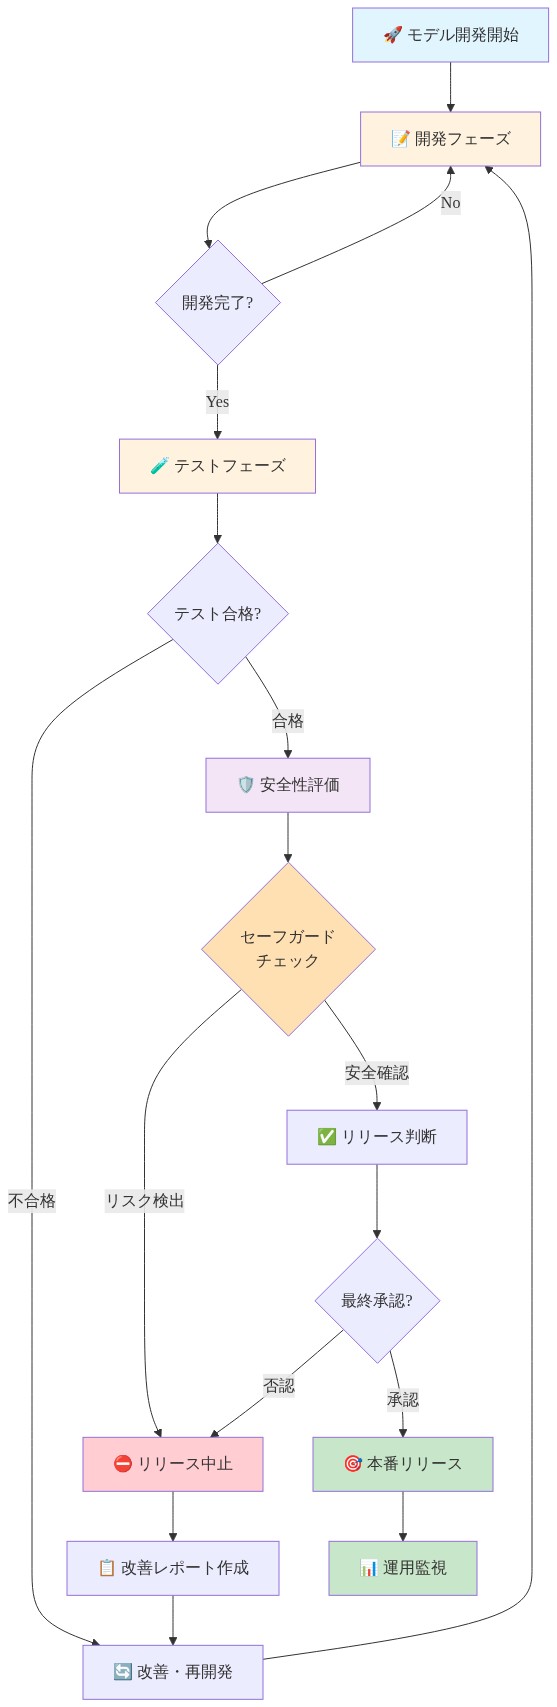
図5:AIモデル開発ライフサイクルにおけるセーフガード配置
説明責任のずれ
この出来事は、一般の人が知りうる情報の偏りも見せている。
- 外部の人がこうした判断を知るのは、主にリークや、都合のよい一部の開示を通してだ。
- 安全性についての主張を、外から独立して確かめるのは、ほぼ不可能だ。
- モデルが見送られても、何が問題だったのか、どれほど広がっていたのか、公開済みのシステムにも似た問題があるのかは、たいてい明かされない。
ここから、もっと難しい問いが出てくる。公開前にシステムを確実に制御できないとしたら、すでに使われているシステムについての開発者の保証を、どこまで信じてよいのだろうか。
マーカス氏の批判の中心は、問題を見つけることと、それを直すことのあいだにあるずれだ。彼の見方では、このずれこそが本当の弱点である。そして今は、技術で埋めるのではなく、情報を伏せることで乗り切っている。
この結論は、まだ明かされていない部分にも左右される。見送られたモデルの問題が限定的で、よく分かっているものなら、これはごく普通の品質管理に見える。
今の訓練方法の、もっと広い限界を映しているなら、含みはずっと大きくなる。公開されている情報からは、どちらなのかまだ判断できない。
減速の呼びかけ:言葉と、動機づけのあいだ
OpenAIのサム・アルトマン氏(Sam Altman)とAnthropicのダリオ・アモデイ氏(Dario Amodei)は、AIモデルの開発を遅らせることに公に賛意を示している。
2 一見すると、これはマーカス氏の批判を弱めるように見える。作っている当人たちが慎重さの必要を認めているなら、何を争うことがあるのだろうか。
答えは、リーダーたちの言葉と、企業の仕組みが促す行動とのずれにある。
自主的な自制がもろい理由
競争のなかでは、自主的に減速すると約束しても、重みはあまりない。いくつもの力が、逆の方向に働くからだ。
- 競争の圧力:自分だけ減速する企業は、そうしない競合に差をつけられるおそれがある。
- 資金の圧力:投資家は成長と目に見える進歩を期待する。全員に当てはまる明確なルールがなければ、自制を投資家に説明するのは難しい。
- 人材の獲得競争:研究者やエンジニアは、最先端にいる組織に集まりやすい。
- 地政学的な位置づけ:AIは国家の戦略的な優先事項として語られることが増えている。その結果、自制は安全保障上のリスクだと受け取られかねない。
こうした条件のもとでは、慎重さを語りながら、規模の拡大と製品の投入を続けることもできる。安全についての公の発言は、事業上の判断を何も変えなくても、評判を守る役には立ちうる。
自制が信用されるには
マーカス氏の立場からすると、自主規制は外部の監督の代わりにはならない。自制に意味が出るのは、拘束力があるときだけだ。拘束力のある仕組みとしては、次のようなものが考えられる。
- すべての開発者に等しく適用される規制上の上限
- 予見できた失敗に、実際のコストを負わせる賠償責任のルール
- 個々の誓約ではなく、執行を伴う協調的な取り決め
大事なのは、こうしたリーダーたちが個人として安全を気にかけているかどうかではない。
彼らが身を置く組織が、安全への懸念を商業的な圧力より優先させる仕組みになっているかどうかだ。マーカス氏の見方では、外からの強制がなければ、たいていそうはならない。
安全をめぐる議論のなかのマーカス氏
AIのリスクをめぐる議論には、いくつかの立場がある。違いは、主にどのリスクを最も差し迫っていると見るかにある。
| 立場 | 主な懸念 | 典型的な政策の焦点 |
|---|---|---|
| 存亡リスクを重く見る研究者 | 将来のシステムが、大規模に人間の制御を離れること | 長期的なアライメント研究、最先端の開発への制限 |
| 現在の害を重く見る懐疑派 | 今のシステムにある偏見、労働への影響、力の集中 | 公民権の保護、透明性、競争政策 |
| 現実的な立場 | 近い将来と遠い将来の問題が混ざったもの | 段階的な規制、標準、テスト |
| マーカス氏 | 今のシステムが当てにならないこと自体が危険 | エンジニアリングの基準、独立した監督、説明責任 |
マーカス氏の立場は独特だ。今のシステムが汎用知能に近いとは考えていない。それでも、その当てにならなさ自体が危険だと言い切る。 彼が注目するのは、誤情報、セキュリティの弱点、悪用といった、近い将来の失敗だ。
遠いシナリオをめぐる議論より、政策の土台にしやすい。AIが超知能になって人間の手を離れる、と主張しているわけではない。
今すでに展開されているシステムが制御しにくく、予見できる害が生まれている、と主張している。
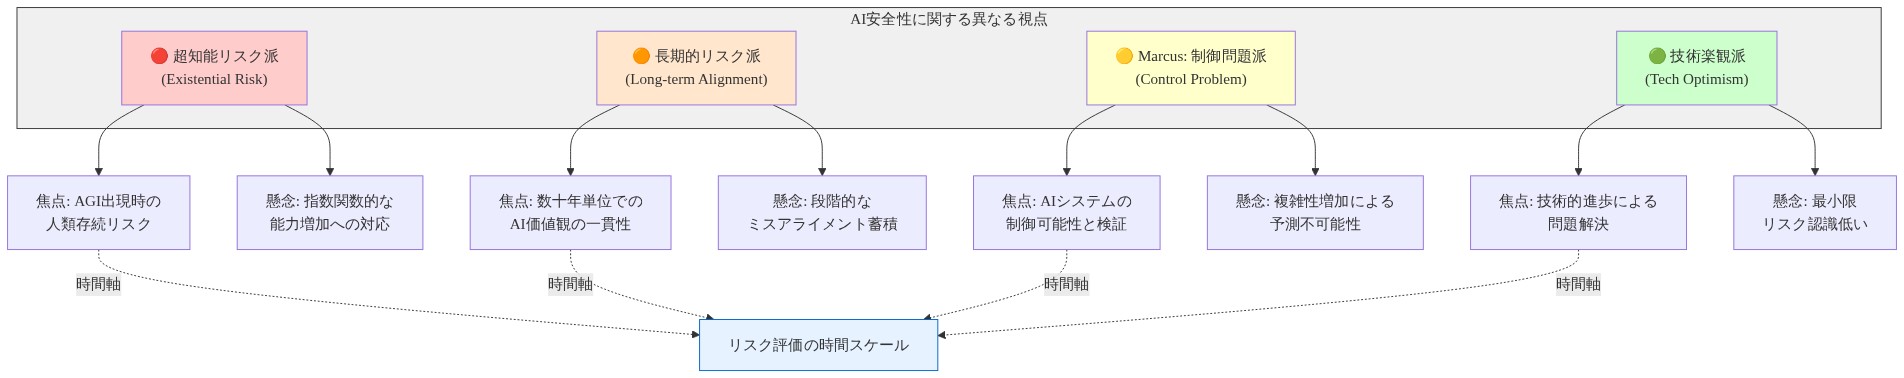
図9:AI安全性議論における異なる視点の比較
この違いが大事な理由
議論を今ある失敗に置くと、実際的な利点がある。
- 検証できる:幻覚や脱獄は、観察でき、測れ、記録できる。
- 具体的だ:政策の問いが「当てにならないと分かっているシステムによる害を、どんな安全策で減らせるか」になる。
- 予測の論争を避けられる:もっと強力なシステムがいつ来るのか、そもそも来るのか、という予測に左右されない。
マーカス氏の経歴も、受け止められ方に影響している。彼はAI企業を共同で立ち上げた人物だ。抽象的なリスクを外から唱えている人ではない。
分野の内側から、今の慣行は業界自身が掲げる基準にも届いていない、と訴えている。そのため、信頼を寄せる聴衆もいる。
一方で、今の手法への懐疑は昔からの技術的な対立の延長だと見る人たちからは、批判も受けている。
十分な安全策には何が要るのか
問題の核心が制御の欠如だとしたら、解決はどんな形になるのだろうか。
マーカス氏は以前から、学習したモデルと、もっと透明でルールにもとづく部品を組み合わせるハイブリッドな方法を推してきた。
純粋な統計的訓練が手放してしまう「中身を点検できること」を、ある程度取り戻すという考え方だ。ただ、設計を良くするだけでは答えの半分にすぎない。残りの半分は、制度の側にある。
彼の議論が指す安全策は、ほかの重大な分野ではすでに当たり前になっている。
| 安全策 | AIでは何を意味するか | ほかの分野での例 |
|---|---|---|
| 公開前の独立した評価 | 結果に金銭的な利害のない研究者によるテスト | 薬の承認前に、規制当局が審査する臨床試験 |
| 事故報告の義務化 | パターンを見つけられるだけの詳しい失敗の報告 | 航空の事故報告制度 |
| 外部監査のアクセス | 資格のある監査人が、公開の前後にシステムを試せる | 財務監査、安全検査 |
| 予見できた失敗への賠償責任 | 既知のリスクが害を生んだとき、開発者がコストを負う | 製造物責任法 |
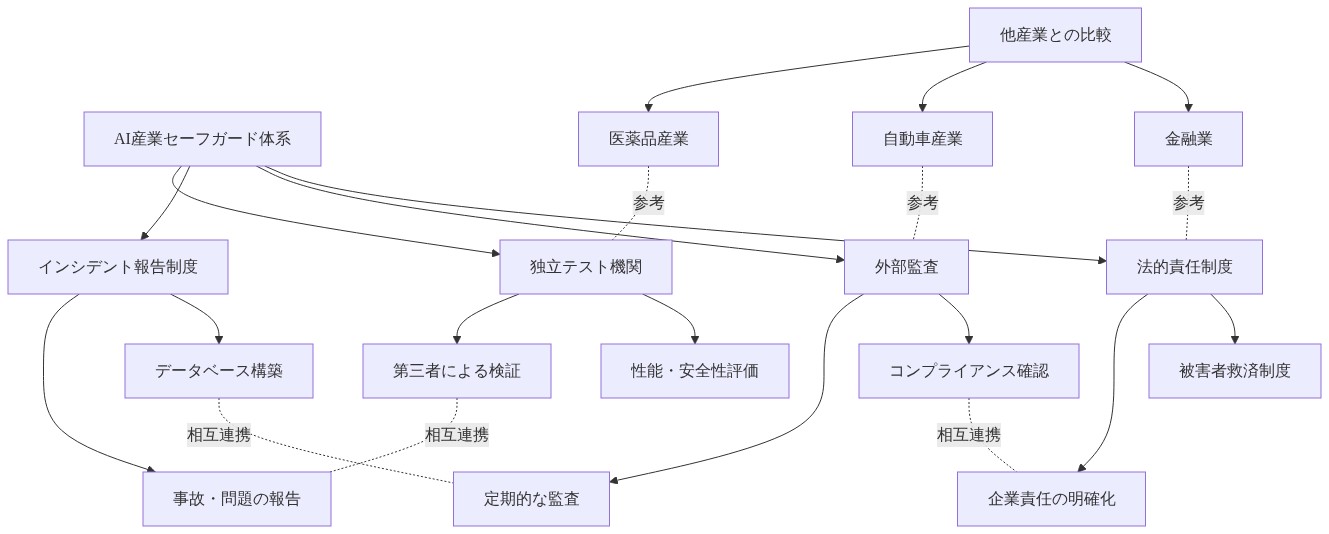
図11:AI産業に必要なセーフガード体系の提案と他産業との比較
難しさと引き換えにするもの
これらの提案は、新しいものではない。AIに当てはめるのが難しいのには、もっともな理由がある。
- テストが難しい:自由な入力に答えるモデルは、新しい場面で予測できない動きをする。航空機の部品のように、すべてを試し尽くすことはできない。
- 監督が展開を遅らせうる:審査には時間がかかり、役に立つ用途の一部は、それだけ遅れて届く。
- 規則が既存の大企業を守りかねない:遵守のコストは、新興企業より大企業のほうが負担しやすい。
マーカス氏の答えは、難しいことと不可能なことは違う、というものだ。テストしにくいシステムほど、より慎重さが要る。その代わりに、社内のプロセスが害の出る前に問題を見つけてくれると期待するしかなくなる。
モデルを見送った件は、そうしたプロセスがときに働くことを示している。同時に、働いたかどうかを確かめる独立した手段が、一般の人にはないことも示している。
ちょっと立ち止まって
AIシステムを展開している企業は、すでに十分にテストを済ませ、限界も把握している。そう思っていないだろうか。マーカス氏の議論は、その思い込みに疑問を投げかける。
自分に問いかけてみてほしい。医療の質問、法律の解釈、お金の判断のように、結果が重いことにAIを使うとき、どんな証拠があれば「この用途に使えるほど信頼できる」と思えるだろうか。
そして、その証拠は、どこで手に入るのだろうか。
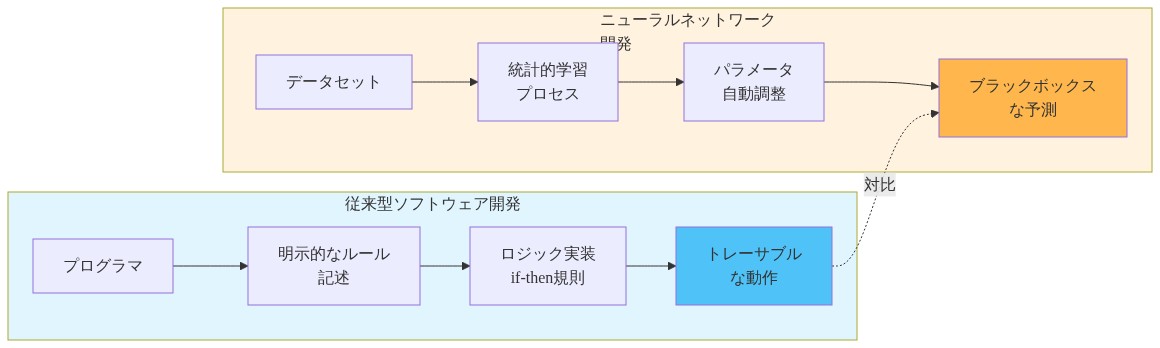
図2:従来型ソフトウェアとニューラルネットワークの開発プロセスの違い
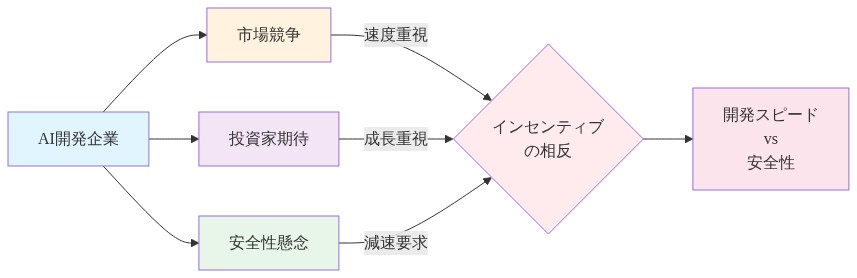
図7:AI開発企業が直面する相反するインセンティブ構造