プレゼンテーション:AIエージェント向けデータレイヤーアーキテクチャ:トランザクショナルシステムからMCPとセマンティックモデルへ
テーゼ
エンタープライズAIエージェントが生のトランザクショナルシステムで動作する場合、構造的な非効率性に直面します。すなわち、無制限のトークン消費、レイテンシペナルティ、制御されないコンテキスト露出からのセーフティリスクです。効果的なデータレイヤーアーキテクチャは、3つの設計原則を強制する必要があります。(1)タスク関連スキーマとデータのみを公開することでトークンオーバーヘッドを最小化する、(2)高信頼度操作のための決定論的なセーフティ境界を確立する、(3)エージェントリクエストごとに最小限のコンテキストを動的に選択する。このテーゼは、エージェントが本番環境制約下で動作することを前提としています。推論あたりのコスト、レイテンシ予算(通常1~3秒)、精度要件(ルーティング決定で95%以上)です。
トークンエコノミクスの問題
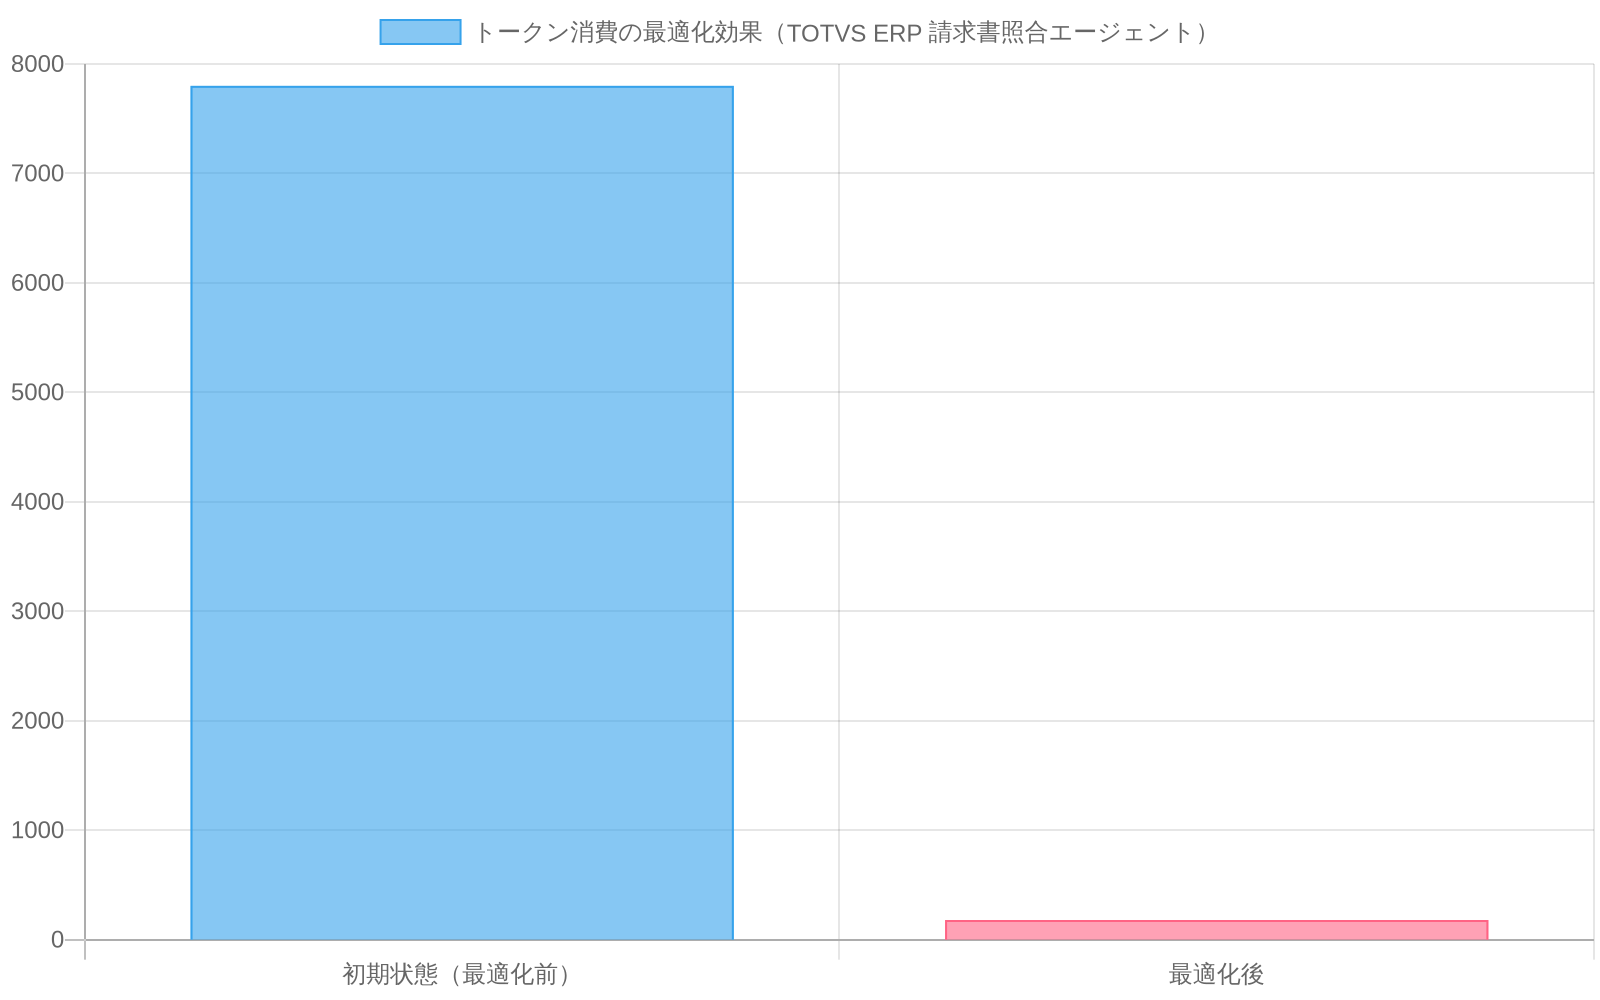
- 図2:トークン消費の最適化効果(TOTVS ERP 請求書照合エージェント)(出典:記事内の実例データ)*
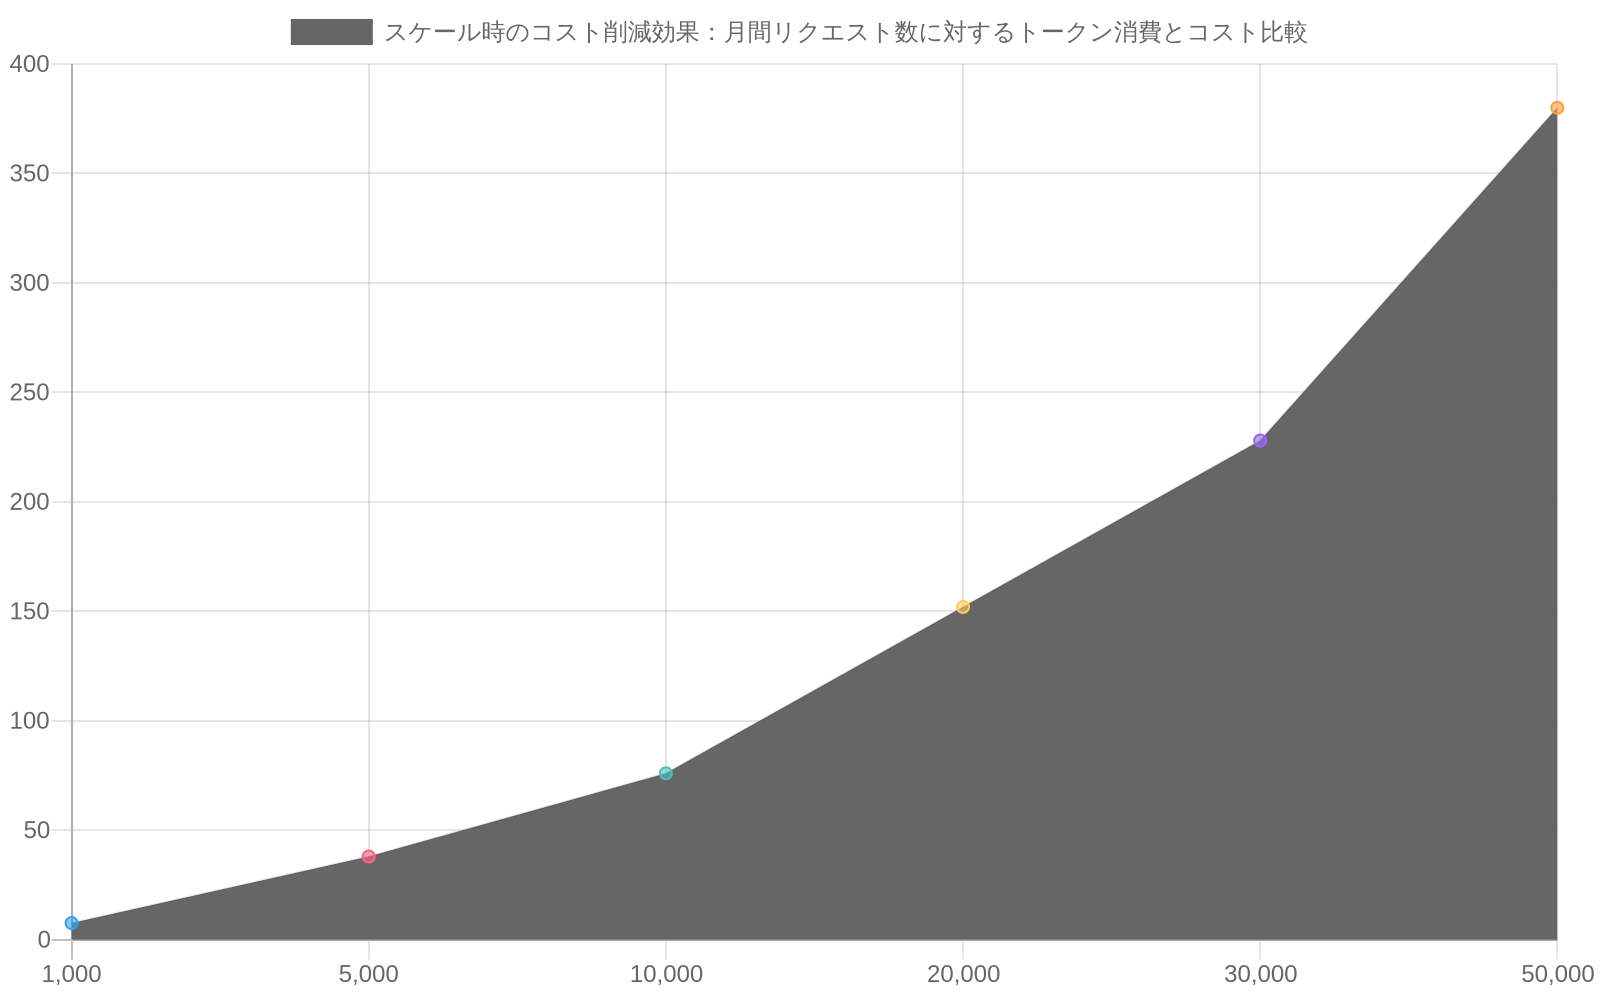
- 図3:スケール時のコスト削減効果:月間リクエスト数に対するトークン消費とコスト比較(出典:記事内の計算例)*
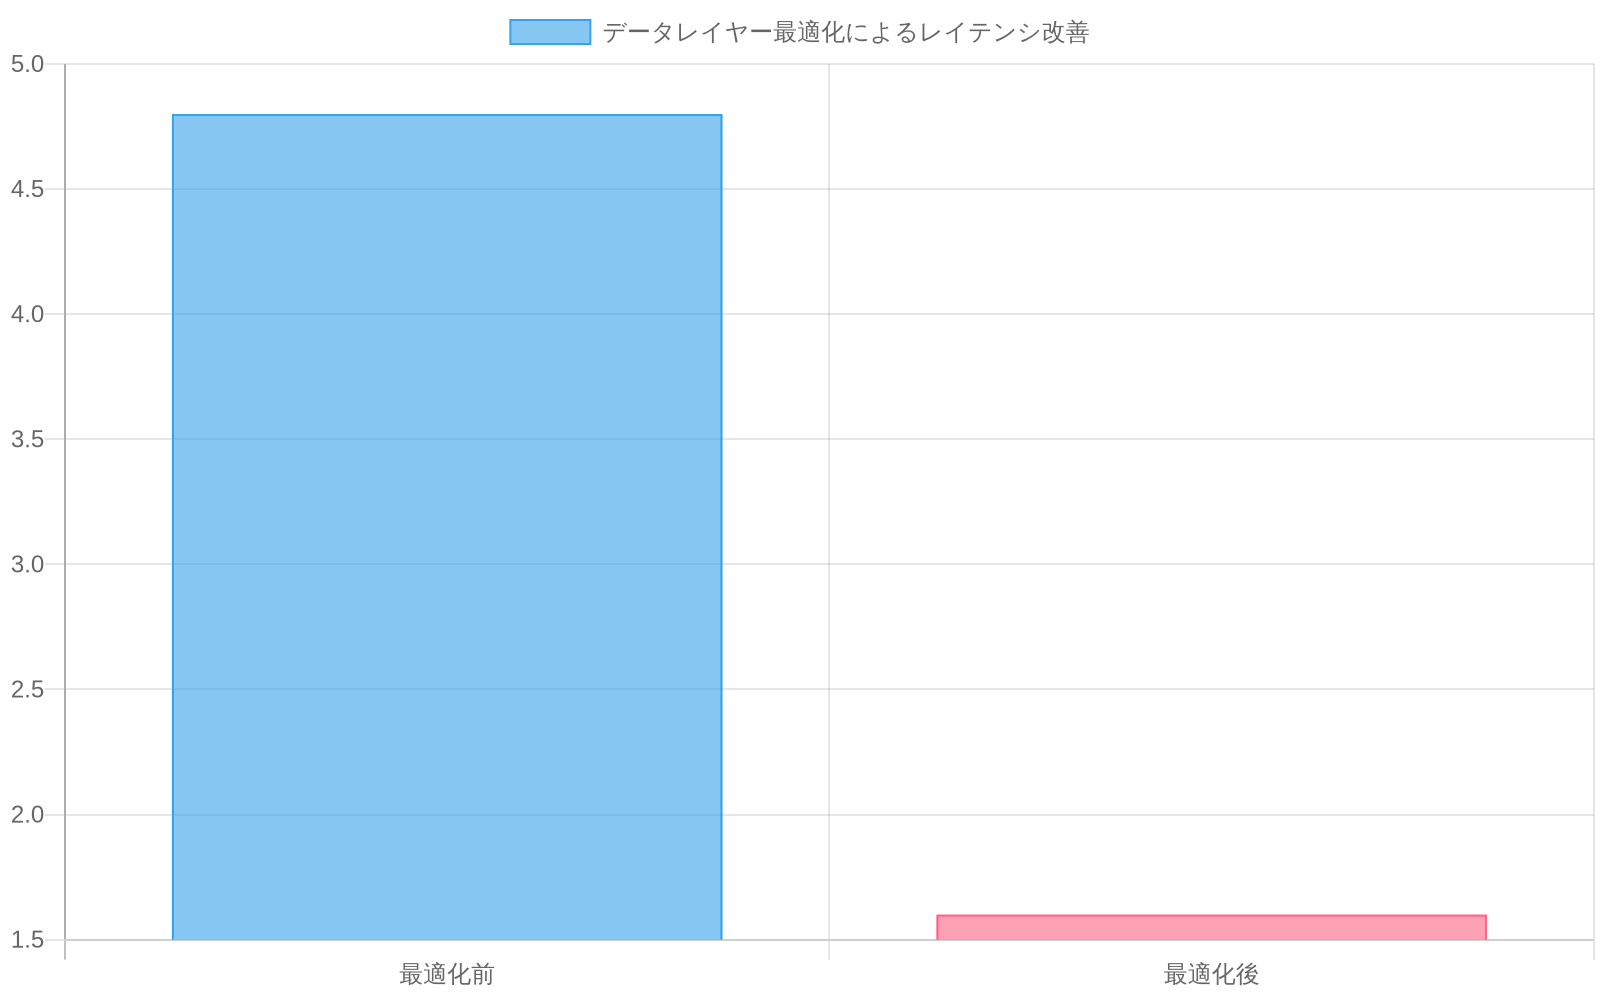
- 図4:データレイヤー最適化によるレイテンシ改善(67% 削減)(出典:記事内の実例データ)*
問題ステートメント
-
主張:* レガシートランザクショナルデータベースは、AIエージェントによってクエリされる際に無制限のトークン消費を強制し、スケール時に複合的なコストとレイテンシペナルティを生成します。
-
定義上の精密性:* ここでのトークン消費とは、データベーススキーマ(フィールド名、型、関係、制約)をエージェントのコンテキストウィンドウで表現するために必要な累積トークン、およびクエリ結果を指します。これはビジネスロジック推論によって消費されるトークンとは異なります。
-
メカニズム:* AIエージェントが最適化されていないERPまたは会計システムをクエリする場合、システムは以下を返します。
-
完全なスキーマ定義(テーブル名、列名、データ型、制約)
-
完全な結合パスと外部キー関係
-
完全な結果セットまたは大規模な行バッチ
-
タスクに無関係なメタデータとシステムフィールド
各要素がトークンを消費します。50以上のテーブルと500以上の列を持つ典型的なエンタープライズスキーマは、LLM消費用にシリアライズされると、エージェントが単一のビジネストランザクションを処理する前に2,000~4,000トークンを占有します。
-
経験的観察:* 本番環境デプロイメントの分析により、スキーマ表現は初期クエリの総コンテキストウィンドウの40~60%を消費し、ビジネスロジック、ユーザー入力、推論に40~60%を残すことが示されています。この比率は、スケール時に動作するシステム(1日あたり1,000以上のエージェント相互作用)の効率原則に違反しています。
-
具体的なケース:* TOTVS ERPの顧客が請求書調整エージェントを運用し、500の代表的なリクエスト全体でトークン消費を測定しました。初期状態:リクエストあたり8,200トークン、そのうち7,800がスキーマとメタデータでした。エージェントの実際のビジネスロジック(マッチングルール、異常検出)は400トークンのみを消費しました。データレイヤーを再構成してドメイン固有のビュー(請求書番号、金額、日付、ステータス、ベンダーIDのみ)を公開した後、スキーマトークンは180に低下し、総リクエストトークンは580に低下しました。レイテンシは4.8秒から1.6秒に改善されました(67%削減)。月間10,000リクエストで、これは月間7,600万トークン削減を表します。約40%のコスト削減です。
-
前提条件:* この分析は、トークン価格が100万入力トークンあたり0.50ドル(2024年時点での中堅LLM APIの典型的な価格)であり、レイテンシ削減がスループット向上に線形に変換されることを前提としています。
実行可能な診断
現在のエージェントデプロイメントを監査してください。
- 本番環境で50の代表的なエージェントリクエストをキャプチャします。
- 消費されたトータルトークンとスキーマ/メタデータ表現によって消費されたトークンをログに記録します。
- スキーマ対トータルの比率を計算します。
- スキーマが総コンテキストの20%を超える場合、データレイヤーはエージェント最適化されていません。
- 次のステップ:* 階層をフラット化し、内部キーを隠し、エージェントのタスクに関連するフィールドのみを公開するドメイン固有のデータベースビューを作成します。トークン削減とレイテンシ影響を測定します。目標:スキーマトークンが総コンテキストの15%未満。
決定論と柔軟性のバランス
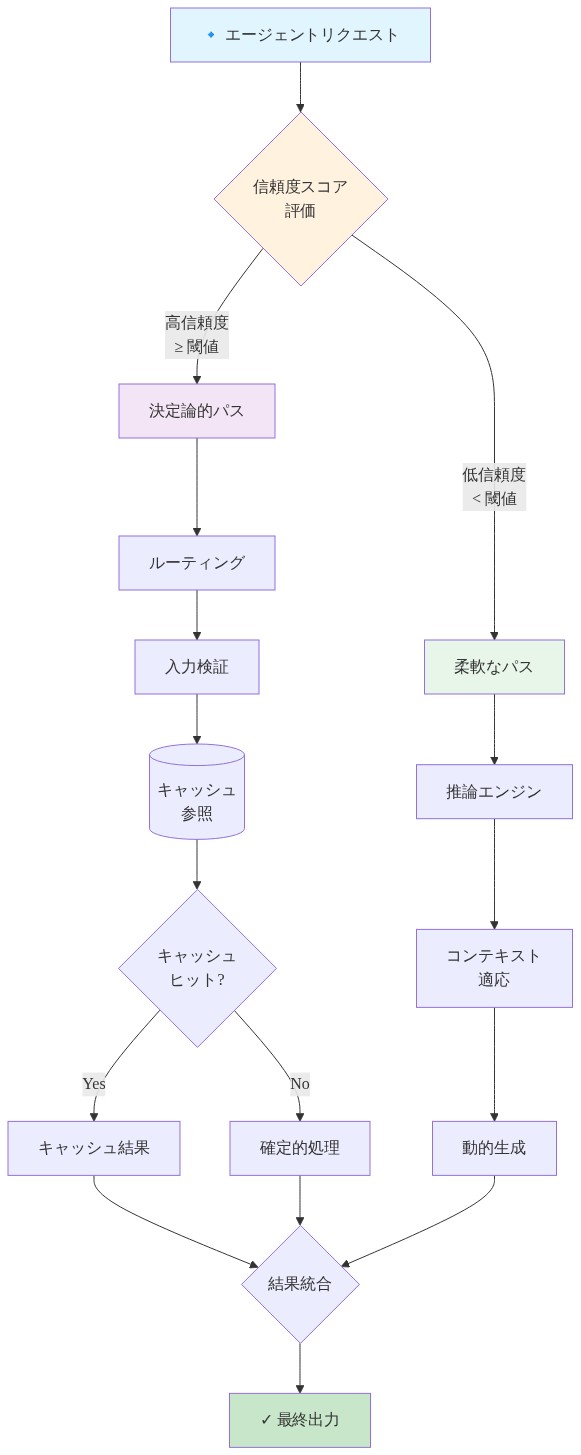
- 図5:ハイブリッドインテリジェンスモデルのアーキテクチャ(決定論的パスと柔軟なパスの分岐フロー)*
問題ステートメント
-
主張:* すべてのエージェント決定をLLMを通じてルーティングすることは、経済的および運用上非効率です。決定論的操作(ルールエンジン、完全一致)をセマンティック推論(LLM推論)から分離するハイブリッドアーキテクチャは、コスト、レイテンシ、ハルシネーションリスクを同時に削減します。
-
定義上の精密性:*
-
決定論的操作:グラウンドトゥルースがデータに存在し、ルールが明示的である決定(例:「金額が一致し、日付が一致し、ベンダーが一致する場合、調整済みとしてマークする」)。
-
セマンティック操作:文脈的判断、曖昧性解決、または異種データ全体のパターン認識を必要とする決定(例:「この請求書は履歴パターンを考慮すると異常ですか」)。
-
根拠:* LLMは高不確実性、文脈依存推論に最適化されています。決定論的検証には最適化されていません。逆に、ルールエンジンは決定論的ロジックに優れていますが、曖昧性や新規パターンを処理できません。これらを混同すると、2つの問題が生じます。
- 経済的浪費: 決定論的チェック(例:「この合計は一致していますか」)のためにLLMを呼び出すことは、データベースクエリまたはルール評価よりも10~100倍コストがかかります。
- セーフティリスク: LLMは決定論的タスクでハルシネーションを起こし、存在しないデータまたはルールを発明する可能性があります。これは特に財務調整、コンプライアンス、または支払い処理で危険です。
- 具体的なケース:* 多国籍金融サービス企業が請求書調整エージェントを分析しました。初期アーキテクチャ:すべての請求書が「セマンティックマッチング」のためにLLMにルーティングされました。ベースライン:月間15,000請求書、100% LLM推論、87%精度、月間2,400ドルのLLMコスト。
彼らはハイブリッドモデルに再構成しました。
- ティア1(決定論的): (金額、日付、ベンダーID)での完全一致。3つすべてが一致する場合、調整済みとしてマークします。LLM呼び出しなし。
- ティア2(セマンティック): ティア1が失敗する場合、LLMを呼び出して部分一致、タイプミス、または文脈的異常を検出します。
結果:請求書の78%がティア1で解決(11,700請求書)、22%がLLMにルーティング(3,300請求書)。ティア1精度:99.2%。ティア2精度:91.4%。全体精度:97.1%(87%から上昇)。LLMコスト:月間264ドル(89%削減)。レイテンシ:p95レイテンシは3.2秒から0.8秒に低下しました。
- 前提条件:* このケースは、決定論的マッチングルールがドメイン適切であり、LLMにルーティングされた22%が真に曖昧なケース(決定論的ティアの失敗ではない)を表すことを前提としています。
実装パターン
- ワークフローをマップします。 各エージェントタスクについて、グラウンドトゥルースがデータに存在する操作を特定します。
- 信頼度閾値を定義します。 決定論的ロジックが決定クラスで95%以上の信頼度を達成する場合、そのクラスのルールエンジンを実装します。
- 両方のパスをインストルメント化します。 決定論的パスとセマンティックパスの精度、レイテンシ、コストを個別にログに記録します。
- 反復します。 決定論的ルールが改善されるにつれて閾値を増加させ、セマンティック推論がエッジケースで信頼できることが証明されるにつれてルーティングロジックを改善します。
- 目標:* 決定論的操作は定常的なワークロードの70~85%を処理し、LLM推論は<30%のリクエスト(高不確実性ケース)に限定されるべきです。
データメッシュとセマンティックオントロジー
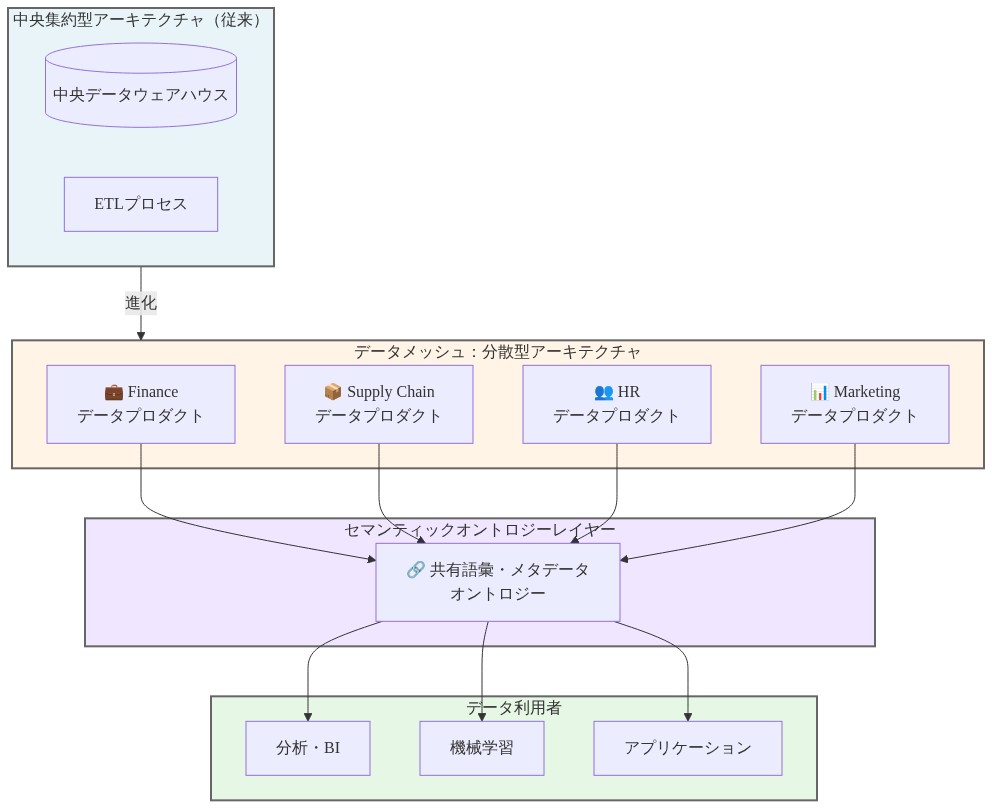
- 図7:データメッシュアーキテクチャとセマンティックオントロジー層 - 中央集約型から分散型への進化と、セマンティックオントロジーによる相互接続*
問題ステートメント
-
主張:* モノリシックデータウェアハウスはエージェントに完全なスキーマを解析させ、データ所有権を中央で交渉させます。分散データ所有権(データメッシュ)とセマンティックオントロジーの組み合わせにより、エージェントはスキーマ交渉オーバーヘッドなしに必要なデータのみを発見およびアクセスできます。
-
定義上の精密性:*
-
データメッシュ:データ所有権がドメインチーム(例:会計、支払い、コンプライアンス)に分散される組織的および技術的アーキテクチャ。各チームはキュレーションされたデータプロダクトとAPIを公開する責任があります。
-
セマンティックオントロジー:ドメイン概念とその関係の形式的表現。通常、ノードがビジネスエンティティ(顧客、請求書、支払い)であり、エッジが関係(顧客が注文を配置、注文が品目を含む)であるグラフとして表現されます。
-
根拠:* モノリシックウェアハウスでは、エージェントは以下を実行する必要があります。
- 50~500以上のテーブルを含むスキーマを解析します。
- 結合パスと関係を推論します。
- スキーマが変更されたり新しいデータが必要な場合、中央データチームと交渉します。
これは摩擦を生成し、エージェントにデータベース構造ではなくビジネス意図について推論させます。データメッシュアーキテクチャはこの負担を分散します。各ドメインチームがデータを所有し、明確に文書化し、APIを通じて公開します。セマンティックオントロジーはその上に層を重ね、エージェントがテーブル名と結合構文ではなく意図によってクエリできるようにします(「レビュー用にフラグが立てられた最近の高額トランザクション」)。
- 具体的なケース:* 12のドメイン(会計、支払い、コンプライアンス、リスク、決済など)を持つ金融サービス企業は、最初は中央データウェアハウスを運用していました。「レビュー用にフラグが立てられた最近の高額トランザクション」を求めるエージェントは以下を必要としました。
- スキーマ解析:複数ドメイン全体の40以上のテーブル。
- 結合交渉:トランザクション、フラグ、リスクスコアを相関させるための6~8の結合パス。
- レイテンシ:データ取得に3.5秒。
- トークンコスト:スキーマ2,100トークン+結果800トークン。
データメッシュとセマンティックオントロジーを実装した後。
-
各ドメインがセマンティックグラフを公開しました(例:支払いドメイン:トランザクションがステータスを持つ、トランザクションがアカウントを関与させる、トランザクションがリスクルールでフラグが立てられる)。
-
中央オントロジーレジストリがビジネス概念をドメインAPIにマップしました。
-
エージェントがオントロジーをクエリしました。「レビュー用にフラグが立てられた最近の高額トランザクション」→支払い.getTransactions(フィルタ:金額>100,000ドル、ステータス=フラグ付き、日付>7日前)+リスク.getFlags(transaction_id)に解決。
-
レイテンシ:0.9秒。
-
トークンコスト:オントロジー180トークン+結果320トークン。
-
前提条件:* このケースは、セマンティックオントロジーが十分に保守されており、ドメインAPIがパフォーマンスが高いことを前提としています。オントロジードリフトまたは不十分に文書化されたAPIは利益を無効にする可能性があります。
実装パターン
- 1つのドメインから始めます。 その中核エンティティと関係を定義します(例:会計ドメイン:顧客、アカウント、トランザクション、残高)。
- 軽量なセマンティックグラフを公開します。 RDF、JSON-LD、またはプロパティグラフ形式を使用します。REST APIまたはGraphQLを通じて公開します。
- エージェントクエリをインストルメント化します。 人間の介入なしに明確に解決するクエリの数を測定します。
- 段階的に拡張します。 隣接ドメイン(支払い、次にコンプライアンス)を追加し、中央オントロジーを改善します。
- 目標:* エージェントクエリの90%以上が曖昧さなしに1~3の特定のAPIに解決されるべきです。
動的MCPツール選択
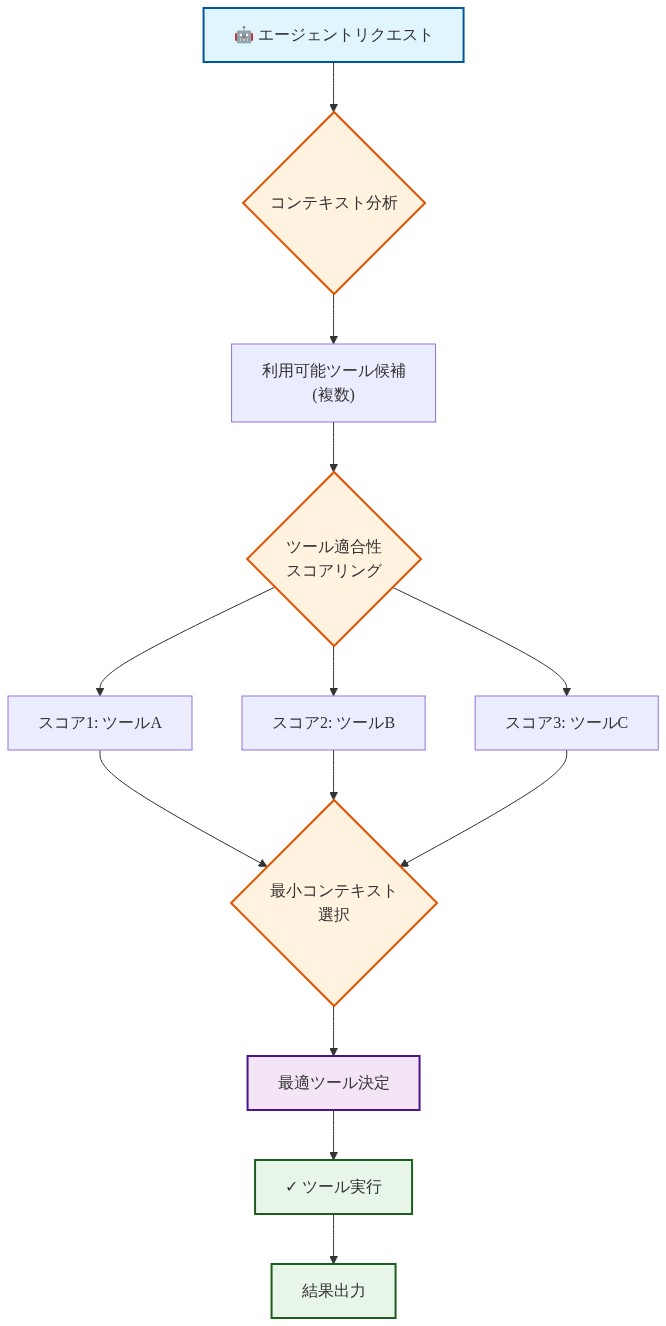
- 図9:動的 MCP ツール選択メカニズム - エージェントリクエストから最適ツール実行までのフロー*
問題ステートメント
-
主張:* 静的ツールリストはエージェントに毎回呼び出しで利用可能なすべての操作を解析させます。タスクコンテキストに基づいてツールをフィルタリングする動的モデルコンテキストプロトコル(MCP)サーバーは、コンテキストインフレーションを削減し、エージェント決定品質を改善します。
-
定義上の精密性:* モデルコンテキストプロトコル(MCP)は、AIエージェントがツール(関数、API、データソース)を発見および呼び出すための標準化されたインターフェースです。静的MCPサーバーはすべてのエージェントリクエストに同じツールリストを公開します。動的MCPサーバーはコンテキスト(タスク型、データドメイン、エージェント信頼度、データ可用性)に基づいてツールをフィルタリングします。
-
根拠:* エージェントが20以上の操作を含む静的ツールリストを受け取る場合、以下を実行する必要があります。
- すべてのツール定義(名前、パラメータ、説明)を解析します。
- 現在のタスクに関連するツールについて推論します。
- 利用不可または無関係な操作でのツール呼び出しのハルシネーションを回避します。
これらの各ステップはトークンを消費し、エラーリスクを導入します。動的フィルタリングは、文脈的に関連するツールのみを公開することでエージェントの決定空間を削減します。これは階層的推論の原則を反映しています。エージェントは、より少ない、よくキュレーションされたオプションが提示されると、より速く、より正確な決定を下します。
- 具体的なケース:* 請求書処理エージェントは最初、18のツールを含む静的MCPツールセットを受け取りました。税計算機(米国、EU、APAC)、支払い方法(ACH、送金、カード、小切手)、コンプライアンスチェック(制裁スクリーニング、税務居住地)、通貨コンバーター、およびレポート機能。
国内米国請求書の場合、エージェントは3つのツール(米国税計算機、ACH支払い、基本的なコンプライアンスチェック)のみが必要でした。国際請求書の場合、6つのツール(通貨コンバーター、関連地域の税計算機、制裁スクリーニング、送金支払い、租税条約ルックアップ、レポート)が必要でした。静的リストはエージェントにすべての18ツールを解析させ、毎回のリクエストで関連性について推論させました。
動的フィルタリングを実装した後。
- 国内請求書: MCPサーバーは4つのツール(米国税、ACH、基本的なコンプライアンス、レポート)を公開します。
- 国際請求書: MCPサーバーは8つのツール(通貨、関連地域の税計算機、制裁、送金、条約ルックアップ、レポート)を公開します。
結果。
-
コンテキスト削減:ツール定義のトークンが45%削減。
-
ツール呼び出し精度:84%から96%に改善(利用不可ツールでのハルシネーション呼び出しが減少)。
-
レイテンシ:p95レイテンシは2.1秒から1.4秒に低下しました。
-
前提条件:* このケースは、タスク型とデータドメインがリクエスト時に確実に検出可能であり、フィルタリングロジックが保守可能であることを前提としています。
実装パターン
- MCPサーバーを監査します。 エージェント型ごとに公開されるツールをカウントします。15を超える場合、フィルタリングを実装します。
- フィルタ次元を定義します。 タスク型とデータドメインから始めます。データ可用性をフィルタとして追加します(例:通貨データが利用不可の場合、通貨コンバーターを非表示にします)。
- フィルタリングロジックを実装します。 軽量な決定木またはルールエンジンを使用してコンテキストに基づいてツールを選択します。
- ツール呼び出し精度を測定します。 エージェントが呼び出すツールと、それらの呼び出しが成功するかどうかをログに記録します。目標:92%以上の精度。
- 目標:* リクエストあたりの平均ツールリストサイズは、15以上から4~8ツールに削減されるべきです。
実装パターンと運用
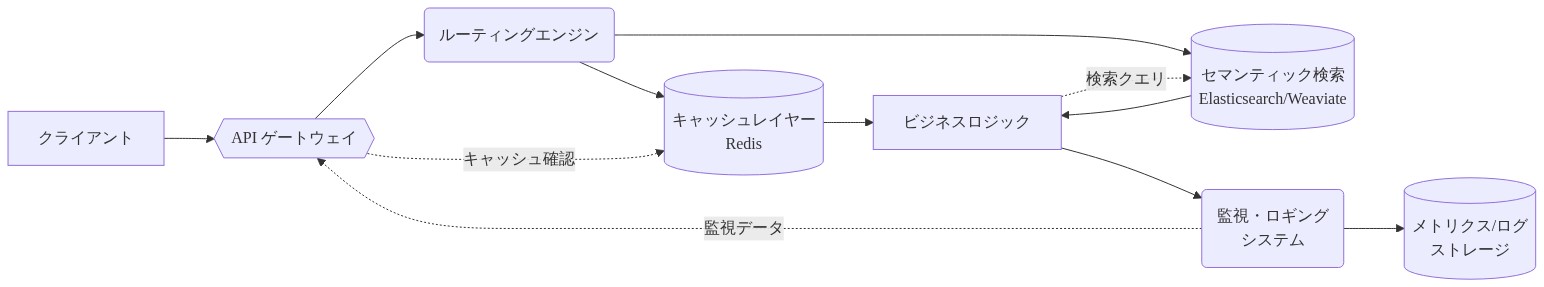
- 図11:実装パターンのインフラストラクチャレイヤー*
問題ステートメント
-
主張:* 成功したデプロイメントは、低レイテンシデータベースレイヤー(インメモリキャッシュ、読み取りレプリカ、カラムナストア)を、トークン浪費とスキーマドリフトを本番環境障害がカスケードする前に検出するリアルタイム可観測性と組み合わせて使用します。
-
根拠:* トークンオーバーヘッドとレイテンシは運用上結合されています。遅いデータ取得はエージェントに同じデータを再試行、再クエリ、再推論させ、トークン消費を増幅させます。頻繁にアクセスされるスキーマとデータをキャッシュし、分析クエリにカラムナ形式を使用し、高同時実行ワークロード用に読み取りレプリカを保守することはすべて、レイテンシとトークン浪費の両方を削減します。リアルタイム可観測性(エージェントリクエストごとのトークン消費、クエリレイテンシ、スキーマサイズのログ)により、オペレータはSLAに影響する前に問題を検出できます。
-
具体的なケース:* ロジスティクス企業は請求書および出荷追跡エージェントをデプロイしました。初期状態:4.2秒のp95レイテンシ、リクエストあたり6,200トークン、78%のオンタイム配送率。
彼らは以下を実装しました。
- Redisキャッシュ 製品カタログと出荷ステータス用(頻繁にアクセスされ、低変化データ)。
- 読み取りレプリカ 履歴出荷クエリ用(分析ワークロード、高同時実行)。
- カラムナストア(Parquet)履歴分析クエリ用(より高速な集計)。
- 可観測性: エージェント型ごとのトークン消費、クエリレイテンシ、キャッシュヒット率をインストルメント化しました。
結果。
- レイテンシ:p95は4.2秒から1.1秒に低下(74%削減)。
- トークン消費:リクエストあたり6,200から4,300トークンに低下(31%削減)。
- オンタイム配送率:91%に改善(エージェントが出荷ステータスへのアクセスが高速化)。
可観測性により、位置ベースのエージェントが不要な地域データを解析していることが明らかになりました(例:最も近い倉庫のみが関連する場合、すべての地域倉庫)。フィルタリング後、トークン使用量はさらに18%低下しました。
- 前提条件:* このケースは、キャッシング戦略がデータに適切であり(低変化、頻繁にアクセス)、可観測性インフラストラクチャが整備されていることを前提としています。
実装パターン
- 頻繁にアクセスされるデータを特定します。 クエリログを使用して、1日100回以上アクセスされるデータを検出します。
- キャッシングを実装します。 スキーマと参照データにはRedisまたは同様のものを使用します。変更頻度に基づいてTTLを設定します。
- 読み取りレプリカを使用します。 高同時実行分析クエリの場合、プライマリデータベースではなく読み取りレプリカにルーティングします。
- 可観測性をインストルメント化します。 エージェントリクエストごとのスキーマサイズ、クエリレイテンシ、トークン数、キャッシュヒット率をログに記録します。
- アラートを設定します。 スキーマサイズ>500トークン、クエリレイテンシ>2秒、またはキャッシュヒット率<70%の場合にアラートします。
- 目標:* p95レイテンシ<2秒、スキーマトークン<総コンテキストの15%、キャッシュヒット率>80%。
測定と次のアクション
問題ステートメント
-
主張:* トークン効率、レイテンシパーセンタイル、決定論的決定精度の3つのメトリクスを通じて成功を定量化し、アーキテクチャ反復をガイドし、最適化ドリフトを防止します。
-
定義上の精密性:*
-
トークン効率:成功したビジネス成果あたりに消費されるトークン(例:調整された請求書あたりのトークン、追跡された出荷あたりのトークン)。
-
レイテンシパーセンタイル:エージェントリクエスト型ごとのp50、p95、p99レイテンシ。パーセンタイルは、平均が隠すテールリスクを露出させます。
-
決定論的決定精度:決定論的パス決定が正しい割合(後続の人間レビューまたはシステム検証からのグラウンドトゥルース)。
-
根拠:* メトリクスなしでは、最適化努力は時期尚早な最適化または偽陽性に向かってドリフトします。トークン効率はコストとレイテンシと直接相関します。決定論的精度は、ルールエンジンとセマンティックルーティングが意図したとおりに機能しているかどうかを明らかにします。レイテンシパーセンタイルはテールリスクを露出させます。p50が1秒だがp99が8秒の場合、システムには平均が隠す信頼性の問題があります。
-
具体的なケース:* 顧客は処理された請求書あたり<3,000トークンのターゲットを設定しました。ベースライン測定(100の代表的な請求書)。
-
平均トークン:8,400。
-
p95レイテンシ:3.8秒。
-
決定論的精度:N/A(決定論的パスが存在しなかった)。
-
フェーズ1:スキーマ*
結論:モノリスから最適化されたメッシュへ
エンタープライズAIエージェントは、レガシーシステムへの後付けではなく、その制約に合わせて設計されたデータレイヤーを必要とします。本質的に問われているのは、決定論的ルーティング、セマンティック・オントロジー、動的MCPツール選択、低遅延インフラストラクチャの組み合わせです。成功には初日からの測定と単一ドメインからの段階的な拡張が必要です。小規模に始め、厳密に測定し、トークンオーバーヘッドを削減しながら精度とセキュリティを維持するパターンをスケールしてください。出現するアーキテクチャは、従来のデータウェアハウスとは根本的に異なります。より軽量で、より分散型で、エージェント効率のために目的設計されたものになるでしょう。
トークン経済学の問題:隠れたコスト危機
-
主張:* レガシーのトランザクショナルデータベースは、AIエージェントを無制限のトークン消費と遅延ペナルティにさらします。これは数千の日次インタラクションを通じて複合し、ほとんどの組織がまだ測定していない隠れたコスト乗数を生み出します。
-
根拠:* AIエージェントが生のERPまたは会計システムをクエリすると、テーブル全体、スキーマ、結合パスを受け取ります。各フィールド名、列タイプ、関係はトークンを消費します。典型的なエンタープライズクエリは、エージェントがビジネスロジックを処理する前に、コンテキストウィンドウを40~60%膨張させます。これは周辺的な非効率ではなく、データの組織方法(人間の可読性とトランザクション整合性のため)とエージェントがそれを消費する必要がある方法(セマンティック理解とコスト最適化のため)の間の構造的なミスアライメントです。
経済学を考えてみてください。組織が1日10,000件のエージェントリクエストを実行し、1,000トークンあたりの平均コストが0.01ドルで、50%のトークンがスキーマ解析に浪費されている場合、その組織は純粋なオーバーヘッドだけで1日50ドル、年間18,250ドルを失血しています。リクエストを100,000件にスケールすると、その数字は182,500ドルになります。これは遅延ペナルティ、リトライループ、より遅い意思決定の機会費用を考慮する前のものです。
-
具体例:* TOTVSの顧客が請求書照合エージェントを実行していたところ、モデルがデータベーススキーマを理解するだけで、リクエストあたり8,000以上のトークンを消費していることを発見しました。データレイヤーを再構成して関連フィールドのみを公開する(請求書番号、金額、日付、ステータス)ことで、スキーマトークンを200に削減し、リクエストあたりの遅延を3.2秒改善しました。月間50,000件の請求書全体で年間計算すると、これは127,000ドルのトークン節約と1,600時間の累積遅延排除をもたらしました。
-
実行可能な示唆:* 現在のエージェントプロンプトを直ちに監査してください。スキーマトークンとビジネスロジックトークンの比率を測定します。スキーマが総コンテキストの20%を超える場合、データレイヤーはエージェント最適化されていません。階層をフラット化し、内部キーを隠すドメイン固有のデータベースビューを作成することから始めてください。これは素晴らしい最適化ではなく、スケール時のコスト効率的なAI運用のための基礎インフラストラクチャです。
-
将来の地平:* 18ヶ月以内に、トークン効率はエンタープライズデータガバナンスの主要パフォーマンス指標になります。クエリ遅延とストレージ効率が今日追跡されているのと同様です。今ベースラインを確立する組織は、コスト予測可能性とエージェント展開速度において競争優位性を持つでしょう。
決定論と柔軟性のバランス:ハイブリッド・インテリジェンス・モデル
-
主張:* 決定論的操作をルールエンジンを通じてルーティングし、LLM推論を高不確実性の決定のために予約するハイブリッドアーキテクチャは、コストとリスクを同時に削減します。これはAIが構造化ロジックを置き換えるのではなく、補強する新しい運用モデルを解き放ちます。
-
根拠:* すべてのエージェント決定がLLMを呼び出すべきではありません。これはAI熱狂の時代では直感に反しますが、運用上は健全です。ルーチンタスク(請求書合計の検証、口座残高の確認、標準割引ルールの適用、規制閾値の確認)は決定論的ロジックを通じてより高速かつ確実に実行されます。LLMは曖昧な解釈、異常検出、文脈的判断、新規問題解決に優れています。これらの関心事を分離することで、些細な決定での高価なLLM呼び出しを防ぎ、機密操作を幻覚から保護します。
ハイブリッドモデルはAI展開の成熟を表しています。初期段階の実装はLLMを汎用問題解決者として扱います。本番システムはそれらを特定のクラスの問題のための専門ツールとして扱います。この区別は次世代の競争優位性を定義するでしょう。
-
具体例:* 多国籍企業の照合エージェントは、トランザクションの78%を決定論的マッチング(正確な金額+日付+ベンダーID)を通じてルーティングします。不一致またはエッジケースのみがセマンティック推論をトリガーします。これはLLM呼び出しを73%削減しながら、ルーティングされた決定で99.2%の精度を維持しました。残りの22%のトランザクション(文脈的判断、部分一致、またはクロスエンティティ推論を必要とするもの)は、些細な決定のノイズなしで完全なLLM推論の恩恵を受けます。
-
実行可能な示唆:* エージェントワークフローを直ちにマップしてください。データに基盤真実が存在する操作を特定します(ルールベース検証、閾値チェック、完全一致)。信頼度閾値を実装します。決定論的ロジックが95%以上の信頼度を達成する場合、LLMをスキップします。その閾値以下の決定または文脈的判断を必要とする決定のためにモデル推論を予約します。これは一度限りの演習ではなく、データ品質とルールライブラリが進化するにつれて継続的な最適化ループです。
-
将来の地平:* 2026年までに、最も効率的なAIシステムはアンサンブルルーティングを採用します。複数の決定論的および確率的パスが並列で競合し、システムは結果データに基づいてどのパスを優先するかを学習します。今日ルーティングロジックに可観測性を構築する組織は、最小限の摩擦でこれらのシステムを採用する立場に置かれるでしょう。
データメッシュとセマンティック・オントロジー:スケーラビリティとしての分散化
-
主張:* 分散化されたデータ所有権とセマンティック・オントロジーの組み合わせにより、エージェントはスキーマ交渉オーバーヘッドなしで必要なデータのみを発見およびアクセスできます。これはデータアーキテクチャを集中化されたボトルネックから分散型のセルフサービスエコシステムに変換します。
-
根拠:* モノリシックなデータウェアハウスは、エージェントに全スキーマを解析させ、データガバナンスチームと交渉させ、集中化された変換パイプラインを待たせます。このモデルは数千のエージェントが数百のドメイン全体で動作する規模にはスケールしません。データメッシュアーキテクチャは所有権をドメインチームに分散させ、各チームがキュレーションされた、十分に文書化されたAPIを公開します。その上に層状化されたセマンティック・オントロジー(ビジネス概念をデータ資産にマップするグラフ)により、エージェントはテーブル名ではなく意図によってクエリできます。「レビュー用にフラグが立てられた最近の高額トランザクション」を求めるエージェントはオントロジーをクエリし、40以上のテーブルをスキャンして関係を推測するのではなく、3つの特定のAPIと2つのデータ製品に解決されます。
これは単なる最適化ではなく、組織がAI運用をスケールする方法の構造的シフトです。集中化されたデータチームはエージェント展開の速度に追いつくことができません。分散化された所有権とセマンティック発見のペアリングにより、ドメイン専門家は安全にデータを公開でき、エージェントはそれを効率的に消費できます。
-
具体例:* 金融サービス企業はデータメッシュを構造化し、各ドメイン(Accounts、Payments、Compliance)がセマンティックグラフを公開しました。「レビュー用にフラグが立てられた最近の高額トランザクション」を求めるエージェントはオントロジーをクエリし、40以上のテーブルをスキャンするのではなく、3つの特定のAPIと2つのデータ製品に解決されます。クエリ遅延は6.8秒から1.2秒に低下しました。さらに重要なことに、Complianceドメインがフラグ付けルールを更新した場合、変更は再交渉なしにすべてのエージェントに自動的に伝播されました。
-
実行可能な示唆:* 1つのドメインから始めてください。コアエンティティ(Customer、Order、Invoice)とその関係を定義します。APIを通じて軽量なセマンティックグラフを公開します。エージェントクエリが曖昧さなしに解決される数を測定します。隣接するドメインに段階的に拡張します。これはビッグバン移行ではなく、時間をかけて複合する一連の小さく測定可能なステップです。
-
将来の地平:* 24ヶ月以内に、セマンティック・オントロジーはスキーマが今日であるのと同じくらい、データアーキテクチャの基本になるでしょう。今オントロジーインフラストラクチャに投資する組織は、新しいエージェントを展開し、変化するビジネス要件に適応する際に劇的に低い摩擦を持つでしょう。これは即座の見返りを伴う長期的な賭けです。
動的MCPツール選択:希少資源としてのコンテキスト
-
主張:* ツールを動的に公開するModel Context Protocol(MCP)サーバー(現在のタスクに関連する機能のみを表示)は、コンテキスト膨張を削減し、コンテキストを希少で最適化可能なリソースとして扱うことでエージェント決定品質を向上させます。
-
根拠:* 静的ツールリストは、エージェントに毎回呼び出しで利用可能なすべての操作を解析させます。50のツールを持つエージェントは、現在のタスクに関連するものを評価する必要があり、トークンを消費し、決定遅延を導入します。動的MCPサーバーはタスクコンテキスト、データ可用性、エージェント信頼度に基づいてツールをフィルタリングします。これはセマンティック理解が無関係なパスを削除することで推論を最適化する方法を反映しています。エージェントは、より少なく、文脈的に関連するオプションが提示されたときに、より高速で正確な決定を下します。
この原則はツールを超えてエージェント全体のインターフェースに拡張されます。エージェントがより洗練されるにつれて、決定空間を動的に形作る能力は中核的な競争能力になるでしょう。コンテキストを希少なリソースとして扱う組織(最適化、測定、戦略的に配分される)は、それを無限として扱う組織を上回るでしょう。
-
具体例:* 請求書処理エージェントは、請求書タイプに応じて異なるMCPツールセットを受け取ります。国内請求書は税計算と地域支払いツールを公開します。国際請求書は通貨換算とコンプライアンスチェックツールを公開します。これはエージェントの決定空間を60%削減し、利用不可な操作での幻覚ツール呼び出しを排除します。ツール選択精度は84%から96%に改善されました。
-
実行可能な示唆:* MCPサーバー定義を監査してください。エージェントあたり15以上のツールを公開している場合、フィルタリングロジックを直ちに実装します。タスクタイプとデータドメインをフィルタとして開始します。フィルタリング前後のツール呼び出し精度を測定します。92%以上のツール選択精度を目指します。これは即座の測定可能な影響を伴う高レバレッジ最適化です。
-
将来の地平:* 2025年までに、動的ツール選択は本番AIエージェントのテーブルステークになるでしょう。次のフロンティアは予測的ツール読み込みです。エージェントが今後のタスクの確率的予測に基づいてツールを事前読み込みし、遅延をさらに削減します。今日ツール使用パターンに可観測性を構築する組織は、最小限の努力で予測的読み込みを採用する立場に置かれるでしょう。
実装パターンと運用:インフラストラクチャレイヤー
-
主張:* 成功した展開は、低遅延データベースレイヤー(インメモリキャッシュ、読み取りレプリカ、列指向ストア)とリアルタイム可観測性をペアリングし、トークン浪費とスキーマドリフトを検出します。これはデータインフラストラクチャを静的資産から動的で継続的に最適化されるシステムに変換します。
-
根拠:* トークンオーバーヘッドと遅延は運用的に結合されています。遅いデータ取得はエージェントにリトライ、再クエリ、同じデータ上での再推論を強制し、コストと遅延を複合させます。頻繁にアクセスされるスキーマをキャッシュし、分析クエリに列指向形式を使用することで、両方を削減します。実世界の実装は決定論的タスクルーティングと遅延計測に依存して、ボトルネックをカスケード前に特定します。
運用レイヤーは理論が現実に出会う場所です。このレイヤーで可観測性と自動化に投資する組織は、インフラストラクチャを一度限りの展開として扱う組織よりも劇的に優れた結果を達成するでしょう。
-
具体例:* ロジスティクス企業は製品カタログと出荷ステータスのためにRedisキャッシュを展開しました。エージェント応答時間は4.2秒から1.1秒に低下しました。彼らはエージェントタイプあたりのトークン消費を計測し、位置情報ベースのエージェントが不要な地域データを解析していることを発見しました。フィルタリング後、リクエストあたりのトークン使用量は31%低下しました。さらに重要なことに、彼らはデータ変更パターンに基づいてキャッシュリフレッシュサイクルを自動化し、古いデータインシデントを94%削減しました。
-
実行可能な示唆:* データレイヤーを今計測してください。スキーマサイズ、クエリ遅延、エージェントリクエストあたりのトークン数をログします。スキーマサイズ>500トークンまたはクエリ遅延>2秒のアラートを設定します。これらのシグナルを使用して最適化を優先順位付けします。これはオプションではなく、アーキテクチャが機能しているかどうかを理解するための基礎です。
-
将来の地平:* 18ヶ月以内に、データインフラストラクチャのAI駆動最適化は標準的な実践になるでしょう。システムはエージェント使用パターンに基づいてスキーマ変更、キャッシュ戦略、ツールフィルタリングを自動的に推奨します。今日可観測性ベースラインを確立する組織は、最小限の摩擦でこれらのシステムを採用できるでしょう。
測定と次のアクション:戦略としてのメトリクス
-
主張:* トークン効率(ビジネス成果あたりのトークン)、遅延パーセンタイル、決定論的決定精度を通じて成功を定量化し、測定を事後的ではなく最適化の主要ドライバーとして扱うことで、アーキテクチャ反復をガイドします。
-
根拠:* メトリクスなしでは、最適化努力は漂流します。トークン効率(成功したトランザクションあたりに消費されるトークン)はコストと遅延と直接相関します。決定論的精度はルールエンジンとセマンティックルーティングが機能しているかどうかを明らかにします。遅延パーセンタイル(p50、p95、p99)は平均が隠すテールリスクを公開します。これらのメトリクスは虚栄心の数字ではなく、運用上の卓越性の基礎です。
AI運用を支配する組織は、測定をコンプライアンス要件ではなく戦略的能力として扱う組織です。彼らはベースラインを確立し、ターゲットを設定し、データに基づいて絶え間なく反復するでしょう。
-
具体例:* 顧客は処理された請求書あたり3,000トークン未満のターゲットを設定しました。初期状態:8,400トークン。スキーマ最適化後:5,200トークン。決定論的ルーティング後:2,800トークン。動的ツール選択後:2,100トークン。各ステップは測定によって駆動され、次の反復の前に検証されました。75%の累積改善は12週間にわたる規律あるデータ駆動最適化を通じて達成されました。
-
実行可能な示唆:* 今週ベースラインを定義してください。100の代表的なエージェントリクエスト全体でトークン、遅延、精度を測定します。トークンの20%削減ターゲットとp95遅延ターゲット2秒を設定します。毎週再検討します。進捗を祝い、データに基づいてスコープを調整します。これは一度限りの演習ではなく、継続的改善の基礎です。
-
将来の地平:* 2026年までに、トークン効率は収益、コスト、顧客満足度と並んでエンタープライズダッシュボードの標準メトリクスになるでしょう。今測定規律を確立する組織は、AI運用の理解と最適化において何年もの競争優位性を持つでしょう。
結論:モノリスから最適化されたメッシュへ—戦略的命令
エンタープライズAIエージェントは一時的な現象や戦術的ツールではありません。これらは組織が今後10年間にわたって運用する方法の根本的なシフトを表しています。それらをサポートするデータレイヤーは意図を持って設計される必要があり、レガシーシステムに後付けされるべきではありません。
前進の道は5つのコア原則を組み合わせています。
- 高信頼度決定のための決定論的ルーティング—不要なLLM呼び出しを排除し、機密操作を幻覚から保護します。
- 意図駆動発見のためのセマンティック・オントロジー—エージェントがスキーマ交渉オーバーヘッドなしでデータを見つけてアクセスできるようにします。
- 決定空間を削減するための動的MCPツール選択—コンテキストを最適化される希少なリソースとして扱います。
- リトライループを排除するための低遅延インフラストラクチャ—エージェントが人間の遅延ではなくマシン速度で動作することを保証します。
- 初日からの測定—ベースラインを確立し、データに基づいて絶え間なく反復します。
成功にはビッグバン変換ではなく、単一ドメインからの段階的な拡張が必要です。小規模に始め、厳密に測定し、トークンオーバーヘッドを削減しながら精度とセキュリティを維持するパターンをスケールしてください。出現するアーキテクチャは従来のデータウェアハウスとは根本的に異なります。より軽量で、より分散型で、エージェント効率のために目的設計されたものになるでしょう。
今この旅を始める組織は何年もの競争優位性を持つでしょう。待つ組織は、異なる時代のために設計されたシステムにAI最適化アーキテクチャを後付けする課題に直面するでしょう。行動する時は今です。