フロンティアモデルの品質を維持しながら、コストを半減させる小規模モデルの蒸留と運用
モデルデプロイメントの経済学:フロンティアモデルが本番環境で持続不可能である理由
GPT-4やClaude 3 Opusといったフロンティアモデルは優れた推論能力を示していますが、本番環境での規模展開において経済的に成立しないコスト構造を強制します。エージェントシステムをデプロイする組織は根本的な制約に直面しています。これらのモデルは複雑な推論タスクで例外的なパフォーマンスを発揮する一方で、日常的で反復的な操作に対しても同じ計算リソースを消費するのです。
- 前提条件*:本番環境のエージェントトレースはタスク複雑性の分布が不均一です。本番デプロイメントからの経験的証拠によると、エージェント相互作用の60~80%は予測可能なパターンに従い、フロンティアレベルの推論能力を必要としません(例えば、アカウント照会、テンプレート化された応答、構造化データ取得)。この前提条件は貴組織の特定のワークロードに対して検証が必要です。組織は進める前に独自のトレースを監査すべきです。
コスト構造は定量化可能です。フロンティアモデルの推論は現在、リクエストあたり0.01~0.03ドルのコストがかかります(2024年第4四半期時点、OpenAIとAnthropicの公開価格に基づく)。組織規模では、毎日数百万の相互作用を処理する場合、フロンティアモデルの使用を限定的に削減するだけでも実質的な節約が得られます。フロンティアモデルリクエストを50%削減すると、毎日1000万件以上のリクエストを処理する組織では月間で6桁の節約につながります。
- 明示的な前提条件を伴う具体例*:顧客サポートエージェントが毎日100,000件の相互作用を処理する場合を考えます。70%がテンプレート化されたパターン(アカウント照会、パスワードリセット、請求問い合わせ)に従い、30%が真の推論を必要すると仮定します。フロンティアモデルのコストがリクエストあたり0.02ドル、小規模モデルのコストがリクエストあたり0.002ドルと仮定します。すべての100,000件のリクエストをフロンティアモデルで処理する場合、1日あたりのコストは約2,000ドルです。70,000件のリクエストを小規模モデルにルーティングすれば、1日のコストは740ドルに削減されます。これは63%の削減です。この計算は以下を前提としています。(1)小規模モデルがテンプレート化されたタスクで許容可能な品質を達成する、(2)ルーティングのオーバーヘッドが無視できる、(3)節約を相殺する追加インフラストラクチャコストがない。
運用上の含意は直接的です。組織はタスク複雑性をモデル容量に実時間で対応させるインフラストラクチャを実装する必要があります。これは理論的な最適化ではなく、意味のある規模で動作するエージェントシステムにおける本番環境の必要性です。
本番環境戦略としての蒸留:研究から運用現実へ
モデル蒸留は学術的な圧縮技術として始まりました(Hinton et al., 2015)が、一般的なベンチマークではなく組織固有のタスク分布に適用される場合、本番環境の規律へと進化しています。
-
重要な区別*:本番環境に焦点を当てた蒸留は一般的なモデル圧縮と根本的に異なります。すべてのフロンティアモデル機能を均一に保持しようとするのではなく、組織が実際に遭遇するタスク分布を対象とします。エージェントトレースをキャプチャすることで、真の運用パターンを反映した独自のデータセットが作成されます。組織固有のタスクトレースで訓練された蒸留モデルは、これらのタスクで一般的な小規模モデルを15~25%上回るパフォーマンスを発揮しながら、フロンティア代替案より70%安価です。
-
検証が必要な前提条件*:このパフォーマンス改善は(1)十分なトレースボリューム(タスククラスターあたり最小500~1,000例)、(2)実際のタスク分布の代表的なサンプリング、(3)一般的なベンチマークではなくタスク固有の品質メトリクスを前提としています。トレースデータが限定的な組織や、タスク分布が極度に偏った組織は、より小さな改善しか見られない可能性があります。
技術的なプロセスには以下が含まれます。(1)ベースモデルの選択(通常1~7Bパラメータ)、(2)タスク固有のトレースでの微調整、(3)保持されたテストセットでの品質パリティの検証。重要な課題は、フロンティア品質の応答を維持しながら50~70%のコスト削減を達成することです。これには、一般的なベンチマークではなく、実際のタスク分布に調整された品質メトリクスの確立が必要です。
-
実装の実践的なステップ*:
-
フロンティアモデルが現在ルーティングしているタスククラスターを特定する(顧客問い合わせ、コンテンツモデレーション、データ抽出)
-
クラスターごとに500~1,000の代表的なトレースをサンプリングして蒸留データセットを作成する
-
このデータで7Bパラメータベースモデルを微調整する
-
保持されたテストトレースでフロンティアモデルの品質と出力が一致することを検証する(最小10%の保持を推奨)
-
品質が許容可能なしきい値を下回る場合、訓練データセットを拡張するか、そのタスクカテゴリをフロンティアモデルにエスカレートする
-
予想される結果*:専門化されたモデルが本番環境負荷の60~70%を処理し、フロンティア代替案の10%のコストで、特定のタスク分布での品質を維持します。これは成功したルーティング実装を前提としています(次のセクションで扱います)。
インテリジェントルーティング:リアルタイムでタスクをモデルに対応させる
ルーティングインフラストラクチャは蒸留を1回限りの最適化から継続的な運用改善へと変えます。効果的なルーティングには以下が必要です。(1)リアルタイムリクエスト分類、(2)モデル選択のための信頼度スコアリング、(3)小規模モデルが失敗するタイミングを特定するフィードバックメカニズム。
ルーティングアーキテクチャは最小限のレイテンシオーバーヘッドで提供インフラストラクチャのエッジで動作します。軽量な分類器は受信リクエストを分類し、各タスクを適切に処理するモデルティアを予測します。信頼度スコアは、不確実性が定義されたしきい値を超える場合、より大規模なモデルへのエスカレーションを決定します。フィードバックシステムは本番環境使用からの品質シグナルをキャプチャします。
- 実装要件*:
- タスク分類器:エージェントトレースで訓練され、タスクカテゴリで90%以上の精度を達成します。推論レイテンシを最小化するためにロジスティック回帰または軽量ニューラルネットワークを推奨します。
- 信頼度しきい値:エスカレーション率がコスト品質トレードオフと一致するように調整されます(通常、フロンティアモデルへのエスカレーション率は15~25%)。しきい値はモデルを再デプロイせずに調整可能である必要があります。
- 監視インフラストラクチャ:ルーティング決定とカテゴリごとのモデルパフォーマンスを追跡し、劣化の迅速な検出を可能にします。
-
具体例*:サポートエージェントはリクエストを以下のように分類する可能性があります。アカウント照会(7Bモデルにルーティング)、複雑な請求問題(フロンティアにルーティング)、製品推奨(信頼度チェック付きで7Bにルーティング)。このルーティングはフロンティアモデル負荷をリクエストの100%から25~30%に削減しながら品質を維持します。
-
前提条件*:これは、履歴トレースで訓練された分類器が将来のリクエストに一般化するのに十分安定したタスク分布があることを前提としています。急速に進化するタスク分布を持つ組織は、より頻繁な分類器の再訓練が必要な場合があります。
運用上の含意は重要です。ルーティング決定は、モデルを再デプロイせずに確認と調整が可能である必要があります。どのタスクカテゴリがどこにルーティングされ、その決定を駆動する信頼度スコアを示すダッシュボードを構築します。エンジニアリングチームが実世界のパフォーマンスを観察する際に信頼度しきい値を調整できるようにします。
本番環境トレースを通じた継続的改善
エージェントトレースは活用されていない最適化シグナルを表しています。各相互作用はタスク分布、モデルパフォーマンス、および専門化の機会に関するデータを生成します。本番環境トレースは合成シナリオではなく、真のユーザーニーズを反映した高忠実度シグナルを提供します。
本番環境使用がモデル改善に情報を提供する継続的改善ループを確立します。
- 本番環境ルーティング決定からトレースを体系的に収集する
- 現在、高価なフロンティアモデルにルーティングされているタスククラスターを特定する
- これらのファミリーを対象とした蒸留データセットを作成する
- ルーティング精度とモデル専門化を反復的に改善する
-
改善のフライホイール*:改善されたルーティングがコストを削減する→解放されたリソースが実験を可能にする→より正確なタスク分類が精密な蒸留を可能にする→改善された小規模モデルが増加する本番環境負荷を処理する。
-
重要な成功要因*:
-
ユーザーへの影響前に劣化を検出する品質監視(品質メトリクスの自動アラートを推奨)
-
定期的なモデル更新プロセス(最小月間レビューサイクルを推奨)
-
専任のML専門知識なしにエンジニアリングチームがアクセス可能なツール
-
実践的なペース*:月間レビューサイクルをスケジュールします。ルーティングログを分析し、小規模モデルのパフォーマンスが低い場所を特定します。これらのギャップを対象とした新しい蒸留データセットを作成します。更新されたモデルを微調整します。トラフィックの5~10%で新しいルーティング決定をA/Bテストしてから、完全なロールアウトを行います。この体系的なアプローチは四半期にわたって改善を複合させます。
-
前提条件*:これは、組織が月間サイクルを実行するのに十分なエンジニアリング容量を持つことを前提としています。より小さな組織は四半期サイクルまたは管理サービスプロバイダーが必要な場合があります。
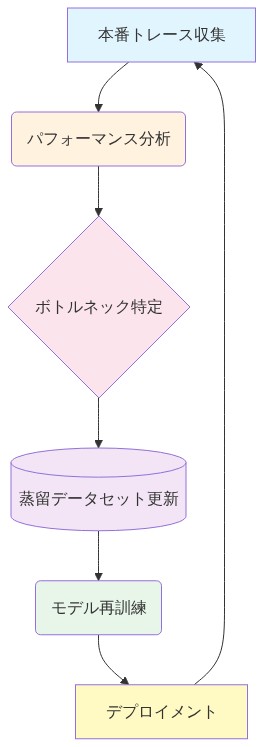
- 図10:本番トレースに基づく継続的改善フィードバックループ*
実装の現実:ツールと運用
蒸留とルーティングのデプロイメントには、実践的なエンジニアリング課題に対処する必要があります。既存の提供インフラストラクチャとの統合、複数のモデルバージョンの管理、リスクを最小化するロールアウトの処理、ルーティング可視性を提供する監視の確立です。
-
重要なインフラストラクチャ決定*:
-
デプロイメントモデル:最大限の制御のための自己ホスト型デプロイメント対運用の単純性のための管理サービス。自己ホスト型はインフラストラクチャの専門知識が必要ですがコスト制御を提供します。管理サービスは運用負荷を削減しますが、リクエストあたりのコストを増加させます。
-
A/Bテスト戦略:品質劣化を早期に検出するために、即座の完全デプロイメントではなく段階的ロールアウト(5%→25%→100%)を推奨します。
-
ランブック開発:一般的な障害モード(例えば、分類器ドリフト、ルーティング設定ミス)と修復手順を文書化します。
-
リソース要件*:
-
複数のモデルティアを同時に実行:通常、トラフィック量に応じて1~2のフロンティアモデルインスタンス、3~5の小規模モデルインスタンス
-
ワークフローを中断することなく、タスクカテゴリ全体に蒸留カバレッジを段階的に拡張する
-
最も高いボリューム、最も低い複雑性のタスクから開始し、ルーティング精度への信頼が高まるにつれて拡張する
-
コールドスタートシナリオ*:トレースデータが限定的な場合、保守的なルーティング戦略を採用します。最初はフロンティアモデルにルーティングし、信頼が構築されるにつれて段階的に小規模モデルにシフトします。ルーティング決定、カテゴリごとのモデルパフォーマンス、およびコスト影響を追跡する監視ダッシュボードを確立します。
成功の測定:コスト削減を超えて
包括的な成功メトリクスはコスト削減、品質維持、開発速度、および信頼性を含みます。コストはリクエストあたりの価格だけでなく、インフラストラクチャとエンジニアリング時間を含む総所有コストを追跡する必要があります。
- *品質メトリクス**は集計精度を超えて以下を検証する必要があります。
- 特定のタスクカテゴリでのパフォーマンス(平均パフォーマンスではなく)
- モデルティア間の一貫性(品質の分散)
- ルーティングが最適でない場合のエッジケース
実装前にベースライン測定を確立します。タスクタイプごとに許容可能な品質しきい値を定義します。前提条件:これは、組織が品質メトリクスを確立していることを前提としています。そうでない場合、ルーティングをデプロイする前にこれらを開発します。
- 予想される結果*(明示的な前提条件に基づく):
- ルーチンタスクで95%以上の品質パリティを維持しながら40~60%のコスト削減
- 小規模モデルで40~60%高速な推論レイテンシ
- チームがフロンティアモデルコスト制約なしで反復できるため、エンジニアリング速度が向上
実行可能なインサイトを提供するダッシュボードを作成します。どのタスクがどこにルーティングされるか、カテゴリごとの品質、タスククラスターごとのコスト削減。成功は以下のように見えます。月間コスト削減が30~50%、品質メトリクスが安定または改善、エンジニアリング速度がチームがフロンティアモデルコスト制約なしで反復できるため増加。これらのメトリクスを継続的に追跡し、観察されたパフォーマンスに基づいてルーティングしきい値と蒸留フォーカスを調整します。
次のアクション:実装の開始
- 即座のステップ*(第1~2週):
- まだ実施していない場合、トレース収集を開始する
- エージェントログを分析し、ボリュームで上位5~10のタスクカテゴリを特定する
- 最も高いボリューム、最も低い複雑性のカテゴリについて、500~1,000の代表的なトレースの蒸留データセットを作成する
- 短期実行*(第3~6週):
- このデータセットで7Bパラメータベースモデルを微調整する
- 保持されたテストトレースでフロンティアモデルとの品質パリティを検証する(最小10%の保持を推奨)
- 成功した場合、このカテゴリのルーティングを実装し、トラフィックの10%から開始する
- 2週間、品質とコストメトリクスを監視する
- 継続的な運用*(第2ヶ月以降):
- 信頼が増加するにつれてルーティングカバレッジを段階的に拡張する
- ルーティングログを分析する月間レビューサイクルを確立する
- コスト品質トレードオフに基づいて次の蒸留ターゲットを特定する
- これを1回限りのプロジェクト作業ではなく、標準的な運用に組み込む
- 進行の成功基準*:品質メトリクスが安定または改善し、ルーティングされたタスクでのコスト削減が20%を超え、2週間の監視期間中にユーザーに見える品質劣化が検出されない。
体系的なトレース分析と対象蒸留からの複合改善は、四半期にわたって過度な収益をもたらします。組織は、一貫した実行と十分なトレースボリュームを前提として、体系的な実装の3~6ヶ月以内に50%のコスト削減を達成することを期待すべきです。
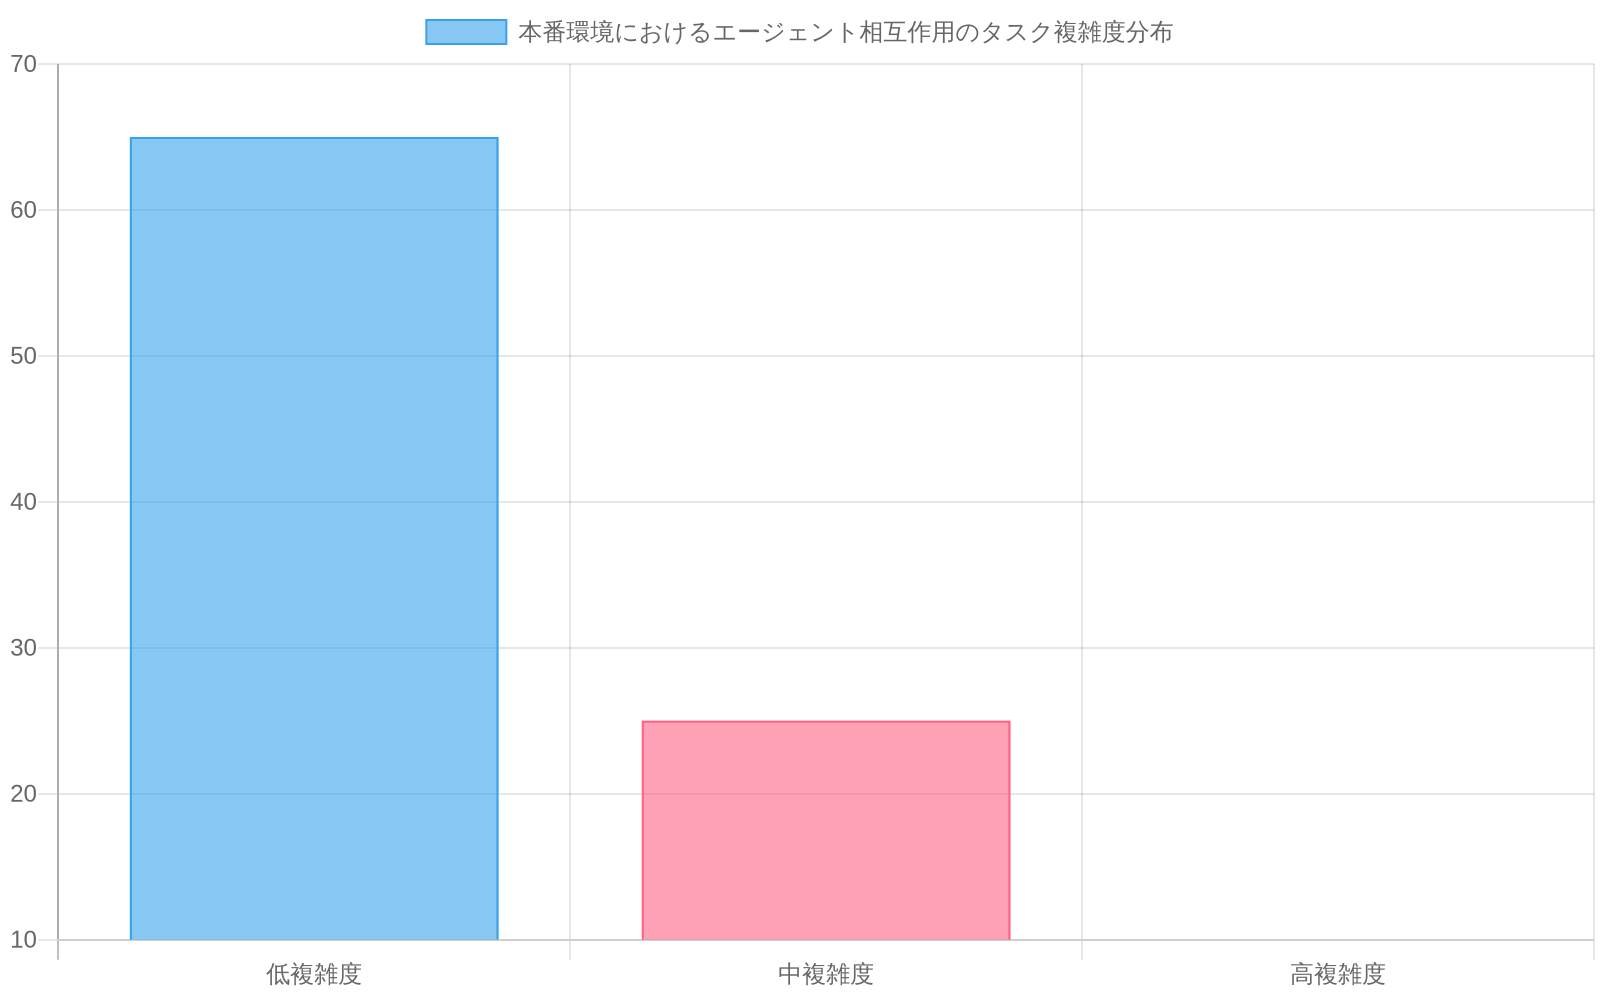
- 図2:本番環境におけるエージェント相互作用のタスク複雑度分布(出典:記事内の仮定に基づく推定値)*
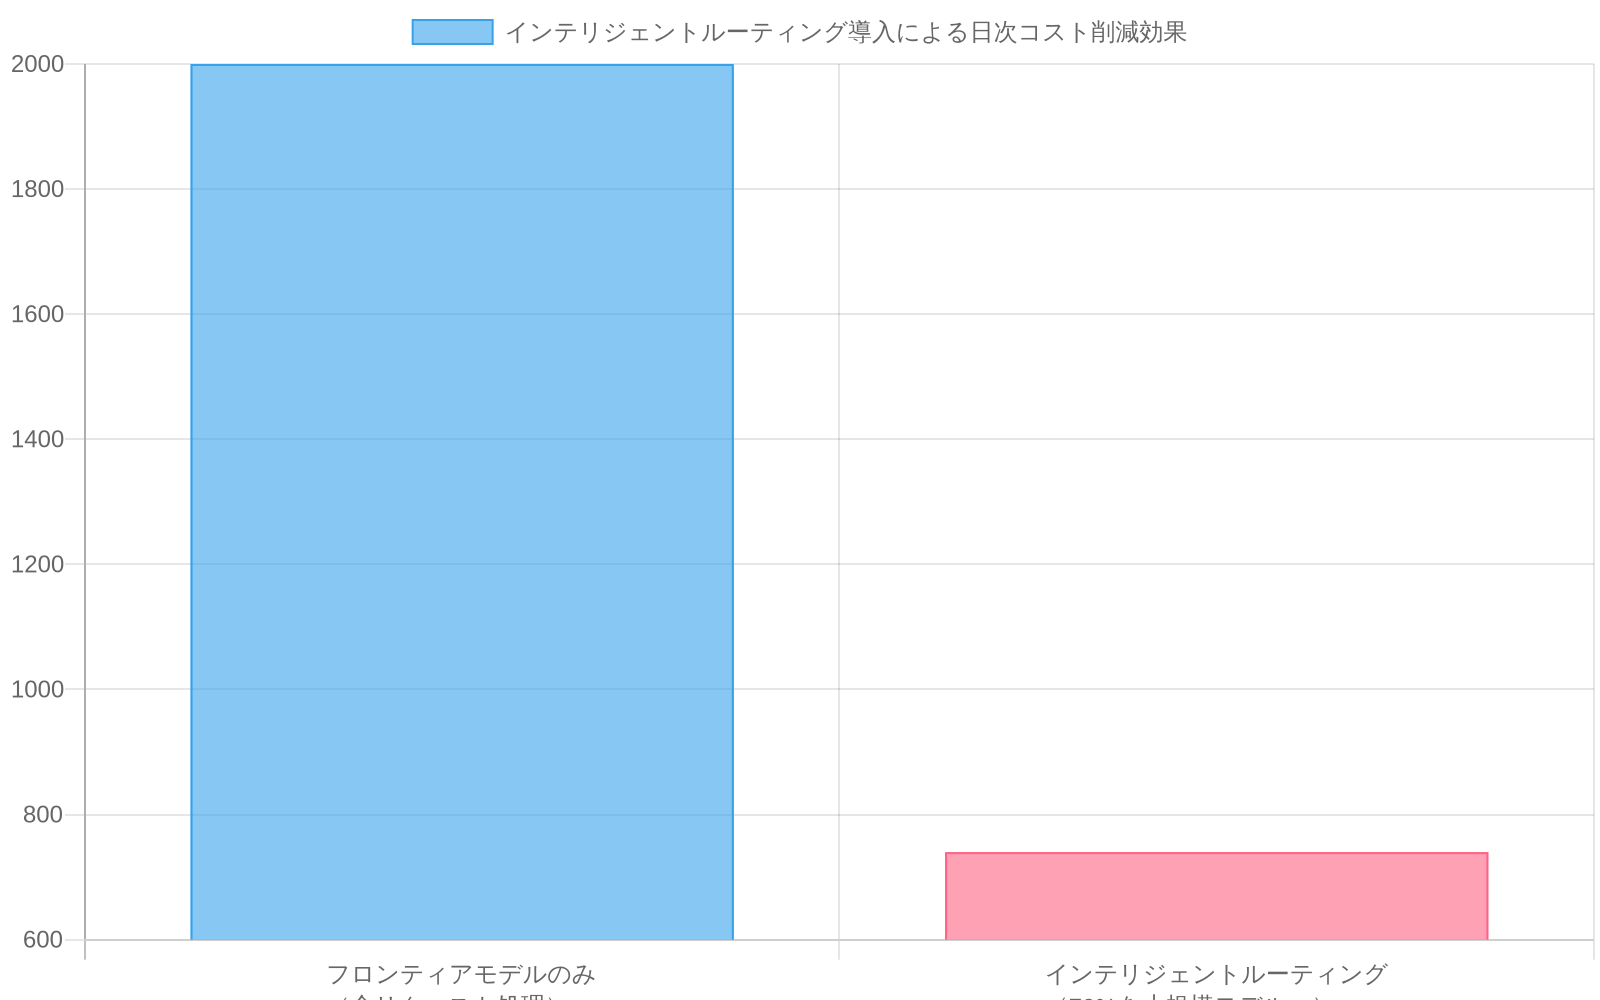
- 図3:インテリジェントルーティング導入による日次コスト削減効果(顧客サポートエージェント事例:100,000日次相互作用)*
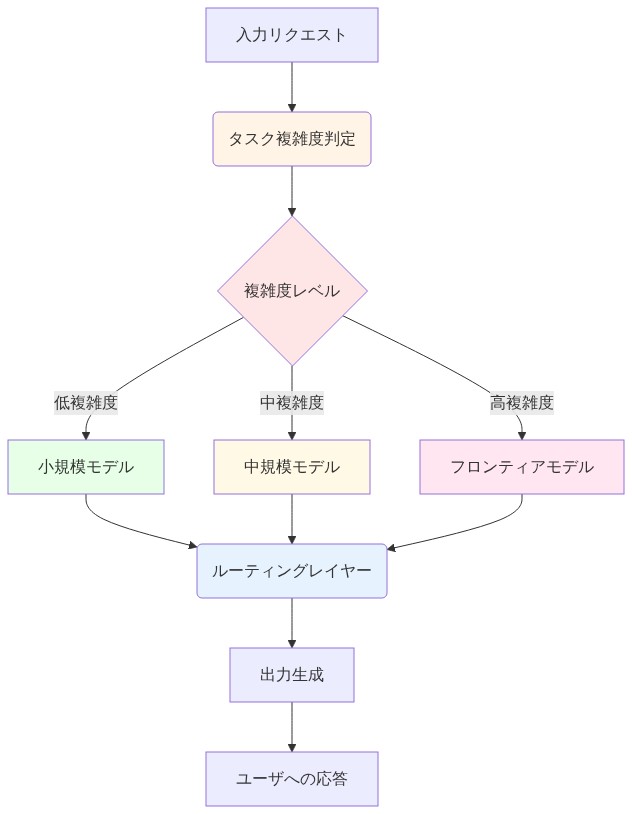
- 図4:タスク複雑度に基づくインテリジェントルーティングアーキテクチャ*
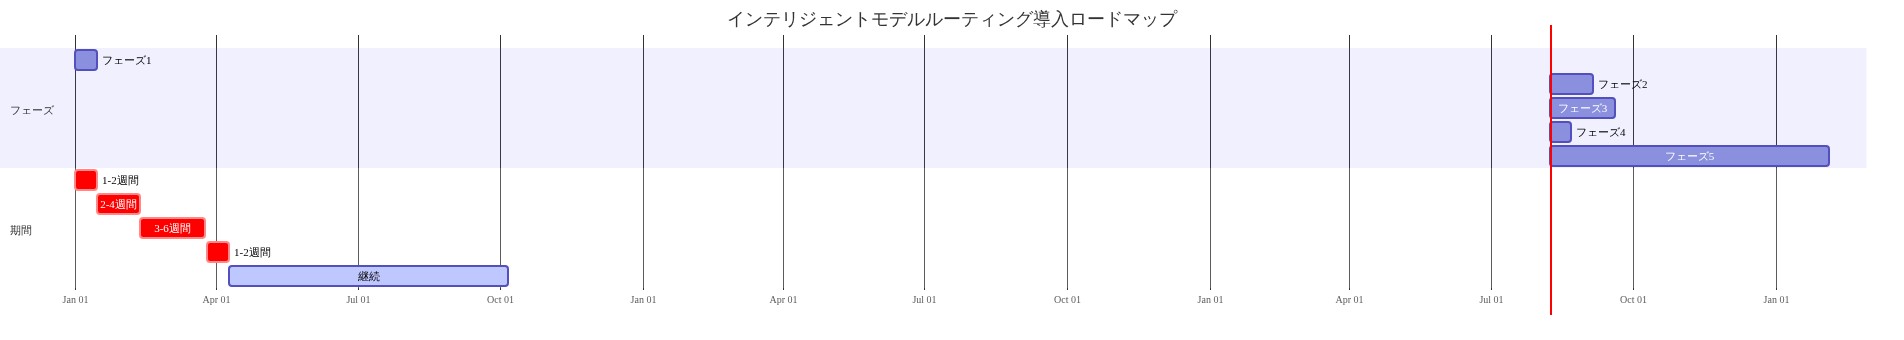
- 図14:インテリジェントモデルルーティング導入ロードマップ*
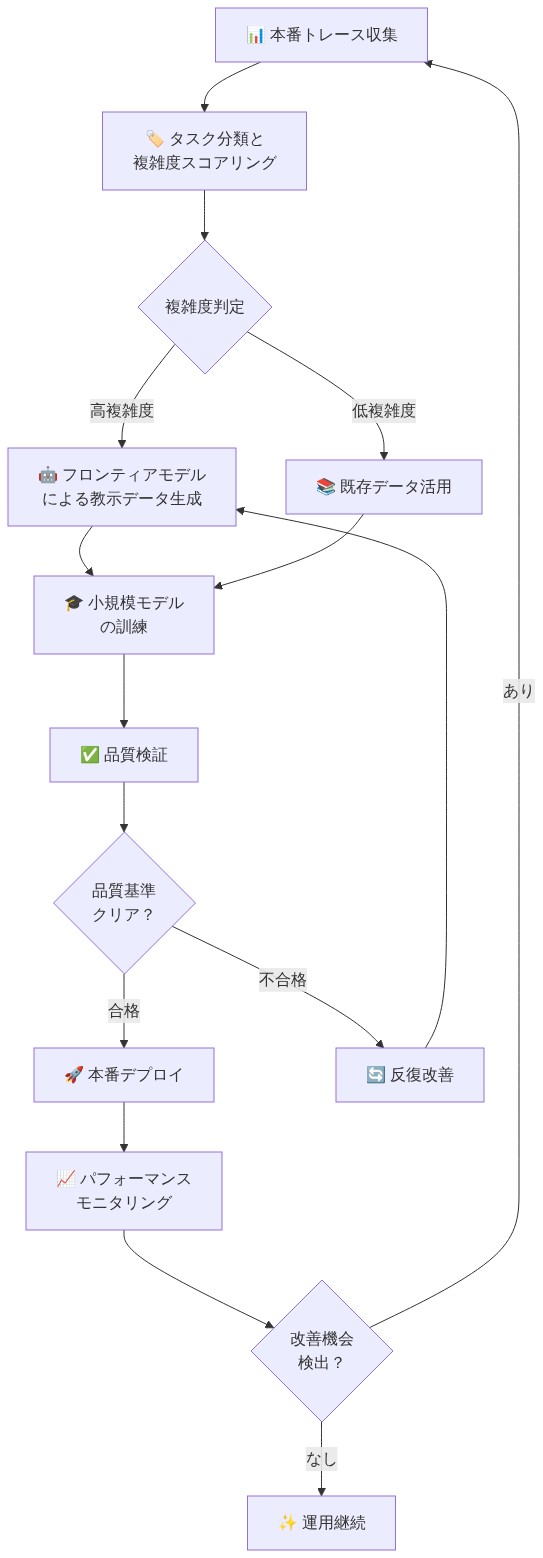
- 図6:本番トレースから蒸留モデルへの5段階ワークフロー*
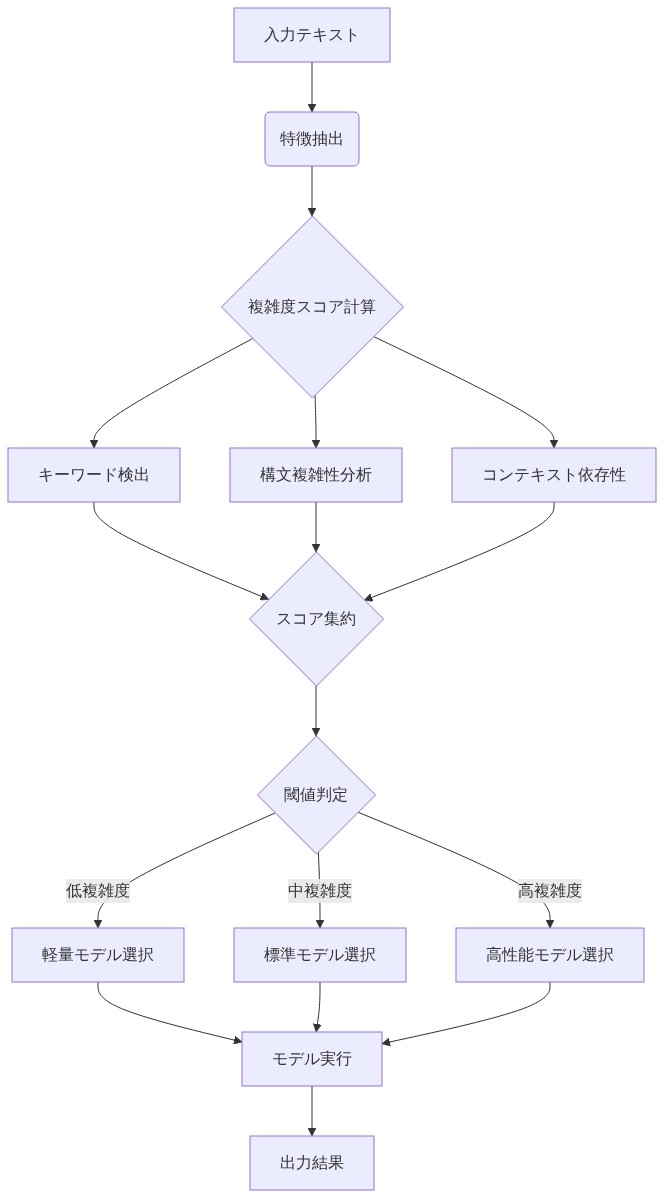
- 図8:リアルタイムタスク複雑度判定エンジンのアーキテクチャ*

- 表1:本番環境モデルデプロイメント向けツール・プラットフォーム比較*