Anthropicの35億ドルLambda契約:インフラ戦略と市場への含意
Anthropicの35億ドル約定を支える戦略的計算
Anthropicが2028年までの大規模言語モデル(LLM)開発向けの計算容量確保を目的としてLambdaと締結した35億ドルのクラウドコンピューティング契約は、従来のクラウドサービス契約とは異なる金額規模と期間を特徴としています。この取り決めの根底にある前提と戦略的根拠を検討する価値があります。
- 重要な前提:* この契約は、フロンティアAIモデルの学習が2028年までの間、継続的または増加する計算リソースを必要とすることを前提としています。この前提はNvidiaのリーダーシップによるGPUアクセラレータへの需要継続に関する公開声明と一致していますが、実際の計算要件はモデル効率、学習アルゴリズム、アーキテクチャ革新における革新的進展に依存しており、これらは不確実性を伴っています。
Anthropicのアウトソーシング型インフラ戦略はハイパースケーラー戦略と対照的です。Amazon、Google、Microsoftは直接的なGPU調達を拡大し、独自のデータセンターインフラを構築することで、垂直統合と統制を優先しています。Anthropicの場合、Lambda契約を通じてインフラ管理責任を専門プロバイダーに移譲しながら、容量配分を保証しています。この選択は戦略的優先順位を反映しています。すなわち、エンジニアリングリソースをモデル開発に集中させ、データセンター運用やGPU調達ロジスティクスには向けないということです。
- 重要な区別:* 財務構造は単純な前払いではなく、パフォーマンス保証、容量スケーリング条項、潜在的なエクイティ成分を含む可能性があります。契約条件へのアクセスがない状態では、正確な支払いスケジュール、最小年間約定、調整メカニズムは確認されていません。業界の先例から判断すると、このような大規模契約は通常、複数年にわたり、変動的な利用条項を伴っています。
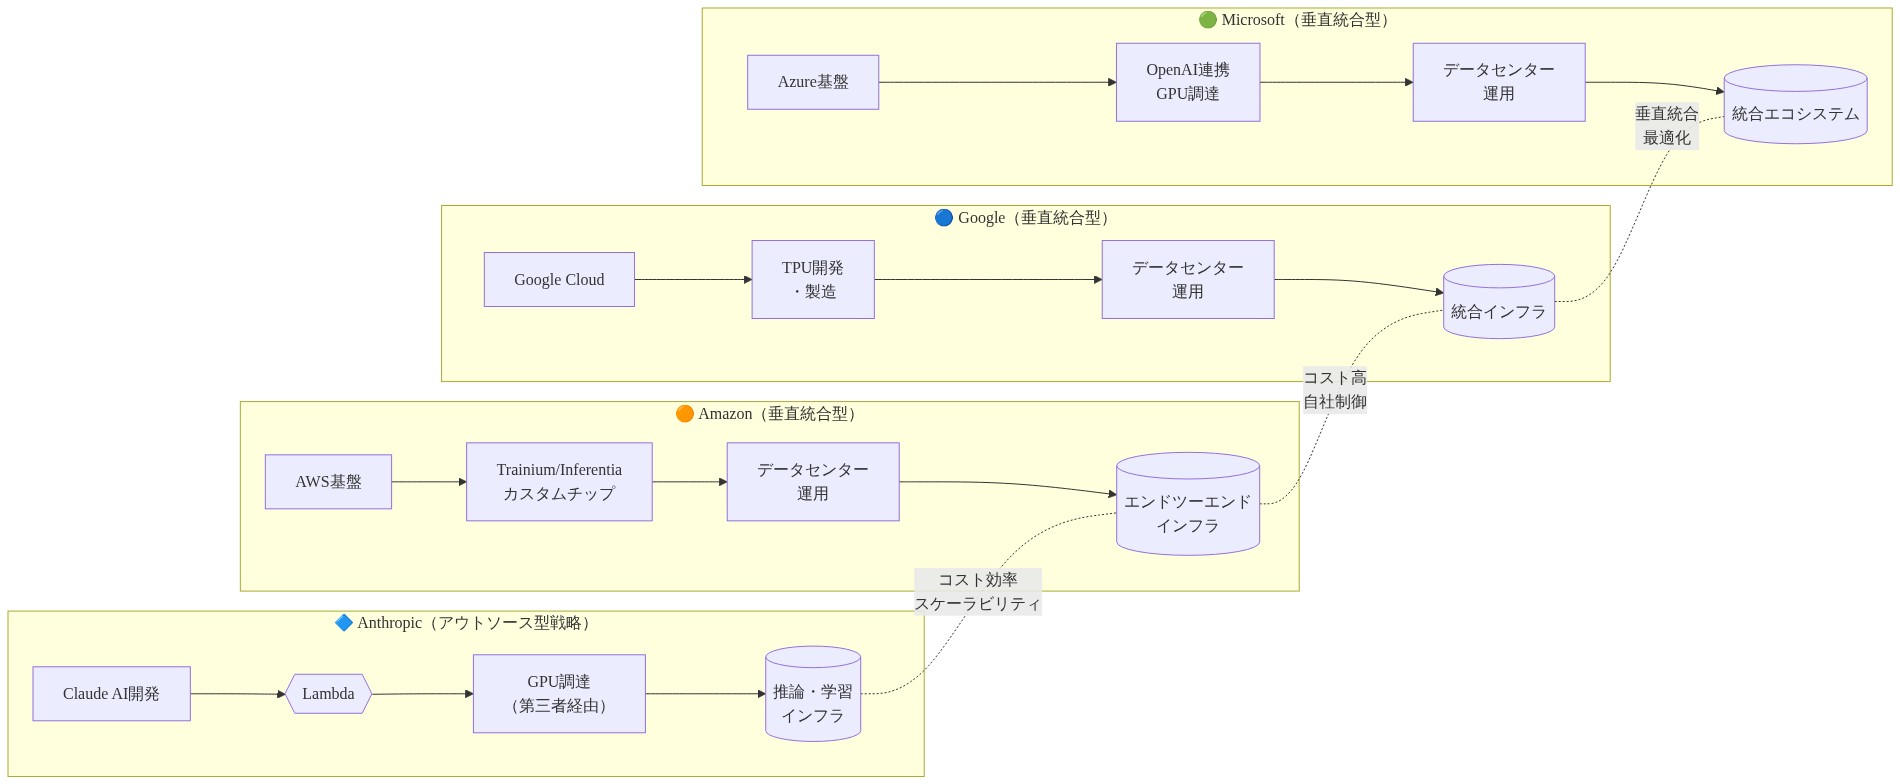
- 図2:AI企業のインフラ戦略の比較:アウトソース型(Anthropic)vs 垂直統合型(Amazon・Google・Microsoft)*
戦略的インフラパートナーへと進化するLambda
Lambdaが30億ドルのプリIPO評価から35億ドル契約の成約に至るまでの軌跡は、AI インフラ統合における異常な速度を示しています。このトランザクションはLambdaが、ハイパースケール既存企業に対抗できる専門的AI クラウドプロバイダーとしての地位を確認しています。大規模言語モデル学習に最適化された目的別インフラを提供することで競争力を発揮しています。
Nvidiaの支援はLambdaに供給制約時のGPU優先アクセスを提供します。これは汎用クラウドプロバイダーが複製できない競争上の優位性です。この契約はLambdaがAnthropicのワークロード専用に構築されたデータセンター容量を構築することを含む可能性が高く、従来のクラウドサービスとカスタムインフラの間のハイブリッドモデルを表しています。この取り決めにより、LambdaはAnthropicの約定を大規模なGPUクラスタと支援インフラへの莫大な資本支出の担保として活用できます。
このパートナーシップはLambdaをAWS、Google Cloud、Microsoft Azureを超えた選択肢を求めるAI企業向けのインフラ代替案として位置付けています。Lambdaがこの契約を成約できたという事実は、数万個のアクセラレータを含む学習実行に必要なGPUクラスタネットワーキング、冷却、オーケストレーション周辺の重要な技術的課題を解決したことを示唆しています。この契約は、汎用クラウドプラットフォームとして競争するのではなくAIワークロードに専念することで、特化したインフラプロバイダーが重要な価値を獲得できることを検証しています。
AI軍拡競争における相異なるインフラ戦略
Anthropicの Lambda パートナーシップとAmazonの直接Nvidia チップ注文を3倍にする戦略の対比は、AI計算容量確保に向けた根本的に異なるアプローチを明らかにします。AmazonやGoogle、Microsoftなどのハイパースケーラーは、GPUを直接購入し、カスタムデータセンターを構築し、独自のネットワーキングファブリックを開発することで垂直統合を進めています。このアプローチは最大限の統制を提供し、長期的には低いコストをもたらす可能性がありますが、莫大な初期資本と専門的エンジニアリング人材を必要とします。
Lambdaを通じたAnthropicのアウトソーシングモデルは統制の一部を犠牲にし、計算時間あたりプレミアムを支払う可能性がありますが、インフラ構築と運用を排除します。この相違は各企業の中核的能力を反映しています。Amazonは異なるワークロードを持つ多様なクラウド顧客に対応する必要があり、一方Anthropicはモデル学習と推論に完全に最適化できます。
他のAI企業はハイブリッドアプローチを追求しており、所有インフラの一部を維持しながらピーク需要時にクラウド容量で補完しています。これらの多様な戦略はAI市場が成熟するにつれて異なる競争上の優位性をもたらします。Anthropicの選択は、特化したプロバイダーがAIワークロード向けに内部インフラ構築よりも効率的に計算を提供でき、企業がデータセンター運用ではなくモデル開発にリソースと資本を集中できるという確信を反映しています。
大規模クラウド契約における金融工学
35億ドルという数字は、単純な前払いではなく、複数年にわたる最大約定を表しており、複雑な支払い構造、容量保証、パフォーマンスベンチマークを含んでいる可能性があります。取り決めは通常、最小年間約定を含み、Anthropicの資金調達軌跡と製品開発マイルストーンに基づくスケーリング条項を備えています。
Lambdaは定義されたタイムラインで特定の計算容量を提供することを約定することで、重大な実行リスクを引き受けます。これはNvidiaからのGPU配分、データセンター構築、専門的運用チームを必要とします。Anthropicのリスクは、そのモデルが契約容量を必要とするかどうか、および企業が支払い義務を満たすのに十分な収益を生成できるかどうかに集中しています。
契約構造はおそらく、Anthropicが未使用容量をサブリースしたり、計算要件を削減する技術的進展に基づいて約定を調整したりすることを可能にする条項を含んでいます。LambdaのNvidia支援は重要になり、おそらく有利なGPU価格設定と配分優先度を促進します。契約はエクイティ成分を含む可能性があり、Lambdaに Anthropic の成功への上昇エクスポージャーを与えながら、即座の現金要件を削減します。これらのメカニズムは、長期的インフラ投資を不確実なAI能力開発軌跡と一致させるという課題を反映しています。
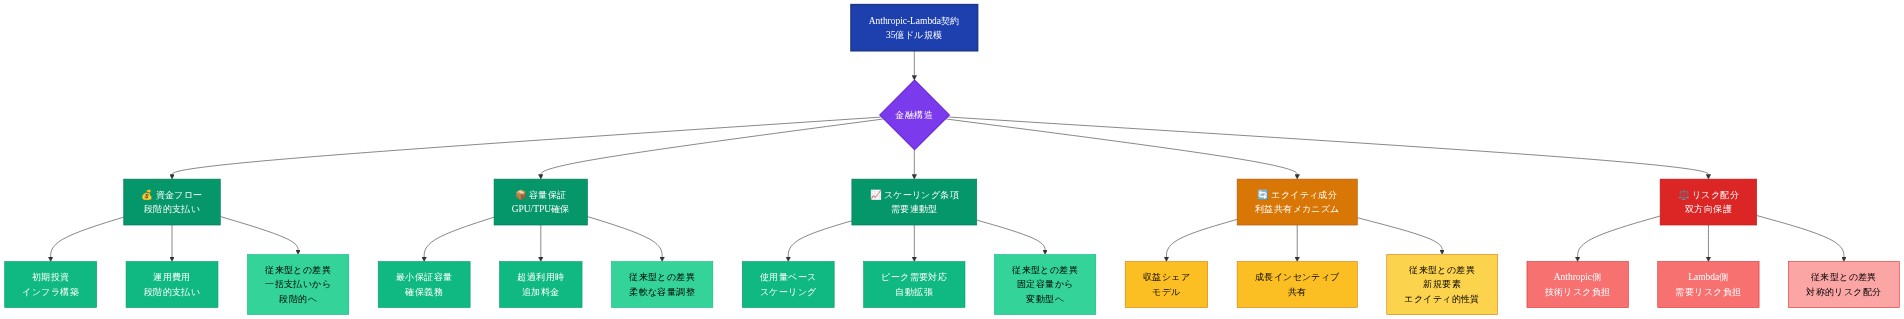
- 図5:Anthropic-Lambda契約の金融構造:従来型クラウド契約との相違点*
競争上の含意と市場統合
この契約はAIインフラにおける競争上の境界を定義する戦略的同盟の形成を加速させ、今後数年間の競争力学に影響を与えます。Anthropicの Lambda パートナーシップは、GoogleとAmazonとの既存の投資家関係と組み合わせて、急速なスケーリングを可能にしながら戦略的柔軟性を制約する複雑な依存関係のネットワークを作成します。
この取り決めは事実上、Anthropicをlambdaのテクノロジースタックにロックインし、学習インフラが深く統合されると切り替えコストが法外に高くなります。OpenAIやCohere などの競合企業にとって、この契約は長期計算容量の確保が同様の数十億ドル規模の約定を必要とする戦略的命令になったことを示唆しています。このダイナミクスは十分な資金を持つプレイヤーを優遇し、大規模契約を信頼できる形で約定できないスタートアップに対する障壁を作成します。
このトランザクションは、特化したAIクラウドプロバイダーがハイパースケーラーの実行可能な代替案として機能することを検証し、市場の断片化と他のインフラ企業の機会創出の可能性があります。しかし、成功はLambdaの実行能力とNvidiaの継続的なGPU供給に依存します。Lambdaが運用上の課題に直面したり、供給制約が激化した場合、Anthropicは研究ロードマップに対する重大な混乱に直面する可能性があり、単一ベンダー約定に固有の集中リスクを示しています。
戦略的計画への含意
-
AI企業向け:* アウトソーシング型インフラパートナーシップまたは直接GPU調達が資本制約と戦略的優先順位とより良く一致するかどうかを評価してください。インフラ契約を構造化する際に、長期計算要件とロックインリスクを検討してください。
-
インフラプロバイダー向け:* 特化したAIクラウドプロバイダーは現在、目的別容量とNvidia支援を提供することでハイパースケーラーに対抗するための検証済みのプレイブックを持っています。GPUオーケストレーションとネットワーキングにおける深い技術的専門知識の構築は、防御可能な競争上の優位性を作成します。
-
投資家向け:* この契約はAIワークロード周辺のインフラ統合が加速し続けることを示し、戦略的パートナーシップがますます競争上の成果を決定することを示しています。競合するAIラボが計算約定をどのように構造化するかを監視し、資本配分優先度と長期モデルスケーリング軌跡への信頼の先行指標として機能します。
Lambdaの市場ポジションと競争力学
LambdaがプリIPO評価コンテキストから35億ドル契約の実行へと移行したことは、インフラプロバイダー評価の大幅な成長を示しています。このトランザクションはLambdaを、LLM学習ワークロード向けに最適化された目的別GPU クラスタ容量を提供することでハイパースケーラーの確立された企業に対抗できる特化したAIインフラプロバイダーとして位置付けています。
-
Nvidiaの役割:* Nvidiaによるlambdaの支援は、供給が制限される期間中のGPU供給への優先アクセスを作成します。この関係はおそらくLambdaに有利な配分優先度と価格設定条件を提供し、汎用クラウドプロバイダーが容易に複製できない競争上の優位性を作成します。この取り決めはLambdaが大規模学習運用に必要なGPUクラスタオーケストレーション、ネットワーキング、熱管理における技術的能力を開発したことを示唆しています。
-
インフラモデル:* 契約はおそらくLambdaがAnthropicのワークロード向けに特別に構成された専用データセンター容量を構築することを含み、従来のクラウドサービスとカスタムインフラの間のハイブリッド取り決めを表しています。この構造によりLambdaはAnthropicの長期約定を、GPU クラスタと支援インフラへの実質的な資本支出の担保として活用できます。
-
実行リスク:* Lambdaは定義されたタイムラインで特定の計算容量を提供することを約定することで、重大な運用リスクを引き受けます。これはNvidiaからの信頼できるGPU供給、成功したデータセンター構築と展開、専門的運用専門知識を必要とします。Anthropicの対応するリスクは、そのモデルが契約容量を必要とするかどうか、および収益生成が支払い義務を支援するかどうかに集中しています。
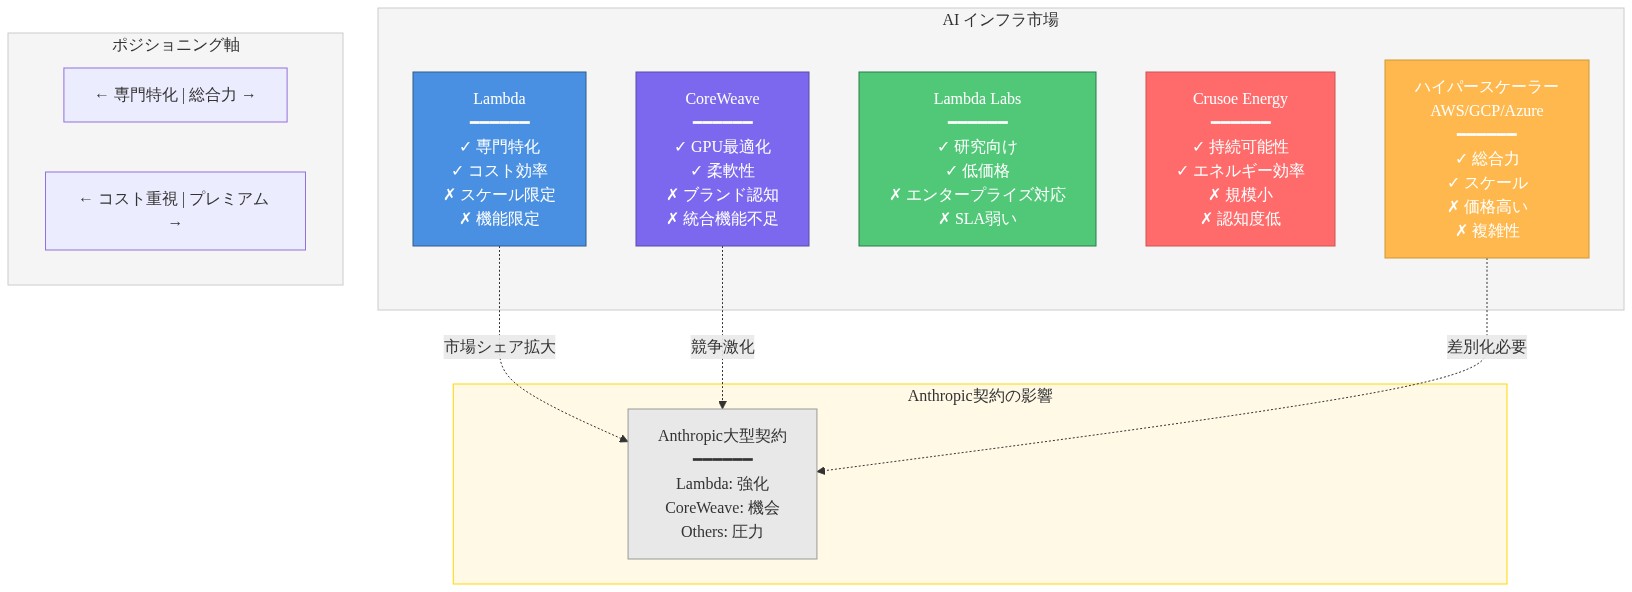
- 図8:AI インフラプロバイダーの競争ポジショニングマップ(Anthropic契約による市場影響を含む)*
AI開発における相異なるインフラ戦略
Anthropicのアウトソーシング型Lambdaパートナーシップとハイパースケーラーの直接GPU調達戦略の対比は、AI計算容量確保に向けた異なるアプローチを明らかにし、各々は異なるトレードオフを伴っています。
-
垂直統合アプローチ(ハイパースケーラー):* Amazon、Google、Microsoftはnvidiaから直接GPUを購入し、独自のデータセンターを構築し、カスタムネットワーキングインフラを開発しています。この戦略は最大限の運用統制と潜在的に低い長期単位コストを提供しますが、実質的な初期資本投資とインフラ開発および運用向けの専門的エンジニアリング人材を必要とします。
-
アウトソーシングアプローチ(Anthropic):* Lambdaを通じた計算確保はインフラ構築と運用責任を排除しますが、おそらく高い単位計算コストと インフラ決定に対する統制の削減を伴います。このアプローチは資本効率と中核的能力への焦点を優先します。
-
相違の根拠:* ハイパースケーラーは異なる要件を持つ多様な顧客ワークロードに対応し、垂直統合投資を正当化します。Anthropicのワークロードはモデル学習と推論に狭く焦点を当てており、特化したインフラプロバイダーがこの特定の使用事例に対してより効率的である可能性があります。この選択は各組織の中核的能力と資本制約を反映しています。
-
ハイブリッドアプローチ:* 他のAI企業は混合戦略を追求しており、基本容量向けに所有インフラを維持しながらピーク需要期間中にクラウドプロバイダーで補完しています。これらの多様なアプローチは市場条件が進化するにつれて異なる競争上の成果をもたらします。
財務構造とリスク配分
35億ドルという数字は即座の支払いではなく、複数年にわたる最大約定を表しています。実際の財務メカニズムはおそらく以下を含みます。
-
最小年間約定 定義された計算容量保証を伴う
-
スケーリング条項 Anthropicの資金調達軌跡と研究マイルストーンに基づく調整を可能にする
-
パフォーマンスベンチマーク 計算可用性、レイテンシ、信頼性要件を指定する
-
潜在的なエクイティ成分 Lambdaに Anthropic の成功への上昇エクスポージャーを与えながら、即座の現金要件を削減する
-
Anthropicの財務リスク:* 企業は支払い義務を満たすのに十分な収益を生成する必要があります。モデル開発が契約より少ない計算を必要とする場合、または収益生成が期待を下回る場合、Anthropicは未使用容量コストまたは契約再交渉の課題に直面します。
-
Lambdaの実行リスク:* プロバイダーは契約容量を確実に提供する必要があります。GPU供給の混乱、データセンター構築の遅延、運用上の失敗はLambdaが約定を満たすことを妨げ、潜在的に契約上の罰則または紛争を引き起こす可能性があります。
-
緩和メカニズム:* 契約はおそらくAnthropicが未使用容量をサブリースしたり、計算要件を削減する技術的進展に基づいて約定を調整したり、研究進捗に基づいてタイムラインを修正したりすることを可能にする条項を含んでいます。これらの条項は長期インフラ投資を予測不可能なAI能力開発軌跡と一致させることの固有の不確実性を反映しています。
競争上の含意と戦略的ロックイン
この契約は今後数年間のAI開発における競争力学を形作る戦略的同盟を確立します。Anthropicの Lambda パートナーシップは、投資家としてのGoogleとAmazonとの既存関係と組み合わせて、急速なスケーリングを可能にしながら潜在的に戦略的柔軟性を制約する複雑な依存関係を作成します。
-
ロックイン効果:* 学習インフラがLambdaのテクノロジースタック、ネットワーキングアーキテクチャ、運用手順に深く統合されると、切り替えコストは法外に高くなります。この取り決めは事実上Anthropicをlambdaのプラットフォームにコミットします。OpenAIやCohere などの競合企業は同様の数十億ドル規模の約定を通じて長期計算容量を確保するという同様の圧力に直面しています。
-
市場統合:* このトランザクションは特化したAIインフラプロバイダーがハイパースケーラーの実行可能な代替案として機能することを検証し、市場の断片化と他のインフラ企業の機会創出の可能性があります。しかし、成功はLambdaの実行能力と継続的なNvidia GPU供給に重大に依存しています。Lambdaが運用上の課題に直面したり、供給制約が激化した場合、Anthropicは研究ロードマップに対する重大な混乱に直面する可能性があります。
-
集中リスク:* 単一ベンダーのインフラ約定はプロバイダー固有の失敗に対する脆弱性を作成します。Lambdaへの主要計算容量の依存は、Lambdaによる運用上の混乱、財務上の困難、または戦略的転換がAnthropicの研究能力と製品開発タイムラインに直接影響を与える可能性があることを意味しています。
-
競争上のシグナリング:* この契約は他のAI企業に対し、長期計算容量の確保が戦略的命令になったことを示唆しています。このダイナミクスは大規模契約を信頼できる形で約定できる十分な資金を持つプレイヤーを優遇し、同等の容量約定を確保できないスタートアップに対する障壁を作成します。
含意と検討事項
Anthropicの35億ドルのLambda契約は、フロンティアAI開発における資本配分、運用フォーカス、リスク管理に関する戦略的選択を反映した、アウトソースAIインフラストラクチャへの重要なコミットメントを表しています。
-
AI開発企業にとって:* インフラストラクチャの決定は、資本効率性、運用上の統制、戦略的柔軟性の間のトレードオフを伴います。アウトソースパートナーシップは資本要件を削減し、モデル開発に集中することを可能にしますが、ベンダーロックインと潜在的なコストプレミアムを生み出します。直接的なGPU調達は統制を提供しますが、実質的な資本と運用専門知識を必要とします。
-
インフラストラクチャプロバイダーにとって:* 専門化されたAIインフラストラクチャプロバイダーは、特定のワークロードに最適化された目的別キャパシティを提供することで、ハイパースケーラーに対抗できます。成功にはGPUオーケストレーション、ネットワーキング、熱管理における深い技術的専門知識と、GPU供給への信頼できるアクセスが必要です。
-
投資家にとって:* AIワークロード周辺のインフラストラクチャ統合は加速し続ける可能性が高いです。戦略的パートナーシップはAI開発における競争成果にますます影響を与えます。競合するAIラボがコンピュート契約をどのように構成しているかを監視することで、資本配分の優先順位と長期的なモデルスケーリング軌道への信頼度に関するインサイトが得られます。
Lambdaの戦略的インフラストラクチャパートナーへの変革
Lambdaの30億ドルのプリIPO評価目標から35億ドルの契約締結への進化は、並外れた価値創造を表すか、従来の評価が示唆するものとは異なる方法でリスクを分散する構造化された取り決めを表しています。
- Lambdaが実際に得たもの:*
-
収益の確実性: 5年以上にわたる350億ドルのコミットされた顧客収益は、GPU購入とデータセンター建設のための担保を提供します。これはLambdaを投機的スタートアップから収益裏付けのインフラストラクチャオペレーターに変換します。
-
GPU配分の優先順位: Nvidiaの支援は供給制約時の優先的配分を含む可能性が高く、これはそのような取り決めを持たない競合他社と比較して有効なコンピュート容量の10~15%相当の具体的な競争優位性です。
-
運用上の検証: Anthropicのトレーニング実行のための大規模なコンピュート配信に成功することで、他のAI企業を引き付ける参照顧客が作成され、将来の取引の顧客獲得コストが削減されます。
-
Lambdaが実行する必要があるもの:*
-
Anthropicのワークロード用に最適化された専用GPUクラスターを構築(おそらく10,000~50,000のH100/H200相当)
-
分散クラスター全体で400Gbps以上のインターコネクト速度を維持できるネットワークインフラストラクチャを構築
-
ジョブスケジューリング、フォールトトレランス、リソース配分を管理するオーケストレーションソフトウェアを開発
-
99.5%以上のアップタイムSLAを維持するか、契約上のペナルティに直面
-
実行リスクは実質的です。* データセンター建設のタイムラインは通常6~12ヶ月遅延します。GPU供給は依然として制約されています。このスケールでのネットワーキングはカスタムエンジニアリングが必要です。Lambdaがキャパシティ配信日を逃した場合、Anthropicのトレーニングロードマップは遅延に直面し、製品リリースと収益に連鎖的な影響を与えます。
-
財務構造には以下が含まれる可能性があります:*
-
エクイティコンポーネント(Lambdaはanthropicが成功した場合にアップサイドを得る)
-
パフォーマンス保証(Lambdaは逃したキャパシティ目標についてAnthropicに払い戻す)
-
サブリース条項(Anthropicは未使用のキャパシティを他の企業にリースでき、有効コストを削減)
このハイブリッド構造はAnthropicの即座の現金負担を削減しながら、LambdaにはアップサイドとAnthropicに未使用キャパシティの部分的なオプション性を与えます。
競争上の含意と業界統合
この取引は、2028年を通じて競争上の境界を定義するAIインフラストラクチャパートナーシップのテンプレートを確立します。
- 即座の競争対応:*
-
OpenAI: 同等の長期的なコンピュートコミットメントを確保する必要があります。オプションには以下が含まれます:
- 正式なキャパシティ保証を伴うMicrosoft Azureパートナーシップを拡大
- GPU配分のためのNvidiaとの直接的な取り決めを交渉
- 部分的に所有されたインフラストラクチャを構築(資本集約的、より遅い)
-
Cohere、Mistral、その他のフロンティアラボ: コンピュートパートナーシップに50億~150億ドルをコミットするか、モデルスケーリングを制限するキャパシティ制約に直面するプレッシャーに直面しています。
-
ハイパースケーラー(AWS、Google Cloud、Azure): Lambdaのような専門プロバイダーに対抗するために、キャパシティ保証を伴うAI固有のオファリングを正式化する必要があります。
- 戦略的ロックイン効果:*
AnthropicのトレーニングインフラストラクチャがLambdaのシステムに展開されると、切り替えコストは法外に高くなります:
- モデルを異なるインフラストラクチャで再トレーニングするには2~4週間のダウンタイムが必要です
- Lambdaのハードウェア用のカスタム最適化はトレーニングコードに組み込まれます
- 競合他社との再交渉には同等のキャパシティと信頼性を実証する必要があります
これにより、Anthropicが実質的にLambdaにロックインされる3~5年のウィンドウが作成され、Lambdaに契約更新のための価格設定力を与えます。
- 市場分断リスク:*
Lambdaが正常に実行された場合、専門化されたAIクラウドプロバイダーはハイパースケーラーの実行可能な競合他社になり、市場が分断される可能性があります:
- Lambdaはllmトレーニングに焦点を当てます
- 他のプロバイダーは推論、マルチモーダルモデル、またはロボティクストレーニングに特化する可能性があります
- ハイパースケーラーは汎用クラウドサービスの利点を維持します
ただし、この分断はLambdaと競合他社が運用上の優秀性を維持する場合にのみ持続します。単一の大規模な停止またはキャパシティ不足により、顧客がハイパースケーラーに戻る可能性があります。
- 集中リスク:*
この取引は以下への危険な依存を生み出します:
- Nvidia GPU供給: Nvidiaが製造上の混乱に直面した場合、LambdaとAnthropicの両方が影響を受けます
- Lambdaの実行: 運用上の失敗はAnthropicの研究ロードマップに直接カスケードします
- Nvidiaの支援: Nvidiaが支援を撤回するか、財務上の困難に直面した場合、Lambdaの資金調達は問題になります
Anthropicは代替プロバイダーからのコンピュート容量の継続計画を維持する必要がありますが、350億ドルのコミットメントはこれを困難にします。
運用プレイブック:インフラストラクチャパートナーシップの評価
-
同様の取り決めを検討しているAI企業向け:*
-
フェーズ1:キャパシティプランニング(1~3ヶ月)*
-
スケーリング則に基づいて次の3~5年間のコンピュート要件をモデル化
-
トレーニング、ファインチューニング、推論に必要なGPU時間を推定
-
コンピュートコストをサポートするために必要な収益を示す財務モデルを構築
-
コンピュート支出が持続不可能になるポイントを特定
-
フェーズ2:プロバイダー評価(2~4ヶ月)*
-
技術的能力、財務安定性、GPUアクセスに関して3~5のインフラストラクチャプロバイダーを評価
-
既存顧客とのアップタイム、サポート品質、価格設定の公正性に関する参照チェックを実施
-
切り替えコストと契約上の柔軟性を評価
-
コンピュートコストが収益予測を超えるシナリオをモデル化
-
フェーズ3:契約交渉(4~8ヶ月)*
-
現実的な収益予測に合致する最小コミットメント(楽観的なシナリオではなく)を交渉
-
プロバイダーのパフォーマンス不足に対する意味のあるペナルティを伴うキャパシティ保証を確保
-
キャパシティが必要を超える場合に有効コストを削減するためのサブリース権を構築
-
GPU価格が20%以上低下した場合またはコンピュート要件が変わった場合の再交渉トリガーを含める
-
戦略的柔軟性を保持するために、ロックイン期間を最大3~4年に制限
-
フェーズ4:実行監視(継続中)*
-
実際と契約されたキャパシティを毎月追跡
-
プロバイダーの財務健全性とGPU配分状態を監視
-
継続計画として1~2の代替プロバイダーとの関係を維持
-
コンピュートコストと収益の四半期ごとのレビューで持続可能性の問題を早期に特定
リスク軽減フレームワーク
- 重要なリスクと軽減戦略:*
| リスク | 影響 | 軽減 |
|---|---|---|
| Lambdaキャパシティ不足 | トレーニング遅延、製品ローンチの遅延 | 20~30%の過剰キャパシティ契約を維持。AWS/Azureとの継続計画を開発 |
| Nvidia GPU供給中断 | キャパシティ削減のカスケード | GPU調達を多様化。Nvidiaと直接配分保証を交渉 |
| Anthropic収益不足 | コンピュートコストをサポートできない | 収益マイルストーンに関連する調整可能な最小値を伴う構造化契約。追加資金調達を確保 |
| コンピュートコストインフレ | マージン圧縮 | 3年間の価格をロック。CPI上限を含める。ボリュームディスカウントを交渉 |
| プロバイダー運用上の失敗 | 拡張停止、データ損失 | 99.9%のアップタイムSLAと財務ペナルティを要求。バックアップインフラストラクチャアクセスを維持 |
| 技術的破壊 | コンピュート要件の低下 | 契約再交渉トリガーを含める。コミットメント削減の柔軟性を維持 |
主要な洞察と実行可能なインサイト
- この取引がAIインフラストラクチャ戦略について明らかにすること:*
-
コンピュート容量は現在、戦略的資産です 。複数年のコミットメントと数十億ドルの資本を必要とします。確保されたキャパシティのない企業はモデルスケーリングにおいて競争上の不利に直面します。
-
専門化されたプロバイダーはハイパースケーラーの実行可能な代替案です 。ただし、運用上の優秀性とGPUアクセスを維持する場合に限ります。Lambdaの成功はこのモデルがスケールするかどうかを決定します。
-
ロックインは実在し、実質的です。 インフラストラクチャが展開されると、切り替えコストは法外に高くなり、プロバイダーに価格設定力を与え、顧客の柔軟性を制限します。
-
財務上の持続可能性は不確実です。 Anthropicが年間50~80億ドルのコンピュートコストをサポートするのに十分な収益を生成する能力は証明されていません。収益成長が停滞した場合、企業は構造的な収益性の課題に直面します。
-
AI企業向け:*
-
コンピュート要件を楽観的ではなく現実的に評価
-
実際の利用に基づいてコミットメントを調整する柔軟性を伴う契約を交渉
-
戦略的なオプション性を保持するために複数のプロバイダーとの関係を維持
-
異なる収益シナリオでコンピュートコストの持続可能性を示す財務モデルを構築
-
インフラストラクチャプロバイダー向け:*
-
専門化されたAIクラウドプロバイダーはハイパースケーラーに対抗するための検証されたプレイブックを持つようになりました
-
成功にはキャパシティ配信、アップタイム、顧客サポートの完璧な実行が必要です
-
Nvidiaの支援は重要な競争優位性を提供します。これらの関係を維持
-
カスタム最適化と深い顧客統合を通じて切り替えコストを構築
-
投資家向け:*
-
競合するAIラボがコンピュートコミットメントをどのように構成しているかを監視して、資本配分の優先順位の主要指標として
-
企業が収益軌道に基づいて契約されたコンピュートコストを現実的にサポートできるかを評価
-
契約の再交渉または紛争を監視して、財務上のストレスの早期警告兆候として
-
実行能力に基づいてインフラストラクチャプロバイダーを評価し、資金調達レベルではなく