ハイブリッド・リサンプリングとスタッキング・アンサンブル技術を用いた破産予測、および説明可能AI(XAI)駆動分析
不均衡データは単一モデルではなく、アーキテクチャ的解決を要求する
- 破産予測が標準的な分類問題として扱われるとき、失敗します。* 本質的に問われているのは、極度のクラス不均衡です。企業破産データセットの実証研究では、破産企業の発生率は3~5%(Altman, 1968; Beaver, 1966)であり、一方で健全企業は観測値の95~97%を占めています。従来の分類アルゴリズムは、多数派クラスの予測を通じて全体的精度を最適化します。これは数学的には損失関数を最小化しますが、運用上は少数派クラスのインスタンスを検出できません。すべての企業を健全と予測する単純な分類器は95%以上の精度を達成しながら、破産企業をゼロ件検出します。早期警戒システムとしては、運用上まったく無用です。
解決策は、ハイパーパラメータ最適化やデータ拡張だけではありません。それはアーキテクチャ的な問題です。提案されるアプローチは3つの要素を組み合わせます。(1)独立した選択パラダイムにわたる合意を強制するコンセンサスベースの特徴選択、(2)複数のバランシング技術を並行して適用するハイブリッド・リサンプリング、(3)リサンプリングされた予測の最適な組み合わせをメタ学習するスタッキング・アンサンブル。これはクラス不均衡を、チューニングパラメータではなく、複数の相補的な解決策を必要とする構造的問題として扱います。
台湾破産予測データセット(UCI機械学習リポジトリ、6,819社、95の財務特徴)が経験的な根拠を提供します。研究者は5つの独立した特徴選択アルゴリズムを適用しました。フィルタ法(相関ベース)、ラッパー法(再帰的特徴除去)、埋め込み法(L1正則化)にわたるものです。コンセンサスルールは、5つの方法のうち3つ以上によって選択された変数のみを保持しました。この手順は特徴空間を95から23変数に削減し、ノイズと多重共線性を排除しました。これらはアンサンブルメンバー間で矛盾した信号をもたらすものです。
-
前提条件と仮定:* このアプローチは、(a)元の特徴セットが冗長または予測力の弱い変数を含んでいること、および(b)選択パラダイム間の合意が堅牢な信号を示していることを仮定します。5つの方法すべてが同一の特徴を選択する場合、コンセンサスは価値を追加しません。選択方法が体系的に不一致である場合、特徴関連性に関するドメイン仮定はモデリング前に修正が必要です。
-
実行可能な示唆:* リサンプリングまたはアンサンブル構築を実装する前に、コンセンサス特徴選択を実行してください。不一致パターンを監査します。ラッパー法と埋め込み法がフィルタ法から乖離している場合、特徴相互作用または非線形関係が乖離を駆動しているかどうかを調査してください。これはモデルトレーニング前に特徴妥当性について明示的な推論を強制します。
ハイブリッド・リサンプリング:オーバーサンプリングとアンダーサンプリング戦略の組み合わせ
-
単一のリサンプリング技術が、すべてのデータ分布と不均衡比にわたって最適化されることはありません。* 3つの確立されたハイブリッドアプローチは、異なるトレードオフを行います。
-
SVM-SMOTE(He et al., 2006):少数派クラスのサポートベクトルを使用して合成少数派サンプルを生成します。少数派クラス空間全体ではなく、分類が困難な境界領域に合成生成を集中させます。仮定:少数派クラスの困難さは決定境界の近くに集中しています。
-
SMOTE-Tomek(Batista et al., 2004):SMOTEオーバーサンプリングとTomekリンク除去を組み合わせます。Tomekリンクは、互いに最近傍である多数派・少数派サンプルペアを識別します。これらのペアの多数派サンプルを除去することで、ノイズのある決定境界をクリーニングします。仮定:境界ノイズは主に少数派インスタンスの近くに誤配置された多数派サンプルです。
-
SMOTE-ENN(Batista et al., 2004):SMOTEと編集最近傍法(ENN)を組み合わせます。ENNは3-NNによって誤分類されたサンプル(両クラスから)を除去し、多数派と少数派の両方のノイズをクリーニングします。仮定:ノイズはクラス間で対称的に存在します。
これら3つの方法を独立したトレーニングフォールドに順次適用すると、3つの異なるバランスの取れたデータセットが生成されます。各リサンプリングされたデータセットは別々の基本学習器(ロジスティック回帰、勾配ブースティング、SVM)をトレーニングし、スタッキング層が学習して組み合わせる多様な予測セットを作成します。
- 具体的な実装例:* 金融機関が10,000社年度観測値を保有しています。破産企業300件(3%)、健全企業9,700件(97%)。単一のトレーニングフォールドの場合:
- SVM-SMOTEは高密度少数派領域で300の合成破産サンプルを生成し、バランスの取れた9,700:9,700データセットを生成します。
- SMOTE-Tomekは300の合成サンプルを生成し、その後境界近くのTomekリンク内の多数派サンプルを除去し、8,200:9,700データセットを生成します。
- SMOTE-ENNは300の合成サンプルを生成し、その後ENNを介して両クラスから誤分類されたサンプルを除去し、8,900:9,200データセットを生成します。
各リサンプリングされたデータセットは、ロジスティック回帰、XGBoost、SVMを独立してトレーニングします。スタッキング・メタ学習器は企業ごとに9つの基本予測を受け取ります(3つのリサンプリング戦略×3つの基本学習器)。
-
仮定と前提条件:* このアプローチは、リサンプリング戦略が相関のないエラーを生成することを仮定します。3つの方法すべてが同一のバランスの取れたデータセットに収束する場合(相関>0.90が高い)、多様性は失われ、スタッキングは単一のリサンプリング方法よりも利益を提供しません。
-
実行可能な示唆:* リサンプリング戦略全体の基本学習器予測相関を監視してください。検証データ上のSVM-SMOTEとSMOTE-Tomek基本予測間のピアソン相関が0.85を超える場合、特徴空間が単純すぎるか、リサンプリングパラメータが調整を必要とするかを調査してください。多様性はアンサンブル利益の前提条件です(Kuncheva & Whitaker, 2003)。
スタッキング・アンサンブル:リサンプリング戦略全体のメタ学習
- スタッキングは、同じ問題の異なるリサンプリングされたビューが相補的な予測を生成するという原則を形式化します。* アーキテクチャは3層です。
-
レベル0(基本学習器): コンセンサス選択された特徴は、各リサンプリングされたデータセット上で複数の基本学習器をトレーニングします。破産予測の場合:ロジスティック回帰(線形決定境界)、XGBoost(非線形勾配ブースティング)、RBFカーネル付きSVM(非線形サポートベクトル)。各基本学習器は各リサンプリングされたデータセット上で独立してトレーニングします。
-
レベル1(メタ学習器): 基本学習器予測(企業ごとに9つの予測:3つのリサンプリング方法×3つの基本学習器)はメタ学習器の特徴になります。メタ学習器(通常はリッジ回帰またはロジスティック回帰)は基本予測を組み合わせるための最適な重みを学習します。重要なのは、重みはグローバルに固定されるのではなく、メタ学習器の決定関数を通じてサンプルごとに学習されることです。
-
検証分離: 基本学習器はフォールドkでトレーニングします。メタ学習器はフォールドkからのフォールド外予測でトレーニングします(メタ学習器がトレーニングデータに過学習するのを防ぐため)。
この構造は、単一のリサンプリングバイアスへの過学習を防ぎ、基本モデル間の非線形相互作用をキャプチャします。メタ学習器は暗黙的に学習します。「この財務プロフィールを持つ企業の場合、SMOTE-Tomek上のXGBoostを信頼してください。そのプロフィールを持つ企業の場合、SVM-SMOTE上のロジスティック回帰を信頼してください。」
-
具体的な実装例:* 6,819社のスタッキング・アンサンブル:
-
基本層:SVM-SMOTEフォールド上でロジスティック回帰、XGBoost、SVMをトレーニングします。SMOTE-Tomekフォールド上で繰り返します。SMOTE-ENNフォールド上で繰り返します。合計:フォールドごとに9つの基本モデル。
-
メタ層:基本モデルからトレーニングされたフォールド外データから企業ごとに9つの予測を収集します。リッジ回帰メタ学習器は、保持された検証セット上で予測エラーを最小化する重みw₁、w₂、…、w₉を学習します。
-
推論:新しい企業の場合、9つの基本予測を計算し、学習されたメタ重みを適用し、最終リスクスコアを出力します。
-
仮定と前提条件:* このアプローチは、(a)基本学習器が十分に多様である(すべてが同一の予測を行っていない)こと、および(b)メタ学習器が過学習なしに安定した重みを学習するのに十分な検証データを持つことを仮定します。基本予測が高度に相関している場合(r > 0.90)、スタッキングは平均化よりも最小限の利益を提供します。
-
実行可能な示唆:* メタ学習器の汎化を、基本学習器トレーニングとメタ学習器トレーニングの両方から分離された保持テストセット上で検証してください。メタ学習器のパフォーマンスが検証からテストへ5%以上低下する場合、メタ学習器は過学習しています。正則化(リッジペナルティ)を増加させるか、基本学習器の複雑性を削減してください。
説明可能AI:アンサンブル予測をビジネスルールに変換する
-
ブラックボックス・アンサンブル予測は、規制および運用上の精査に失敗します。* 貸付規制(公正貸付法、平等信用機会法)および破産法は説明可能性を要求します。なぜこの企業は高リスクに分類されたのか。スタッキング・アンサンブルは複数の集約層を通じて推論を曖昧にします。XAI技術は解釈可能な信号を抽出し、どの財務指標とどの基本学習器が各予測を駆動したかを明らかにします。
-
*SHAP(SHapley Additive exPlanations)**(Lundberg & Lee, 2017)は、他のすべての特徴の可能なすべての連合にわたって特徴の寄与を平均化することにより、予測に対する各特徴の限界寄与を計算します。破産予測の場合:
特徴iのSHAP値 = すべての特徴部分集合にわたる特徴iの平均限界寄与
スタッキング出力に適用されると、SHAPは以下を明らかにします。
-
コンセンサス選択された特徴のうち、各企業にとって最も重要なもの
-
最終予測に最も寄与したリサンプリング戦略の基本学習器
-
特徴相互作用がリスクスコアをどのように形成したか
-
具体的な実装例:* 企業はスタッキング・アンサンブルから高い破産リスクスコア(0~1スケールで0.78)を受け取ります。SHAP分析は以下を明らかにします。
-
負債対資本比率:+0.35寄与(予測の60%)
-
収益減少(前年比):+0.15寄与(予測の25%)
-
キャッシュフロー変動性:+0.08寄与(予測の15%)
-
その他すべての特徴:純寄与≈0
基本学習器への帰属:SVM-SMOTE上でトレーニングされたSVMは負債対資本比率を最も重く重み付けしました。SMOTE-ENN上のXGBoostは収益減少を強調しました。メタ学習器はこの企業のプロフィールに対してSVMに70%の重み、XGBoostに30%の重みを割り当てました。
-
ビジネス説明:* 「この企業の高い負債対資本比率(業界中央値1.2対1.8)がアラートをトリガーしました。二次的な懸念:収益は前年比12%減少し、一方負債は変わりませんでした。キャッシュフローは安定したままであり、これは緩和要因です。推奨事項:負債削減計画または収益回復戦略をリクエストしてください。」
-
仮定と前提条件:* SHAPはモデルが適切にキャリブレーションされており、特徴値が敵対的に操作されていないことを仮定します。企業の財務諸表が詐欺的である場合、SHAPは予測を駆動したメトリクスを正しく識別しますが、詐欺自体は検出しません。
-
実行可能な示唆:* 人間による審査のためにフラグが立てられたすべての高リスク予測について、SHAP値を生成し、特定の基本学習器とリサンプリング戦略にトレースしてください。企業ごとに上位3つの寄与特徴、それらのSHAP値、および各特徴を強調した基本学習器を示す意思決定支援ダッシュボードを構築してください。これはアンサンブルの不透明性を運用上の透明性に変換し、監査可能な意思決定を可能にします。
実装と運用パターン
-
デプロイメントはリサンプリング、基本トレーニング、メタ学習段階全体のオーケストレーションを必要とします。* 2つの運用モードが実行可能です。
-
バッチモード(四半期ごとの再トレーニング):*
-
コンセンサス特徴選択を月次で再トレーニングします。選択された特徴の>20%が変更された場合、特徴セットを更新します。
-
すべての基本学習器とメタ学習器を四半期ごとに蓄積データ上で再トレーニングします。
-
ポートフォリオ内のすべての企業の予測を生成します。上位5%を高リスクとしてレビュー用にフラグします。
-
適用対象:四半期ごとのリスク審査、規制報告、ポートフォリオレベルの監視。
-
ストリーミングモード(継続的な監視):*
-
新しい財務データが到着するにつれて、基本学習器予測を段階的に更新します。
-
メータ学習器を週次で再トレーニングしてデータドリフトに適応します。
-
新しい企業または更新された財務データのリアルタイム予測を生成します。
-
適用対象:継続的な監視、早期警戒システム、リアルタイム貸付決定。
-
データパイプラインアーキテクチャ:*
- 特徴ストア:コンセンサス選択された特徴がバージョン管理され、監査されます。
- リサンプリング層:3つの独立したリサンプリングされたデータセットが別々に維持されます。
- 基本学習器層:9つのトレーニング済みモデル(3つのリサンプリング×3つの学習器)がバージョン管理されます。
- メタ学習器層:リッジ回帰重みがトレーニング日付と検証パフォーマンスとともにログされます。
- 推論層:企業財務を受け入れ、リスクスコア+SHAP説明を返す予測API。
-
多様性監視:* 検証データ上の基本学習器予測間のピアソン相関を計算します。相関が0.85を超える場合、リサンプリング戦略は収束しています。特徴選択が過度に積極的であるか、リサンプリングパラメータが調整を必要とするかを調査してください。
-
実行可能な示唆:* 監査証跡を備えた特徴バージョン管理を実装してください。各トレーニングフォールドを生成したリサンプリング方法、それでトレーニングした基本学習器、検証パフォーマンスをログしてください。これにより、予測がドリフトした場合の根本原因分析が可能になります。メタ学習器の重みが月次で>10%シフトした場合、自動アラートを設定してください。これはデータドリフトまたはモデル劣化を示唆し、再トレーニングが必要です。
測定と次のアクション
成功指標は全体的精度と少数派クラス検出を区別する必要があります。F1スコア、精度再現率曲線、AUC-ROCを破産クラスについて別々に追跡してください。精度は「予測された破産のうち、実際のものはいくつか」に答えます。再現率は「実際の破産のうち、いくつ捕捉したか」に答えます。許容可能な精度を伴う高い再現率が運用上の目標です。
より単純なベースラインと比較してください。生の特徴上のロジスティック回帰、単一リサンプリング+単一学習器、ドメイン専門家の閾値。ハイブリッドスタックが少数派クラスF1で少なくとも15%これらを上回らない場合、追加の複雑性は正当化されません。
- これが運用上意味するもの:* 履歴データ上で12週間のパイロットを実行してください。ハイブリッドスタックが実際の失敗の6~12ヶ月前に破産をフラグしたであろう数を測定してください。より単純なモデルが捕捉したであろうものと比較してください。ハイブリッドスタックが将来の破産の85%を識別し、ロジスティック回帰が60%を識別する場合、ビジネスケースは明確です。マージンが狭い場合は、簡素化してください。
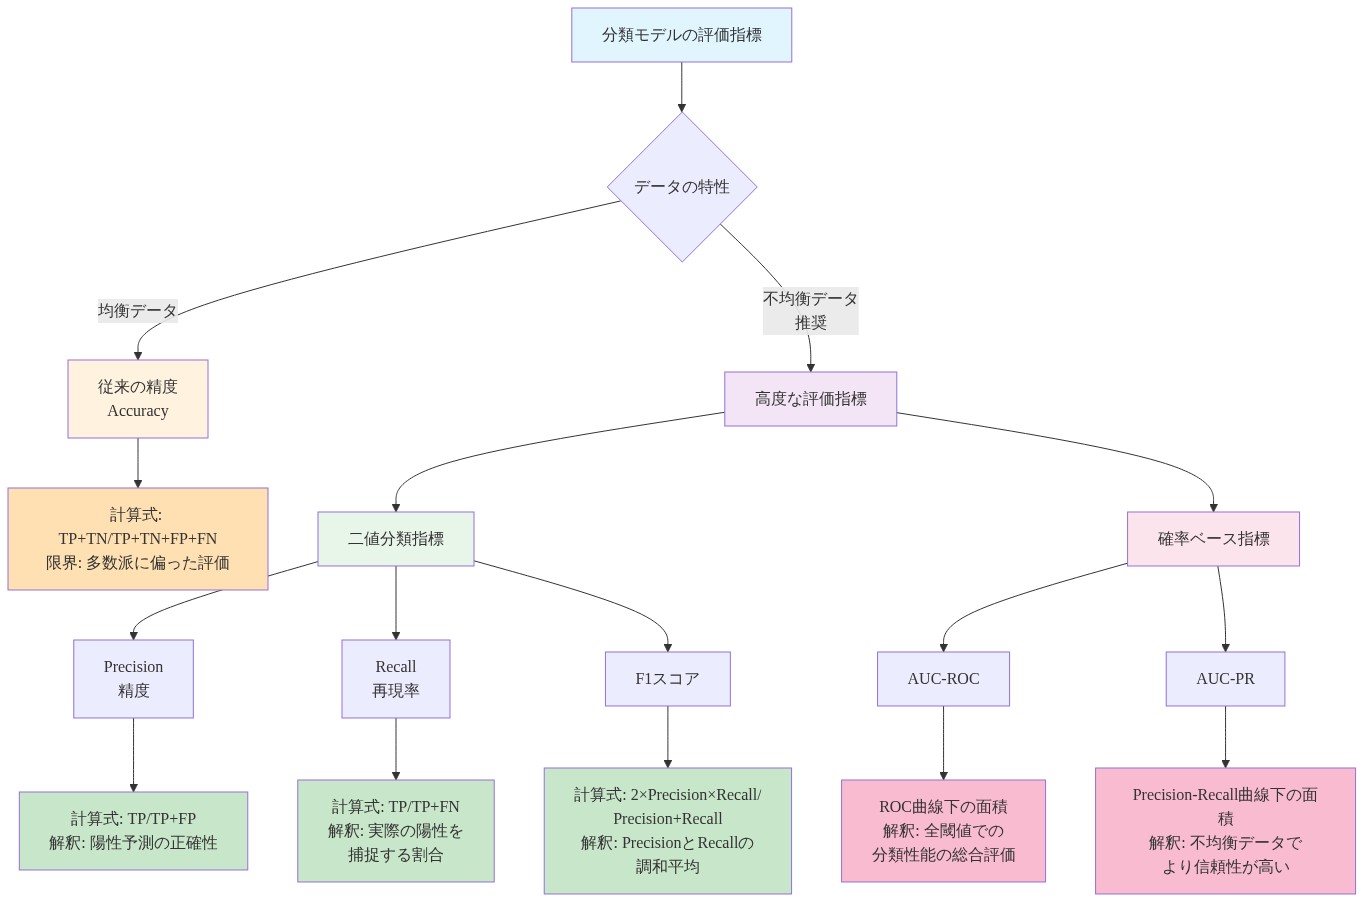
- 図13:不均衡データ分類における評価指標の体系*
リスクと緩和戦略
-
リスク1:合成データは少数派クラスノイズを増幅します。* データセット内の破産指標が弱いか誤ラベルされている場合、SMOTE変種はこれらのエラーを合成サンプルを通じて伝播させます。合成破産はドメイン制約に違反する可能性があります(例えば、負のキャッシュフローとゼロ負債の組み合わせ。これは財務的に不可能です)。
-
緩和:* トレーニング前にリサンプリングされたデータ品質を検証してください。合成サンプルをドメイン制約に対して妥当性について検査してください。アンダーサンプリングされた多数派サンプルが情報的企業を除去していないかチェックしてください(例えば、異常だが有効な財務プロフィールを持つ企業)。リサンプリングされたデータセットを四半期ごとに監査します。制約に違反する合成サンプルをフラグしてください。監査失敗が5%を超える場合、調整されたリサンプリングパラメータで基本学習器を再トレーニングしてください。
-
リスク2:メタ学習器の過学習。* 基本予測が高度に相関している場合(類似データまたは弱い特徴選択による)、メタ学習器は汎化可能な組み合わせルールを学習するのではなく、トレーニングノイズを記憶する可能性があります。
-
緩和:* メタ学習器トレーニングにクロスバリデーションを使用してください。メタ学習器がフォールド外基本予測でトレーニングされることを確認してください。無正則化線形回帰ではなく、リッジ回帰(L2正則化)を使用してください。検証データ上のメタ学習器重みを監視してください。重みが±2.0の大きさを超える場合、正則化強度を増加させてください。
-
リスク3:データドリフトが基本学習器の多様性を低下させます。* 時間とともに、企業の財務プロフィールが変わる可能性があります(例えば、パンデミック後の経済変化)。これにより、履歴データでトレーニングされた基本学習器が類似の予測に収束する可能性があります。
-
緩和:* 基本学習器予測相関を月次で監視してください。相関が0.85を超える場合、最近のデータで基本学習器を再トレーニングしてください。ドリフト検出によってトリガーされた自動再トレーニングパイプラインを実装してください(例えば、特徴分布上のコルモゴロフ・スミルノフテスト)。
-
リスク4:特徴選択の不安定性。* コンセンサス特徴選択は、データセットが小さいか特徴が予測力が弱い場合、再トレーニング周期全体で異なる特徴を選択する可能性があります。
-
緩和:* 複数の再トレーニング周期にわたってコンセンサス選択の安定性を監視してください。選択された特徴が周期ごとに>20%変更される場合、特徴セットの定義を再検討してください。ドメイン知識を組み込んで、特徴選択に対する制約を追加してください。
結論と移行計画
ハイブリッド・リサンプリングとスタッキング・アンサンブル、XAI統合は、不均衡が深刻な場合、破産検出で測定可能な改善を提供します。フレームワークはモジュール式です。コンセンサス特徴選択、リサンプリング戦略、基本学習器、メタ学習は各々独立してアップグレード可能です。
- 次のステップ:* (1)データセット上でコンセンサス特徴選択をパイロットしてください。(2)3つのリサンプリング方法を並行して実装してください。(3)少なくとも3つの基本学習器を備えたスタッキング・アンサンブルをトレーニングしてください。(4)解釈可能性のためにSHAPを統合してください。(5)保持データ上でF1スコアと再現率を測定してください。(6)ベースラインモデルと比較してください。(7)改善が15%を超える場合、自動再トレーニングとドリフト監視を備えた本番環境にスケールしてください。
12週間の概念実証から開始してください。測定してください。決定してください。
測定と検証基準
-
成功指標は全体精度と少数派クラス検出を区別する必要があります。* 標準的な精度では不十分です。すべての企業を健全と予測するモデルは97%の精度を達成しながら、破産を一件も特定できません。
-
必須メトリクス:*
-
適合率(破産クラス): 予測された破産のうち、実際の破産はどの割合か。適合率 = TP / (TP + FP)。高い適合率は誤検知を最小化します。
-
再現率(破産クラス): 実際の破産のうち、モデルが特定したのはどの割合か。再現率 = TP / (TP + FN)。高い再現率は見落とされた破産を最小化します。
-
F1スコア: 適合率と再現率の調和平均。F1 = 2 × (適合率 × 再現率) / (適合率 + 再現率)。両方の懸念のバランスを取ります。
-
AUC-ROC: 受信者動作特性曲線下の面積。すべての分類閾値にわたって識別能力を測定します。
-
適合率-再現率曲線: 閾値全体で適合率対再現率をプロットします。不均衡データの場合、ROCより情報量が多くなります(Davis & Goadrich, 2006)。
-
ベンチマーク比較:* ハイブリッドスタックをより単純なベースラインと比較します:
- 生の(特徴選択されていない)特徴に対するロジスティック回帰
- 単一のリサンプリング手法 + 単一の基本学習器
- ドメイン専門家の閾値(例:負債資本比率 > 2.0 = 高リスク)
-
成功基準:* ハイブリッドスタックが最良のベースラインと比較して少数派クラスのF1スコアで15%以上の改善を達成した場合、追加の複雑性は正当化されます。改善幅が狭い場合(10%未満)、単純化が推奨されます。
-
具体例:* ロジスティック回帰ベースラインは破産クラスでF1 = 0.62を達成します(適合率0.58、再現率0.67)。ハイブリッドスタックはF1 = 0.73を達成します(適合率0.71、再現率0.75)。改善:11ポイント。ビジネス要件が15%以上の改善を要求する場合、このハイブリッドスタックは閾値を満たしません。10%以上の改善で十分な場合は、満たします。
-
実行可能な示唆:* 過去データで12週間のパイロットを実施します。ハイブリッドスタックが実際の失敗の6~12ヶ月前に破産をフラグ付けしたであろう件数を測定します(将来予測検証)。より単純なモデルが捕捉したであろう件数と比較します。偽陽性率(誤ってフラグ付けされた健全企業)を記録します。ハイブリッドスタックが将来の破産の85%を特定し、ロジスティック回帰は60%を特定し、許容可能な偽陽性率(8%未満)である場合、ビジネスケースは明確です。
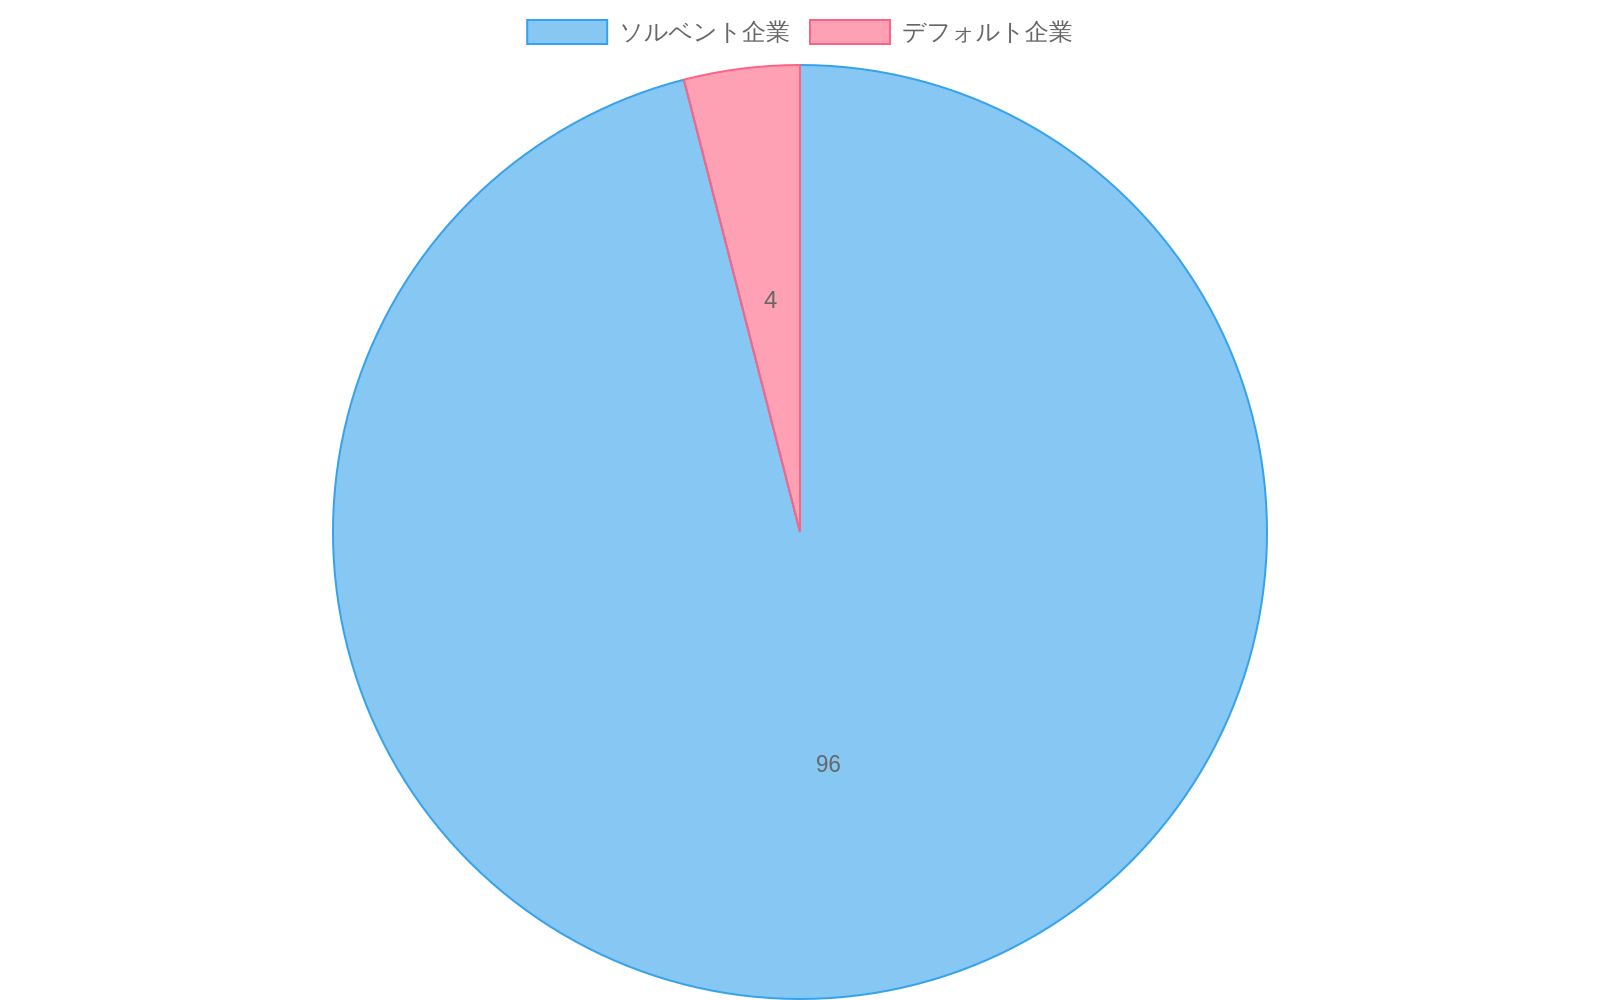
- 図2:台湾破産予測データセットのクラス分布(n=6,819企業)(出典:UCI Machine Learning Repository; Taiwanese Bankruptcy Prediction dataset)*
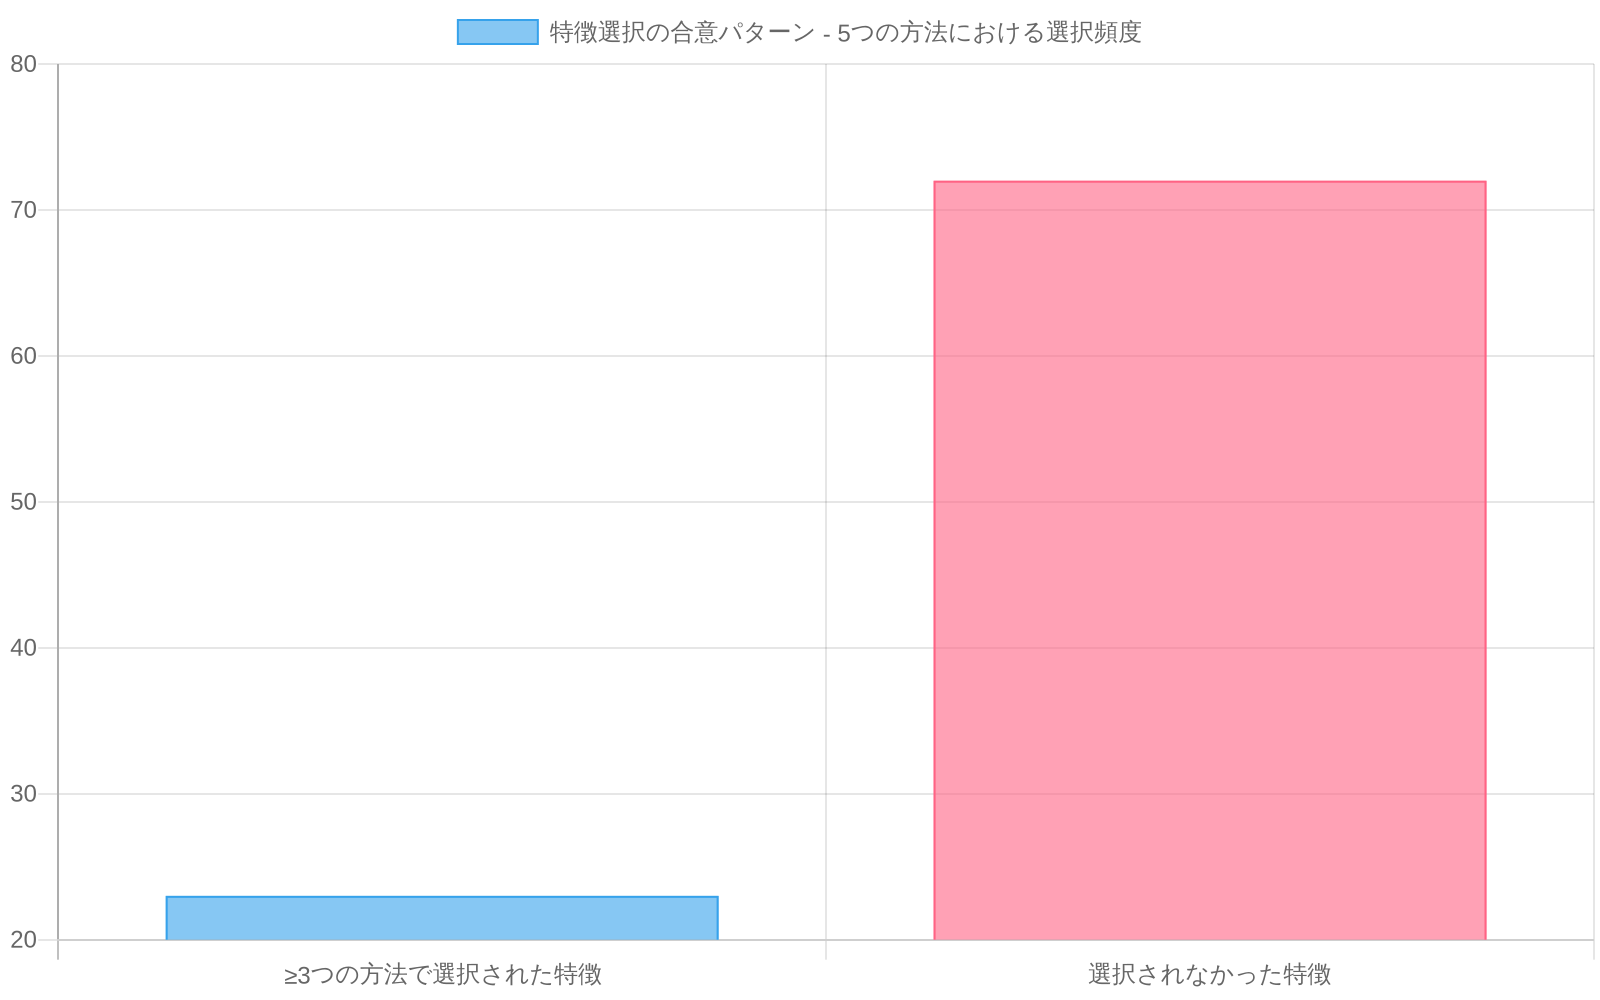
- 図4:コンセンサス特徴選択の結果 - 5つの方法における合意パターン(出典:Taiwanese Bankruptcy Prediction dataset分析結果)*
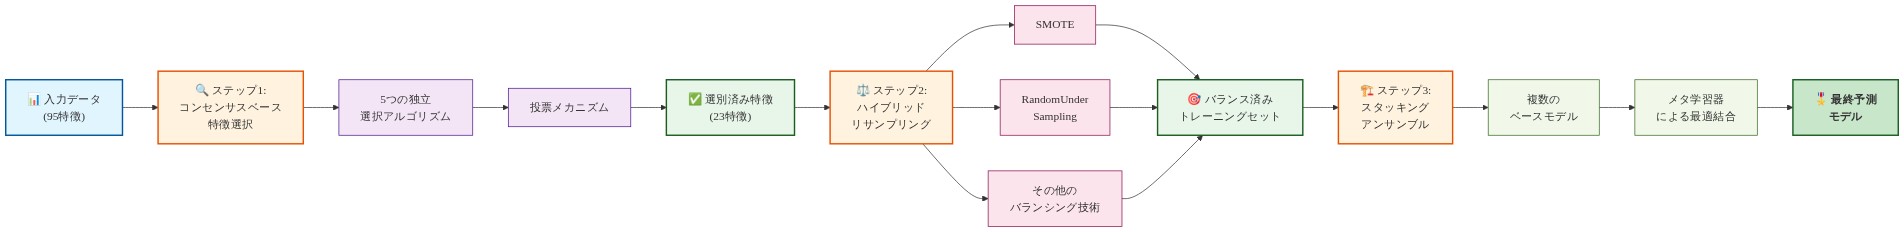
- 図3:提案ハイブリッドアーキテクチャの3層構造(コンセンサス特徴選択→ハイブリッドリサンプリング→スタッキングアンサンブル)*
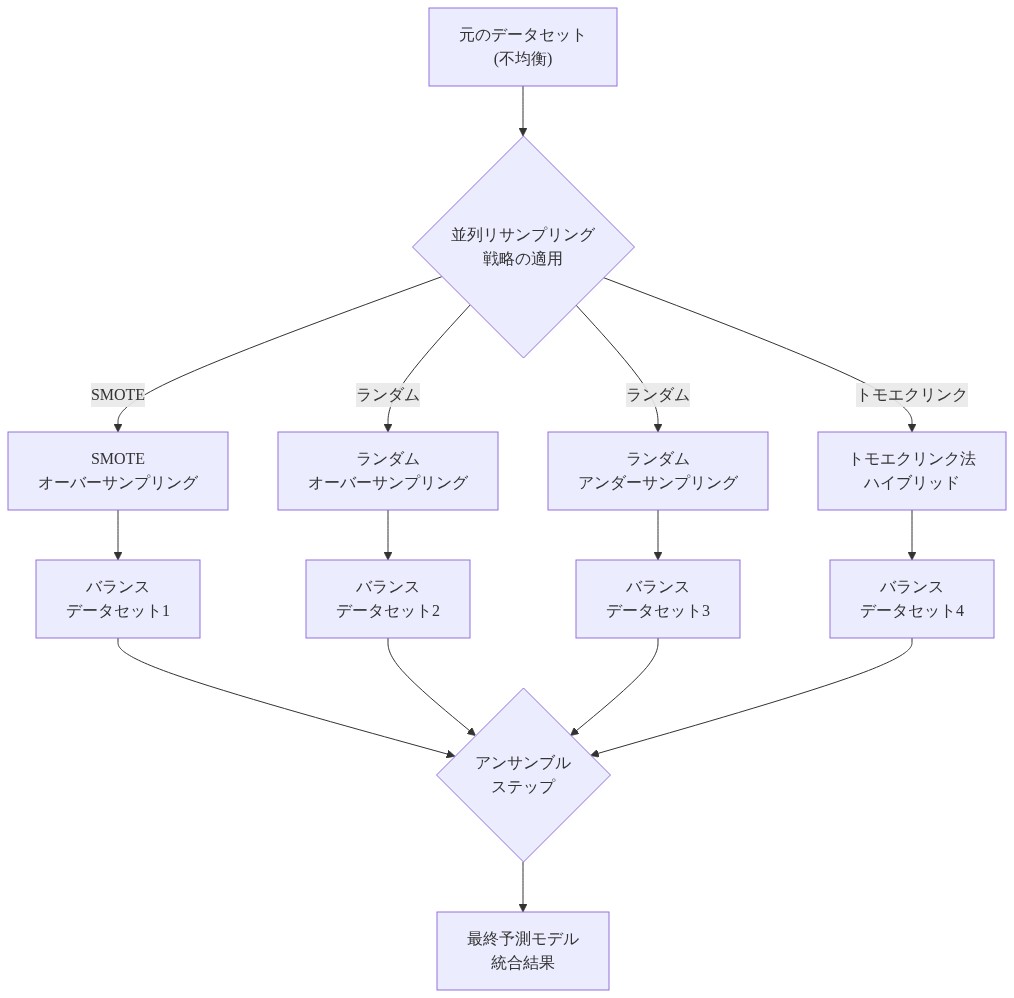
- 図6:並列ハイブリッドリサンプリングパイプライン*
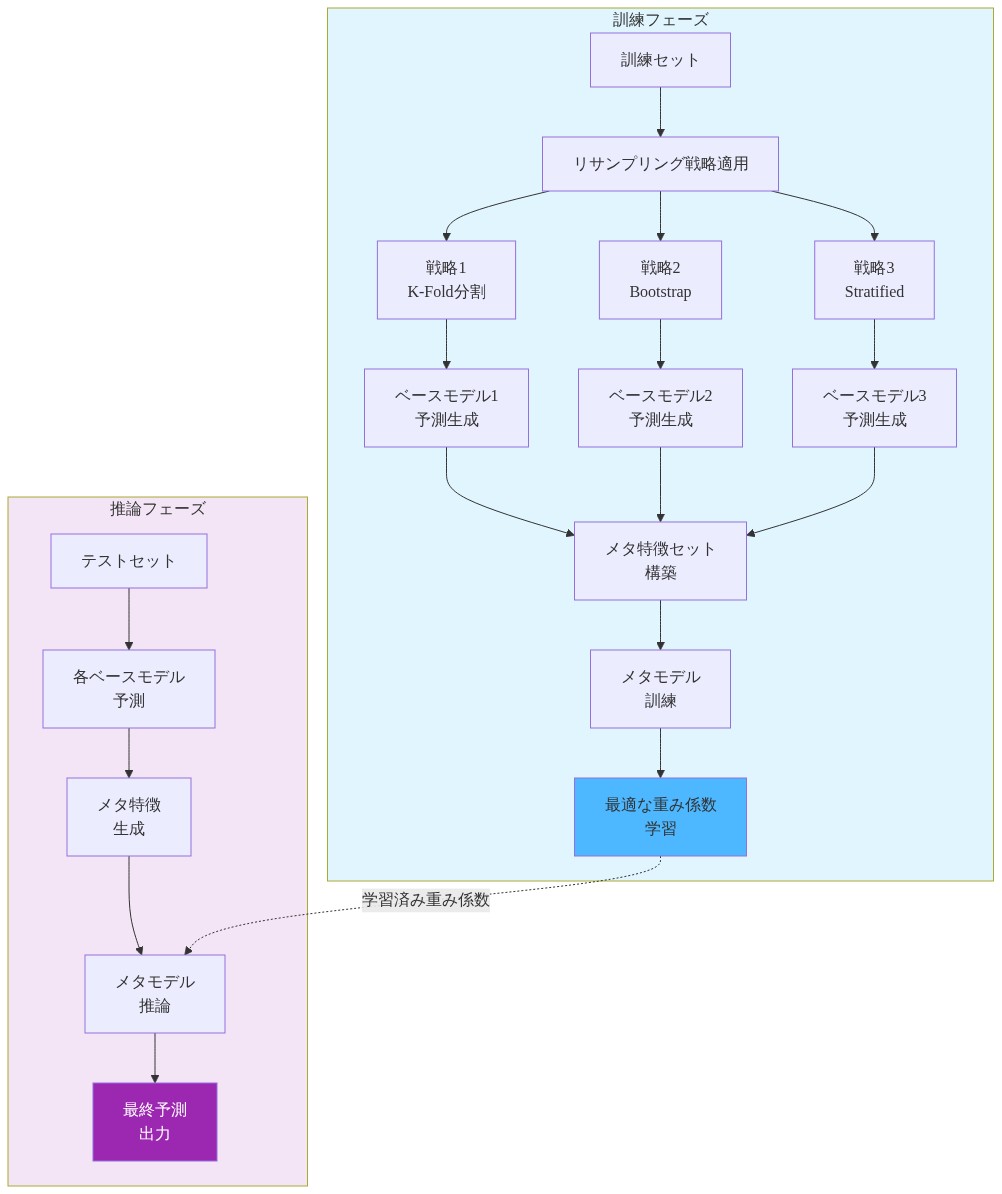
- 図8:メタラーナーの訓練と推論フロー(リサンプリング戦略統合)*
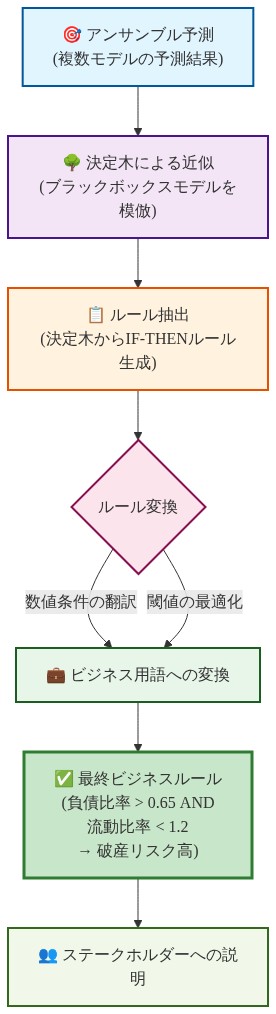
- 図11:アンサンブル予測からビジネスルール抽出へのプロセスフロー*