自動化したい選択があると、まず大規模言語モデル(LLM)や機械学習のパイプラインを思い浮かべる人が多い。柔軟で、誰でも使える。手が伸びるのは自然なことだ。
ただ、世の中の判断の多くは範囲が狭い。いくつかの選択肢に順位をつける。依頼の送り先を決める。
決まった範囲のなかで承認するか却下するか選ぶ。こうした仕事なら、目的に絞って作った小さな判断モデルのほうが、汎用のシステムよりうまくいくことが多い。
コスト、速さ、結果の読みやすさ、そしてなぜその選択になったかを説明できる点で、差が出る。
この記事のポイント
- 手作りの判断モデルは、守備範囲を絞る代わりに精度を取る。安く、速く、説明しやすい。
- いちばん難しいのは計算ではなく、判断が何に左右されるのかを言葉にすることだ。
- 過去の判断は、口で語る優先順位より本当の優先順位をよく映す。
小さな判断モデルが汎用モデルに勝つとき
汎用モデルは、ほとんど何でもこなせるように作られている。答えの決まっていない問題なら、その柔軟さには大きな価値がある。しかし、仕事の範囲がはっきり決まっているなら、その柔軟さはむだになる。
狭い判断では、入力の種類も結果の種類も決まっている。何をもって「よい」とするかも見えている。
汎用モデルは、そうした判断には要らない能力まで抱えている。その能力にもお金がかかり、応答は遅くなり、動きも読みにくくなる。
専用モデルは、逆の取引をする。ひとつの仕事をきちんとこなすのだ。 その代わりに、次のものが手に入る。
- 低いコスト:スコア関数やルール集は、ふつうのハードウェアで動く。呼び出しごとの料金もかからない。
- 短い待ち時間:判断はミリ秒で返る。振り分けやリアルタイムの承認では、これが役に立つ。
- 読みやすさ:同じ入力なら、いつでも同じ出力になる。
- 説明のしやすさ:関係者は、数時間ではなく数分で筋道をたどれる。
どちらを選ぶかは、思想の問題ではなく、技術者としての判断だ。次の3つの問いが手がかりになる。
| 問い | 専用モデル向き | 汎用モデル向き |
|---|---|---|
| 判断を左右する要素はいくつか | 測れるものが数個 | 多く、定義があいまいか、変わり続ける |
| 過去の判断の記録はあるか | あり、結果も分かっている | ほとんどない |
| 無関係な分野をまたぐ仕事か | いいえ、ひとつの分野で完結する | はい、幅広い推論が要る |
現実の業務の多くは、両者のあいだにある。たとえば、サポート窓口で汎用モデルが自由記述のクレームを要約する。
次に、小さな明示的モデルが、どのチームに回すかを決める。こうした組み合わせの設計は、両方の長所を取り込みやすい。それぞれの部品が、得意な部分を受け持つからだ。

表1:カスタムモデルと汎用モデルの選択判断基準
あいまいな判断を、はっきりした基準に変える
判断モデルづくりが失敗するのは、たいてい計算の段階ではない。判断が何に左右されるのか、誰も合意できていないときに失敗する。
組織の判断の多くは、直感に頼っている。経験豊富な人は、どの候補者を採るべきか、どの依頼が急ぎかを「なんとなく分かる」。その判断をモデルに写すには、名前をつけて測れる部品に分けるしかない。
手順は、たいてい4つの段階を踏む。
- 要素を挙げる:採用の判断なら、技術力、コミュニケーション、社風との相性、伸びしろなどが考えられる。
- 要素ごとに、測れる形で定義する:「コミュニケーション」は、構造化面接の点数や、文書化した評価基準にもとづく評価にできる。
- 相対的な重要度を決める:技術力は伸びしろの2倍の重みか、それとも同じ重みか。
- 要素の組み合わせ方を選ぶ:組み合わせ方によって、境目でのモデルの振る舞いが変わる。
よく使う組み合わせ方には、それぞれ得手不得手がある。
| 方式 | 強み | 弱み |
|---|---|---|
| 重み付きの合計 | 分かりやすく、要素間のトレードオフがなめらか | すべての要素を同じ物差しで比べられる前提になる |
| ルールの連鎖 | 絶対条件や明確な優先順位を表せる | 例外が増えるともろくなる |
| しきい値 | 作りやすく、説明しやすい | 白か黒かで、境目付近の微妙な差を拾えない |
| 一対一の比較 | 優先順位の選択を明示させられる | 要素が数個を超えると現実的でない |
実際に動いているモデルは、これらを混ぜていることが多い。しきい値で、最低基準を満たさない選択肢をふるい落とす。
残ったものを、重み付きの合計で順位づけする。そんな具合だ。
過去の判断が教えてくれること
基準を明示すると、同じ言葉の裏に隠れていた意見の食い違いが見えてくる。2人のマネージャーが、どちらも「相性」を重視すると言う。
ところが、頭にある中身は別々だったりする。あるチームは、ある資質を最優先すると言いながら、実際にはいつも別の資質で選んでいる。
ここで役に立つのが、過去の判断という証拠だ。そこには、人が何を大事にすると言ったかではなく、実際に何をしたかが残っている。
たとえば、技術の点数は満点なのにコミュニケーションが弱い候補者を、チームが3人続けて落としたとする。この傾向は、チームが掲げる優先順位より、実際にはコミュニケーションが重く見られていることを示している。
掲げた優先順位だけで作ったモデルは、これを見落とす。
とはいえ、過去がいつも正しい目標とは限らない。以前の判断には、偏見や時間の圧力、いまはもう当てはまらない事情が混じっているかもしれない。
言葉にした優先順位と、行動に表れた優先順位を比べるのは、議論のきっかけとして使うのがよい。
どちらかを自動的に採用するものではない。目指すのは、チームが胸を張って説明できる基準の組だ。過去の癖を完璧に写したものではない。
限られた領域のなかで、自律に柵を立てる
判断モデルがうまく働くのは、取れる行動の範囲が決まっていて、成功の目印がはっきりしているときだ。その範囲のなかなら、モデルは本物の自律性を持って動いても安全でいられる。
具体例が、チップ設計にある。OpenAIは、自社の言語モデルを使ってチップ「Jalapeño」の設計を助けた。このシステムの自律性は本物だったが、柵で囲まれていた。
1 モデルは選択肢を提案し、そこから選んだ。
周りのツールが、守るべき限界を強制し、フィードバックを返した。これは汎用モデルの事例だが、考え方は小さな専用システムにも通じる。選ぶのはモデルに任せ、境界を守るのは別の仕組みに任せるのだ。
柵を決める
柵がうまくできているシステムには、3つの要素がはっきり定義されている。
- 許された行動:モデルが出してよい出力の全体。承認、却下、上位への引き継ぎなど。
- 測れる目的:モデルが最適化しようとするもの。確認できる形で書く。
- 独立したチェック:モデルが何を勧めても、すべての出力に対して走るルール。
好みとルールを分ける
きれいな設計では、システムを2つの層に分ける。
スコアリング層は、好みを表す。要素に重みをつけ、選択肢に順位をつける。判断やトレードオフはここにあり、調整もここで行う。
検証層は、破れないルールを表す。何かを比べて重みづけすることはしない。出力が許されるものかどうかを確かめ、許されなければ止める。
| 層 | 役割 | 変更の頻度 |
|---|---|---|
| スコアリング | 重み付きの好みで選択肢に順位をつける | 優先順位が変わるたびに、よく変える |
| 検証 | 法律、安全、容量の限界を守らせる | めったに変えず、変えるときは正式な審査を経る |
この分け方は、実際には次のように働く。
- ローンの承認:スコアリング層は、申込者を信用リスクの低い順に並べる。検証層は、それとは別に、申込者が規制上のしきい値を満たすかを確認する。スコアが高くても、チェックに落ちれば覆せない。
- サポートの振り分け:スコアリング層は、チケットにいちばん合うチームを選ぶ。検証層は、そのチームがその種類の問い合わせを扱っていて、手が空いているかを確認する。
こうして分けておくと、システムの筋道を追いやすくなる。コンプライアンスのルールを弱めてしまう心配なしに、重みを調整できる。
モデル全体を調整し直さずに、ルールを更新できる。モデルは柵の内側で最適化し、柵は系統的な失敗から守る。
モデルが正しいか、そしてなぜ正しいかを確かめる
もっともらしい出力を出すモデルが、信頼できるとは限らない。もっともらしさは簡単に手に入り、正しさと取り違えやすい。
検証では、2つの別々の問いを立てる。判断は正しいか。そして、その説明は、結果を本当に動かしたものを映しているか。
この節のポイント
- 説明には、安定性(似た入力なら似た理由になる)と忠実性(述べた理由が、モデルが実際に使ったものと一致する)が要る。
- 摂動テスト、要素の除去、専門家と
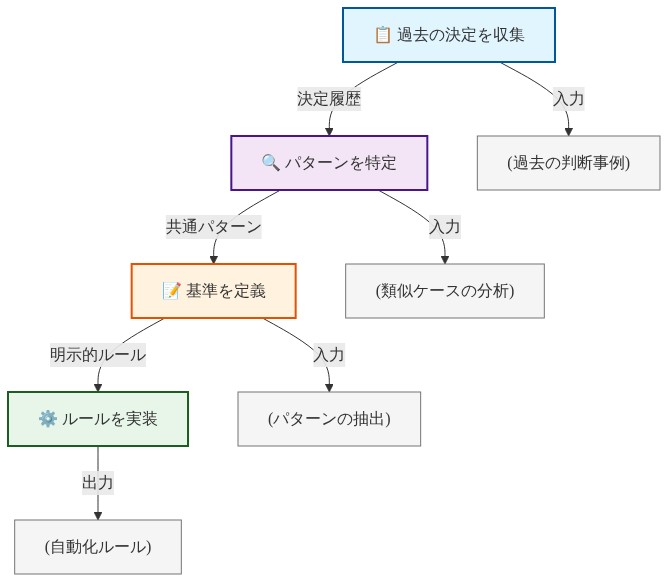
図5:判断の明示化プロセス(4ステップ)
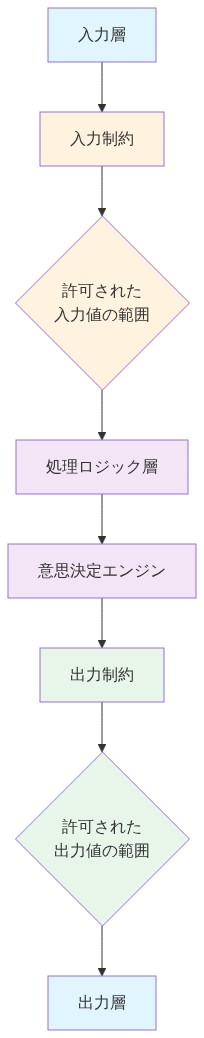
図7:意思決定モデルの制約設定構造
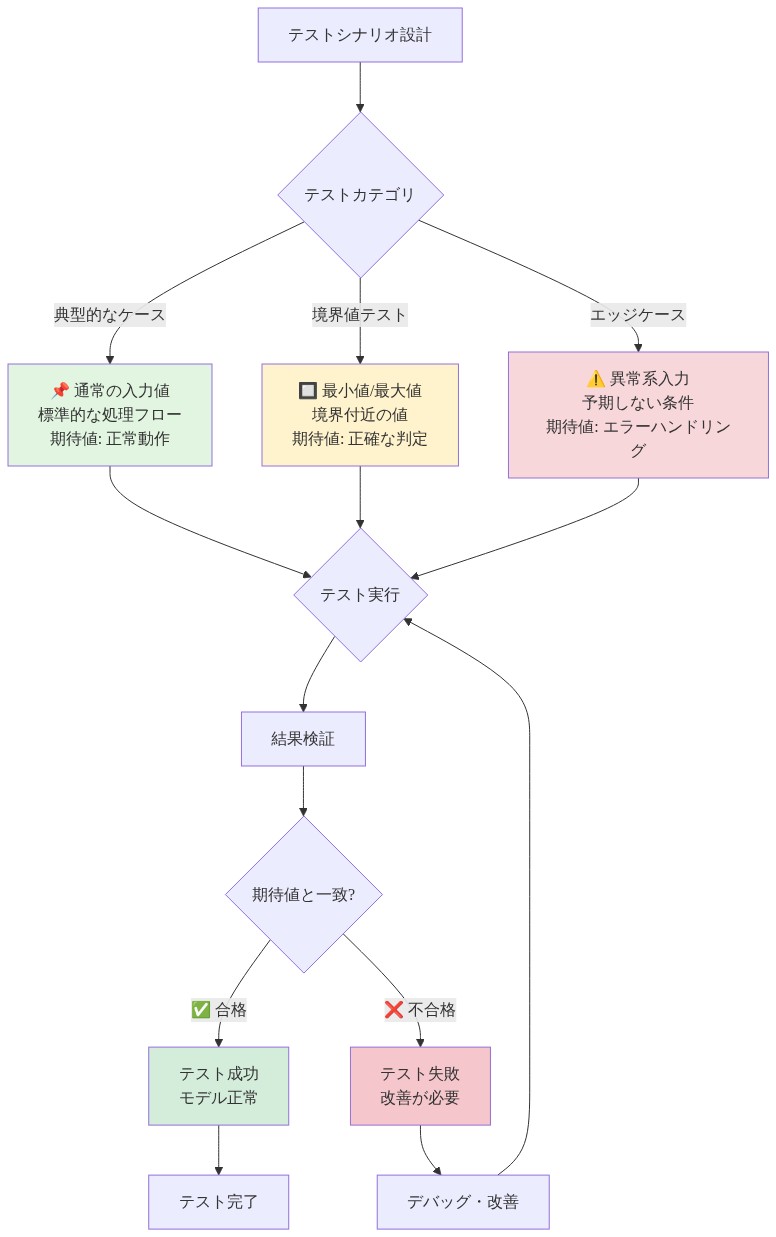
図9:包括的なテストシナリオ設計フロー