スクロール動作を通じたスクレイパーボット検出
テーゼ
スクロール動作検出がボット検出メカニズムとして機能するのは、人間のスクロールが再現可能な二次特性を示すためです。速度分布、読書に相関した滞在パターン、コンテンツ認識的な時間的リズムといった特性は、自動化システムが計算オーバーヘッドなしに複製することができません。そしてそのオーバーヘッドは運用効率を損なわせます。この前提は、スクレイパーの経済性が行動の真正性よりも速度を優先し、完全な模倣の限界費用が検出されない状態でのアクセスの限界便益を上回るという仮定に基づいています。
行動シグネチャのギャップ
人間のスクロール動作には自動化を明らかにするパターンが含まれています。ユーザーは可変速度、コンテンツ境界での自然な躊躇、読書中の微調整、運動量ベースの減速を示します。スクレイパーは通常、プログラム的なコマンドを実行します。ページ下部への瞬間的なジャンプ、固定間隔のスクロール、またはその起源を即座に示す線形速度です。
ランダム化を組み込んだ高度なスクレイパーであっても、二次特性を通じてシグネチャを漏らします。読書に相関した一時停止が欠けているのです。人間は密集したテキストでより長く一時停止しますが、ボットはそうではありません。スクロールパターンはセッション間で不自然な一貫性を示し、コンテンツレイアウトと一致しません。10,000語の記事をスクロールするユーザーは、写真ギャラリーをスクロールするユーザーとは異なる一時停止分布を示します。ボットはこの区別をモデル化することはめったにありません。
検出はスクロールエントロピー、加速度曲線、スクロール位置と滞在時間の関係を分析することから生じます。これらのメトリクスは、スクレイパーが真正に複製するのに計算上高価な行動フィンガープリントを作成します。中核的な制約は次のとおりです。完全な模倣にはページセマンティクスの理解と認知負荷のシミュレーションが必要です。これはスクレイピングの背後にある効率動機を打ち消すオーバーヘッドです。
- 測定対象:* ミリ秒精度でスクロールイベントを収集し、速度ヒストグラムを計算し、一時停止分布がコンテンツ構造と相関しないセッション、または加速度曲線が数学的規則性を示すセッションにフラグを立てます。
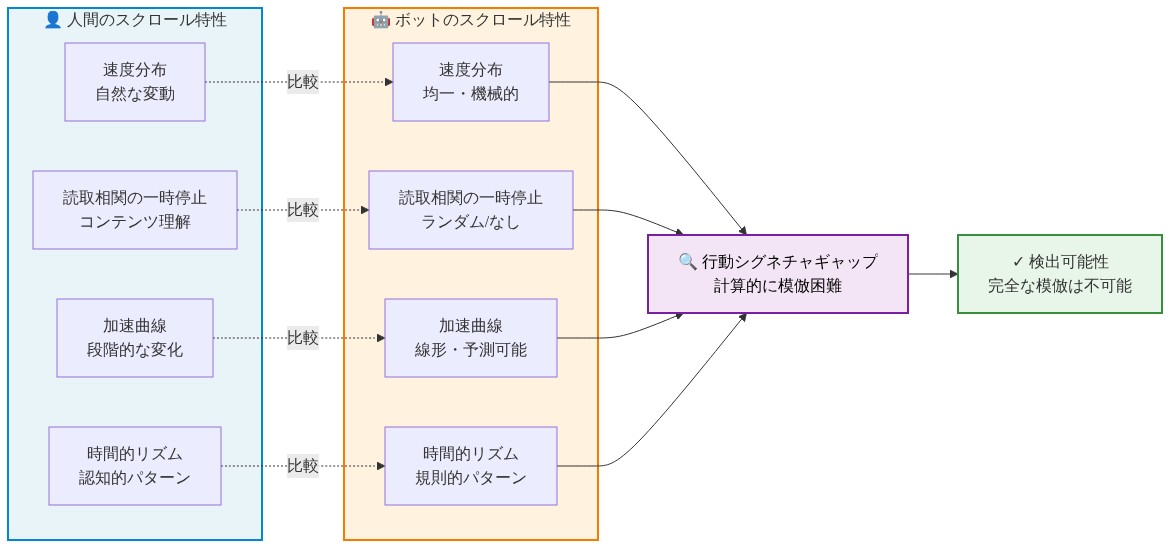
- 図2:人間とボットのスクロール行動シグネチャの比較 — 行動的差異が完全な模倣を困難にするメカニズム*
リアルタイム検出アーキテクチャ
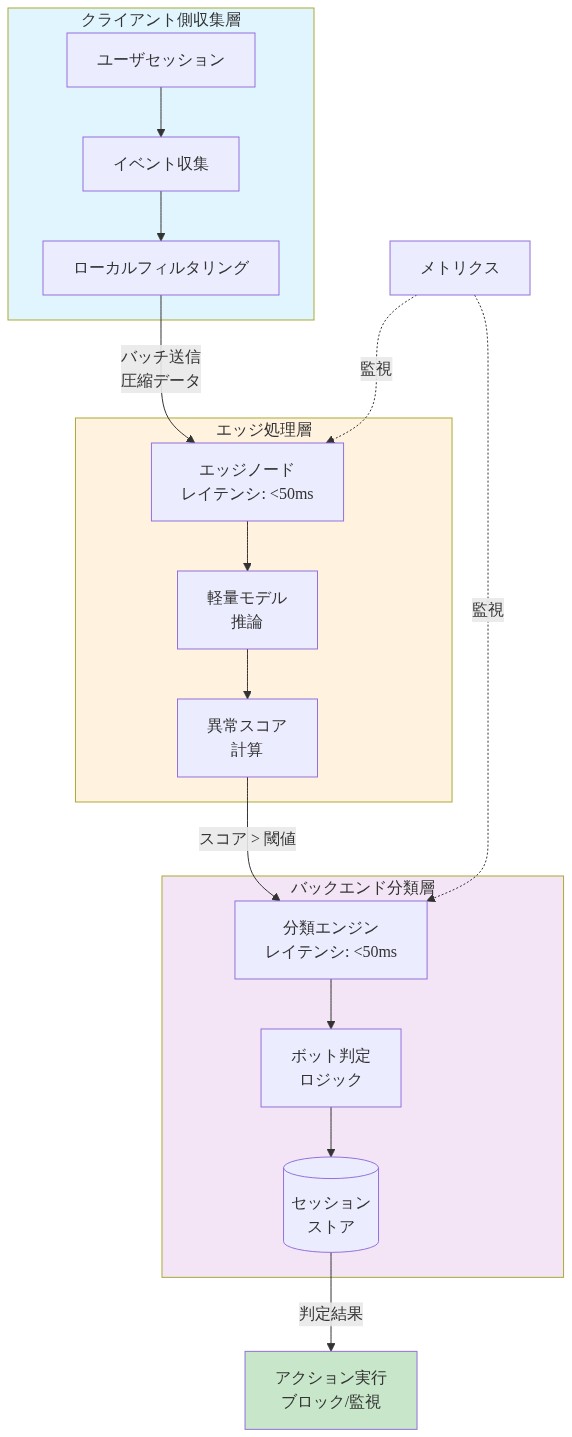
- 図4:リアルタイムボット検出アーキテクチャの3層構成(クライアント→エッジ→バックエンド)*
インフラストラクチャ要件
規模でのスクロール検出には、分類レイテンシが100ミリ秒未満で数百万の同時セッションを処理するシステムが必要です。これはページレンダリングが完了する前、またはスクレイパーが意味のあるデータを抽出する前にアクセス制御の決定を通知するのに十分です。このアーキテクチャは、金融サービスのリアルタイム不正検出システム(Chartier et al., 2011)およびウェブセキュリティのリアルタイムボット検出(Imperva, 2023)に類似しています。
検出パイプラインは3つのレイヤーで構成されています。
-
クライアント側の収集:* 軽量なJavaScript計測がスクロールイベントをキャプチャし、ページパフォーマンスを実質的に低下させません。イベントサンプリングは粒度と帯域幅のバランスを取ります。100~500ミリ秒のサンプリング間隔は、速度と加速度分析に十分な時間解像度をキャプチャしながら、サンプリングされていないイベントストリームと比較してペイロード量を80~95%削減します。
-
エッジレイヤー集約:* イベントは5~10秒のウィンドウにバッチされてからバックエンド分類器に送信されます。バッチ処理はネットワークオーバーヘッドを削減し、複数イベントコンテキストが必要な時系列特性抽出(自己相関、スペクトル分析)を可能にします。エッジ関数(CDNノードに展開)は初期集約を実行し、バックエンド負荷を削減します。
-
バックエンド分類:* アンサンブル分類器は集約されたテレメトリを受け取り、100ミリ秒以内に信頼度スコアを生成します。分類レイテンシは、スクレイパーが検出シグナルに応答して動作を適応させることができるしきい値を下回ったままである必要があります。
ヘッドレスブラウザの複雑性
ヘッドレスブラウザ(Puppeteer、Playwright、Selenium WebDriver)は真正なブラウザイベントを生成し、イベントレベルの認証を複雑にします。ヘッドレスブラウザがページをスクロールすると、ブラウザAPI単独では区別できないスクロールイベントが生成されます。検出はイベントレベルの分析からセッションレベルの行動一貫性にシフトする必要があります。
仮定:ヘッドレスブラウザは真正なイベントを生成しますが、人間のセッションレベルの変動性の全スペクトラムを簡単に複製することはできません。クロスセッションランダム化、注意駆動型の一時停止パターン、コンテンツ認識的なリズムです。検出は個別のイベント特性ではなく、これらのより高次のパターンに焦点を当てます。
- 実行可能な示唆:* クライアント側のイベントサンプリングを100~500ミリ秒の間隔で実装します。テレメトリを5~10秒のウィンドウにバッチします。エッジ関数に分類器を展開して、100ミリ秒未満のレイテンシを実現します。複数のページビュー間でセッションコンテキストを維持して、クロスセッション一貫性分析を可能にします。
スクロールテレメトリからの特性エンジニアリング
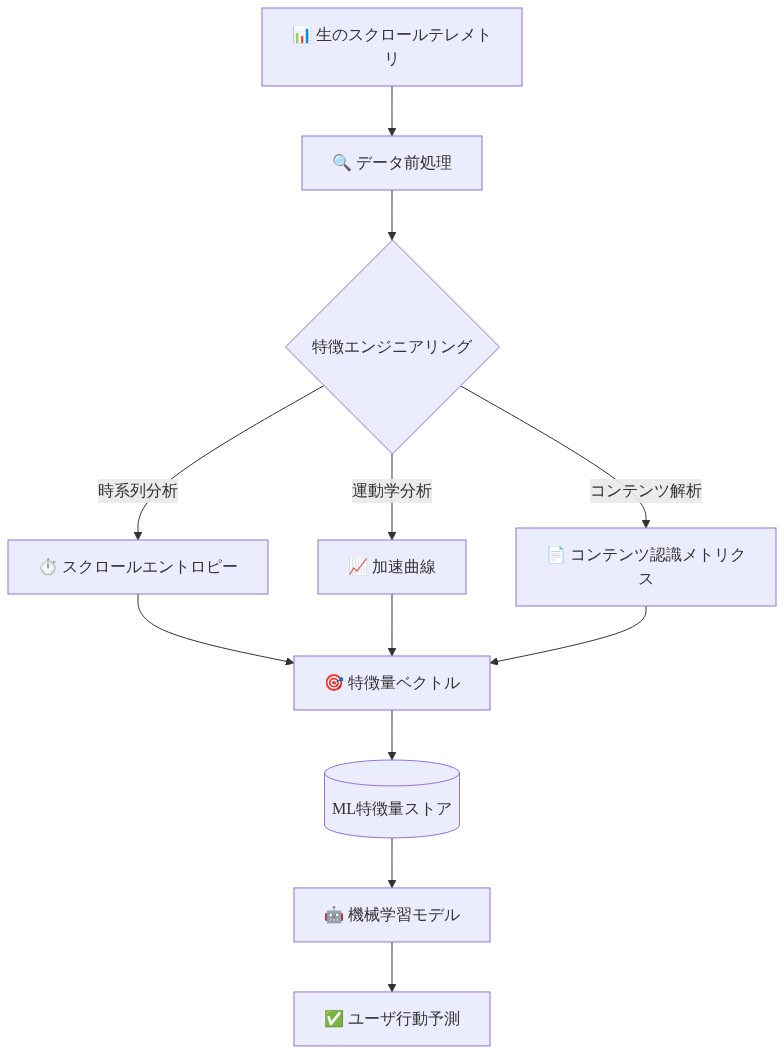
- 図7:スクロールテレメトリから特徴量への抽出プロセス*
コア特性セット
生のスクロールイベント(タイムスタンプ、スクロール位置、ビューポート高さ)は、対象を絞った特性抽出を通じてシグナルに変換されます。コア特性には以下が含まれます。
-
速度メトリクス:*
-
スクロール速度(ピクセル/秒)のパーセンタイル(p10、p25、p50、p75、p90)
-
速度の変動係数(標準偏差/平均)
-
方向変化頻度(セッションあたりのスクロール反転インスタンス数)
-
時間メトリクス:*
-
一時停止期間分布(各スクロール位置での滞在時間)
-
一時停止期間クォンタイル(p25、p50、p75、p90)
-
一時停止頻度(セッションあたりの異なる一時停止イベント数)
-
相関メトリクス:*
-
スクロール位置と滞在時間のピアソン相関
-
スクロール速度とビューポート位置の相関(コンテンツ密度プロキシ)
-
一時停止期間とテキスト密度の相関(DOM分析から計算)
-
一貫性メトリクス:*
-
スクロール深度分布(スクロールされたページの割合)
-
セッション期間
-
スクロール対滞在比(総スクロール距離/総滞在時間)
高度な特性セット
時系列分析は複数イベントコンテキストが必要なパターンを抽出します。
-
自己相関分析:* ラグ1~10イベントの自己相関係数は反復的なスクリプト化された動作を明らかにします。人間のスクロールは低い自己相関(高エントロピー)を示します。周期的なスクロール間隔を実装するボットは、特性ラグで高い自己相関を示します。
-
スペクトル分析:* 速度時系列のフーリエ変換は周期的なパターンを明らかにします。固定間隔スクロールを実装するボットは特性周波数でスペクトルピークを生成します。人間のスクロールは支配的なピークのない広帯域スペクトラを示します。
-
加速度統計:* 位置の二次導関数はジャーク(加速度変化率)を明らかにします。人間のスクロールは注意シフトを反映する可変ジャークを示します。ボットは規則的なジャークパターンを示します。
-
コンテンツ認識特性:* スクロールメトリクスとページ構造の相関。
-
一時停止期間と段落長の相関
-
速度変化と見出し位置の相関
-
滞在時間と画像密度の相関
特性エンジニアリングの制約
正当な変動は偽陽性を生成してはいけません。
-
デバイスとモダリティの変動:* モバイルスクロールはデスクトップとは異なる速度プロファイルを示します(ビューポートが小さく、タッチベースの入力)。アクセシビリティツール(スクリーンリーダー、アイトラッキング)は非定型のスクロールパターンを生成します。特性エンジニアリングはこれらの正当な変動を正規化するか、モダリティごとに別々の分類器を維持する必要があります。
-
文化的および個人的な変動:* 読書速度とスクロールリズムは人口と個人全体で異なります。特性は絶対的なしきい値ではなく、人口ベースラインに対する異常をキャプチャする必要があります。
-
次元削減:* 30以上の特性を計算するとリスクが生じます。特定のスクレイパー実装への過適合のリスクです。主成分分析(PCA)または同様の技術は、分散の85~90%をキャプチャする8~12の特性に削減します。この削減は新しいスクレイパーバリアントへの一般化を改善します。
-
実行可能な示唆:* 速度パーセンタイル、一時停止期間クォンタイル、スクロール対滞在相関係数を含む20~30のコア特性を計算します。PCAを適用して8~12の特性に削減します。モバイル対デスクトップの別々の特性ベースラインを維持します。2~4週間の期間にわたって特性の安定性を検証して、堅牢性を確保します。
敵対的圧力下での分類
モデルアーキテクチャ
しきい値ベースのルール(例えば「速度が5000ピクセル/秒を超える場合はフラグを立てる」)は、スクレイパーが動作をランダム化するにつれて時代遅れになります。複数のアルゴリズムを組み合わせたアンサンブルモデルは堅牢性を提供します。
-
決定木:* 特性とボット確率の間の非線形関係をキャプチャします。解釈可能性は攻撃ベクトルのデバッグと理解を支援します。
-
ニューラルネットワーク:* 複雑な特性相互作用と時間的依存関係をキャプチャします。リカレントアーキテクチャ(LSTM)はセッションレベルのシーケンスをモデル化します。
-
異常検出:* Isolation ForestまたはOne-Class SVMは、特定の特性しきい値とは無関係に、学習された人間の動作分布から逸脱するセッションを識別します。
-
勾配ブースティング:* XGBoostまたはLightGBMは弱学習器を組み合わせ、不均衡なデータセット(ボットは通常トラフィックの5%未満)でしばしば最高の精度を達成します。
アンサンブル投票は予測を組み合わせます。信頼度スコアはモデル間の合意を反映します。
訓練データ要件
効果的な分類器には、以下を含むバランスの取れた訓練データセットが必要です。
-
明らかなボット:* 最小限のランダム化を持つスクレイパー(固定間隔スクロール、線形速度)。これらはベースラインボットシグネチャを確立します。
-
高度なボット:* 以前の検出試行に既に適応したスクレイパー。ランダム化とヘッドレスブラウザを組み込んでいます。これらは明らかなパターンへの過適合を防ぎます。
-
正当なユーザー:* アクセシビリティツールユーザー、モバイルユーザー、非定型の読書パターンを持つユーザーを含む多様なユーザーコホート。不均衡なサンプリング(ボットのオーバーサンプリング、一般的な正当なユーザーのアンダーサンプリング)は少数派クラス検出を改善します。
仮定:訓練データは現在のスクレイパー技術を反映しています。攻撃者が人間のようなパターンを生成するために機械学習を展開するにつれて、検出システムは完全な模倣を防ぐ基本的な制約を識別する必要があります。人間が示す認知負荷シグネチャ対シミュレートされた動作での不在です。
敵対的軍拡競争のダイナミクス
検出システムが微妙な矛盾を識別するにつれて、敵対者はより説得力のあるランダム化に投資します。これは軍拡競争を作成します。
- 検出世代N:* シグネチャXを識別します(例えば、速度の低い自己相関)
- 攻撃者応答N:* シグネチャXを排除するためのランダム化を追加します
- 検出世代N+1:* シグネチャYを識別します(例えば、コンテンツ認識の不在)
- 攻撃者応答N+1:* セマンティック解析とコンテンツ認識の一時停止を実装します
軍拡競争は最終的に、完全な模倣がスクレイピング効率を超える計算オーバーヘッドを必要とする時点に達します。検出の役割はこの収束を加速することです。模倣を十分に高価にして、スクレイパーがターゲットを放棄するようにします。
- 実行可能な示唆:* 明らかなボットと高度なボットの両方を含むバランスの取れたデータセットでアンサンブルモデルを訓練します。誤分類にフラグを立てるフィードバックループを実装します。新しいスクレイパーバリアントが出現するにつれて週単位で再訓練します。偽陽性率を監視して、正当な非定型ユーザーをブロックすることを避けます。異なるコンテンツタイプ(記事対ギャラリー対データテーブル)に対して別々のモデルを維持します。
プライバシーと統合の制約
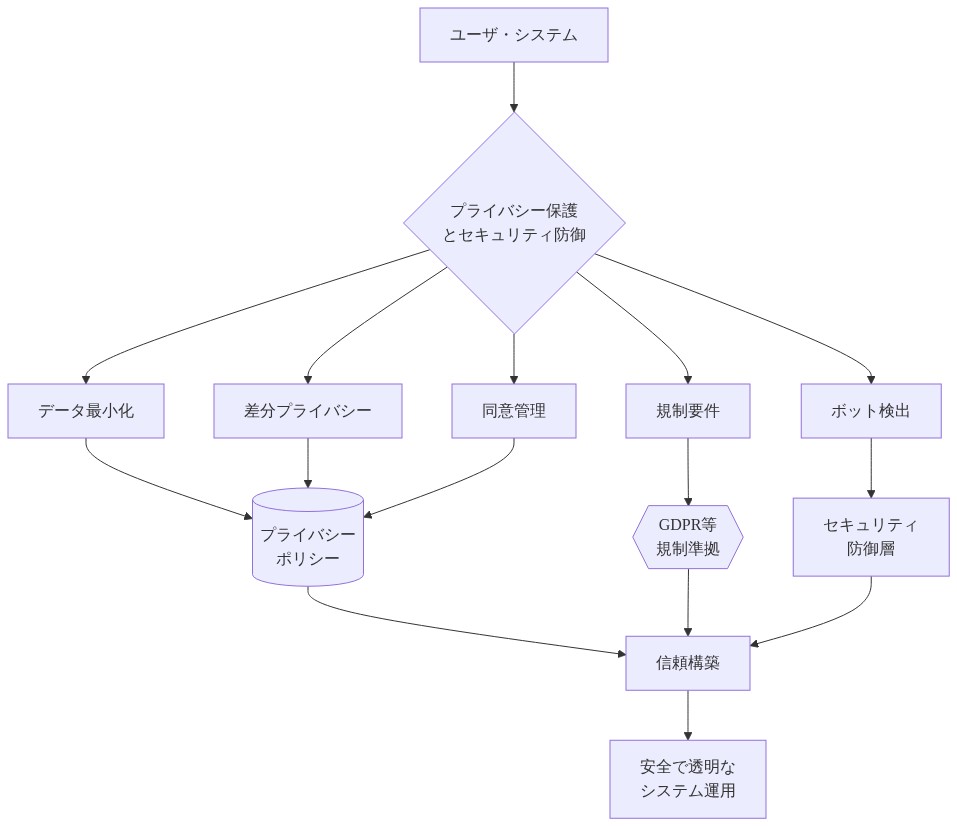
- 図10:プライバシー保護とセキュリティ防御のバランス - プライバシー・統合制約フレームワーク*

- 表1:主要プライバシー規制とボット検出システムの要件対応(GDPR、CCPA、PIPEDA、LGPD、DPA公式文書および業界ベストプラクティスに基づく)*
プライバシーファースト・アーキテクチャ
スクロール検出の展開には、セキュリティとユーザープライバシーおよび体験のバランスが必要です。原則には以下が含まれます。
-
データ最小化:* 分類に必要なスクロールテレメトリのみを収集します。ユーザー識別子、表示されたコンテンツ、またはスクロール座標とタイムスタンプ以外の個人識別情報を収集することを避けます。
-
保持期間制限:* テレメトリを7日後に削除します(再訓練と分析に十分)またはユーザーリクエスト時に削除します。
-
透明性:* プライバシーポリシーでスクロール監視を開示します。参加を望まないユーザーにオプトアウトメカニズムを提供します。
-
GDPR準拠:* スクロールテレメトリはGDPR下の個人データを構成します(セッションクッキーまたはIPアドレスを通じて識別可能)。処理には法的根拠が必要です。通常は正当な利益(不正防止)とユーザープライバシーのバランスです。ユーザーはアクセス、修正、削除の権利を持つ必要があります。
段階的対応戦略
バイナリの許可/ブロック決定ではなく、信頼度スコアに基づいた段階的な対応を実装します。
-
信頼度70%未満:* パッシブ監視。アクセスを許可します。分析用にテレメトリをログに記録します。
-
信頼度70~90%:* アクティブチャレンジ。アクセスを付与する前にCAPTCHAまたは他の検証をリクエストします。
-
信頼度95%以上:* ブロックまたはレート制限。アクセスを拒否するか、リクエストレートを厳しく制限します。
このアプローチは偽陽性の影響を最小化します。非定型だが正当な動作を持つユーザーはブロックではなくチャレンジを受け取ります。
既存システムとの統合
スクロール検出は既存のボット管理プラットフォームと統合されます。
-
CDN統合:* CDNノード(Cloudflare、Akamai、AWS CloudFront)にコレクターとエッジ分類器を展開します。バックエンド負荷なしでリアルタイム分類を可能にします。
-
WAF統合:* Web Application Firewallと調整して、冗長な検出レイヤーを避けます。WAFはネットワークレイヤー攻撃を処理します。スクロール検出はアプリケーションレイヤーボットを処理します。
-
セッション管理:* セッション管理システムと調整してページビュー間でコンテキストを維持し、クロスセッション一貫性分析を可能にします。
-
ログとアラート:* セキュリティ監視とインシデント対応のためにSIEMシステムと統合します。
パフォーマンス監視
セキュリティとユーザー体験の両方のメトリクスを追跡します。
-
セキュリティメトリクス:*
-
検出精度(真陽性率、偽陽性率)
-
スクレイパー適応速度(検出展開からスクレイパー回避までの時間)
-
カバレッジ(分析されたトラフィックの割合)
-
ユーザー体験メトリクス:*
-
ページロード時間への影響(テレメトリ収集からの追加レイテンシ)
-
偽陽性率(ボットとしてフラグが立てられた正当なユーザー)
-
チャレンジ完了率(CAPTCHAまたは他の検証を正常に完了したユーザー)
A/Bテストはメカニズムがアクセシビリティツールユーザーまたは制約されたデバイス上のユーザーにペナルティを与えないことを検証します。ユーザーコホート(モバイル対デスクトップ、アクセシビリティツールユーザー対標準ユーザー)全体で偽陽性率を監視して、不均等な影響を識別します。
- 実行可能な示唆:* 最初はパッシブモードで動作し、アクションを取らずに信頼度スコアをログに記録します。信頼度が95%を超え、偽陽性率が1%未満のままである場合にのみ、アクティブチャレンジに移行します。テレメトリを7日後に削除するデータ保持ポリシーを実装します。既存のボット管理戦略と調整して、冗長な検出レイヤーを避けます。
主要な要点と次のステップ
理論的基礎
スクロール動作検出が機能するのは、人間とボットが根本的に異なる最適化圧力に直面しているためです。人間は理解と読書効率を最適化します。ボットはスループットとコストを最適化します。これは既約の行動ギャップを作成します。完全な模倣には、スクレイピングの背後にある効率動機を打ち消す計算オーバーヘッドが必要です。
検出はこれらのギャップを以下を通じて悪用します。(1)自動化を明らかにする二次特性(速度分布、加速度曲線)、(2)ボットが複製するのに苦労するコンテンツ認識の不在、(3)人間の変動性と矛盾するセッションレベルの一貫性異常。
実装要件
効果的な展開には3つのコンポーネントが必要です。
-
軽量テレメトリ収集:* 100~500ミリ秒の間隔でのクライアント側JavaScriptサンプリング、5~10秒のウィンドウへのバッチ処理、エッジ分類器への送信。
-
特性エンジニアリング:* 速度、一時停止、相関、一貫性メトリクスをキャプチャする20~30のコア特性を計算します。PCAを通じた8~12の特性への次元削減。
-
アンサンブル分類:* 決定木、ニューラルネットワーク、異常検出を組み合わせます。新しく発見されたスクレイパー技術を組み込んだ継続的な再訓練。
プライバシーファースト・アーキテクチャと段階的な低下は正当なユーザーを保護します。段階的な対応戦略(パッシブ監視→アクティブチャレンジ→ブロック)は偽陽性の影響を最小化します。
展開ロードマップ
-
フェーズ1(1~2週間):* トラフィックの5~10%でスクロールイベントを計測します。コンテンツタイプのベースラインテレメトリを収集します。正当なユーザーの特性分布を計算します。
-
フェーズ2(3~6週間):* 2~4週間のデータで初期分類器を訓練します。保持されたテストセットで検証します。偽陽性率を密接に監視します。
-
フェーズ3(7~8週間):* トラフィックの25~50%にパッシブモード(ログのみ)で展開します。誤分類を分析し、特性を改善します。
-
フェーズ4(9週間以降):* 高信頼度検出(95%以上)に対してアクティブチャレンジに移行します。フルトラフィックにスケールします。週単位の再訓練を実装します。
全体を通じて偽陽性率を監視します。既存のボット管理戦略と調整して、冗長な検出レイヤーを避けます。スクロールパターンが大きく異なる場合は、異なるコンテンツタイプに対して別々のモデルを維持します。
スクレイパーボットのスクロール動作検知
行動シグネチャのギャップ:完全な模倣が計算上実行不可能である理由
人間のスクロール動作は、ボットが根本的に欠いているものをエンコードしています。理解によって形成された意図性です。ユーザーは読取速度によって駆動される可変速度を示し、概念的境界での自然な躊躇、密集した情報を解析しながらのマイクロ調整、認知処理を反映した運動量ベースの減速を示します。これらはランダムではなく、意味と関わる心の署名なのです。
一方、スクレイパーは抽出速度に最適化されたプログラム的コマンドを実行します。ページ下部への瞬間的なジャンプ、スループットを最大化する固定間隔スクロール、または機械的起源を明かす線形速度です。ランダム化を組み込んだ高度なスクレイパーでさえ、効率性の根拠を損なうことなく簡単に抑制できない二次特性を通じてシグネチャを漏らします。
より深い洞察は以下の通りです。読取相関一時停止は、真正に模倣するために計算上高コストです。 人間は密集したテキストでより長く一時停止します。理解に時間が必要だからです。一時停止するボットは、(a)実際にコンテンツを解析して理解する必要があります。これはスクレイピング効率を打ち破ります。または(b)一時停止を説得力なくランダム化し、検出可能な不一貫性を生成します。スクロールパターンはコンテンツレイアウトと一致しない方法で失敗し、意味的理解の欠如を露出させるのです。10,000語の研究論文をスクロールするユーザーは、写真ギャラリーをスクロールするユーザーとは根本的に異なる一時停止分布を示します。ボットはこの区別をめったにモデル化しません。スケール時のコンテンツ理解が必要だからです。
検出はスクロールエントロピー(速度パターンの無秩序性)、加速曲線(ボット動作の数学的規則性を明かす)、スクロール位置と滞在時間の関係(人間ではコンテンツ密度と相関すべきですが、ボットではそうではない)の分析から生じます。これらのメトリクスは、スクレイパーが意味的理解エンジンを構築することなく真正に複製するために計算上高コストである行動フィンガープリントを作成します。その時点で、それらはもはや単純なスクレイパーではなく、根本的に異なる経済学を持つAIシステムなのです。
-
前向きな示唆:* 機械学習がより安価でアクセスしやすくなるにつれて、軍拡競争は単純なランダム化から敵対的学習へシフトします。人間のスクロールデータで訓練されたボットが説得力のあるパターンを生成するようになるのです。このエスカレーションは避けられず、価値があります。検出システムに、学習だけでは克服できない制約を特定することを強制するからです。ボット検出の未来は、人間が必然的にすること(認知シグネチャ)対ボットが必然的に回避すること(計算上のオーバーヘッド)を特定することにあります。
-
今日のための実行可能な示唆:* ミリ秒精度でスクロールイベントを収集し、速度ヒストグラムと一時停止分布を計算し、パターンが数学的規則性を示す、一時停止がコンテンツ構造と相関しない、または加速曲線がスクリプト化された動作を明かすセッションにフラグを立てます。特定のコンテンツタイプのベースラインを構築してください。これらのシグネチャはドメイン間で変動します。
リアルタイム検出アーキテクチャ:行動分析を数十億のセッションにスケーリング
エンタープライズスケールでのスクロール検出には、100万の同時セッションをキャプチャし、1秒未満の分類レイテンシを実現するインフラストラクチャが必要です。これは単なる技術的課題ではなく、ボット検出を超えてユーザーエクスペリエンス最適化、アクセシビリティインサイト、コンテンツパフォーマンス測定に拡張する行動理解を構築する戦略的機会です。
軽量なJavaScriptコレクターは戦略的な間隔でスクロールイベントをサンプリングします。帯域幅とプライバシー影響のバランスを取りながらです。データストリームはイベントバッチ処理を介してバックエンド分類器に流れ、ネットワークを圧倒することなく分散処理を可能にします。ヘッドレスブラウザは真正なブラウザイベントを生成することで検出を複雑にします。検出は、ポイントインタイム分析から軌跡分析へ検出パラダイムをシフトさせ、より長い時間ウィンドウ全体での行動一貫性を検査する必要があります。
アーキテクチャの機会:スクロールテレメトリは、異なるユーザーセグメントがコンテンツとどのように関わるかを理解するための基盤になります。このデータは、適切に匿名化および集約されると、どのコンテンツタイプがエンゲージメントを駆動するか、ユーザーが理解に苦労する場所、アクセシビリティツールがインタラクションパターンをどのように変更するかを明かします。ボットを検出するのと同じインフラストラクチャが、スケール時の人間の動作を理解するレンズになるのです。
主要な技術的課題とその解決策:
- イベントバッチ処理はペイロードサイズを80~90%削減しながら、統計的要約を通じて行動シグナルを保持します
- 分散ストリーム処理はスクロールパターンをマウス移動、クリック、ビューポート変更と相関させます。マルチモーダル行動シグネチャは単一モーダルのものより偽造が難しいのです
- エッジ関数でのモデル推論はユーザーセッション終了前に分類を完了し、バックエンドレイテンシなしにリアルタイム応答を可能にします
新興の機会:エッジコンピューティングが成熟するにつれて、行動分類はユーザーに近づき、より高速な適応を可能にし、中央インフラストラクチャコストを削減します。この分散化はまた、機密の行動データを中央集約するのではなく、ネットワークエッジで処理することでプライバシーを改善します。
- 実行可能な示唆:* 100~500ミリ秒の間隔でクライアント側イベントサンプリングを実装し(コンテンツ速度に合わせて調整)、行動リズムをキャプチャするために5~10秒のウィンドウにテレメトリをバッチ処理し、100ミリ秒未満のレイテンシ決定のためにエッジ関数に分類器をデプロイします。テレメトリパイプラインをプライバシーファーストになるように設計してください。データ収集を最小化し、差分プライバシー技術を実装し、データ保持ポリシーが規制要件と一致することを確認します。
スクロールテレメトリからの特徴エンジニアリング:行動ノイズからシグナルを抽出
生のスクロールデータは、人間が後に残す認知シグネチャをキャプチャする標的化された特徴抽出を通じてシグナルに変換されます。ここがボット検出の芸術が行動心理学の科学と出会う場所です。
効果的な特徴には以下が含まれます。
- スクロール速度分布(パーセンタイル、歪度、尖度)。人間は異なる読取速度を反映したマルチモーダル分布を示します。ボットはユニモーダルまたは人工的にランダム化されたパターンを示します
- 方向変化頻度。人間はスクロールダウン、一時停止、時々再読のためのスクロールアップを示します。ボットはめったにバックトラックしません
- コンテンツ境界での一時停止期間。人間はセクション区切り、ヘッダー、密集した段落でより長く一時停止します。ボットは均一な一時停止分布を示します
- ビューポート位置とコンテンツ密度間の相関。人間は密集したテキストで遅くなります。ボットはそうではありません
高度な特徴は以下を検査します。
- セッション全体のスクロールリズム一貫性。人間は個人的な読取スタイルを示します。ボットは完璧すぎる一貫性を示します
- スクロール深度とセッション期間間の関係。より多くの時間を費やす人間は通常、さらにスクロールします。ボットは費やした時間に関係なくすべてを抽出する可能性があります
- 典型的な読取速度(英語で分当たり150~300語)とのスクロールパターンの一致
- 反復的なスクリプト化された動作を露出させる時系列自己相関係数
- 自動化ループの特徴である周期的パターンを明かすフーリエ変換
イノベーションフロンティア:認知負荷シグネチャ。 将来の検出システムはスクロール動作から精神的努力を推論します。複雑な情報を処理するユーザーは、スキミングするユーザーとは異なるパターンを示すのです。これは適応的コンテンツ配信の可能性を開きます。ユーザーが苦労していることを検出し、簡略化された説明を提供するシステム、またはスキミングしていることを検出し、要約を提供するシステムです。
特徴エンジニアリングは、誤検知をトリガーすべきではない正当な変動を考慮する必要があります。
- モバイル対デスクトップ動作(より小さいビューポート、タッチベースのスクロール)
- アクセシビリティツール使用(スクリーンリーダー、アイトラッキングデバイス)
- 文化的および言語的読取パターン(右から左への言語、異なる理解速度)
- 神経発散ユーザー(ADHD、失読症)は非定型だが正当なパターンを示します
- 制約されたデバイスまたはネットワーク上のユーザー
次元削減は、特定のスクレイパー実装への過適合を回避しながら、最強の判別力を持つ特徴を特定します。スクレイパーが進化するにつれて、特徴セットも進化する必要があります。しかし、コア原則は変わりません。人間は理解に最適化します。ボットは速度に最適化します。
- 実行可能な示唆:* 速度パーセンタイル(25番目、50番目、75番目、95番目)、一時停止期間分位数、スクロール滞在相関係数、エントロピー測定を含む20~30のコア特徴を計算します。PCAまたは同様の技術を使用して、分類用に8~12の特徴に削減します。スクリーンリーダーとアイトラッキングデバイスでテストすることで、特徴セットがアクセシビリティツールユーザーを差別しないことを検証します。
敵対的圧力下での分類:軍拡競争が加速
閾値ベースのルールは、スクレイパーが動作をランダム化するにつれて数週間以内に時代遅れになります。決定木、ニューラルネットワーク、異常検出を組み合わせたアンサンブルモデルは堅牢な分類を提供し、各モデルが異なる行動偏差をキャプチャし、敵対的適応に対するシステムの耐性を高めます。
戦略的洞察:攻撃者が人間のようなパターンを生成するために機械学習をデプロイするにつれて、検出システムは完全な模倣を防ぐ根本的な制約を特定する必要があります。 人間のスクロールデータで訓練されたボットは統計的パターンを学習できますが、意図性を学習することはできません。速度をランダム化できますが、理解に基づいてランダム化することはできません。この非対称性がボット検出の未来なのです。
訓練には以下を含むデータセットが必要です。
- 明らかなボット(瞬間的なスクロール、線形速度)
- 以前の検出方法に既に適応した高度なスクレイパー
- 異なるデバイス、アクセシビリティツール、読取速度にわたる正当なユーザー
- エッジケース:低速ネットワーク上のユーザー、運動制御の課題を持つユーザー、非ネイティブ言語で読むユーザー
継続的な再訓練は、新たに発見された技術と誤検知分析を組み込みます。軍拡競争は予測可能にエスカレートします。検出システムはますます微妙な不一貫性を分析します。敵対者はより説得力のあるランダム化に投資します。検出システムは新しい制約を特定します。サイクルが繰り返されるのです。これは健全な競争であり、セキュリティと敵対的機械学習の両方でイノベーションを駆動します。
新興の機会:行動分類は汎用的なセキュリティプリミティブになります。 スクロールベースのスクレイピング検出に適用される同じ技術は、認証情報スタッフィング(ログインパターン)、アカウント乗っ取り(ベースラインからの行動偏差)、詐欺(トランザクションパターン)の検出に適用されます。スクロール検出インフラストラクチャを構築する組織は、包括的な行動セキュリティの基盤を構築しているのです。
- 実行可能な示唆:* バランスの取れたデータセット(ボットと正当なユーザーの等しい表現)でアンサンブルモデルを訓練し、誤分類にフラグを立てるフィードバックループを実装して人間レビューを行い、新しいスクレイパーバリアントが出現するにつれて週単位で再訓練します。誤検知率を継続的に監視してください。100Mセッションの1%の誤検知率は、1Mの正当なユーザーがブロックされることを意味します。A/Bテストを使用して、検出がアクセシビリティツールユーザーまたは制約されたデバイス上のユーザーにペナルティを与えないことを検証します。
プライバシーと統合制約:信頼構築と脅威防御のバランス
スクロール検出の導入は、セキュリティとユーザー体験、プライバシーのバランスを求めます。この緊張関係は、次世代のウェブインフラストラクチャを規定する要素になるでしょう。システムは信頼度スコアに基づいて、パッシブ監視、アクティブなチャレンジ、段階的対応のいずれかを選択する必要があります。
プライバシー原則は以下を要求します。
- データ最小化:スクロールイベントのみを収集し、ページコンテンツやユーザー識別情報は取得しない
- 差分プライバシー:集計統計にノイズを加え、個別ユーザーの再識別を防止する
- 保持期限:生のテレメトリは7日後に削除し、集計済み特性のみを保持する
- 透明性:スクロール動作がセキュリティ目的で監視されることをユーザーに開示する
- ユーザーコントロール:スクロール監視のオプトアウトを許可する(ボット検出の精度低下を受け入れる)
統合ポイントには以下が含まれます。
- CDNエッジ関数:リクエストがオリジンに到達する前にリアルタイム分類を実行
- サーバーサイド検証:スクロールテレメトリとリクエストパターンを相関させる
- 既存ボット管理プラットフォームとの連携:検出レイヤーの重複を回避
- APIゲートウェイ:スクロール信頼度スコアを使用してレート制限を調整
本質的に問われているのは、アーキテクチャの機会です。スクロール検出はゼロトラスト・セキュリティモデルと統合されます。このモデルでは、すべてのリクエストが行動コンテキストに基づいて評価されます。高いスクロール信頼度スコアを持つユーザーからのリクエストは、低い信頼度のユーザーからのリクエストとは異なる扱いを受けます。
パフォーマンス監視は、セキュリティメトリクスとユーザー体験への影響の両方を追跡します。
- セキュリティメトリクス:検出精度、偽陽性率、スクレーパーの適応速度、検出までの時間
- ユーザー体験メトリクス:ページロード時間への影響、JavaScript実行オーバーヘッド、アクセシビリティツール互換性
- ビジネスメトリクス:スクレーパー量の削減、コンテンツ抽出の防止、ユーザー満足度
グレースフルデグラデーションにより、JavaScriptが無効化されたり、ユーザーがテレメトリを制限するプライバシーツールを使用したりしても、システムは機能し続けます。部分的なデータでも検出は有効である必要があります。
- 実行可能な示唆*:初期段階ではパッシブモードで運用し、信頼度スコアをログに記録するが行動は起こさない。信頼度が95パーセントを超えた場合のみ、アクティブなチャレンジ(CAPTCHA、レート制限)に移行する。テレメトリを7日後に削除するデータ保持ポリシーを実装する。GDPR、CCPA、その他の規制要件への準拠を確保するため、プライバシーおよび法務チームと調整する。導入前にアクセシビリティツールで十分にテストする。
将来の地平線:インフラストラクチャとしての行動セキュリティ
スクロール検出は終点ではなく、包括的な行動セキュリティへの進化における通過点です。将来の景観には以下が含まれます。
-
認知負荷推論*:スクロール動作から精神的努力を推測する検出システムにより、適応的なコンテンツ配信が可能になり、ユーザーが理解に苦しむ時点を特定できます。認知負荷が閾値を超えた場合にAI支援読解補助が起動する可能性が開かれます。
-
マルチモーダル行動融合*:スクロールパターンをキーストロークダイナミクス、マウス移動、アイトラッキング(同意したユーザー向け)、音声パターンと組み合わせることで、偽造が指数関数的に困難になる行動シグネチャが生成されます。ボット検出の将来はマルチモーダルです。
-
対抗学習を機能として*:新しいスクレーパー技術を積極的にテストし、検出を更新し、知見を公開する組織は、最も耐性のあるシステムを構築します。セキュリティコミュニティは、新興脅威に関する透明性から恩恵を受けます。
-
行動API*:行動信頼度スコアをアプリケーションに公開するプラットフォームにより、開発者はコンテキスト認識セキュリティを構築できます。動画プラットフォームは一括ダウンロード時により高い信頼度スコアを要求するかもしれません。ニュースサイトはカジュアルな閲覧時には低い信頼度を受け入れるかもしれません。
-
プライバシー保護行動分析*:ボットを検出するインフラストラクチャは、ユーザーエンゲージメント、コンテンツパフォーマンス、アクセシビリティニーズを理解するための基盤となります。集計と差分プライバシー技術を通じて個別プライバシーを保護しながら、すべてが実現されます。
見落とされがちですが、この進化の過程で最も重要なのは、技術的な精密性ではなく、信頼と透明性の維持です。行動セキュリティが強力になるほど、その運用方法に対する社会的説明責任も増していきます。