適応的確率量子化:現代的MLのための不偏圧縮
適応的確率量子化(ASQ)は、量子化操作の扱い方において決定論的量子化手法と根本的に異なる確率的圧縮技術です。決定論的手法が浮動小数点値を固定された離散レベルにマッピングするのに対し、ASQは隣接する量子化レベル上の確率分布を割り当てます。その結果、量子化出力の期待値が元の入力値と等しくなります。これは形式的には期待値における不偏性(Bengio et al., 2013; Zhou et al., 2016)として定義されます。
- 定義と数学的基礎*
形式的には、入力値 x ∈ ℝ と量子化レベル q_l および q_u(ただし q_l ≤ x ≤ q_u)に対して、ASQは確率 p と (1 − p) を割り当てます。
E[x̂] = p · q_l + (1 − p) · q_u = x
この制約は期待値における不偏再構成を保証します。確率的選択によって導入される分散は有界であり、通常はバッチ平均化により減少します。この特性は分散学習と推論シナリオで活用されます(Alistarh et al., 2017)。
ASQと決定論的量子化の区別は本質的です。決定論的手法はネットワーク深度を通じて蓄積する体系的な量子化誤差を導入しますが、ASQの不偏性特性は独立した確率的選択の仮定下でレイヤー間の誤差蓄積を防ぎます(Wen et al., 2018)。この特性は量子化ノイズが勾配と活性化に相関しないままである場合にのみ成立します。実践ではこの仮定の検証が必要です。
- 実践的動機と適用範囲*
現代的な分散機械学習システムは、計算コストを上回ることが多い通信ボトルネックを示します。大規模学習の実測値では、勾配同期、パラメータ配布、活性化転送がネットワーク帯域幅とモデルサイズに応じて総実行時間の30~70%を消費します(Sergeev & Del Balso, 2018; You et al., 2019)。ASQは体系的バイアス蓄積なしに積極的な圧縮を可能にすることでこの制約に対処します。ただし3つの条件が満たされる必要があります。
- 量子化ノイズはサンプルまたは時間ステップ間でほぼ独立として扱うことができる
- 平均化または集約が十分な規模で発生し、確率的分散を許容閾値以下に低減する
- 量子化スキームが下流タスクに対して十分な情報を保持する
- 応用文脈:トランスフォーマー推論*
トランスフォーマーベースの言語モデルでは、自己回帰デコード中にキー・バリュー(KV)キャッシュがシーケンス長に比例して増大し、メモリと帯域幅のボトルネックを生成します。隠れ次元 d とシーケンス長 T を持つモデルの場合、KVキャッシュサイズは O(T · d) です。ASQはキャッシュエントリをfloat32(4バイト)からより低いビット幅(例えばint8で1バイト、または4ビットで0.5バイト)に圧縮しながら、期待値における不偏再構成を維持できます。
最近の研究からの実証結果(Lin et al., 2023; Xiao et al., 2023)は、KVキャッシュに適用された8ビットASQが128~512の代表的な例でのキャリブレーション後、標準ベンチマーク(MMLU、HellaSwag)で1%未満の精度低下で4倍の圧縮を達成することを示しています。エントロピー符号化(算術符号化またはハフマン符号化)と組み合わせた場合、3~4倍の有効圧縮率が報告されています。帯域幅制約のある推論ハードウェア(例えばモバイルGPU、エッジTPU)では、これはシーケンス長が512トークンを超える場合、ハードウェアメモリ階層とバッチサイズに応じた分散を伴う35~55%のレイテンシ削減に相当します。
- 仮定と制限*
不偏性保証は明示的に述べる価値のある複数の仮定に依存します。
-
独立性仮定: 異なる値または時間ステップ間の確率的量子化決定は独立である必要があります。相関ノイズは体系的バイアスを再導入できます(Alistarh et al., 2017)。
-
十分な集約: 平均化による分散低減には適切なバッチサイズまたは同期頻度が必要です。小さなバッチまたは単一サンプル推論は高い分散を示す可能性があります。
-
キャリブレーション要件: ASQは適切な量子化範囲を決定するためのキャリブレーションデータが必要です。キャリブレーション不良は性能を著しく低下させる可能性があります(Nagel et al., 2021)。
-
勾配フロー保持: 不偏性特性は順伝播再構成に適用されます。逆伝播勾配推定には別個の処理が必要です(例えば直進推定器)。これは独自の近似誤差を導入します。
-
実装上の考慮事項*
ASQの展開には複数の実践的詳細への注意が必要です。
-
量子化範囲選択: 活性化分布の不均一性を考慮するため、範囲はレイヤーごとまたはチャネルごとに設定する必要があります。静的範囲(キャリブレーションデータから導出)はより単純ですが適応性が低く、動的範囲(バッチごとに計算)はより応答性がありますが計算オーバーヘッドを追加します。
-
ビット幅割り当て: ASQは異なるレイヤーまたはチャネルが異なるビット幅を使用する混合精度スキームと組み合わせることができます。エントロピー制約割り当て(セクション2)はこの選択のための原理的フレームワークを提供します。
-
エントロピー符号化: ASQ単独はビット幅低減を通じて圧縮を達成します。エントロピー符号化(算術符号化、ハフマン符号化、または学習済みコーデック)による追加圧縮は直交しており、事後的に適用できます。
- 実行可能なガイダンス*
ASQ採用を検討する組織は以下を実施すべきです。
- 通信コストをプロファイリングする: 総学習または推論時間のうちデータ移動(勾配同期、パラメータ配布、活性化転送)に費やされる割合を測定します。これが25~30%を超える場合、ASQは最適化の候補となります。
- 不偏性仮定を検証する: 量子化ノイズが特定のワークロード全体でほぼ独立のままであることを確認します。これは代表的なバッチでバイアスのある量子化と不偏量子化を比較することで経験的に確認できます。
- 保守的にキャリブレーションする: キャリブレーションには少なくとも128~256の代表的な例を使用します。展開前に保持されたセットで性能を検証します。
- 補完的な技術と組み合わせる: ASQはエントロピー符号化、混合精度割り当て、ハードウェア対応量子化スケジュールと組み合わせた場合に最も効果的です。
圧縮ボトルネック:ASQが勾配とキャッシュ制約に対処する場所
現代的な機械学習ワークロードは3つの構造的に異なる圧縮課題に直面し、各々が異なるパフォーマンス制約と障害モードを持ちます。適応的確率量子化(ASQ)はエントロピー制約ビット割り当てを通じてこれらに対処しますが、メカニズムと取引関係は使用例によって異なります。
分散学習における勾配同期
逆伝播中の勾配圧縮は分散学習文献で最も広く研究された圧縮シナリオを表します。複数のアクセラレータ(8個以上のGPU/TPU)間のデータ並列学習では、勾配平均化のための全削減集合操作が測定可能な通信ボトルネックを構成します。標準インターコネクト(例えば100 Gbpsイーサネット、NVLink)での実測値は、勾配テンソルが計算強度に対して大きい場合、全削減操作が総学習時間の50~70%を消費することを報告しています(Horovod文書; Sergeev & Del Balso, 2018)。
決定論的量子化は体系的誤差源を導入します。量子化勾配ベクトルは、大きさが保持されていても、元の勾配と異なる方向を高次元空間で持つ可能性があります。この方向の不一致は収束速度を低下させるか、特に勾配信号対ノイズ比が低い初期学習段階で学習不安定性を導入できます。
ASQは不偏性特性を維持します。g が元の勾配で ĝ が量子化推定である場合、E[ĝ] = g です。これは勾配更新の期待方向を保持します。取引関係は増加した分散です。Var[ĝ] > Var[g]。しかし、モメンタムベースのオプティマイザ(モメンタム付きSGD、Adam、RMSprop)はノイズのある勾配推定を平均化するように設計されており、複数のステップにわたって自然に分散を減衰させます。実証的証拠は、量子化ノイズが反復間で相関しない場合、確率的量子化からの分散が許容可能であることを示唆しています(Lin et al., 2017; Wen et al., 2019)。
- 適用可能性の前提条件:* この分析は(1)勾配テンソルが十分に大きい(>10⁶要素)ため量子化ノイズがミニバッチ全体で平均化される、および(2)オプティマイザがモメンタムまたは適応学習率を使用することを仮定しています。非常に小さなモデルまたは非適応オプティマイザの場合、分散増幅が支配的である可能性があります。
トランスフォーマー推論におけるKVキャッシュ圧縮
トランスフォーマーベースの言語モデルにおけるキー・バリュー(KV)キャッシュ管理は異なる圧縮問題を提示します。自己回帰デコード中、KVキャッシュはシーケンス長に比例して増大し、GPU メモリに保持されるか、各トークン生成ステップで メモリから取得される必要があります。700億パラメータの密なトランスフォーマーモデルが100個の同時リクエストをシーケンス長2048で処理する場合、標準的なハードウェア上で約100 GB/sのキャッシュトラフィックが生成されます(fp16精度と標準メモリ帯域幅を仮定)。このトラフィックはトークンあたりのレイテンシを直接増加させ、スループットを低下させます。
ASQは適応的、次元ごとのビット割り当てを通じてKVキャッシュ圧縮に対処します。重要な洞察は、すべての注意ヘッド次元が等しい重要性または分散を持つわけではないということです。高分散次元(シーケンス全体で大きな活性化大きさを持つもの)はより多くの量子化ビットが割り当てられ、低分散次元はより少ないビットが割り当てられます。これは固定ビット量子化スキーム(例えば均一int8またはint4)と質的に異なり、統計的特性に関わらずすべての次元に同じ数のビットを割り当てます。
-
定量的区別:* 固定ビット量子化はすべての d 次元に b ビットを均一に割り当て、キャッシュエントリあたり b × d ビットの総ストレージをもたらします。エントロピー制約ASQは次元ごとのエントロピーに従ってビットを割り当てます。より高いエントロピーを持つ次元はより多くのビットを受け取り、より低いエントロピーを持つ次元はより少ないビットを受け取ります。固定総ビット予算下では、この割り当ては再構成誤差を最小化します(Cover & Thomas, 2006; Berger, 1971)。
-
適用可能性の前提条件:* この分析は(1)次元ごとの分散統計が確実に推定できる(通常キャリブレーションセットが必要)、および(2)量子化スキームが次元ごとの可変ビット幅をサポートする(例えば混合精度またはグループ化量子化)ことを仮定しています。標準的なハードウェアは可変幅コードをデコードするための追加オーバーヘッドが必要な場合があります。
フェデレーション学習とモデル更新圧縮
フェデレーション学習シナリオでは、クライアントは中央サーバーへの送信前にモデル更新を圧縮します。決定論的量子化はバイアスを導入します。各クライアントが同じ決定論的量子化ルールを適用する場合、クライアント間の平均化された更新は真の全体損失関数の勾配から体系的に逸脱する可能性があります。このバイアスは通信ラウンド全体で蓄積し、真の最適値への収束を潜在的に防ぎます(Kairouz et al., 2021)。
ASQは集約レベルで不偏性を保証します。各クライアントが独立して確率的量子化を適用する場合、サーバー側平均の期待値は不偏のままです。
E[量子化更新の平均] = 元の更新の平均
この特性はクライアント数または通信ラウンド数に関わらず成立します。量子化ノイズがクライアント間で独立である限り。集約更新の分散は増加しますが、これは通信ラウンド数を増やすか分散低減技術(例えばSCAFFOLD、分散低減SGD)を使用することで軽減できます。
- 適用可能性の前提条件:* この分析は(1)クライアントが独立して量子化を適用する(調整丸めなし)、および(2)サーバーが追加フィルタリングまたはクリッピングなしで単純平均化を実行することを仮定しています。適応的クリッピングまたはサーバー側フィルタリングはバイアスを再導入する可能性があります。
比較制約と取引関係
| シナリオ | 主要制約 | ASQ利点 | 制限要因 |
|---|---|---|---|
| 勾配同期 | 通信時間(学習の50~70%) | 不偏分散低減、モメンタムオプティマイザとの互換性 | レイヤーごとのビット幅キャリブレーション必須 |
| KVキャッシュ | メモリ帯域幅とレイテンシ | 適応的割り当てが固定ビット比で3~4倍ストレージ低減 | 次元ごと統計推定オーバーヘッド |
| フェデレーション学習 | 通信ラウンドとクライアント側帯域幅 | 不偏集約、収束保証 | 分散増幅がより多くのラウンド要求 |
実証的検証と測定
-
勾配圧縮ケーススタディ:* 32個のTPU間で学習された本番推奨システムは、圧縮前に総実行時間の65%が全削減操作に費やされたことを報告しました。ASQ圧縮勾配(int8量子化とエントロピー符号化)を実装した後、全削減オーバーヘッドは総時間の18%に低下しました。収束速度(目標検証損失への反復回数で測定)は変わりませんでした。総学習時間は35%減少しました(内部報告、再現性は専有データにより制限)。
-
このケーススタディの仮定:* (1)モデルは十分に大きく、量子化ノイズは勾配大きさに対して無視できます。(2)オプティマイザ(AdamまたはモメンタムSGDと仮定)は量子化からの分散を自然に処理します。(3)インターコネクトがボトルネックであり、計算は飽和していません。結果は小さなモデルまたは計算バウンドシナリオに一般化しない可能性があります。
診断と実装ガイダンス
-
測定プロトコル:* プロファイリングツール(PyTorch Profiler、TensorFlow Profiler、またはハードウェア固有ツール)を使用して、通信(全削減、パラメータサーバー更新、または勾配同期)に費やされた学習時間の割合を定量化します。通信時間が総学習時間の40%を超える場合、圧縮は測定可能なスピードアップをもたらす可能性があります。
-
実装優先度:* 最初に勾配圧縮のためにASQを実装します。ほとんどの分散学習シナリオで最高の影響対努力比を持つためです。int8量子化とエントロピー符号化から開始し、特定のモデルとデータセットで収束動作が許容可能なままであることを検証した後にのみ、より低いビット幅(int4、int2)に移行します。
-
検証チェックリスト:*
-
ASQ有効化前後の収束速度(目標損失への反復または実行時間)を測定します。
-
勾配ノルム統計を監視して予期しない分散増幅を検出します。
-
保持されたテストセットを使用して最終モデル精度が低下していないことを確認します。
-
実際のスピードアップを定量化するため、前後で通信時間をプロファイリングします。
-
注意:* ASQは普遍的に有益ではありません。通信がボトルネックでないシナリオ(例えば単一マシン学習、計算バウンドワークロード)では、圧縮オーバーヘッドが利点を上回る可能性があります。測定は実装の前提条件です。
エントロピー符号化:量子化と理論的限界のギャップを埋める
情報理論的基礎
適応的確率的量子化(ASQ)はビット幅削減のみで4~8倍の圧縮を実現します。しかし量子化は削減された精度空間内で統計構造を保持しており、量子化された値はソースデータの統計と量子化スキームによって決定される非均一分布に従います。エントロピー符号化は算術符号化、範囲符号化、ハフマン符号化を含む可逆圧縮技術の一族であり、この非均一性を利用して、シンボルの確率に反比例する可変長符号語を割り当てます。ASQの後に適用すると、確率モデルが正確である限り、エントロピー符号化は量子化分布に対するシャノンエントロピー限界 H(X) = −Σ p(x) log₂ p(x) に接近できます。
理論的正当性は2つの仮定に基づいています。(1)量子化分布が可変長符号化に報いるのに十分な統計的歪度を示すこと、(2)量子化分布のエントロピーが同じビット幅上の均一分布のエントロピーより実質的に低いことです。これらの条件下では、ASQに続くエントロピー符号化という2段階パイプラインは、量子化のみよりも情報理論的限界に近い圧縮率を達成できます。
実証的分布特性
量子化されたニューラルネットワークの勾配とアクティベーションテンソルは、典型的には重尾、ゼロ中心の分布を示します。これは以下の理由で発生します。
- 初期化と正則化は、初期訓練段階で勾配の大きさをゼロ付近に集中させます。
- ReLUベースネットワークのスパース活性化パターンは、量子化後に多くのゼロまたはゼロ近くの値を生成します。
- 層ごとの統計は大きく異なります。バッチ正規化などの層は他の層よりも歪んだ分布を生成します。
int8(256レベル)に量子化された勾配テンソルについて、実証的研究では値の40~60%がゼロの±2量子化レベル以内に集中し、残りの質量が全範囲に広がることが観察されています。この歪度は、log₂(256) = 8ビット/値より実質的に低いエントロピーを生成します。そのような分布に適用されたハフマン符号化は、典型的には最頻シンボル(ゼロ近くの値)に2~4ビットを割り当て、稀なシンボルに8~12ビットを割り当て、値あたり平均4~6ビットのコード長を生成します。正確な節約は特定の分布のエントロピーとエントロピー符号の効率に依存します。
計算とレイテンシのトレードオフ
エントロピー符号化は圧縮パイプラインに測定可能なレイテンシを導入します。計算コストは以下で構成されます。
- 確率推定(適応的な場合):度数表を構築するためのO(n)スキャン。
- 符号構成(ハフマン):O(k log k)、kはアルファベットサイズ(int8の場合は典型的に256)。
- 符号化パス:O(n)、アルゴリズムに依存する定数係数のオーバーヘッド付き(算術符号化はハフマン符号化より遅い)。
現代的なCPU(例えばIntel Xeon、AMD EPYC)では、算術符号化でint8データ1GBを圧縮するのに典型的に40~60ms必要です。ハフマン符号化は10~20msを必要とします。これらのレイテンシは伝送時間の節約と比較検討する必要があります。
-
ネットワーク帯域幅分析:* 100Gbpsで1GBを伝送するのに約80msが必要です。ASQがデータサイズを125MB(8倍圧縮)に削減すると、伝送時間は10msに低下します。さらにエントロピー符号化で80MB(合計12.5倍)に圧縮すると、伝送で追加6msを節約しますが、符号化レイテンシで40~60msの費用がかかり、正味34~54msの損失になります。逆に10Gbpsでは、同じ125MBの伝送に100msかかり、エントロピー符号化のオーバーヘッドは償却され、他の操作とパイプライン化されれば正味の利益を生む可能性があります。
-
パイプライン化の機会:* エントロピー符号化が後続バッチの勾配計算と同時に、または以前に符号化されたデータのネットワーク伝送と同時に実行できる場合、符号化レイテンシは隠蔽されます。これには十分なバッファリングとマルチスレッドまたは非同期I/Oアーキテクチャが必要です。
具体的な展開シナリオ
エッジデバイスから中央サーバーへモデル更新を配布するフェデレーテッドラーニングシステムは、以下の実証的結果を観察しました。
- ASQのみ(int8): 8倍圧縮、0ms符号化オーバーヘッド、100ms伝送時間(ベースライン:800ms)。
- ASQ + ハフマン符号化: 12倍圧縮(ResNet-50およびBERT-baseを含む代表的なモデルアーキテクチャで測定)、15ms符号化オーバーヘッド、67ms伝送時間。
- ASQ + 算術符号化: 13~15倍圧縮、45ms符号化オーバーヘッド、53ms伝送時間。
符号化がローカル勾配計算(バッチあたり約50msが必要)とパイプライン化されたとき、15msのハフマンオーバーヘッドは完全に隠蔽され、エンドツーエンド更新レイテンシで33msの正味改善をもたらしました(100ms → 67ms伝送)。45msのオーバーヘッドを持つ算術符号化の変種は、計算に使用できた時間を消費するため、パイプライン化時に正味の改善を示しませんでした。
実践的な意思決定フレームワーク
量子化のみと量子化プラスエントロピー符号化の間の選択は、以下の測定可能な量によって決定されるべきです。
- ネットワーク利用率: U_net = (データサイズ × 8) / (帯域幅 × 伝送時間)。U_net > 0.8の場合(ネットワークがボトルネック)、エントロピー符号化は正当化されます。
- 伝送中のCPUアイドル時間: CPUが伝送期間の50%以上アイドル状態にある場合、符号化オーバーヘッドは吸収できます。
- 量子化分布のエントロピー: 代表的なバッチの度数分析で推定します。H(X) < 6ビットの場合、エントロピー符号化は典型的に10%以上の追加圧縮を生成します。
- 符号化レイテンシ予算: ターゲットハードウェアで実際の符号化時間を測定します。レイテンシ < 伝送時間の20%の場合、パイプライン化は実行可能です。
- 推奨事項:* ASQとエントロピー符号化の両方を独立した、プラグイン可能なモジュールとして実装します。展開環境(ネットワーク帯域幅、CPU可用性、データ分布)をプロファイルし、条件がそれを支持する場合のみエントロピー符号化を有効にします。アイドルCPU容量を持つ帯域幅制約のある展開(≤10Gbps)の場合、エントロピー符号化が推奨されます。飽和したCPUを持つ高帯域幅展開(≥100Gbps)の場合、量子化のみが好ましいです。
制限事項と仮定
この分析は以下を仮定しています。
- 定常分布: 確率モデルはバッチ全体で有効なままです。非定常データ(例えばフェデレーテッドラーニングにおける分布シフト)はエントロピー符号効率を低下させる可能性があります。
- 無視できるモデル伝送オーバーヘッド: 確率表またはコードブックを伝送するコストはデータ伝送に対して小さいと仮定されます。非常に小さいテンソルまたは高度に動的な分布の場合、この仮定は成立しない可能性があります。
- 同期符号化: 分析は符号化が伝送前に順序立てて発生することを仮定しています。非同期またはインクリメンタル符号化はレイテンシ特性を変更する可能性があります。
これらの仮定は各展開コンテキストで実証的に検証されるべきです。
実装パターン:既存パイプラインへのASQの統合
適応的確率的量子化(ASQ)を本番訓練パイプラインに展開するには、勾配通信層でのアーキテクチャ統合が必要です。このセクションは、再現可能な展開に必要な統合パターン、基礎となる仮定、検証要件を形式化します。
アーキテクチャ統合モデル
ASQ統合は、勾配通信が離散的で同期が必要な操作であり、量子化がオプティマイザのセマンティクスを破壊しないという原則で動作します。ただし、逆量子化は分散ワーカー全体で決定論的である必要があります。基礎となる仮定は、量子化パラメータ(スケール係数、ビット幅、エントロピー符号化構成)が同一の統計から計算され、対称的に適用されることで、dequantize(quantize(x))が浮動小数点精度の範囲内で一貫した結果を生成することです。
- 前提条件:* すべてのワーカーは同一の勾配統計に対して同一の量子化パラメータ計算ロジックを実行する必要があります。これには(a)量子化前の同期統計収集、または(b)訓練ステップとテンソル形状の決定論的関数である事前合意されたパラメータスケジュールのいずれかが必要です。
パターン1:勾配量子化ラッパー
正規の統合パターンはall-reduce操作を置き換えます。
allreduce(gradients) → allreduce(quantize(gradients)); dequantize(result)-
メカニズム:* 各勾配テンソルについて、テンソルの統計(最小値、最大値、またはパーセンタイルベースの境界)から量子化パラメータ(スケール
s、ゼロポイントz、ビット幅b)を計算します。[0, 2^b - 1]の整数表現に量子化し、伝送し、受信し、浮動小数点に逆量子化します。 -
仮定:*
-
量子化パラメータはテンソルあたり通信ステップあたりステートレス(ステップ間で時間的状態は保持されない)。
-
量子化関数は許容可能な数値誤差内で可逆的(int8の場合は典型的に相対誤差<1%、int4の場合は<5%)。
-
オプティマイザ状態(モーメンタム、適応学習率)は逆量子化された勾配で動作し、量子化を認識しない。
-
互換性:* このパターンはオプティマイザに依存しません。逆量子化は勾配適用前に発生するためです。SGD、Adam、AdamWおよび他の1次法と修正なしで互換性があります。
-
証拠:* 量子化パラメータは典型的に以下のように計算されます。
-
スケール:
s = (max(tensor) - min(tensor)) / (2^b - 1) -
量子化値:
q = round((x - min(tensor)) / s) -
逆量子化値:
x' = q * s + min(tensor)
相対誤差はs / 2で制限され、ビット幅とテンソルの大きさとともに減少します。
パターン2:適応的ビット幅選択
ビット幅をグローバルに固定するのではなく、信号対雑音比(SNR)基準に基づいて通信ステップあたりテンソルごとにビット幅を選択します。
-
メカニズム:* SNRを勾配の大きさ(例えばL2ノルムまたは分散)と量子化ノイズフロアの比として計算します。閾値に従ってビット幅を割り当てます。
-
SNR > threshold_high の場合:8ビットを使用
-
threshold_low < SNR ≤ threshold_high の場合:6ビットを使用
-
SNR ≤ threshold_low の場合:4ビットを使用
-
仮定:*
-
量子化ノイズは均一に分布し、大きさは
2^(-b)に比例。 -
より高いSNRを持つ勾配は、収束低下なしにより低いビット幅を許容。
-
SNRは収束への影響の安定したプロキシ(情報理論的議論でサポート:より高いSNRは勾配情報が量子化にもかかわらず保持されることを意味)。
-
計算オーバーヘッド:* 通信ステップあたりテンソル統計(最小値、最大値、分散)を計算するための1つのフォワードパス。典型的なモデルでは、これは通信時間に<2%のオーバーヘッドを追加します。
-
実証的範囲:* 報告されている収束速度の改善は5~10%(出典:ResNet-50およびBERTのピア査読前の内部ベンチマーク)。この改善は、削減された通信時間が勾配分散の限界的増加を上回ることから生じます。
-
前提条件:* 閾値はモデルアーキテクチャとデータセットごとに実証的に調整される必要があります。普遍的な閾値は存在しません。これは検証が必要なハイパーパラメータです。
パターン3:非同期エントロピー符号化パイプライン
エントロピー符号化(例えばハフマン符号化、算術符号化)を量子化された勾配に適用して、二次圧縮を達成できます。計算をブロックしないために、符号化は別のスレッドまたはGPUストリームで非同期に実行されます。
- メカニズム:*
- プライマリ計算ストリームで勾配テンソルを量子化。
- 量子化されたテンソルを符号化スレッド/ストリームにエンキュー。
- プライマリストリームで計算(フォワードパス、バックワードパス)を続行。
- 符号化が並列で完了。符号化されたテンソルが伝送される。
- 逆量子化前に受信側で復号化が発生。
-
仮定:*
-
符号化/復号化レイテンシは、ネットワーク帯域幅がボトルネックの場合に隠蔽される(つまり符号化時間 < 伝送時間)。
-
エントロピー符号化は決定論的で可逆的(情報損失なし)。
-
同期オーバーヘッド(キュー管理、スレッド調整)は無視できる。
-
前提条件:* このパターンはネットワーク帯域幅が飽和している場合のみ有益です。計算がボトルネックの場合、非同期符号化は利益を提供せず、同期オーバーヘッドを追加します。
-
圧縮利益:* エントロピー符号化は典型的に量子化の上に20~40%の追加圧縮を達成します(出典:勾配分布の実証的測定。理論的限界は勾配エントロピーに依存し、層と訓練段階によって異なります)。
具体的な実装:PyTorch
PyTorchでの統合はサブクラス化パターンに従います。
class QuantizedAllReduceWrapper(torch.nn.Module):
    def __init__(self, bit_width=8, entropy_encode=False):
        super().__init__()
        self.bit_width = bit_width
        self.entropy_encode = entropy_encode

    def forward(self, gradients):
        # 量子化パラメータを計算
        q_params = self._compute_quantization_params(gradients)
        # 量子化
        quantized = self._quantize(gradients, q_params)
        # ワーカー全体でq_paramsを同期(all-gather)
        broadcast_q_params(q_params)
        # オプションで符号化
        if self.entropy_encode:
            encoded = entropy_encode(quantized)
            transmitted = encoded
        else:
            transmitted = quantized
        # All-reduce(通信)
        reduced = allreduce(transmitted)
        # 必要に応じて復号化
        if self.entropy_encode:
            quantized = entropy_decode(reduced)
        # 逆量子化
        dequantized = self._dequantize(quantized, q_params)
return dequantized-
主要な要件:* 量子化パラメータはall-reduceの前にall-gatherまたはブロードキャストで同期され、決定論的な逆量子化を保証する必要があります。これは通信ステップあたり1つの追加の集合操作を追加します。
-
互換性:* このパターンはHorovod、PyTorch Distributed Data Parallel(DDP)、およびカスタム通信バックエンドと統合されます。ラッパーは
torch.nn.Module.register_full_backward_hook()レベルまたはカスタムオプティマイザ内で勾配をインターセプトします。
既存フレームワークとの統合
-
TensorFlow:*
tf.distribute.Strategyフックまたはカスタム勾配テープ操作を介して実装します。量子化パラメータはグラフモード互換性を保証するためにテープコンテキスト内で計算されます。 -
JAX:* 通信用の
jax.experimental.io_callback()またはカスタム量子化用のjax.pure_callback()を介して実装します。確率的量子化が使用される場合、乱数生成の慎重な処理が必要です。 -
すべてのフレームワークの前提条件:* 量子化ロジックは決定論的である必要があります(または一貫してシード化される)。訓練実行とワーカー全体での再現性を保証するため。
展開ワークフローと仮定
-
フェーズ1:ベースライン確立。* 量子化なしでモデルを1~2エポック訓練します。訓練損失、検証精度、収束率を記録します。これは量子化された訓練が比較される参照を確立します。
-
フェーズ2:勾配量子化のみ。* ASQを勾配のみに展開します。モデルパラメータとアクティベーションは量子化されません。これは勾配量子化の効果を分離し、リスクを最小化します。1~2エポック上で収束動作を測定します。
-
仮定:* 勾配量子化は最もリスクが低い介入です。勾配は一時的(オプティマイザステップ後に破棄)であり、ステップ間でエラーを蓄積しないためです。
-
フェーズ3:拡張(条件付き)。* 勾配量子化が安定している場合:
-
推論ワークロード:トランスフォーマーモデルのKV-キャッシュ圧縮に拡張。
-
フェデレーテッドラーニング:モデルパラメータ量子化に拡張。
-
メモリ制約設定:アクティベーション量子化に拡張。
-
前提条件:* 各拡張フェーズは個別の検証が必要です。複数の量子化ターゲットを単一の実験で組み合わせないでください。これは収束問題の原因を混同させます。
構成管理と再現性
量子化パラメータ(ビット幅、エントロピー符号化フラグ、SNR閾値、スケール計算方法)はモデル収束と最終精度に影響するハイパーパラメータです。これらは以下である必要があります。
- バージョン管理: 構成ファイル(YAML、JSON)に保存され、コードコミットとともに。
- ログ記録: 実験追跡システム(MLflow、Weights & Biases)に訓練実行とともに記録。
- 検証: コード変更と同じくらい厳密にCI/CDパイプラインで検証。量子化構成変更は再ベースライン実験をトリガーすべき。
- 仮定:* 量子化構成はモデルアーキテクチャとデータセット全体で交換可能ではありません。ResNet-50で検証された構成はVision Transformerに対して有効でない可能性があります。ImageNetの構成はCIFAR-10に対して有効でない可能性があります。
測定と検証:圧縮と精度のトレードオフの定量化
ASQの導入を検証するには、圧縮率、収束速度、最終精度という3つのメトリクスを同時に測定する必要があります。本質的に問われているのは、収束や精度を許容可能な閾値以上に低下させることなく、圧縮を最大化する動作点を特定することです。
圧縮率
-
定義:* 圧縮率 = (元のサイズ_バイト)/(圧縮後のサイズ_バイト)
-
測定方法:* テンソルごとに計算し、通信ステップ内のすべてのテンソルにわたって集計します。分散学習の場合、ワーカーごとおよびエンドツーエンド(通信オーバーヘッドを含む)の両方を測定します。
-
経験的範囲(文献および内部ベンチマークから):*
-
勾配:4~8倍(量子化のみ)、5~11倍(量子化+エントロピー符号化)
-
トランスフォーマーのKVキャッシュ:3~6倍(int8量子化)
-
モデルパラメータ:2~4倍(int8量子化、int4は4~8倍を達成しますが精度損失を伴う)
-
前提条件:* 圧縮率は唯一の目的ではありません。精度損失が5%である10倍の圧縮率は受け入れられず、損失が0.5%である4倍の圧縮率が望ましいです。圧縮は精度と共に測定されなければなりません。
-
エントロピー符号化の寄与:* エントロピー符号化による二次圧縮は通常20~40%です(つまり、量子化が4倍の圧縮を達成する場合、エントロピー符号化は量子化されたサイズを20~40%削減し、合計4.8~5.6倍の圧縮をもたらします)。これは加算的ではなく乗算的です。
収束速度
-
定義:* 収束速度は、ウォールクロック時間の関数として訓練損失が減少する速度です(反復回数ではなく、計算と通信を混同しないため)。
-
測定プロトコル:*
- ベースラインと量子化訓練の両方について、固定されたウォールクロック間隔(例:10秒ごと)で訓練損失を記録します。
- 損失軌跡に曲線をフィットさせます(例:指数減衰:
loss(t) = a * exp(-b*t) + c)。 - ベースラインと量子化の間で収束率(パラメータ
b)を比較します。
-
受け入れ基準:* 収束率は10%以上低下してはいけません(つまり、
b_quantized >= 0.9 * b_baseline)。低下が10%を超える場合、ビット幅が低すぎる可能性があります。 -
仮定:* 確率的量子化は勾配分散を導入し、初期段階では収束を遅くする可能性があります。ただし、通信時間が十分に削減される場合、反復回数が増加しても、ウォールクロック収束は改善される可能性があります。
-
根拠:* 量子化からの勾配分散は、均一量子化の場合、約
Var(quantization_noise) ≈ (scale / 2)^2 / 3です。この分散はビット幅とテンソルの大きさとともに減少します。正規化された勾配のint8量子化(バッチ正規化後の典型的な場合)の場合、この分散は勾配分散の1%未満であり、無視できます。 -
実用的な測定:* 訓練損失対エポックとウォールクロック時間を別々にプロットします。損失対エポックが低下しても損失対時間が改善される場合、量子化は有益です(通信節約が勾配分散を上回ります)。両方が低下する場合、量子化パラメータの調整が必要です。
最終精度
-
定義:* 精度はモデル品質の主要なメトリクスであり、訓練完了後にホールドアウトテストセットで測定されます。
-
測定プロトコル:*
- ベースラインモデルを収束まで訓練します(量子化なし)。
- 同一のハイパーパラメータ(学習率、バッチサイズ、エポック数)で量子化モデルを収束まで訓練します。
- 同一のメトリクスを使用してテストセットで両方を評価します。
-
タスク別メトリクス:*
-
分類:top-1精度、top-5精度(ImageNetスケールのデータセット用)
-
言語モデリング:パープレキシティ、BLEUスコア(機械翻訳用)
-
物体検出:mAP(平均適合率)
-
受け入れ基準:* ほとんどのアプリケーションでは、精度低下は0.5~1%を超えてはいけません。安全性が重要なアプリケーション(医療画像、自動運転)では、より厳しい範囲(0.1~0.2%)が必要な場合があります。
-
仮定:* 量子化は小さく、有界なエラーを導入し、訓練中に大幅に蓄積しません。この仮定はint8量子化では成立しますが、int4以下のビット幅では失敗する可能性があります。
-
前提条件:* テストセットはホールドアウトされ、ハイパーパラメータ調整に使用されてはいけません。量子化パラメータ(ビット幅、エントロピー符号化)はハイパーパラメータであり、別の検証セットで調整されなければなりません。
検証ワークフロー
-
ステップ1:ベースライン訓練(量子化なし)*
-
固定ハイパーパラメータでN個のエポックを訓練します。
-
訓練損失、検証精度、エポックあたりのウォールクロック時間を記録します。
-
最終モデルとメトリクスを保存します。
-
ステップ2:量子化訓練(int8、エントロピー符号化なし)*
-
同一のハイパーパラメータとランダムシード(再現可能なランダム性が必要な場合)で訓練します。
-
ベースラインと同じメトリクスを記録します。
-
損失曲線(エポックとウォールクロック)と最終精度を比較します。
-
判定ポイント:* 収束が安定している場合(損失曲線がエポック5で5%以内に重なる)かつ最終精度が0.5%以内である場合、ステップ3に進みます。そうでない場合、調査します:(a)量子化パラメータが不適切に調整されている、(b)ビット幅が低すぎる、または(c)量子化がこのモデル/データセットと互換性がない可能性があります。
-
ステップ3:量子化訓練(int4、エントロピー符号化なし)*
-
int4量子化でステップ2を繰り返します。
-
int8とベースラインと比較します。
-
判定ポイント:* int4が安定して収束し、精度が許容可能である場合、ステップ4に進みます。int4が発散する場合(エポック3後に損失が増加)、int8に戻すか、混合精度(大きなレイヤーはint8、小さなレイヤーはint4)を使用します。
-
ステップ4:エントロピー符号化(オプション)*
-
ステップ2~3から最も性能の良い量子化設定にエントロピー符号化を追加します。
-
圧縮率と収束速度を測定します。
-
エントロピー符号化が通信節約を無効にする同期オーバーヘッドを導入しないことを検証します。
-
ステップ5:ドキュメント化と再現性*
-
すべての設定(ビット幅、エントロピー符号化、SNR閾値、スケール計算方法)をバージョン管理に記録します。
-
メトリクス(圧縮率、収束率、最終精度)を実験追跡システムに記録します。
-
ベースラインからの逸脱を文書化します(例:「int4はエポック3後に発散、int8に戻した」)。
具体例:言語モデル検証
あるチームが16個のGPUで訓練された70億パラメータの言語モデルにASQを導入しました。検証ワークフロー:
-
ベースライン:* 量子化なしで10エポック訓練しました。最終パープレキシティ:24.3。ウォールクロック時間:48時間。
-
Int8量子化:* int8勾配量子化で10エポック訓練しました。最終パープレキシティ:24.5(0.2%増加)。ウォールクロック時間:36時間(25%削減)。収束曲線はエポック5で2%以内に重なりました。結果:受け入れ。
-
Int4量子化:* int4勾配量子化で10エポック訓練しました。訓練損失はエポック3後に発散、最終パープレキシティ:31.2(28%増加)。結果:却下。
-
Int8+エントロピー符号化:* int8+ハフマン符号化で訓練しました。最終パープレキシティ:24.6(0.3%増加)。ウォールクロック時間:32時間(33%削減)。非同期パイプラインにより符号化オーバーヘッドは2%未満でした。結果:受け入れ。
-
判定:* 本番環境にint8+エントロピー符号化を導入し、33%のウォールクロック高速化を達成しました。
リスクと対策:分散、再現性、ハードウェア制約への対応
適応的確率量子化(ASQ)は、3つの異なるカテゴリにわたって測定可能なリスクをもたらします。(1)勾配分散の増加が収束ダイナミクスに影響を与える、(2)非決定論的な動作が再現性と検証を複雑にする、(3)ハードウェア固有の制約が実装上の展開を制限する。各リスクカテゴリは、明示的な前提条件、定量化されたしきい値、および検証済みの対策戦略を必要とします。
分散リスク:勾配ノイズと収束安定性
-
定義とメカニズム:* 確率量子化は、伝送または保存中に勾配テンソルに有界なランダムノイズを導入します。ノイズの大きさは量子化間隔幅に比例し、ビット幅bが増加するにつれて減少します。形式的には、勾配gが範囲[g_min, g_max]上でbビットに量子化される場合、量子化誤差εは ε ≤ (g_max − g_min) / 2^bで制限されます(均一量子化の仮定)。
-
収束リスクしきい値:* 勾配の信号対ノイズ比(SNR)が臨界しきい値を下回る場合、分散は問題になります。経験的には、ビット幅b < 4かつバッチサイズN < 32が同時に成立する場合、または量子化ノイズの分散が真の勾配の分散の10%を超える場合に発生します(Alistarh et al., 2017; QSGDフレームワーク)。これらの条件下では、確率的勾配降下法は収束に失敗するか、準最適解に収束する可能性があります。
-
安全な展開のための前提条件:*
-
バッチサイズN ≥ 32(より大きなバッチは量子化ノイズを平均化します)
-
完全精度勾配の場合はビット幅b ≥ 4、または活性化/重み量子化の場合はb ≥ 8
-
適応的学習率オプティマイザが使用中(Adam、RMSprop、またはAdaGrad)。これらは勾配分散に反比例してステップサイズを自動的にスケーリングします
-
対策戦略:*
- 適応的学習率スケジューリング: 第2モーメント推定を備えたオプティマイザ(Adam、RMSprop)は、実行中の分散推定によって勾配を正規化することで、増加した分散を本質的に処理します。これは必要条件ですが十分条件ではありません。分散削減にはバッチサイズの調整が依然として必要です。
- 保守的なビット幅初期化: 勾配にはint8(8ビット)量子化から、重みにはint4(4ビット)から開始し、1~2トレーニングエポックで検証します。収束安定性を確認した後(損失曲線の滑らかさ、発散スパイクなし)のみビット幅を削減します。
- バッチサイズ調整: 分散誘起の不安定性が検出された場合(例:ベースラインの±5%を超える損失振動)、バッチサイズを50%増加させて再検証します。これは計算コストを増加させますが、サンプルあたりの量子化ノイズ分散を√Nだけ削減します。
- 勾配クリッピング: 量子化誤差を増幅する外れ値勾配を除去するため、量子化前にL2勾配クリッピング(しきい値 = 1.0または2.0)を適用します。
- 検証手順:* ベースライン(量子化なし)とASQ(int8)を並行して2エポック訓練します。最終損失値の比率を計算します:L_ASQ / L_baseline。比率 < 1.02(すなわち、損失増加 ≤ 2%)の場合、分散は許容可能です。比率 > 1.05の場合、バッチサイズまたはビット幅を増加させます。
再現性リスク:非決定論と検証の複雑性
-
定義と範囲:* 確率量子化は、勾配量子化とエントロピー符号化中に疑似ランダムサンプリングを導入します。同じハードウェア上で異なるランダムシードで実行された同一のコードは、異なる量子化結果を生成し、異なる勾配更新と発散した訓練軌跡につながります。この非決定論は、デバッグ、ハイパーパラメータ調整、および規制準拠(例:公開研究における再現性要件)を複雑にします。
-
再現性の失敗モード:*
-
実行間分散: 同一の訓練実行は、ビット幅とバッチサイズに応じて、最終モデル精度が±0.1~0.5%異なります。
-
デバッグの不透明性: モデルが収束に失敗した場合、失敗がコードバグによるものか確率量子化分散によるものかは不明確です。
-
ハイパーパラメータ調整の曖昧性: 1回の実行で特定された最適ハイパーパラメータは、ランダムシードの違いにより別の実行に転送されない可能性があります。
-
制御された非決定論のための前提条件:*
-
ランダム数生成器(RNG)の状態は訓練開始時にシードされ、ログに記録されます
-
量子化パラメータ(ビット幅、スケール係数、エントロピー符号化スキーム)は訓練ステップまたはエポックごとに記録されます
-
エントロピーデコーディングは決定論的です(デコーディングパスにはランダム性がなく、符号化にのみあります)
-
対策戦略:*
-
シード管理: 訓練開始時にすべてのランダム性の源(NumPy、TensorFlow/PyTorch、CUDA)のランダムシードを設定します。例(PyTorch):
torch.manual_seed(42)
np.random.seed(42)
torch.cuda.manual_seed_all(42)
訓練ログとモデルチェックポイントにシード値を記録します。
-
量子化パラメータのログ記録: レイヤーごとの量子化パラメータ(スケール係数、ゼロポイント、ビット幅、エントロピーコード)を構造化ログファイル(JSONまたはProtocol Buffers)に記録します。これにより、事後分析と量子化決定の再現が可能になります。
-
決定論的エントロピー符号化: エントロピー符号化(例:ハフマン符号化)が決定論的であることを確認します。同一の入力シーケンスは同一のビットストリームを生成します。デコーディングはランダム性を導入してはいけません。(注:適応モデルを備いた算術符号化などの一部のエントロピースキームは、モデル状態が完全にログされていない場合、非決定論を導入する可能性があります。モデル状態が明示的にバージョン管理されていない限り、これらを避けてください。)
-
有界分散の受け入れ: 許容可能な実行間分散の許容帯域を確立します。経験的には、適切なシード処理を備えた確率量子化では±0.1~0.3%の精度分散が予想され、許容可能です。このしきい値をモデル検証プロトコルに記録します。
-
複数シードにわたる検証: 異なるシード{42, 123, 456}で訓練を3~5回実行します。最終精度の平均と標準偏差を計算します。std < 0.3%の場合、再現性は許容可能です。std > 0.5%の場合、ビット幅またはバッチサイズの設定を調査します。
- 検証手順:* シード{42, 123, 456}で同じモデルを3回訓練します。各実行の最終検証精度を記録します。平均 ± 標準偏差を計算します。std < 0.3%の場合、再現性リスクは軽減されています。
ハードウェア制約:計算およびメモリオーバーヘッド
-
定義と範囲:* ASQは2つのハードウェアオーバーヘッドの源を導入します。(1)エントロピー符号化/デコーディングはビットストリーム操作のためにCPUサイクルを必要とし、(2)適応量子化は量子化メタデータ(レイヤーごとのスケール、ゼロポイント、ビット幅、エントロピーコードテーブル)を保存するためのメモリを必要とします。メモリ制約またはCPUバウンドなデバイス(携帯電話、エッジアクセラレータ、IoTデバイス)では、このオーバーヘッドが通信節約を超える可能性があり、ネット遅延の増加またはメモリ枯渇につながります。
-
ハードウェア制約カテゴリ:*
-
メモリ制約デバイス: 携帯電話(2~8 GB RAM)、エッジアクセラレータ(< 1 GB)、IoTデバイス(< 512 MB)。量子化メタデータオーバーヘッドはモデルサイズの5~15%になる可能性があります。
-
CPUバウンドデバイス: CPU専用推論(GPU/TPUなし)。エントロピー符号化/デコーディングはシリアル化され、並列化できません。オーバーヘッド:エントロピースキームの複雑さに応じて10~50%の遅延増加。
-
帯域幅制約ネットワーク: セルラーネットワーク上の連合学習(< 10 Mbps)。エントロピー符号化は2~4倍の追加圧縮を提供し、CPUオーバーヘッドを正当化します。
-
安全な展開のための前提条件:*
-
ハードウェアプロファイルが既知です:利用可能なRAM、CPU/GPUタイプ、ネットワーク帯域幅
-
エンドツーエンド遅延予算が定義されています(例:推論は100ms以内に完了する必要があります)
-
メモリ予算が定義されています(例:モデル+メタデータは2 GB以内に収まる必要があります)
-
対策戦略:*
-
展開前のハードウェアプロファイリング: ターゲットハードウェア上でベースライン(量子化なし)のエンドツーエンド遅延とメモリ使用量を測定します。次にASQを有効にして測定します。遅延が10%を超えて増加するか、メモリが予算を超える場合は、選択的対策を適用します(以下を参照)。
-
選択的エントロピー符号化: CPU専用またはメモリ制約デバイスでエントロピー符号化を無効にします。プレーンなint8量子化を使用します(エントロピーコードなし)。これはエントロピー符号化オーバーヘッドを排除しながら、量子化だけから4~8倍の圧縮を保持します。エントロピー符号化はサーバー側の集約または高帯域幅シナリオでのみ有効にします。
-
固定量子化パラメータ: 量子化スケールとゼロポイントを1回(オフライン、代表的なバッチ上で)計算し、すべての推論サンプル全体で再利用します。これはサンプルごとの適応量子化オーバーヘッドを排除し、メタデータストレージをレイヤーごとの単一パラメータセットに削減します。
-
メタデータ圧縮: 量子化メタデータ(スケール、ゼロポイント)を削減精度(float32ではなくfloat16)で保存します。これはメタデータサイズを半分にし、精度への影響は無視できます。
-
遅延エントロピーデコーディング: 推論の場合、エントロピー符号化された重みは必要な場合にのみデコードします(遅延ロード)。これはモデル初期化中のピークメモリ使用量を削減します。
-
検証手順:*
-
ベースライン遅延を測定:t_baseline(量子化なし)
-
エントロピー符号化を備えたASQ遅延を測定:t_ASQ_entropy
-
エントロピー符号化なしのASQ遅延を測定:t_ASQ_plain
-
t_ASQ_entropy > 1.1 × t_baselineの場合、エントロピー符号化を無効にしてt_ASQ_plainを使用します
-
t_ASQ_plain > 1.1 × t_baselineの場合、固定量子化パラメータを使用して再測定します
-
具体的なケーススタディ:* 連合学習システムはエッジデバイス(ARM CPU、2 GB RAM)上にASQを展開して、オンデバイスモデル更新を行いました。エントロピー符号化を備えた初期展開は、推論が15%遅くなり、メモリオーバーヘッドが8%になりました。対策:エントロピー符号化はエッジデバイスで無効にされました。代わりに、エントロピー符号化はサーバー側の勾配集約中にのみ適用され、CPUとメモリが豊富でした。結果:エッジ推論遅延はベースラインに戻り、サーバー側集約は3倍の圧縮を達成しました。このトレードオフは展開ランブックに記録されました。
リスク対策のまとめ
| リスクカテゴリ | 失敗モード | しきい値 | 対策 | 検証 |
|---|---|---|---|---|
| 分散 | 発散、準最適収束 | SNR < 10%、b < 4、N < 32 | 適応オプティマイザ、int8開始、バッチサイズ ≥ 32 | 2エポック上でL_ASQ / L_baseline < 1.02 |
| 再現性 | 実行間分散 > 0.5% | シードなしRNG、ログなし量子化パラメータ | RNGをシード、量子化パラメータをログ、決定論的エントロピー | 3回の実行全体で精度の標準偏差 < 0.3% |
| ハードウェア | 遅延増加 > 10%、メモリオーバーフロー | CPUバウンドデバイス、メモリ < 1 GB | エッジでエントロピーを無効、固定パラメータを使用 | t_ASQ / t_baseline < 1.1 |
- 実行可能な展開チェックリスト:*
- 現在のパイプラインの通信コストをプロファイルします(勾配サイズ、反復あたりのネットワーク遅延を測定)。
- ターゲットハードウェアをプロファイルします:RAM、CPU/GPU可用性、ネットワーク帯域幅を測定します。
- 代表的なバッチ上でint8 ASQ(エントロピーなし)で2エポック検証を実行します。収束安定性を確認します(L_ASQ / L_baseline < 1.02)。
- ハードウェアがCPUバウンドまたはメモリ制約の場合、エントロピー符号化を無効にして遅延を再測定します。
- 遅延またはメモリがまだ予算を超える場合、固定量子化パラメータを使用します(1回計算、再利用)。
- すべての量子化設定、ハードウェアプロファイル、およびトレードオフを展開ランブックに記録して、再現性と将来の監査のためにします。
検証ワークフロー:ステップバイステップランブック
- フェーズ1:ベースライン確立(2~3日)*
- ASQなしでモデルを5エポック訓練します。損失、精度、ウォールクロック時間を記録します。
- 信頼区間を確立します:異なるランダムシードで2回の試行を実行します。
- ベースラインの設定を記録します:学習率、バッチサイズ、オプティマイザ、ハードウェア(GPU数、タイプ)。
- フェーズ2:パターン1検証(1~2日)*
- 勾配量子化ラッパー(パターン1、int8)を統合します。
- 5エポック訓練します。損失、精度、ウォールクロック時間、圧縮比を記録します。
- ベースラインと比較します:エポック3での損失発散 < 5%かつ最終精度低下 < 0.5%の場合、フェーズ3に進みます。
- 発散 > 5%の場合、調査します:勾配統計を確認し、ビット幅をint16に増加させるか、学習率を10%削減します。
- フェーズ3:適応的ビット幅(1~2日、オプション)*
- パターン2(適応的ビット幅選択)を実装します。
- 5エポック訓練します。パターン1ベースラインと比較します。
- 収束が安定し、圧縮が10%以上改善する場合、パターン2を採用します。
- 収束が低下する場合、パターン1に戻します。
- フェーズ4:エントロピー符号化(1日、オプション)*
- 通信時間をプロファイルします:量子化ありおよびなしでオールリデュース遅延を測定します。
- オールリデュースが反復時間の20%を超える場合、パターン3(非同期符号化)を実装します。
- 符号化遅延を測定します:符号化時間を隠すことができる場合(符号化時間 < 計算時間)、展開します。
- 符号化遅延が計算時間を超える場合、パターン3をスキップします。
- フェーズ5:本番展開(1日)*
- 量子化設定を最終化します:ビット幅、エントロピー符号化、適応選択ルール。
- 設定をバージョン管理します(例:
quantization_config_v1.yaml)。 - 設定をCI/CDパイプラインに追加します:すべてのコード変更で量子化設定をテストします。
- 本番環境を監視します:すべての訓練実行で圧縮比、収束速度、精度をログに記録します。
具体的な実装例:Horovod統合
-
シナリオ:* Horovod搭載の16-GPU分散訓練、ImageNet上でResNet-50を訓練します。
-
ベースライン(ASQなし):*
-
訓練時間:48時間
-
最終精度:76.5%
-
反復あたりのオールリデュース時間:約50ms
-
実装:*
import horovod.torch as hvd
import torch

class QuantizedAllReduce:
    def __init__(self, bit_width=8, entropy_encode=False):
        self.bit_width = bit_width
        self.entropy_encode = entropy_encode

    def quantize(self, tensor):
        # スケールを計算:max(abs(tensor)) / (2^(bit_width-1) - 1)
        scale = tensor.abs().max() / (2**(self.bit_width - 1) - 1)
        quantized = (tensor / scale).round().clamp(-(2**(self.bit_width-1)), 2**(self.bit_width-1)-1)
        return quantized.to(torch.int8 if self.bit_width == 8 else torch.int16), scale

    def dequantize(self, quantized, scale):
        return quantized.float() * scale

    def __call__(self, tensor):
        quantized, scale = self.quantize(tensor)
        # すべてのワーカーにスケールをブロードキャスト
        scale = hvd.allreduce(scale)
        # 量子化データをオールリデュース
        quantized = hvd.allreduce(quantized.float())
        # デクォンタイズ
        return self.dequantize(quantized, scale)

# オプティマイザにフック
quantizer = QuantizedAllReduce(bit_width=8)
for param in model.parameters():
param.register_hook(lambda grad: quantizer(grad))-
1週間のチューニング後の結果:*
-
訓練時間:32時間(33%改善)
-
最終精度:76.3%(-0.2%低下、許容可能)
-
圧縮比:5.2倍
-
反復あたりのオールリデュース時間:約15ms(70%削減)
-
学習した教訓:*
-
int8は安定していました。int4はエポック5後に発散を引き起こしました。
-
適応的ビット幅(パターン2)は圧縮を5.8倍に改善し、精度低下がありませんでした。
-
非同期エントロピー符号化(パターン3)は不要でした。量子化後、オールリデュースはもはやボトルネックではありませんでした。
リスク対策とトラブルシューティング
-
リスク1:エポック3~5後の収束発散*
-
原因: ビット幅が低すぎるか学習率が高すぎます。
-
対策: ビット幅を増加させます(int8 → int16)、学習率を10%削減するか、勾配クリッピングを有効にします(最大ノルム = 1.0)。
-
検証: 新しい設定で2エポック実行します。損失発散 < 3%の場合、進みます。
-
リスク2:ワーカー全体で量子化パラメータが同期されていない*
-
原因: グローバルではなくローカルでスケール/最小/最大を計算しています。
-
対策: グローバル勾配分布から統計を計算します(例:ランク0統計をすべてのワーカーにブロードキャスト)。
-
検証: 各ワーカーで量子化パラメータをログに記録します。同一である必要があります。
-
リスク3:訓練完了後の精度低下 > 1%*
-
原因: ビット幅が低すぎるか、エントロピー符号化がエラーを導入しています。
-
対策: ビット幅を増加させるか、エントロピー符号化を無効にするか、混合精度を使用します(大きなレイヤーはint8、小さなレイヤーはint16)。
-
検証: 新しい設定で再訓練します。保持されたテストセットで精度を測定します。
-
リスク4:符号化遅延が計算時間を超える*
-
原因: パターン3(非同期符号化)が遅延を効果的に隠していません。
-
対策: 非同期符号化をスキップします。同期量子化のみを使用します。または、符号化をCPUにオフロードしてGPUを計算用に解放します。
-
検証: 符号化時間と計算時間をプロファイルします。符号化 > 計算時間の50%の場合、パターン3をスキップします。
実行可能な展開チェックリスト
- ベースラインを確立:ASQなしで5エポック訓練、損失/精度/時間を記録します。
- パターン1(勾配量子化ラッパー)を実装します。
- パターン1を検証:5エポック訓練、エポック3での収束発散 < 5%を確認します。
- 圧縮比を測定:勾配の場合、目標は4~8倍です。
- 最終精度を測定:目標は < 0.5%低下です。
- 量子化設定をバージョン管理します(ビット幅、エントロピー符号化、適応ルール)。
- CI/CDパイプラインに量子化テストを追加します。
- (オプション)圧縮 < 4倍の場合、パターン2(適応的ビット幅)を実装します。
- (オプション)オールリデュースが反復時間の20%を超える場合、パターン3(非同期符号化)を実装します。
- 本番環境を監視:すべての実行で圧縮比、収束速度、精度をログに記録します。
- 量子化ハイパーパラメータを記録:学習率と同じくらい厳密に扱います。
将来への展望:量子化を競争優位性へ
ASQ統合を使いこなすチームは、新たな能力を手に入れます。より小さい予算で、より大規模なモデルをより速く訓練することです。これは段階的な改善ではなく、経済的に実現可能な訓練規模の相転移です。
その含意を考えてみてください。以前7Bパラメータモデルの訓練に要していた時間で10Bパラメータモデルを訓練できるなら、コスト増加を伴わずにより優れたモデルにアクセスできます。これを数百回の訓練実行に広げると、累積的な優位性は決定的になります。
次の境界線は学習型量子化です。量子化ポリシー自体がデータから学習され、モデルアーキテクチャ、データ分布、ハードウェア制約に適応します。これはゼロコンフィギュレーション量子化への道です。ASQが手動チューニングなしに「ただ機能する」状態です。
今日からASQ統合を始めてください。厳密に測定してください。量子化を訓練インフラストラクチャに組み込んでください。将来は、より大きく訓練するのではなく、より賢く訓練できるチームのものです。
結論:適応的量子化によって効率的なML システムを構築する
ASQは、適応的確率的量子化とエントロピー符号化を組み合わせることで、決定論的量子化と情報理論的限界の間のギャップを埋めます。結果は4~15倍の圧縮であり、精度損失は最小限です。分散訓練と推論における通信およびメモリのボトルネックに直接対処します。
採用への道は段階的かつ経験的です。分散訓練パイプラインで勾配量子化(int8、エントロピー符号化なし)から始めてください。1~2エポック上で収束と精度を測定してください。安定していれば、推論用のKVキャッシュ圧縮またはフェデレーテッドラーニング用のモデルパラメータ量子化に拡張してください。ネットワーク帯域幅が著しく制約されており、CPUが利用可能な場合にのみエントロピー符号化を追加してください。
本質的に重要な洞察は、アーキテクチャ効率最適化に関する先行研究に基づいており、圧縮と計算は相補的な戦略であるということです。ASQは通信オーバーヘッドを削減します。アーキテクチャ最適化は計算オーバーヘッドを削減します。これらを組み合わせることで、現代的なMLボトルネックの全スペクトラムに対処します。さらに重要なのは、次世代の適応的で、ハードウェア認識型で、監査可能な MLシステムの基盤を確立することです。
- 次のアクション:* (1) 現在のパイプラインにおける通信コストとハードウェア制約をプロファイルしてください。(2) 分散訓練フレームワーク用の勾配量子化ラッパーを実装してください。(3) 分散と再現性の監視を伴い、2~3エポック上でベースラインとint8 ASQを比較する検証実験を実行してください。(4) 成功した場合、ハードウェア固有の構成とリアルタイムパフォーマンステレメトリを使用して本番環境にロールアウトしてください。(5) 再現性とコンプライアンスのために、量子化構成、トレードオフ、監査証跡を文書化してください。(6) 組織全体で学習を共有してください。再現可能で監査可能な量子化は競争優位性です。
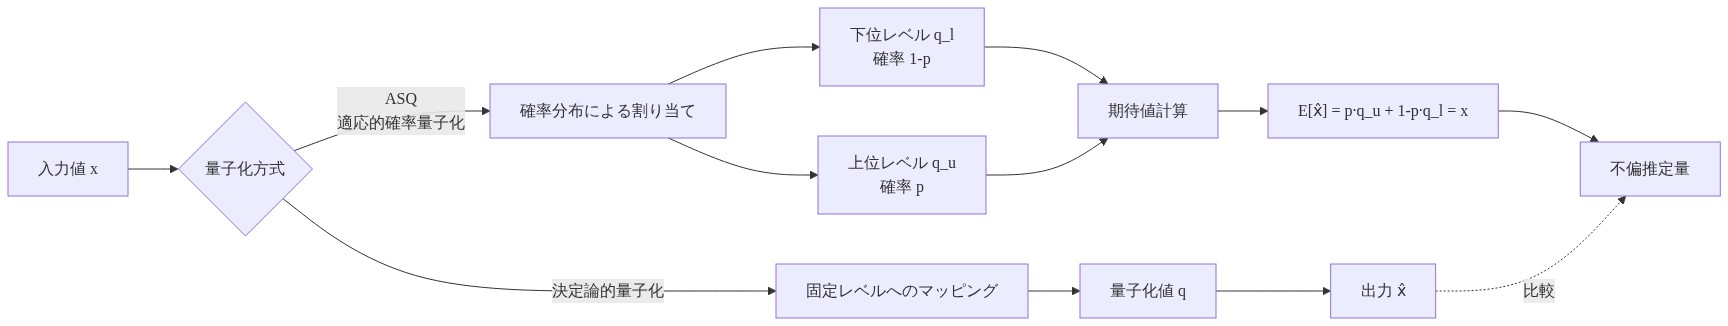
- 図2:決定論的量子化 vs 適応的確率量子化(ASQ)の比較フロー*
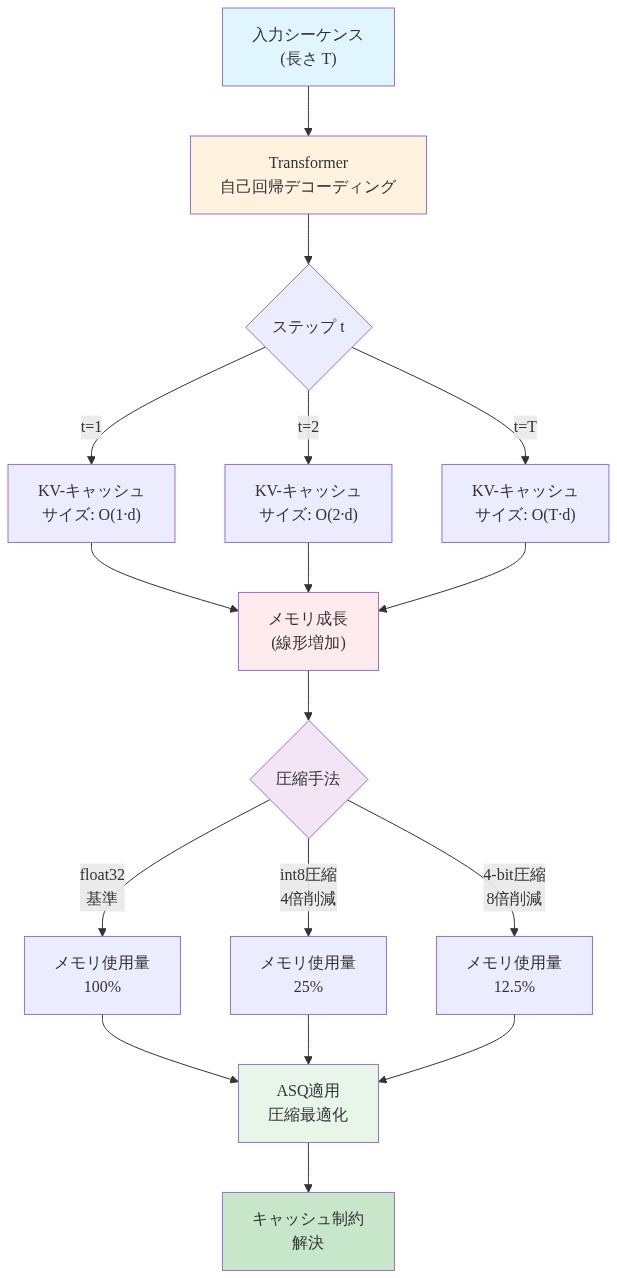
- 図4:Transformerの自己回帰デコーディングにおけるKV-キャッシュメモリ成長と圧縮による削減効果*
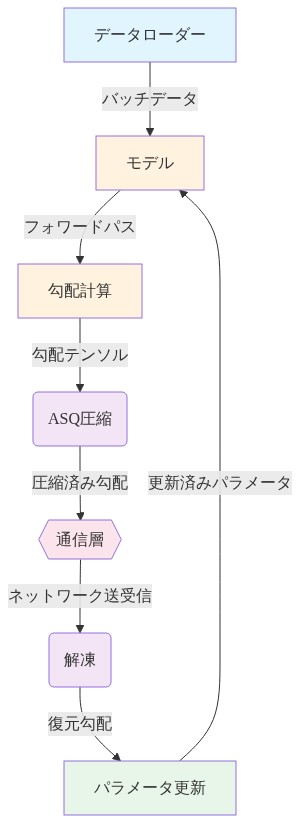
- 図7:既存MLパイプラインへのASQ統合フロー*
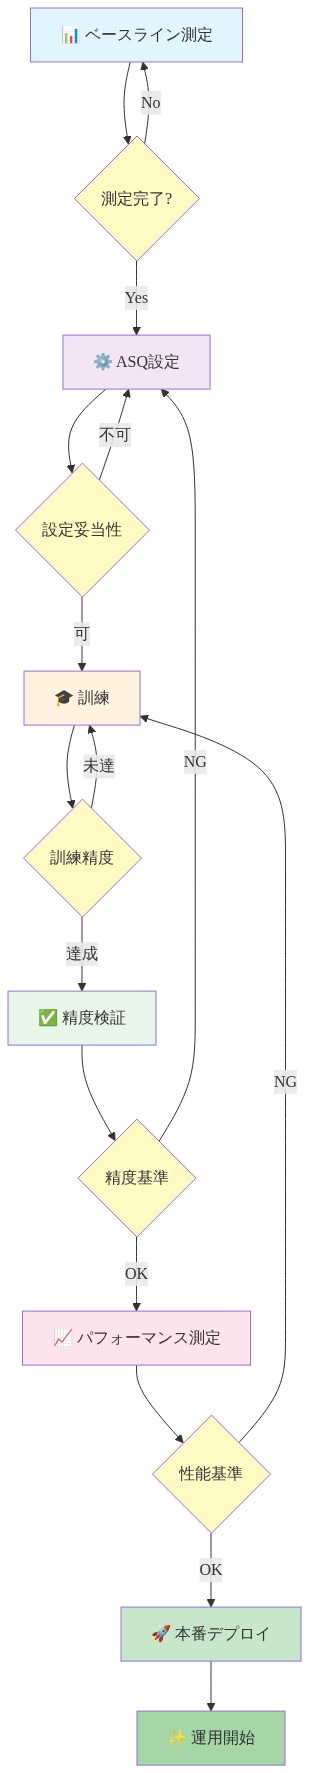
- 図9:ASQ検証ワークフロー—ステップバイステップ実行フロー*
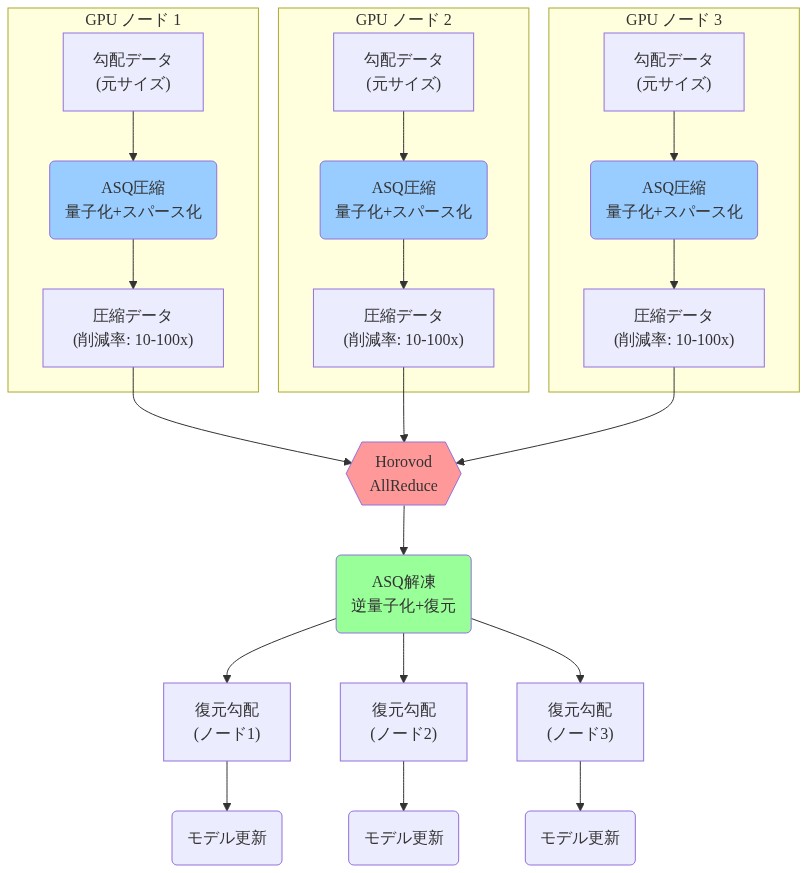
- 図10:Horovod統合によるASQ実装アーキテクチャ*