ニュースから、自分の思い込みに気づく

テクノロジーと社会のニュースを、やさしい言葉で解きほぐすメディア。読み終えたとき、自分の見方が少し変わる記事を届けます。

Tag

#量子化

AI・機械学習
2026年10月26日 21:24
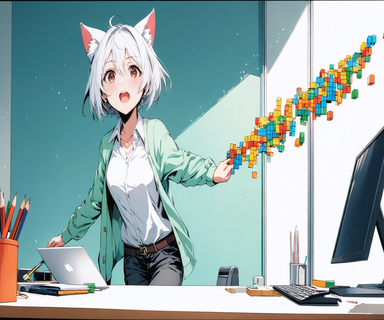
テーブルの上で、小さな助っ人たちが大きさの違う丸い粒を調整できるスーツケースにぴったり詰め込んでいる様子。Neko-sanが粒の雪崩に巻き込まれて慌てている。

誤差ゼロの積和演算をうたう新数値形式AINF 速度は「予測できる倍率」止まり

大きなモデルを動かすにはお金がかかる。そのコストの多くは、数字を運び、掛け合わせる作業から生まれる。重みも活性化も、何らかの形式で保存しなければならない。その形式しだいで、モデルに必要なメモリ、動く速さ、保てる精度が決まる。arXivに載った新しい論文(arXiv:2610.12494)が、その形式の選び方を変える提案をしている。著者らは代数的整数数値形式(AINF)を導入した。論文はこれを「高度に設定でき、しかも正確な圧縮計算のための枠組み」と呼んでいる。発想はこうだ。
-- いいね数
続きを読む
小さなマイコン基板たちが台所のテーブルの上でブロックを手渡しリレーしている様子を、驚いたネコさんが見つめているイラスト。

1億パラメーターのBitNetを数ドルのマイコンで 8MBボード4枚でぎりぎり収まる計算

数ドルで買えて、消費電力もLED1個ほどのボードで言語モデルを動かす。SFのような話に聞こえるが、BitNetの3値の重みがそれを可能にする。ESP32-S3というマイコンを複数つないだクラスターを見ると、何が実際に動き、どこに本当の限界があるのかが分かってくる。限界のほとんどは、最初に思い浮かぶ場所にはない。

-- いいね数
続きを読む
AI・機械学習
2026年9月3日 17:33
Technical illustration showing a continuous mathematical curve transforming into probabilistic discrete blocks, representing the concept of adaptive stochastic quantization

適応的確率量子化:現代的MLのための不偏圧縮

適応的確率量子化(ASQ)は、量子化操作の扱い方において決定論的量子化手法と根本的に異なる確率的圧縮技術です。決定論的手法が浮動小数点値を固定された離散レベルにマッピングするのに対し、ASQは隣接する量子化レベル上の確率分布を割り当てます。その結果、量子化出力の期待値が元の入力値と等しくなります。これは形式的には期待値における不偏性(Bengio et al., 2013; Zhou et al., 2016)として定義されます。定義と数学的基礎

-- いいね数
続きを読む
Abstract visualization of a ternary quantization network showing interconnected nodes in three distinct states, representing the compression mechanism of the Ternlight embedding model with geometric vectors in three-dimensional space

Ternlight – ブラウザで動作する7 MBの埋め込みモデル(WASM)

Ternlightは三値量子化という手法を通じて7 MBのフットプリントを実現しています。この手法はモデルの重みを3つの離散値(−1、0、+1)に制限するものです。このアプローチは確立された知識蒸留の原理に基づいており、より小さなモデルが大規模な埋め込みモデルの出力動作を近似することを学習しながら、意味情報をエンコードする幾何学的関係を保持します。圧縮メカニズム: 従来の埋め込みモデルは重みを32ビット浮動小数点値として保存します。

-- いいね数
続きを読む
Technical illustration of a unified memory chip architecture showing processor cores connected to shared memory through glowing data pathways on a dark background

M4の24GBメモリでローカルモデルを実行する

24GBのユニファイドメモリを搭載したM4チップは、ローカルモデル推論において明確なアーキテクチャ上の優位性をもたらします。従来のCPU-GPUシステムでは、分離されたメモリプールが計算ユニット間の明示的なデータ転送を必要とするのに対し、M4のユニファイドメモリアーキテクチャは、ニューラルエンジン、GPU、CPUが中間的なコピーオーバーヘッドなしに共有メモリプールにアクセスできます。

-- いいね数
続きを読む
AI・機械学習
2026年1月15日 22:03
A technical visualization depicting neural network compression, showing a dense network of glowing blue nodes transforming into a sparse, efficient structure with fewer green nodes, illustrating the concept of hierarchical sparse plus low-rank compression in large language models

LLMの階層的スパース+低ランク圧縮

大規模言語モデルは現在、法外な量のメモリと計算資源を消費しており、実用的な展開と継続的な訓練のために圧縮は交渉の余地のない要件となっている。前提条件と仮定:証拠: FP32での700億パラメータモデルは約280GBのメモリを必要とする(700億パラメータ × 4バイト/パラメータ)。

-- いいね数
続きを読む
TOPへ