チャットボットに、メールの文面を整えてもらったり、契約書の条文を説明してもらったりしたとしよう。その答えを出すモデルは、他の人が書いた膨大な文章で訓練されている。
その訓練に、書いた人の許可は必要だったのか。いま、この問いが法廷で争われている。結論しだいで、仕事で使う道具の姿も変わってくる。
「フェアユースはみんなの利益になる」というのは、この問いへの答え方のひとつだ。
OpenAIは、まさにこのタイトルの文章で主張を公に示した。これに対しては、Hacker Newsで鋭い議論も起きた。言葉は短い。
だが、その裏にある問いは短くない。
AI開発企業は、著作物を使った訓練を、許諾なしで適法と扱ってほしいと考えている。
裁判所や議員にそう求めているのだ。それを「みんな」の利益と呼ぶと、争いのある法的主張が、公共の利益のように聞こえてしまう。この記事では「みんな」という言葉に、実際に誰が入っているのかを確かめていく。
この記事のポイント
- 標語には、訓練はフェアユースかという法的な主張と、社会は得をするかという政策の主張が混ざっている。
- 最大の難関は市場への影響で、負担は偏る。大手の権利者は交渉できるが、個人の作り手は損失を引き受けがちだ。
- 「無料」と「許諾制」の間にも選択肢がある。どの落としどころも、人々がウェブに新しい作品を出し続けることが前提になる。
1つの標語に隠れた2つの主張
「フェアユースはみんなの利益になる」は、実は2つの主張だ。範囲の狭い法的な主張と、範囲の広い政策の主張である。 この2つは食い違うことがある。
まず別々に見てみよう。
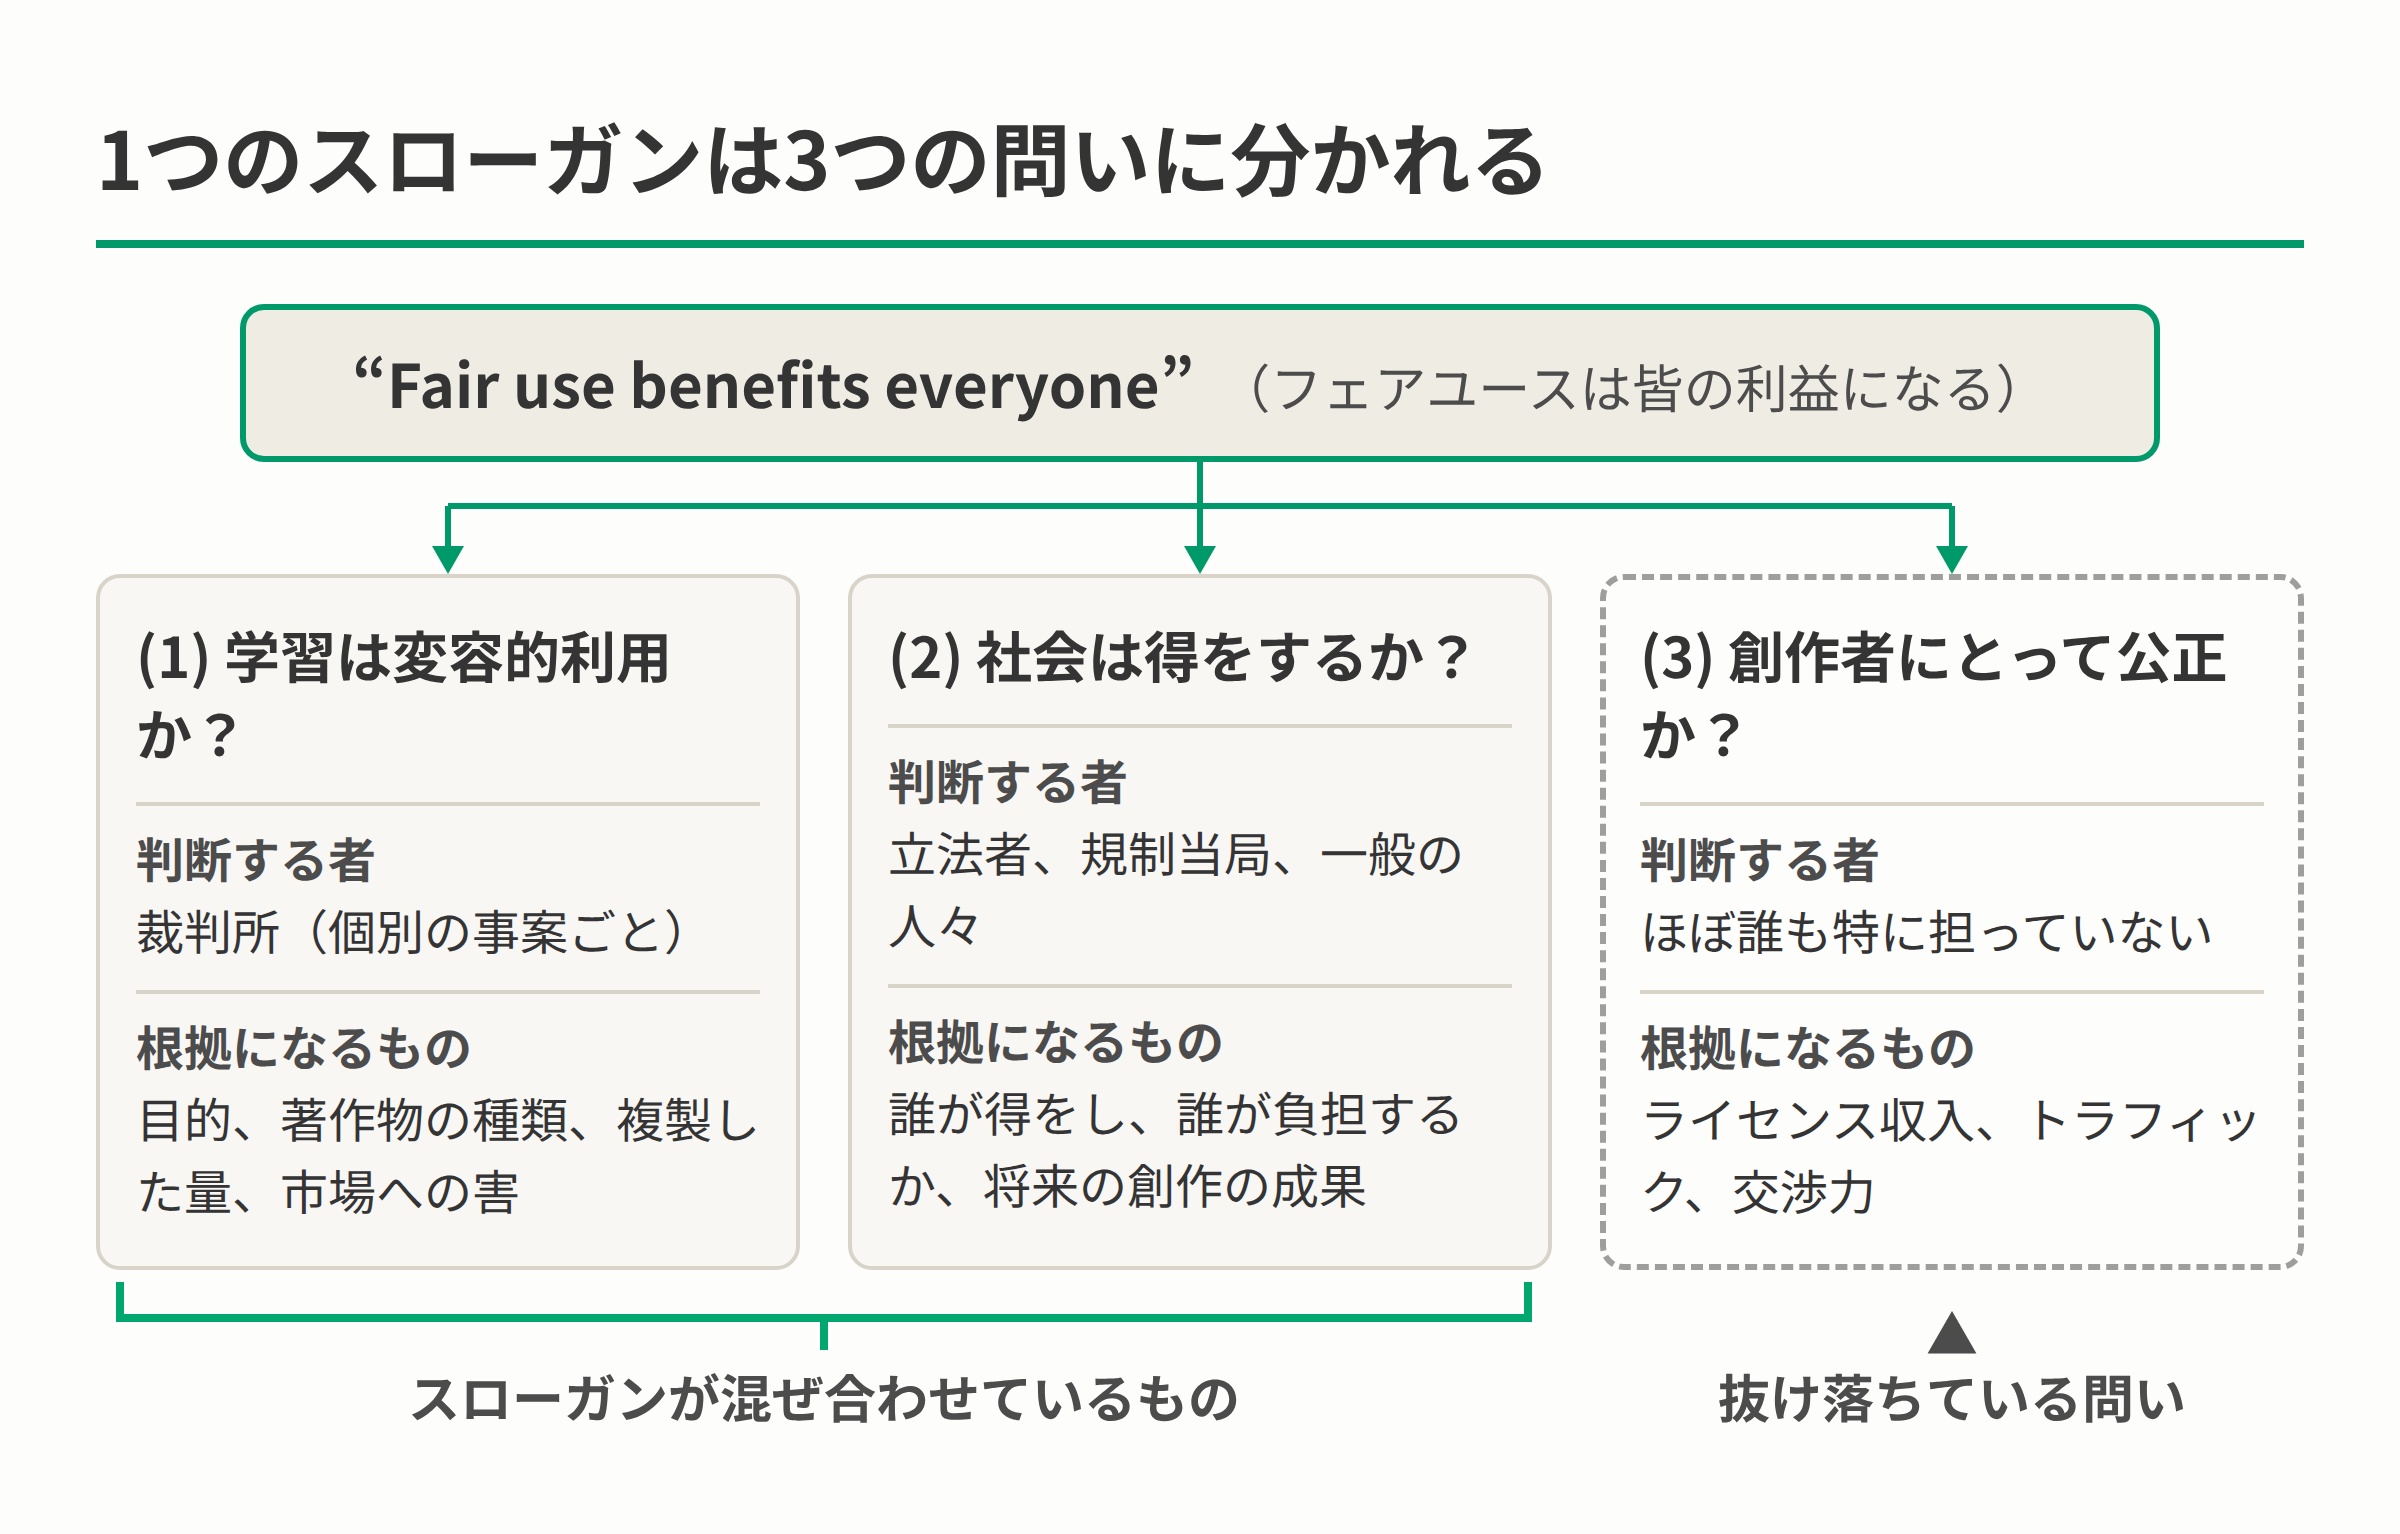
図1:1つのスローガンに含まれる3つの問いと、それぞれの判断者
法的な主張:訓練は「変容的」な利用だ
法的な主張はこうだ。文章、画像、コードをコピーしてモデルを訓練することは、変容的な利用にあたる。米国の法律では、変容的な利用は許可なしでも適法になりうる。
裁判所は、4つの要素からなる判断基準でこれを調べる。機械がコピーする場合、どの要素も無理が出てくる。
なかでも市場への影響の要素が、本当の争点だ。これは、その利用が原作の売れ行きを損なうかを問うものである。
政策の主張:社会全体が得をする
政策の主張は、もっと先まで進む。裁判所がこれを認めれば社会はよくなる、というのだ。しかも、その利益はユーザー、開発者、研究者、さらには作り手にまで行き渡るという。
2つが分かれるわけ
合法であっても、費用と利益が大きく偏ることはある。4つの要素を当てはめる裁判所は、経済全体が公平かどうかは問わない。ひとつの事実関係のもとで、ひとつの利用が基準を満たすかどうかを見るだけだ。
次の表は、標語にまとめて入っている3つの問いと、それぞれに答える主体を示したものだ。
| 問い | 誰が決めるか | 何が根拠になるか |
|---|---|---|
| 訓練は変容的か | 裁判所(事案ごと) | 目的、作品の種類、コピーの量、市場への害 |
| 社会は得をするか | 議員、規制当局、世論 | 誰が得て誰が負担するか、今後の創作の量 |
| 作り手にとって公平か | 決める人は特にいない | 使用料収入、アクセス数、交渉力 |
標語は、1行目と2行目を混ぜ、3行目を抜いている。この記事の残りでは、それをもう一度ほどいていく。
機械学習に4つの要素は耐えられるか
フェアユースは、人間の規模でのコピーを想定してできた。生成AIの訓練は、4つの要素それぞれに違う形で負荷をかける。どれも、すっきりした答えは出してくれない。
よくある例を思い浮かべてみよう。批評家が一節を引用する。パロディの作者がメロディを借りる。
検索エンジンが縮小画像を表示する。どれも、はっきりした理由があって、ごく一部だけを取っている。
モデルの訓練は、この2点で事情が違う。作品を丸ごと、一度に数百万点も取り込む。しかも目的は、製品をつくることだ。
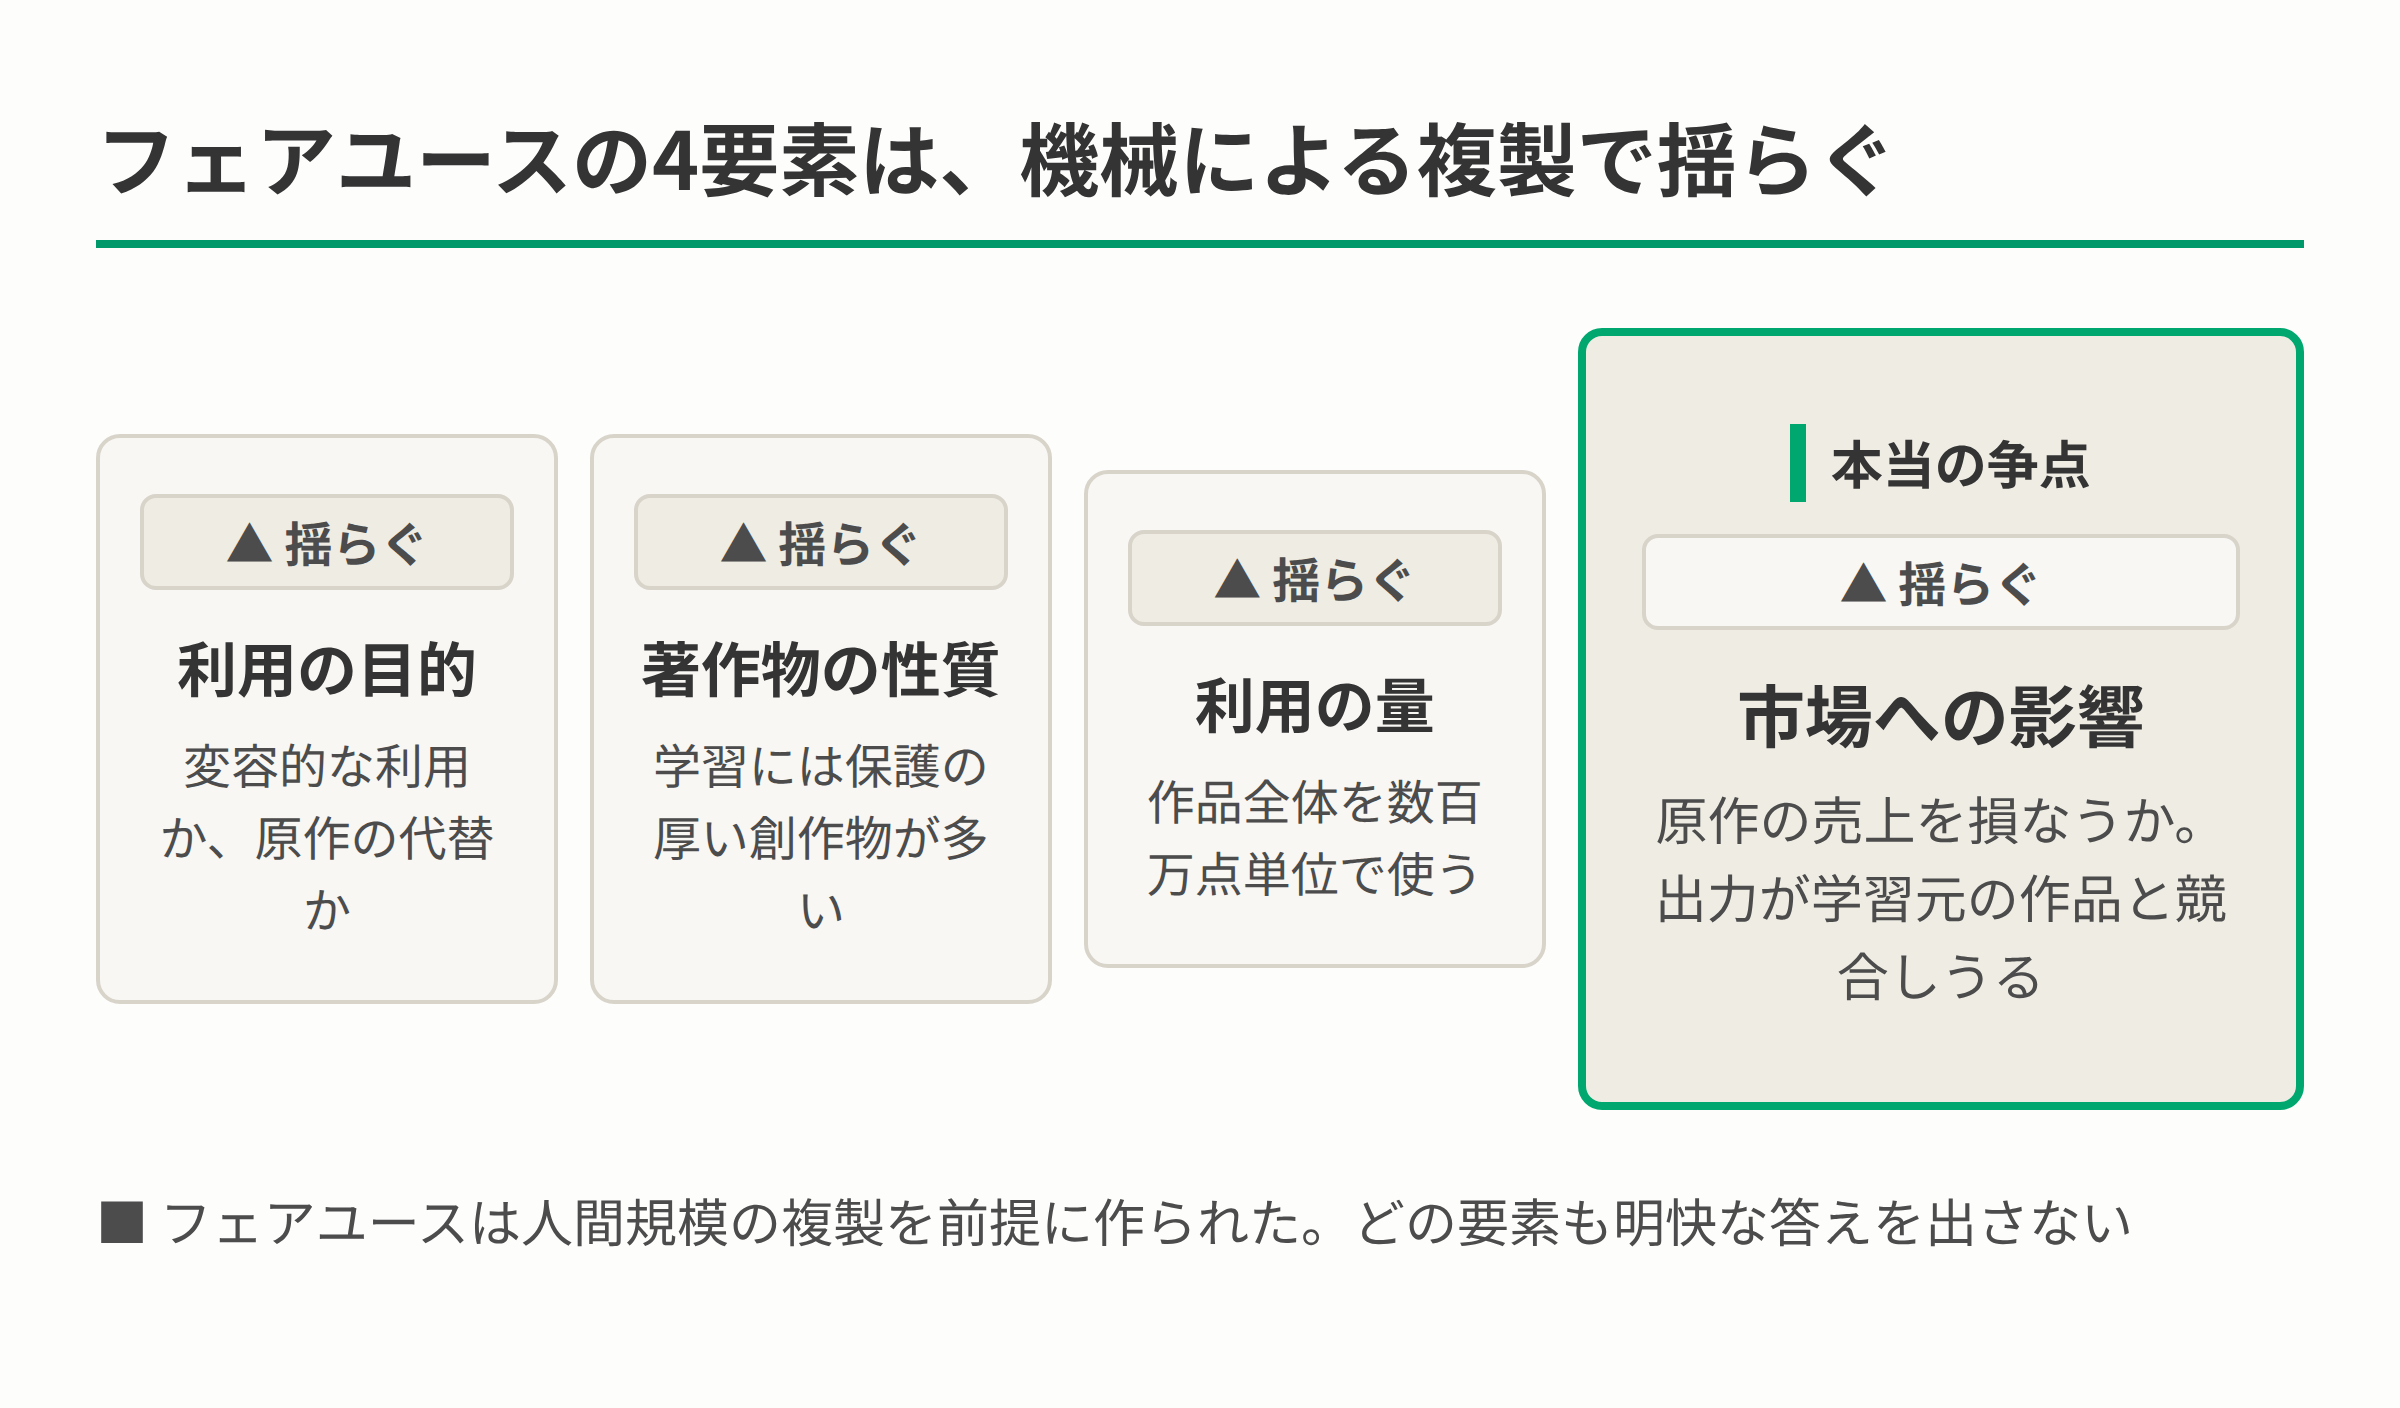
図2:フェアユースの4要素と、最大の争点となる市場への影響
目的と性質
開発者側は、訓練はこれ以上ないほど変容的な利用だと主張する。モデルは本を再び出版するわけではない。本を統計的な重みに変えて、言語や構図や論理のパターンを学ぶのだ。
批判する側は、出てくるものに注目する。モデルは宣伝文を書き、イラストを描き、コードも作れる。その出力が学習元の作品と競合するなら、その利用は論評というより、置き換えに見えてくる。
では、お金もうけが目的なら、それだけで決まりなのか。そうではない。
営利目的というだけでフェアユースが否定されることはない。ただ、製品が同じ買い手に向けられている場合、変容的だという主張は弱まる。
作品の性質
訓練用のデータには、創作性の高い表現豊かな素材が多く入っている。これは、この法理が最も強く守る種類の作品だ。
保護の強さは、おおよそ次のように並ぶ。
- 保護が薄め:事実を集めたデータベース、技術マニュアル。
- 保護が厚め:小説、写真、イラスト、報道記事。
この要素は、ほかの要素より軽く扱われることが多い。それでも、開発者に有利に働くわけではない。
使った量と重要性
モデルは作品を丸ごと取り込む。しかも、数百万点にのぼることが多い。
作品全体のコピーは、ふつうフェアユースに不利に働く。ただ、目的上必要だったとして、裁判所が認めた例もある。
代表例は、書籍のデジタル化をめぐるAuthors Guild v. Googleだ。だが、この先例は広げすぎやすい。2つの状況には、大事な違いがある。
| Google Books | 生成モデル | |
|---|---|---|
| ユーザーが得るもの | 本についての事実 | 新しい文章、画像、コード |
| 典型的な出力 | 抜粋、検索結果、語の出現頻度 | 完成した成果物 |
| 原作の代わりになるか | ならない | 作品の種類によってはなりうる |
最後の行が、両者のへだたりだ。作品全体のコピーが認められた理由の一部は、出てくるものが本の代わりにならなかったことにある。
市場への影響
争いの中心はここにある。ふつうのフェアユースの事件では、害は特定の1作品の売り上げや使用料が失われることだ。
生成AIでは、もっと広い心配が出てくる。たとえば、モデルがストック画像やニュースの要約、特定の作風のコードを、求められるたびに作れるとしよう。
すると、圧力がかかるのは1つの作品ではない。依頼して作ってもらう創作の市場全体だ。
これまでの裁判所の判断
初期の判決は、向きがばらばらだ。どれも、それぞれの事実関係に左右されている。いずれも地方裁判所の判断なので、ほかの裁判所を縛るものではない。
- Thomson Reuters v. Ross:生成AIではないAIツールについて、裁判所はフェアユースを認めなかった。このツールは、コピー元と直接競合していた。
- Bartz v. Anthropic(2025年):連邦地裁の裁判官は、適法に入手した本での訓練は擁護できると判断した。一方、海賊版でつくったライブラリーをめぐる請求は進めることを認めた。この事件は後に、報じられたところでは15億ドルの和解で終わった。
- Kadrey v. Meta(2025年):別の裁判官は、目の前の記録に基づいてMetaを勝たせた。同時に、AIの出力が競合品となってあふれる「市場の希薄化」は、より説得力のある主張がなされれば深刻な害になりうる、と警告した。
Metaの判決が言ったことと言わなかったことに注意したい。Metaが勝ったのは、著者側が害を証明できなかったからだ。裁判官は、害が起こりえないとは言っていない。
4つの要素を並べて見る
次の表は、各要素について双方の主な主張と、初期の判決の傾きをまとめたものだ。
| 要素 | 開発者の言い分 | 作り手の言い分 | 初期の判決の傾き |
|---|---|---|---|
| 目的 | 学習は変容的だ | 出力が競合する。利用は営利だ | 2人の裁判官が訓練を変容的と扱った |
| 性質 | 取り出すのはパターンで、表現ではない | 訓練は創作性の高い作品を狙っている | 決め手になることは少ない |
| 量 | 作品全体が必要だ | 完全な作品が数百万点コピーされた | 目的が正当化するなら許容 |
| 市場 | 1つの作品の市場も害されない | 創作の市場全体が薄まる | 定まっていない |
結果が事実しだいで変わる理由
この法理は、どちらの側が認めるよりも定まっていない。広い一般ルールの代わりに、いくつかの具体的な事実が、法的に重い意味を持ち始めている。
- データの入手方法:Bartzでは、本を買った場合と海賊版を使った場合で、結論が分かれた。
- モデルが丸暗記するか:特定の作品をそのまま再現するモデルは、擁護しにくい。
- 出力が原作の代わりになるか:Thomson Reuters v. Rossでは、直接の競合が抗弁を退けた。
つまり、結論は事案ごとの事実で変わると見ていい。すべてを決める単一の原則は、当面は出てきそうにない。控訴裁判所や議会が動けば、変わるかもしれない。
広いアクセスを支える最も強い理由は何か
大学の研究室と大手のテック企業を思い浮かべてほしい。どちらも、同じ山の本や記事でモデルを訓練したいと考えている。
すべての作品に許諾が必要なら、費用を払えるのは片方だけだ。この差が、フェアユース擁護論の核心である。
この主張は、いちばん強い形で聞く価値がある。いくつかの点は、よく筋が通っている。
- 許諾制は資金力のある側に有利だ。 訓練のたびに許諾が要るなら、適法なデータセットを作れるのは資金の潤沢な企業だけになる。大学の研究室、オープンソースのプロジェクト、小さなスタートアップは、費用の面で締め出される。
- 取引にかかる手間が膨大だ。 権利者は数百万人にのぼり、見つからない人も多い。持ち主を特定できない「孤児著作物」もある。1人ずつ交渉するのは現実的ではない。
- 学ぶのに許可が要ったことはない。 幅広く読んで文体を吸収した小説家は、影響を受けた作家に何の義務も負わない。統計的な学習も同じ種類の行為で、規模が大きいだけだ、と擁護する側は言う。
- 規制しても、作業が別の場所へ移るだけかもしれない。 ある法域がルールを厳しくすれば、開発はゆるい場所に移りうる。作り手は守られず、厳しくした側が開発力を失う。
- ユーザーが直接得をする。 安くて高性能な道具は、学生や小さな事業者、専門家のサービスに手が届かない人たちの負担を下げる。
費用の議論がいちばん重い理由
最初の点が最も強い。厳格な許諾制は、大企業しか渡れない堀になりうる。
多額の和解金を払える企業や、多くの出版社と契約できる企業は、許諾制のもとでも楽に暮らせる。同じ制度が、大学の研究室を沈めることもある。
いまフェアユースを最も強く訴えている企業は、負けた場合でも誰よりうまく適応できるのかもしれない。
「人間の学習」というたとえが崩れるところ
よく読む小説家とのたとえは、もっと弱い。人間とモデルがどこで違うのかを、並べてみると分かりやすい。
| 人間の読者 | 大規模モデル | |
|---|---|---|
| 読む量 | 一生分の本 | 数週間で数百万点の作品 |
| 文章の再現 | まれで、大規模にはならない | 求めに応じて起こりうる |
| 売るもの | 新しい作品 | 学習元と競合しうる製品 |
このたとえが示すのは、学ぶことはコピーと同じではない、という点だ。機械による訓練がすべて、法的な意味での学習にあたることまでは示さない。
擁護する側に必要なのは、その第2の段階だ。たとえだけでは、そこまで届かない。
「作業は移るだけ」という議論が成り立つ場合
法域の議論は、条件しだいだ。訓練を別の場所へ移すのが安くすむときに、最も強くなる。完成したモデルが、どこで訓練されたかに関係なく、どこでも売れることも必要だ。
大きな市場が、訓練だけでなく運用も規制すると弱まる。その場合、ルールは自国のユーザーに売ってよいものを対象にする。モデルをどこで作ったかは、ほとんど意味を持たなくなる。
無料でアクセスできるとき、誰が払うのか
モデルをつくる側が自由に使えることには、代償がある。その多くは、オンラインで書き、描き、質問に答える人たちにのしかかる。
Autognosisの以前の記事では、エージェントに使いやすいウェブが、人間のユーザーにとってはむしろ悪くなりうることを取り上げた。
スクレイピング、アクセス制御、知的財産のルールは、オンラインで作って公開する人に最も重くのしかかる。フェアユースの議論は、その話の続きにあたる。
機械に読みやすくなったウェブは、人間の書き手には支え続けにくいウェブになりうる。
作り手が損をする2つの形
損失は2段階で起こる。どちらも、誰にも気づかれないまま進むことがある。
- 対価なしに価値が移る。 出版社のアーカイブ、イラストレーターの作品集、フォーラムに何年も積まれた回答が、モデルの能力に変わる。請求書は誰からも届かない。
- アクセスが戻ってこなくなる。 AIが生成する回答は、元のコンテンツを支えていた参照元からの訪問を減らしうる。読者は要約を受け取り、元のサイトには来ない。
訪問が減ると、元のサイトは広告収入や購読料を失う。時間がたてば、発信を続ける理由そのものを失いかねない。
二層に分かれる結果
交渉力に差があるので、影響ははっきりした線で分かれやすい。次の表は、各グループにできることと、たいてい得られるものを比べたものだ。
| グループ | できること | 得られがちなもの |
|---|---|---|
| 大手出版社、ストック素材会社 | 訴訟、交渉、差し止めの請求 | 使用料契約、和解金 |
| 中規模のメディア | クローラーの遮断、連合への参加 | たまの契約、アクセスの減少 |
| 個人の作り手、フォーラムのユーザー | オプトアウトのタグくらい | ほとんど何もない |
| モデル開発者 | 規模、法務チーム、ロビー活動 | 安い原料 |
| 一般のユーザー | 道具を選ぶ | 安くて高性能なサービス |
大手の権利者が支払いを受けやすいのは、訴えると言えば本気だと受け取られるからだ。すそ野の作り手が何も得られないのは、その人たちに代わって訴えても、割に合うことがまずないからである。
その結果、作り手がどれだけ貢献したかに関係なく、訴える力に応じて報酬が決まる市場になる。
オプトアウトでは解決しない理由
robots.txtの指定や、AI専用のクローラー遮断は、中間の道に見える。だが実際には、はっきりした限界がある。
- 負担が作り手に回る。 サイトの持ち主は、どんなクローラーがあるかを学び、遮断リストを更新し続けなければならない。
- さかのぼっては効かない。 遮断より前に集められたデータは、既存のデータセットや訓練済みのモデルに残る。
- 下流で漏れる。 第三者のデータセットやミラーサイトを通じて、元の遮断が届かない訓練にコンテンツが流れ込むことがある。
- 善意に頼っている。 契約や法律で義務づけられていなければ、従うかどうかは任意だ。
- 見つけてもらう機会を失うおそれがある。 AIクローラーを遮断すると、いま一部の読者がコンテンツを見つけているAI検索から外れることがある。
だから「みんな」が得をするのは、ゆるい意味でしかない。消費者は安い道具を得て、開発者は安い原料を得る。作り手は、「みんなの利益になる」という議論が語らない費用を背負っている。
「無料」と「禁止」の間に道はあるか
選択肢は2つだけではない。議論ではたいてい、訓練はフェアユースで無料か、侵害で許諾が必要か、の2つしか示されない。その間にあるいくつもの道は、この枠組みの中で見失われてしまう。
ラジオ局が曲を流す場面を考えてみよう。局は、作曲者一人ひとりに電話して許可をもらったりしない。
共有の仕組みにお金を払い、そのお金が権利者へ回っていく。AIの訓練でも、似たやり方はありうる。
ただし、考えられる設計はそれだけではない。
訓練を禁じずに作り手へ払う5つの方法
次の表は、作り手に報酬を払う、または発言権を与える5つの方法を、主な強みと弱みとともに比べたものだ。
| 仕組み | 動き方 | 主な強み | 主な弱み |
|---|---|---|---|
| 集中管理による許諾 | 管理団体が権利をまとめて支払う(音楽と同じ) | 作品ごとの契約が要らない | 仲介者がお金の多くを取りうる |
| 法定許諾 | 法律が、定めた使用料での訓練を認める | 利用の許可と支払いを切り分けられる | 料率の決定は政治的で時間がかかる |
| 収益への課金 | モデルの収益の一部を作り手の基金に回す | 集めるのが簡単 | 公平に分けにくい |
| 検索時の出典表示 | 最新の情報源を引く回答が、出典を示して対価を払う | 実際の利用に支払いが連動する | 対象は検索だけで、基礎訓練は含まない |
| データの透明性 | 開発者が訓練データを開示する | 権利の行使と交渉が可能になる | 開示だけでは誰にも支払われない |
どれも簡単ではない理由
いちばん難しいのは、測ることだ。1つの作品が、モデルの能力にどれだけ貢献したのかを、簡単に言える人はいない。
1冊の小説の影響が、何十億ものパラメーターに散らばっている。役に立つ形で測るのは、無理かもしれない。だから、お金を分けるどんな計算式も、せいぜいおおまかなものにしかならない。
設計がまずければ、別のリスクも加わる。
- 不透明な支払い:音楽の管理団体は、分配が分かりにくく、支払いが遅いと長く批判されてきた。訓練への課金は、同じ問題をもっと大きな規模でくり返しかねない。
- 高すぎる料率:法定の使用料が高ければ、アクセス重視派が警告する「堀」の問題を再び生む。訓練できるのは、最大手だけになるだろう。
- 届く範囲の偏り:大手の権利者に主に払う仕組みは、個人の作り手の大半を取りこぼす。
これらの選択肢が示すこと
これらの選択肢が示すのは、「フェアユースはみんなの利益になる」だけが筋の通った立場ではない、ということだ。
訓練を認めたうえで、その元になった作り手に払う仕組みも考えられる。広いアクセスがもたらす競争上の利益は残せる。そして、創作物をただの原料として扱うこともなくなる。
それが、どちらの極端よりも公共の役に立つかどうかは、細部しだいだ。お金がどれだけ公平に分けられるかが問われる。誰が費用を負うのかも、同じように問われる。
ちょっと立ち止まって
「みんなの利益になる」と聞くと、つい「それなら自分も含まれているのだろう」と思ってしまわないだろうか。
安くて便利な道具は、確かにありがたい。ただ、その便利さの裏で、誰かが払っているものがあるのかもしれない。
あなたがふだん使っているAIの答えは、誰が書いた文章の上に立っているのだろう。そして、その人たちは、あなたと同じ意味で「みんな」に入っているだろうか。
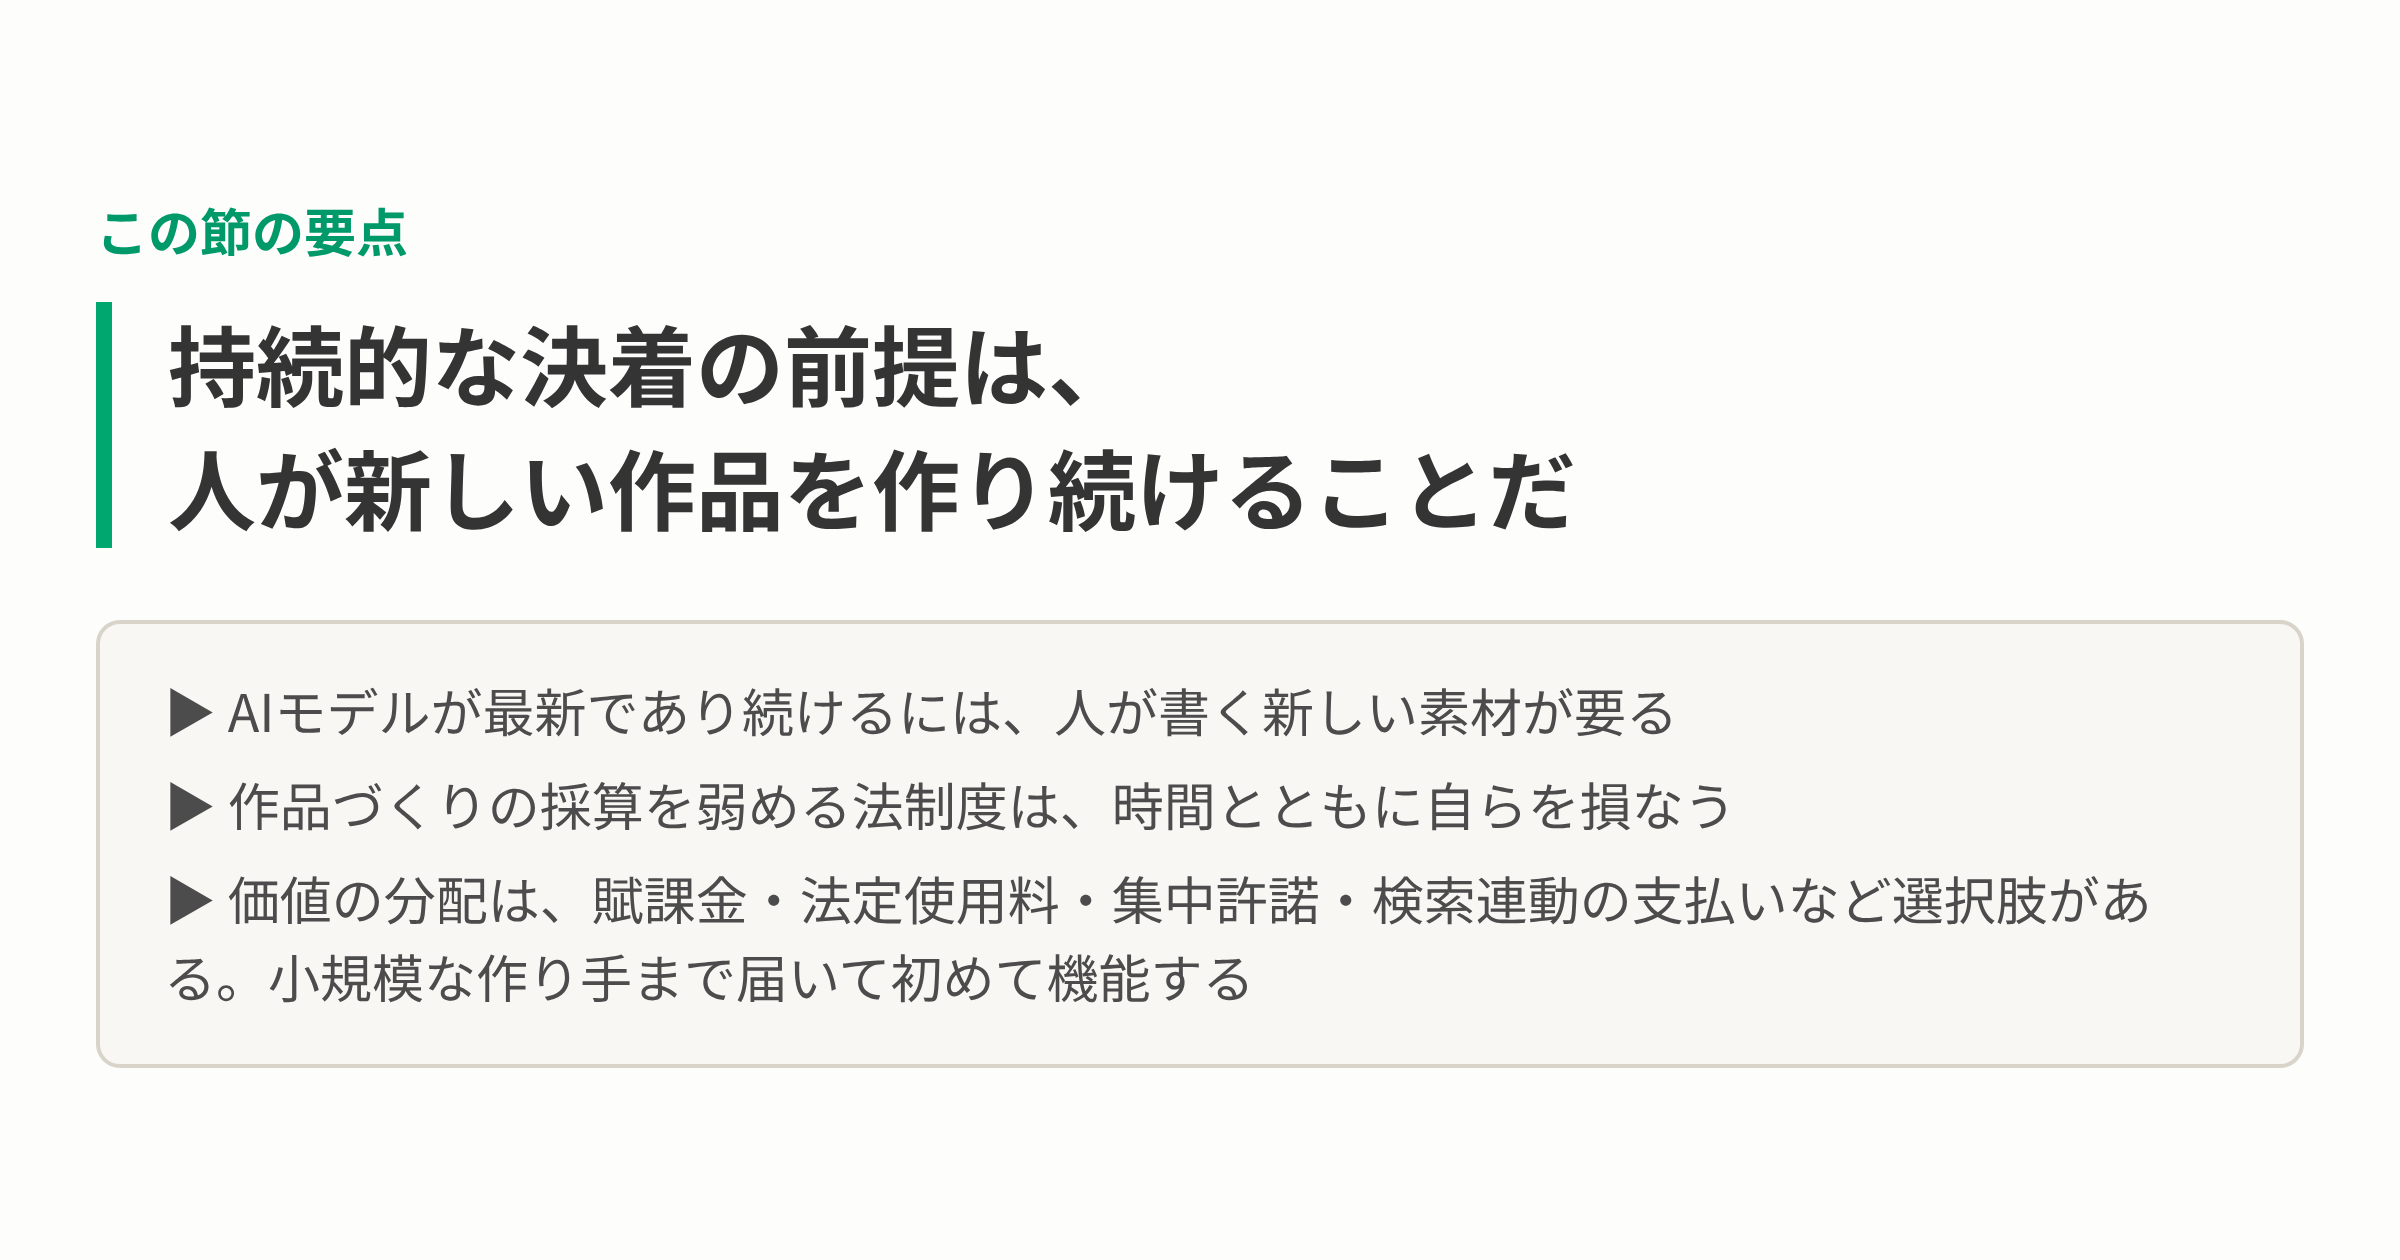
図4:持続的な決着の前提は、オープンウェブで新しい作品が公開され続けること
長続きする落としどころには何が要るのか
裁判所や議会がどんな判断をしても、その結果は「新しい作品を作る動機」を変える。これはAIにとっても大事な話だ。モデルが最新の状態を保つには、人が書いた新しい素材が欠かせないからだ。
もし法の仕組みが、その素材を作る人の稼ぎを弱めたら、仕組みは時間とともに自分の足元を崩すことになる。
ではそれはどれくらいの速さで起きるのか。まだ分かっていない。まだ測っている最中の要素に左右されるからだ。
- 流れてしまう訪問:AIの回答によって、元の情報源から実際にどれだけ訪問が奪われるか。
- 合成データ:機械が作った文章が、人間の文章をどこまで代わりにできるか。
落としどころを支える4つの部分
長続きする落としどころには、おそらく4つの部分が要る。それぞれ別の問題を扱うので、組み合わせてこそ働く。
- 研究と競争の余地。 非営利の研究者や小さな開発者が、大手にしか払えないライセンス料なしで学習できる必要がある。
- 害ごとに別のルール。 学習、丸暗記、出力による置き換えは、それぞれ別の行為だ。ひとつの括りにまとめず、一つずつ判断する。
- 今後のスクレイピングへの実効的な管理。 作り手には、標準化されていて拘束力があり、下流のデータセットも守るオプトアウト(学習への利用を断る手段)が必要だ。ていねいなお願いだけでは足りない。
- 価値を分け合う方法。 課徴金、法定の使用料、集団でのライセンス、検索に基づく支払いなどが考えられる。小さな作り手が大勢いる裾野まで届いて、はじめて機能する。最大手の権利者だけに届くのでは足りない。
今からできること
法はまだ定まっていない。それでも、作る人、公開する人、こうしたツールを買う人は、すでに動ける。ここに挙げる手は、裁判の結果に左右されない。
- クローラーの設定:AI専用のクローラー(ウェブを巡回して情報を集めるプログラム)について、robots.txtやプラットフォームの設定を見直す。初期設定のままにせず、自分で選ぶ。
- プラットフォームの規約:多くのフォーラムやホスティングサービスが、ユーザーの投稿を学習用にライセンスするようになっている。投稿したときに何に同意したのかを知っておくと役に立つ。
- ベンダーのデータの出どころ:組織でAIツールを買うときは、学習データがどこから来たのか、文書で示してもらう。海賊版の出どころは、裁判所が別の責任として扱いつつある。
- 市場への害をめぐる判断:法的な結論は、4つ目の要素である「元の作品の市場への影響」に大きく左右されそうだ。希薄化や丸写しをめぐる判断のほうが、「変容的だ」という大まかな主張よりも多くを教えてくれる。
- 情報源への直接の支援:AIの要約のせいで出版社への訪問が減るなら、購読や直接の支払いは、その情報源を生かし続ける数少ない方法のひとつだ。
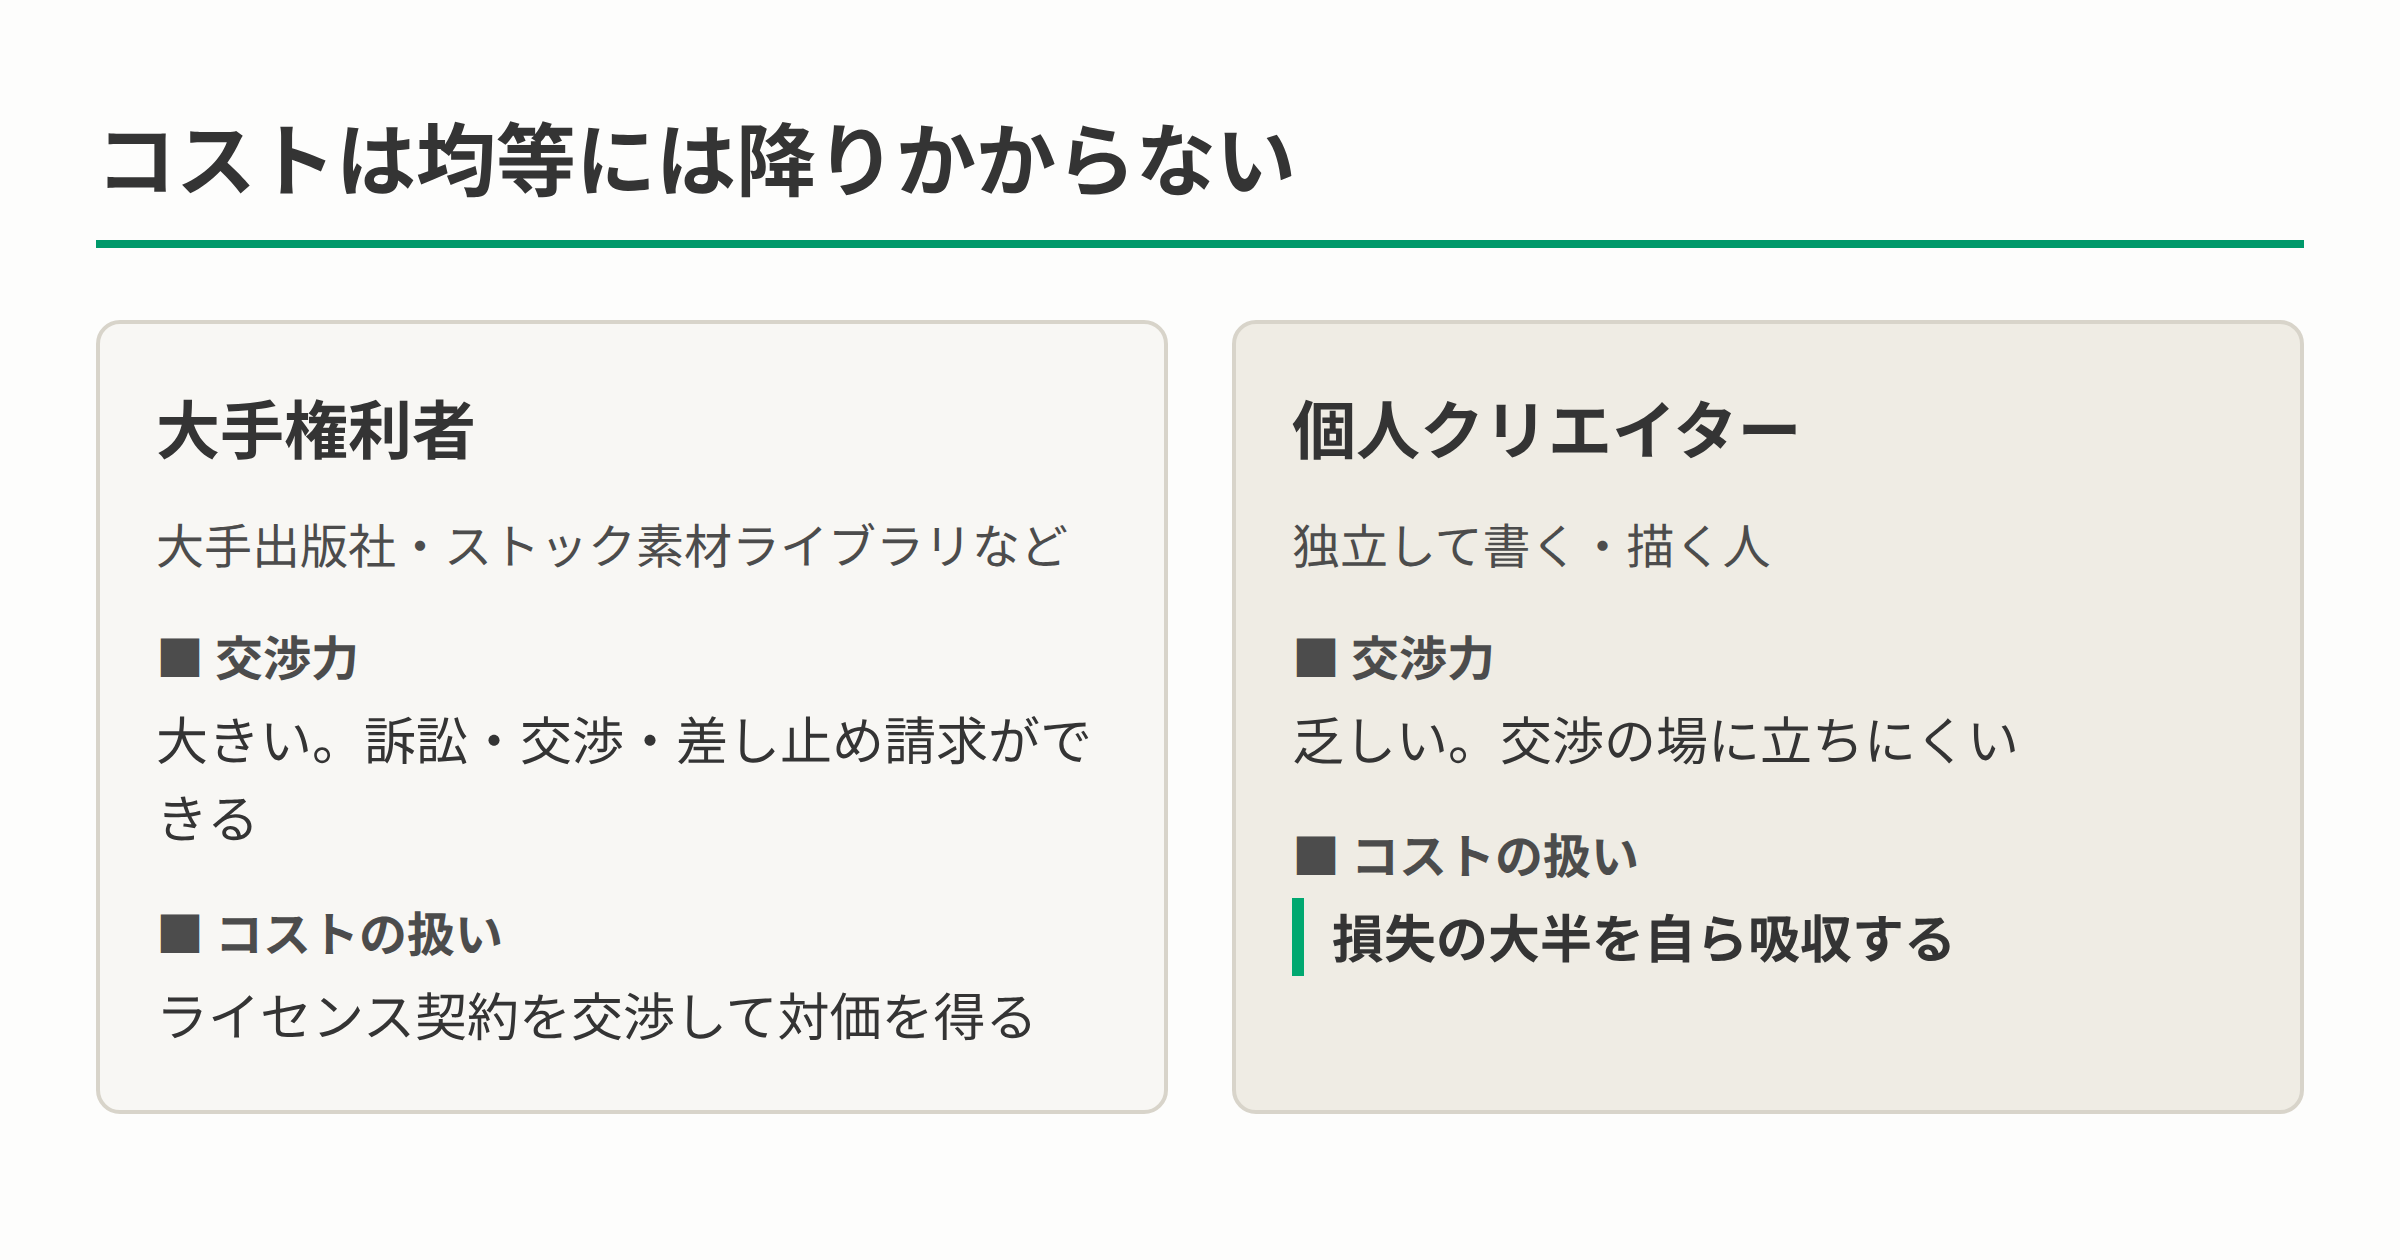
図3:大手権利者と個人クリエイターで異なるコストの負い方