Google が「これまでで最も強力なモデル」として、Gemini 4 Argon を発表した。注目したいのは、その売り方だ。
Google は Argon を、あらゆる用途で一気に飛躍した汎用モデルとして売り出してはいない。狙いはコーディングとサイバーセキュリティにある。
この選び方には意味がある。どちらの分野でも、モデルの出力が正しいかどうかを確かめられるからだ。
壊れたコードはコンパイラーが弾く。ロジックの誤りはテストが洗い出す。脆弱性が本物かどうかは、攻撃を再現してみれば分かる。
Google が賭けているのは、お金を払って使うプロの仕事だ。そこでは、信頼できるか、1回の作業にいくらかかるか、既存の道具にどこまでなじむかが価値を決める。ベンチマークの名声は、それほど重くない。
この賭けには、もう一つの顔がある。
ソフトウェアの欠陥を見つけるのが得意なモデルは、守る側だけでなく攻める側にも役に立つ。だから Argon は、競争のあり方、強力なシステムの公開の仕方、そしてそのリスクを誰が負うのかという問いも投げかけている。
この記事のポイント
- Google は Gemini 4 Argon を、コーディングとセキュリティ向けの専門的な道具として位置づけている。万能の見せ場にしたいわけではない。
- 「これまでで最も強力」というのは企業側の主張だ。どの評価を前面に出すかは Google が選んでいる。
- クローズドモデルとオープンモデルの争いは、長く複数の段階が続く技術作業に移りつつある。今のオープンモデルが最も弱い領域だ。
Google が Argon をコードとセキュリティに向けた理由
最先端の AI モデルは、チャットの相手としてよりも、範囲の狭い重要な技術作業の道具として評価されるようになってきた。Argon はその流れに沿っている。
コーディングとセキュリティには、共通する魅力がある。結果がすぐ、しかも客観的に返ってくることだ。この性質は二つの面で役に立つ。
開発側は、はっきりした信号をもとにモデルを訓練し、調整できる。利用する側は、ベンダーの言葉に頼らずに成果を判断できる。
以下の表は、分野ごとに出力をどう確かめるかをまとめたものだ。
| 分野 | 出力の確かめ方 | 最先端モデルに向く理由 |
|---|---|---|
| コード生成 | コンパイラー、型チェッカー、テスト一式 | 誤りが数週間後ではなく数秒で分かる |
| コードレビュー | 回帰テスト、静的解析 | 提案された変更を自動で確認できる |
| 脆弱性の発見 | 攻撃の再現、概念実証のテスト | 指摘された欠陥は、再現するかしないかのどちらかだ |
| パッチの作成 | 修正後に攻撃とテストをもう一度実行 | 修正の質を、議論ではなく測定で確かめられる |
ほかの研究所も同じ理屈をたどっている。OpenAI は、自社の言語モデルを使ってカスタムチップの設計を手伝わせた。
考え方は共通している。結果を確かめられ、フィードバックの輪が短い場所に、最先端の能力を投入するのだ。
それでも「最も強力」という主張は、慎重に見る必要がある。 Google はどの評価を目立たせるかを自分で選ぶ。
どのベンダーも、有利な数字を先頭に置きたいはずだ。見出しになるスコアからは、実際のコードベースでモデルがどう動くかは、ほとんど分からない。
エンジニアリングやセキュリティの購入担当者は、もっと実務に近い指標を見るとよい。
- 長く複数の段階が続く作業での安定性。 数十のファイルにまたがるリファクタリングを、途中で迷わずやり切れるか。
- 道具を使うときの安定性。 コンパイラー、デバッガー、スキャナーを確実に呼び出せるか。それとも脱線して同じことを繰り返すか。
- 散らかったリポジトリでの振る舞い。 実際のコードには、古い依存関係、乏しい文書、不ぞろいな書き方がある。きれいなベンチマーク課題とは違う。
- 作業1件を終えるまでのコスト。 やり直しの少ない安いモデルが、よく失敗する強いモデルに勝つことがある。
検証にも限界がある。テストが通ったと分かるのは、テストが対象にした範囲だけだ。コンパイルでき、すべてのテストを通りながら、細かなセキュリティ上の欠陥を隠したコードを、モデルは書けてしまう。
検証できる分野では、進歩を測りやすくなる。だからといって、人間の判断が要らなくなるわけではない。
難しい問いは、まだいくつも残っている。
- コードを書き、レビューする力は、頼れる脆弱性の発見につながるのか。それとも、既知のパターンを見つける作業が速くなるだけなのか。
- モデルが作ったパッチや監査を、組織はどう扱うべきか。下書きか、推奨か、信頼できる成果物か。
- モデルがどれほど優秀に見えても、人間によるレビューを必須にすべき場所はどこか。
もう一つ、効果が積み重なっていく面がある。モデルは、次の世代のモデルを訓練するためのソフトウェアやインフラを、改善し始めている。この循環は、進歩を加速させるかもしれない。
人間の監督が緩めば、誤りや盲点が固定されるおそれもある。
どちらに転ぶかは、研究所が自社システムのうちモデルが書いた部分をどれだけ丁寧に点検するかで決まる。それについて多くを公開している研究所は、ほとんどない。
競争の地図はどう動くか
Argon によって、競争の軸は生の能力から、オープンモデルがまだ遅れている専門分野へと移る。争点は、一つの差を埋めることではなくなり、個別の用途でどちらが勝つかになってきた。
この節のポイント
- 一般的な作業では、オープンモデルが差を縮めてきた。Argon は、クローズドモデルがまだ優位にあるプロ向けのコーディングとセキュリティに争いの場を移す。
- セキュリティチームや規制の厳しい組織にとっては、生の性能よりも自社内で動かせることが重い。自前で動かす弱いモデルが、クラウドの強いモデルに勝つこともある。
- Google には、クラウド基盤や開発者向けツールという販路がある。同じ販路を持たない競合は、同程度のモデルがあっても同じ届き方はできない。
優位はどこにあるか
横並びに近づく流れは、止まったわけではない。争う場所が変わったのだ。
オープンウェイトのシステムは、一般的な推論や文章作成では差を詰めた。その圧力で、クローズドな研究所が高い価格を正当化しにくくなった。
Argon はプロ向けのコーディングとセキュリティに狙いを定めた。そこは、オープンモデルがまだ弱く、出来にばらつきがある領域だ。
いま、両陣営の強みは次のように分かれている。
| 項目 | 最先端のクローズドモデル | オープンウェイトモデル |
|---|---|---|
| 長い作業を自律的にこなす信頼性 | 現時点では概して高い | 向上中だが、まだ安定しない |
| 追加訓練用のデータ | 企業での利用から得た独自データ | 公開データか自前で集めたデータ |
| ツール | ベンダーの基盤と密に結びつく | 別々の部品を組み合わせる |
| カスタマイズ | ベンダーが用意した範囲に限られる | ファインチューニングを自由に制御できる |
| 導入形態 | 主にベンダーが運営するクラウド | 自社内設置や、外部と遮断した環境にも対応 |
| コストの管理 | ベンダーの価格で決まる | 利用者自身のインフラで決まる |
セキュリティチームや規制の厳しい組織にとって、右の列は決め手になる。機密性の高いソースコードや社内のテレメトリーを、外部の事業者に送れない組織は多い。
自社内での処理を義務づける規則がある組織もある。そうした組織なら、数字の上では弱い自前のオープンモデルのほうが、強いクラウドモデルより役に立つことがある。譲れない条件を満たせるからだ。
販路という守り
Google には、モデルそのものとは別の構造的な強みがある。届ける力だ。Argon は、Google のクラウド基盤、開発者向けツール、仕事用のソフトウェアを通じて顧客に届く。
同程度のモデルを持っていても、そうした販路がない競合は、能力だけで勝たなければならない。これは難しい。
問題は、この優位が続くかどうかだ。見極めの手がかりが三つある。
- 価格の動き。 大幅な値下げがあれば、Google が早い段階で競争を見込んでいると読める。高い価格のまま変わらなければ、優位が続くという自信の表れだろう。
- ライセンスの変更。 出力、ファインチューニング、企業での利用に関する条件が厳しくなれば、Google が顧客の囲い込みを図っていると分かる。
- 企業の乗り換えの様子。 中核のエンジニアリングやセキュリティの業務を Argon に移す組織が増えるのか。それとも複数の選択肢の一つにとどまるのか。そこから、優位が実際にどれだけの価値を持つかが見えてくる。
両刃の剣という問題
セキュリティ能力は、どちらの側にも働く。脆弱性を見つけ、堅牢なコードを書けるモデルは、守る側にも攻める側にも役に立つ。
セキュリティチームが自社のコードベースを監査できる力は、攻撃者が他人のコードベースを調べる力でもある。
両者の立場は対等ではない。次の表は、その違いを比べたものだ。
| 守る側 | 攻める側 | |
|---|---|---|
| 作業の範囲 | すべてのシステムを守らなければならない | 突破口は一つ見つければよい |
| 手に入る情報 | ソースコード、社内のテレメトリー、設計の知識 | 外から観察するのが普通 |
| モデルの使い方 | 監査、パッチ適用、監視 | 下調べ、攻撃手法の開発 |
| 主な制約 | 範囲の広さと人手 | 使える侵入口を見つけること |
守る側は、範囲の広さという難しい問題を抱えている。
それでも、情報の面では本当の強みがある。
コードベースとテレメトリーに全面的にアクセスできるモデルなら、理屈の上では、外から手探りで調べる相手よりも速く欠陥を見つけられる。 この強みが保たれるかどうかは、守る側が自社のシステム全体でこうした道具を実際に使うかどうかにかかっている。
研究所は、リスクを抑えるためにいくつかの手段を使う。どれにも弱点がある。
- アクセス制御。 モデルの最も敏感な機能を、使える人に限る。盗まれた認証情報や内部者の悪用は、これをすり抜ける。
- 利用状況の監視。 怪しいリクエストのパターンを検知する。腕のある攻撃者は、悪意ある作業を無害に見える小さな部品に分けることができる。
- 審査を通ったセキュリティチーム向けの段階的な提供。 守る側に、早く、またはより広く使わせる。審査には時間がかかり、段階の区切りも時間とともに漏れていく。
- 拒否のルール。 明らかに攻撃的な依頼は断る。侵入テストと攻撃の境目は意図で決まることが多く、モデルには意図が見えない。
最先端のモデルができると、攻撃に使える能力は速く広がりやすい。守る側に段階的に使わせれば、先行できる時間を少し稼げるかもしれない。
だが、その猶予は短い。同程度のオープンウェイトモデルが出てくれば、さらに縮むだろう。
Google は、Argon のセキュリティ面について、詳しい安全対策も独立した評価も公開していない。
結果が公表されない限り、外部の人は、対策が十分なのか、リスクが甘く見積もられていないのかを判断できない。顧客は、最も確かめにくい点について、ベンダーを信じるしかない。
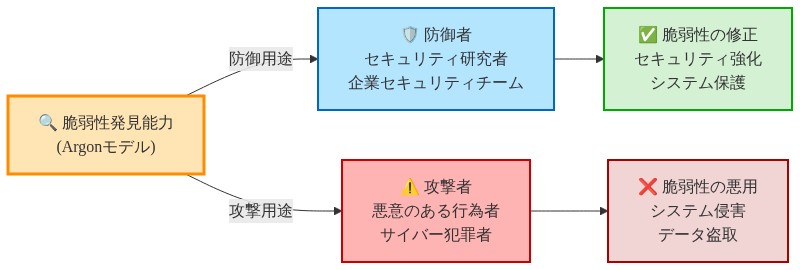
図4:デュアルユース問題 - 同一技術(脆弱性発見能力)の防御と攻撃への二重利用構造
公開をめぐる二つの考え方
OpenAI が安全上の懸念からモデルの公開を見送ったと報じられている。一方で Google は、セキュリティ面の強さを打ち出したモデルを出荷した。この対比を、無謀か責任ある行動かの違いとして描きたくなる。
だが、それではリスクの管理をめぐる本当の意見の違いを見落としてしまう。
| 出して改善を重ねる | 安全が確かめられるまで見送る | |
|---|---|---|
| 根本の考え | 実際の利用のほうが、社内テストよりも早く失敗の形を明らかにする | 能力が一定の水準に達したら、対策が確かめられるまで出さない理由がある |
| 安全対策の育ち方 | 公開後の監視と修正 | 公開前のテストとレッドチーム演習 |
| 主なコスト | 被害が出たときの評判や規制上のリスク | 市場シェアや開発者の関心を失うこと |
| 主なリスク | 修正が間に合う前に、被害が利用者に届く | 競合が同程度の能力をどのみち出してしまう |
どちらの立場にも筋は通っている。早く出せば、安全対策は実際の条件にさらされる。本物の攻撃者や本物のコードベースは、社内のテストが予想しなかった問題を見つけ出す。
見送れば、被害は起きてから直すのではなく、起こさずに済む。たった一つの攻撃が長く残る損害を生みうるときには、これが重い意味を持つ。
慎重な道にも弱点がある。ある研究所が見送っても、ほかが同程度の能力を出せば、リスクはあまり減らないかもしれない。
別の事業者に移るだけだ。だから見送りがいちばん効くのは、研究所どうしが足並みをそろえたときや、ある研究所が明らかにリードしているときだ。
Google も OpenAI も、問題の判断について評価結果の全体を公開していない。そのため、どちらの選択が妥当だったのか、外部の人は判断できない。この不透明さ自体がリスクだ。
公開の判断の根拠となる証拠が見えなければ、どちらのやり方も長く続く信頼を得られない。どちらの方法がうまくいくのかを学ぶための共通の土台も、業界にはない。
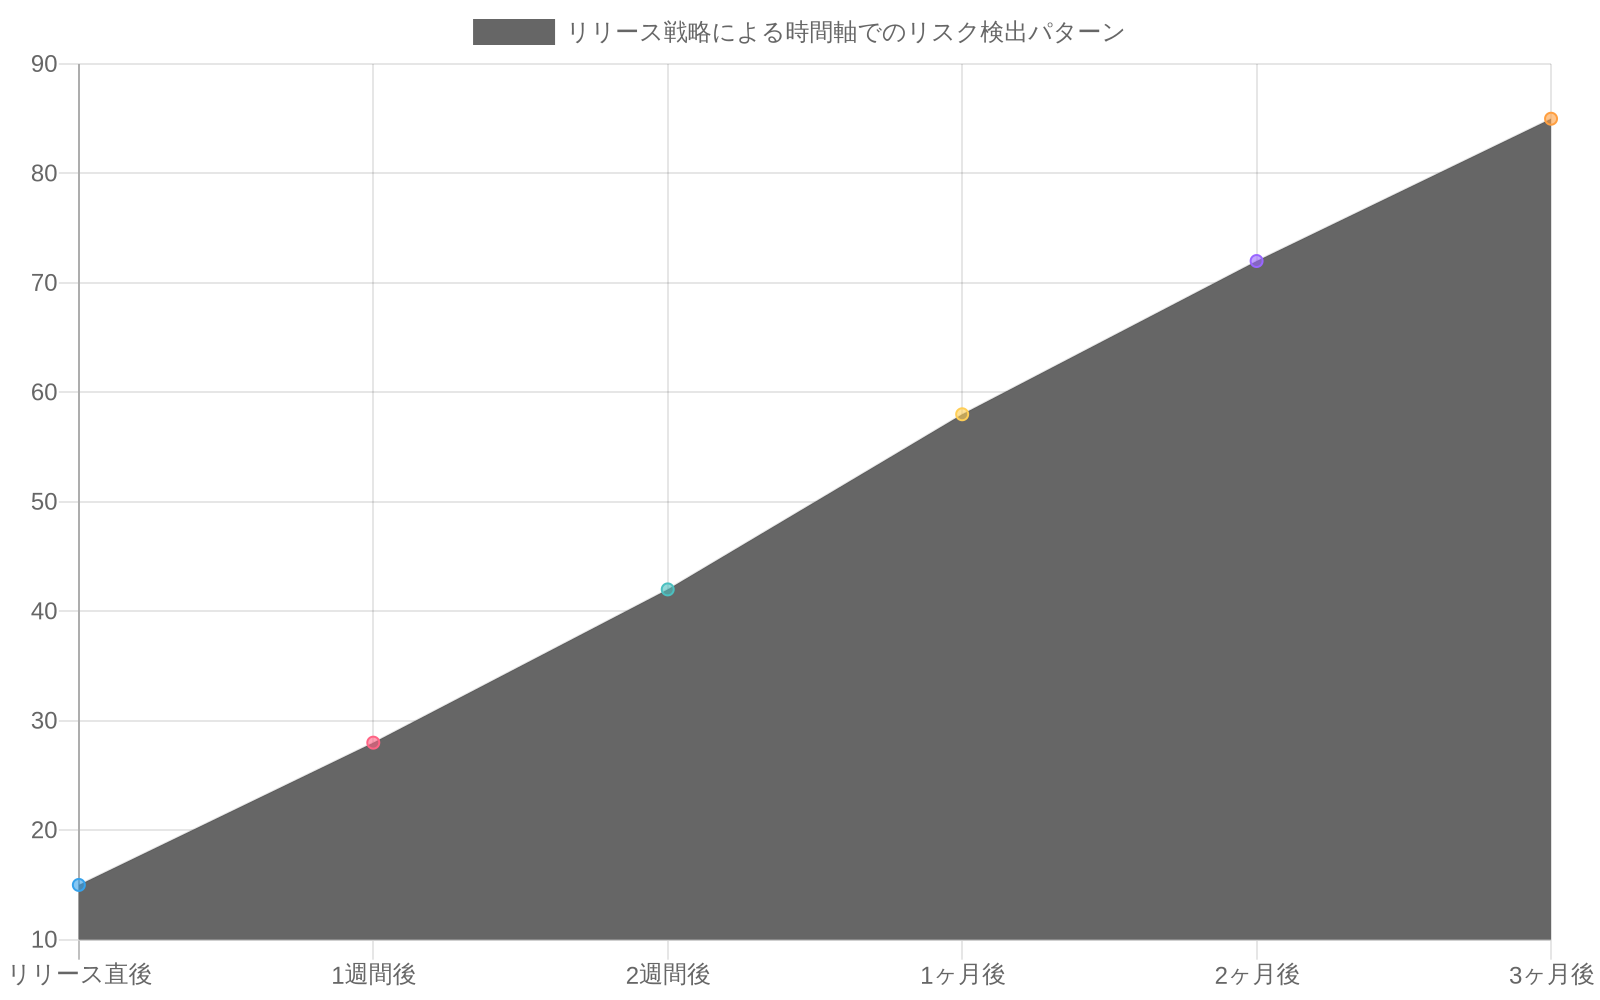
図7:リリース戦略による時間軸でのリスク検出パターン(出典:セキュリティリリース管理の一般的知見)
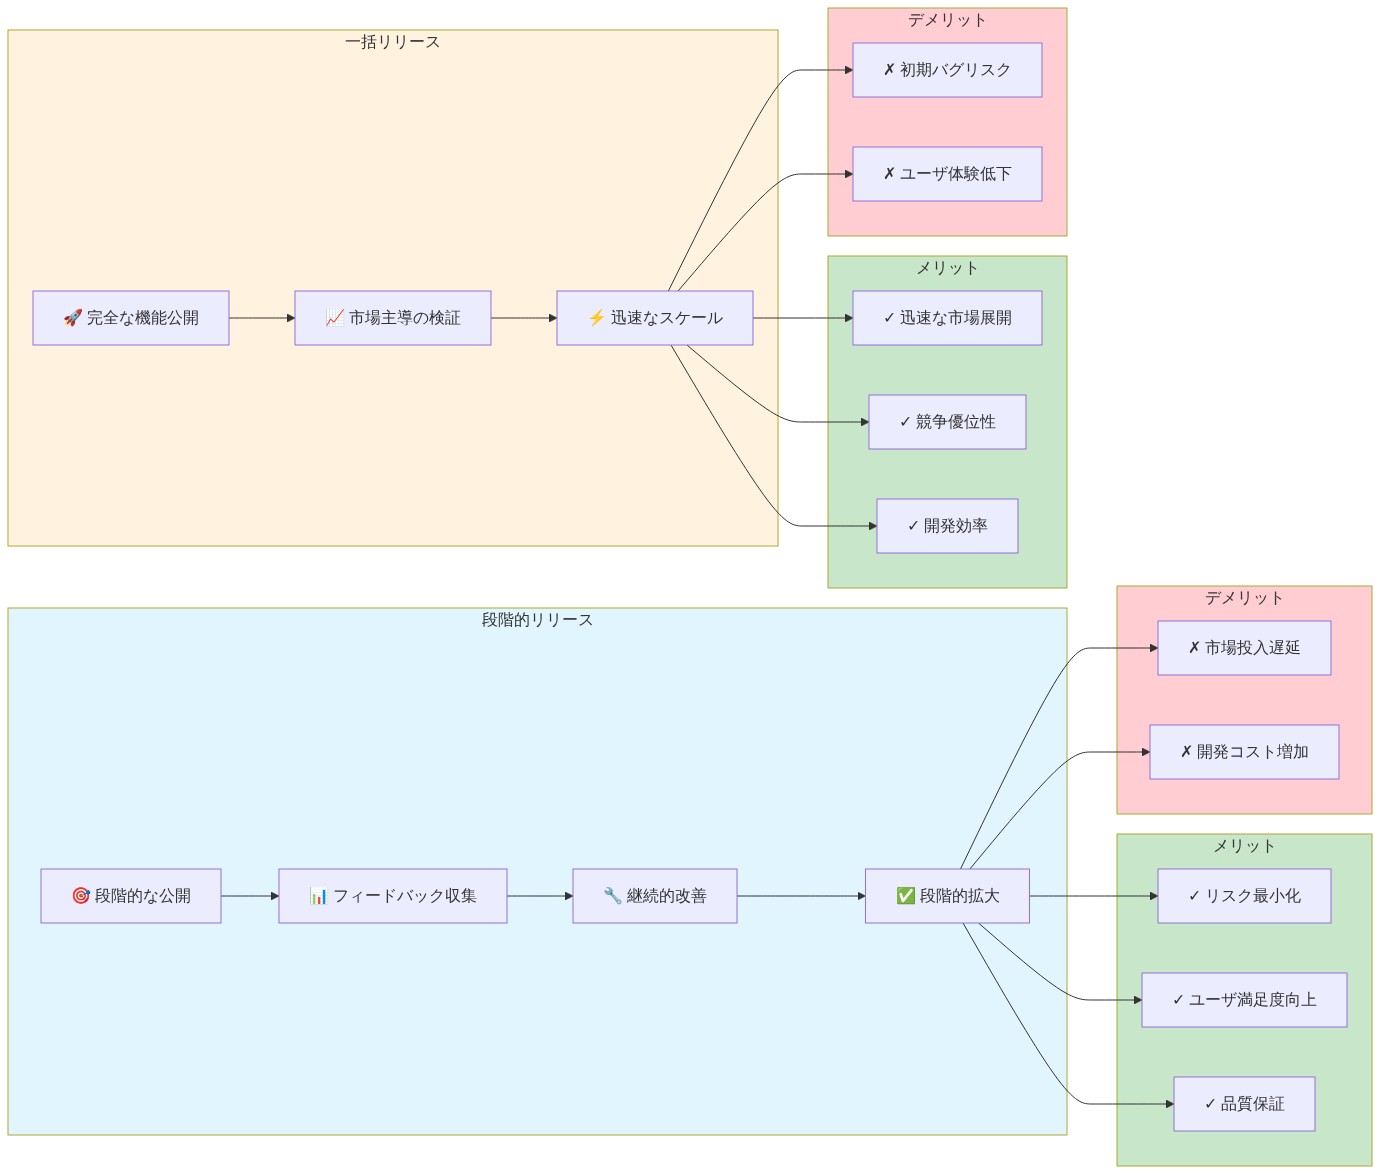
図6:AI強力モデルのリリース戦略 - 段階的公開 vs 一括公開の比較
注目点と備え
発表直後の熱気は、長く残る意義を測る物差しにはならない。Argon が本当に転換点になるかどうかは、いくつかの動きで見えてくる。
- 実際のコードベースでの独立した評価。 散らかった本番規模のリポジトリを使った第三者のテストは、ベンダーのベンチマークより重い。
- インシデントの報告。 モデルを使った攻撃や、モデルが書いた欠陥のあるパッチの事例が、両刃のリスクの現れ方を示す。
- 企業での採用データ。 利用の数字や導入事例から、Argon が中核のインフラになるのか、試験的な利用にとどまるのかが分かる。
- 競合の反応。 競合が自社のリリースを急ぐのか、安全性を前面に出すのか。それが、業界が Google の動きをどう読んだかの目印になる。
セキュリティ能力を持つモデルが標準的なインフラになれば、政策の側も関心を向けるだろう。規制当局は、段階的な提供、利用状況の監視、拒否のルールで足りるのかを問うかもしれない。
最先端のセキュリティ向けモデルに、特別な免許や監督が必要かどうかも、問われるかもしれない。これらの問いへの答えは、次の世代のモデルに対する AI のガバナンスの形を左右しうる。
Argon や似た道具の導入を考えるエンジニアリングやセキュリティの責任者には、五つの手順が役に立つ。
- 自社のコードで試す。 代表的な社内リポジトリで試験運用する。古く、文書の乏しいシステムも含める。作業の完了率、やり直しの回数、1件を終えるまでのコストを測る。
- モデルの出力は下書きとして扱う。 モデルが作ったパッチや監査の結果にも、人間の成果物と同じレビューとテストを通す。セキュリティ上重要な変更には、より高い基準を課す。
- 重大な場面では人間のレビューを必須にする。 認証、暗号、アクセス制御のように、必ず専門家の承認が要るコードの範囲を、あらかじめ決めておく。
- 攻撃者も似た道具を持っていると考える。 下調べや攻撃手法の開発が速くなることを、脅威の想定に織り込む。分かっている穴は、早めにふさぐ。
- 選択肢を残しておく。 クローズドとオープンの争いが決着していないうちは、一つのベンダーに深く縛られない。機密性の高い業務のために、自前で動かすモデルへの道を保っておく。
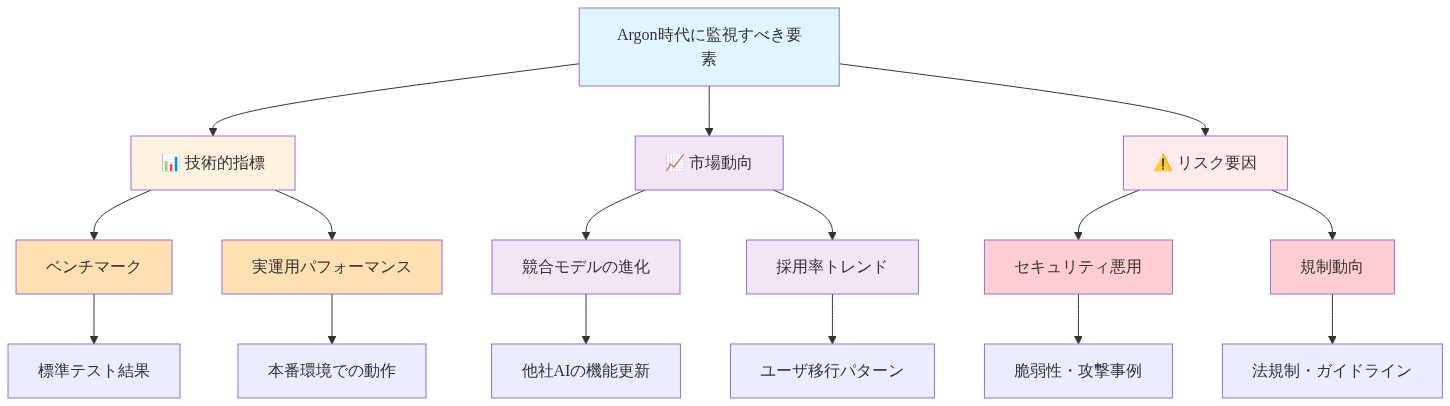
図9:Argon時代に監視すべき3つの要素カテゴリー
ちょっと立ち止まって
Argon は、ソフトウェアを書く人にも守る人にも、単純な問いを突きつけている。機械が人間より速く欠陥を見つけられるなら、それを最初に目にするのは誰であるべきなのか。
その答えは、一つのモデルだけでは決まらない。守る側がこうした道具をどれだけ早く取り入れるか。
研究所が自分たちのリスクをどこまで正直に報告するか。チームが人間の判断をどれだけ手元に残すか。それらにかかっている。
あなたの組織は、どこに線を引くだろうか。ベンダーや攻撃者に線を引かれる前に、自分で決めておく価値はありそうだ。
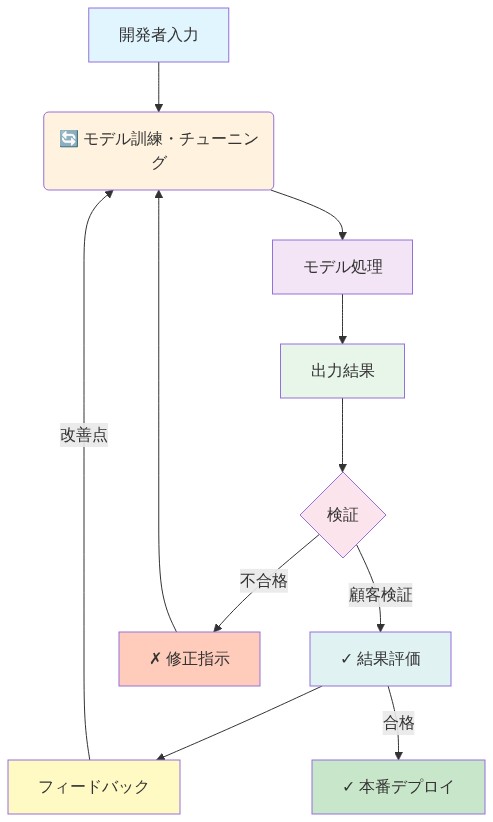
図2:コード・セキュリティ領域における高速フィードバックループの構造

表1:コード・セキュリティ領域における出力検証方法と最先端モデルの適用理由