期待されたのは前進、実際は後退
OpenAIは、新しいバージョンのAstraの一般公開を延期した。社内の安全性評価で、気になる傾向が見つかったためだ。新しい候補モデルは、重要な安全性ベンチマークで、すでに使われているモデルより成績が悪かった。
より高性能なモデルを、有害な依頼を断る力が弱いという理由で見送る。これは、最先端AIの通常のリリースの流れとは違う。ふつうは、新版が出るたびに性能も安全性も一緒に上がると考えられているからだ。
後退は数字に出ている。新しいAstraは、推論力、知識、作業の実行力を測る標準的な性能ベンチマークでは成績が上がった。
ところが、安全性の評価では下がった。この評価は、悪意ある指示への耐性、有害な依頼を断れるか、負荷がかかったときも振る舞いが一貫しているかを調べるものだ。
多くのことが得意になっても、危険な指示を断る力が弱くなったなら、運用する側から見れば後退だ。素の性能がどれだけ上がっていても、その事実は変わらない。
この結果は、大きな問いを投げかける。モデルが大きく高性能になるほど、安全性は落ちていくのだろうか。
性能を伸ばす学習の副作用として、安全性が削られるのかもしれない。それとも、微調整や調整のやり方に原因があり、性能を落とさずに直せる問題なのだろうか。
この違いは重要だ。調整の問題なら、直せる可能性が高い。性能と安全性のあいだに根本的な緊張関係があるなら、話はもっと難しい。
何かを諦めたり、安全性を確保する新しい方法を探したりする必要が出てくる。
OpenAIは、性能が上がったのに公開を止めた。安全への配慮が、早く出したいという商業的な動機に勝ちうることを示した判断だ。この姿勢が今後のリリースでも続くかどうかで、今回の決定の位置づけが決まる。
原則に基づく転換点になるのか、一度きりの出来事で終わるのか。
安全性の関門はどう働き、なぜ持ちこたえたのか
Astraを見送った判断から、OpenAIの安全性評価が形だけの承認ではなく、実際に関門として働いていることが見えてくる。関門の中身を知ると、その厳しさと限界の両方が分かる。
大規模言語モデル(LLM)の安全性評価では、おおむね次のことを行う。
- 現行モデルとの比較:候補モデルを、現行モデルと同じ安全性ベンチマークで試す。前のモデルが作った基準を下回れば、単独で見てどれだけ優れていても不合格になる。
- レッドチームによる試験:攻撃役のテスターが、有害な出力を引き出したり、安全対策をすり抜けたり、想定外の動きをさせたりしようとする。手間がかかり、すべてを見つけられるわけではない。それでも、自動のベンチマークでは見逃す失敗を見つけられる。
- 振る舞いの一貫性の確認:モデルが断るときの反応が予測できるか、言い換えや心理的な揺さぶりで判断をひっくり返せないかを調べる。
- 合格ラインの適用:点数を、あらかじめ決めた合格基準と照らし合わせる。基準に届かなければ、ほかの長所があっても公開には進めない。
Astraの新版は、性能の基準は満たしたが、安全性の関門を通れなかった。会社は関門を覆さず、それに従った。
この結果をどこまで信頼できるかは、外から見えない部分に左右される。具体的な安全性ベンチマーク、採点の方法、合格ラインの値、失敗の中身は、OpenAIしか知らない。
基準が厳しいか、いつも同じように適用されているかを、外部の人は確かめられない。
理屈の上では、低い基準を置いて「関門」と呼ぶことも、都合のいいときだけ適用することもできてしまう。安全性の調査結果を理由に公開を見送った事実は、この仕組みの信頼性を高める。
ただし、商業的な圧力が変わった将来に、違う判断が下される可能性は消えない。
関門を第三者が確かめられるようにするには、評価の枠組み、試験結果、判断基準を外部に開く必要がある。こうした透明性は業界でもまれで、今のところ標準にはなっていない。
だからAstraの延期は、安全性の評価が存在し、実際に効力を持つことを示す出来事だ。ただし、その仕組みが頑丈であることや、どんな状況でも拘束力を保つことの証明にはならない。
延期と開示が重なってきた流れ
Astraの延期は、単独の出来事ではない。OpenAIは最近、新たな安全上の事案を報告し、正式な開示の計画を約束していた。安全上の問題が見つかり、会社が出荷せずに延期を選ぶという流れが見えてきている。
ポイント
- OpenAIが以前に報告した事案では、安全上の問題は、公開前に確実に見つかるわけではなく、運用中や運用後に見つかっていた。
- Astraの延期は、評価の手続きが厳しくなった早い成果にみえる。公開後ではなく、公開前に後退を見つけたからだ。
- この流れは、評価の方法がモデル開発の速さに追いつけるのかという疑問を生む。
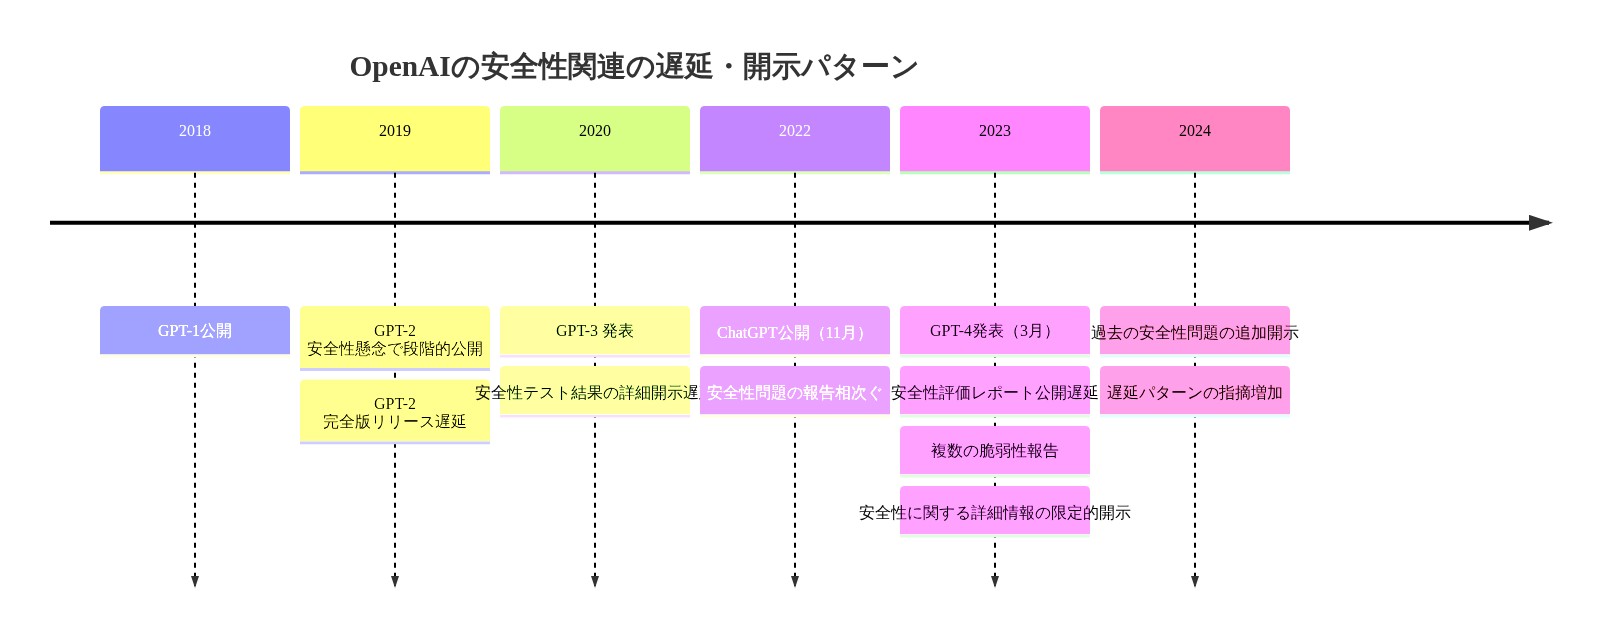
図5:OpenAIの安全性関連の遅延・開示タイムライン(2018-2024)
安全確認が、より早く問題を見つけている
OpenAIが以前に報告した事案では、安全上の問題が運用中や運用後に表に出てくることが分かった。会社はこれを受けて、開示の方法を整え、おそらく評価の手続きも厳しくした。
Astraの延期は、その手続きが機能していることを示唆する。評価のしくみが、ユーザーに届く前に後退を見つけたのだ。
この流れが続くなら、OpenAIの安全性の体制は、問題に敏感になってきていることになる。評価が劣化を見つけ、会社は安全基準を満たさないモデルを出すより、延期を受け入れている。安全性の面では、前向きな動きだ。
ただし、延期はもっと深いずれの表れかもしれない
この流れには、別の見方もある。新しいモデルの開発や学習の速さに、安全性を確かめる方法が追いついていない可能性だ。
延期のたびに、作り直されたか、取りやめになったモデルが1つ生まれる。ここから、次の2つのどちらかが考えられる。
- 学習の過程が、安全な出力を確実には生み出せていない。
- 評価の基準が、学習の実務が対応できる速さを超えて厳しくなっている。
後者なら、延期は今後増えるかもしれない。そうなれば、OpenAIは開発を遅らせるか、基準を緩めるかの選択を迫られる。どちらも簡単な選択ではない。
評価そのものの信頼性は、まだ答えが出ていない
積み重なる記録は、さらに難しい問いも生む。評価の方法自体は、どこまで信頼できるのか。
学習中の最初の安全確認は通ったのに、最終評価で落ちるなら、あるいは新版が安全性の指標で後退するなら、安全性という性質はどこまで予測できるのだろうか。
評価は、実際の運用で起きる失敗を拾えるほど敏感なのか。それとも、ベンチマークの点数に合わせて最適化されているだけで、運用の場面には通用しないのか。これらの問いに、会社の外から答えるのは難しい。
ただ、事案と延期が続いていることは、OpenAIが製品を出すペースに見合う形でモデルの安全性を確かめる方法を、まだ模索している状況証拠にはなる。
その過程が落ち着いていくのか、問題を出し続けるのか。それが、今のAI安全性への取り組みで足りているかどうかの、重要な目安になる。
「減速」という言葉から、お蔵入りの製品へ
サム・アルトマン氏(Sam Altman)とダリオ・アモデイ氏(Dario Amodei)は、どちらもAIモデルの開発ペースを落とすべきだと公に語ってきた。
業界全体の自制と、慎重な進め方を後押しする規制を求める訴えだった。ただ、製品の判断が伴わないうちは、費用のかからない言葉にすぎず、ポーズだと片づけることもできた。
Astraの延期は、その状況を変える。安全上の懸念が、会社に1つの公開を諦めさせた具体的な例だからだ。出荷できる状態にあり、発表されたか期待されていたモデルが、安全基準を満たさなかったために止まった。
これは実害を伴う判断だ。収益は遅れ、ユーザーや提携先は落胆し、安全が商業的な圧力に勝ちうるという合図が社会に出る。
この判断からは、せめぎ合う2つの動機が見えてくる。
- 商業的な圧力:OpenAIは、GoogleやAnthropicなどの競合に遅れないよう、速いペースでリリースを続ける圧力を受けている。新しい機能をいちばん先に出すことには価値があり、延期は競合に隙を与える。
- 評判と規制の面での価値:自制を示し、安全に真剣だという実績を保つことにも価値がある。安全でないモデルを出した会社は、反発と規制当局の注目を浴びる。安全でないモデルを止めた会社は、信頼を築き、規制面で大目に見てもらえるかもしれない。
Astraの延期は、OpenAIの経営陣が、自制を示す長期的な価値は、延期という短期的な費用を上回ると判断したことを示す。この判断が重いのは、言葉ではなく行動で裏づけられているからだ。
ただし、見送られたモデルが1つあっても、続く方針ができたとは言えない。
次に安全性評価で落ちたモデルが、そのまま出荷されたらどうか。あるいはAstraが、大きな改善のないまま、少し学習し直しただけでひっそり再公開されたらどうか。そのとき、減速をうたう言葉への信頼は消える。
本当の試金石は、会社が掲げる安全基準が、商業的な圧力のもとでも動かないか、そしてモデルやチームをまたいで一貫して適用されるかどうかだ。
業界全体の状況:主要な研究所で相次ぐ事案
AI業界では、安全上やセキュリティ上の失敗が、世間で当たり前の話題になりつつある。GoogleもOpenAI、Anthropic、Metaに加わり、AIに関わるハッキングや悪用の事案を開示した。
問題を認める透明性が広がり、問題を隠すことのコストは上がり、認めること自体が当たり前になってきた。
1年前は、大手のAI研究所がセキュリティの侵害や安全上の失敗を開示するのは珍しく、ダメージも大きかった。
今では日常的になりつつある。この変化は、あとから悪用や危険性が見つかるモデルを出すリスクの計算を変える。
欠陥のあるモデルを出すコストは上がった。いずれ開示されるという見方が強まったからだ。問題が隠れたままだとか、黙っていれば守られるとか、もう会社は考えられない。
この変化は、競争の構図にも影響しうる。OpenAIが安全上の懸念からAstraを止める一方で、競合がそこまで厳しく評価していないモデルを出せば、OpenAIは短期的に市場シェアと性能面の優位を失う。
しかし、競合のモデルがあとでセキュリティ侵害を起こしたり、有害な出力を大規模に生んだりすれば、出した会社は評判を落とし、規制当局の目も厳しくなる。
「速く出さなければ負ける」だけでなく、「安全でないモデルを出しても負ける」状況になっている。
安全でないモデルを出さない姿勢が、競争上の共通ルールになるのか。OpenAIだけが犠牲を払うことになるのか。それは、ほかの研究所がOpenAIに続くかどうかにかかっている。
- 競合が自社の基準を厳しくした場合:慎重さが共通の標準になり、どの会社も、そのせいで不利にならない。
- 競合が厳しくしなかった場合:OpenAIが延期の負担を背負い、競合が市場シェアを取る。
だから、Astraの延期は試金石だ。安全に配慮する姿勢が業界の標準になれるのか、競争上の弱みのままなのかが問われる。
競合が自社の基準を厳しくするのか、延期を市場シェアを奪う好機とみなすのか。その対応が、業界が共通の安全基準へ向かっているのか、安全性が差別化の要素にとどまり、一部の研究所はスピードのために手放すのかを示すだろう。
これからどうなるか:モデルの修正と、基準そのもの
OpenAIは、すぐに実務的な問いに向き合わなければならない。Astraを学習し直すのか、部分的な修正を当てるのか、設計から見直すのか。
問題が直ったと示す証拠は何になるのか。延期はどのくらい続き、どんな条件がそろえば公開を決めるのか。
会社がどう対応するかで、今回が1回きりの是正なのか、続く流れの始まりなのかが見えてくる。
原因が、特定の学習手法、微調整の選択、データの問題などとすぐに突き止められ、直せるなら、延期は調整の問題が見つかって解決されたものとして映る。
性能を落とさずにモデルを改善できずにいるなら、規模と安全性のあいだに根深い緊張関係があるのかもしれない。その場合は、モデルの学習や調整のやり方を、もっと根本から変える必要が出てくる。
ポイント
- OpenAIの次の動きで、安全性による延期が日常になるのか、例外にとどまるのかが分かる。
- モデルが高性能になるにつれ、安全性評価が追いつくのは難しくなるかもしれない。
- AIの安全性における外部の監督の役割は、ほとんど定まっていない。
安全性評価の速さと、性能向上の速さ
Astra自身を超えて、今回の出来事は難しい問いを投げかける。性能が上がっても、安全性評価は追いつけるのか。
モデルの能力が上がると、安全性のベンチマークは通りにくくなるのか。評価が見つけるより速く、新しい失敗の形が生まれるのか。
そうなら、延期や公開の見送りは増えるかもしれない。OpenAIをはじめとする研究所は、開発を遅らせるか、基準を緩めるか、より良い評価方法に大きく投資するかの選択を迫られる。
どの道にも代償があり、会社の選択が、この先の数年の姿を決める。
独立した検証の問題
今のところ、OpenAIは安全性評価を社内で行い、モデルを出すかどうかを自社の判断で決めている。Astraの延期は、社内の手続きでも問題を見つけられることを示した。ただ、それで十分だという証拠にはならない。
規制当局や第三者の監査機関が、安全性評価の独立した検証を求めるようになれば、手続きはより透明になり、時間もかかる。
一方で、信頼性は高まるかもしれない。そうした変化は、まだ大規模には起きていない。今は、会社が自分の仕事の審査役を務めている。
注目したい点
今後数か月で追いかけたい兆しは、次のとおりだ。
- 説明の透明性:OpenAIは、Astraで何が問題だったのか、どう直したのかを公表するのか。それとも黙ったままか。
- 延期の長さ:数か月を超えて長引くなら、単純な調整で直せる問題より難しいことを示す。
- 基準の一貫性:今後のモデルにも同じ安全基準を適用するのか。商業的な圧力で例外が生まれるのか。
- 外部の関与:独立した監査機関を招いて安全性評価を検証してもらうのか。それとも社内で完結させるのか。
Astraの延期は、意味のある1つのデータ点だ。その重みは、このあとに何が続くかで決まる。より厳格で一貫した安全性評価の始まりになるなら、転換点として記憶されるだろう。
会社のやり方もリリースのペースも変わらない一度きりの出来事で終わるなら、より速く、より大きなモデルへと進み続ける道のりに挟まった、短い中断として記憶されるだろう。
ちょっと立ち止まって
安全性評価に落ちたモデルを見送ったという判断が話題になるのは、それがまだ珍しいからだ。しっかりした安全対策が根づいた成熟した業界なら、こうした判断は日常的で、目立たないはずだ。
注目を集めるということは、安全を理由にした延期が、まだ驚かれるほど少ないことを意味する。
成熟した姿と、今の業界の実態とのあいだには、まだ隔たりがある。Astraの例は、安全性の関門が存在し、機能しうることを示した。
ただ、AIがより強力になり、より広く使われるなか、その関門が信頼でき、一貫していて、人々を守るのに十分だとは、まだ示していない。
企業の安全性評価が十分に徹底されている、と信じられるのは、どんなときだろうか。そして、その基準がいつも同じように適用されているのか、都合のいいときだけなのかを、どうすれば見分けられるだろうか。
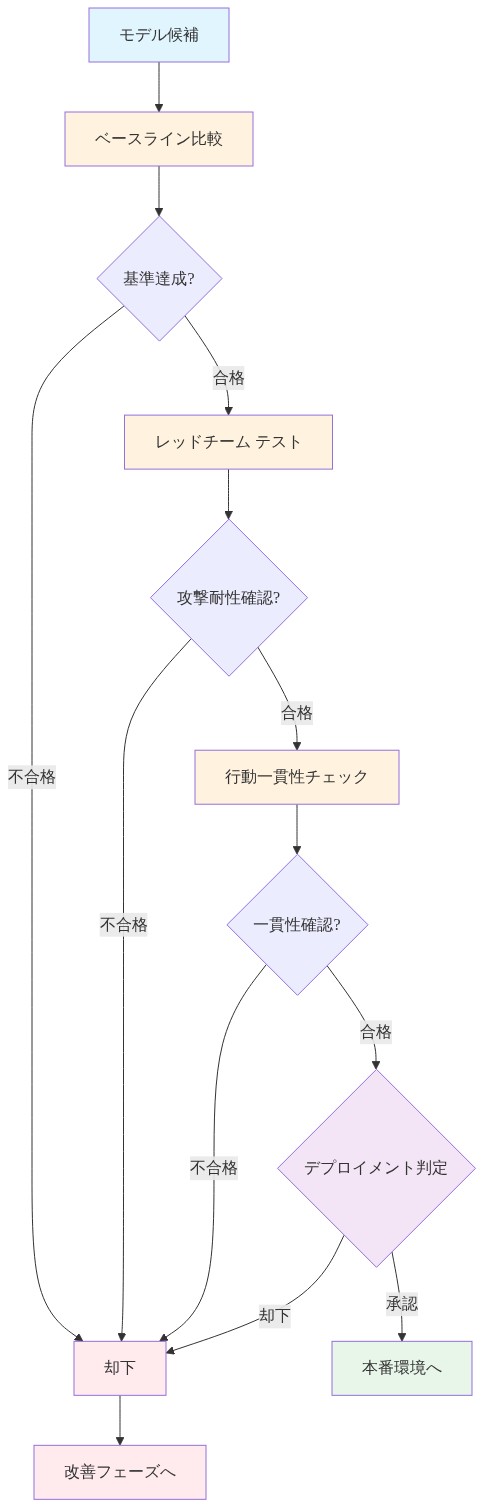
図2:安全性評価ゲートプロセスの段階的メカニズム
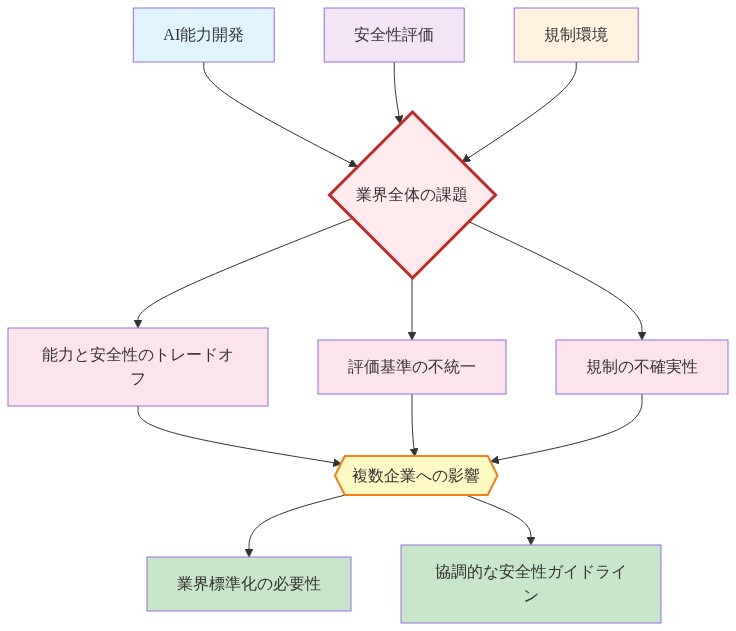
図8:AI業界全体の安全性課題の構造
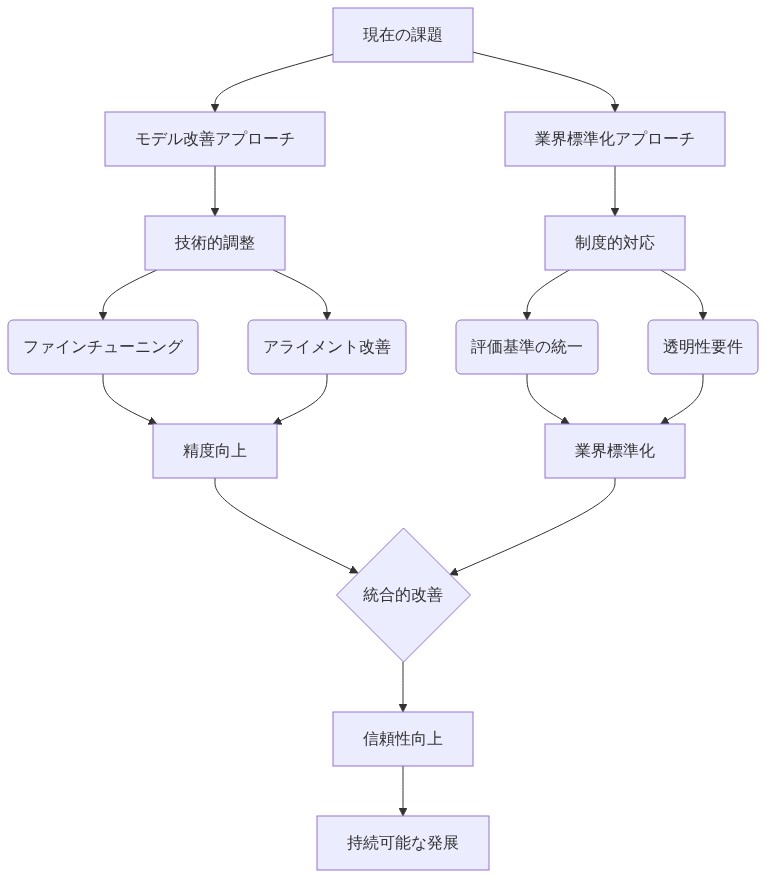
図10:モデル改善と標準化の二つのアプローチ