Jalapeñoチップ:設計のやり方こそが本題
OpenAIは、自社の大規模言語モデル(LLM)が、独自のアクセラレーターチップ「Jalapeño」の設計に大きく貢献したことを示している。注目すべきはシリコンそのものではない。設計のやり方のほうだ。
AIが、次世代のAIを訓練し動かすためのハードウェアを作る手助けをした。ここで輪が閉じる。モデルがインフラ作りを助け、そのインフラがより高性能なモデルを生み出す。
チップ設計は、工学の中でも特に費用がかさみ、高度な専門性が求められ、ミスが許されない分野だ。
見落とされたバグがひとつあるだけで、数か月の遅れと数百万ドルの損失になりうる。だから「言語モデルが作業を大きく速めた」という主張は、しっかり吟味する必要がある。
中心にある問いは単純だ。モデルは、エンジニアがすでに理解していた定型作業を短くしただけなのか。
それとも、チップ工学のあり方そのものを変えたのか。この答えしだいで、ほかの組織が同じ成果を再現できるかどうかが決まる。
この記事のポイント
- LLMが担ったのは、設計工程の一部、特に文章が中心の作業と検証作業だった可能性が高い。モデルが単独でチップを設計したことを示すものはない。
- AIがAIのためのハードウェアを作ると、モデルの能力と、次の能力を支える計算資源とのあいだの時間が縮まる。
- モデルがハードウェアのコードを生成するとき、検証と監査が決定的な安全策になる。
チップ設計の流れとLLMの出番
LLMが役に立つ場面は、工程によって大きく違う。
現代のチップは、長い工程を順にたどって作られる。工程ごとに、チームに求められることが変わる。
- 仕様策定。 アーキテクトが、性能目標、電力の上限、インターフェースなど、チップに求める機能を決める。
- RTL記述。 エンジニアが、VerilogやVHDLといったハードウェア記述言語で、チップの論理を書く。
- 機能検証。 論理が仕様どおりに動くかを、シミュレーション、テストベンチ、アサーション、形式手法で確かめる。
- 物理設計。 フロアプラン、配置、配線を通じて、論理をシリコン上に落とし込む。
- タイミング収束。 実際の動作条件で、信号がチップ全体に時間どおり届くことを確認する。
- テープアウト。 完成した設計を、製造のためにファウンドリに渡す。
言語モデルは、どの工程にも同じようにあてはまるわけではない。ハードウェア記述言語は文章なので、RTLの生成、テストベンチやアサーションの作成、ログの仕分けは、モデルに向いた作業だ。
一方、フロアプラン、配置、配線は、図形を扱う最適化の問題にあたる。この分野ではこれまで、強化学習や従来型のソルバーで取り組んできた。文章を扱うモデルの出番ではなかった。
LLMがいちばん役に立った可能性が高いのは検証だ。
現代のチップでは、設計の労力のうち最も大きな割合を検証が占める。しかも、生成された結果を正解と照らし合わせやすい工程でもある。テストはバグを見つけるか、見つけないかのどちらかだからだ。
検証の典型的な作業には、次のようなものがある。
- 人が思いつかないような境界条件のテストを生成する
- 期待される動作を表すアサーションの案を書く
- 設計の別案をすばやく試す
- 大量のシミュレーションログを仕分けして、重要な失敗を見つける
こうした作業では、独立した判断力よりも、カバーする範囲の広さと速さが大切になる。
モデルが100個のテストを出し、役に立つのが10個だけでも、チームは大きく時間を節約できる。使えない90個を捨てる手間が小さければ、の話だ。
物理設計とタイミング収束は事情が違う。空間を把握する力と、制約を満たす力が必要で、今の言語モデルはどちらも得意ではない。
文章を扱うモデルの得意分野から考えると、これらの工程でLLMが果たした役割は小さかった可能性が高い。テープアウトの成否を左右する重要な工程であるにもかかわらず、だ。
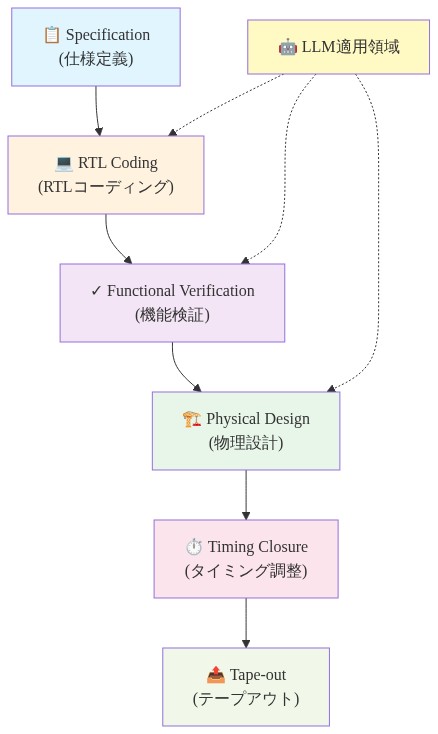
図2:チップ設計プロセスの6段階とLLM適用領域
LLMがやったこと、おそらくやっていないこと
LLMの貢献は、速さ、カバー範囲、判断力の3つに分けて考えるとよい。
AIを使った工学について世間で語られるとき、この3つは混ぜて語られがちだ。チップ設計にあてはめると、次のようになる。
| 貢献 | 中身 | もっともらしさ |
|---|---|---|
| 速さ | 定型的なRTL、文書作成、リグレッションのデバッグを、数日から数時間に縮める | 高い。AIコーディング支援を使った業界の広い経験と合う |
| カバー範囲 | 設計の別案をより多く試し、境界条件のテストを増やし、人が探す時間のなかったバグを見つける | 高い。特に検証では、探す範囲が広く、結果を確かめやすい |
| 判断力 | メモリ階層、数値形式、相互接続、電力をめぐる設計上の兼ね合いを決める | 低い。モデルは選択肢を出せるが、比べて決めるにはシステム全体への深い知識が要る |
費用対効果が最も高いのは、モデルが定型作業を短くし、日々のデバッグを速める場面だ。最も低いのは、モデルが設計上の兼ね合いを決めなければならない場面になる。
よく理解されている作業で速くなった、という話はもっともらしい。新しい設計判断でモデルが判断力を発揮した、という主張は、OpenAIなどが裏づけとなる詳細を公表するまで慎重に見たほうがいい。
モデルが書いたハードウェアに特有のリスク
ハードウェアのコードをモデルが生成すると、ソフトウェアにはない壊れ方が出てくる。
- 見つかりにくい並行処理のエラー。 ハードウェアは並列に動く。競合状態は、何回ものシミュレーションのあいだ隠れたままで、あとから表に出てくることがある。
- 合成に向かない記述。 シミュレーションでは正しく動くコードでも、実際の論理ゲートにうまく変換できないことがある。
- 自信ありげな誤った前提。 モデルは、誤ったタイミングやプロトコルの前提の上に、もっともらしいコードを作ることがある。しかも、疑いの気配を見せないままだ。
ソフトウェアのバグは、出荷後に修正できることが多い。ハードウェアのバグは、テープアウトのあとで見つかると、たいてい直せない。この違いが、ほかのすべてを方向づける。
最も妥当な見方は、LLMが腕の立つチームの力を何倍にも増やした、というものだ。チームの代わりになったわけではない。
報告された成果のうち、どこまでがモデルによるもので、どこまでがプロンプトの工夫や制約のかけ方、監査の腕前といったチームの技量によるのかは、はっきりしない。
ほかの組織が同じ成果を再現できるかどうかは、この内訳にかかっている。
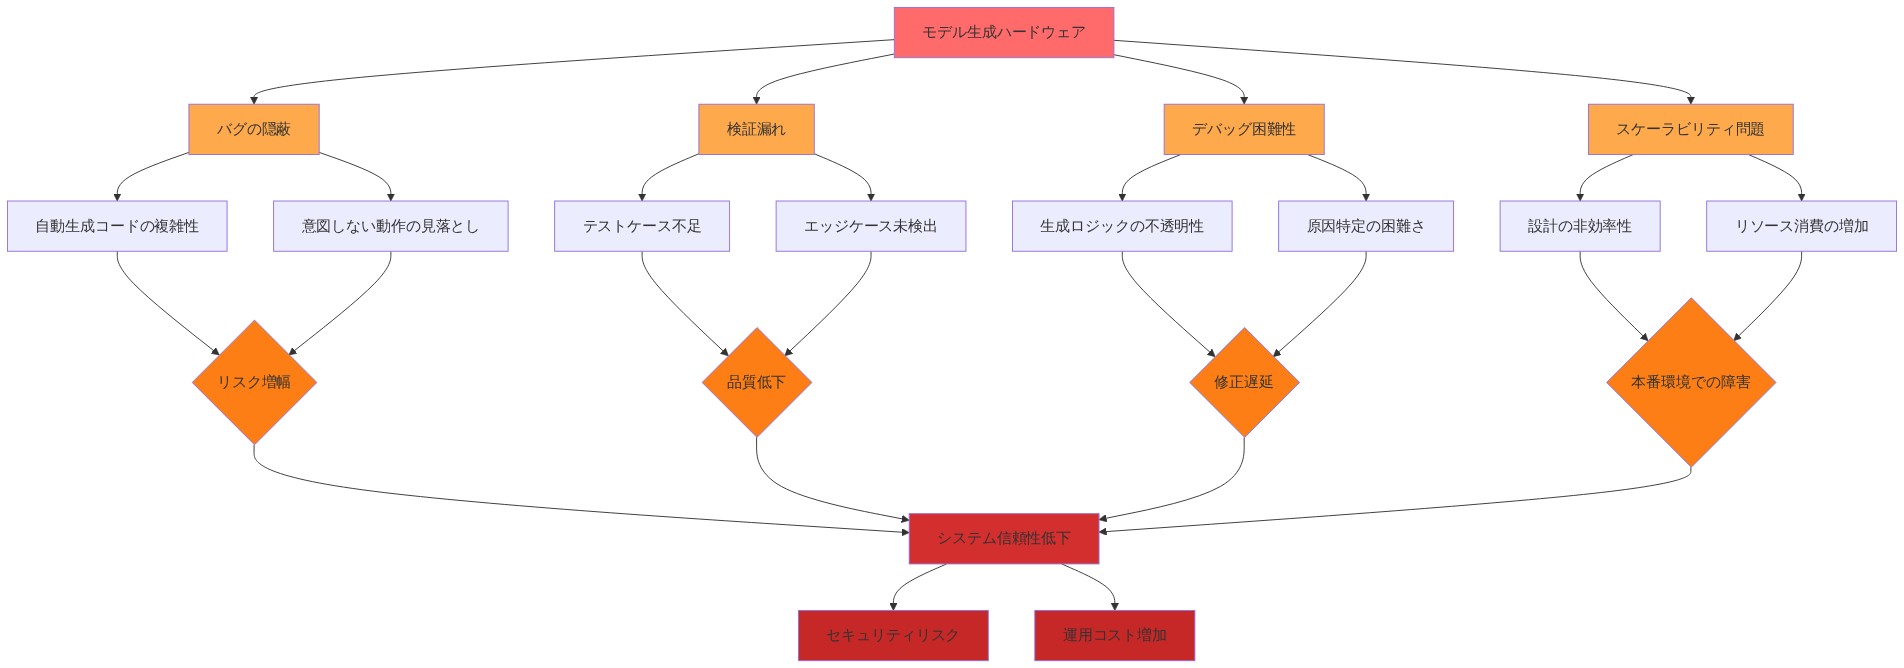
図6:モデル生成ハードウェアの特有リスク体系
検証と信頼:人が書いていないものを確かめる
書くことから、確かめることへ
モデルがハードウェアを書くと、負担の中心は書くことから確かめることに移る。従来の設計レビューでは、書いた人が、そのコードがなぜそうなっているのかを説明できた。
モデルが生成したコードでは、その理由がわからない。信頼は、テストと形式手法に支えられる。
AIを使った設計を正当化するには、何層もの安心材料が要る。
- 形式検証:試した入力だけでなく、あらゆる入力について、重要な性質が成り立つことを証明する
- 等価性検査:設計を変換しても、意図した動作が保たれることを確かめる
- 大規模なシミュレーション:現実的な負荷と、わざと厳しくした負荷の両方で、設計を動かす
- 独立した人間によるレビュー:モデルに指示を出していないエンジニアが、最初の視点が見逃したものを拾う
設計判断の来歴を残す
AIを使った設計を監査できるようにするには、次の記録が必要になる。
- 設計のどの部分がモデル由来で、どの部分が人間由来か
- モデルを導いた制約、プロンプト、仕様は何か
- モデルが生成した各部品を、どの検証手順で確認したか
- 誰が、どんな根拠で承認したか
これは、従来の設計文書よりも要求が重い。だがこの記録があれば、遅れて見つかったバグの出どころをたどれる。原因がモデルにあったのか、プロンプトにあったのか、レビューにあったのかも判断できる。
開示のルールが追いついていない
今の開示のルールは、AIが生成した設計作業から生じたハードウェアの欠陥を、はっきりとは扱っていない。モデルが、次のモデルを動かすハードウェアに欠陥を持ち込んだ場合、どんな透明性が求められるのか。
OpenAIの安全に関する約束はモデルの振る舞いをカバーしているが、工学上の成果物についての空白は残っている。この空白が埋まれば、約束を評価しやすくなる。
速さへの圧力とその限界
速くなれば、検証が終わる前に出荷したくなる。これは予想できる誘惑だ。テープアウトの経済性は、ある程度これを抑えてくれる。
チップを作り直すと、数百万ドルと数か月の遅れがかかるからだ。真剣なチームなら、その代償は払いたくない。
ただし、この歯止めは誰にでも同じように働くわけではない。OpenAIには、高くつく作り直しに耐える体力がある。
同じ方法を採り入れる小さな会社には、ないかもしれない。そうした会社にとって、AIで速めた設計と、十分に検証された設計とのあいだの隔たりは、金銭面でより大きなリスクになる。
人の側の問題:エンジニア、技能、設計の権限
言葉にならない専門知識はどうなるか
定型作業をモデルに任せると、その作業を通じて身についた専門知識が薄れていくことがある。経験豊富なチップアーキテクトは、何年もRTLを書き、デバッグするなかで勘を養った。
どんな書き方がタイミングの問題を起こすか、どのパターンにどんなバグが潜むか、問題が大きくなる前にどう気づくか。
若手エンジニアが自分でコードを書かず、モデルの出力を確認する役回りばかりになると、次世代のアーキテクトを育てる道が細くなるかもしれない。
この兼ね合いには、両面がある。
| 期待できる面 | 心配な面 |
|---|---|
| エンジニアが、アーキテクチャやシステム全体の判断に、より多くの時間を使える | 若手が、勘を養う実地のデバッグを経験できない |
| 同じ期間で、より多くの設計案を試せる | もっともらしい出力に慣れてしまい、レビューが甘くなる |
| 定型作業が、スケジュールの足を引っ張らなくなる | 専門知識が、少数の上級レビュアーに集中する |
チームの形が変わる
モデルが最初の版を書くようになると、仕事そのものの組み立てが変わる。変化は3つある。
- レビューが、主な防衛線になる。 レビュアーは、人間の書き手を確認する二番目の目ではなくなる。品質を守る最初の関門になる。
- 責任の置き場が、承認に移る。 自分では書いていなくても、モデルが生成したコードは正しいと判断する責任を、誰かが負わなければならない。
- キャリアの道筋を考え直す必要がある。 何年ものRTL実務を前提にした育成では、エンジニアがこれから担う役割に備えられないかもしれない。
本当の理解を保つための工夫としては、次のようなものがある。
- モデルが生成した部品には、設計レビューを必須にする。レビュアーは承認するだけでなく、コードの中身を声に出して説明する。
- サブシステム間でローテーションを行い、エンジニアが設計全体に広くなじめるようにする。
- ときどき、モデルの支援なしで重要なブロックを書き、デバッグする実地の作業を入れる。
- 生成されたコードの確認が不十分でバグが出たときは、責任の所在を明確にする。
最良の場合と最悪の場合
最良の場合、LLMが定型作業を引き受け、エンジニアは判断に集中できる。チームは、深い理解を失うことなく、速く進める。
最悪の場合、専門知識は、縮んでいく上級レビュアーの一団に集まる。彼らはボトルネックになり、ひとつでも欠ければ全体が止まる急所になる。彼らが去れば、組織は、どんなモデルにも代えられない知識を失う。
どちらになるかは、モデルの性能よりも、組織がモデルの周りで仕事をどう組み立てるかで決まる。
表では慎重に、実際には加速
OpenAIとAnthropicの幹部たちは、フロンティアモデルの開発を遅らせるべきだと公に訴えてきた。その一方で、これらの組織は、自分たちのインフラの奥深くまでAIを入れ込んでいる。
AIで計算用ハードウェアを設計すると、モデルの能力と、次の能力を支えるインフラとのあいだの時間が縮まる。
ひとつの進歩が、次の進歩を速めうる。この雑に言えば雪だるま式の動きこそが、慎重論の人たちが心配していることだ。
独自のシリコンには、はっきりした商売上の筋道もある。
- ベンダーへの依存を減らす。 自社製のチップなら、数の限られたアクセラレーターを外部の供給元に頼る度合いが下がる。
- 推論のコストを下げる。 自社モデルに合わせて調整したハードウェアなら、そのモデルをより効率よく動かせる。
- 戦略上の主導権を持つ。 ハードウェアの計画を自分で握れば、将来のモデルの設計にも余地が広がる。
どの目的も、不合理ではない。引っかかるのは別の点だ。慎重さを求める声と、社内での積極的な自動化とは、両立させにくい。
これまでの公の発言は、その二つがどう折り合うのかを説明していない。
信頼できる安全への姿勢なら、AIが自らの土台を作るときの使い方にまで及ぶはずだ。
フロンティアモデルには、開示と慎重さを必要とするリスクがあるとOpenAIが考えるなら、そのモデルが能力拡大の最短の道筋に乗るときも、同じ理屈があてはまる。この基準を適用するといっても、作業を止めるという意味にはならない。
モデルをどこで使い、出力をどう確認し、この輪にどんな安全策を設けているのかを、透明にするということだ。
半導体業界への意味
交渉力の変化
OpenAIの説明が裏づけられれば、AIを使った設計は、資金力のあるAI企業がカスタムシリコンに参入する壁を下げる。
すると交渉力は、既存のチップベンダーや、電子設計自動化(EDA)ツールの提供者から離れていく。EDAの各社は、自社ツールに独自のAIアシスタントを組み込もうと急いでいる。
業界全体への影響は、立場によって違う。
| 立場 | 予想される影響 |
|---|---|
| フロンティアモデルとチームを持つ大手AI企業 | カスタムシリコンの開発が速くなり、設計案をより多く試せる |
| 既存のチップベンダー | 主要顧客が自社開発の代替品を作るため、圧力がかかる |
| EDAの提供者 | 競争力のあるAI機能を出せなければ、社内ツールに置き換えられるおそれがある |
| スタートアップと小規模なチップ企業 | AIを使った設計が標準になりつつ、フロンティアモデルを持つ企業に集中したままなら、参入の費用が上がる |
当たり前になるのか、一度きりなのか
AIを使った設計は、競争力のあるシリコン開発の最低条件になるかもしれない。そうなれば、高性能なツールが広く手に入らない限り、新規参入者の費用は高くなる。
設計の力は、フロンティアモデルと深いチップの知識を併せ持つ企業に集まっていく。
そうなるかどうかは、まだ公表されていない証拠にかかっている。
鍵になるのは、この方法が再現できる手順になるのか、それとも、自社のモデルを特別に使える飛び抜けて腕のいい一つのチームの成果にとどまるのか、という点だ。
見ておきたいこと
この動きを追うエンジニア、技術リーダー、観察者にとって、押さえておきたい点は5つある。
- Jalapeñoチップの独立したベンチマークを探す。 OpenAIの外から出る、性能、効率、信頼性のデータが、AIを使った工程で競争力のあるシリコンができたかどうかを示す。
- スケジュールと作り直しの証拠を追う。 OpenAIや、似た方法を採る企業で、設計期間の短縮や作り直しの減少が確認できれば、成果が本物だという最も明確な印になる。
- 検証がどう行われたかを問う。 AIを使ったハードウェアの主張を評価するときは、どんな形式手法、等価性検査、独立レビューでモデルの出力を確認したのかを尋ねる。
- エンジニアリングチームを率いるなら、実地の技能を守る。 AIの導入と合わせて、ローテーションやモデルなしの設計作業のような意識的な取り組みを行い、出荷するものを自分で説明しデバッグできる力を保つ。
- 安全への約束を、一貫した基準で見る。 AI開発者が慎重さを訴えるとき、その慎重さが、将来のモデルを支えるインフラを含む、自社内でのAIの使い方にも及んでいるかを確かめる。
ちょっと立ち止まって
道具が、その道具の次の版を作る機械の製作を手伝う。そこには、静かな驚きがある。同時に、足を止めて考えたくなる場面でもある。
この話で最も大切なのは、モデルが何をしたかではないのかもしれない。
モデルの周りにいる人間が、何を確かめ、何を疑い、何を自分の頭で理解しようとしたか。そのほうが大切なのかもしれない。
速さは測りやすい。理解は測りにくい。
AIが自らの進歩を支える仕事をますます担うようになると、いちばん大事な問いは判断力にかかわるものになる。
システムがどう動くのかを、今も知っているのは誰か。それが壊れたとき、責任を負うのは誰か。そして、この輪をどのくらいの速さで回すかを決めるのは誰か。
次のモデルの設計をモデルに手伝わせるとき、その手伝いは信頼できる、とあなたはどんな前提で考えているだろうか。
そして、間違いを自動化しているだけではないと自信を持つには、何を知っておく必要があるだろうか。
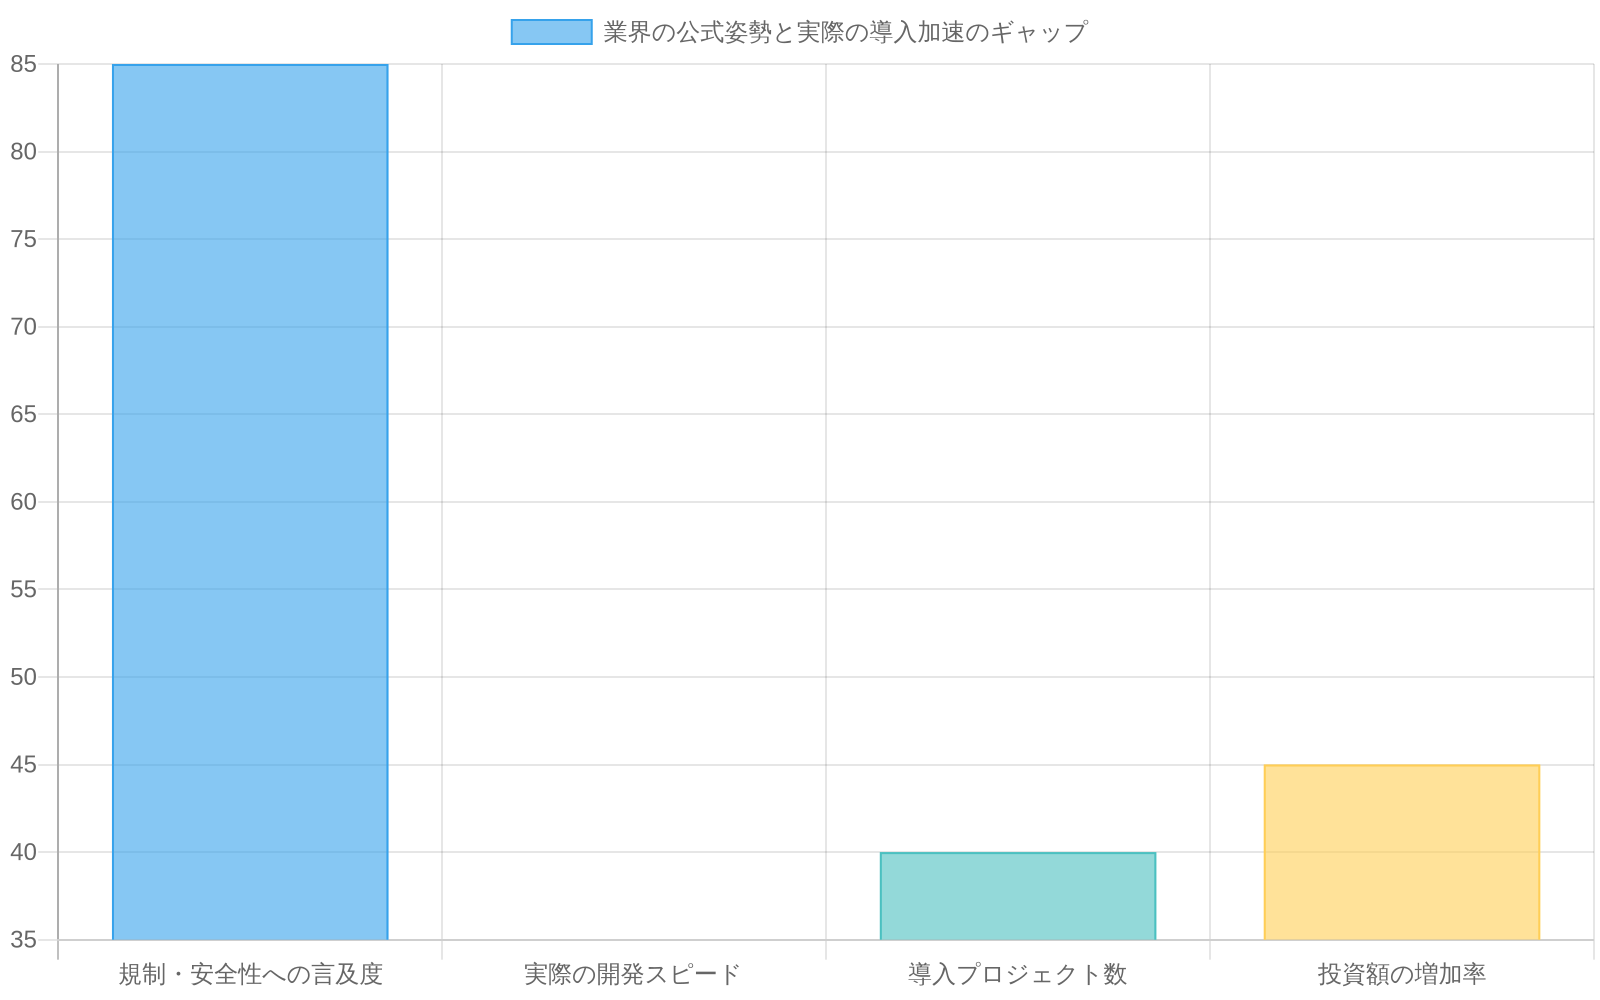
図12:業界の公式姿勢と実践的加速のギャップ(出典:業界トレンド分析・推定値)
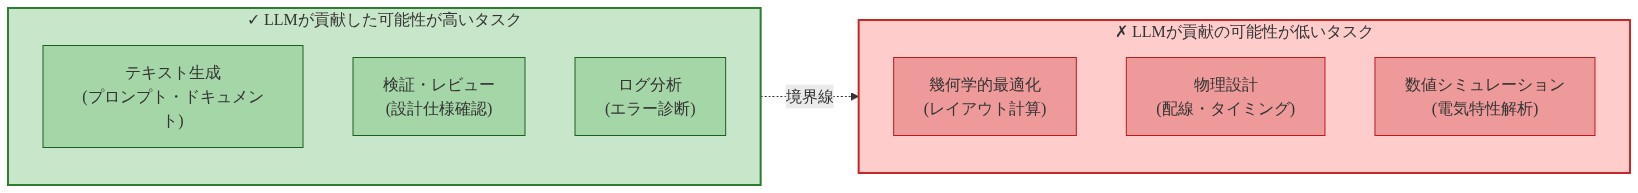
図4:チップ設計におけるLLMの適用可能性マトリックス
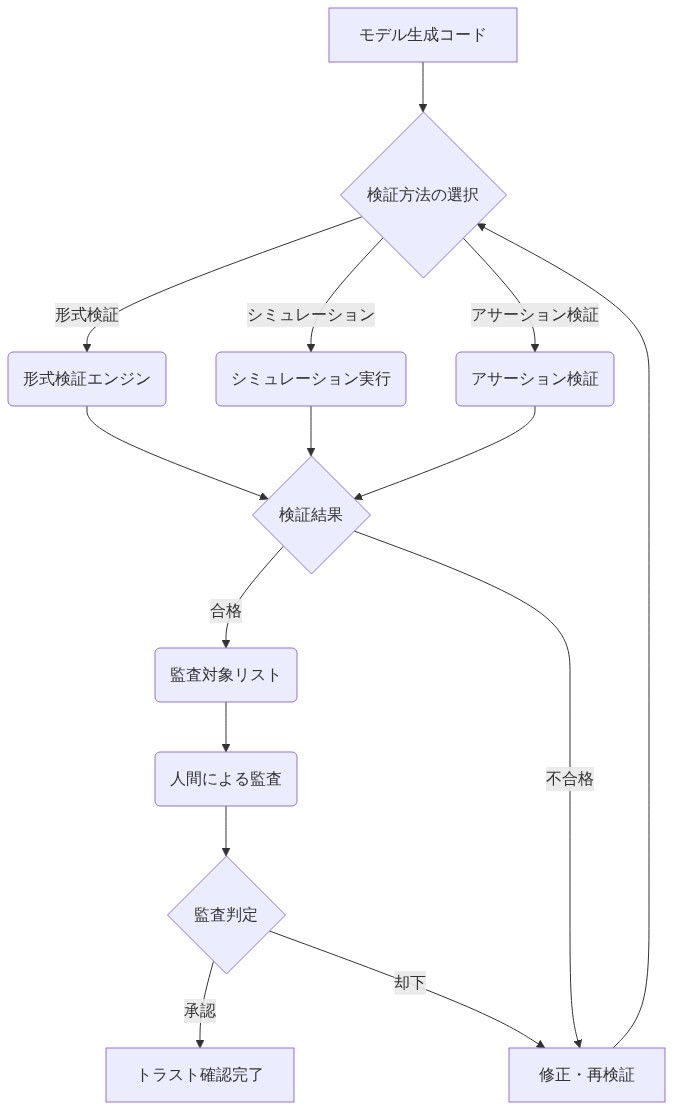
図8:モデル生成コードの検証・監査フロー
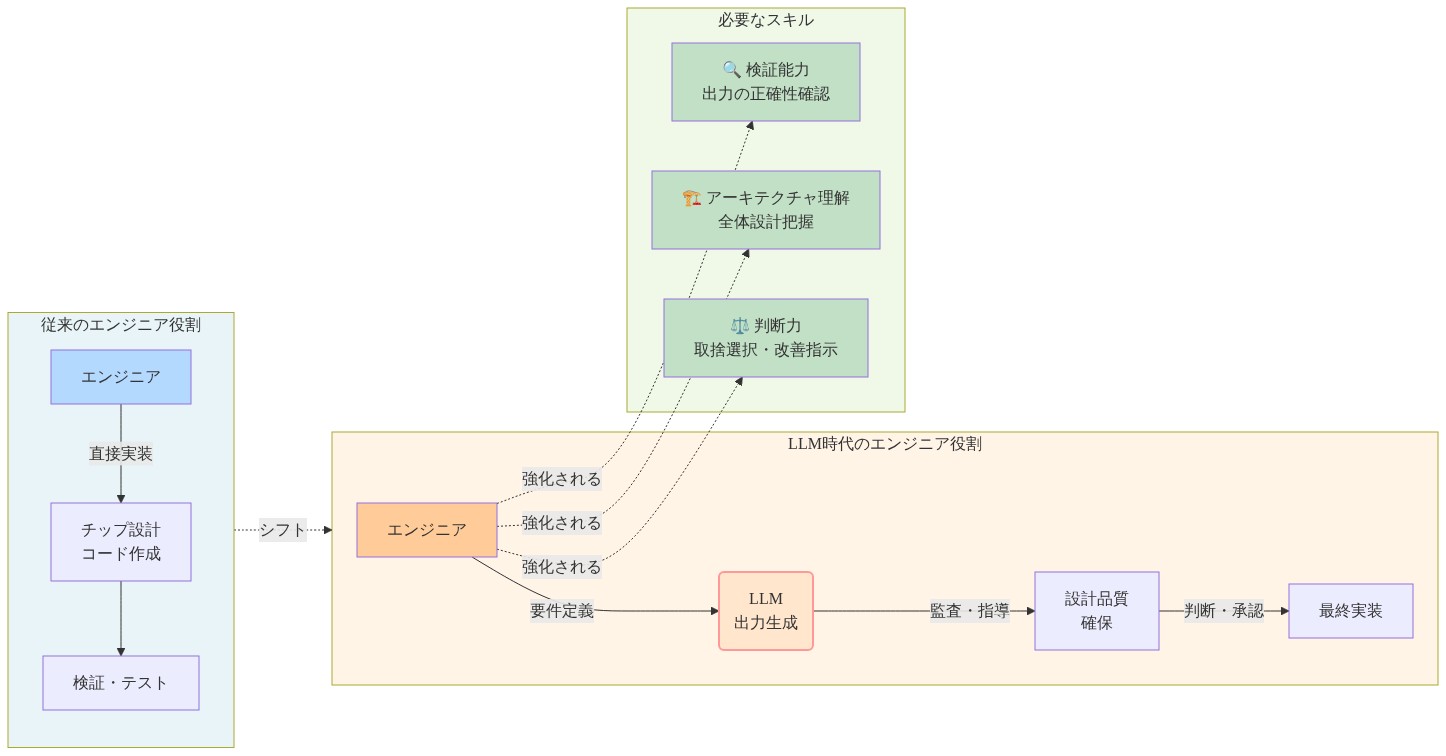
図10:LLM時代のエンジニア役割の進化 - 直接実装から監査・指導へのシフト