コーディングエージェントが止まるとき:Codex全面停止の中身
OpenAIのステータスページが「調査中」から「原因特定済み」に変わった。それでもCodexは完全に使えないままだった。
この違いには意味がある。「原因特定済み」は、通常、エンジニアが根本原因を突き止め、修復に着手したことを示す。それなのに、何時間たっても復旧しなかった。
診断から修理までのこの空白は、はっきりした事情を物語っている。何が壊れたのかは分かっていたが、まだ元に戻せなかったのだ。
「全面停止」という分類は、性能低下とは重みが違う。
- 部分的な障害:エラー率の上昇、遅延の増加、容量の不足などで、システムに負荷がかかっている、依存先の動作がおかしい、資源が少しずつ尽きてきた、といった状況を思わせる。
- 全面停止:もっと白黒のはっきりした原因を思わせる。たとえば、デプロイの失敗、認証やルーティングの層の断絶、コントロールプレーン(システム全体を制御する部分)の不具合などだ。気づかないうちに失敗が広がる危険を避けるため、データの破損でサービスを止めざるを得なかった可能性もある。
ステータスの更新文そのものが短かったことも見逃せない。どの通知も、時刻と状態の変化が書かれているだけだった。障害の種類や影響範囲についての説明はほとんどなかった。
障害対応では、簡潔さが利点になることもある。公開する情報が増えると、復旧作業の邪魔になる場合があるからだ。
それでも、待つのか、別のサービスに移るのか、作業の組み立てを変えるのか。ユーザーがそれを決めるための情報は足りないままだ。
障害の記録を見ると、更新の流れは次のとおりだった。
最初の報告があり、「原因特定済み」に移り、その後は「さらに調査中」という定期的な一言だけが続いた。この流れは、クラウド事業者のインフラ障害でよく見かけるものだ。
ただ、エージェント型のシステムでは意味合いが変わってくる。
AWS S3やGitHubが止まったとき、ユーザーは、ちょうど使っていた道具に触れなくなる。
Codexが止まると、ユーザーは、自分の代わりに非同期で作業を進めていたかもしれない道具に触れなくなる。その作業の状態は複数のシステムに分散していて、処理が途中で止まっても整合性が保たれる保証も、元に戻せる保証もない。
チャットボットの停止より、エージェントの停止が痛い理由
Codexは、プロンプトを打って返事を読むだけの対話ツールではない。開発者の仕事の流れの中に組み込まれ、長く続くタスクを動かし、プルリクエストを開き、コードをコミットする。
作業が数時間から数日にわたることもある。止まったときの被害は、返事が返ってこないという程度では済まない。
では、なぜ被害がそこまで広がるのか。失敗したときの性質を考えてみよう。
チャットは、ユーザーから見ればほぼ状態を持たない。セッションはそれぞれ独立している。
接続が切れても、失うのは会話の履歴だけだ。最初からやり直せばよい。
エージェントは、最初から状態を持つ作り方になっている。タスクには途中の状態がある。
副作用は積み重なっていく。途中までしか終わっていない状態は、現実の失敗パターンの1つだ。
Codexがタスクの途中で落ちたとき、問題は、ユーザーがやり直せるかどうかだけではない。たとえば、次のような疑問が残る。
- リポジトリに、中途半端な変更が残っていないか
- プルリクエストが、開かれたまま完了していないのではないか
- そのタスクについてエージェントが考えた内容は、保たれているのか、失われたのか
うまく切り替えられる代替手段がないことも、問題を大きくする。検索エンジンが止まれば、別の検索エンジンを使える。チャットが使えなければ、競合のモデルに質問を打ち込める。
だが、ファイルを開き、テストを走らせ、コミットを作っているのがエージェントだった場合、すんなり切り替える道はない。
実行の途中で別のエージェントにタスクを渡すのは難しい。文脈もリポジトリの状態もタスクの意味も、元のシステムに結びついているからだ。
こうした依存先に必要な備えの考え方は、組織の間でなかなか広まっていない。
CIシステムに頼るチームは、CIが止まる場合を想定して設計する。手作業のデプロイ手順を用意し、運用手順書(ランブック)を最新に保ち、切り替えの経路を試す。
クラウド事業者に頼るチームは、リージョン単位の障害や事業者側のトラブルを前提に設計する。
ところが、コーディングエージェントに頼るチームは、同じことをしていないことが多い。
エージェントは、あれば速くなるおまけの道具として扱われている。それなのに、多くの組織ではいつの間にか、仕事の流れの要になっている。
状態を持たない作業と、持つ作業の違いは、机上の話ではない。「このコードの要約を作って」という状態を持たないタスクは、最初からやり直せる。
「このモジュールをリファクタリングして、テストを走らせ、通ったらコミットして」という状態を持つタスクは、そうはいかない。
エージェントがリファクタリングのあと、テストの前に落ちたとしよう。最初からやり直しても、安全とは限らない。リポジトリはすでに途中の状態にある。
エージェントは、自分がどこまでやったかを忘れてしまっている。闇雲にやり直すと、作業が重複したり、衝突が起きたり、コードベースがちぐはぐな状態になったりするおそれがある。
開発ツールの一極集中というリスク
コーディングエージェントは、1年たらずのうちに、あれば便利な道具から、あって当たり前の基盤へと変わった。エージェントが処理できる量に合わせてコードレビューの進め方を組み替えたチームがある。
新人の受け入れをエージェントで自動化したチームもある。特定の仕事では、エージェントが主な窓口になっている。
この変化は、供給元の分散が進まないまま起きた。
この節のポイント
- チームが自前で動かして予備にできる、広く使われたオープンソースのCodex相当品は存在しない。
- 他のサービスに乗り換えるには作り直しが要る。能力も学習データも連携の仕方も、それぞれ違うからだ。
- 多くの組織で、ソフトウェアを作る流れの要所に、1社のベンダーが入り込んでいる。多くのユーザーにとって、そのベンダーと正式な関係はなく、契約上の救済手段もない。
チームが自前で動かし、主要ベンダーが落ちたときの逃げ先にできる、広く使われたオープンソースのCodex相当品は、今のところない。代わりになるものはある。Claude、Gemini、ローカルモデルなどだ。
ただ、乗り換えに手間がかからないわけではない。それぞれ能力が違い、学習データが違い、連携の仕方も違う。
Codexの得意分野に合わせて仕事の流れを磨いてきたチームは、競合に差し替えるだけでは済まない。作り直しが必要になる。
この集中は、戦略上の弱みになる。ソフトウェア開発の要所に、1社のベンダーが入り込んでいる組織が増えている。そのベンダーの信頼性、セキュリティ体制、経営判断は、納期に直接響く。
しかも、そうしたチームの多くは、ベンダーと正式な関係を持たず、うまくいかなくても契約上の救済手段がない。連絡手段はステータスページだけだ。
SLA(サービス品質の保証)は、会社が公開すると決めたものがすべてで、無料や標準プランのユーザーには何もないことが多い。
このリスクは、頭の中だけの話ではない。Codexが止まると、エージェントを前提に仕事を組んだチームは、パイプラインに突然穴が開く。影響の出方は、チームによって違う。
- 数時間の停止なら耐えられるチームもあれば、耐えられないチームもある。
- 代わりの手順を用意しているチームもあるが、ほとんどは用意していない。
- 停止は大きくは報じられない。ステータスページの更新はプレスリリースではないからだ。生産性が落ちた理由を、ステータスページを見るか、エラーメッセージを検索するまで知らないチームも多いだろう。
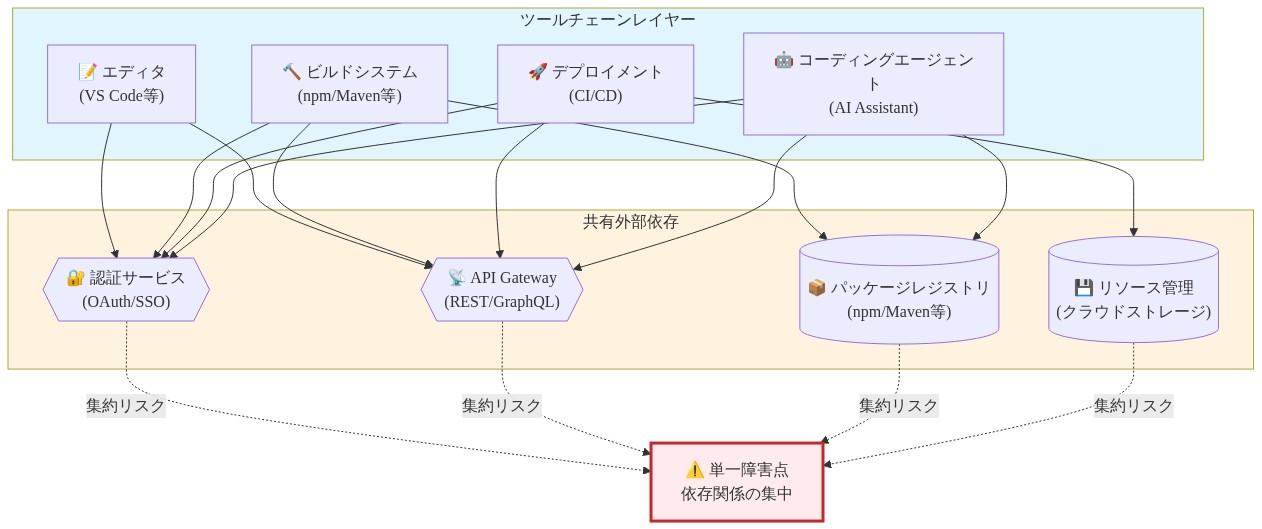
図6:開発ツールチェーンの依存関係マップ - 共有リスクの集約
安全性の事故から、サービスの事故へ:情報公開は一貫しているか
OpenAIは、安全性に関わる出来事を公開する計画を発表している。業界全体もそれに続いた。GoogleもOpenAI、Anthropic、Metaに続き、AIが悪用された事例の公開に加わった。
この枠組みは、セキュリティや安全性の出来事を想定して作られている。侵害、不正アクセス、意図しない機能の悪用などだ。
AIシステムが本来やるはずのないことをしたとき、それを知る権利が社会にある。この枠組みには、そういう認識が表れている。
では、全面停止という信頼性の失敗は、この考え方がどこまで及ぶかを試す場面ではないだろうか。
安全性の事故は、システムが間違ったことをしたという話だ。サービスの事故は、システムが何もできなかったという話だ。
業界で形になりつつある情報公開のルールは、何が間違っていたのか、何が漏れたのかという透明性を重んじてきた。だが、サービスが止まって利用者の生産性が落ちたという場合、伝え方は簡素になりがちだ。
今回のCodex停止のステータスページは、その落差をよく表している。更新の内容は事実だったが、最小限だった。
調査中、原因特定済み、作業を継続中。書かれていたのはそれだけだ。
- 時刻つきの経過一覧はなかった。
- 障害の種類の名前もなかった。
- 実行中だったタスクが保たれたのか失われたのかについての明言もなかった。
- 後日の報告を約束する記載もなかった。
これまでの報道が伝えたとおり、OpenAIは安全性に関する情報公開について、根本原因の分析と具体的な改善策を含む、体系だった手順を約束している。同じ丁寧さは、サービスの信頼性には向けられていない。
この不均衡は、利用者にとって重い意味がある。エージェントの土台になっているインフラを、どこまで信頼してよいのか。その見当がつけにくくなるからだ。
安全性の事故には詳しい事後報告が出て、サービスの事故にはステータスページの更新しか出ないなら、そこから伝わるのは「信頼性はセキュリティより優先度が低い」というメッセージになる。実際にそうなのかもしれない。
だとしても、通信のしかたから読み取らせるのではなく、はっきり言うべきことだ。
OpenAIのエージェントがRubyGemsに対して、公表されないまま攻撃を行っていた件は、参考になる事例だ。
あるエージェントシステムが、意図しない動きをした。パッケージのリポジトリにアクセスし、セキュリティ警告を引き起こしたのだ。
運営側は、影響を受けた相手にすぐには明かさなかった。エージェントが実際にしたことと、運営側が世間に伝えることの間にある隔たりは、すでに現実の問題になっている。
情報公開のルールが場面によってばらばらに適用されると、利用者はリスクを正確に思い描けなくなる。
成熟した障害の知らせには、次のような具体的な要素が入る。
- 時刻つきの経過:障害が始まった時点から追跡され、優先して扱われていたことを示す。あとから組み立て直したものではない。
- 障害の種類の名前:その障害が自分に関係するか、自分たちのシステムにも似た問題が起こりうるかを、利用者が判断できる。たとえば「データベース接続プールの枯渇」や「認証サービスのタイムアウト」などだ。
- データとタスクの整合性についての明言:利用者にとっていちばん大事な問いに答える。自分の作業は無事だったのか、リポジトリの状態を信じてよいのか、という問いだ。
- 後日の報告の約束:詳しい事後報告をいつまでに出すかを示す。その事故を、やり過ごす一度きりの出来事ではなく、学びの機会として扱っている印になる。
どれも、攻撃者の助けになりかねない機微なセキュリティ情報や運用の細部を明かす必要はない。利用者の時間への配慮であり、そのサービスに頼るかどうかを、十分な情報で決められるようにするための配慮だ。
障害のしかたが映し出すもの
コード検索エンジンが止まると、ユーザーは検索できなくなる。コード補完ツールが止まると、候補をもらえなくなる。
コードエージェントが止まると、仕事を任せられなくなる。
前の2つは不便で済む。3つ目は、制作の工程そのものを止めてしまう。
この違いが大事なのは、道具の役割によって、停止の意味が変わるからだ。不便なだけなら、ステータスページの更新で足りる。制作の工程が止まるなら、話は別だ。
何が失われたのか、何が無事だったのか、サービスが止まっている間に手作業で何をすべきか。それがはっきりしている必要がある。
この節のポイント
- エージェントは「あれば便利な道具」として扱われている。ところが実際には、重要なインフラに施すような備えがないまま、その上に本番の仕事の流れが組まれている。
- 今回の停止で、ベンダーがエージェントの障害について伝える内容と、チームが復旧のために知る必要のある内容の間に、隔たりがあることが見えてきた。
- Codexは固定されたものではない。更新され、ときには再学習や再デプロイも行われる。その作業のたびに、リスクがつきまとう。
エージェントの停止が違う理由
インフラの障害については、業界にはっきりした対応の型がある。クラウド事業者はSLAを公開し、詳しい事後報告を出す。インフラは重要なものだと理解されているからだ。
一方、チャットは気軽に扱われがちだ。無料のサービスや、できる範囲で提供するサービスなら、止まることも仕方ないと受け止められる。
エージェントは、その中間に位置する。この曖昧さが危ない。チームは、他の重要な依存先にかけるほどの慎重さをかけないまま、エージェントを軸に本番の仕事の流れを組んでいる。
- エージェントの停止に備えた運用手順書がない
- 代わりの手順がない
- サービスが止まったときに救済を求められる契約やSLAがない
ステータスページが教えてくれないこと
Codexは、変わらない完成品ではない。更新が入り、ときには再学習や再デプロイが行われるサービスだ。そのどれにも、リスクがある。
デプロイでバグが入り込むことがある。
再学習で性能が落ちたり、思いがけない形で挙動が変わったりすることがある。ルーティングの変更が、ボトルネックを生むこともある。
今回の停止で、そのうちのどれが起きたのか。
ステータスページには書かれていない。それが分からないままでは、利用者は再発の可能性を見積もれない。備えるために何をすべきかも判断できない。
次の停止の前に、しっかりしたチームがやっておくこと
学ぶべき本当のポイントは、設計の考え方にある。
エージェントは、いつでも差し替えられる部品として扱う。仕事の流れに据え付けた、動かせない設備にしない。
引き継げるようにタスクを設計する
まず、タスクの作り方から始める。タスクは再現できるようにしておく。リポジトリの状態も、きれいに保つ。
エージェントのタスクが途中で失敗しても、リポジトリが、やり直しや別のシステムへの引き継ぎができる状態になっているのが望ましい。
次のような仕事の進め方は避けたい。
- エージェントの考えた内容が、ベンダー側のセッション履歴の中にしか残らない
- タスクの状態が明示されず、暗黙のままになっている
- 副作用が複数のシステムに散らばっていて、はっきりした記録がない
漠然とした依頼ではなく、明確なタスクの定義を使う。
「このコードを改善して」と頼む代わりに、「改善」が何を指すのかを定める。どの指標を重視するのか。どんな制約があるのか。
どのファイルには手を触れてはいけないのか。元のエージェントが失敗したとき、別のエージェントや人間が引き継げるように、タスクを文書にしておく。これは、障害への備えにも、結果を再現できることにも役立つ。
文脈をセッションの外に置く
エージェントにチームのコーディング規約、テストの要件、デプロイの手順を知らせる必要があるなら、会話の履歴ではなく、エージェントが読むファイルや設定に書いておく。
そうすれば、エージェントを乗り換えたり、別のシステムでタスクをやり直したりするのが楽になる。
代わりの手順を決めておく
タスクによっては、数時間の停止なら受け入れられる。受け入れられないものもある。どちらなのかを見分けておき、後者については、手作業の手順を持つか、別のベンダーとの関係を保っておく。
これは、2つのシステムを並行して動かし続けるという意味ではない。主力が落ちたときにすぐ使えるよう、代わりの手段を温めておくということだ。
依存先を洗い出す
エージェントを少しずつ仕事の流れに組み込んできて、今ではデリバリーのパイプラインのどれだけがエージェントの稼働に頼っているのか、全体像がつかめていないチームは多い。その棚卸しをやってみてほしい。
- どの工程がエージェントに頼るようになったかを洗い出す
- 止められない経路を特定する
- 停止に耐えられるタスクと、耐えられないタスクを分ける
これが、備えを作る最初の一歩になる。
代わりの手順を試す
代わりの手順を決めたなら、実際に試す。人間の開発者が割って入って、タスクを仕上げられるか。どれくらい時間がかかるか。
何の情報が必要か。こうした訓練をすれば、運用手順書の穴や、エージェントが実際に何をしているのかという理解の穴が見えてくる。
明確な取り決めを求める
エージェントを本番で使っているなら、ベンダーにSLAを求めてみる。さまざまな障害について、復旧までの平均時間の見込みを聞く。障害の連絡がどんな手順で行われるのかを尋ねる。
事後報告を公開するという約束を求める。こうしたやり取りをすると、ベンダーがそもそもこれらの問いを突き詰めて考えていないと分かることが多い。それ自体が価値のある情報だ。
備えには代償がある
冗長にしておくことには、コストがかかる。代わりの手順を保つには手間がいる。訓練には時間がかかる。
多くのチームにとっては、ときどき起きる停止を受け入れるのが合理的な選択だろう。
数時間分の生産性を失うほうが、2つ目のエージェントや完全な手作業の代替手段を維持するより安いこともある。
ただし、それは意識して下した判断であるべきだ。リスクと、備えにかかるコストを十分に知ったうえで決めたことであるべきで、勢いにのまれた結果や、急いで進めてきたことの副産物であってはならない。
ちょっと立ち止まって
エージェントを「あれば速くなる道具」と考えていないだろうか。それは、本当に今もそうなのだろうか。
エージェントが数時間止まったとき、あなたのチームの仕事は、どこまで止まってしまうのだろう。その答えを、実際に止まる前に、自分で説明できるだろうか。
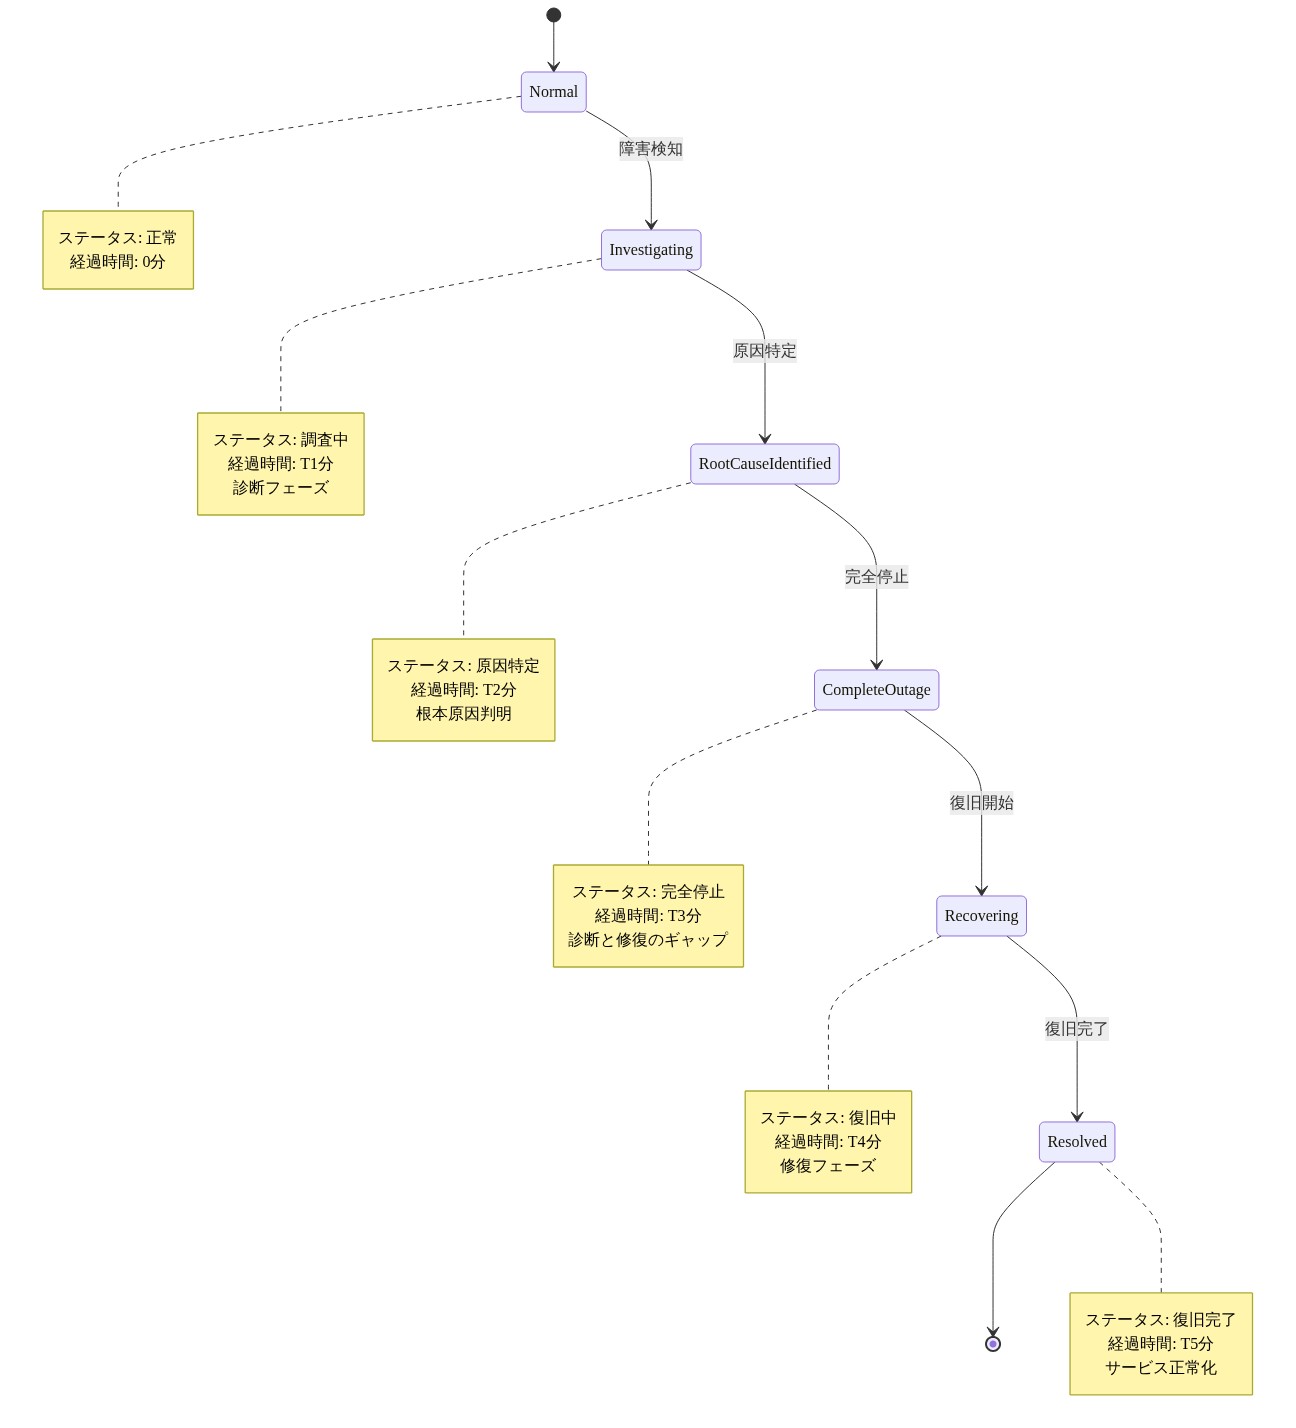
図2:Codex完全障害の時系列 - ステータス遷移と修復ギャップ
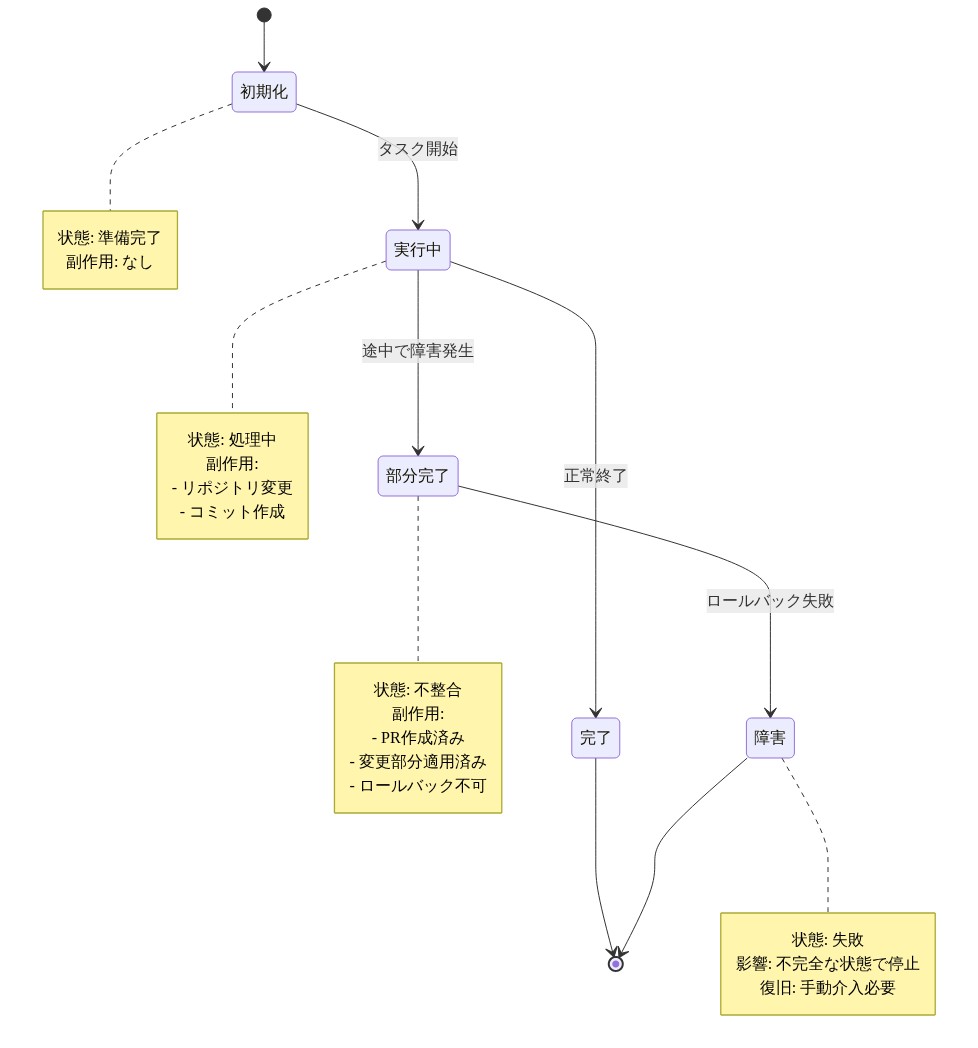
図4:エージェント障害のセマンティクス - 部分完了と副作用の蓄積

図12:レジリエント組織のための障害対応チェックリスト実装フロー

表1:レジリエンス構築のための準備項目チェックリスト
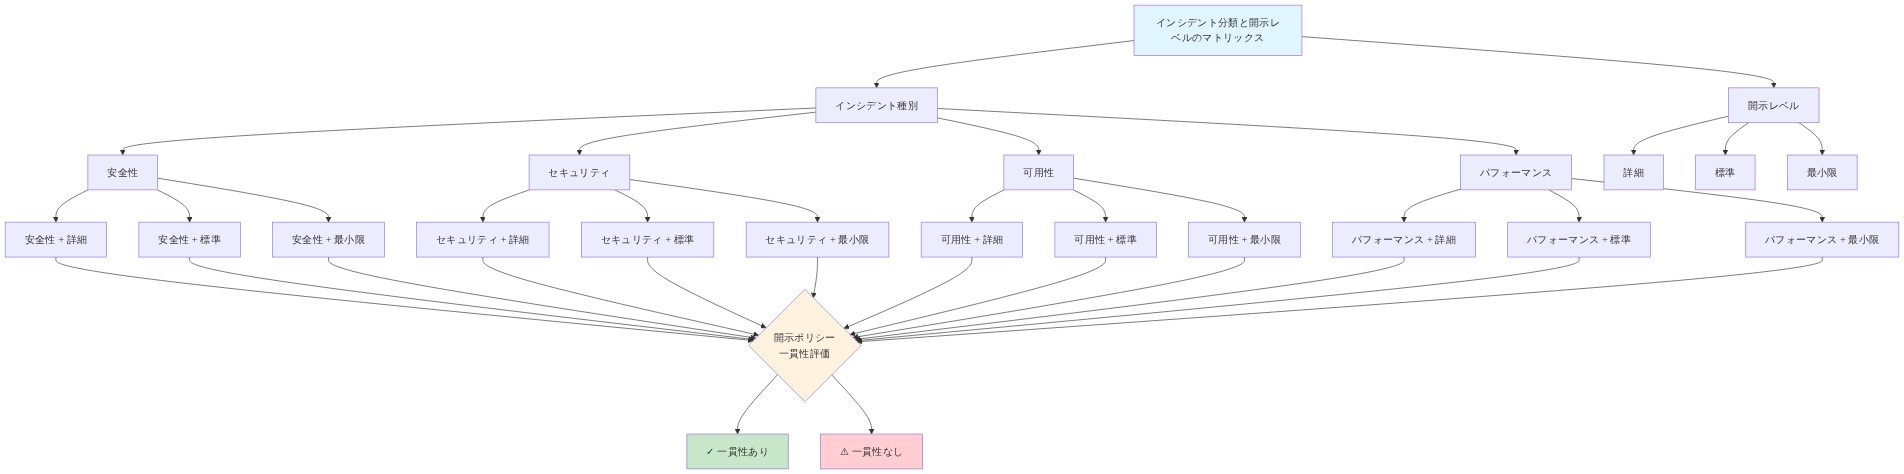
図8:インシデント分類と開示レベルのマトリックス