インターネットの歴史の大半で、サイトを訪れる相手は2種類に分かれていた。人間は閲覧し、ボットは巡回し、データを抜き取り、スパムを送った。
インフラも、事業モデルも、法的な決まりごとも、この区別を前提に育ってきた。
AIエージェントは、この区別をかき乱す。
エージェントは、人の代わりに動く。その人の認証情報と意図を持ち歩くのだ。
しかし動きはマシンの速さで、疲れずに続く。ユーザーがうしろにいるのでクローラーとは言えない。人よりも速く、休まずに動くので、人とも言えない。
この曖昧さは、思った以上に重い。サイトはエージェントを歓迎するか、ブロックするかの二択では済まなくなった。
ウェブをエージェントに親切にする変更は、そのたびにコストや動機、設計の優先順位を動かす。普通のユーザーにとって、その動きは歓迎できるものではないかもしれない。
この記事のポイント
- AIエージェントは新しい種類のトラフィックだ。人の行動を、マシンの規模で代行する。
- 「ボットか人間か」という二分法では、サイトを訪れる相手を言い表せなくなった。
- この二分法を前提に作られたインフラ、価格、アクセスのルールは、見直しを迫られている。
- 多くの変更は、どちらか一方の利用者に有利に働く。お金を払う側が勝ちやすい。
古い区分が通用しなくなった理由
従来の区分が役に立ったのは、単純だったからだ。人間の訪問者は、ページを読み、広告を目にし、リンクをたどり、ときどき買い物をする。
ボットはデータが欲しいだけで、何も返さない。そう考えられていた。
検索エンジンのクローラーは数少ない例外だった。コンテンツを持っていく代わりに訪問者を連れてくるので、サイトは受け入れていた。
それぞれの前提が、さまざまな仕組みを支えていた。
- 広告:人の目に触れる注目に値段をつける。
- アクセス解析:人間のセッションを数え、ボットを除く。
- セキュリティ対策:人間らしくない動きを脅威として扱う。
- アクセス規則:robots.txtのように、クローラーが入ってよい場所を伝える。
- 法的な決まりごと:人がページを読むことと、プログラムが複製することを分けて考える。
AIエージェントは、このどれにもきれいに収まらない。たとえば、航空券の価格比較や、レストランの予約、最近のニュースの要約をエージェントに頼んだとしよう。
エージェントは多くのページを訪れ、フォームに入力し、細かい注意書きを読む。頼んだ本人は、そのページのほとんどを目にしない。
エージェントはボットのように動く。ただし、人の権限と目的を背負っている。
これは技術の問題にとどまらず、仕組みそのものに関わる緊張を生む。
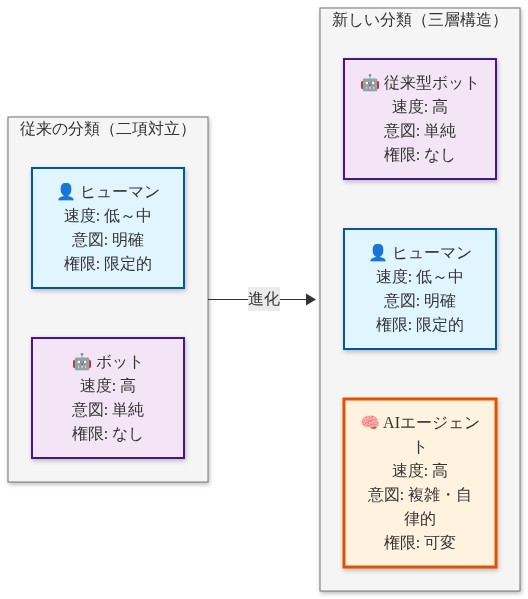
図2:ウェブトラフィック分類の進化:従来の二項対立からAIエージェント時代へ
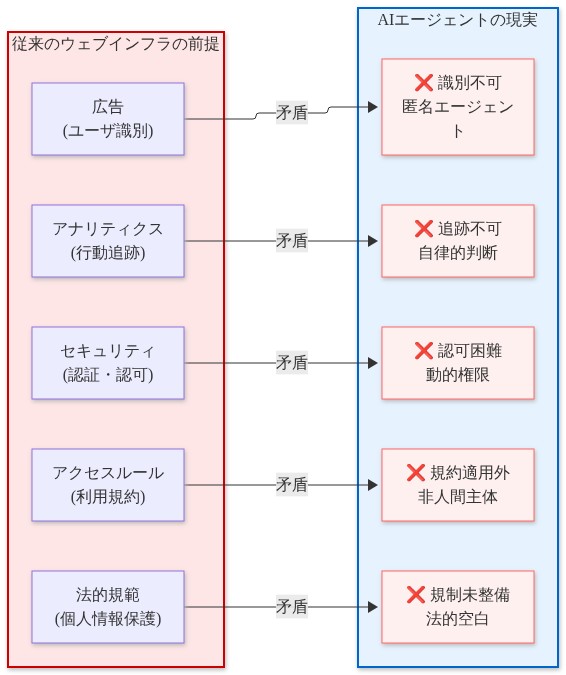
図3:従来のウェブインフラとAIエージェントの矛盾点マッピング
2種類の読み手に同時に応えるコスト
エージェント向けに最適化するサイトは、速さ、コスト、正確さのどれを優先するかを決めなければならない。
人間向けのサイトは、見つけやすさ、文脈、見た目のデザインを大切にする。この2つの目標は、一部しか重ならない。
整ったデータフィードは、エージェントにはありがたい。人間の読者には、そこに留まる理由をほとんど与えない。
人向けと機械向けの2つの版を持ち、両方に応えようとするサイトもあるだろう。
しかし過去を見ると、並行して持つ版が同じ水準を保つことはまれだ。投資や機能開発は、収益や戦略上の価値をもたらす側へ、少しずつ寄っていく。
エージェントのトラフィックのほうが価値の高い窓口になれば、人間向けのウェブは手入れされない面になるおそれがある。
そうなるとは限らない。エージェントのトラフィックが実際に人間より多くの収益を生むか、サイトが両方を維持できるかによって変わる。ただ、動機は確かにその方向を向いている。
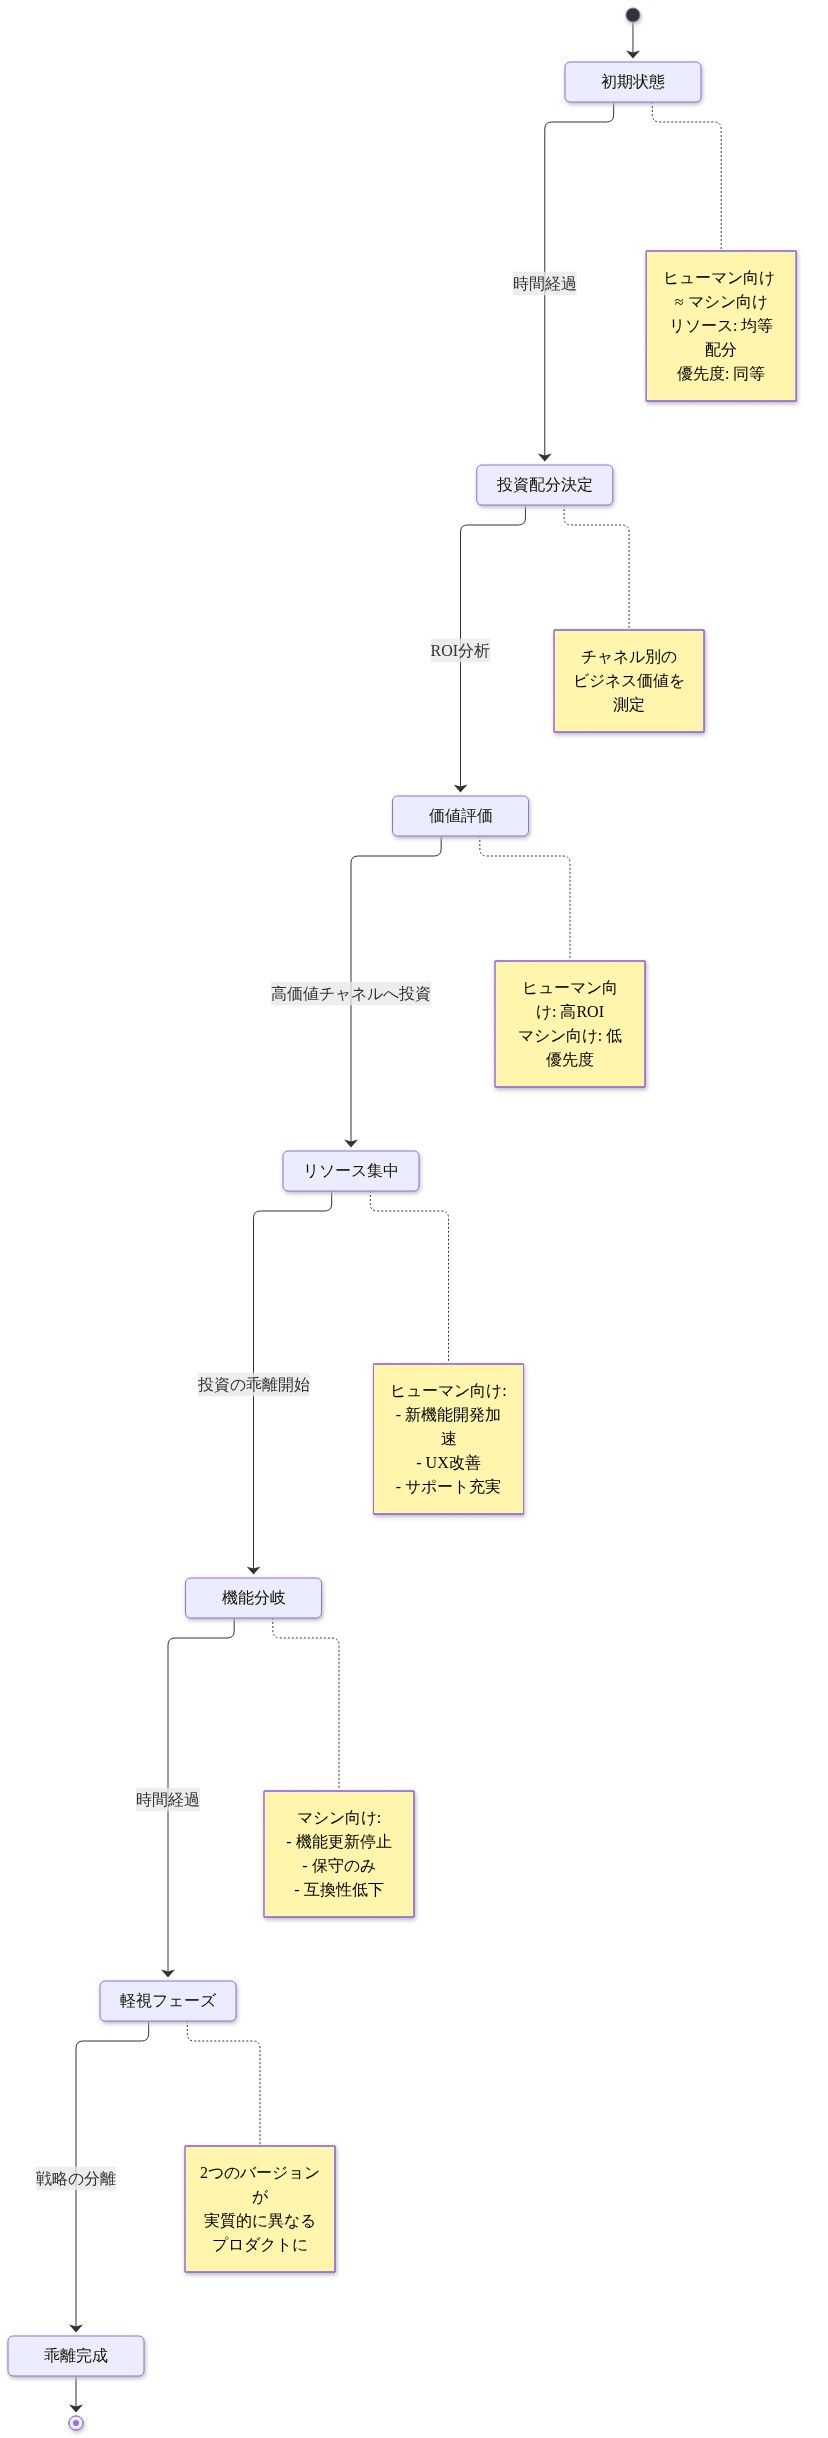
図5:並行バージョン戦略における投資の乖離プロセス
機械の読み手に合わせて作り直す
企業や標準化団体は、エージェント向けの層を提案している。主な案は次のとおりだ。
- 構造化されたエンドポイント:整形されたページではなく、データを返す窓口。
- 機械が読める説明:サイトが何を提供し、どう使うかを記したもの。
- 簡略化したページ:レイアウト、ポップアップ、広告を取り除いた版。
- 専用のプロトコル:エージェントを認証し、できることを明示する取り決め。
理屈は分かりやすい。人の目に合わせて作られたページは、1つの事実だけが欲しいモデルにとって無駄が多い。
モデルは、ナビゲーションメニュー、Cookieのバナー、広告、スクリプトをかき分けなければならない。要素が増えるたびに計算コストが上がり、間違いの入り込む余地も増える。
ただし、この移行は中立ではない。方法ごとに、公開する側のコストとリスクは異なる。次の表は、3つの方法を比べたものだ。
| 方法 | 公開側のコスト | 不正確になるリスク | 主な動機 |
|---|---|---|---|
| エージェント向けの構造化API | 初期費用は高く、1回あたりは低い | 低い | エージェントのトラフィックからの収益 |
| 簡略化したHTML版 | 中程度 | 中程度 | サーバー負荷の軽減 |
| 人間向けとエージェント向けの二重管理 | 高く、継続的にかかる | 高い。版がずれていく | より多く払う側に応える |
二重管理は、最も危うい選択肢だ。同じ内容の2つの版を、そろえておかなければならない。価格、在庫、条件、訂正が一致している必要がある。
食い違えば、エージェントと人間は別々の事実を見る。どちらが正しいのかは、簡単には分からない。
機械が読める版へ投資が流れると、人間向けの版は伸び悩みやすい。 似た例は、パソコンからスマートフォンへの移行に見られる。
多くのサイトがモバイル向けのレイアウトに力を入れ、古いパソコン向けの体験は古びるままになった。
この比較には限界がある。モバイルのユーザーも人間であり、その訪問は広告や売上につながったからだ。エージェントのトラフィックには、人間向けの版を最新に保つ理由が弱い可能性がある。
そうなれば、人間のウェブは過去の遺物になるかもしれない。生き残ってはいても、ほとんど手が入らない場所だ。
もう1つ、気づきにくいコストがある。人のために作られたページには、文脈がある。
関連リンク、筆者のメモ、見た目の階層、思いがけないものに出会える余地だ。データのエンドポイントには、そのどれもない。
ウェブの労力がエンドポイントに注がれるほど、ページを読む価値を支えるものへの労力は減っていく。
エージェントのトラフィックは誰が払うのか
エージェントは、節約しながら閲覧したりはしない。1つの作業で、数十回のページ読み込みや再試行、長い文脈の処理が起こりうる。そのたびにトークンが使われ、誰かが料金を負担しなければならない。
コストは多くの当事者に分かれ、それぞれ利害が違う。次の表は、誰が何を負担し、何を望むかをまとめたものだ。
| 当事者 | 負担するもの | 望むもの |
|---|---|---|
| 公開側(パブリッシャー) | エージェントの訪問によるサーバー負荷と帯域 | 対価、または無償の負荷を減らすこと |
| エージェントの開発者 | 作業ごとのトークンと計算のコスト | 解析しやすく安いコンテンツ |
| プラットフォーム | 両側からの圧力 | アクセスと価格の主導権 |
| 人間のユーザー | 使いにくくなることによる間接的なコスト | 無料で開かれた、使いやすいページ |
公開側にとって、計算は厳しい。エージェントはサーバーに負荷をかけるのに、広告の表示はたいてい生まれない。
ニュース記事を訪れた人間の読者なら、広告を見たり、購読したり、後でまた訪れたりするかもしれない。
同じ記事を要約のために取り込むエージェントは、そのどれもしないことが多い。公開側はページの配信費用を払い、見返りはほとんどない。
エージェントの開発者は、逆の圧力に直面する。処理が安く済むコンテンツが欲しい。余計な要素があるたびにコストが上がるので、すっきりした形式と摩擦の少ないアクセスを求める。
プラットフォームは、その中間に立つ。ありそうな対応は、よくあるパターンをたどる。
- ペイウォール:エージェントによるものを含め、アクセスに課金する。
- レート制限:エージェントがページを要求できる頻度に上限を設ける。
- 段階制のアクセス:有料の顧客に、より速く豊かなデータを提供する。
こうした状況では、機械によるアクセスに値段がつき、制限されるモデルへウェブが傾くかもしれない。普通の人間のアクセスは、価値の低いトラフィックとして扱われかねない。
誰かが示し合わせる必要はない。動機に従えば、そうなる。多く払った側が優先されるのだ。
どこまで進むかは、まだ見えない要因次第だ。エージェントのトラフィックがどれだけ増えるか。開発者がアクセスに対価を払うことに同意するか。
人間の読者がサイトを直接訪れ続けるか。人間の訪問が堅調なら、公開側には人間向けのウェブを健全に保つ理由がある。減れば、その理由は弱まる。
図8:ビジネスモデル別のコスト負担構造の比較
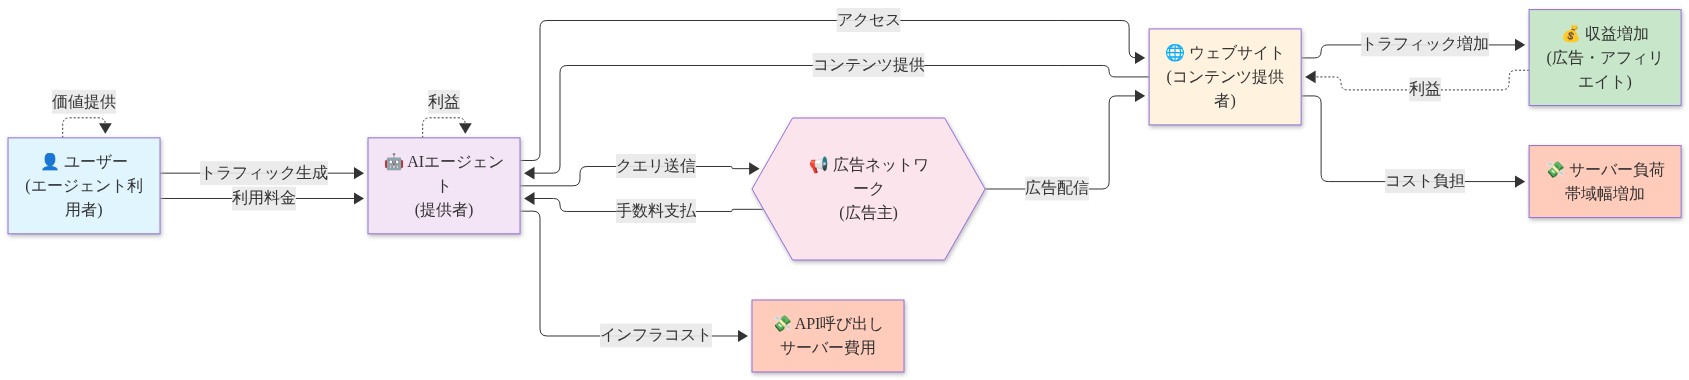
図7:エージェントトラフィックの経済構造と利益配分
人間のユーザーが割を食う道すじ
最も直接的なリスクは、守りの動きから来る。
望まない自動化を防ぎたいサイトは、CAPTCHA、本人確認、行動の審査といった障害物を増やす。こうした仕組みは、本物の人間も止めてしまう。
支援技術を使っている人は、行動パターンから不審だと判定されるかもしれない。共有のネットワークにいる人は、何度も確認を求められるかもしれない。匿名で閲覧したい人は、ログインを迫られるかもしれない。
一つひとつの障害は小さい。重なると、ウェブは遅く、居心地の悪い場所になる。
エージェントを呼び込むサイトは、別の問題を生む。ページを必要最小限まで削り、視覚的な文脈や、思いがけない発見の余地を取り去るかもしれない。
そこを訪れた人間が受け取るのは、記事というより、データシートに近いものだ。
この節のポイント
- エージェントへの防御は、副作用として正当なユーザーも締め出す。
- エージェント向けに最適化したページは、人間が頼りにする視覚デザインや偶然の発見を失う。
- エージェントが情報への主な入り口になれば、独立した情報源への資金が枯れる。
トラフィックと資金の連鎖
時間がたってから表に出てくるリスクもある。エージェントが人々の情報への主な入り口になれば、開かれた、リンクでたどれる、閲覧できるウェブは、自らを支えるトラフィックを失う。
起こりうる連鎖は、次のようになる。
- 人々は、サイトを直接訪れる代わりにエージェントに尋ねる。
- サイトは、訪問、広告収入、購読を失う。
- 小さな独立した情報源は、費用をまかなえなくなる。
- 情報源が減り、残ったところは機械による要約を意識して書くようになる。
- 要約は明快で抜き出しやすい主張を好むので、ニュアンスが平板になる。
どの段階も、起こりうることではあるが、確実ではない。この連鎖が成り立つのは、エージェントの利用が直接の訪問を大きく減らすほど広がった場合だけだ。
そうなれば、ウェブは探索する場所というより、情報を取り出すデータベースに近づく。
身元と信頼の問題
エージェントは、身元についても難しい問いを突きつける。人の代わりに動くエージェントは、誰の代理なのかを証明する必要がある。
証明できなければ、サイトは正当なアシスタントと、アシスタントを名乗るスクレイパーを見分けられない。
提案されている解決策は、いくつかの形に分かれる。次の表は、その仕組みと主な懸念を並べたものだ。
| 方法 | 仕組み | 主な懸念 |
|---|---|---|
| 署名つきのエージェントID | 運用者に結びついた暗号署名をエージェントが持つ | 署名鍵を誰が握るか |
| プラットフォームが発行するトークン | 大手プラットフォームがエージェントを保証する | そのプラットフォームに力が集中する |
| 人間であることを確認した資格情報 | エージェントの背後にいる人が身元を証明する | 閲覧が、継続する身元に結びつく |
どの方法でも、資格情報を発行する側に力が集まる。プライバシーの問題も生じる。
すべてのエージェントが確認済みの人物に結びつく必要があるなら、その人の閲覧は、開かれたウェブが求めなかった形でたどれるようになる。
核心にあるのは、説明責任と匿名性のトレードオフだ。エージェントが正当だと確かめる人は必要だ。
ところが、確認の仕組みはそのまま関所になる。資格情報を発行するプラットフォームは、エージェントが何にどんな条件でアクセスできるかを左右する力を得る。
時間がたてば、その力は、エージェントがどのサービスを選び、どのサービスを無視するかにまで影響しうる。
政策の空白と、両方の読み手に向けた設計
AIの監督に関する今の業界の提案は、モデルの能力と安全性の基準に集中している。エージェントが公開ウェブと出会うインフラの層については、ほとんど触れていない。1
その空白に、いくつもの論点が落ちている。
- アクセスの権利:エージェントがどこを訪れてよいか、どんなルールに従うか。
- 負荷のコスト:自動化されたトラフィックがサーバーに負担をかけたとき、誰が払うか。
- 同意:サイトやユーザーが、自動化された操作に同意しているか。
- 人間向けサービスの保護:サイトが適応していくなかで、人が信頼できるアクセスを保てるか。
モデルが安全だと認証する枠組みは、これらの論点に答えない。人間のユーザーが知らないうちに機械のトラフィックを肩代わりする、というウェブ全体の変化も止められない。
安全なモデルであっても、誰かが負担するコストを生むことはある。
共有のウェブを守る政策に必要なもの
共有のウェブを真剣に考える政策には、いくつかの要素が要る。
- 透明性:どれだけのトラフィックがエージェントから来ていて、誰の代理なのか。
- 公平なコスト分担:自動化による大量の利用で、公開側だけが負荷を抱えないようにする。
- 人間のアクセスを守られた初期設定にする:サイトが機械向けに最適化するなかで、人が下の階層に滑り落ちないようにする。
どれも、エージェントを遅くすることは求めていない。求めているのは、そのコストを正直に数えることだ。
両方の読み手に応える設計
結果は、決まっているわけではない。設計の選び方しだいで、両方の読み手に応えることはできる。 1つの正しい情報源を最新に保ち、人にも機械にも向けて表示すれば、版が別々になることで起こるずれは避けられる。
コストの分担を取り決めれば、エージェントのトラフィックも自分の分を払える。アクセスの規則を整えれば、悪用への防御が普通の読者を罰することも避けられる。
どんな変更案にも、使える問いがある。それは、人にとってウェブを良くするのか、それとも機械にとって安くなるだけなのか、という問いだ。
実際にできること
ウェブを作り、公開し、頼りにしている読者のために、できることを挙げる。
- 正しい情報源を1つに保つ。 コンテンツを公開しているなら、人間向けと機械向けの版を同じデータから作り、事実がずれないようにする。
- エージェントのトラフィックを別に測る。 エージェントからどれだけの負荷が来て、何が返ってくるかを記録し、価格やアクセスの判断を実際の数字に基づかせる。
- 防御策が巻き添えを出していないか点検する。 CAPTCHAや審査の仕組みが、とくに支援技術を使う人など、本物の人間を止めていないか確かめる。
- 資格情報を誰が発行するか尋ねる。 エージェントの身元確認の仕組みを採用する前に、誰がそれを握り、ユーザーのどんなデータに結びつくのかを調べる。
- 大事なときは情報源を直接訪れる。 調べ物にエージェントを使うときも、特に重要な元の情報源には自分でアクセスする。直接の訪問は、その情報源が続いていく助けになる。
ちょっと立ち止まって
最後に、探していなかったものをネットで見つけたのはいつだったか、思い出してみてほしい。
ページの下にあったリンク先の記事かもしれない。フォーラムのスレッドかもしれないし、1人で運営している小さなサイトかもしれない。
エージェントなら、おそらく素通りしていただろう。それは、問いへの答えではなかったからだ。
エージェントが必要とするウェブは、効率のよいウェブだ。人が必要とするウェブは、ときにさまよえるウェブだ。
両方が存在することはできる。ただ、後者の居場所を残すには、ウェブを作り、支え、使う人たちの意図的な選択が要る。
その選択がなされていると信じるために、あなたはどんな材料が見えてほしいだろうか。
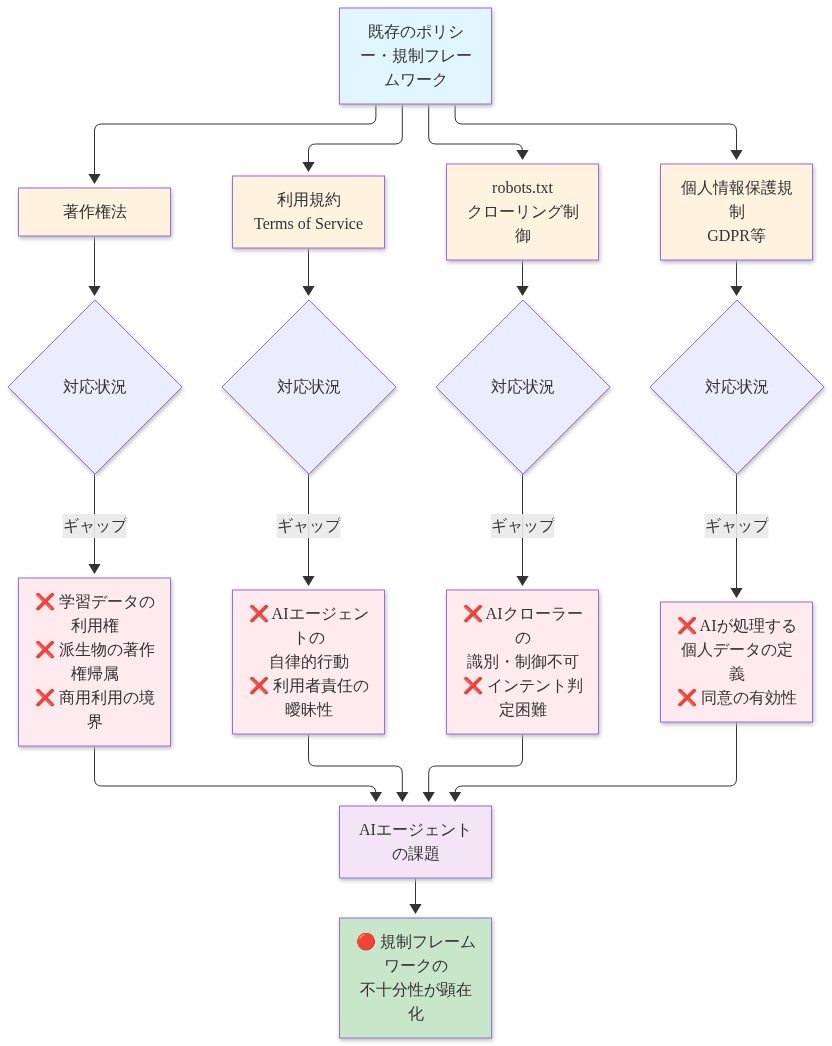
図11:既存ポリシーフレームワークのギャップ分析