OKF Agent Memory – Git ネイティブな永続的メモリを備えた AI コーディングエージェント
AI コーディングエージェントにおけるメモリの問題
AI コーディングエージェントは根本的なアーキテクチャ上の制約下で動作しています。異なる呼び出しやセッション間で永続的なメモリメカニズムを欠いているのです。これは、コードベース、アーキテクチャ上の決定、実装の根拠、プロジェクト履歴に関する文脈的知識を長期間にわたって蓄積・保持する人間の開発者とは大きく異なります。
エージェントの各呼び出しは、先行する相互作用へのアクセスなしに開始されます。その結果、以前に検査したコードの冗長な分析、セッション間での矛盾したアーキテクチャ上の決定、過去の相互作用から得られた学習の組み込み不可能性が生じます。この制限は、タスクの複雑性が増すにつれて深刻になります。特に、複数の相互依存ファイル間のリファクタリング、確立されたコーディング標準との一貫性の維持、依存関係を伴う複数ステップの変更の調整など、継続的な文脈を必要とする作業において顕著です。
-
現在の技術的アプローチは測定可能な制限を示しています。*
-
プロンプトベースの文脈埋め込み: コードベースの文脈をプロンプトに直接エンコードすると、ハードなトークン制限に直面します。大規模なコードベース(100K 行以上)は 2~3 回の相互作用内で実用的な文脈ウィンドウを超過し、文脈の切り詰めや省略を強制します。
-
ベクトルデータベース: 意味的類似性検索に有効ですが、ベクトルストアは構造的関係(例:「モジュール A はモジュール B に依存している」)と時間的シーケンス(例:「このアプローチは以前失敗した理由は…」)に苦戦します。意味的埋め込みは明示的に失敗するのではなく段階的に劣化するため、無関係なメモリの無言の検索というリスクが生じます。
-
セッション状態メカニズム: メモリ内セッション状態はエージェント終了時に消失し、再起動や分散呼び出し間での永続性を提供しません。
実際の結果は次のとおりです。エージェントは、自分が分析したものを確実に追跡できず、却下されたアプローチについての推論を保持できず、以前の作業に段階的に構築することができません。プロフェッショナルなソフトウェア開発の特徴である継続的で文脈認識のある作業ではなく、狭く孤立したタスクに限定されたままです。
- 具体的なシナリオ*: エージェントがマイクロサービスシステムのサービス A における並行処理バグを診断して解決します。6 週間後、同じバグパターンがサービス B に現れます。永続的なメモリがなければ、エージェントは診断プロセス全体を繰り返します。ログを検査し、仮説をテストし、修正を検証します。メモリがあれば、エージェントは以前の診断を取得し、パターンマッチを認識し、学習した解決策を適用し、タスクを短時間で完了します。これらの結果間の違いは、永続的なメモリの価値を直接反映しています。
この制限は、本番環境におけるエージェントの有用性を直接制約します。開発ワークフロー用にエージェントをデプロイしている組織は、精巧なプロンプトエンジニアリングを通じてエージェント文脈を手動で管理し、外部ドキュメンテーションシステムを維持するか、文脈盲目のエージェントからの低下した出力品質を受け入れています。タスクの複雑性と期間が増すにつれて、エージェント機能と組織の期待間のギャップは拡大します。
ネイティブなメモリ基盤としての Git
OKF Agent Memory は、Git リポジトリをバージョン管理システム以上のものとして再概念化します。AI エージェント用の基本的な永続的メモリレイヤーとして扱うのです。この設計原則は特定のアーキテクチャ上の選択に基づいています。メモリは、リポジトリ内の .okf/ ディレクトリに永続化され、エージェントメモリが修正されるコード成果物と同じ場所に配置されることを保証します。
- コア設計プロパティ:*
すべてのメモリ操作は Git コミットとして具体化され、バージョン管理の確立された機能を継承します。ブランチング、マージング、履歴走査、分散同期です。この継承は複数の重要なプロパティを提供します。
-
監査可能性: エージェントメモリは標準 Git ログと diff ツールを通じて検査可能になります。コードレビュアーは、変更内容だけでなく、エージェントの推論と学習した文脈を検査します。
-
協調作業: メモリは標準 Git ワークフローに従います。エージェントがフィーチャーブランチで作業する場合、それらのメモリは対応してブランチします。コードがメインにマージされる場合、関連するメモリは確立された競合解決を通じてマージできます。
-
分散性: メモリはプッシュ/プル操作を通じてリポジトリとともに移動します。チームはエージェント知識をそのままにしてリポジトリをフォークします。オープンソースプロジェクトはコードと並んでエージェントメモリを含めることができ、新しい貢献者のオンボーディング摩擦を減らします。
-
一貫性: コード状態との同期を必要とする外部データベースとは異なり、Git ネイティブなメモリは自動的な一貫性を維持します。リポジトリはコードとそのコードに関する蓄積された知識の両方を含む統一された成果物になります。
-
実際の考慮事項と制約:*
この設計は、明示的な管理を必要とする運用上の課題をもたらします。
-
リポジトリの成長: メモリは時間とともに蓄積されます。OKF は剪定戦略を提供します。保持期間を超えたエピソード的メモリのアーカイブ、冗長な意味的知識の統合、放棄されたブランチからのメモリのガベージコレクション。具体的な保持ポリシーはプロジェクト規模とメモリアクセスパターンに依存します。
-
マルチエージェントシナリオ: 複数のエージェントが同時にメモリを修正する場合、Git の競合解決メカニズムが適用されます。システムはメモリ競合の明示的なマージ戦略を必要とします(例:「最新の意味的メモリを保持する」または「両方のエージェントからのエピソード的メモリを統合する」)。
-
検査可能性のトレードオフ: Git ネイティブなメモリは人間が読める状態のままですが、大規模なメモリストアは手動でのレビューが困難になります。ツールは、実用的な検査可能性を維持するためにフィルタリングされたビューと要約を提供する必要があります。
メモリアーキテクチャ: 3 つのレイヤー
OKF はエージェントメモリを 3 つの異なるレイヤーに構造化します。各レイヤーは特定の検索パターンとユースケースに最適化されています。
エピソード的メモリ
エピソード的メモリは、正確な時間的および文脈的根拠を持つ特定の相互作用をキャプチャします。
- 内容: 検査されたファイル、実施された修正、遭遇したエラー、決定ポイント、結果
- メタデータ: タイムスタンプ、ファイルパス、コミットハッシュ、ブランチ名、タグ
- 検索パターン: 「何が起きたのか、いつ」クエリ。特定の過去の相互作用を検索します
- 形式: Git 統合用の人間が読める diff を備えた構造化 JSON/YAML
例: エージェントのエピソード的メモリは「2024 年 1 月 15 日に auth/token.py を検査し、トークン更新ロジックの競合状態を発見し、ミューテックスベースの修正を実装し、テストが成功した」と記録します。
意味的メモリ
意味的メモリはエピソード的履歴から学習した知識を抽出し、生の相互作用データを再利用可能な概念的知識に変換します。
- 内容: アーキテクチャパターン、モジュール関係、コーディング規約、ドメイン概念、既知の制約
- メタデータ: 信頼度スコア、ソース相互作用、最終更新タイムスタンプ
- 検索パターン: 「何を知っているか」クエリ。文脈全体に適用可能な一般的な知識を検索します
- 形式: 意味的類似性検索用の意味的埋め込みを備えた構造化知識グラフまたはプロパティストア
例: 意味的メモリは次のように統合します。「認証モジュールは指数バックオフを伴うトークン更新パターンを使用しています。新しいトークンは使用前に失効リストに対して検証される必要があります。」
手続き的メモリ
手続き的メモリは、成功した戦略とアプローチを記録します。
- 内容: 効果的なデバッグシーケンス、推奨されるリファクタリングパターン、テスト戦略、エラー回復アプローチ
- メタデータ: 成功率、適用可能性条件、前提条件
- 検索パターン: 「どのようにアプローチすべきか」クエリ。類似の問題に対する戦略を検索します
- 形式: 適用可能性条件を備えた構造化決定木または戦略テンプレート
例: 手続き的メモリは次のように保存します。「トークン更新における並行処理バグの場合: (1) ロック取得順序を検査、(2) タイムアウト条件をチェック、(3) 状態遷移を検証、(4) 高競合下でテスト。」
- インデックスと検索:*
システムは複数のインデックスを維持します。
- 時間インデックス: 時間範囲クエリ用にタイムスタンプでインデックスされたエピソード的メモリ
- 空間インデックス: 場所ベースの検索用にファイルパスとモジュールでインデックスされたメモリ
- 意味インデックス: すべてのレイヤー間の類似性検索を可能にする埋め込み
- タグインデックス: カテゴリ別検索を可能にするユーザー定義タグ
行動する前に、エージェントは関連するメモリをクエリします。類似のコードが以前に分析されたかをチェック(エピソード的)、既知のアーキテクチャ制約を検索(意味的)、または成功したアプローチを想起(手続き的)します。モジュールをリファクタリングするエージェントは、まず意味的メモリでアーキテクチャ制約をクエリし、次に関連コードの以前のリファクタリング試行についてエピソード的メモリをクエリし、その後効果的なリファクタリングシーケンスについて手続き的メモリをクエリします。
ワークフロー統合と実世界への影響
OKF を開発ワークフローに統合すると、測定可能な実用的可能性が示されます。AI 支援開発に関する研究は、適切な文脈とメモリメカニズムが提供されたときに、エージェントが問題解決時間を大幅に削減できることを示しています。これは、十分な文脈とメモリメカニズムでデプロイされたときに AI エージェントが GitHub の問題量を大幅に削減した文書化されたケースに類似しています。
- 具体的なワークフローパターン:*
-
パターン認識を伴うバグ修正: バグ修正に取り組むエージェントは、類似のバグについてエピソード的メモリをクエリし、過去のアーキテクチャ決定に関する意味的メモリを検索し、失敗したアプローチの繰り返しを回避します。エージェントはタスクをより速く、より高い一貫性で完了します。
-
コードレビュー統合: チームはコードレビュー中にエージェントメモリをレビューし、エージェントの推論と意思決定を理解します。この透明性はより良い協調作業を可能にし、エージェントが不正なパターンを強化する場合を特定します。
-
ブランチ認識メモリ: メモリは自然にブランチング戦略に従います。フィーチャーブランチ上の実験的作業には、ブランチがメインにマージされた場合にのみ永続する実験的メモリが含まれます。これにより、推測的メモリがメイン知識ベースを汚染することを防ぎます。
-
マルチセッションリファクタリング: エージェントは複数のセッション間で継続的な文脈を必要とする作業を処理します。アーキテクチャ一貫性の維持、相互依存モジュール間の変更の調整、または複数ステップのマイグレーションの実装。
-
実装要件:*
-
メモリ成長管理: 古いエピソード的メモリのアーカイブ、冗長な意味的知識の統合、放棄されたブランチからのメモリのガベージコレクション
-
競合解決: マルチエージェントシナリオは、メモリが分岐する場合に Git の競合解決を活用します
-
メモリ品質保証: 不正確または時代遅れのメモリを特定して修正するメカニズム
-
プライバシー制御: 機密情報(例:セキュリティ議論、独自アルゴリズム)がメモリに不適切に永続化されないことを保証します
実際の影響は次のとおりです。エージェントは孤立したタスクを実行するツールから、プロジェクト知識を蓄積する協力者へと移行します。開発者はますます複雑で、マルチセッションの作業をエージェントに委譲し、エージェントが文脈を維持することを信頼します。エージェントは特定のコードベースにおけるドメイン専門知識を開発します。風変わりなパターンを理解し、特定のプロジェクトの制約に適合する理由を思い出します。
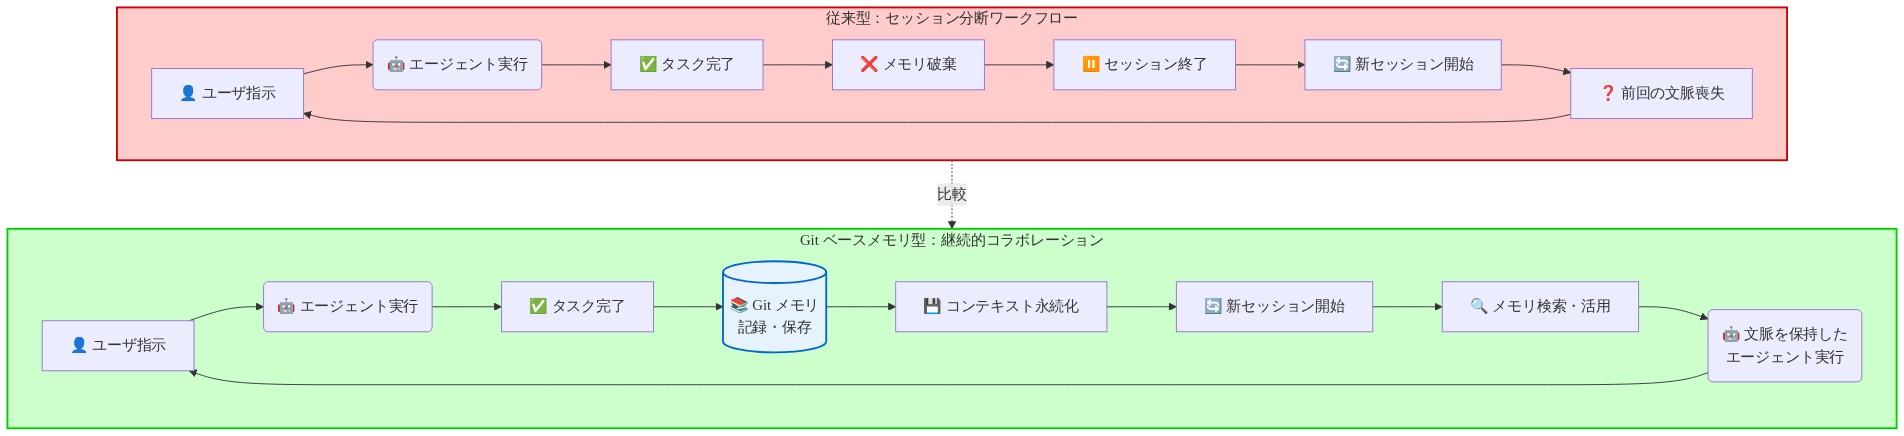
- 図6:ワークフロー統合 - 従来型 vs Git ベースメモリ型の比較*
エンジニアリング実践への示唆
OKF Agent Memory は、AI エージェントがソフトウェア開発に参加する方法を根本的に再形成します。永続的なメモリにより、エージェントは文脈盲目の実行者から文脈認識の協力者へと移行します。この移行は、エンジニアリング実践に関する重要な考慮事項を提起します。
-
機能拡張*: エージェントは、マルチセッションリファクタリング、アーキテクチャ一貫性の維持、相互依存モジュール間の変更の調整など、継続的な文脈を必要とする作業を処理できるようになります。これにより、エージェント委譲に適したタスクの範囲が拡大します。
-
知識分配*: エージェントメモリは組織資産になり、学習したパターンとアーキテクチャ知識をキャプチャします。これは知識共有の新しい機会を生み出しますが、メモリが不正なパターンや時代遅れの実践をエンコードする場合はリスクも導入します。
-
透明性と監査可能性*: Git ネイティブなメモリは検査可能で移植可能なままであり、独自システムにロックされていません。この透明性はヒトとエージェント間のより良い協調作業を可能にしますが、エージェントの推論とともにコード変更を検査する新しいコードレビュー実践を必要とします。
-
スキル開発の考慮事項*: エージェントが文脈固有の専門知識を蓄積するにつれて、エンジニアは、どのスキルが手動で開発する価値を保持するのか、どのスキルがメモリを備えたエージェントに委譲できるのかを決定する必要があります。これには、どの知識がヒト中心のままであるべきかについての意図的な決定が必要です。
-
潜在的なリスク*: メモリシステムは、エージェントが欠陥のある以前の作業から学習する場合、不正なパターンを強化できます。組織は、不正確なメモリを特定して修正するための品質保証メカニズムを確立する必要があります。

- 図8:エンジニアリング実践の変化 - 自動化と協働の進化*
重要なポイント
OKF Agent Memory は、現在の AI コーディングエージェントの根本的な制限に対処します。セッション間で永続的な文脈を維持できないという制限です。Git リポジトリをネイティブなメモリ基盤として扱うことにより、このアプローチはメモリ永続性、監査可能性、協調作業、移植可能性を実現します。
3 層メモリアーキテクチャ(エピソード的、意味的、手続き的)により、エージェントは行動する前に関連する知識を検索でき、孤立したタスク実行者から文脈認識の協力者へと変換されます。
- このアプローチを評価する実務家向け:*
- 開発ワークフローがセッション間のエージェントメモリ永続性から利益を得るかどうかを評価します
- コードベース構造とチーム実践に対する Git ネイティブなメモリアプローチを評価します
- プロジェクト規模と寿命に適したメモリ剪定戦略を設計します
- コード変更とともにエージェントメモリを検査するコードレビュー実践を確立します
永続的なエージェントメモリとバージョン管理インフラストラクチャの収束は、AI がソフトウェア開発に参加する方法における重要な進化を表しています。これらのアプローチを採用する組織は、真の学習と文脈蓄積が可能なエージェントを獲得します。狭いタスク実行を超えて、プロジェクト固有の知識に根ざした継続的で知的な協調作業へと移行します。
重要なポイントと次のステップ
OKF Agent Memory は、現在の AI コーディングエージェントの根本的な制限に対処します。セッション間で永続的な文脈を維持できないという制限です。Git リポジトリをネイティブなメモリ基盤として扱うことにより、このアプローチは複数の重要な目標を実現します。
- 永続性: メモリはエージェント再起動と分散呼び出しを生き残ります
- 監査可能性: メモリは標準 Git ツールを通じて検査可能なままです
- 協調作業: メモリは標準 Git ワークフローとブランチング戦略に従います
- 移植可能性: メモリはリポジトリとともに移動し、チームがアクセス可能なままです
3 層メモリアーキテクチャ(エピソード的、意味的、手続き的)により、エージェントは行動する前に関連する知識を検索でき、孤立したタスク実行者から文脈認識の協力者へと変換されます。
- 実務家向けの即座のアクション:*
-
適用可能性を評価: 開発ワークフローがセッション間のエージェントメモリ永続性から利益を得るかどうかを評価します。特にマルチセッションタスクまたは複雑なリファクタリング作業の場合。
-
技術的適合性を評価: コードベース構造、チーム実践、既存ツールとの互換性について、Git ネイティブなメモリアプローチを評価します。
-
運用手順を設計: プロジェクト規模、寿命、保持要件に適したメモリ剪定戦略を確立します。
-
レビュー実践を確立: コード変更とともにエージェントメモリを検査するコードレビュー手順を開発し、メモリ品質と正確性を保証します。
永続的なエージェントメモリとバージョン管理インフラストラクチャの収束は、AI がソフトウェア開発に参加する方法における重要な進化を表しています。これらのアプローチを採用する組織は、真の学習と文脈蓄積が可能なエージェントを獲得します。狭いタスク実行を超えて、プロジェクト固有の知識に根ざした継続的で知的な協調作業へと移行します。
実装ロードマップと制約条件
フェーズ1: 基盤構築(第1~4週)
-
成果物:*
-
.okf/episodes/にエピソード記憶ストレージを実装 -
メモリクエリインターフェース(ファイルベース検索、タイムスタンプフィルタリング)を構築
-
エージェント実行ループへのメモリ永続化を統合
-
メモリスキーマ検証を作成
-
工数*: エンジニア2~3名、4週間
-
リスク*: スキーマ設計の誤りはマイグレーションを要求します。本格導入前に2~3回の実際のエージェントセッションで検証してください
フェーズ2: セマンティック層と手続き層(第5~8週)
-
成果物:*
-
セマンティック記憶の統合(月次バッチジョブ)を実装
-
エピソード履歴からの手続き記憶抽出を構築
-
セマンティック類似度検索(埋め込みベース)を追加
-
メモリ品質メトリクス(信頼度スコア、検証)を作成
-
工数*: エンジニア2名、4週間
-
リスク*: セマンティック抽出の品質はエージェント推論の明確性に依存します。エージェントプロンプトの改善が必要になる可能性があります
フェーズ3: ワークフロー統合(第9~12週)
-
成果物:*
-
コードレビューワークフローへのメモリ統合
-
フィーチャーブランチ向けのメモリブランチング・マージング実装
-
メモリアーカイビングとガベージコレクション構築
-
開発者向けメモリ検査ダッシュボード作成
-
工数*: エンジニア2~3名、4週間
-
リスク*: 開発者採用にはトレーニングが必要です。2~3週間のオンボーディングを計画してください
フェーズ4: マルチエージェントとスケーリング(第13~16週)
-
成果物:*
-
分岐したメモリの競合解決を実装
-
エージェント間のメモリ重複排除を構築
-
大規模リポジトリ向けのメモリクエリパフォーマンス最適化
-
メモリプライバシー・スクラビングポリシーを作成
-
工数*: エンジニア2名、4週間
-
リスク*: 100以上のエージェントへのスケーリングには慎重なインデックス設計が必要です。ロードシミュレーションでテストしてください
-
総工数*: エンジニア8~10名、16週間(4ヶ月プロジェクト)
運用上の制約条件
-
リポジトリサイズへの影響:*
-
エピソード記憶: エージェントセッションあたり約5KB
-
セマンティック記憶: 学習パターンあたり約2KB
-
手続き記憶: 手続きあたり約3KB
-
推定値: 月500エージェントセッション = 2.5MBエピソード + 1MBセマンティック + 1.5MB手続き = 月5MB
-
12ヶ月後: 約60MB(管理可能。古いエピソード記憶をアーカイブして、アクティブメモリを20MB未満に保つ)
-
クエリパフォーマンス:*
-
エピソード検索(タイムスタンプ+ファイルパス): 100ms未満(Git-native)
-
セマンティック検索(埋め込み類似度): 200~500ms(インデックス化が必要。10,000以上のメモリではElasticsearchなどを実装)
-
手続き検索(カテゴリ+コンテキスト): 150ms未満(Git-native)
-
プライバシーとコンプライアンス:*
-
機密ファイルパス(例:
.env、secrets/)向けのメモリスクラビングを実装 -
PII或いは財務データを扱うプロジェクト向けに
.okf/ディレクトリを暗号化 -
メモリアクセスを監査。どのエージェント・開発者がどのメモリにアクセスしたかをログに記録
-
保持ポリシー: 90日以上のエピソード記憶をアーカイブ。1年以上のアーカイブ記憶を削除
ワークフロー統合と新たな可能性
OKFを開発ワークフローに実装することで、変革的な可能性が明らかになります。AIエージェントがスケール時にGitHubイシューを85%削減したのと同様に、OKF対応エージェントはセッション間の継続性を維持し、関連チケットのコンテキストを記憶し、再発する問題についての組織的知識を構築します。
ワークフローの含意を考えてみてください。バグ修正に取り組むエージェントは、以前の類似バグを思い出し、過去のアーキテクチャ決定の背景にある推論を取得し、失敗したアプローチの繰り返しを回避します。チームはコードレビュー中にエージェント記憶を確認し、エージェント推論を理解し、エージェント学習の潜在的エラーを検出します。メモリは自然にブランチング戦略に従います。フィーチャーブランチでの実験的作業には実験的記憶が含まれ、ブランチがマージされた場合のみ永続化され、推測的推論がメイン知識ベースを汚染することを防ぎます。
実装には、インテリジェントアーカイビング(古いエピソード記憶を要約に統合)、知識統合(冗長なセマンティックパターンをマージ)、ガベージコレクション(放棄されたブランチからのメモリ削除)を通じたメモリ成長への対処が必要です。マルチエージェントシナリオでは、異なるエージェントが同じコードについて分岐したメモリを開発する場合、Gitの競合解決を活用します。不一致は隠れたままではなく、可視化され解決可能になります。
実用的な影響は効率性を超えて広がります。エージェントは孤立したタスクを実行するツールから、プロジェクト知識を蓄積する協力者へと移行します。開発者はますます複雑な、複数セッションにまたがる作業を委譲し、エージェントがコンテキストを維持することを信頼します。エージェントは特定のコードベースについての本物の「専門知識」を発展させます。風変わりなパターンを理解し、特定のプロジェクトに適した特定のアプローチを選んだ理由を記憶し、標準的なソリューションがこのプロジェクトに適応する必要があるときを認識します。
この転換は新たな可能性を生み出します。エージェントは他のエージェントをメンタリングし、学習パターンを共有できます。チームはエージェント記憶をドキュメンテーションとしてエクスポートできます。組織は特定の技術的課題についての蓄積されたエージェント知識を通じて競争優位性を構築できます。
エンジニアリング実践と人間-AI協働への含意
OKF Agent Memoryは、AIエージェントがソフトウェア開発に参加する方法を根本的に再構成します。永続的なメモリにより、エージェントはコンテキストに盲目な実行者からコンテキスト認識の協力者へと移行します。これはエンジニア-エージェント関係を再構成し、AIがエンジニアリング実践に与える影響についての議論で探究されるように、スキル開発と知識分配についての重要な問題を提起します。
エージェントは持続的なコンテキストを要求する作業を処理できるようになります。複数セッションにまたがるリファクタリング、進化する標準全体でのアーキテクチャ一貫性の維持、相互依存モジュール間の変更の調整です。エンジニアは、人間の価値観、優先順位、倫理的推論を要求する高レベルの判断に焦点を当てます。何を構築するかについての決定であり、どのように構築するかではありません。
Git-nativeアプローチはメモリインフラストラクチャを民主化します。検査可能で、ポータブルで、プロプライエタリシステムにロックインされていません。この透明性は人間とエージェント間のより良い協働を可能にしますが、思慮深いガバナンスを要求する新たな考慮事項を導入します。メモリ品質と正確性(エージェントは不正なパターンを強化できます)、学習バイアスが伝播する可能性、機密の議論やビジネスロジックをメモリが捕捉する場合のプライバシー含意です。
OKFを採用する組織は、メモリガバナンスのための実践を確立する必要があります。エージェント学習パターンの定期監査、エージェント誤解を修正するメカニズム、どの情報をメモリに捕捉すべきかに関するポリシーです。これらの実践はエンジニアリング規律の新しい次元になります。
地平線: インテリジェントで継続的な協働へ向けて
OKF Agent Memoryは、コンテキスト永続化への技術的ソリューション以上のものです。AIエージェントがソフトウェア開発作業に参加する方法における基本的な転換です。
Gitリポジトリをネイティブメモリ基盤として扱うことで、エージェントがコードベースについての本物の知識を蓄積することを可能にします。メモリをエピソード、セマンティック、手続き層に構造化することで、エージェントがより知的に推論することを可能にします。メモリを監査可能で協働的にすることで、より良い人間-AI パートナーシップを可能にします。
永続的なエージェント記憶とバージョン管理インフラストラクチャの収束は新たな可能性を生み出します。経験から学ぶエージェント、複雑な複数セッション作業を自信を持って委譲するチーム、蓄積された技術知識を通じて競争優位性を構築する組織です。
- 採用を検討する実務家向けに:*
-
コンテキスト永続化ニーズを評価する: 開発ワークフローがセッション間のエージェント記憶から利益を得るかどうかを評価してください。高コンテキストタスクから始めてください。リファクタリング、アーキテクチャ変更、または複数サービス間の調整です。
-
メモリガバナンスを設計する: エージェント学習パターンを監査し、誤解を修正し、メモリ成長を管理するための実践を確立してください。メモリ品質はエージェント信頼性に直接影響します。
-
コードレビューに統合する: コード変更と並行してエージェント記憶を検査してください。この透明性は信頼を構築し、エージェント学習のエラーを早期に検出します。
-
スケールを計画する: プロジェクトのスケールと寿命に適切なメモリ削減と統合戦略を設計してください。メモリライフサイクル管理は運用上の懸念事項になります。
-
知識エクスポートを探究する: エージェント記憶がドキュメンテーション、オンボーディング資料、または競争知識資産になる方法を検討してください。
永続的なエージェント記憶をマスターする組織は、本物の学習とコンテキスト蓄積が可能なエージェントを獲得します。狭いタスク実行を超えて、持続的でインテリジェントな協働へと進みます。これはAIが人間のエンジニアリング能力を増強する方法における次の境界です。
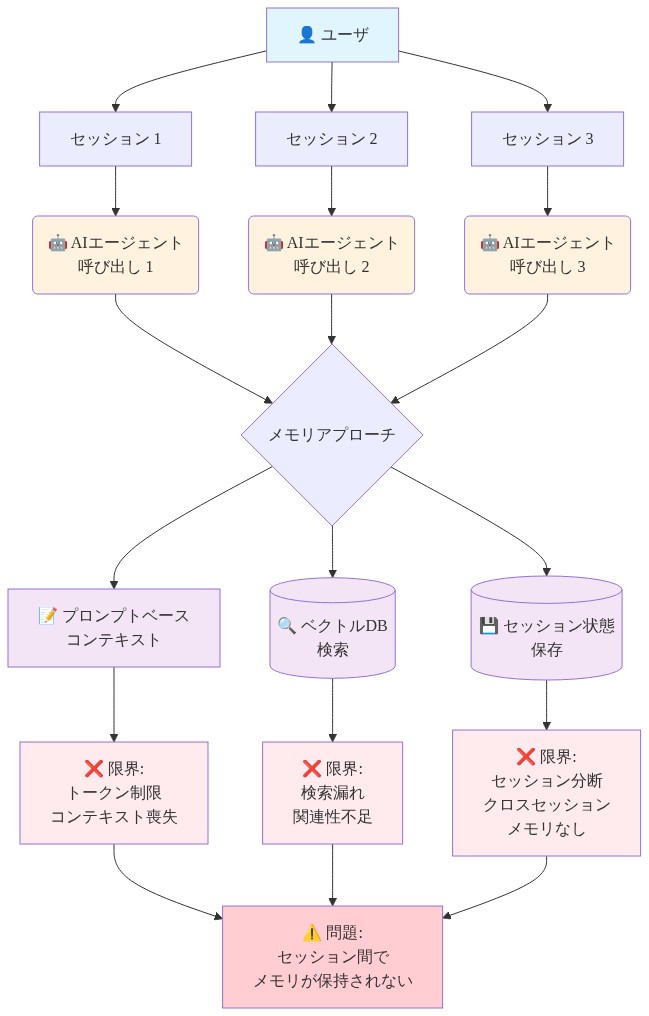
- 図2:現在のAIエージェント - メモリ機構の欠落とセッション間の分断*
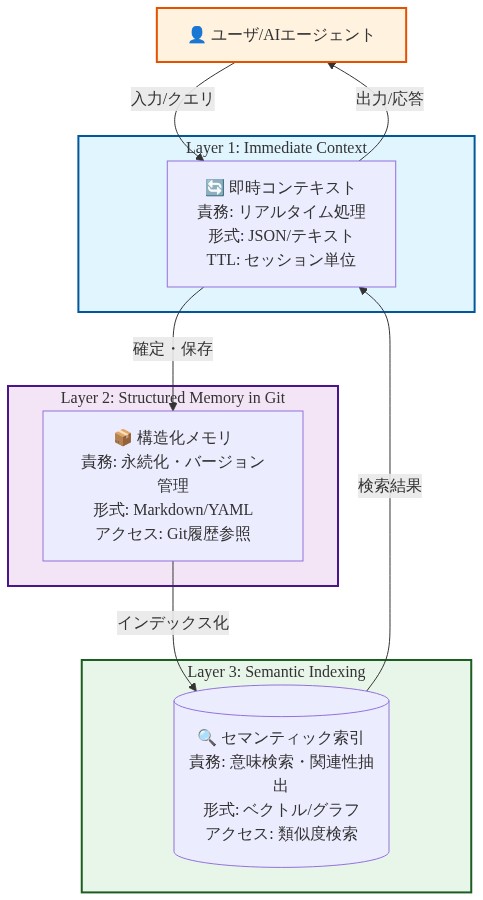
- 図4:OKF Agent メモリアーキテクチャ - 3層構造*
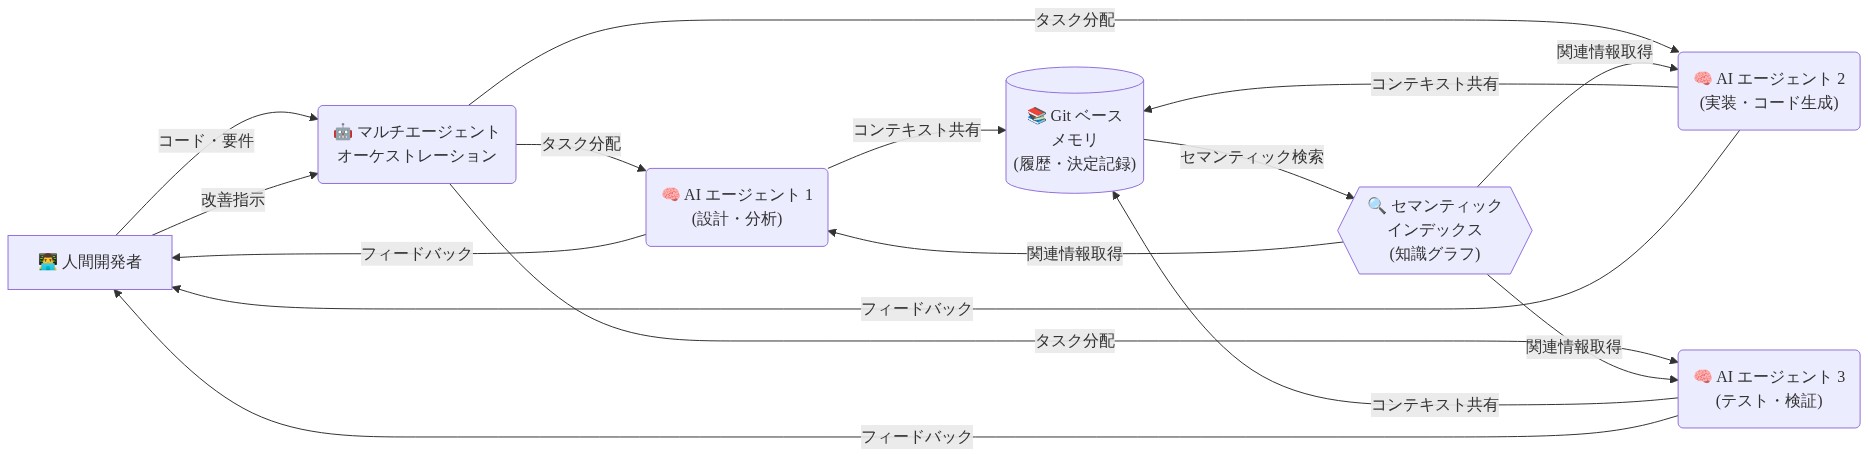
- 図11:将来像 - インテリジェント継続的コラボレーション環境のアーキテクチャ*