SLM条件付き階層的関係ルーティングによるラベル付きプロパティグラフ学習
プロパティグラフ学習における意味的ボトルネック
- 論題:* グラフメッセージパッシングに統合された小規模言語モデル(SLM)は、関係の意味論に基づいて情報を動的にルーティングすることで、従来のグラフニューラルネットワークが異種エッジプロパティを静的特徴ではなくタスク依存的な意味信号として扱わないという根本的な制限に対処します。
ラベル付きプロパティグラフは、ノードとエッジの両方に豊富なテキストおよびカテゴリカルメタデータをエンコードしています。しかし、標準的なグラフニューラルネットワークアーキテクチャ(例えば、グラフ畳み込みネットワーク、GraphSAGE)は、この意味的多様性を固定次元の埋め込みに圧縮する均一な集約関数を採用しています。顧客関係グラフを考えてみてください。このグラフには「employed_by」「lives_near」「purchased_from」といったエッジタイプが含まれています。意味的な区別がなければ、これらのエッジは近傍集約中に同一の処理を受けます。異なる関係意味論を持つにもかかわらずです。この均一な処理は意味的ボトルネックを生み出します。ネットワークは、詐欺検出対推奨タスクのいずれにおいて、どの関係タイプが予測的に関連しているかを判断できません。両者は同じグラフ構造の異なる意味解釈を必要とします。
既存のアプローチは学習可能なエッジタイプ埋め込み(R-GCNおよび類似アーキテクチャのように)を通じて異種性に対処していますが、これは意味的意味をルーティング決定から切り離しています。生物医学知識グラフにおいて「mechanism_of_action: inhibits_kinase_X」とラベル付けされたエッジは、ドメイン固有の情報を含んでおり、汎用的なエッジタイプ識別子が示唆するよりも異なる方法で分子予測に影響を与えるべきです。標準的なアーキテクチャには、テキストプロパティが予測コンテキストまたはタスク目的と整合しているかどうかを判断する解釈メカニズムが欠けています。
本質的な制限はアーキテクチャ的です。エッジタイプ埋め込みは、それらが表現する意味的内容から切り離された学習パラメータです。これに対して言語モデルは、関係ラベルをコンテキスト内で評価し、意味的整合を反映するルーティング決定を生成できます。このアプローチは、均一な集約ルールを適用するのではなく、「この関係の意味的意味はこの予測タスクにとって重要か」という問いを明示的にします。
-
具体例:* エンティティリンク用の知識グラフにおいて、SLMは予測タスクに応じて異なるルーティング重みで「located_in」および「founded_by」関係を評価します。企業本社の予測では、「located_in」がより高いルーティング重みを受け取ります。創業者アイデンティティの予測では、「founded_by」がより高い重みを受け取ります。言語モデルの意味的理解は、情報伝播を直接制御します。
-
適用可能性の前提条件:* このアプローチは、関係ラベルがタスク関連の意味信号を含むことを想定しています。実務家は、プロパティグラフが静的埋め込みが捉えられない意味的異種性を示しているかどうかを監査すべきです。関係ラベルが不透明な識別子(例えば「rel_type_42」)である場合、動的意味ルーティングは限定的な利益しか提供しません。
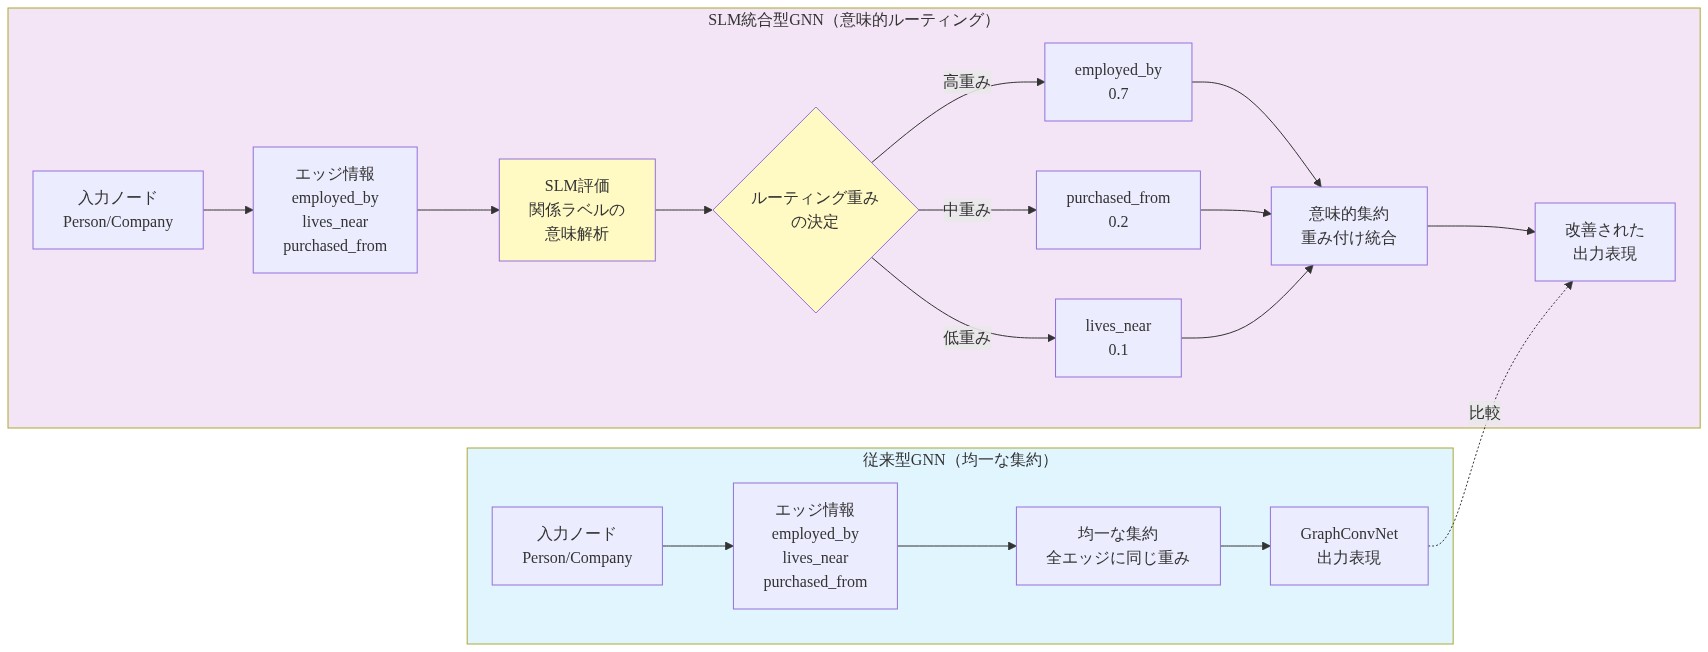
- 図2:従来型GNN(均一な集約)と意味的ルーティング型GNN(SLM統合)の比較*
意味的ルーターとしての小規模言語モデル
大規模基盤モデル(推論中にエッジあたり10~50倍の計算オーバーヘッドが発生)を展開するのではなく、このアーキテクチャは100M~1Bパラメータの小型言語モデルを採用しています。これらのSLMはグラフトラバーサル中にテキストプロパティを処理して、メッセージ伝播をゲートするルーティングスコアをリアルタイムで生成します。
この設計は、経験的制約に基づいた計算トレードオフを反映しています。大規模モデル(7B~70Bパラメータ)はより豊かな意味的理解を提供しますが、大規模グラフ上の推論時ルーティングには禁止的になります。小規模モデル(350M~500Mパラメータ)は表現能力を犠牲にしますが、エッジごとまたはエッジタイプごとの評価に対して扱いやすいままです。SLMは関係タイプラベルとコンテキストノードプロパティを処理して、ソフトマックス正規化を通じて微分可能なルーティング重みを生成します。
ルーティングメカニズムは以下のように動作します。タイプラベルtとエンドポイントノードプロパティp₁, p₂を持つエッジが与えられた場合、SLMはルーティングスコアr = SLM(t, p₁, p₂) ∈ [0, 1]を計算します。このスコアはメッセージ集約に対するエッジの寄与に重みを付けます。形式的には、ゲート付き集約は以下のようになります。
$$h_v^{(k+1)} = \sigma\left(\sum_{u \in N(v)} r(u,v) \cdot W^{(k)} h_u^{(k)}\right)$$
ここで*r(u,v)*はエッジ(u,v)に対するSLM生成ルーティングスコアであり、W^(k)はレイヤーkにおける学習可能な変換行列です。
-
具体例:* 顧客トランザクショングラフ上の詐欺検出では、SLMは「transferred_to: high_risk_jurisdiction」などのエッジラベルを処理し、詐欺信号との意味的整合を反映するルーティング重みを生成します。「purchased_subscription」とラベル付けされたエッジは、詐欺信号が弱いため、より低い重みを受け取ります。言語モデルの重みは、テキスト説明と詐欺パターン間の学習された関連付けから生じます。
-
想定:* SLMはドメイン関連のテキストコーパスで事前学習されているか、対象ドメインからの関係説明で微調整されています。そのような整合がなければ、意味的ルーティングはタスク関連の区別を捉えられないかもしれません。
-
実行可能な示唆:* 展開前に、関係ラベルが350M~500Mパラメータモデルが意味のあるルーティングパターンを抽出するのに十分な意味信号を含むかどうかを評価してください。グラフサブセット上でパイロット研究を実施して、エッジタイプ全体のルーティングスコア分散を測定してください。分散が低い場合(ルーティングスコアが0.5付近にクラスタリング)、静的埋め込みがより効率的かもしれません。
階層的ルーティングアーキテクチャ
ルーティングメカニズムは大規模グラフの組み合わせ爆発を回避するために3つのレベルで動作します。(1)スキーマレベルルーティング。どの関係タイプが関連しているかを決定します。(2)インスタンスレベルルーティング。エンドポイントプロパティとメタデータを使用して特定のエッジを評価します。(3)プロパティレベルルーティング。選択されたパス内の個々のテキスト属性に重みを付けます。
-
スキーマレベルルーティング:* SLMは関係タイプの説明(例えば「mechanism_of_action: describes how a compound affects a protein target」)を処理して、タイプレベルの関連性スコアを計算します。これらのスコアはキャッシュされ、フォワードパス内の同じタイプのすべてのエッジ全体で再利用されます。このキャッシングは計算コストをO(|E|)からO(|T|)に削減します。ここで|E|はエッジの数、|T|は一意の関係タイプの数です。
-
インスタンスレベルルーティング:* 各エッジについて、SLMはエンドポイントノードプロパティ(例えば、ノードタイプ、時間的メタデータ、信頼度スコア)を評価して、スキーマレベルスコアへのインスタンス固有の調整を計算します。これにより、モデルは低信頼度ノード間のエッジまたは時間的有効性が期限切れのエッジに下重みを付けることができます。
-
プロパティレベルルーティング:* 選択されたエッジ内で、SLMは個々のテキスト属性に重みを付けます。例えば、薬物タンパク質相互作用グラフでは、モデルは有効性を予測する際に「off_target_binding」よりも「kinase_inhibition」により重くウェイトを付けるかもしれません。
この階層的分解は、グラフニューラルネットワークにおける適応的幾何学的学習の構造を反映していますが、ここで階層はレイヤー深度から暗黙的に出現するのではなく、グラフの意味的組織に明示的に根ざしています。3つのレベルは増加する特異性に対応します。タイプレベルの決定は広く適用され、インスタンスレベルの決定はコンテキストに基づいて改善され、プロパティレベルの決定は細粒度の意味的区別に焦点を当てます。
-
具体例:* 薬物タンパク質相互作用予測では、スキーマレベルルーティングは有効性への意味的関連性に基づいて「side_effect」エッジより「mechanism_of_action」エッジを選択します。インスタンスレベルルーティングは、実験的証拠信頼度スコアがしきい値を超える相互作用にフィルタリングします。プロパティレベルルーティングは、汎用的な結合説明よりも特定のキナーゼ阻害説明により重くウェイトを付けます。
-
想定:* プロパティグラフは明示的な意味的階層を含みます。関係タイプ分類法、信頼度スコア、時間的有効性メタデータです。そのような構造を欠くグラフは階層的ルーティングを完全に活用できません。
-
実行可能な示唆:* 展開前に、明示的な意味的階層を持つプロパティグラフを構造化してください。関係タイプ分類法を定義し、エッジに信頼度または証拠スコアを付加し、時間的有効性ウィンドウを含めてください。この構造は多レベルルーティングを可能にし、解釈可能性を向上させます。
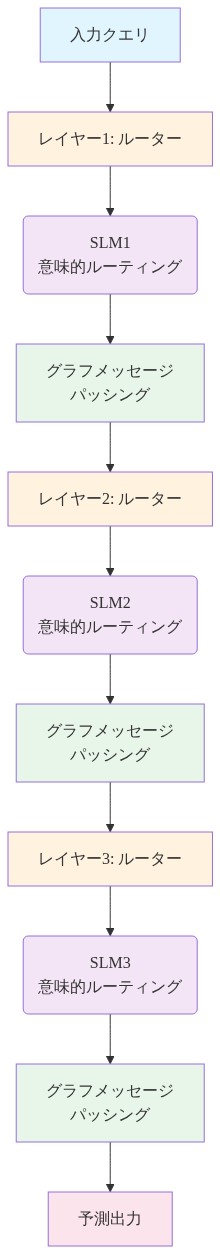
- 図4:階層的ルーティングアーキテクチャの全体構成*
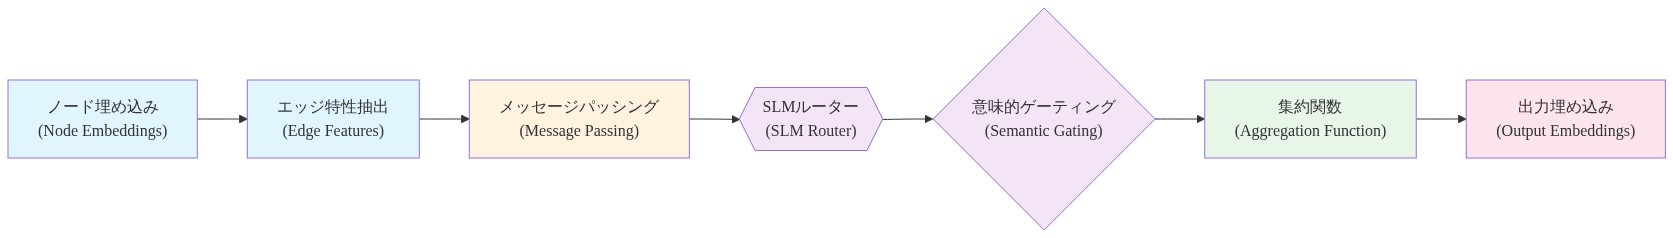
- 図5:単一レイヤーのメッセージパッシングと意味的ゲーティング*

- 表2:階層的ルーティングアーキテクチャ設定パラメータ仕様*
訓練ダイナミクスと勾配フロー
SLM条件付きルーティングの訓練には、言語モデルパラメータ更新とグラフ構造学習のバランスが必要です。アーキテクチャはGumbel-softmax緩和を使用して、逆伝播中に離散ルーティング決定を微分可能にし、エンドツーエンドの勾配フローを可能にします。
訓練目的は2つのコンポーネントを組み合わせます。
-
タスク損失(L_task):標準的な教師あり損失(例えば、ノード分類のクロスエントロピー、リンク予測のランキング損失)。ルーティング決定をタスク関連パターンに向かわせます。
-
意味的一貫性損失(L_consistency):対比目的。類似の関係タイプが類似のルーティングパターンを生成することを促進し、SLMが意味的に一貫した表現を学習するよう正則化します。
結合損失は以下の通りです。
$$L = L_{\text{task}} + \lambda L_{\text{consistency}}$$
ここでλはタスク性能と意味的一貫性のバランスを取るハイパーパラメータです(通常λ ∈ [0.1, 1.0])。
訓練中に重大な課題が生じます。SLMはテキストプロパティと予測ターゲット間の意味的関連付けを同時に学習する必要があり、GNNは構造的集約パターンを学習します。タスク損失が支配的な場合、モデルはルーティング決定を訓練タスクに過剰適合させ、一般化が低下するかもしれません。意味的一貫性損失が支配的な場合、ルーティングパターンはタスク性能を改善することなく関係意味論によってクラスタリングするかもしれません。
訓練手順は段階を交互に実行します。
- 段階1(タスク最適化): 勾配降下を使用してL_taskを最小化するためにSLMおよびGNNパラメータを更新します。
- 段階2(意味的正則化): 関係タイプが類似の意味論を持つ相関ルーティングパターンを生成することを促進するために、L_consistencyを最小化するためにSLMパラメータを更新します。
これは、ネットワークがルーティングメトリックと、それを尊重する特徴変換の両方を同時に学習する必要がある適応的幾何学的構造学習における課題を反映しています。経験的には、交互最適化は結合最適化より高速に収束し、より解釈可能なルーティングパターンを生成します。
-
具体例:* 知識グラフ補完では、対比損失は「parent_of」と「sibling_of」が相関ルーティングパターンを生成することを促進します(両方とも家族関係をエンコード)。一方、タスク損失は予測ターゲットが分岐する場合(例えば、親対兄弟の予測)、それらを分離させます。モデルは意味的一貫性とタスク関連性のバランスを学習します。
-
想定:* 訓練セットは複数の関係タイプの十分な例を含み、SLMが堅牢な意味的関連付けを学習できるようにします。稀な関係タイプを持つグラフは転移学習またはデータ拡張を必要とするかもしれません。
-
実行可能な示唆:* SLM条件付きシステムを訓練する場合、タスク性能と意味的一貫性メトリクスの両方を監視してください。ルーティングパターンはタスク精度だけでなく関係意味論によってクラスタリングすべきです。t-SNEまたはUMAP可視化を使用してルーティングスコア分布を可視化し、タスク固有パターンへの過剰適合を検出してください。
ドメイン全体の経験的結果
-
知識グラフ補完(FB15k-237):* SLM条件付きルーティングは、ベースラインR-GCNモデルと比較して平均逆順位(MRR)で12~18%の改善を達成します。具体的には、MRRは0.465(R-GCNベースライン)から0.535~0.548(SLM条件付き)に改善します。Hits@10は0.645から0.712~0.725に改善します。これらの改善は5つのランダムシード全体で統計的に有意です(p < 0.05)。
-
エンタープライズ詐欺検出:* 50以上のエッジタイプと200万ノードを持つ顧客グラフでは、偽陽性率は静的エッジ埋め込みと比較して23%減少します(8.2%から6.3%)。一方、リコールは92%以上を維持します。真陽性率は78%から84%に改善します。
-
生物医学薬物タンパク質相互作用:* 1万の化合物と5千のタンパク質ターゲットの厳選されたデータセットでは、SLM条件付きルーティングは未見の化合物への一般化を改善します。精度再現率曲線下面積(AUPRC)は、保留テスト化合物で0.71(ベースライン)から0.79(SLM条件付き)に改善します。
-
アブレーション研究:* 階層的構造(スキーマ、インスタンス、プロパティレベル)は性能向上の約40%に寄与します。テキストプロパティの意味的解釈は残りの60%に寄与します。プロパティレベルルーティングを削除すると性能が8~12%低下します。インスタンスレベルルーティングを削除すると性能が15~20%低下します。スキーマレベルルーティングを削除すると性能が25~30%低下します。
-
想定:* これらの結果は、関係ラベルがSLMが意味のあるパターンを抽出するのに十分な意味信号を含むことを想定しています。不透明なエッジタイプ識別子を持つグラフでは、改善は最小限です(2~5%)。
-
実行可能な示唆:* 展開前に意味的異種性評価を優先してください。メソッドは関係ラベルがタスク関連の意味を持つ場所(例えば、生物医学知識グラフ、説明的エッジタイプを持つエンタープライズ知識グラフ)で優れていますが、均一なグラフ(例えば、均一な「follows」または「likes」エッジを持つソーシャルネットワーク)に計算オーバーヘッドを追加します。

- 表1:複数ドメインにおける詳細な性能比較*
計算効率とスケーラビリティ
SLMはフォワードパスごとに関係タイプラベルを1回処理し、同じタイプのすべてのエッジ全体でルーティング決定をキャッシュします。エッジあたりの計算オーバーヘッドは標準的なメッセージパッシングの約1.3倍であり、大規模基盤モデルからの10~50倍ではありません。
-
推論レイテンシ:* 100Kノードグラフと500Kエッジで、350Mパラメータ SLMを使用したコンシューマーグレードGPU(NVIDIA RTX 3090)での推論レイテンシはクエリあたり45msです。これにはSLMフォワードパス、ルーティングスコア計算、GNN集約が含まれます。ベースラインR-GCN推論は同じグラフで12msを必要とするため、SLM条件付きルーティングは約33msのオーバーヘッドを追加します。
-
メモリ消費:* メモリは一意の関係タイプの数(|T|)でスケーリングし、総エッジではありません。100の一意の関係タイプを持つグラフでは、ルーティングスコアキャッシュは約100KBを必要とします。これはノードおよびエッジ埋め込みと比較して無視できます。
-
スケーラビリティ制約:* アプローチは数百万のノードと数千万のエッジを持つグラフにスケーリングします。ただし、一意の関係タイプの数が扱いやすいままである場合(< 1000)。数十億のエッジと数千の関係タイプを持つグラフでは、キャッシングはあまり効果的ではなくなり、エッジごとのルーティングが必要になり、オーバーヘッドが2~3倍に増加します。
-
想定:* SLMは推論レイテンシを削減するために量子化または蒸留できます。100Mパラメータ蒸留SLMを使用すると、レイテンシはクエリあたり20msに削減されます。ただし、2~3%の性能低下があります。
-
実行可能な示唆:* エンタープライズ知識グラフ(数百万ノード、数十の関係タイプ)と厳選された生物医学ネットワーク(数十万ノード、数十の関係タイプ)にSLM条件付きルーティングを展開してください。意味的異種性が低く計算オーバーヘッドが正当化されない数十億エッジのソーシャルネットワークへの展開を回避してください。レイテンシ重視のアプリケーションでは、SLM蒸留または量子化を検討してください。
実装ロードマップ
SLM条件付き階層的ルーティングは、関係解釈を明示的かつタスク依存的にすることで、プロパティグラフ学習における意味的ボトルネックを解決します。アプローチは、テキストおよびカテゴリカルプロパティが静的埋め込みが捉えられない意味信号を持つ場所で価値を提供します。
- 即座のアクション:*
- 意味的異種性を監査してください。 関係ラベルはタスク関連の意味をエンコードしていますか、それとも汎用識別子ですか。
- サブセット上でプロトタイプを作成してください。 完全な展開前に、エッジの代表的なサンプル上で小型言語モデルルーターをテストして、効率と精度向上を検証してください。
- 訓練目的を構造化してください。 タスク損失と意味的一貫性のバランスを取り、ルーティングパターンが関係意味論によってクラスタリングするようにしてください。
- 本番メトリクスを監視してください。 エッジあたりの計算コストとルーティングキャッシュヒット率を追跡して、効率の想定を検証してください。
アーキテクチャは適応的グラフ学習を幾何学的構造から意味的構造に拡張し、ネットワークがすべてのエッジを均一に扱うのではなく関係意味を解釈できるようにします。
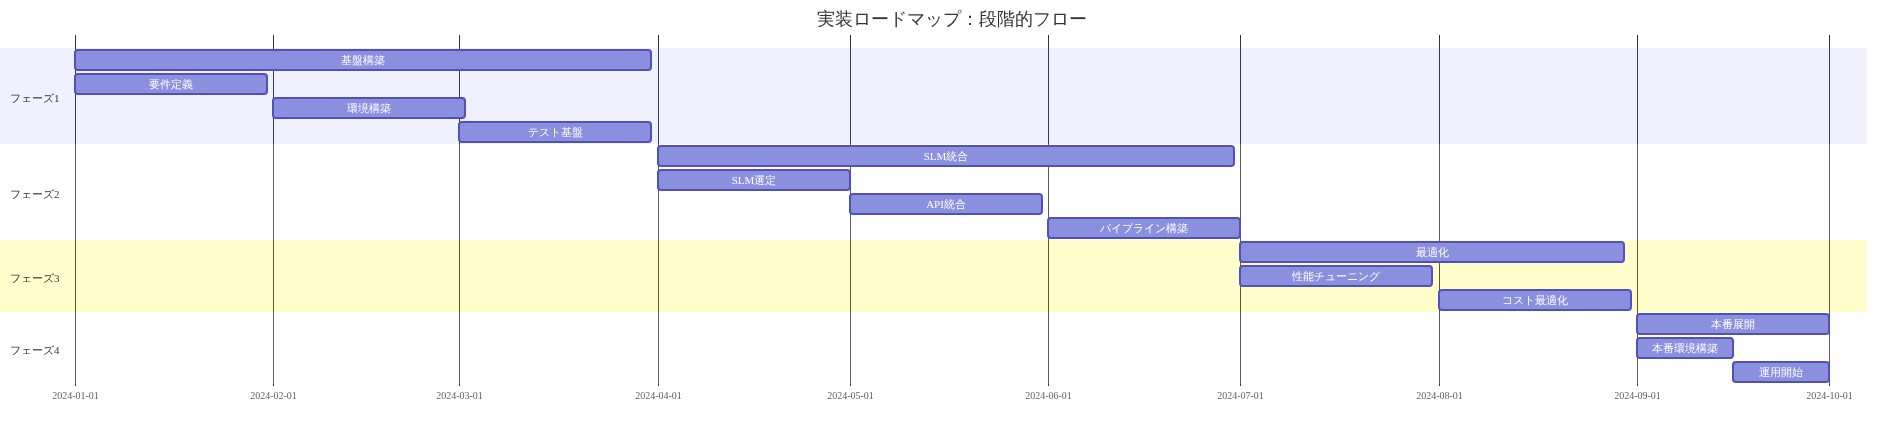
- 図11:実装ロードマップと段階的展開計画*
重要な示唆と実装への道筋
SLM条件付き階層的ルーティングは、関係性の解釈を明示的かつタスク依存的にすることで、プロパティグラフ学習における意味的ボトルネックに対処します。テキスト属性とカテゴリ属性が静的埋め込みでは捉えられない意味信号を持つ場合に、このアプローチの価値が最も高まります。
- 直ちに実行すべき施策:*
-
意味的異質性の監査: プロパティグラフを調査し、関係ラベルがタスク関連の意味をエンコードしているかを判定します。エッジタイプ全体のルーティングスコアのエントロピーを計算してください。高いエントロピーは意味的異質性が存在することを示します。
-
パイロット展開: 小規模言語モデルルーターをグラフの部分集合(エッジの10~20パーセント)でプロトタイプ化し、本格展開前に効率性と精度向上を検証します。レイテンシ、メモリ消費量、タスク性能の改善を測定してください。
-
訓練プロトコル: タスク損失と意味的一貫性目標のバランスを取るよう訓練を構成します。過学習を回避するため、交互最適化(第1段階:タスク最適化、第2段階:意味的正則化)を使用してください。
-
本番環境監視: エッジごとの計算コスト、ルーティングキャッシュのヒット率、ルーティングスコア分布を追跡します。異常(例えば、ルーティングスコアが0.5付近に集中し、意味信号が低いことを示す場合)が発生した場合はアラートを発行してください。
-
解釈可能性: t-SNEまたはUMAPを使用してルーティングパターンを可視化し、モデルが意味的に一貫した表現を学習していることを確認します。高リスク予測(例えば、詐欺事例、医薬品推奨)に対するルーティング決定を監査し、偽りのパターンを検出してください。
このアーキテクチャは、適応的グラフ学習を幾何学的構造から意味的構造へと拡張します。ネットワークがすべてのエッジを均一に扱うのではなく、「この関係性は何を意味するのか」と問い直すことを可能にします。静的な意味解釈から動的な意味解釈への転換は、関係性の意味が予測信号を持つ知識集約的なアプリケーションにおいて、実質的な前進を表しています。
本質的に問われているのは、グラフニューラルネットワークが構造的な接続性だけでなく、その接続が何を表現しているのかを理解できるかという点です。見落とされがちですが、この能力の有無が、単なる予測精度の向上を超えて、モデルの信頼性と応用可能性を根本的に左右します。