ニューラル定理証明器は、ベンチマークで強い結果を出し続けている。そのほとんどが、ある前提から出発している。目標とする問題を忠実に写した Lean 4 の命題が、すでに手元にあるという前提だ。
この前提の裏には、データの足りなさという問題が隠れている。形式化された命題がきれいにコンパイルできても、元の問題とは違うことを述べているかもしれない。
仮定が消えている。量化子が意味を失っている。
厳密な不等号が緩い不等号に変わっている。コンパイラは、そのどれも受け入れてしまう。
Sage は、このすき間に着目して作られたパイプラインだ。緑のチェックマークが出たところで仕事を終えない。
自動形式化を4つの段階に分ける。そのうえで、コンパイラに加えてもうひとつ「意味」を見る信号を使う。形式化した命題が、元の問題の言いたかったことをまだ保っているかを問うのだ。
この記事では、なぜそのすき間が生まれるのか、Sage がどう埋めようとしているのかを説明する。まだ裏づけのない部分にも触れる。同じ問題がコード生成やエージェントの安全性にも現れる理由も見ていく。
この記事のポイント
- コンパイルが通っても忠実とは限らない。 Lean の型チェッカーが確かめるのは、命題の形が整っていることだ。元の数学的な意図と合っているかは確かめられない。
- 忠実でない命題は気づかれないまま通る。 落ちた仮定、意味のない前提、ずれた境界、型の変換は、どれもエラーなしでコンパイルできる。
- 汚染は下流に広がる。 こうした命題が学習データや評価に入り込むと、証明器は出された問題より易しい問題や別の問題を解いて報われてしまう。
コンパイルが通っても間違いうる理由
Lean の型チェッカーは、いくつかの点で非常に厳しい。すべての項に型がなければならない。すべての関数に正しい引数を渡さなければならない。
参照する補題は実在していなければならない。これを通った命題は、Lean の論理における整った命題だ。
一方、型チェッカーは元の問題文をまったく見ない。教科書の問題も、コンテストの出題も、命題の出どころになった論文も、チェッカーの目には入らない。
保証できるのは、その命題が正当な命題だということまでだ。意図した命題であることは保証できない。
小さな翻訳ミスは、次のような形で数学の中身を変えてしまう。
- 仮定の欠落:定理が意図より強くなり、想定外の場合まで覆うようになる。偽になることもあれば、元の問題とは無関係な理由で証明できてしまうこともある。
- 意味のない仮定や矛盾した仮定:定理が自明に真になる。仮定が同時に成り立つことがなければ、どんな結論でも導ける。
- 境界のずれ:問題の対象とする範囲が変わる。
<が≤に、開区間が閉区間に変わると、問題が本来扱っていた端の場合が入り込んだり、抜け落ちたりする。
これらはどれもコンパイラエラーを出さない。ひとつひとつが、気づかないうちに問題を別のものにすり替えている。
被害はその場にとどまらない。自動形式化された命題は、ニューラル証明器の学習データやベンチマークに使われることが多い。そうした命題のかなりの割合が忠実でなければ、3つの問題が起こる。
- 証明器は、意図された問題より易しい命題や別の命題を証明して報われる。
- ベンチマークの点数が、本来の数学的課題での進歩を実際より大きく見せる。
- 汚染された命題はどれも正当に見えるため、あとから誤りをたどるのが難しい。
人が見直す方法は、規模が大きくなると追いつかない。
査読者は、元の問題文と Lean の命題を並べて読み、仮定、量化子、型をひとつずつ確かめなければならない。これは専門知識のいる遅い作業だ。しかも、人が見ても細かなずれは見落としやすい。
こうして、自動形式化の見方が変わる。
有効な出力の構文を作ることが目的の翻訳問題というより、意味を保つことが目的の意味合わせの問題になる。実際に問われるのは、コンパイラには見えない意味のずれを見つける、独立した信号は何かということだ。
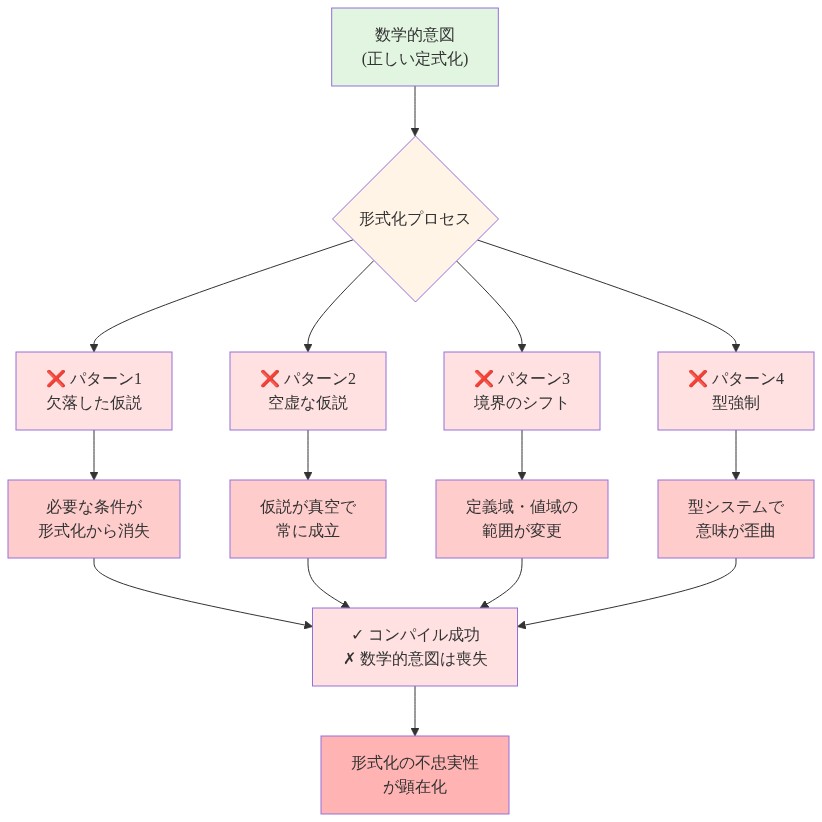
図2:非忠実な形式化における4つの典型的エラーパターンと伝播メカニズム
気づかれない失敗の分類
忠実でない形式化は、どれも同じ壊れ方をするわけではない。種類を分けておくと、コンパイラのチェックだけでは足りない理由と、2つ目のチェックが何を探すべきかが見えてくる。
次の表は、失敗の種類ごとに、Lean の命題で何が起き、数学の中身がどう変わり、なぜコンパイルでは見逃されるかをまとめたものだ。
| 失敗の種類 | Lean の命題で起きること | 数学への影響 | コンパイルで見逃される理由 |
|---|---|---|---|
| 仮定の欠落 | 正値性や相異性など、元の問題の条件が現れない | 定理が意図より強くなり、偽になったり、別の理由で証明できたりする | 仮定が少なくても型は正しい |
| 意味のない量化 | 量化子が空または退化した範囲を動く | 主張が自明に成り立ち、中身がない | 空の範囲でも型は正しい |
| 矛盾した仮定 | x > 0 と x < 0 のように、同時に成り立たない仮定 | どんな結論も導け、定理が自明に真になる | Lean は仮定の無矛盾性を調べない |
| 境界のずれ | < が ≤ になる、区間の端点が変わる | 端の場合が増減し、問題の範囲が変わる | どちらの不等式も正当な命題 |
| 型の変換 | 量が ℤ や ℝ ではなく ℕ で型付けされる、またはその逆 | 演算の振る舞いが変わり、前提が変わる | 変換は自動で挿入または受け入れられる |
型の変換は、とくに気づきにくいので、少し詳しく見ておこう。Lean の約束事が、見落としを起こしやすくしているのだ。
Lean の自然数では、引き算が切り捨てになる。3 - 5 の値は -2 ではなく 0 だ。
整数なら正しい差の命題が、自然数の上では別の主張になりうる。Lean の標準ライブラリでは、0での割り算は 0 と定義されている。
紙の上では未定義の式が、黙って数に評価されてしまう。どちらの約束事も意図的に決められたもので、文書にもきちんと書かれている。それでも、忠実に見える命題が、何の警告もなく別の定理に変わることがある。
この分類から、2つのことが言える。
ひとつ目。これらの誤りは、構文上のランダムなノイズではない。
構文としては正しいのに、意味が間違っている誤りだ。 コンパイルが通る Lean を書く力をモデルに付けても、それだけでこの誤りには届かない。
ふたつ目。誤りの分布の形によって、対策が変わる。
- 失敗がいくつかの型に集中するなら、その型を狙ったチェックで大半を捕まえられるかもしれない。たとえば、正値性の条件の欠落や、ℕ と ℤ の取り違えがそうだ。
- 失敗がさまざまな種類に散らばるなら、どんなチェックリストでも抜けが出る。もっと構造に踏み込んだやり方が必要になる。途中の推論を見える形にして、ずれがどこで起きても捕まえられるようにするのだ。
どちらの場合も、根にある問題は同じだ。
コンパイルが通る出力を作るためだけに訓練された一枚岩のモデルは、これらの失敗に目の利かない信号を最適化している。その信号を使った訓練を重ねても、信号に見えない問題は直りにくい。
最初の一歩は、問題を目に見えるようにすることだ。
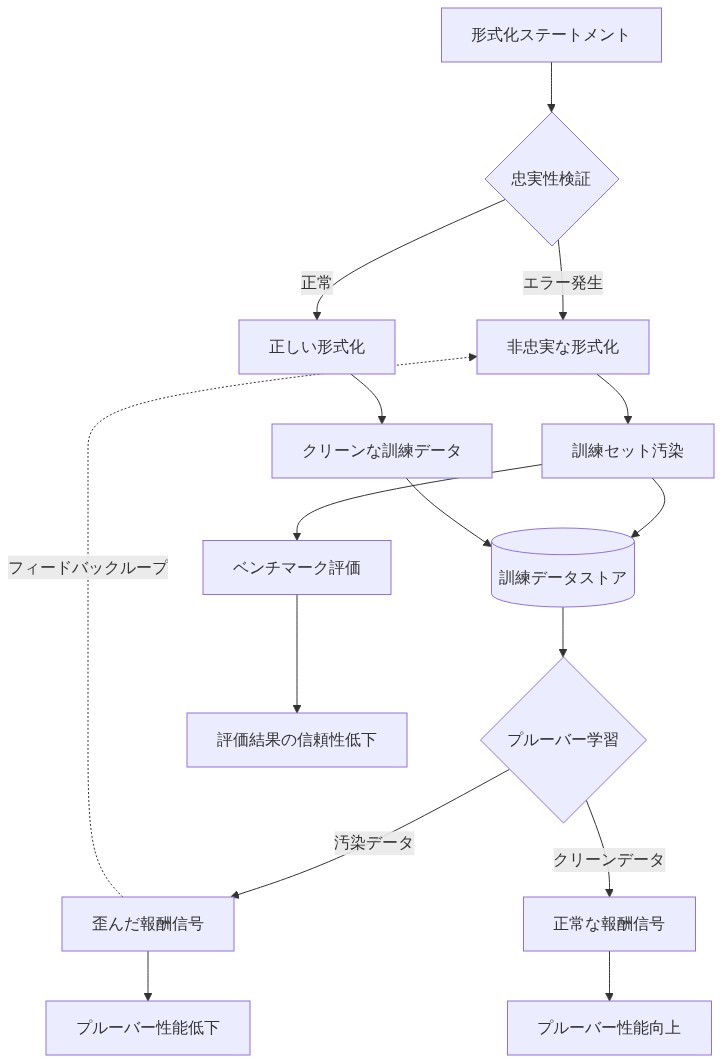
図4:非忠実ステートメントの汚染伝播フロー(3段階の影響メカニズム)
Sage の4段階パイプラインの中身
Sage は、一度で訳しきるやり方をやめて、段階に分けたパイプラインを採る。各段階の役割は狭く、それぞれが単独で調べられる成果物を出す。
- 理解:元の問題文を読み、中心となる主張と仮定を取り出す。出力は、問題が何を主張し、どんな条件のもとで成り立つのかを書き出した一覧だ。
- 構造化:主張を論理的な依存関係に整理し、定理の形を見きわめる。どの変数が量化され、どの条件が仮定で、結論が何かを決める。
- 形式化:Lean の構文に踏み込む。型を選び、Mathlib の定義を選び、命題を書く。
- 検証:結果を2つの面から確かめる。コンパイルが通るか、そして元の問題と意味が変わっていないか。
次の表は、各段階が何を出力し、どこで誤りうるかを示したものだ。
| 段階 | 主な出力 | よくある誤り | 見つけ方 |
|---|---|---|---|
| 理解 | 主張と仮定の一覧 | 問題の読み違い、暗黙の条件の見落とし | 検証時に一覧を元の問題文と突き合わせる |
| 構造化 | 定理の論理的な骨組み | 量化子の順序の誤り、結論の一部として置かれた仮定 | 元の命題との意味チェック |
| 形式化 | Lean 4 の命題 | 型の誤り(ℕ、ℤ、ℝ)、ライブラリ定義の誤り、境界のずれ | 構文はコンパイラ、意味は意味チェック |
| 検証 | 合否と指摘 | 本物のずれの見逃し、偽のずれの指摘 | 意味チェッカーの質しだい |
なぜ分けるのか
一度で訳すやり方では、読む、組み立てる、書くという作業がひとつの見えない工程に押し込まれる。出力が間違っていても、どの部分が失敗したのかは分からない。
分解すると、3つの点が変わる。
- 責任の所在が絞れる。 理解の段階で仮定を見落としたなら、そのすき間は最終的な Lean のコードだけでなく、仮定の一覧にも現れる。形式化の段階で間違ったライブラリ定義を選んだなら、構造化した骨組みと Lean の命題のずれが、その段階を指し示す。
- 指摘が具体的になる。 検証役は「手順1で出た
nの正値性の条件が、Lean の命題にない」と言える。「これは間違いだ、もう一度やり直せ」よりも、生成側にはるかに役立つ。 - 成果物を監査できる。 人間の査読者は、仮定の一覧と論理の骨組みを確認できる。どちらも、最終的な Lean のコードより短く、自然言語に近い。
分解のコスト
このやり方には、現実のトレードオフがある。
- 待ち時間。 4つの段階に加えて修正の往復があるので、一度生成するだけのやり方より時間がかかる。
- 誤りの伝播。 理解の段階で読み違えると、その誤りがあとの段階にそのまま持ち込まれる。分解が役に立つのは、検証が最終的な命題を前の段階の出力とだけでなく、元の問題文と突き合わせる場合に限られる。
- 部品の増加。 段階の境目は、どれも情報が落ちたり、言い換えられたりしうる新しい接点になる。
つまり、待ち時間と複雑さを払って、監査のしやすさを得る取引だ。それが割に合うかどうかは、検証段階がどこまでうまく働くかにかかっている。
2つの信号による修正ループ
Sage の検証段階は、性質のまったく違う2つの信号を組み合わせる。
次の表は、コンパイラの信号と意味の信号を比べたものだ。
| 性質 | コンパイラの信号 | 意味の信号 |
|---|---|---|
| 何を調べるか | 構文と型の整合性 | 形式化した命題が元の意味を保っているか |
| 仕組み | Lean の型チェッカー | モデルによる、形式の命題と元の命題の比較 |
| 速さ | 速い | 遅い |
| 決定性 | 決定的で再現できる | 確率的で、判断がぶれうる |
| 信頼性 | 調べる範囲では非常に高い | それ自体は形式的に検証されていない |
| 死角 | 意味のずれ | 型レベルやライブラリ固有の細かな問題を見逃す可能性 |
どちらの信号も、単独では足りない。
コンパイラは意味を見られない。意味チェッカーは、命題が整っていることを保証できず、完全に信頼できるわけでもない。 組み合わせることで、お互いの死角を補い合える。
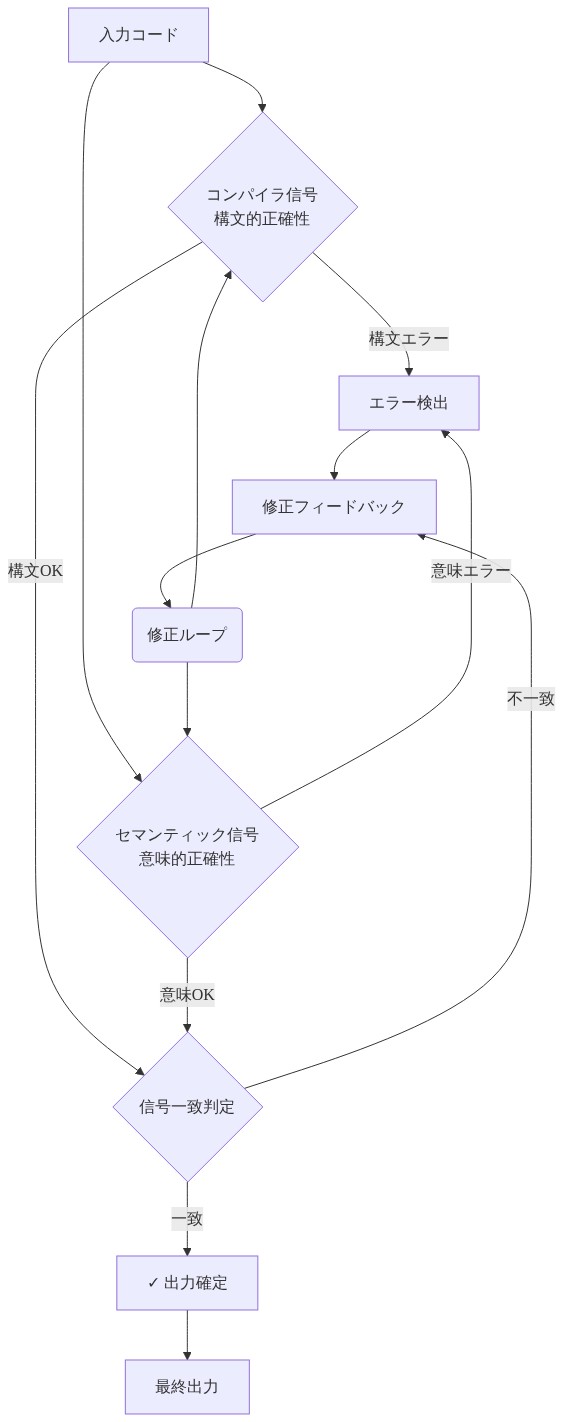
図6:デュアル信号補正ループのメカニズム
ループの動き
修正ループは、5つの手順で動く。
- 構造化した骨組みから、Lean の命題の候補を生成する。
- コンパイラを走らせる。失敗したら、エラーを生成側に返す。
- コンパイルが通れば、元の問題文に対して意味チェックを走らせる。
- 意味チェックがずれを見つけたら、具体的な問題を名指しした的を絞った指摘を作る。仮定の欠落、境界のずれ、型の誤りなどだ。
- 指摘を生成側に戻して、2つの信号が通るか、停止の条件に達するまで繰り返す。
肝になる設計は、手順4だ。ただ再サンプリングするやり方は、もう一度生成して当たりを期待するだけで、失敗をすべてノイズとして扱う。
的を絞った指摘は、失敗を情報として扱う。「元の問題では x は実数だが、命題では ℕ が使われている」という指摘は、生成側に直すべき具体的な点を渡せる。
ループをめぐる未解決の問い
ループの論理は、原理としては筋が通っている。実際にうまく働くかどうかは、いくつかの問いにかかっている。
- 循環した検証。 意味チェッカーと生成側が似たモデル、あるいは同じモデルなら、間違った理由で互いに賛成してしまうかもしれない。生成側と同じ読み違いを元の問題文に対して犯し、そのせいで命題を承認することがありうる。
- 相関した死角。 現在の言語モデルのどれにとっても見つけにくい誤りがあるかもしれない。ℕ の引き算の細かな振る舞いや、ライブラリ固有の定義がその例だ。生成側とチェッカーの両方が見逃せば、ループはそれらを素通りさせる。
- 終了条件。 ループには止め方が必要だ。回数が少なすぎると、直せる誤りが残る。多すぎると計算が無駄になり、生成側が直しすぎて元の問題からさらに離れていく恐れがある。
- 偽陽性。 チェッカーがずれを積極的に指摘しすぎると、生成側を正しい形式化から遠ざけてしまいかねない。問題に複数の正当な形式的な読み方がある場合は、とくに影響が大きい。
何が決め手になるか
ループが忠実さのすき間を本当に狭めていると示すには、2種類の結果が必要だ。
- 忠実さそのもの。 2つの信号を両方通った命題は、コンパイルだけを通った命題よりも、独立した専門家の査読者に忠実と判断される割合が高いはずだ。
- 下流での価値。 2つの信号で検証された命題で訓練または評価された証明器は、コンパイルだけを通したデータで訓練された証明器より、忠実に形式化された保留問題で良い成績を出すはずだ。
この両方の結果がなければ、ループは、実証された改善というより、もっともらしい設計にとどまる。
命題の忠実さが Lean の外でも問われる理由
Sage が扱うのは形式数学だが、取り組んでいる問題は一般的なものだ。ゆるく述べられた人間の意図を、機械が検証できる成果物に変えなければならない。その翻訳がずれれば、下流のすべてがそのずれを受け継ぐ。
コード生成にある同じすき間
ソフトウェアの道具にも、よく似た構図がある。軽量な仕様フレームワークは、開発者の意図を Git ベースの仕様として形式化し、コード生成に使う。
開発者が望むことを、コード生成器が従え、レビュー担当者が確認できる形にしようとするものだ。
リスクの構造は、2つの分野で同じだ。次の表で対応を見てみよう。
| 形式数学 | コード生成 | |
|---|---|---|
| 非形式的な意図 | 自然言語で書かれた問題 | 機能要望や要件 |
| 形式的な成果物 | Lean 4 の定理の命題 | 仕様 |
| 下流の解き手 | 定理証明器 | コード生成器 |
| 仕様を読み違えた結果 | 間違った定理の正しい証明 | 動くが、間違ったことをするコード |
| いちばん弱い環 | 命題 | 仕様 |
どちらの場合も、解き手が優秀でも、仕様が間違っていれば出力は間違いになる。どちらの分野でも、Sage が取る2つの手が役に立つ。
翻訳を点検できる段階に分けること、そして構造が正しいかどうかに頼らず、意味を明示的に確かめることだ。
数学には、ひとつ大きな違いがある。数学の正解は、とりわけ容赦がない。
Lean の証明は、通るか通らないかのどちらかで、部分的な正しさは存在しない。そのため、数学では忠実さの誤りがはっきり目立つ。
間違って述べられた定理の完璧な証明は、やはり間違ったものの完璧な証明だ。
エージェントの安全性にある同じすき間
AI システムがより自律的な仕事を担うようになるにつれて、この問題は鋭さを増している。安全性への懸念は、エージェントシステムにとって厳密な形式検証がなぜ重要かを浮き彫りにする。
形式検証は、強い保証として語られることが多い。ある性質を証明すれば、それが成り立つと分かる、というわけだ。
Sage の中心的な観察は、この保証の限界を示している。検証された性質は、その仕様と同じ程度にしか意味を持たない。
- 安全上の制約が、条件の欠けた形で形式化されていれば、システムは検証された性質を満たしながら、意図した性質を破りうる。
- 制約の前提が実際には決して成り立たなければ、その制約は意味を持たず、証明は何も保証しない。
- 形式化の途中で境界がずれれば、検証された範囲は、誰も意図しなかった範囲かもしれない。
これらは、上の分類に出てきた失敗と同じ種類のものが、コンテストの数学からシステムの振る舞いへ場所を移したものだ。
意味の監査は、検証されたシステムにとって、あってもなくてもよい余計な作業ではない。検証を信頼に足るものにする要素のひとつなのだ。
忠実な形式化が実現したら何が変わるか、そして今できること
文の忠実さを確実に高められれば、効果はベンチマークがきれいになる程度では終わらない。
よい訓練データ、信頼できる評価、大規模なデジタル化の道がそろって開ける。ただし、いくつかの障害を先に越える必要がある。
この節のポイント
- 忠実な形式化なら、ニューラル証明器は本来の問題どおりの文から学べる。報酬の信号も、数学としての本当の難しさとそろう。
- 行く手には難題がある。モデルの判断は間違えうる。非形式の数学はあいまいなことが多い。忠実さの評価にはお金がかかる。
- Sage の最大の貢献は、概念面にあるかもしれない。文の忠実さは、目に見えない負債から、名前をつけて測り、改善できるものに変わる。
なぜ訓練データがよくなると大事なのか
ニューラル証明器は、与えられた文から学ぶ。その文に問題があるとどうなるだろうか。
仮定が抜けていたり、範囲がずれていたり、数の型が無理に変えられていたりすると、報酬の信号が実際の問題からずれてしまう。証明器は、意図された問題より易しい別の問題を解くことを覚える。
忠実な形式化なら、この問題を根っこで断てる。文が元の非形式の問題に十分近ければ、その文で訓練することで、仕様の誤りを突く技ではなく、本物の数学的推論を学べる。
なぜ評価がより正直になるのか
ベンチマークの成績が上がる理由は、2つ考えられる。1つは、証明を見つける力が本当に伸びたこと。
もう1つは、易しく言い換えられた誤った問題へ寄っていったことだ。文が忠実でないと、どちらが起きているのか見分けにくい。
忠実さを測れば、本当の進歩と見かけ上の成績を切り分けられる。 忠実さを確認した文で正答率が5ポイント上がった証明器は、実際に力をつけた可能性が高い。
確認していない文で5ポイント上がった証明器は、専門家なら見抜く仕様の誤りを突いているだけかもしれない。
なぜ大規模なデジタル化が現実的になるのか
非形式の数学を形式化したライブラリに変えるには、費用がかかる。すべての文を人の手で確かめなければならないからだ。
もし第2のモデルや信号を使って、よくある誤りを半自動で拾い、忠実さを確かめられるなら、この詰まりはゆるむ。
専門家の確認がいらなくなるわけではない。その役目が変わる。専門家は全行を点検する代わりに、忠実さを確かめる仕組みそのものの調整に力を注ぐことになる。
残っている障害
この見通しと現実のあいだには、いくつかの難題がある。
| 未解決の問題 | なぜ重要か |
|---|---|
| モデルの判断は間違えうる | 第2の信号も誤りを含む。その誤りは、コンパイラの誤りより見つけにくい |
| 非形式の数学はあいまい | 正しい形式化が複数ある問題もある。「忠実でない」とは言い切れない場合がある |
| 競技問題と研究の文章は違う | 短く自己完結した問題は、文脈や暗黙の約束事に頼る論文より形式化しやすい |
| 忠実さの評価は高くつく | 文が忠実か測るには、少なくとも調整の段階で専門家の確認が要る |
最初の障害が、いちばん見えにくい。コンパイラがコードを拒めば、誤りは目に見える。
ところが、モデルが「この形式化は忠実でない」と判断したとき、その判断自体が間違っているかもしれない。誤りは構文エラーではなく意味についての主張に宿るので、見逃されやすい。
Sage の貢献は何か
Sage の主な貢献は、技術面と同じくらい概念面にあるかもしれない。文の忠実さは、目に見えない負債から、名前をつけて測り、改善できるものに変わる。これが通用するかどうかは、3つの試験で決まる。
- 二重の信号で検証した文は、独立した専門家の確認に耐えるか。
- その文から、証明器のためのよりよい訓練データと、より正直なベンチマークが生まれるか。
- 選び抜いた問題から、現実の数学の文献へと規模を広げられるか。
答えがよいものなら、分解と二重の信号を使う自動形式化は、意味のある前進になる。答えが弱ければ、筋は通っていても大規模にはうまくいかなかった設計にとどまる。
今できること
- 「コンパイルできる」は必要条件であって、十分条件ではないと考える。 自動形式化した文を使うときや公開するときは、型が通ったかどうかだけでなく、忠実さをどう確かめたかも記録する。
- 既知の失敗の型を点検する。 サンプルを調べ、仮定の抜け、矛盾した仮定や中身のない仮定、範囲のずれ、ℕ・ℤ・ℝの型の強制変換を探す。切り捨てられる引き算や、0での割り算も含める。
- 途中の成果物を残す。 形式化や仕様作成のパイプラインを作るなら、最終的な出力のそばに、仮定の一覧と論理の骨組みも保存する。誤りが入った段階をさかのぼれるようにするためだ。
- チェックする側の相関を下げる。 モデルが別のモデルの出力を確かめるなら、異なるモデルやプロンプトを使う。そして、ときどき人間の専門家の確認と突き合わせて調整する。
- ベンチマークの主張は、データの出どころを意識して読む。 証明器が成績の向上を報告したら、訓練用と評価用の文がどう検証されたかを確かめてから、本当の進歩かどうか判断する。
ちょっと立ち止まって
証明支援系ソフトは、めったにない確かさを与えてくれる。証明が通れば、それは正しい。Sage が思い出させるのは、その確かさが及ぶのは、私たちが実際に立てた問いまでだということだ。
難しいのは、答えを出すことより、問いを忠実に述べることかもしれない。条件を1つも落とさず、範囲をずらさず、数の型も正しく保つ。
競技問題でも、ソフトウェアの仕様でも、自律システムの安全規則でも、事情は同じだ。
検証済みの結果を信じる前に、考えてみたい。それは、どんな文に対して検証されたのだろうか。その文が私たちの意図どおりかどうかは、誰が確かめたのだろうか。
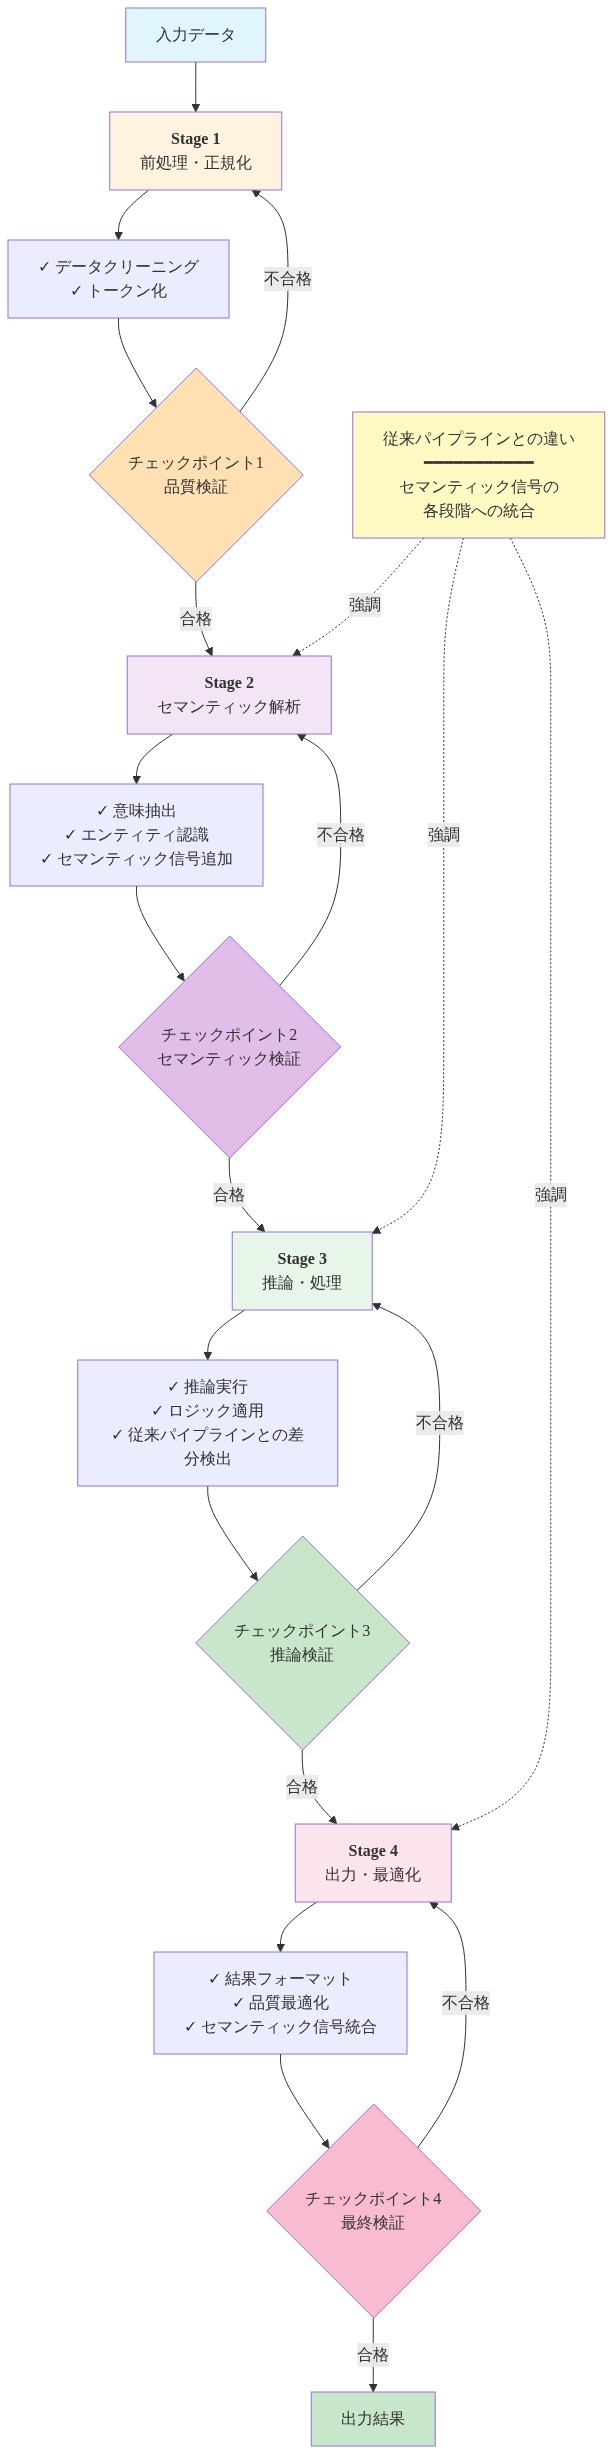
図5:Sageの4段階パイプラインアーキテクチャ

図10:忠実な形式化がもたらす潜在的利益と具体的な効果