知識追跡モデルは、生徒が次の問題に正解するかどうかを予測する。適応型学習システムの中核を、長く担ってきた技術だ。ところが、先生が画面で「正解の確率62%」と見ても、何をすればよいのかは分からない。
補習が必要なのか。ペースを変えるべきなのか。
今すぐ誰かが声をかけるべきなのか。確率の数字だけでは、どれも答えられない。
ある研究は、これを「検証」の問題として扱う。モデルに説明を付け足して終わりにはしない。その説明が吟味に耐えられるかを問う。
先生が見慣れた行動の特徴から、読み解きやすいモデルをつくる。そのうえで、精度、安定性、忠実性という3つのテストを組み合わせて、説明を確かめる。
この記事のポイント
- 説明のない予測は、先生が動く手がかりにならない。精度が高いだけでは、信頼できるモデルとは言えない。
- 説明の質は測れる。予測の強さとは別のところで、独自の壊れ方をする。
- 検証では3つを同時に問う。精度は十分か。再学習しても説明は安定しているか。目立つ特徴を外すと、本当に性能が落ちるか。
確率の数字だけでは、先生は動けない
知識追跡モデルは、生徒が取り組んだ問題の流れを見て、次の問題に成功する確率を見積もる。予報としては役に立つ。しかし、指針としては心もとない。
先生は具体的な選択を迫られる。誰を呼んで話すのか。
どの単元を復習するのか。いつなら、生徒が苦戦しているのを見守ってよいのか。
確率は、モデルの判断の中身をすべて1つの数字に押し込めてしまう。 その数字が高い理由も低い理由も、見えなくなる。
こうした透明性の問題は、AI全般に共通している。教育向けのモデルにも同じ要請がある。説明は、それに頼る人が実際に使える形でなければならない。
ただし、説明にも危うさがある。精度の高いモデルが、あてにならない説明を出すことがある。精度は、信頼性の代わりにはならない。
説明が失敗するやり方は、おもに2つある。
| 失敗の型 | どう見えるか |
|---|---|
| 忠実でない順位 | 特徴の順位は毎回同じだが、モデルが実際に頼っているものを映していない |
| 不安定な順位 | 再学習のたびに、目立つ特徴が入れ替わる |
どちらも、高い精度の裏に隠れうる。画面には自信ありげな予測ともっともらしい理由のリストが並ぶ。それでもリストは間違っているかもしれない。
先生には、行動の根拠にできる説明と、納得できそうに見えるだけの説明を見分ける方法が必要だ。以下の検証手順は、そのためにつくられた。
互いに確かめ合う3つのテスト
説明可能性の研究の多くは、性質を1つずつ調べる。このやり方だと、強みの陰に弱点が隠れてしまう。
精度が高ければ信頼できそうに見える。説明が安定していれば正しそうに見える。
この手順は3つの研究課題を結びつけ、お互いを確かめ合うようにしている。
| 問い | 調べること | 先生にとっての意味 |
|---|---|---|
| RQ1:精度で張り合えるか | 読み解きやすいモデルは、中身の見えないモデルと同じ予測力を持てるか | 読みやすさのために精度を大きく失うなら、説明は学校が手を出せない贅沢品になる |
| RQ2:説明は安定しているか | 乱数の種やデータの分け方を変えても、特徴の順位は保たれるか | 順位が大きく入れ替わるなら、1回の順位は逸話にすぎない |
| RQ3:再学習による忠実性 | 重要とされた特徴を外して再学習すると、性能は下がるか | 性能が変わらないなら、その「重要な」特徴は固有の情報を持っていなかった |
1つのテストに通るだけなら、むずかしくない。3つすべてに通るのが、むずかしい。
- 精度は高いが不安定。 予測はよく当たるが、再学習のたびに説明が変わる。
- 安定しているが誤解を招く。 説明は毎回同じだが、モデルに必要のない特徴を指している。
- 忠実だが力不足。 説明は正直だが、モデルが弱すぎて実際には使えない。
3つを同時に求めると、擁護できる説明の範囲が狭まる。その分、先生は直感ではなく筋の通った根拠で信頼を置ける。
忠実性のテストは、よくある方法とは違う。単純な摂動テストは、特徴を書き換えたり空にしたりして、予測がどう動くかを見る。するとモデルは、学習で見たことのない入力に出会う。
性能が落ちても、情報が失われたからではなく、モデルが戸惑ったからかもしれない。再学習なら、この問題を避けられる。特徴が欠けた状態にモデルを先になじませてから、性能を比べるからだ。
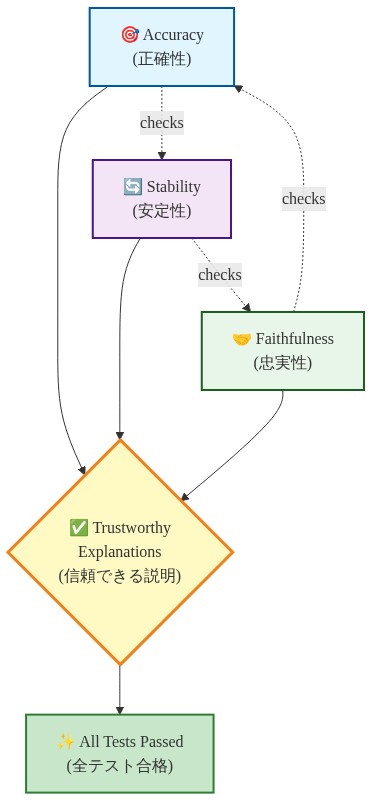
図4:3つの検証テストの相互関係と信頼できる説明の生成フロー
先生が見慣れた特徴をつくる
深層学習による知識追跡モデルの多くは、問題の埋め込み表現から学ぶ。人にとっては直接の意味を持たない、密なベクトルだ。埋め込みの上につくった説明は、その分かりにくさを受け継ぎやすい。
この研究は別の道を選んだ。ASSISTments 2009と2012のデータセットから、13個の行動特徴を設計した。特徴は、教育上の5つのテーマにまとめられている。
| テーマ | 何をとらえるか | 先生が尋ねそうなこと |
|---|---|---|
| 粘り強さ | 困難のなかで取り組みを続ける様子 | 早々にあきらめているのか、踏ん張っているのか |
| 助けを求める行動 | ヒントや支援の使い方 | 助けを求めているか、求めるならいつか |
| 回答の速さ | 答えるまでの早さ | 急いで答えているのか、考えて答えているのか |
| 問題の難しさ | 問題そのものの難度 | つまずきの原因は生徒か、教材か |
| 回答のタイミングの型 | やりとり全体のリズムや間合い | 取り組みは安定しているか、波があるか |
特徴が身近な考え方に対応していれば、説明は最初から読み解ける形になる。 粘り強さの特徴が上位に挙がれば、先生はそれを手がかりに考え、動ける。
見慣れた特徴であっても、説明が正しいとは限らない。読みやすくなるだけで、正しさとは別の話だ。その2つ目の段階を受け持つのが、安定性と忠実性のテストである。
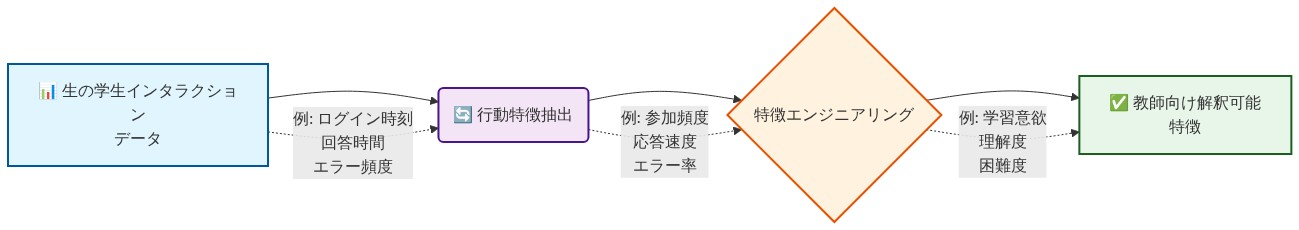
図6:教師が認識できる特徴の構築プロセス(Article methodology)
時間の順序を守る
時間の扱いは、誰にも気づかれずにモデルがズルをしやすい場所の1つだ。予測の時点より後の情報を、特徴がこっそり使っていたらどうなるか。モデルは、実際のシステムにはありえないほど賢く見える。
この研究は、明確なルールでそれを防いでいる。
| 特徴の種類 | 情報の出どころ | 実際のシステムで使えるか | 役割 |
|---|---|---|---|
| 履歴の特徴 | 予測対象より前のやりとりだけ | 使える | 予測と説明 |
| 今回の回答の所要時間 | 予測しようとしている回答そのもの | 使えない | 事後の分析だけ |
履歴の特徴は過去だけを見るので、未来からの情報の漏れ込みを防げる。今回の回答の所要時間は、事後の分析用に残してある。実際の学習支援システムは、予測を出す時点でその値を持っていないからだ。
こうすれば、説明は実際のシステムが知りえた情報に正直なままでいられる。事後の特徴は、学習行動を振り返る分析を深めてくれる。ただし、運用中のモデルが使える信号とは取り違えない。
安定性:説明は繰り返し現れなければならない
再現できなければ、説明は役に立たない。乱数の初期値やデータの分け方を変えるたびに特徴の順位が変わるなら、1回の順位からはほとんど何も分からない。発見というより、逸話に近い。
行動データでは、これがさらにむずかしくなる。多くの指標が互いに相関しているからだ。たとえば、粘り強さと助けを求める行動は、一緒に現れやすい。
相関があると、貢献の割り振りがあいまいになる。
モデルはどちらの信号に頼っても、混ぜて頼っても、ほぼ同じ精度に届く。どちらを選ぶかは、乱数の種やデータの分け方で変わりうる。モデルの性能は同じなのに、実行のたびに説明が変わってしまう。
安定性の問いは、モデルがある信号に頼っているのが本物か偶然かを確かめることにほかならない。
この節のポイント
- 学習のたびに変わる説明は、精度が同じでも信頼できない。
- 順位ベースの指標と大きさベースの指標は、食い違うことがある。それぞれ別の種類のずれを捉える。
- 安定性だけでは、説明が正しいことの証明にならない。再現できると分かるだけだ。
順位と大きさ
安定性は、複数のやり方で測れる。そして、その結果は食い違うことがある。
| 指標の種類 | 何を追うか | 見逃しうること |
|---|---|---|
| 順位ベース | 特徴同士の相対的な順番が保たれるか | 重要度の大きな変動 |
| 大きさベース | 重要度のスコアが近いままか | スコアが近い特徴同士の入れ替わり |
順位は保たれていても、重要度のスコアは大きく揺れるかもしれない。逆に、スコアは安定していても、近くの特徴と順番を入れ替えるかもしれない。先生にとっては、どちらの型かで意味が違う。
ある特徴が首位を保ちながら重みが揺れるなら、大づかみの結論は変わらない。その特徴がいちばん重要だ、ということだ。変わるのは細部、つまりどれくらい重要かである。
スコアの近い2つの特徴が入れ替わり続けるなら、両者は互いの代役にすぎないのかもしれない。モデルは、どちらを使ってもよい。
どれだけ一致すれば十分か
先生が傾向を信じるには、どれだけの一致が必要なのか。万能の基準はない。この手順では、これを実験で確かめる問いとして扱う。
ばらつきがどこから、ただの揺らぎではなくあてにならない状態に変わるのかを調べる。
再学習しても説明が保たれるなら、先生は、1回の学習のたまたまの癖ではなくモデル自体の性質を見ているのだと、より安心できる。
安定性だけでは、説明が真実だとは示せない。再現できると示すだけだ。真実かどうかを試す前に、まずそれが必要になる。
忠実性:特徴を外すと本当に影響が出るか
安定性が示すのは、説明が繰り返し現れることだ。忠実性が問うのは、説明が正しいかどうかである。再学習を使ったテストなら、これを直接確かめられる。
- すべての特徴でモデルを学習させ、性能を記録する。
- 説明手法で、特徴を重要度の順に並べる。
- 重要度が高いとされた特徴を取り除く。
- それらを使わずに、モデルを最初から学習し直す。
- 元のモデルと比べて、性能がどれだけ落ちたかを測る。
上位の特徴を外して性能が明らかに落ちるなら、その特徴はモデルに必要な情報を持っていたことになる。性能がほとんど変わらないなら、説明はその重要性を実際より大きく見せていた。
再学習は、単純な摂動テストの知られた欠点を解消する。学習で見たことのない書き換えた入力でテストされたモデルは、特徴の重要性とは関係ない理由で失敗しうる。再学習すれば、モデルは欠けた特徴に適応する。
それでも残る性能の低下は、その特徴だけが提供していた情報を示している。
相関の問題が戻ってくる
相関のある特徴があると、忠実性の結果は読みにくくなる。2つの特徴が密接に結びついているとき、片方を外しても、あまり響かないことがある。
再学習したモデルが、もう片方に頼るからだ。性能があまり落ちなかったことは、元の行動が無関係だという意味ではない。その情報が、その特徴だけのものではなかったという意味だ。
だから、忠実性の結果は安定性の結果と並べて読む必要がある。安定していても忠実でない特徴は、冗長なのかもしれない。
相関のある別の特徴で、モデルが代わりを務められる。忠実でも不安定な特徴には、本物の情報があるかもしれない。ただし、その貢献の割り振りはあてにならない。
| 安定か | 忠実か | 説明の扱い方 |
|---|---|---|
| はい | はい | 頑健で意味のある説明。行動の根拠にしてよい |
| はい | いいえ | 一貫しているが冗長かもしれない。仮説として扱う |
| いいえ | はい | 情報は重要だが、貢献の割り振りがあてにならない。個々の特徴でなく、テーマ全体を見る |
| いいえ | いいえ | 判断の根拠にならない |
両方のテストに通った特徴は、頑健で意味のある説明と言える。どちらかに落ちた特徴は、結論でなく仮説として扱うべきだ。
先生がどこまで結論づけられるか、どう使うか
この研究は、素朴な問いを検証している。読み解きやすい特徴を使うと、予測力を犠牲にすることになるのか。
分かりやすい行動の信号でつくったモデルが、中身の見えないモデルと同じ精度を出せるなら、ブラックボックスを擁護する定番の議論は弱まる。
先生は、よく当たるモデルと理解できるモデルのどちらかを選ばされなくて済む。
より深い発見は、信頼の度合いを調整することにある。安定していて忠実な説明は、判断の手がかりにしてよい。 どちらかのテストに落ちる説明は、行動の根拠でなく仮説にとどめるべきだ。
この考え方は、教育の外にも広がる。AIツールを使う人は、その出力に疑問を向ける力を持ち続ける必要がある。
検証の手順は、そのための構造化された方法を与えてくれる。手順がないと、人は次のどちらかの極端に流れやすい。
- 鵜呑みにする。 画面に出ているというだけで、強調された特徴をすべて受け入れる。
- すべてを疑う。 一部の説明が間違っていたからと、説明を全部退ける。
どちらも、生徒のためにならない。信頼の度合いを調整するのは、この両極のあいだだ。それは、個々の説明についての証拠にもとづく。
事後の特徴の扱いにも、独自の意味がある。今回の回答の所要時間は、授業が終わったあとで何が起きたかを説明する助けになる。
しかしこの研究は、それを運用中のシステムが事前に使える信号とは数えない。先生は、学習行動のより広い全体像を得ながら、予測を出す時点で実際に使える情報が何かを見失わずにいられる。
この方法が他の教育データセットやモデルにも広がるかもしれない。どこまで通用するかは、そうしたデータセットが教育的な根拠のある似た特徴を支えられるかと、特徴同士の相関の強さにかかっている。
うまく一般化できれば、教育向けAIシステムへの信頼を評価する、繰り返し使える基準になるかもしれない。
この発見の使い方
-
スコアだけでなく説明を求める。 適応型学習ツールを評価するときは、モデルの予測が何に基づいているかを尋ねる。中身の見えない重み付けより、粘り強さ、助けを求める行動、間違いの型のように、見慣れた行動に対応する説明のあるツールを選ぶ。
-
説明が検証されたかを尋ねる。 モデルを再学習しても特徴の順位が安定しているか。上位の特徴を外すと、性能が実際に落ちるか。精度の数字だけでは、これらの問いに答えられない。
-
1つだけ示された特徴には慎重になる。 ツールが1つの行動を強調していたら、関連する行動も考えてみる。特徴同士に相関があるときは、個々の信号より、その背後にあるテーマのほうが重要なことが多い。
-
振り返りと予測を分ける。 レポートが今回の回答のデータ、たとえば生徒がその問題に費やした時間を使っているなら、次に何が起きるかの予報でなく、何があったかの説明として読む。
-
自分の判断を手放さない。 安定性と忠実性の両方のテストに通った説明は、その生徒について先生が知っていることと照らし合わせる証拠として使う。それ以外は、自動的に行動の根拠にせず、授業のなかで確かめるべきことと考える。
ちょっと立ち止まって
最近、1つの数字が生徒についての判断を左右したことを思い出してみてほしい。テストの点数、進捗の表示、リスクを示す旗かもしれない。その数字がなぜその値になったのか、あなたは知っていただろうか。
もしその理由が、不安定だったり誤りだったりすると分かっていたら、違う行動をとっていただろうか。
よい説明は、あなたの判断に取って代わるものではない。判断が拠って立つ、確かな足場を与えてくれる。いま頼っている信号のうち、本当にその信頼に値するものはどれだろうか。
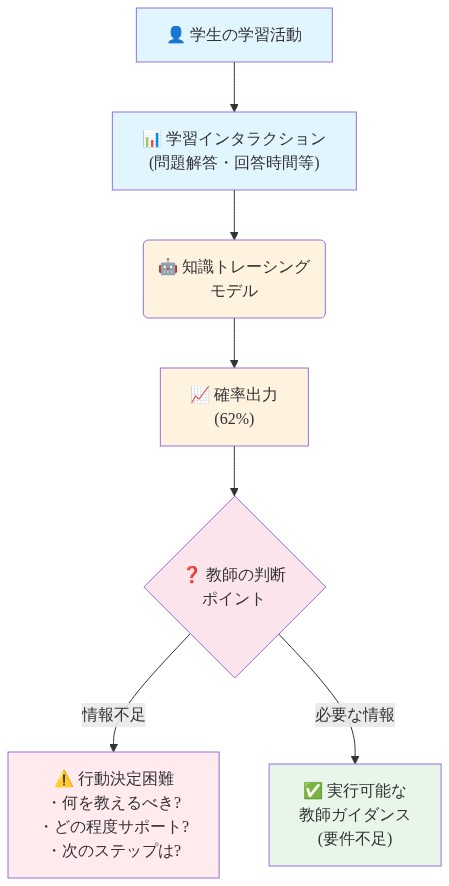
図2:知識トレーシングモデルから教師の行動への流れ—確率出力と実行可能なガイダンスの間のギャップ
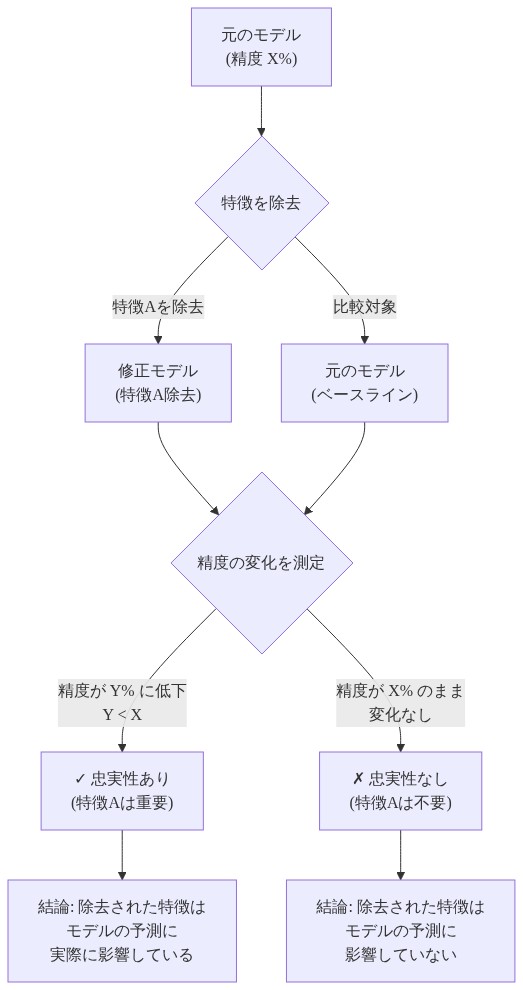
図10:特徴除去実験による忠実性の検証(アブレーション研究の論理)
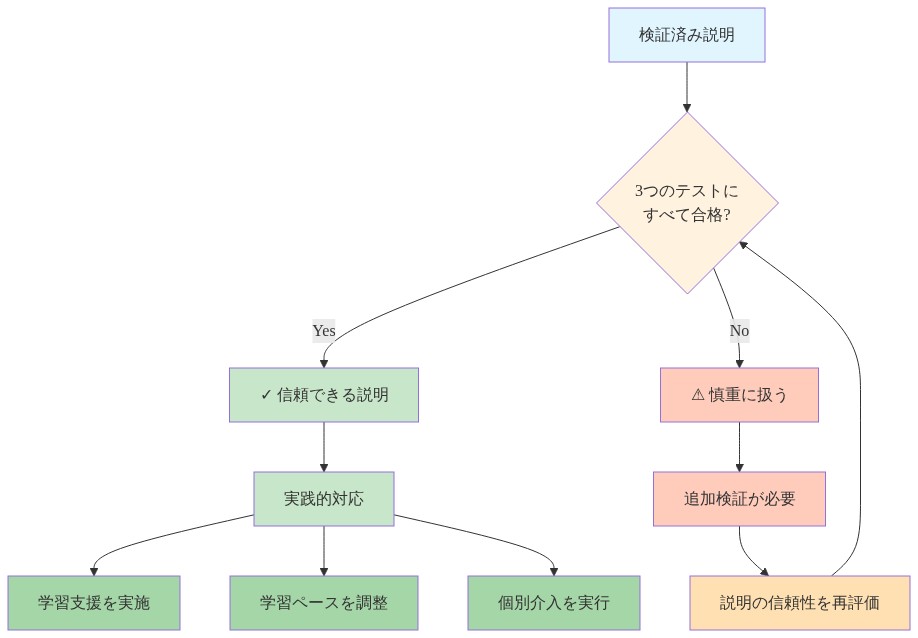
図12:検証済み説明に基づく教師の意思決定フロー(Article guidance framework)