オープンウェイトAIの話は、よく「ダビデとゴリアテ」の物語として語られる。資金力のある閉じた研究所に、小さなコミュニティが挑む構図だ。だが実際には、もっと入り組んでいる。
オープンモデルの力は、いくつもの門番に分かれている。中国の研究所は、強力なMixture-of-Experts(専門家混合)モデルを、制限の緩いライセンスで公開している。
Metaは、Llamaのあとも公開を続けるのかがはっきりしない。
アメリカの取り組みもいくつか続いているが、慎重な姿勢が目立つ。何千人ものファインチューナーが、実際に使えるモデルを選び分けている。そのすべての下には、チップとクラウドの計算資源を握る企業がいる。
ペースを決める単独の主役はいない。影響力はいくつもの軸に沿って動き、それらはなかなかそろわない。技術的には劣るのに、広く使われるモデルがある。
書類の上では「オープン」でも、ライセンスの条件やハードウェアの要件のせいで、実際には閉じているモデルもある。
それでも、重心は動いた。制限の緩いライセンスで公開されている強力なモデルの多くは、いまや中国の研究所から出ている。
アメリカのオープンな取り組みは、まだ散らばったままだ。この差は、思想の違いというより、動機の違いから生まれている。
この記事のポイント
- オープンモデルの力は、中国の研究所、Meta、アメリカの小さな取り組み、ファインチューニングのコミュニティ、インフラ事業者に分かれている。
- 影響力は、性能、普及、ライセンス、計算資源の4つの軸で別々に動く。4つすべてで先頭に立つ主体はいない。
- コーディングや推論のベンチマークでは、オープンモデルは閉じたモデルに近づいている。差が残るのは、エージェントとしての信頼性と、本番運用での頑丈さだ。
オープンモデルの力を分ける4つの軸
「オープンAIの先頭にいるのは誰か」という問いは、「インターネットの先頭にいるのは誰か」と聞くのに似ている。どの層の話をするかで、答えが変わってしまう。
次の表は、4つの軸ごとに、何を測り、誰が握りやすく、なぜ大事かを整理したものだ。
| 軸 | 何を測るか | 握りやすいのは | なぜ大事か |
|---|---|---|---|
| 素の性能 | ベースモデルのベンチマークと実タスクでの成績 | 資金力のある少数の研究所(中国勢が増えている) | その上に作るもの全部の天井を決める |
| 普及と波及 | ファインチューニング、導入、製品への組み込みの多さ | ベースモデルの公開元とファインチューニングのコミュニティ | 公開されたモデルを、広がりのある仕組みに育てる |
| ライセンスの力 | 商用利用、再配布、派生物についての条件 | 最初の公開元 | 誰が何を合法的に作れるかを決める |
| 計算資源へのアクセス | 大規模に訓練し、動かす力 | チップのベンダーとクラウド事業者 | そもそも誰が参加できるかを決める |
この4つの軸は、ばらばらの方向に引っぱり合う。
- 普及が伴わない性能は、色あせていく。 強いモデルでも、周辺ツールが使いにくかったり、条件が不明確だったりすると、ほとんど使われないことがある。
- 普及は、性能を追い越すことがある。 少し劣るモデルでも、ライセンスが明快で、文書が整い、ハードウェアで動かしやすければ、何千もの派生モデルの土台になりうる。
- ライセンスは、オープンなモデルを静かに閉じることがある。 商用利用の制限、ユーザー数の上限、利用規約の条項があると、頼れる相手が絞られる。
- 計算資源も、同じように静かに閉じる。 重みが公開されていても、動かすのに大きなGPUクラスターが要るなら、それを持つ人にしか開かれていない。
ファインチューナーは、ふだん思われている以上に評価されていい。最先端のベースモデルを訓練するわけではない。
それでも、どのベースモデルが「インフラ」になるかは、彼らの選択で決まる。
ベースモデルを選ぶとき、彼らはツール、チュートリアル、量子化版、分野別の派生版も一緒に連れてくる。このネットワーク効果は、リーダーボードには載らないが、確かな力だ。
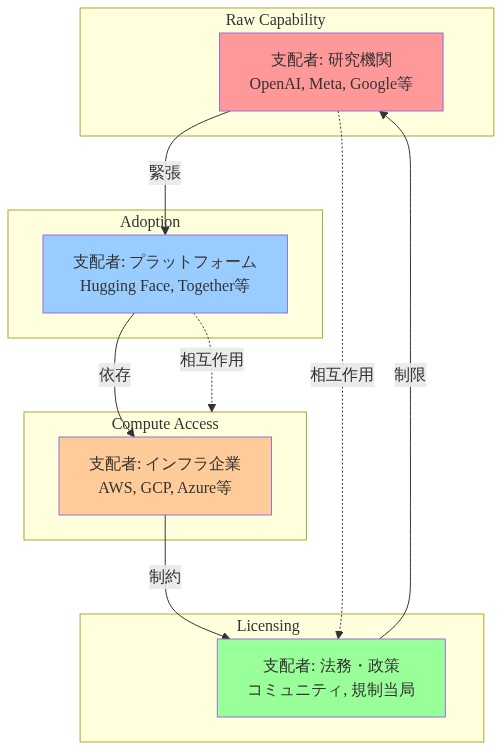
図2:オープンモデルにおける4つの権力軸と支配者
図3:権力軸間の相互矛盾と緊張関係
性能の差は、実際どれくらいか
公開ベンチマークでは、最良のオープンモデルと最良の閉じたモデルの差は、数か月分にまで縮んでいる。この数字は本物だ。
ただし、見えているのは話の一部にすぎない。ベンチマークが届かない場所に、差は残っている。
この節のポイント
- ベンチマークは推論とコーディングをよく測れる。実際の信頼性を左右するポストトレーニングの仕事は、ほとんど捉えられない。
- 現場の人たちによれば、オープンモデルは、長く続くタスク、ツールの使用、曖昧で矛盾した指示の扱いで見劣りする。
- データ汚染と自己申告の結果という2つの測定上の問題があるため、ベンチマークの数字ひとつをうのみにはできない。
ベンチマークに映らない差
現場の人たちは、リーダーボードには出てこない部分で見劣りがあると話す。
- 長い道のりでのエージェントとしての信頼性:複数の段階を踏むタスクを、迷走も停止もせずにやり遂げられるか。
- ツール使用の頑丈さ:関数を正しく呼び出し、エラーから立ち直り、壊れた出力を扱えるか。
- 雑なプロンプトでの振る舞い:指示があいまいだったり、矛盾していたり、ノイズだらけでも、役に立ち続けるか。
リーダーボードは、推論とコーディングならかなりよく測れる。
一方で、ポストトレーニングの仕事はほとんど捉えられない。その多くは強化学習に基づくもので、閉じた研究所が腕の見せどころとして重視している。この作業が、何千もの例外的な場面でモデルがどう振る舞うかを形づくる。
ベンチマークにしにくく、まねするにも時間がかかる。
仕事の種類ごとの差
タスクによって、差の大きさは違う。コーディングと推論はベンチマーク上でほぼ並んでいる。エージェント型のシステムと本番での信頼性では、まだ閉じた研究所が有利だ。
次の表は、仕事の種類ごとに、オープンと閉じたモデルの差と、見るときの注意点をまとめたものだ。
| 仕事の種類 | オープンと閉じたモデルの比較 | 主な注意点 |
|---|---|---|
| コーディング | ベンチマークではほぼ並ぶ | ベンチマークの汚染で、点数が実力より高く出ることがある |
| 推論と数学 | ベンチマークではほぼ並ぶ | 自己申告の結果は、独立した再現で確かめられているとは限らない |
| エージェント型システム | 閉じた研究所が、はっきりした優位を保つ | 長いタスク向けの標準的な評価が少ない |
| 本番での信頼性 | 閉じた研究所が優位を保つ | ポストトレーニングと、モデルを動かす仕組みに大きく左右される |
| 狭い分野向けのファインチューニング | オープンモデルが互角か、上回ることが多い | 社内の専門知識とデータが要る |
数字を疑ってかかる理由
測り方には、2つの問題がある。ひとつはデータ汚染だ。テスト問題が訓練データに紛れ込み、点数が実力より高く出てしまう。
もうひとつは、目立つ成果の多くが、モデルを作った研究所自身による自己申告であることだ。
どちらの問題も、成果が偽物だという意味ではない。ただ、単独の数字は疑ってかかったほうがいい。
後追いは続くのか
オープンモデルは、すばやく追いつくが、先頭に立つことはまれだ。
蒸留や共有された訓練レシピのおかげで、競争相手は数か月で追いつける。そこで、ひとつの問いが出てくる。後追いは安定した立場なのか、それとも永久に不利なのか。
答えは、閉じた研究所の強みが何でできているかで決まる。主に規模から来ているなら、十分な計算資源を持つオープンな取り組みは、並ぶことができる。
ポストトレーニングの規律から来ているなら、その手法がもっと文書化され、広く共有されるにつれて、差は縮まるかもしれない。
あり得る展開だが、保証はない。閉じた研究所が、アーキテクチャについてよりポストトレーニングについて公開しない状態が続くのか。
オープン側が、同等のフィードバックと評価の仕組みを作れるのか。そこにかかっている。
それまでは、閉じた研究所の優位は、モデルの大きさというより、訓練の腕前の問題に見える。
地政学、ライセンス、計算資源
なぜ中国の研究所は公開し、アメリカの研究所はためらうのか
いちばん影響の大きい変化は、地理的なものだ。アリババのような大手テック企業を含む中国企業は、いまや高性能で制限の緩いモデルを、大規模に公開している。アメリカのオープンな取り組みは、遅く、慎重だ。
両者の動機は大きく違う。
| 要因 | 中国の研究所 | アメリカの研究所 |
|---|---|---|
| 海外の閉じたモデル市場への入りやすさ | 限られる。世界の閉じた市場は、OpenAIやAnthropicなどアメリカ企業が率いている | 強い。閉じたAPIが直接の収益源になる |
| 公開で得られるもの | 世界への広がり、開発者の支持、人材、ソフトな影響力 | エコシステムでの好意。代わりに競争上の優位を手放す |
| 公開の主なリスク | 商業面での損は小さい。閉じた形での輸出はもともと難しいため | 自社製品のコモディティ化と、安全面の統治が複雑になること |
| 政策面の圧力 | 輸出規制でハードウェアの入手が制限される | 安全面の監視と、競争相手を助けることへの懸念 |
中国の研究所にとって、重みの公開は、閉じた製品では入りにくい市場への入口だ。世界のどこにいる開発者でも、モデルをダウンロードし、手元で動かし、その上に作れる。
国境をまたぐAPI契約はいらない。採用が1件増えるごとに、その研究所の影響力は広がる。
すでに収益を上げているか、もうすぐ上げるAPIを持つアメリカの研究所では、損得の計算が逆になる。
強い重みを公開することは、製品を手放すことだ。 閉じた形で運用していれば研究所自身が管理できる悪用の問題も、公開すれば避けて通れなくなる。
政策が溝を広げる
政策は、この溝をいくつかの形で広げている。
- 輸出規制は、最先端の訓練用ハードウェアを手に入れられる研究所を絞る。狙いは、中国の最先端開発を遅らせることだ。副作用として、中国の研究所は効率を高める強い圧力を受け、Mixture-of-Expertsのようなアーキテクチャが有利になる。
- 調達の優遇は、いくつかの国で国産モデルに有利に働く。これで、それぞれの陣営に守られた国内市場ができる。
- コンプライアンスの負担は、強力な重みを公開する側にとって、監視が強まるほど重くなる。禁止する規則がなくても、アメリカでの公開をためらわせうる。
その結果、エコシステムは二つに割れている。中国のオープンモデルは、多くの地域や、コストに敏感な開発者の間で広く使われている。
アメリカの閉じたモデルは、企業向けで先頭を走る。アメリカのオープンモデルは、その中間の狭い場所を占め、ニッチな導入や学術研究に使われることが多い。
計算資源という、静かな決定権
オープンモデルが独立していられる度合いは、訓練と運用に使うハードウェアで決まる。ここではNvidiaが、並外れた影響力を持つ。規模の拡大が続くことで収益が伸びる供給元は、需要が増え続けてほしいと考える。
オープンな重みは、その需要を生む強力なエンジンになる。推論が、何千もの独立した導入先に分散し、それぞれが自前でハードウェアを買ったり借りたりするからだ。
計算資源の総使用量は、閉じた研究所1社が使う量をはるかに超えて増える。この意味では、オープンモデルの広い普及は、どの公開元よりも、チップメーカーの得になるかもしれない。
計算資源は、ほかの形でもこの分野を形づくる。
- 輸出規制は、最先端で訓練できる主体そのものを決める。
- 推論の経済性は、特定のアーキテクチャに有利に働く。たとえばMixture-of-Expertsは、1トークンごとにモデルの一部しか動かさないので、運用コストが下がる。
- 代替のアクセラレーターはあるが、最先端の訓練ではまだ脇役だ。
資金力も、もう一枚の層になる。黒字化に向かう閉じた研究所は、インフラ事業者に対する交渉力を強めていく。安定したAPIの収入があれば、計算資源の枠を交渉するときに強い。
オープン側の開発者には、たいていその収入の柱がない。最先端の訓練を正当化するには、ホスティングの提携、クラウドのクレジット、親会社の予算に頼ることになる。
最先端の訓練が高くつき、ハードウェアの供給が少数に集中している限り、力の釣り合いを決めるのはライセンスよりも、チップとクラウドの計算資源を握ることかもしれない。
ビジネスモデルと、オープンモデルが勝つ場所
研究所はなぜ公開し、なぜ閉じるのか
重みを公開するかどうかは、思想の問題であると同時に、お金の問題でもある。訓練に大金がかかったモデルを無料で配るなら、事業のどこか別の場所で価値を生まなければならない。
研究所が公開を正当化する道筋は、いくつかある。
- クラウドの囲い込み:無料のモデルで開発者を引きつけ、公開元のクラウドで計算資源やサービスを借りてもらう。アリババのような企業には、この理屈が合う。
- プラットフォーム戦略:主な事業がほかにある会社は、たとえばソーシャルネットワークを持つMetaのように、モデルを直接売らなくても、安くコモディティ化したAIの恩恵を受けられる。
- ハードウェアの販売:自社のチップでモデルを動かす人が増えれば、チップのベンダーが得をする。
- 人材と評判:強いオープンモデルを出せば、研究者が集まり、分野での地位も上がる。
- 戦略的な位置取り:オープンモデルは、事実上の標準を作り、国や企業の影響力を広げることができる。
はっきりしているのは、お金を別の場所で稼げる会社ほど、公開を続けやすいということだ。 モデルだけを製品にしている独立の研究所は、訓練コストが上がるにつれて、厳しい問いに直面する。
そのコストは上がり続けている。収入源が分散していない開発者は、世代を重ねるごとに利益が薄くなる。この傾向が続けば、オープンな最先端は、資金力のある少数の主体に絞られていきそうだ。
大手テック企業が後ろ盾になった中国の研究所、公開を続けるならMeta、そしておそらくアメリカの有力な取り組みが1つ。この見通しは、訓練コストが効率化の進みより速く上がり続けることを前提にしている。
大きな効率化のブレークスルーがあれば、前提は崩れる。
オープンモデルが持ち続ける強み
最先端の優位を閉じた研究所が保ち続けるとしても、オープンモデルには、簡単には崩れない構造的な強みがある。
閉じたAPIでは解決できない問題を、オープンモデルは解決する。
- 自前のインフラ:機密データを持つ組織は、データを外に出さずに、モデルを社内だけで動かせる。
- 深いファインチューニング:重みに自由に触れるので、閉じたAPIが通常許すよりはるかに深く、狭い分野向けに調整できる。
- エッジでの運用:通信環境が悪い場所や、外部への依存を避けたい場所では、手元で動くモデルが必要になる。
- コストの管理:大量に使うなら、ハードウェアと使い方次第で、自前で動かすほうが、トークン単位の課金より安く、予測もしやすい。
- 研究のための入手:解釈可能性、ポストトレーニング、評価の研究は、オープンな重みに大きく頼っている。
最後の点は強調しておきたい。オープンな重みは、学術的なAI研究のほとんどの土台になっている。
そこから出た成果、つまりより良い評価方法、ポストトレーニングの技術、安全面の知見は、閉じた研究所を含むすべての研究所に還っていく。科学の共有財産は、慈善ではない。分野全体が頼っているインフラだ。
ロングテールも見逃せない。専門分野向けの派生モデルを1つずつ見れば、最先端のモデルに並ぶものはない。だが、分野別に調整された何千もの派生モデルが集まれば、1つのモデルでは届かない範囲をカバーできる。
規制のある多くの導入先、研究の現場、エッジでの利用では、オープンモデルは単なる選択肢ではない。
データを構外に出せない場合や、端末をオフラインで動かさなければならない場合には、現実的に使えるのはそれだけかもしれない。
これからの18か月の3つの道筋と、できること
もっともらしい道筋は3つある。互いに排他的ではない。
| 道筋 | 何が起きるか | 起きやすくなる条件 | 見ておく兆し |
|---|---|---|---|
| 中国への集約 | 中国の研究所がオープンな重みでの優位を深める。アメリカの取り組みは散らばったまま。オープンAIの地政学色が強まる | 中国の研究所が効率のよい公開を続ける。アメリカの慎重さが続く | 公開のペース、ライセンスの変更、中国国外の開発者による採用 |
| アメリカの再コミット | アメリカの有力な主体が、大規模なオープン公開を後押しする。広い導入で得をするハードウェアベンダーが支える | 国産のオープンモデルを後押しする政策。チップメーカーやクラウドの支援 | 調達の判断、新しいクラウド提携、大規模なオープン公開 |
| 最先端の集約 | コストの上昇で、オープンな最先端が少数の開発者に絞られる。オープンモデルは、少数のベースモデルの派生として残る | 訓練コストが効率化を上回って増える | 新しいベースモデルの減少、同じ少数のモデルのファインチューニングの増加 |
いちばんありそうなのは、3つが混ざった結果だ。制限の緩いライセンスでの公開は、中国の研究所が先導するだろう。アメリカの取り組みは、安全面に配慮した仕事と、企業向けの仕事に集中するだろう。
インフラ事業者は、誰が訓練でき、誰が導入できるかについて、目立たないが決定的な影響力を持ち続ける。この見通しは、現在の輸出規制、コストの傾向、企業戦略が変わらないことを前提にしている。
政策の急な転換や、効率化のブレークスルーがあれば、釣り合いは急に変わりうる。
オープンモデルの上に作る側のチームには、現実的な手順がいくつかある。
- 自分たちの仕事で試す。 コーディングと推論ではほぼ並んでいても、エージェント型や本番での差は、実際に使ってみて初めて見える。決める前に、小さな社内用の評価セットを作っておく。
- ラベルではなく、ライセンスを読む。 「オープン」の中に、商用の制限、ユーザー数の上限、用途の制限が隠れていることがある。条件が自社の事業に長く合うか確かめる。
- ハードウェアを見込んでおく。 運用コストと必要なハードウェアは、早めに見積もる。手頃な値段で動かせないモデルは、自分たちにとっては、オープンとは言えない。
- 1つのモデルに縛られない。 パイプラインをモジュール化し、分野の集約やライセンスの変更に合わせて、ベースモデルを切り替えられるようにしておく。
- 出どころと政策のリスクを見積もる。 調達規則や輸出規制のせいで、一部の業種や地域では使えるモデルが限られるかもしれない。作り始める前に確かめる。
ちょっと立ち止まって
「オープン」という言葉は、ひとつの単純な考えのように聞こえる。実際には、性能、コスト、管理、信頼のあいだのトレードオフの集まりだ。
開発者がダウンロードする重みは、研究所のビジネスモデル、政府の政策、チップメーカーの供給網に形づくられている。それを知っても、オープンモデルの価値が下がるわけではない。
ただ、どれを土台にするかを選ぶ目は、確かになるだろう。
あなたがオープンモデルを選ぶとき、見ているのは何だろうか。ベンチマークの点数だろうか、それとも、その重みを送り出した会社の稼ぎ方や、動かすために必要なハードウェアまで含めて、見えているだろうか。
「自由に使える」という言葉の裏に、思いがけない条件が潜んでいないか。一度、自分の使い方に当てはめて考えてみてもいい。
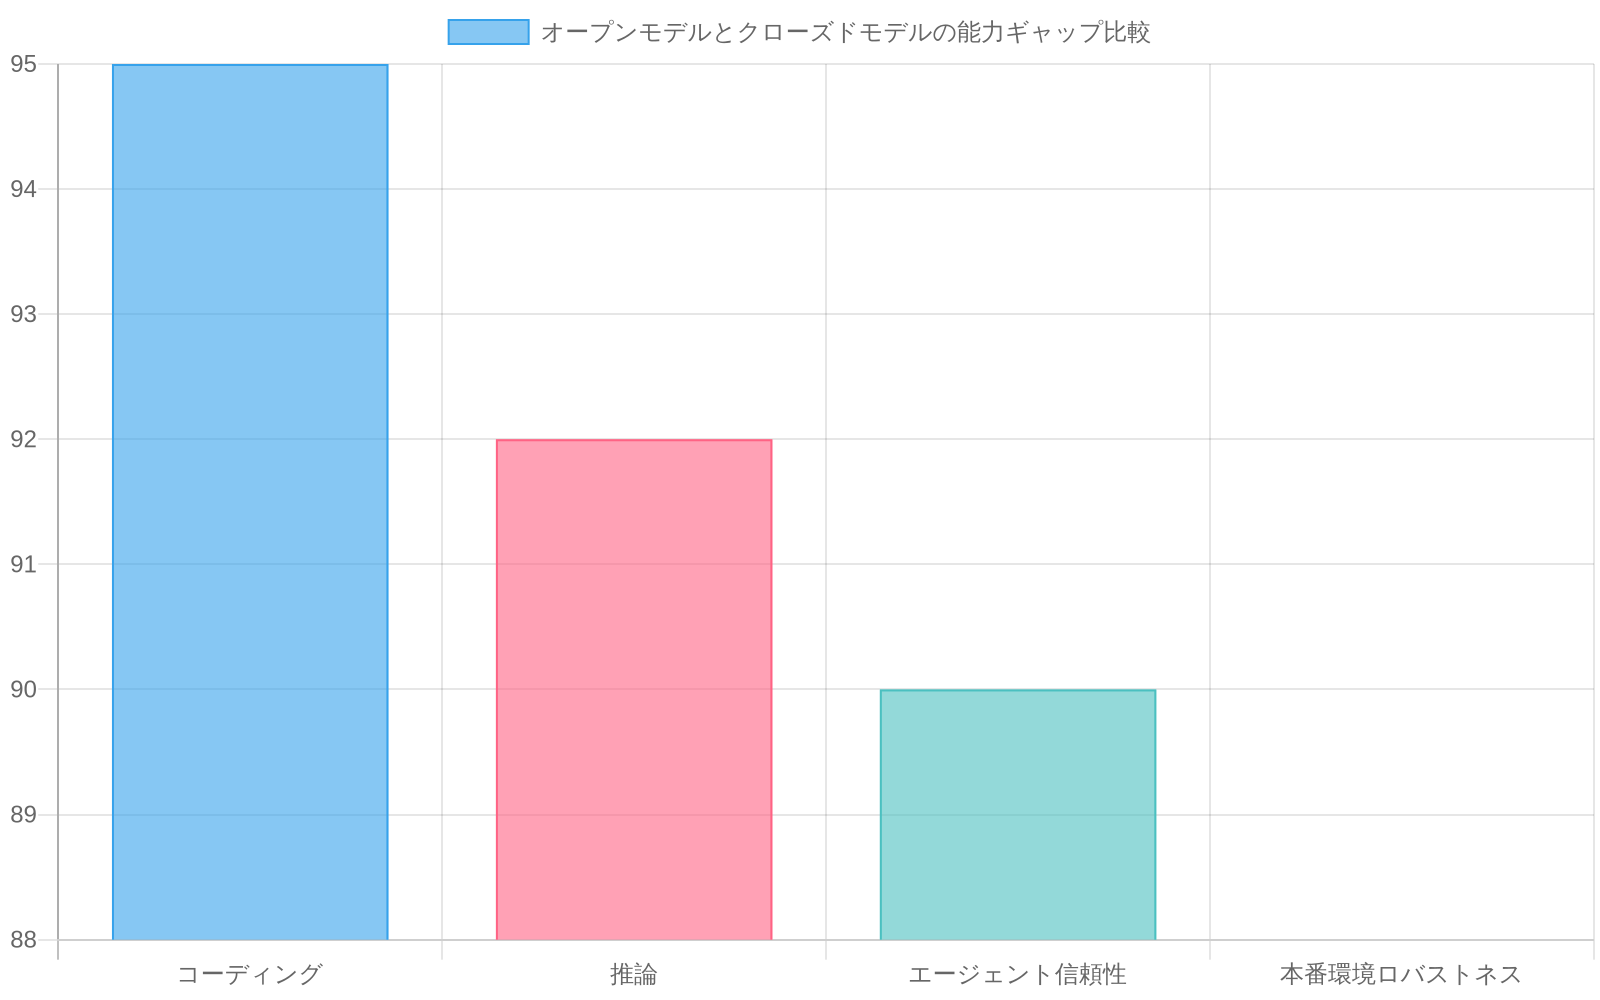
図4:オープンモデルとクローズドモデルの能力ギャップ比較
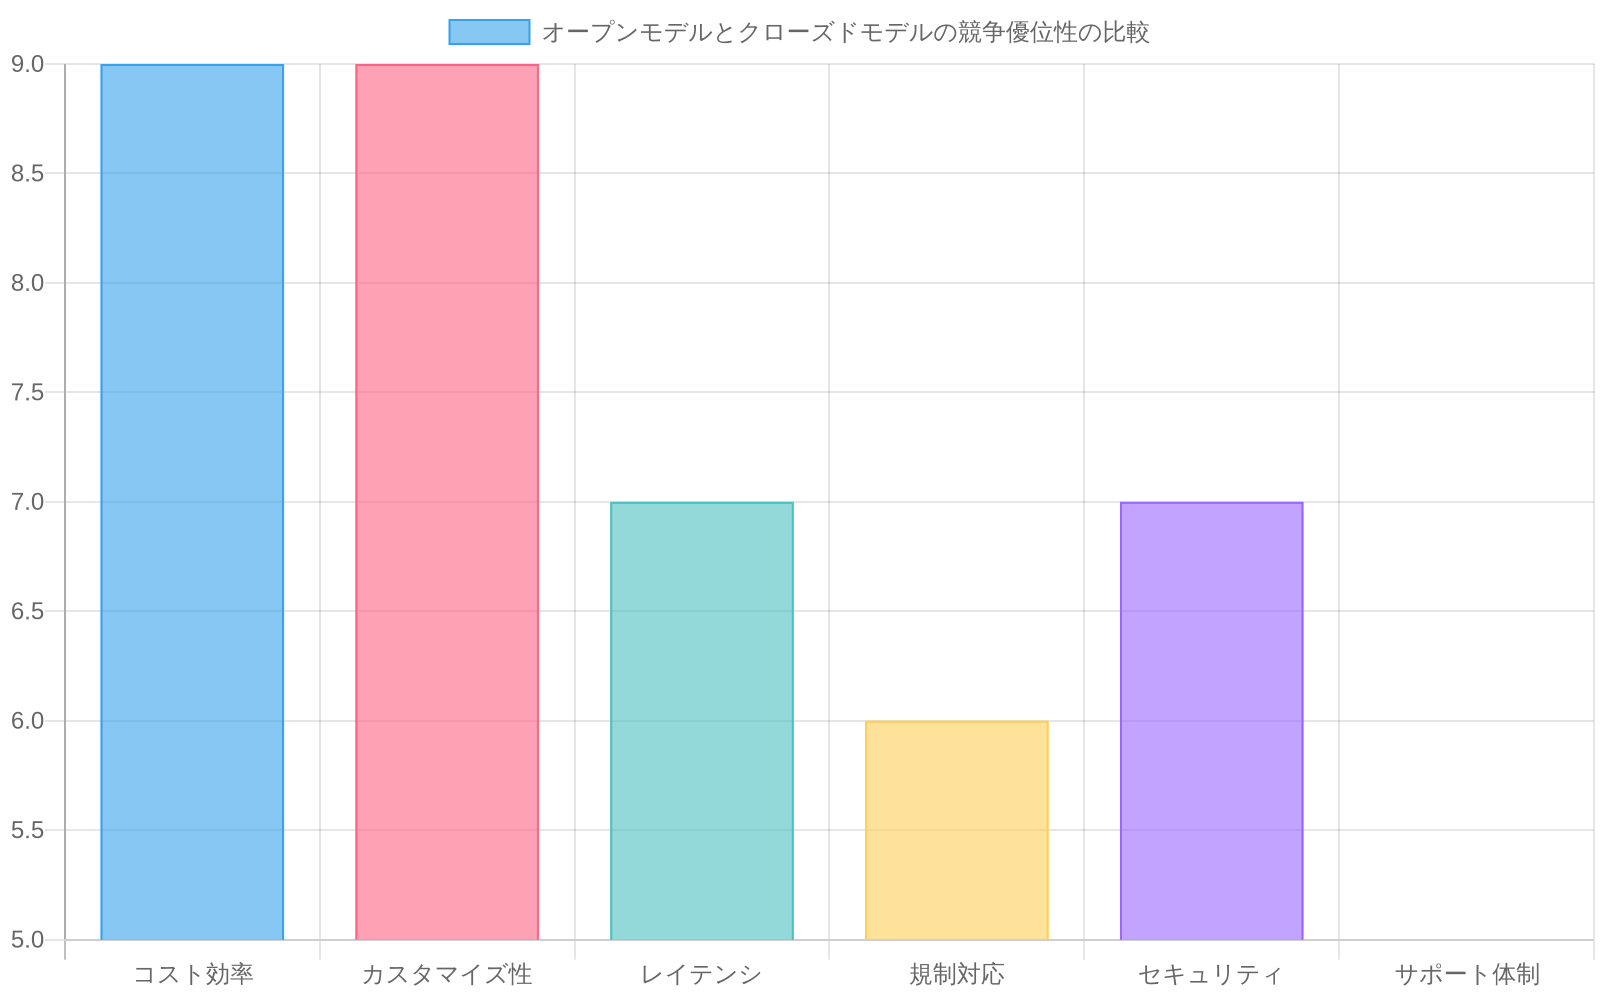
図9:オープンモデルとクローズドモデルの競争優位性の比較
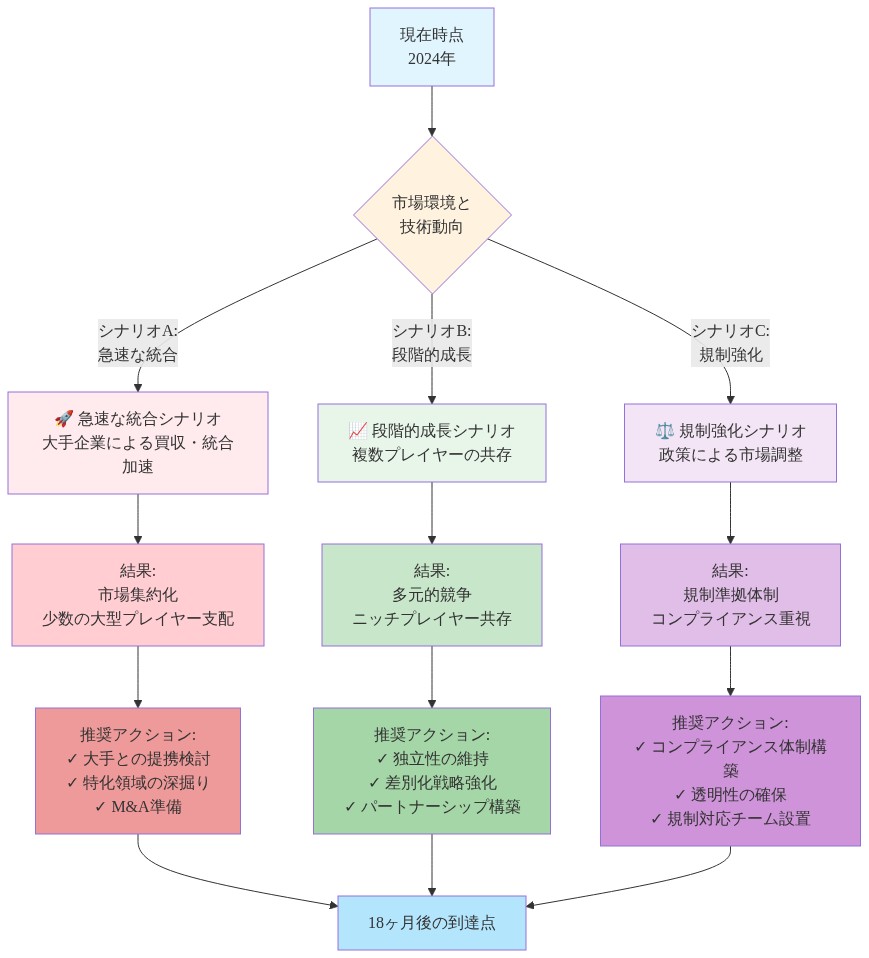
図11:今後18ヶ月のOpenAI市場における3つのシナリオパスと推奨アクション
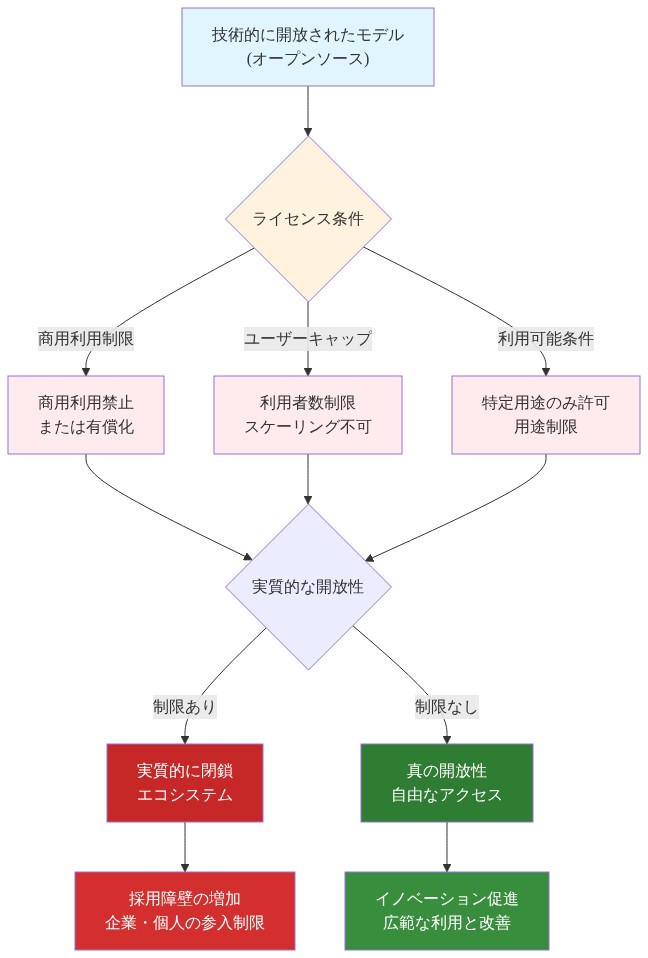
図7:ライセンス条件によるモデルの実質的な閉鎖メカニズム