チャットボットに同じ質問を2回すると、違う答えが返ってくることがある。出典を尋ねると、実在しない論文の引用が、それらしい形で出てくることもある。
仕事でAIを使う人の多くはどちらも経験しているが、理由を説明できる人は少ない。
その「なぜ」を扱うのが、The Little Book of Generative AI Foundationsという入門書だ。Hacker Newsでも話題になった。この本の主張は、プロンプトの腕前だけではモデルの振る舞いは説明できない、というものだ。
ほんの少しの数学があれば説明がつき、しかも練習問題ではなく直感で身につけられるという。
この本は、数学を長い予備知識の一覧としては扱わない。何度も顔を出す3つの考え方を土台にする。
確率、高次元の幾何、最適化だ。この3つで、実行のたびに答えが変わることや、自信満々の間違いといった身近な現象が説明できる。
この記事のポイント
- 生成モデルは、データの傾向を近似して学び、そこから標本を引き出す。
- 幻覚(ハルシネーション)や答えのばらつきは、不具合ではなく、この引き出し方から生じる。
- 温度などの設定は、引き出されるものの形を変え、確実さと多様さを引き換えにする。
確率:生成の母語
生成モデルは、設計がどうであれ、どれも同じことを試みている。学習データの背後にある確率分布を近似し、その近似から新しい標本を引き出すのだ。
分布とは、出力ごとの「どれくらい起こりやすいか」を描いた地図のことだ。モデルが出会うあらゆる場面について、「たいてい次に来るもの」の感覚を持っていると考えるとよい。
分布を学ぶことは、丸暗記とは違う
学習の目的は、データをしまい込むことではない。丸暗記しただけのモデルは、見たものをなぞることしかできない。分布を学んだモデルは、見たことのない、もっともらしい出力を作れる。
この1つの能力が、よく別々に語られる2つの現象を説明する。
- 創造性:モデルは、なじみのある型を組み合わせて、新しい文章や画像を作れる。
- 幻覚:流れるように書かれた作り物の引用は、「ありそうな標本」になりうる。実在しない論文でも、本物のデータと同じ形をしているからだ。
モデルに新しいものを書かせる仕組みは、偽物を作り出す仕組みでもある。 本物らしく見える出力と、本当の出力は、同じものではない。
尤度、驚き、距離
では、モデルはどうやって分布を学ぶのか。学習の土台にあるのは尤度(ゆうど)だ。モデルが、実際に観測されたデータにつける点数のことをいう。
最尤(さいゆう)学習では、本物のデータにモデルができるだけ驚かないよう、パラメーターを調整する。この考え方を具体的にする量が2つある。
- 交差エントロピー損失:本当の次のトークンや画素に対する、モデルの平均的な驚き。驚きが小さいほど、予測がよい。
- KLダイバージェンス:モデルの見方と本当の分布とのずれを測る尺度。データに対して交差エントロピーを小さくすると、このずれが縮まる。
ここで1つ大事な点がある。KLダイバージェンスは非対称だ。PからQを測った値と、QからPを測った値は違ってくる。
2つの向き、2つの失敗のしかた
どちらの向きを小さくするかで、モデルの失敗のしかたが変わる。教科書的な2つの場合を比べた表が下だ。
| 小さくする向き | 振る舞い | よくある症状 |
|---|---|---|
| 順方向KL(データからモデルへ) | モード被覆型:確率を広く散らす | ぼやけた標本、平均的な標本 |
| 逆方向KL(モデルからデータへ) | モード探索型:少数の山に集中する | 繰り返しが多く、多様性が低い出力 |
順方向KLのモデルは、本物のデータが持つものをすべて覆おうとする。そのため、多少のぼやけは出る。逆方向KLのモデルは安全策をとり、自信のある少数の型にとどまる。
こう見ると、ぼやけた画像と繰り返しの多い文章は、1つのトレードオフの裏表かもしれない。ただ、これは便利な見方であり、完全な診断ではない。どの症状にも、出力の引き出し方を含め、ほかの原因がありうる。
引き出し方は設計の選択
学習を終えたモデルが渡してくれるのは、答えではなく分布だ。答えが現れるのは、そこから何かを引いたときだけで、その引きには偶然が入る。同じプロンプトで違う答えが返ってくる理由は、単純にこれだ。
推論時の設定は、引く前に分布の形を変える。
- 温度(temperature):確率を鋭くしたり、平らにしたりする。低いと安全で予測しやすい出力に、高いと多様で冒険的な出力になる。
- top-k:確率の高い上位k個の選択肢だけを残す。
- ニュークリアス(top-p):確率の合計がpに届く、最小の選択肢の集まりを残す。
どの設定も、忠実さと多様さを引き換えにする。温度を下げると答えは安定するが、正しくなるわけではない。モデルがもともと最も「ありそう」と思うものを選びやすくなるだけだ。
条件づけが全体をつなぐ
プロンプトやクラスラベル、画像から生成するとは、条件つき分布を扱うことだ。「この入力があったとき、何がありそうか」を表している。
見た目の違う複数のシステムも、同じ考え方でつながる。
- 文章の続きの生成:ここまでの文章があったとき、ありそうな次の言葉。
- テキストから画像への生成:説明があったとき、ありそうな画像。
- マルチモーダルなシステム:文章と画像が混ざった入力があったとき、ありそうな出力。
どの場合も、プロンプトはモデルに答えを手渡すわけではない。モデルが標本を引く分布を、絞り込むだけだ。
ベクトル、埋め込み、意味の幾何
生成モデルは、言葉も画素も音も数の並びに変え、その後の処理はすべてその数の空間で進む。ここが分かると、この分野の多くは、向きと角度と距離をめぐる幾何の話になる。
トークンも、画像の断片も、音の1コマも、数千次元の空間の1点になる。2本よりずっと多い軸を持つ地図だと思えばよい。モデルが関連が深いと見なすものは、その地図の上で近くに並ぶ。
仕事の大半をこなすのは、いくつかの幾何の道具だ。
- 角度が類似度を測る:だいたい同じ向きのベクトルは、たいてい関連の深い内容を表す。内積がこれを捉えるが、内積はベクトルの長さにも比例して大きくなる。そのため、先に長さをそろえることが多い。
- 向きが属性を運ぶ:多くのモデルでは、ある向きに動くと、時制、感情、丁寧さのような1つの性質がおおよそ変わる。これはおおむね成り立つ話で、すべての属性に当てはまるわけではない。
- 距離が近所を決める:検索、取得、クラスタリングは、どの点が近くにあるかを見つけることに頼っている。
高次元が奇妙にふるまうわけ
数千次元の空間は、身のまわりの3次元の部屋のようにはふるまわない。ここで大事な事実は2つある。
- ランダムに2つの向きを選ぶと、ほぼ必ず、ほとんど直角になる。
- 高次元の球の体積は、ほとんどが表面のすぐ内側の薄い殻に集まっている。
1つ目の事実が、効率のよさを説明する。ランダムな向き同士がほぼ直角なら、軸の数よりずっと多くの、ほぼ独立な向きを空間に収められる。次元が増えると、その数は急に増えていく。
数千の次元に、軸の数よりずっと多くの概念を入れられるのは、このためだ。 特徴どうしが少し重なっても、互いの邪魔にはならない。
ただし、この重なりには代償がある。1つのニューロンが、複数の特徴に同時に関わることが多いのだ。個々のニューロンだけを見ても読み解きにくい大きな理由の1つが、これだ。
空間を進む道としての推論
最近の研究は、この幾何の見方をもう一歩進めている。トークンの隠れ状態を層ごとに追った研究は、推論を、この空間を進む道すじとして扱う。
著者らは、モデルが予測に落ち着くまでに、漂い、磨かれ、決まっていく段階があると述べている。
表現が動く点なら、難しい問いのいくつかは幾何の問いに言い換えられる。それぞれの問いと、幾何での形を並べた表が下だ。
| 問い | 幾何での形 |
|---|---|
| 解釈可能性 | どの向きが、どの特徴を表しているか |
| ステアリング(誘導) | 道の途中でどのベクトルを足すと、出力が変わるか |
| モデル編集 | どんな小さな変更なら、1本の道だけを向け直せるか |
直感から始める利点は、ここにある。「モデルは何を知っているのか」というあいまいな話が、測れる問いに変わるのだ。
トランスフォーマーの神秘をはがす
トランスフォーマーは難しそうに見えるが、中身は単純な操作の寄せ集めだ。それぞれの操作には、1文で言える理由がある。
文を、予測の連なりに分ける
出発点は自己回帰分解だ。文全体の確率を、次のトークンの予測の連なりとして書く。各予測は、その前にあるトークンだけに頼る。
この分解は近似ではなく、厳密に成り立つ。解けそうにない1つのモデル化の問題が、「次はどのトークンか」という多数の分類問題に変わる。
生成は、単純な繰り返しとして進む。
- ここまでのトークンをベクトルに変える。
- 何層も重なった層に通す。
- 最後のベクトルを、語彙全体に対する確率に変える。
- トークンを1つ選ぶ。多くは、その確率からの標本抽出で選ぶ。
- 選んだトークンを列に足して、また最初から繰り返す。
柔らかい検索としてのアテンション
アテンションは、1つの項目を選ぶのではなく、結果を混ぜ合わせる検索のようなものだ。自分のメモを検索して、関連の深いページが重みづけされて混ざったものが返ってくる場面を思い浮かべるとよい。
部品ごとに役割がある。
- クエリ:各位置が「何を探しているか」を問う。
- キー:各位置が「ここに何があるか」を示す。
- バリュー:実際に受け渡される情報。
- スケールした内積へのソフトマックス:クエリとキーの一致度を、合計が1になる重みに変える。
設計の細部は、最初は思いつきのように見える。だが、どれも特定の問題を直すためにある。主なものを並べた表が下だ。
| 細部 | 存在する理由 |
|---|---|
| √dでの割り算 | 大きな値が勾配を平らにするのを防ぐ |
| 複数のヘッド | 複数の関係を同時に追う |
| 位置エンコーディング | なければ、アテンションは語順を無視する |
| 残差接続 | 各層が置き換えではなく更新を加える |
スケーリングには、もう一言の説明がいる。ランダムなベクトル同士の内積は、次元の平方根にほぼ比例して大きくなる。
√dで割ると、ソフトマックスが1つの位置に固まるのを防げる。固まってしまうと、学習に使える勾配がほとんど残らない。
残差ストリーム
残差ストリームは、ネットワークの中で情報を運ぶ主な通り道だ。各層はそこから読み取り、小さな更新を書き戻す。
これは、先ほどの「道すじ」の見方に直接つながる。各層は、トークンの点を少しずつ動かす。点がどこに着くかで、予測が決まる。
趣味のプロジェクトで、DOOMをトランスフォーマーに変えた例がある。同じことを別の角度から示している。
1990年代のゲームを、トランスフォーマーの部品で作れた人がいたのだ。つまりこの設計は具体的な機械であり、中身はおもに行列の掛け算、単純な非線形関数、正規化だ。
すべてを比べるコスト
トランスフォーマーの一番の弱点はコストだ。アテンションは、すべての位置を、ほかのすべての位置と比べる。そのため、作業量は系列の長さの2乗で増える。
入力を2倍にすると、アテンションの作業量はおよそ4倍になる。比較の表をまるごと保存するなら、メモリも同じ増え方をする。ただし、新しいカーネルは、この表を保存せずに済ませている。
このコストが、技術者の労力の多くが向かう先を説明する。
- より長いコンテキストウィンドウ:丁寧なメモリ管理が前提になる。
- キー・バリューのキャッシュ:過去のトークンのキーとバリューを保存し、ステップごとにやり直さない。
- 効率的なアテンションの変種:疎なもの、線形のもの、ハードウェアに合わせたものがあり、比較のコストを減らす。
潜在変数、拡散、ノイズを消す学び方
モデルがみな、出力を1トークンずつ書くわけではない。隠れた構造をたどって生成するものもあれば、砂嵐のような状態から、少しずつきれいにしていくものもある。
潜在変数とVAE
潜在変数モデルは、目に見えるものが、より少数の隠れた原因から生まれると考える。顔写真を例にとろう。向き、照明、その人らしさで、見た目の多くが説明できるかもしれない。
変分オートエンコーダー(VAE)は、こうした隠れた原因を学ぶ実用的な方法の1つだ。
難点は、正確な尤度を計算できないことにある。そこで、尤度の下限を代わりに最適化する。これを証拠下界(ELBO)という。
ELBOは、2つの方向に同時に引っ張る。
- 再構成:復元した出力が、入力にぴったり合うようにする。
- 整理:隠れた符号が、単純でなめらかな基準の分布の近くにとどまるようにする。
この引っ張り合いが、VAEの特徴とされる2つの性質を説明する。隠れた空間がよく整理されているので、ある標本から別の標本へ、なめらかに移り変われる。
では、なぜ標本はぼやけやすいのか。モデルは自信がないと、ありそうな答えを一度にすべて覆おうとする。これがモード被覆と呼ばれる振る舞いだ。
ありそうな画像をいくつも平均すると、柔らかくにじんだ結果になる。
拡散モデルのしくみ
拡散モデルは、いまや画像と音の有力な手法になり、動画にも広がりつつある。考え方は、ノイズの消し方を学ぶことだ。
手法は2つの半分でできている。
- 順方向の過程:小さな段階ごとにガウスノイズを足し、データが完全な砂嵐になるまで続ける。ここでは何も学ばない。
- 逆方向の過程:ニューラルネットワークが、そのノイズを1段階ずつ取り除くことを学ぶ。
ネットワークは、足されたノイズを予測するように訓練されることが多い。地味に聞こえるが、深い意味がある。
足されたノイズの予測は、スケール倍を除いて、スコアの推定と同じだ。スコアとは、データがより「ありそう」になる向きのことである。 もっと正確に言うと、スコアは、各ノイズの水準におけるノイズ入りデータの対数密度の勾配だ。
いつも「より本物のデータらしい方向」を指す羅針盤だと考えるとよい。すると生成は、導かれながら歩くことになる。ランダムな砂嵐から出発し、本物の例がある領域に向かって、一歩ずつ進んでいく。
ガイダンスとフローマッチング
実際の使い方を形づくる工夫が2つある。1つは、出力がプロンプトにどれだけ強く従うかを調整する。もう1つは、歩き方そのものの学び方を変える。
分類器なしガイダンスは、プロンプトで条件づけた出力を鋭くする。各ステップで、モデルは2つの予測を出す。
プロンプトありの予測と、なしの予測だ。そのうえで、プロンプトありの予測の向きに、標本をさらに押し出す。
これは、確率の節で見た、忠実さと多様さのトレードオフの再登場だ。
- ガイダンスを強めると:出力がプロンプトにより近く合う。
- その代償:出力同士も似てくるので、多様さが減る。
フローマッチングは、より新しい定式化だ。生成を、速度場を学ぶこととして扱う。
速度場とは、各点でどちらへ、どれだけの速さで動くかを決める規則のことだ。この場が、単純な道すじに沿って、ノイズをデータへ運ぶ。
道すじが単純なので、訓練もやりやすくなる。必要なサンプリングの段階数も減ることが多い。ただし、どれだけ減るかは設定による。
4つの系統を並べて見る
4つの系統を、生成のしかたと、得意・不得意で比べた表が下だ。
| 系統 | 生成のしかた | 得意なこと | 苦手なこと |
|---|---|---|---|
| 自己回帰 | 次のトークン予測の連なり | 文章、正確な尤度 | 遅い逐次デコード |
| VAE | 潜在符号から復元する | なめらかな潜在空間 | ぼやけた標本 |
| 拡散 | 繰り返しのノイズ除去 | 画像の高い忠実度 | 多くのサンプリング段階 |
| フローマッチング | 学んだ速度場に沿って進む | 訓練が単純、段階が少ない | 新しく、定着していない |
これらは傾向であり、固定された決まりではない。どの系統にも、典型的な弱点を和らげた変種がある。
ちょっと立ち止まって
チャットボットが同じ質問に違う答えを返すと、つい「調子が悪い」「壊れている」と思ってしまう。だが、ここまで見たように、モデルが渡してくるのは答えではなく分布で、答えはそこから引かれた1つだ。
自信たっぷりの間違いも、もっともらしさを学んだ仕組みの、もう1つの顔かもしれない。
あなたはこれまで、AIの答えの「らしさ」と「正しさ」を、同じものとして受け取っていなかっただろうか。同じ質問で答えがぶれたとき、そのぶれは何を教えてくれているのだろうか。
最適化とスケーリング、そして使える理解へ
モデルを訓練するとは、何十億ものパラメーターの中から、よい設定を探し出すことだ。
道しるべになるのは、どちらへ進めば誤差が減るかを大まかに見積もった方向である。この作業の大部分を、次の3つの道具が担っている。
- 誤差逆伝播法(バックプロパゲーション):微積分の連鎖律を、無駄なく帳簿につけていく方法だ。順方向に1回計算すれば、逆方向に1回たどるだけで、すべてのパラメーターの勾配が得られる。
- 確率的勾配降下法:データ全体ではなく、ランダムに選んだ小さなまとまりから勾配を見積もる。結果として生じるノイズが役に立つと考える研究者は多い。モデルが平らな領域へ押しやられ、新しいデータにも強くなりやすいからだ。ただし、これはまだ作業仮説であり、証明されてはいない。
- Adamなどの適応型オプティマイザー:それまでの勾配の動きに合わせて、パラメーターごとに歩幅を変える。
大きなモデルがうまくいき続けた理由
大きなモデルは訓練データを丸暗記し、新しいものには弱くなる。従来の理論はそう警告していた。ところが実際には、逆のことがよく起きた。
パラメーターが必要以上にあるように見えるネットワークは、過剰パラメーター化されたネットワークと呼ばれる。こうしたネットワークは、むしろ訓練しやすいことが多い。
よく挙げられる説明は、パラメーターが多いほどよい解がたくさんでき、解どうしが通りやすい道でつながるというものだ。これは役に立つ見取り図であり、決着のついた結果ではない。
その後、研究者はスケーリング則を測定した。計算量、データ量、パラメーター数を増やすと、損失が予測できる形で下がっていく。おかげで、計算の予算を勘に頼らず、前もって計画できるようになった。
スケーリング則は、観測された傾向をまとめたものだ。自然の法則ではない。 成り立つのは、測定したサイズや設定の範囲の中だけである。その範囲を大きく超えた先は、推測にすぎない。
4つの部品はどうつながるか
この入門書の内容は、4つの部品にまとめられる。それぞれに役割がある。下の表で整理しよう。
| 部品 | 役割 |
|---|---|
| 確率 | 目標を決める |
| 幾何 | 表現を与える |
| アーキテクチャ | 計算を実行する |
| 最適化 | パラメーターを見つける |
この4つは、間取り図のように使える。新しいアーキテクチャが出てきたら、まず4つのうちどこが変わったのかを考えればよい。
この見取り図は、論文を批判的に読むときにも役立つ。流暢な出力を、理解している証拠のように扱う主張がある。
しかし、自信ありげなサンプルが示すのは、どんな出力が起こりやすいかをモデルが学んだことだけだ。その出力が正しいことまでは示さない。
直感を育てる5つの小さな実験
数式は、読むだけより手を動かしたほうが早く身につく。次の練習は、どれも4つの部品のどれかに対応している。
- 文字単位の小さな言語モデルを作る。 サンプリングの温度を変えると、違いがそのまま見える。高くすると多様になり、低くすると文章がまとまりやすくなる。
- 単語の埋め込みをPCAやUMAPで描く。 関連する単語が集まる様子が見える。ベクトルの足し算や引き算は、元の埋め込み空間で試すのがよい。2次元に落とすと距離がゆがみ、UMAPでは特に大きくゆがむからだ。
- 2次元の小さな拡散モデルを動かす。 ノイズを取り除くにつれて、ばらけた点がらせんや輪に戻っていく様子を眺められる。
- 小さなTransformerからアテンションの重みを取り出して表示する。 各ヘッドがどのトークンに注目しているかが分かる。
- 入門書を1冊、ゆっくり読む。 たとえばthe Little Bookがある。各章で式を1本ずつ自分の手で導き直すと、理解が固い部分と、まだ怪しい部分が見えてくる。
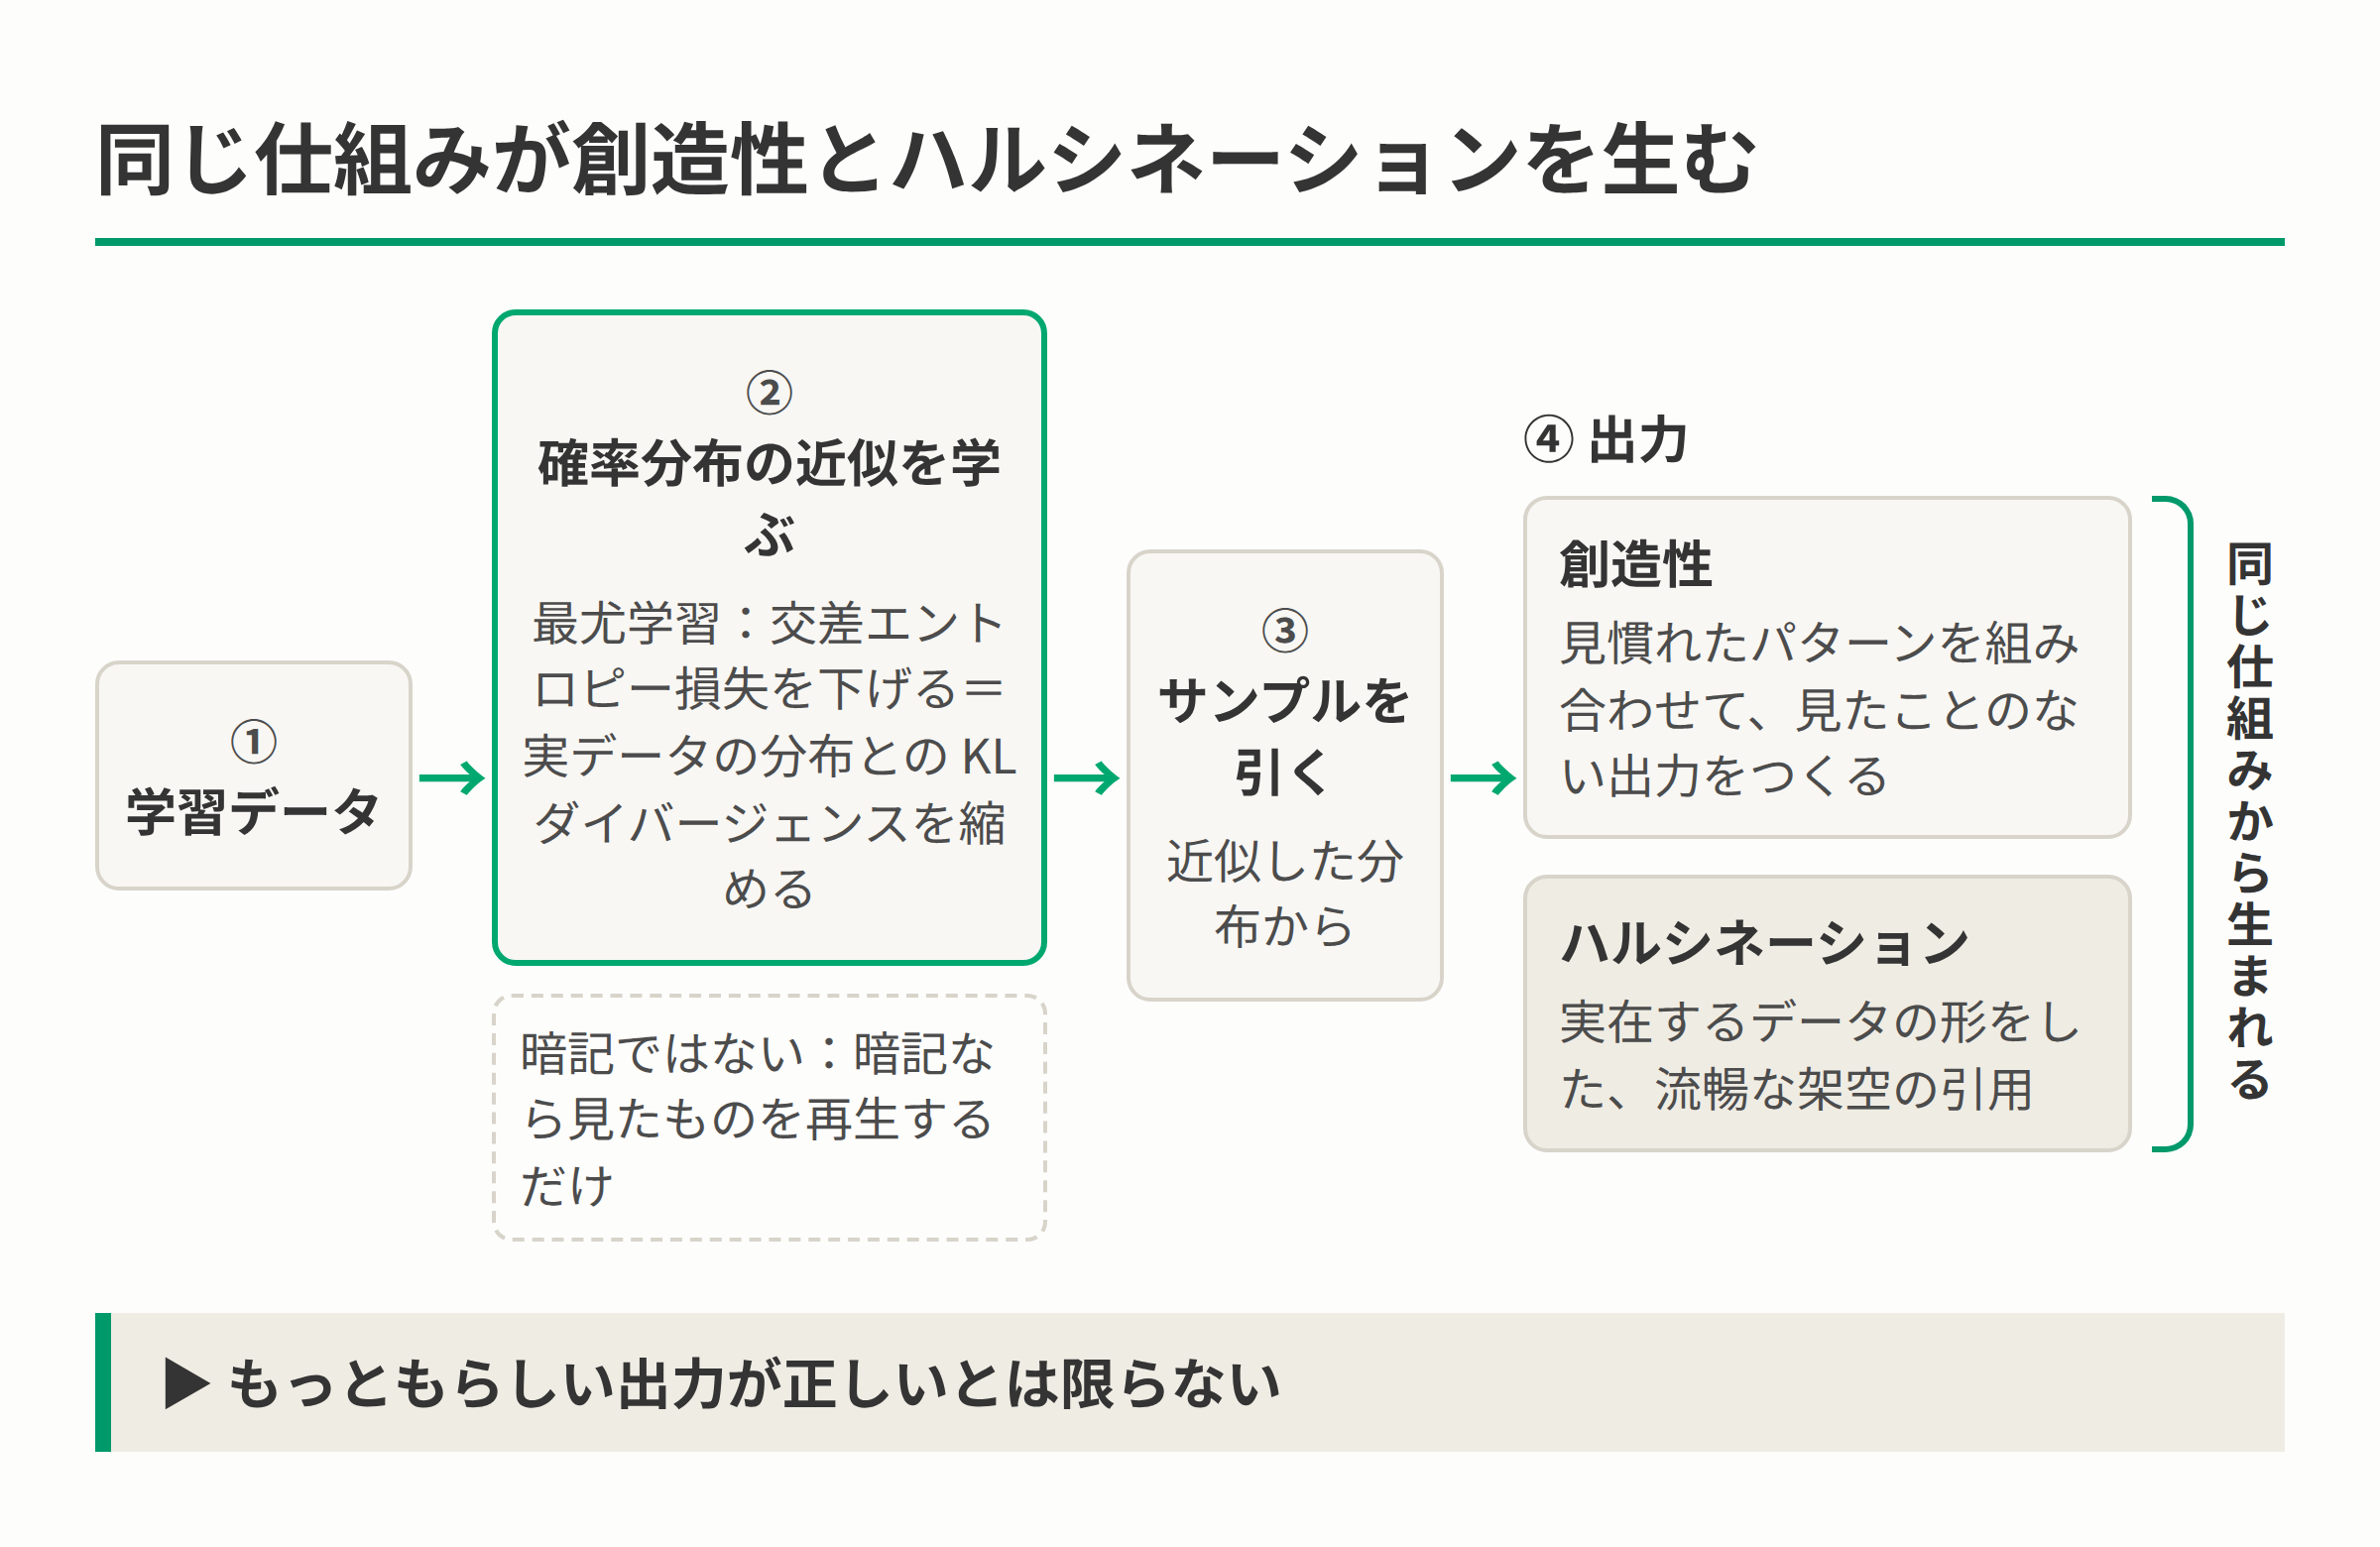
図1:分布を学んで標本を引くという仕組みが、創造性とハルシネーションの両方を生む(出典:記事本文「Probability: The Native Language of Generation」節)