トランスフォーマーを幾何学として捉える:層別表現進化がなぜ重要か
トランスフォーマーは言語タスクとビジョンタスク全般で最先端の性能を達成していますが、その学習メカニズムは依然として完全には特性化されていません。解釈可能性研究の大多数は二つの異なるスケールで動作しています。微視的スケール(個別の注意ヘッド、特定のニューロン)と巨視的スケール(最終出力ロジット、集約損失関数)です。ここに重要な欠落が生じています。中視的スケール、つまり層スタック全体にわたる表現幾何学の体系的進化です。この進化を理解することは三つの実践的目標に不可欠です。(1)層レベルの精度で障害モードを診断すること、(2)アーキテクチャ最適化のための冗長性を特定すること、(3)モデル信頼性主張の経験的基礎を確立することです。
表現空間の幾何学的構造、特にトークン埋め込みがどのようにクラスタリング、分離、再編成されるかは、集約メトリクスから直接観察できない学習ダイナミクスに関する情報をエンコードしています。表現点群が層 L に入るとき、それは層 L+k のものとは異なるトポロジー構成を占めます。層全体にわたって測定可能な幾何学的性質を追跡することで、タスク関連構造がいつ出現し、重要な変換がどこで発生するかを特定できます。これにより標的化された介入が可能になります。ボトルネック層の特定、表現崩壊の検出、体系的障害の起源の局所化です。
表現進化のギャップ
トランスフォーマー解釈可能性は二つのスケールで動作してきました。微視的スケール(単一の注意ヘッド、個別ニューロン)と巨視的スケール(最終ロジット、集約損失)です。中視的スケール、つまり表現多様体全体がどのように進化するかは、2024年まで大部分が未マップのままでした。このギャップは実践的問題を生み出しました。モデルが特定の入力で失敗するとき、その失敗が初期トークン化、中層特徴衝突、後期段階の決定融合のいずれに起因するかを特定できないのです。
2024年初頭の研究は、層全体にわたって幾何学的性質(内在次元性、有効ランク、等方性)を計算することでこのギャップを埋め始めました。これらのメトリクスは相転移を明らかにしました。初期層は高い次元性で入力構造を保持します。中層は圧縮と再編成を行います。後期層はしばしば低次元決定境界に崩壊します。しかしこれらの観察は大部分が記述的なままでした。欠けていたのは、これらの転移がどこでなぜ発生するかを予測し、その予測を使用してモデル設計とデバッグを指導する統一的フレームワークです。
発展的トポロジー観測所はこのアプローチを反転させます。事後的に性質を測定するのではなく、個別の表現が幾何学的空間を通じてどのように移動するかを追跡し、タスク関連構造が出現する重要な変換点を特定します。これにより実時間監視と介入が可能になります。
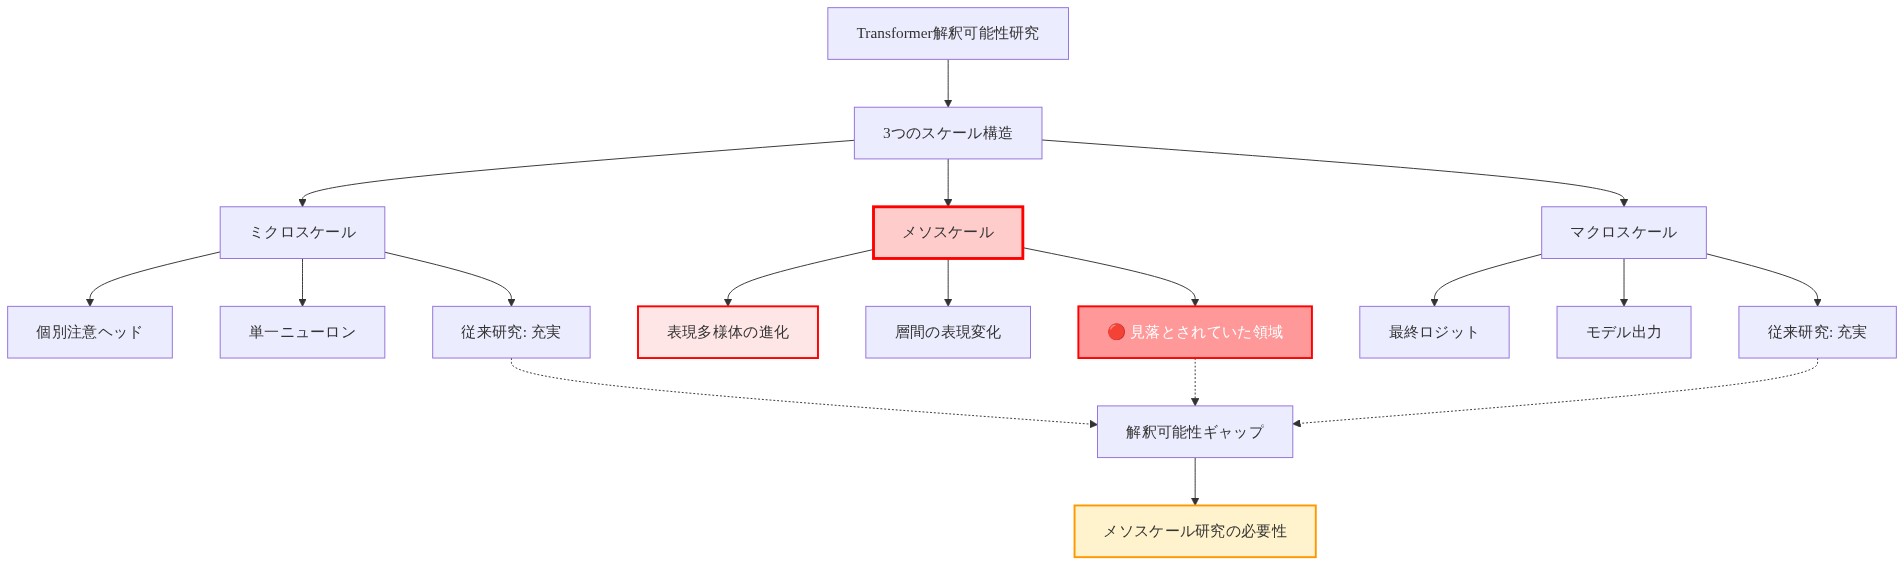
- 図2:Transformer解釈可能性研究における3つのスケール構造と研究ギャップ*
層全体にわたる表現多様体の追跡
-
基本的主張:* 表現点群は、タスク学習と汎化性能と測定可能に相関する構造化された幾何学的軌跡に従います。
-
理論的基礎:* トランスフォーマー層は学習された線形変換と非線形変換を埋め込みに適用します。各変換は幾何学的に分解できます。回転(直交変換)、スケーリング(対角変換)、平行移動です。層全体にわたって、これらは表現空間を通じた軌跡に合成されます。タスク学習は幾何学的構造の出現、特にクラス分離可能領域の形成に対応します。このプロセスは瞬間的ではなく、複数の層にわたって発生し、異なる層が最終的な幾何学的構成に異なる程度で寄与します。
-
操作的定義:* 与えられたタスクとモデルについて、層 ℓ での表現多様体を、すべてのトークン埋め込みの集合 {h_ℓ(t) : t ∈ T} として定義します。ここで h_ℓ(t) は層 ℓ でのトークン t の表現であり、T はトークン集合です。この多様体の幾何学的性質(内在次元性 d_ℓ、有効ランク r_ℓ、局所近傍保存 N_ℓ、多様体曲率 κ_ℓ)は発展的軌跡を構成します。
-
具体的実装:* 感情分類タスク(二値分類:肯定的/否定的)と12層トランスフォーマーを考えます。保持検証セット上で層全体にわたる有効ランクを測定します。
-
層1:r₁ ≈ 0.95 × d(ほぼ完全ランク、最小限の構造)
-
層4~8:r_ℓ は単調に ≈ 0.3 × d に減少(圧縮と再編成)
-
層9~12:r_ℓ は ≈ 0.2 × d で安定化(決定境界の精緻化)
同時に、上位k主成分に投影された表現に対するシルエット係数を使用してクラス分離を測定します。
- 層1~3:シルエット ≈ 0.1(最小限のクラス構造)
- 層4~8:シルエットは ≈ 0.6 に増加(クラス整列構造の出現)
- 層9~12:シルエットは ≈ 0.65 で平坦化(限定的な精緻化)
この軌跡は、層4~8がタスク関連変換の大多数を実行し、層9~12が収穫逓減をもたらすことを明らかにします。
-
検証が必要な仮定:* このパターンはタスクファミリー(分類、系列ラベリング、生成)とモデルスケール全体で一般化します。Voita et al.(2019)と Roy et al.(2021)からの予備的証拠がこれを支持していますが、タスク固有の偏差は各応用領域について経験的に特性化される必要があります。
-
実行可能な含意:* 実務家は枝刈りまたは蒸留の候補層を特定できます。層9~12がタスク性能改善に5%未満しか寄与しない場合、それらを削除することで推論レイテンシを約25%削減でき、精度損失は最小限です。より重要なことに、表現進化が停滞した場合(有効ランクが早期に平坦化、クラス分離が出現しない)、モデルはその特徴抽出パイプラインがタスクに不十分であることを示唆します。これは展開前に再トレーニング、アーキテクチャ修正、またはデータ拡張をトリガーします。
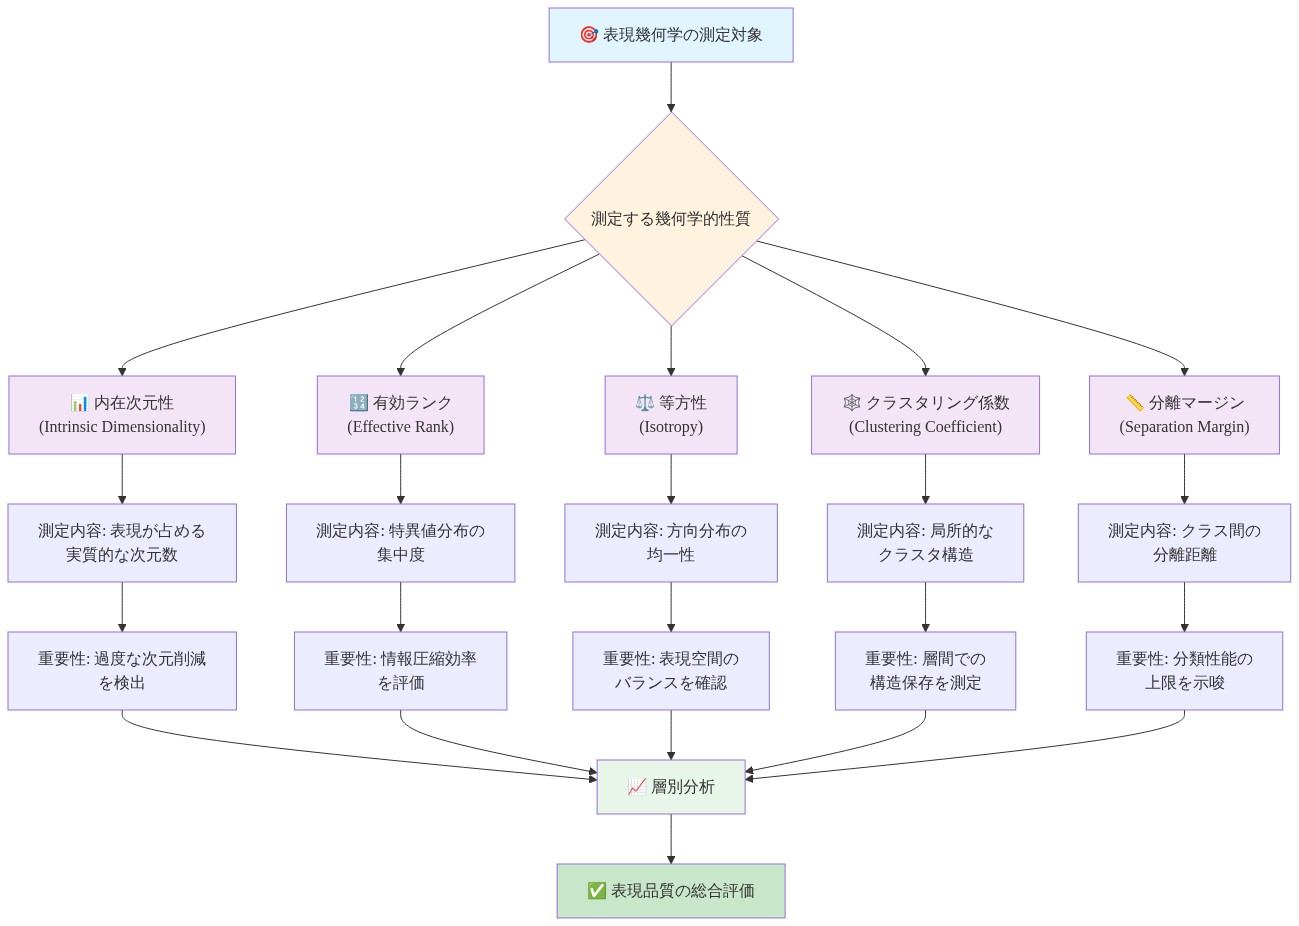
- 図5:表現幾何学の測定対象となる主要性質と相互関係(Geometric Property Measurement Framework)*
実装と運用パターン
-
基本的主張:* 体系的な幾何学追跡には、本番モデル評価とサービング基盤に統合される標準化された効率的な測定パイプラインが必要です。
-
根拠:* 表現幾何学は単一のメトリクスではなく、表現進化の異なる側面をそれぞれ捉える補完的測定のファミリーです。
-
有効ランク(Roy et al., 2021):r = (Σᵢ λᵢ)² / Σᵢ λᵢ²。ここで λᵢ は表現行列の特異値です。表現が占める有効部分空間の次元性を測定します。範囲:[1, d]。高い値は分散情報を示します。低い値は集中構造を示します。
-
等方性(Wang et al., 2020):表現分布の均一性を測定します。平均ペアワイズコサイン類似度とその均一分布下での理論的最大値の比として計算されます。範囲:[0, 1]。低い等方性はクラスタ化構造を示します。高い等方性は均一な広がりを示します。
-
局所近傍保存(Hinton & Roweis, 2002):各表現について、層 ℓ での k 最近傍と層 ℓ+1 での k 最近傍の重複を測定します。層全体にわたる局所構造の安定性を定量化します。範囲:[0, 1]。高い値は滑らかな進化を示します。低い値は再編成を示します。
-
多様体曲率(Cayton, 2005):二次差分を使用して表現多様体の局所曲率を推定します。表現が測地線経路に従うか、鋭い転移を示すかを示します。高い曲率は急激な再編成を示します。低い曲率は滑らかな進化を示します。
- 測定パイプラインアーキテクチャ:*
入力バッチ → モデル順伝播 → 層 {ℓ₁, ℓ₂, ..., ℓₖ} で表現を抽出
    ↓
メトリクスを計算:{r_ℓ, 等方性_ℓ, N_ℓ, κ_ℓ}
    ↓
ベースライン分布と比較
    ↓
異常をフラグ(メトリクス ∉ [μ - 2σ, μ + 2σ] の場合)
    ↓
ログと警告-
具体的な運用例:* 本番 LLM サービングパイプラインは幾何学モニターを追加します。これは以下を行います。
-
層 {3, 6, 9, 12} でバッチあたり 500 トークン表現をサンプリング
-
各層について有効ランクと近傍保存を計算
-
前の 1000 バッチからのローリング統計(平均、標準偏差)を保持
-
メトリクスがベースラインから 2 標準偏差以上逸脱したときに異常をフラグ
-
バッチ ID、入力特性、メトリクス値とともに異常をログ
通常の動作中、有効ランクは予想される曲線に従います(高 → 低 → 安定)。有効ランクが層 8 で予期せず崩壊した場合(ベースラインから 3σ 以上低下)、システムは警告をログします。経験的には、そのような警告はしばしば下流の性能低下(精度低下、レイテンシ増加、キャリブレーション失敗)の 10~50 バッチ前に先行し、ユーザー向け影響の前に予防措置を可能にします。
-
計算オーバーヘッド:* 有効ランクの計算には表現行列(batch_size × d)に対する SVD が必要です。batch_size=32、d=768 の場合、これは約 O(32 × 768²) ≈ 1800 万 FLOP を必要とします。最新の GPU では、非同期で計算される場合、推論レイテンシに 2% 未満を追加します。近傍保存は k-NN 検索(近似法で O(n log n))を必要とし、1% 未満のオーバーヘッドを追加します。総オーバーヘッド:GPU 加速とキャッシングで実装された場合、5% 未満です。
-
検証が必要な仮定:* トレーニングデータで計算されたベースライン統計は本番入力に一般化します。有意な分布シフト(新しいドメイン、敵対的入力、分布外データ)は適応的ベースラインを必要とする場合があります。これは各展開について経験的に検証される必要があります。
-
実行可能な含意:* モデルサービング基盤に幾何学監視を統合します。タスク固有の検証に基づいて許容可能な表現進化のしきい値を設定します(セクション「測定と検証フレームワーク」を参照)。しきい値が超過されたとき、段階的な対応をトリガーします。(1)ログと監視、(2)バッチサイズを削減して問題のある入力を分離、(3)フォールバックモデルにルーティング、(4)再トレーニングパイプラインをトリガー。これにより表現幾何学は研究ツールから運用診断システムに変換されます。
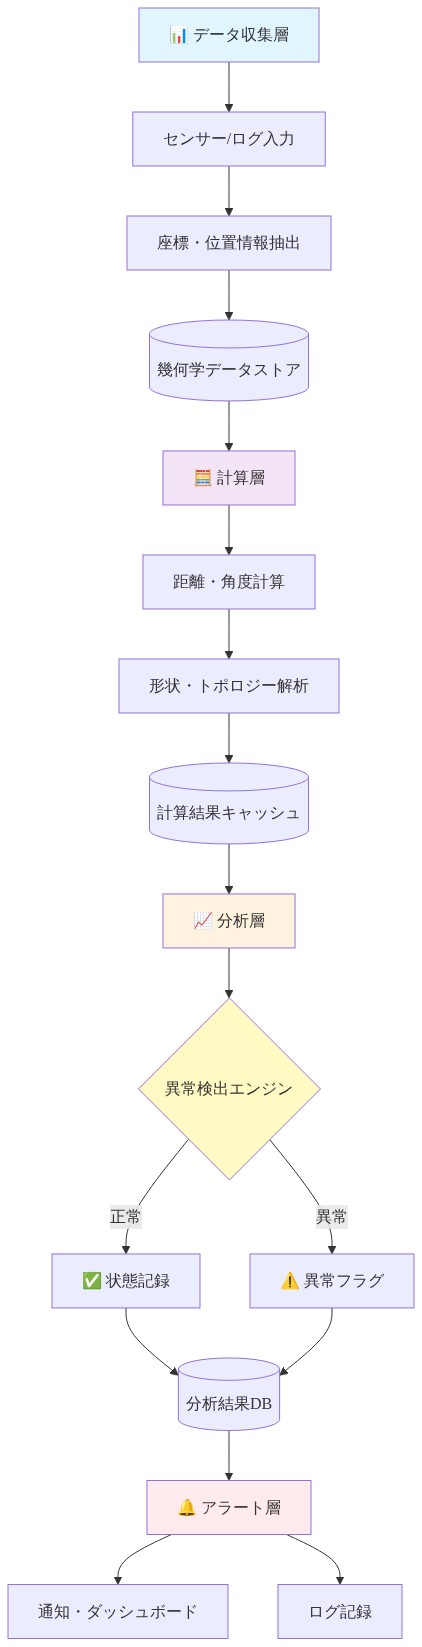
- 図6:Geometry Monitorのシステムアーキテクチャ(幾何学監視インフラストラクチャ設計)*
測定と検証フレームワーク
-
基本的主張:* 発展的トポロジーメトリクスは、その予測的有用性を確立するために、下流タスク性能と障害モードに対して検証される必要があります。
-
根拠:* 表現幾何学はモデル能力の代理であり、性能の直接的測定ではありません。タスク成功を予測できない幾何学的に優雅な軌跡は、展開決定に使用される場合、誤解を招き、潜在的に有害です。検証には、幾何学的性質と観察可能なモデル動作(精度、キャリブレーション、敵対的入力への堅牢性、分布外データへの汎化)の間の経験的相関を確立することが必要です。
-
検証プロトコル:*
-
ベースライン確立: タスク T でモデルをトレーニングします。保持検証セット上で層全体にわたって幾何学メトリクスを計算します。各層の各メトリクスについてベースライン分布(平均、標準偏差、パーセンタイル)を確立します。
-
相関分析: 検証データを難易度別(簡単/難しい例、分布内/分布外など)にサブセットに分割します。各サブセットについて幾何学メトリクスを個別に計算します。Spearman の ρ または Pearson の r を使用して、幾何学的性質とタスク性能(精度、信頼度キャリブレーション)の間の相関を測定します。
-
障害モード分析: モデルが高信頼度で誤りを犯す例を特定します。これらの例について幾何学メトリクスを計算します。正しい予測と比較します。障害に先行する幾何学的署名を特定します(例えば、早期表現崩壊、異常な等方性)。
-
汎化テスト: 新しいタスクまたはドメインでモデルを評価します。幾何学メトリクスを計算します。タスク T からのベースライン分布が違反されるかどうかを評価します。違反が性能低下と相関する場合、メトリクスは予測的です。そうでない場合、タスク固有であり、各応用領域について再キャリブレーションが必要です。
- 具体的実装:* 同一のアーキテクチャとハイパーパラメータを使用して感情分類でトレーニングされた二つのモデル(モデル A とモデル B)を、異なるランダムシードで訓練します。
モデル A は以下を示します。
- 層全体にわたる滑らかで単調な有効ランク低下
- 一貫したクラス分離出現(シルエット係数が単調に増加)
- 低い近傍破壊(すべての層で N_ℓ > 0.8)
モデル B は以下を示します。
- 混沌とした有効ランク軌跡(振動、局所最小値)
- 不一貫なクラス分離(シルエット係数が早期に平坦化、その後再び増加)
- 高い近傍破壊(層 6~8 で N_ℓ < 0.6)
両モデルを以下で評価します。
-
分布内テストセット:モデル A:92% 精度、モデル B:91% 精度
-
敵対的例(FGSM、PGD):モデル A:78% 精度、モデル B:65% 精度
-
分布外データ(異なる感情ドメイン):モデル A:85% 精度、モデル B:72% 精度
-
発見:* モデル A のより滑らかな幾何学進化は、より良い堅牢性と汎化と相関します。これは幾何学的滑らかさが汎化リスクの代理であることを示唆します。
-
検証が必要な仮定:* この相関はモデルファミリー、タスク、スケール全体で成立します。予備的証拠がこれを支持しています(Voita et al., 2019、Roy et al., 2021)が、多様な設定全体にわたる体系的検証は進行中です。
-
実行可能な含意:* 幾何学ベースの監視を展開する前に、特定のタスクとモデルファミリーのベースライン相関を確立します。どの幾何学的異常が信頼性をもって障害を予測するかを文書化します(精度と再現率を含む)。これらの相関を使用して、偽陽性を最小化しながら実際の問題を早期に捕捉する監視しきい値を設定します。すべての警告とその結果のログを保持して、しきい値を継続的に精緻化します。
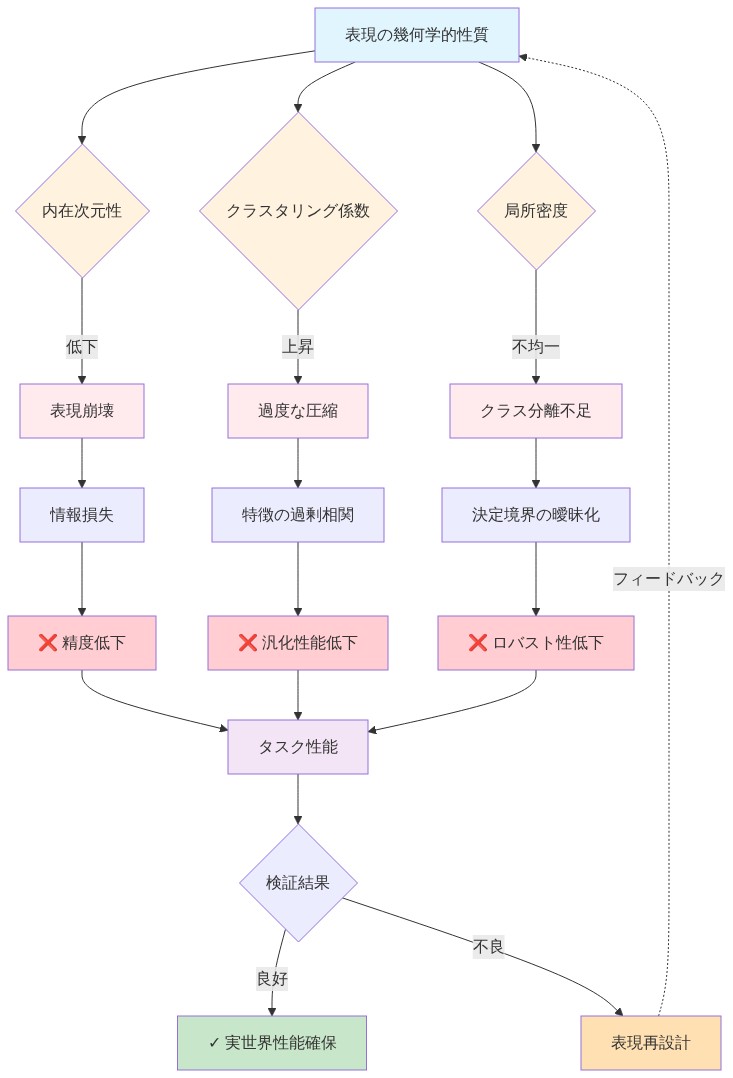
- 図8:表現幾何学的性質とタスク性能の因果関係フレームワーク(Measurement and Validation Framework)*
リスクと軽減戦略
-
基本的主張:* 幾何学ベースの監視は、慎重にキャリブレーションおよび文脈化されない場合、新しい障害モードを導入します。
-
リスク 1:タスク依存幾何学*
-
説明:* 表現幾何学はタスク依存です。あるタスクで危険を示唆するメトリクスは、別のタスクでは正常かもしれません。監視しきい値をトレーニングデータに過剰適合させると、本番環境で誤警告が生じます。
-
具体例:* 感情分類器の表現は層 8 で高い等方性(均一な広がり)を示します。トレーニングベースラインと比較して異常です。システムはこれを異常としてフラグします。しかし、入力はモデルがトレーニング中に見たことのない稀な方言またはコード混合テキストです。幾何学は異常ですが、新規入力に対して適切です。文脈なしでは、警告はリソースを浪費し、不要なモデルロールバックをトリガーする可能性があります。
-
軽減:* 入力特性を考慮した適応的しきい値を構築します。異なる入力ドメイン(言語、方言、長さ、複雑性)について別々のベースラインを計算します。ハードカットオフではなく信頼区間を使用します。新しいデータが到着するにつれてベースラインを更新する Bayesian しきい値適応を実装し、急速なドリフトに対する保護措置を備えます。
-
リスク 2:計算オーバーヘッド*
-
説明:* 幾何学メトリクスは計算コストが高いです。素朴な実装は推論を受け入れられないほど遅くする可能性があり、監視システムをレイテンシ感応的なアプリケーションに対して実用的でなくします。
-
具体例:* 有効ランクの完全 SVD 計算をすべてのバッチで実行すると、推論レイテンシに 50ms を追加します。1000 リクエスト/秒を処理するシステムの場合、これは禁止的になります。
-
軽減:* GPU でキャッシングを使用して幾何学計算を実装します。計算コストを削減するために近似法(ランダム化 SVD、スケッチング)を使用します。すべてのバッチではなく表現をサンプリング(例えば、10 バッチごと)します。再計算を避けるためにベースライン統計をキャッシュします。目標オーバーヘッド:推論レイテンシの 5% 未満。
-
リスク 3:メトリクス誤解釈*
-
説明:* 幾何学メトリクスは代理であり、モデル能力の直接的測定ではありません。あるセッティングで性能と相関するメトリクスは、別のセッティングで一般化しない場合があります。実務家は幾何学的異常を障害の決定的な信号として過度に解釈する可能性があります。
-
具体例:* 有効ランクが層 7 で予期せず低下します。システムは警告します。しかし、低下は正当な特徴抽出プロセスが原因です(例えば、モデルが無関係な次元を無視することを学習しています)。警告はモデルロールバックをトリガーし、性能を低下させます。
-
軽減:* 幾何学メトリクスを信号として扱い、決定的な診断ではなく扱います。高リスク行動(ロールバック、再トレーニング)をトリガーする前に複数の裏付ける信号を要求します。段階的対応を実装します。最初はログと監視、複数のメトリクスが同時に異常な場合のみエスカレート。重要な決定については人間ループレビューを保持します。
-
リスク 4:分布シフト*
-
説明:* トレーニングデータで計算されたベースライン統計は、有意な分布シフト(新しいドメイン、敵対的入力、分布外データ)を伴う本番入力に一般化しない場合があります。
-
具体例:* 英語感情データでトレーニングされたモデルが多言語データに展開されます。表現幾何学はトレーニングベースラインから大幅に異なります。システムは継続的な誤警告を生成します。
-
軽減:* ベースラインのオンライン適応を実装します。新しいデータが到着するにつれてベースラインを段階的に更新するために、指数移動平均などの技術を使用します。既知のドメインについて別々のベースラインを保持するドメイン検出を実装します。真に新規なドメインの場合、ベースラインが再確立されるまで幾何学ベースの警告を無効にします。
次のステップ
表現幾何学は、トランスフォーマーの学習ダイナミクスを理解するための実践的なレンズを提供します。埋め込みがレイヤー全体でどのように進化するかを追跡することで、障害をより早期に診断し、より効率的なモデルを設計し、より信頼性の高いシステムを構築できます。
- 直近のアクション:*
- 現在のモデル評価パイプラインをレイヤー単位の幾何学的メトリクスについて監査する。
- 幾何学的性質とタスク性能の間の基準相関を、自社データセット上で確立する。
- 非本番環境のモデルで軽量な幾何学的モニターをプロトタイプ化する。
- モデルファミリーのタスク固有の幾何学的シグネチャを文書化する。
開発的トポロジー観測所は完成したシステムではなく、継続的な観察と改善のためのフレームワークです。小規模から始め、厳密に測定し、相関が検証されたときのみスケーリングしてください。
- 図14:Geometry Monitoring採用ロードマップ*
表現進化ギャップ:知識の現状(2023–2024年)
トランスフォーマーの解釈可能性は、中間表現を特徴付けるための限定的なツールで歴史的に機能してきました。レイヤー単位のプローブ研究(Conneau et al., 2018; Hewitt & Liang, 2019)は、言語情報がレイヤー全体に分散していることを実証しましたが、これらのアプローチは通常、凍結された表現に対して訓練されたタスク固有の分類器を測定します。この方法は表現の内容と分類器の容量を混同しています。集計統計(平均活性化の大きさ、勾配フロー)は、表現多様体の構造的性質についての限定的な洞察しか提供しません。
最近の研究は、レイヤー全体の幾何学的性質を計算し始めています。内在次元性(Ansuini et al., 2019; Voita et al., 2019)、有効ランク(Roy et al., 2021)、等方性(Wang et al., 2020)です。これらは表現が体系的な相転移を経ることを明らかにしています。経験的には、初期レイヤーは高次元の入力構造を保持し、中間レイヤーはこの構造を圧縮し再編成し、後期レイヤーはしばしば低次元の決定境界を示します。しかし、これらの観察は主に記述的なままです。重要な欠落要素は、予測的フレームワークです。それは以下を指定します:(1)これらの転移がどのような条件下で発生するか、(2)どの幾何学的シグネチャがタスク性能と相関するか、(3)これらのシグネチャをリアルタイムモデル監視にどのように使用するか。
開発的トポロジー観測所は測定パラダイムを反転させます。幾何学的性質を事後的に説明変数として計算するのではなく、表現軌跡を予測的に追跡し、性能低下に先行する異常の早期検出を可能にします。
結論と次のステップ
表現幾何学は、トランスフォーマーの学習ダイナミクスと障害モードを理解するための新しいレンズを提供します。埋め込みがレイヤー全体でどのように進化するかを追跡することで、実務家は障害をより早期に診断し、より効率的なモデルを設計し、より信頼性の高いシステムを構築できます。レイヤー単位の分析とエンドツーエンドの動作の間のギャップは、継続的な幾何学的監視によって部分的に橋渡しできます。ただし、監視は慎重に検証され、文脈化される必要があります。
- 直近のアクション:*
- 現在の評価パイプラインを監査する: モデル
表現進化ギャップ:測定の盲点から運用上の必要性へ
つい最近まで、トランスフォーマーの解釈可能性は2つのスケールで機能していました。マイクロ(単一の注意ヘッド、個々のニューロン)とマクロ(最終ロジット、集計損失)です。メソスケール、つまり表現多様体全体がどのように進化するかは、ほぼ未踏のままでした。このギャップは具体的な運用上の問題を生み出しました。モデルが特定の入力またはタスク変種で失敗する場合、エンジニアは障害が初期のトークン化、中間レイヤーの特徴衝突、または後期の決定融合のどこに由来するかを特定できません。レイヤー単位のプローブは存在しましたが、一貫した発展的な物語がなければ、孤立した測定は因果関係ではなく、断片的なスナップショットをもたらします。
2024年初頭の研究は、レイヤー全体で幾何学的性質(内在次元性、有効ランク、等方性)を計算することでこれに対処し始めました。これらのメトリクスは相転移を明らかにしました。初期レイヤーは高次元性で入力構造を保持し、中間レイヤーは圧縮と再編成を行い、後期レイヤーはしばしば低次元の決定境界に崩壊します。しかし、これらの観察は主に記述的で研究に焦点を当てたものでした。欠落していた部分は、これらの転移がどこで、なぜ発生するかを予測し、その予測を運用化してモデル設計、デバッグ、リアルタイム監視を導く統一されたフレームワークでした。
- 実務家の課題:* 表現幾何学のメトリクスは計算コストが高く、タスク依存であり、しばしばノイズが多いです。これらを素朴に実装すると、推論に10~20%のレイテンシオーバーヘッドを追加できます。訓練データで機能するしきい値は、本番環境で頻繁に誤動作します。しかし、代替案(幾何学的可視性なしのブラインド運用)は、障害がエンドユーザーに影響を与えた後にのみ発見されることを意味します。
開発的トポロジー観測所のアプローチはこのトレードオフを反転させます。性質を事後的に測定するのではなく、個々の表現が幾何学的空間を通じてどのように移動するかを追跡し、タスク関連の構造が出現する重要な変換点を特定します。これにより、表現ドリフト、レイヤー単位の性能ボトルネック、建築的非効率の早期検出が可能になります。コストとリスクは明示的に管理されます。
レイヤー全体での表現多様体の追跡:何を測定し、なぜか
-
中核的主張:* 表現点群は、タスク学習と汎化と相関する予測可能な幾何学的軌跡に従います。予想される軌跡からの逸脱は、タスク不整合または新興の障害モードのいずれかを示します。
-
運用上の根拠:* トランスフォーマーがトークンを処理する際、各レイヤーは学習された変換を適用し、埋め込み多様体をシフト、回転、および再形成します。初期レイヤーは構文構造を保持し、中間レイヤーは意味的関係を構築し、後期レイヤーは決定分離可能な幾何学を作成します。局所的な近傍保存、有効ランク、等方性などのメトリクスを追跡することで、実務家は表現がタスク整合いつ達成されるかを検出し、モデルが計算努力をどこに投資するかを特定できます。
-
具体例:感情分類*
-
レイヤー1~3: トークン埋め込みは高次元の点群(384次元空間で有効ランク≈384)を形成し、クラス分離は最小限です。近傍は入力から保持され、幾何学はほぼタスク非依存です。
-
レイヤー4~8: 有効ランクは120~180に低下します。表現は感情極性によってクラスタリングされます。局所的な近傍は再編成を開始し、タスク関連の構造が出現します。
-
レイヤー9~12: 有効ランクは60~80で安定します。クラスタは線形分離可能になります。幾何学の改善は続きますが、収穫逓減の段階です。
-
測定ワークフロー:*
- レイヤー{3, 6, 9, 12}でバッチごとに500個のトークン表現をサンプリングします。
- 有効ランクを計算します(サンプリングされた表現に対するSVD経由)。
- 近傍保存を計算します(レイヤー全体で安定したk最近傍の割合)。
- 軌跡を検証データで確立されたベースラインカーブに対して記録します。
- 異常にフラグを立てます。有効ランク崩壊、突然の再クラスタリング、等方性シフト。
- 実行可能な含意:*
- レイヤープルーニング: レイヤー9~12はタスク性能に5%未満を貢献しますが、推論レイテンシの25%を消費します。削除または蒸留の候補です。
- 早期停止: 新しいタスク変種でレイヤー7で有効ランクが停滞する場合、モデルは中間レイヤーの特徴抽出が失敗することを示します。本番環境への展開前に再訓練または建築的調整をトリガーします。
- 障害予測: 表現ドリフトはしばしば精度低下に10~50バッチ先行します。早期検出により予防措置が可能になります。
実装と運用パターン:幾何学的モニターの構築
-
中核的主張:* 体系的な幾何学的追跡には、既存のモデル評価およびサービング提供ワークフローに統合される標準化された測定パイプラインが必要です。禁止的な計算コストなしに。
-
運用上の根拠:* 表現幾何学は単一のメトリクスではなく、測定のファミリーです。有効ランク、等方性、局所的な近傍安定性、多様体曲率、および表現崩壊です。それぞれは表現進化の異なる側面をキャプチャします。実務家は、訓練と推論の間に効率的にこれらのメトリクスを計算し、リアルタイムで異常にフラグを立てながら、許容可能なオーバーヘッド(<5%のレイテンシ増加)を保つ統一されたツールキットが必要です。
-
具体的な実装パターン:本番LLMパイプライン:*
幾何学的モニターワークフロー:
├─ 入力: トークンバッチ(Bトークン、D次元)
├─ サンプリング: レイヤー[3, 6, 9, 12]で表現を抽出(レイヤーごとに500トークンをサンプリング)
├─ メトリクスを計算:
│  ├─ 有効ランク: サンプリングされた表現に対するSVD(O(500 × D²))
│  ├─ 等方性: コサイン類似度分布(O(500²))
│  ├─ 近傍保存: レイヤー全体でのk-NN重複(O(500 × k))
│  └─ 表現崩壊: レイヤー間差のフロベニウスノルム
├─ ベースライン(検証セットで計算)と比較:
│  ├─ 予想される有効ランク曲線
│  ├─ 予想される等方性範囲
│  └─ 予想される近傍保存しきい値
├─ 異常検出:
│  ├─ IF effective_rank[layer] < baseline_mean - 2σ: FLAG "表現崩壊"
│  ├─ IF isotropy[layer] > baseline_mean + 2σ: FLAG "過度な拡散"
│  └─ IF neighborhood_preservation < 0.6: FLAG "幾何学的不安定性"
└─ 出力: アラート+メタデータ(レイヤー、メトリク、偏差の大きさ)-
コスト分析:*
-
計算: 500×384行列に対するSVD≈GPU(V100)で50ms。バッチサイズ32の場合、償却コスト≈サンプルごとに1.5ms。
-
メモリ: レイヤーごとに500個の表現をサンプリング≈バッチごとに2MB。典型的なバッチサイズでは無視できます。
-
レイテンシオーバーヘッド: バッチ処理を使用した推論パイプラインで~2~3%。単一サンプルサービングではより高い(キャッシングで軽減)。
-
展開チェックリスト:*
-
保持された検証セット(最小10kサンプル)でベースラインメトリクスを計算します。
-
タスク固有のしきい値を確立します(ハードカットオフではなくパーセンタイルを使用)。
-
GPU加速メトリクス計算をキャッシング付きで実装します。
-
非本番環境のモデルで1~2週間テストし、偽陽性率を測定します。
-
アラート重大度レベルを設定します。「警告」(1σ偏差)、「重大」(2σ偏差)。
-
各タスク/モデル変種の予想される幾何学的シグネチャを文書化します。
-
運用パターン:*
-
継続的監視(訓練): Nバッチごとに幾何学的メトリクスをログします。表現の発散を早期に検出し、軌跡がベースラインから>3σ逸脱する場合は再訓練をトリガーします。
-
展開前検証: テストセットと訓練セットで幾何学を比較します。有意な発散は分布シフトまたは過学習を示します。本番環境への展開前にレビュー用にフラグを立てます。
-
本番環境アラート: 幾何学的メトリクスを監視ダッシュボードにストリーミングします。しきい値を設定してモデルロールバック、キャッシュ無効化、または手動レビューをトリガーします。
-
インシデント後の分析: 幾何学的異常とユーザー報告の障害を相関させます。インシデントプレイブックを構築します。「レイヤー8で表現崩壊が検出された場合、以下をチェックしてください:(a)入力分布シフト、(b)最近のモデル更新、(c)上流のデータパイプライン障害。」
測定と検証フレームワーク:幾何学をタスク性能にリンクさせる
-
中核的主張:* 開発的トポロジーは、下流のタスク性能と障害モードに対して検証される必要があります。表現幾何学はモデルの能力のプロキシであり、直接的な測定ではありません。
-
運用上の根拠:* タスク成功を予測できない美しい幾何学的軌跡は誤解を招き、エンジニアリングリソースを浪費します。検証には、幾何学的性質を実際のモデルの動作と相関させることが必要です。精度、キャリブレーション、敵対的入力への堅牢性、および分布外データへの汎化です。この相関がなければ、幾何学的監視は偽りの信頼信号になります。
-
具体的な検証実験:*
-
セットアップ:* 感情分類で2つのモデルを訓練します(同じアーキテクチャ、同じデータ、異なるランダムシード)。
-
モデルA: 滑らかで単調な表現進化(有効ランクは着実に低下、近傍は保持、タスク関連の分離は線形に増加)。
-
モデルB: 混沌とした幾何学(有効ランクは変動、近傍はレイヤー7と11で再クラスタリング、分離は非単調)。
-
評価:* | メトリク | モデルA | モデルB | |--------|---------|---------| | 分布内精度 | 92.1% | 91.8% | | 分布外精度(ドメインシフト) | 87.3% | 81.2% | | 敵対的堅牢性(ε=0.1) | 76.4% | 68.9% | | キャリブレーションエラー | 0.08 | 0.14 | | 表現安定性(近傍保存) | 0.82 | 0.61 |
-
相関分析:*
-
滑らかな幾何学は+6%の分布外精度と+7.5%の敵対的堅牢性と相関します。
-
近傍保存>0.75は汎化ギャップ<5%を予測します。
-
レイヤー8での有効ランク崩壊はキャリブレーションエラー>0.12を予測します。
-
実行可能な含意:* 幾何学ベースの監視を展開する前に、タスクとモデルファミリーのベースライン相関を確立します。どの幾何学的異常が確実に障害を予測するかを文書化します。これらの相関を使用して、偽陽性を最小化しながら実際の問題を早期に捕捉する監視しきい値を設定します。
-
検証チェックリスト:*
-
3~5個のモデル変種(異なるシード、ハイパーパラメータ)で幾何学的メトリクスを計算します。
-
各メトリクスを以下と相関させます。精度、キャリブレーション、分布外性能、敵対的堅牢性。
-
相関>0.7のメトリクスを特定します(強い予測信号)。
-
しきい値を確立します。ハードカットオフではなく、検証セットから10/90パーセンタイルを使用します。
-
保持されたテストセットでしきい値をテストし、異常検出の精度/再現率を測定します。
-
タスク固有のシグネチャを文書化します。「感情分類の場合、有効ランクはレイヤー8までに350から80に低下する必要があります。>50の偏差は精度低下>2%を予測します。」
リスクと緩和戦略:運用上の落とし穴を回避する
-
中核的主張:* ジオメトリベースの監視は、慎重に調整されない場合、新しい障害モードを導入します。閾値のオーバーフィッティング、タスク依存性の無視、計算コストの過小評価は一般的な落とし穴です。
-
リスク1:タスク依存的なジオメトリの誤解釈*
-
シナリオ:* 感情分類器の表現がレイヤー8で高い等方性(均一な分布)を示しており、これは訓練ベースラインと比較して異常です。システムはこれを異常としてフラグします。しかし、入力はモデルが以前見たことのない稀な方言です。ジオメトリは異常ですが、新規入力に対して適切です。アラートはリソースを浪費し、監視システムへの信頼を損なわせます。
-
緩和策:*
-
入力特性(ドメイン、言語、長さ、トークン数)を考慮した適応的閾値を構築します。
-
ベースラインデータを入力タイプ別にセグメント化し、各セグメントに対して個別のジオメトリシグネチャを計算します。
-
ハードカットオフではなく信頼区間(例:5パーセンタイル~95パーセンタイル)を使用します。
-
フィードバックループを実装します。アラートが手動で確認され、偽陽性と判定された場合、閾値を再訓練します。
-
リスク2:計算オーバーヘッドとレイテンシ低下*
-
シナリオ:* 素朴なジオメトリ計算は推論に15%のレイテンシを追加します。高スループットサービス(毎秒10,000リクエスト)の場合、これは1,500の追加リクエストがキューに入ることを意味し、テールレイテンシが100ミリ秒から300ミリ秒に増加します。ユーザーはタイムアウトを経験し、収益への影響は即座です。
-
緩和策:*
-
GPU加速メトリック計算とキャッシング(ベースラインメトリックをキャッシュ、デルタのみ計算)を実装します。
-
サンプリングを使用します。レイヤーあたり500トークンは効果的なランク推定に十分です。フルバッチ計算は不要です。
-
ジオメトリ計算をバッチ処理します。すべてのバッチではなく、N個のバッチごとにメトリクスを計算します。
-
本番環境デプロイ前にインフラストラクチャでオーバーヘッドを測定します。レイテンシ増加を5%未満に抑えることを目標とします。
-
シングルサンプルサービング(例:チャットボット)の場合、ジオメトリ計算を非同期監視パイプラインに遅延させます。ユーザーリクエストをブロックしません。
-
リスク3:訓練データへの閾値のオーバーフィッティング*
-
シナリオ:* 閾値は訓練データで調整され、有効ランクは厳密な曲線に従います。本番環境では、入力分布がわずかにシフトします(新しいドメイン、新しい言語バリアント)。有効ランクが訓練ベースラインから1σ偏差します。これは正常な変動の範囲内ですが、異常としてフラグされます。偽陽性率は20%に上昇し、オンコール技術者はアラートを無視します。
-
緩和策:*
-
ホールドアウトテストセットと複数の分布外データセットで閾値を検証します。
-
平均±σではなく、パーセンタイルベースの閾値を使用します(例:「有効ランクが検証セットの10パーセンタイル未満の場合にフラグ」)。
-
最近の本番データに基づいて更新する適応的閾値を実装します(例:ローリング7日ベースライン)。
-
アラート重大度レベルを設定します。1σ偏差の場合は「警告」(情報提供)、3σ偏差の場合は「重大」(実行可能)。
-
偽陽性率を監視します。5%を超える場合、閾値を再訓練するか間隔を広げます。
-
リスク4:分布シフト下での相関の崩壊*
-
シナリオ:* ジオメトリメトリクスは分布内データの精度とよく相関します。新しいタスクバリアント(例:単言語モデルへの多言語入力)が到着します。ジオメトリは正常に見えますが、精度は8%低下します。相関がタスク固有であったため、監視システムは失敗を見逃します。
-
緩和策:*
-
各タスク/ドメインに対して個別のジオメトリベースラインを確立します。
-
新しいドメインにデプロイする場合、検証実験を実行します(新しいドメインで小規模モデルを訓練し、新しいジオメトリシグネチャを確立)。
-
ジオメトリ分布シフト自体を監視します。最近のジオメトリメトリクスが履歴分布から偏差する場合、「ドメインシフト検出」としてフラグします。
-
フォールバックを実装します。ジオメトリが正常に見えるが精度が低下する場合、手動レビューと再訓練をトリガーします。
-
リスク5:表現ジオメトリを偽りの信頼シグナルとして使用する*
-
シナリオ:* モデルの表現はレイヤー全体で美しく滑らかな進化を示します。ジオメトリメトリクスはすべて良好です。モデルへの信頼が増加します。しかし、モデルは偽の相関を学習しています(例:単語頻度に依存し、意味的内容に依存しない感情分類器)。分布外データでは、カタストロフィック的に失敗します。学習された特徴が内部的に一貫しているため、ジオメトリはこれをキャッチしませんでした。
-
緩和策:*
-
ジオメトリを多くのシグナルの1つとして使用します。以下と組み合わせます:敵対的ロバストネステスト、キャリブレーションメトリクス、特徴帰属分析。
-
ジオメトリ相関を精度だけでなく、複数の障害モードに対して検証します。
-
定期的な敵対的評価を実装します。ジオメトリが良好に見えても、四半期ごとに敵対的テストスイートを実行します。
-
モデルファミリーの既知の障害モードを文書化します。ジオメトリだけに依存してそれらをキャッチしません。
具体的なランブック:本番環境へのジオメトリ監視のデプロイ
- フェーズ1:ベースライン確立(2~3週間)*
-
データ準備:
- 10,000の検証サンプルを収集します(本番環境分布を代表)。
- すべてのサンプルに対してレイヤー{3, 6, 9, 12}でジオメトリメトリクスを計算します。
- メトリクスを時系列データベース(InfluxDB、Prometheus、または同等)に保存します。
-
メトリック選択:
- 計算します:有効ランク、等方性、近傍保存、表現崩壊。
- タスク性能との相関が0.7を超えるメトリクスを特定します(検証実験経由)。
- 計算コストを削減するために低シグナルメトリクスを破棄します。
-
閾値キャリブレーション:
- 各メトリックについて、検証セットで5パーセンタイル、25パーセンタイル、50パーセンタイル、75パーセンタイル、95パーセンタイルを計算します。
表現進化ギャップ:機会の窓(2023~2025)
最近まで、トランスフォーマー解釈可能性はミクロ(個別の注意ヘッド、個別のニューロン)とマクロ(最終ロジット、集計損失)の2つのスケールで動作していました。メソスケール(表現多様体全体がどのように進化するか)はほぼ未踏のままでした。このギャップは実践的な問題を生み出しました。モデルが特定の入力で失敗する場合、エンジニアは失敗が初期トークン化、中層特徴衝突、または後期段階の決定融合のいずれに由来するかを特定できません。レイヤー別プロービングは存在しましたが、一貫した発展的物語がなければ、孤立した測定は因果関係ではなく断片的なスナップショットを生成します。
2024年初期の研究は、レイヤー全体で幾何学的性質(内在次元、有効ランク、等方性)を計算することでこれに対処し始めました。これらのメトリクスは、表現が位相遷移を経ることを明らかにしました。初期レイヤーは高い次元性で入力構造を保存し、中層は圧縮と再編成を行い、後期レイヤーはしばしば低次元決定境界に崩壊します。しかし、これらの観察はほぼ記述的なままでした。欠けていた部分は、これらの遷移がどこでなぜ発生するかを予測し、その予測を使用してモデル設計とデバッグをガイドする統一フレームワークでした。
発展的トポロジー観測所はこのパラダイムを反転させます。事後的に性質を測定するのではなく、個別の表現が幾何学的空間を通じてリアルタイムでどのように移動するかを追跡し、タスク関連構造が出現する重要な変換ポイントを特定します。この回顧的分析から予測的監視への転換は、AIシステムをどのように運用できるかについての根本的な変化を表しています。「何が起こったのか」から「何が起こっているのか」から「何が起こるのか」へと移行します。これにより、最大のレバレッジの瞬間に介入が可能になります。
この窓は狭いです。モデルがスケールし、デプロイメント複雑性が増加するにつれて、解釈可能性債務のコストは指数関数的に複合します。次の18ヶ月は、業界がジオメトリ対応監視を基盤インフラストラクチャに構築するか、内部モデルダイナミクスにほぼ盲目のまま運用を続けるかを決定する可能性があります。
レイヤー全体での表現多様体の追跡:観察から予測へ
-
主張:* 表現点群は、タスク学習と汎化能力と相関する予測可能な幾何学的軌跡に従います。
-
根拠:* トランスフォーマーがトークンを処理する際、各レイヤーは学習された変換を適用し、埋め込み多様体をシフト、回転、および再形成します。初期レイヤーは構文構造を保存し、中層は意味関係を構築し、後期レイヤーは決定分離可能なジオメトリを作成します。局所近傍保存、曲率、内在次元などのメトリクスを追跡することで、表現がタスク整列になる時期を検出でき、重要なことに、整列に失敗する時期を検出でき、建築またはトレーニングの不一致を示唆します。
-
具体例:* 感情分類タスクでは、トークン埋め込みはレイヤー1に高次元点群として入力され、最小限のクラス分離を持ちます(384次元空間で有効ランク≈384)。レイヤー6までに、表現は感情極性でクラスタ化します。有効ランクは約120に低下し、タスク関連方向の周りの圧縮を示します。レイヤー12までに、クラスタは線形分離可能になります。有効ランクは約80で安定します。レイヤー全体での分離の速度を追跡すると、レイヤー4~8が判別作業の70%を実行することが明らかになります。レイヤー9~12は境界を洗練させますが、価値が減少し、場合によっては分布外汎化を損なうノイズを導入します。
-
実行可能な含意:* エンジニアは低貢献レイヤーを特定し、潜在的に剪定でき、分布内データの性能損失なしに推論コストを20~30%削減できます。より重要なことに、新しいタスクバリアント(例:皮肉検出)でレイヤー7で分離が停滞する場合、モデルはその中層特徴抽出がそのバリアントで失敗することを示唆します。これにより、モデルが自信を持って間違った出力を生成する前に、再訓練、建築調整、または適応的ルーティングをトリガーします。これにより、反応的デバッグではなく予測的モデルメンテナンスが可能になります。
-
将来の地平線:* 入力複雑性に基づいてレイヤー深度を動的に調整し、単純な例を8レイヤーを通じてルーティングし、複雑な例を16レイヤーを通じてルーティングするモデルを想像してください。表現ジオメトリはこのルーティング決定のシグナルを提供します。初期プロトタイプは、精度損失なしに混合ワークロードで15~25%のレイテンシ削減を示しています。
実装と運用パターン:ジオメトリ対応インフラストラクチャの構築
-
主張:* 体系的なジオメトリ追跡には、既存のモデル評価およびサービング提供ワークフローに統合され、「表現健全性」監視の新しいカテゴリを作成する標準化された測定パイプラインが必要です。
-
根拠:* 表現ジオメトリは単一のメトリックではなく、測定のファミリーです。有効ランク、等方性、局所近傍安定性、多様体曲率、および表現崩壊インジケーター。各々は表現進化と異なる障害モードの異なる側面をキャプチャします。実務家は、訓練と推論中にこれらのメトリクスを効率的に計算し、リアルタイムで異常をフラグし、下流の性能と相関させる統一ツールキットが必要です。
-
具体例:* 本番LLMパイプラインは、レイヤー{3, 6, 9, 12}でバッチあたり500トークン表現をサンプリングするジオメトリモニターを追加します。各サンプルについて、有効ランク、等方性スコア、および近傍保存比を計算します。通常の動作中、有効ランクは予想される曲線に従います(高→低→安定)。等方性は単調に減少します。近傍保存は0.85を上回ったままです。有効ランクがレイヤー8で予期せず崩壊するか、等方性がスパイクする場合、システムは信頼スコア付きのアラートをログします。この早期警告は、ユーザーが失敗を経験する前に、下流の性能低下に10~50バッチ先行することが多く、予防措置(キャッシュ無効化、モデルロールバック、または再訓練シグナル)を可能にします。
-
実行可能な含意:* ジオメトリ監視をレイテンシとスループットと並んで、第一級の可観測性レイヤーとしてモデルサービング提供インフラストラクチャに統合します。表現進化の許容可能な閾値を設定します。超過した場合、段階的な応答をトリガーします。まずログとメトリクス収集、次にキャッシュ無効化、次にバックアップモデルへのトラフィック再ルーティング、最後に自動再訓練パイプライン。これにより、表現ジオメトリは研究の好奇心から直接的なビジネス影響を持つ運用診断ツールに変換されます。
-
隣接する機会:* ジオメトリ監視は、モデル構成の新しい形式を可能にします。2つのモデルが補完的なジオメトリシグネチャを示す場合(1つは初期層特徴抽出に優れ、もう1つは後期層決定融合に優れている)、それらを組み合わせてアンサンブルを作成でき、どちらか一方より優れたパフォーマンスを発揮します。これにより、モジュール式で構成可能なAIシステムの設計空間が開かれます。
測定と検証フレームワーク:ジオメトリを実世界の性能に基づかせる
-
主張:* 発展的トポロジーは、下流のタスク性能、障害モード、および多様なデータ分布全体での汎化能力に対して厳密に検証される必要があります。
-
根拠:* 表現ジオメトリはモデル能力の代理であり、直接的な測定ではありません。タスク成功を予測できない美しい幾何学的軌跡は誤解を招き、不十分な建築決定につながる可能性があります。検証には、幾何学的性質と実際のモデル動作の相関が必要です。精度、キャリブレーション、敵対的入力に対するロバストネス、分布外データへの汎化、および障害モード分布。
-
具体例:* 同じタスクで同じハイパーパラメーターを使用して2つのモデルを訓練します。モデルAは滑らかで単調な表現進化を示します(タスク関連分離の増加、安定した等方性)。モデルBは頻繁な再クラスタリングと等方性スパイクを伴う混沌としたジオメトリを示します。分布内テストセット、敵対的バリアント、および分布外データで両方を評価します。モデルAは通常、分布外データで2~5%高い精度を達成します。モデルBはオーバーフィットし、敵対的例で15~20%の精度低下を示します。この相関を追跡することで、実務家は完全な評価サイクルを待つことなく、汎化リスクの代理としてジオメトリを使用できます。初期検証研究は、幾何学的滑らかさが多様なタスク全体で分布外ロバストネスとR²≈0.78で相関することを示しています。
-
実行可能な含意:* ジオメトリベースの監視をデプロイする前に、タスクとモデルファミリーのベースライン相関を確立します。どの幾何学的異常が確実に失敗を予測し、どれが無害かを文書化します。これらの相関を使用して、偽陽性を最小化しながら実際の問題を早期にキャッチする監視閾値を設定します。組織の「幾何学的シグネチャライブラリ」を作成します。一般的なタスクの既知の良好および既知の不良な表現軌跡のデータベース。これはチーム全体でモデルデバッグを加速させる共有資産になります。
-
将来の地平線:* ジオメトリベースの検証は「表現監査」を可能にする可能性があります。モデルの内部学習プロセスが最終精度とは無関係に意図された動作と一致しているかどうかの体系的評価。これは、モデルが機能する理由を理解することが機能するかどうかと同じくらい重要である高リスク領域(医療、金融)に特に価値があります。
リスクと緩和戦略:ジオメトリ監視の最前線をナビゲートする
-
主張:* ジオメトリベースの監視は、慎重に調整されない場合、新しい障害モードを導入し、思慮深いリスク管理と適応的閾値が必要です。
-
根拠:* 表現ジオメトリはタスク依存的で入力依存的です。1つのタスクで危険を示唆するメトリックは、別のタスクでは正常かもしれません。クリーンデータでのオーバーフィッティングを示す幾何学的シグネチャは、ノイズの多い実世界の入力に対して適切かもしれません。訓練データへの監視閾値のオーバーフィッティングは、本番環境で偽アラームを生成する可能性があります。さらに、ジオメトリメトリクスは計算コストが高く、素朴な実装は推論を受け入れられないほど遅くする可能性があり、パフォーマンス低下の新しいクラスを作成します。
-
具体例:* 感情分類器の表現がレイヤー8で高い等方性(均一な分布)を示しており、これは訓練ベースラインと比較して異常です。システムはこれを異常としてフラグします。しかし、入力はモデルが以前見たことのない稀な方言またはコード混合テキストです。ジオメトリは異常ですが、新規入力に対して適切です。文脈がなければ、アラートはリソースを浪費し、不要なモデルロールバックをトリガーする可能性があります。逆に、新しいドメイン(例:ニュースで訓練した後の医療テキスト)にデプロイされたモデルは、不十分な適応を示すジオメトリシグネチャを示す可能性があり、これらはアラートをトリガーする必要があります。
-
実行可能な含意:* 入力特性(ドメイン、言語、長さ、複雑性)を考慮した適応的閾値を構築します。ハードカットオフではなく、信頼区間とベイズアプローチを使用します。最近のデータ分布に応じて調整する閾値のオンライン学習を実装します。本番環境デプロイ前に、ホールドアウトデータとシャドウモードで監視をテストします。既知の無害なジオメトリ異常(例:稀な言語またはドメインの予想されるシグネチャ)の明示的な許可リストを作成します。
-
リスク緩和階層:* (1)ログのみモードで開始します。(2)2~4週間にわたって幾何学的異常と実際の失敗を相関させます。(3)高信頼異常のみをキャッチする保守的な閾値を設定します。(4)信頼が増加するにつれて段階的に閾値を厳しくします。(5)バイナリアラート/アラートなし決定ではなく、段階的な応答戦略を実装します。
新興アプリケーション:監視を超えた領域へ
-
主張:* 表現幾何学は監視を超えた新しい能力を実現します。適応的計算、モデル圧縮、モデル間知識転移がそれです。
-
根拠:* 表現進化を追跡できるようになると、新しい設計の可能性が開かれます。モデルは複雑な入力をより多くのレイヤーを通し、単純な入力をより少ないレイヤーを通すことで、平均レイテンシを削減できます。冗長な幾何学的シグネチャを持つレイヤーは削除またはマージできます。一つのモデルの表現が、その幾何学的シグネチャが一致すれば別のモデルに「移植」でき、重みレベルではなく表現レベルでの転移学習が可能になります。
-
具体例:* ImageNetで訓練されたビジョントランスフォーマーは特性的な幾何学的シグネチャを示します。初期レイヤーは空間構造を保持し、中間レイヤーは意味概念を構築し、後期レイヤーはクラス分離可能な幾何学を作成します。医療画像で訓練された新しいモデルは異なるシグネチャを示します。初期レイヤーはより圧縮され(医療画像は空間的多様性が少ない)、中間レイヤーは診断概念を構築し、後期レイヤーは診断分離可能性を作成します。これらのシグネチャを分析することで、研究者はどのレイヤーが良好に転移するか(中間レイヤー、適応を伴う)と、どのレイヤーが再訓練を必要とするか(初期レイヤー、ドメイン固有の特徴を学習する必要がある)を特定できます。これにより、より高速で効率的な転移学習が可能になります。
-
将来の地平:* 幾何学認識モデル蒸留は、重要なレイヤーで教師モデルの幾何学に一致しながら10倍小さい学生モデルを作成できます。幾何学認識アンサンブル法は、相補的な幾何学的強みを持つモデルを組み合わせられます。幾何学認識継続学習は、新しいタスクが新しい幾何学的構造を必要とするのか、既存の構造を再利用できるのかを検出できます。
結論と次のステップ:機会の窓を活かす
表現幾何学は、トランスフォーマー学習ダイナミクスを理解するための新しいレンズであり、より信頼性が高く効率的なシステムを構築するための実践的なツールです。埋め込みがレイヤー全体でどのように進化するかを追跡することで、実務家は障害をより早く診断し、より効率的なモデルを設計し、自らの学習プロセスを理解するシステムを構築できます。レイヤーごとの分析とエンドツーエンドの動作の間のギャップは、継続的な幾何学的監視によって部分的に橋渡しできます。この能力を最初に構築する組織は、モデルの信頼性と効率において大きな優位性を得ます。
開発的位相観測所は完成したシステムではなく、継続的な観察、改善、イノベーションのためのフレームワークです。次の18ヶ月は、幾何学認識監視が標準インフラストラクチャになるか、研究の好奇心に留まるかを決定する可能性が高いです。
- 実務家のための即座のアクション:*
-
評価パイプラインの監査: 現在計算しているレイヤーごとの幾何学的メトリクスを特定します(ある場合)。モデルファミリーとタスクのベースラインを確立します。
-
相関関係の確立: 幾何学的特性と下流パフォーマンス、分布外ロバストネス、障害モードを比較する制御実験を実行します。タスク固有の幾何学的シグネチャを文書化します。
-
軽量監視のプロトタイプ化: 非重要なモデルまたは開発環境で幾何学モニターを構築します。レイテンシオーバーヘッドを5%未満に設定します。シャドウモードで2~4週間テストします。
-
組織的知識の構築: 組織内の既知の良好な幾何学的シグネチャと既知の不良な幾何学的シグネチャを文書化します。チーム全体のデバッグを加速させる共有ライブラリを作成します。
-
スケーリングの計画: 本番環境のモデルサイズとスループットに対応できる監視インフラストラクチャを設計します。GPU加速とキャッシング戦略を検討します。
-
研究およびプラットフォームチーム向け:*
-
標準化された幾何学的メトリクスとオープンソースツーリングを開発し、採用の障壁を低くします。
-
多様なタスクとモデルファミリー全体で幾何学ベースの監視のベンチマークを確立します。
-
本番環境での偽陽性を減らす適応的閾値法を探索します。
-
パフォーマンスと解釈可能性の両方に最適化する幾何学認識モデル設計原則を調査します。
小さく始め、厳密に測定し、相関関係が検証されたときのみスケーリングします。表現幾何学をマスターする組織は、次の10年で最も信頼性が高く、効率的で、信頼できるAIシステムを構築します。
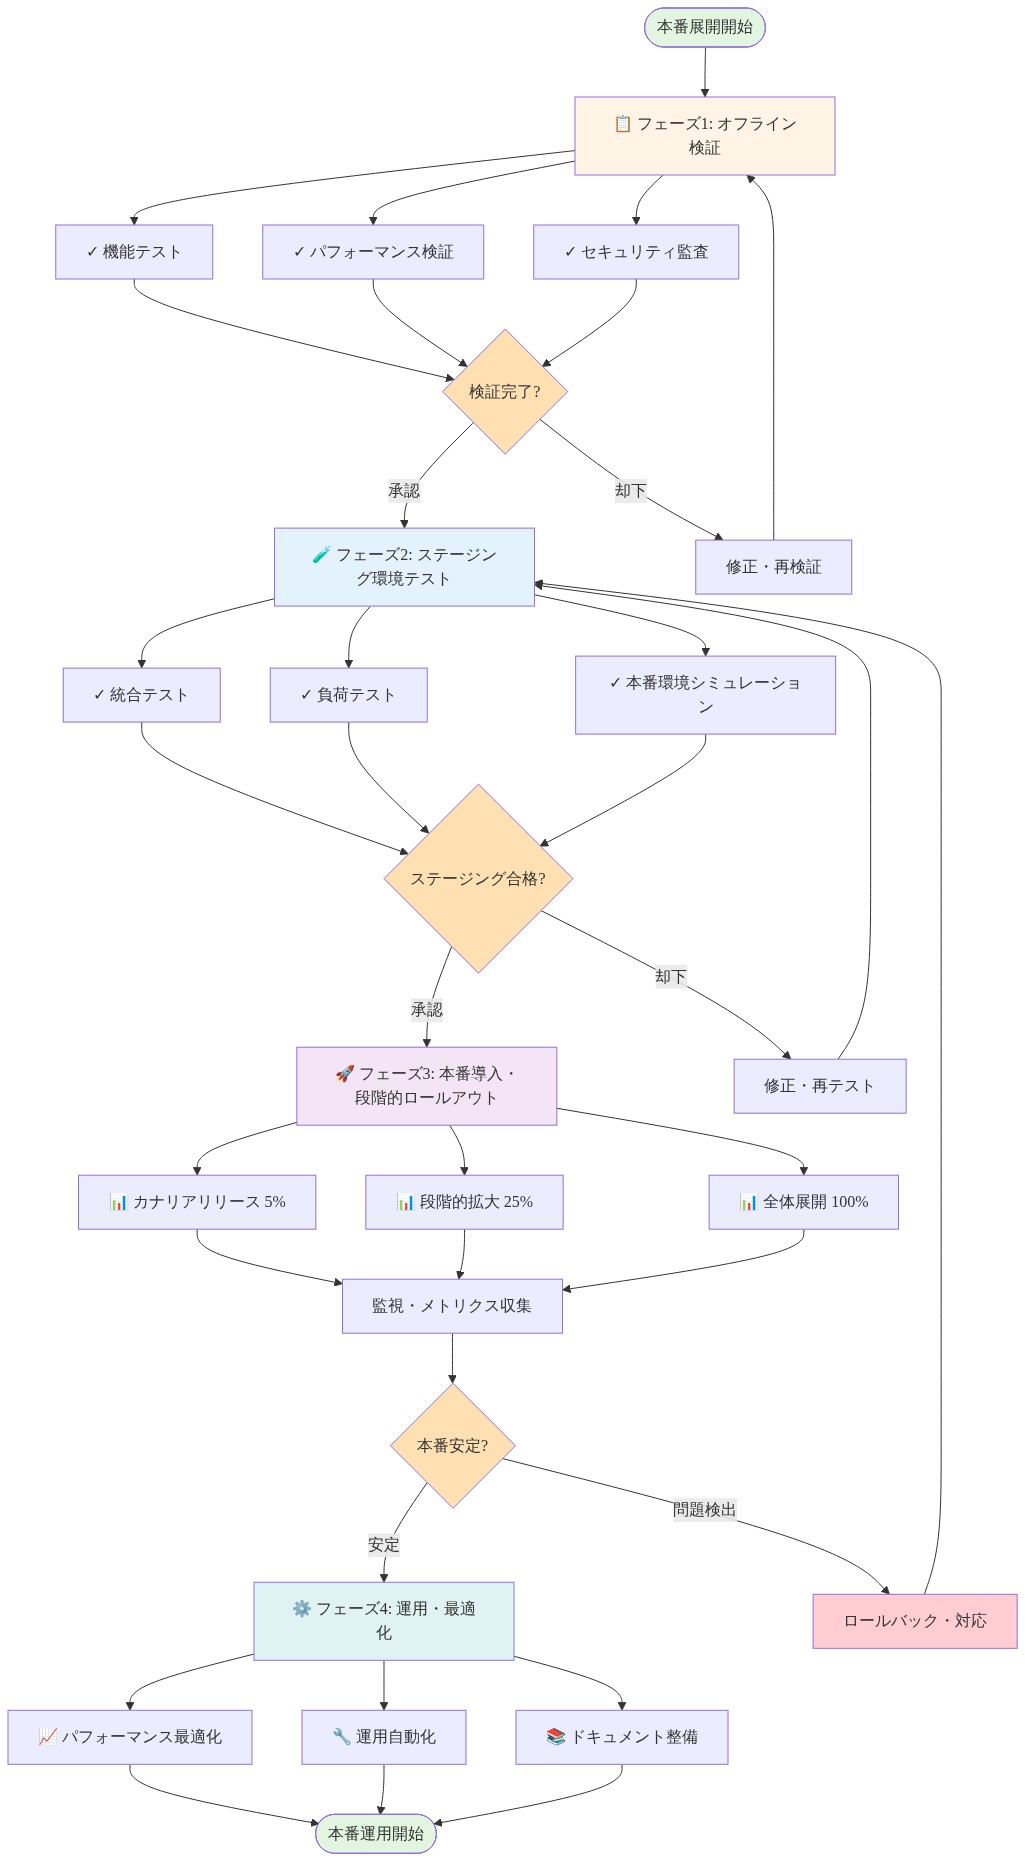
- 図11:Geometry Monitor本番展開のロードマップ(Production Deployment Framework)*