AhaBench:エージェントは経験から学ぶのか 長期継続学習のためのベンチマーク
多くのエージェント向けベンチマークは、たった1つの問いしか立てていない。「このエージェントは今このタスクを解けるか」というものだ。
エージェントはプロンプトを受け取り、行動の軌跡を作り、点数がつく。そして次のタスクでは、まっさらな状態に戻される。
だが、この作り方には見落としがある。実際に使われるシステムは、経験を積むほど賢くなることが前提だからだ。1回のやりとりで得た教訓を、次のやりとりに持ち込めることが期待されている。
AhaBenchが狙うのは、まさにこの見落としだ。エージェントが本当に過去の経験から学んでいるかを問う。もし学んでいないなら、以前見た状況とそっくりなときだけうまくやれている、ということになる。
この記事のポイント
- 多くのベンチマークは、1回の実行での純粋な能力しか測っていない。学びが後のタスクに引き継がれるかは測っていない。
- 実際のエージェントは長い時間軸で動く。追加の質問、使い回される文脈、ツールからのフィードバック、遅れて表れる結果などがある。
- AhaBenchはまずエージェントに役立つ経験を与える。その後、支えとなる情報を取り除いたり、変えたり、遅らせたりした関連タスクで試す。
単発型ベンチマークが学びを見落とす理由
今のベンチマークには、共通する2つの癖がある。タスクごとにエージェントをリセットするか、タスクの最終結果だけを採点するか。
どちらの癖も、同じものを見えなくしている。エージェントが関連する経験を得た後、何が起きるかだ。
見落とされている問いは、はっきり言葉にできる。あるモデルを固定し、役立つ経験を与えたとしよう。その支えを取り除いたり、変えたり、遅らせたりしたとき、後の成績は上がるだろうか。
標準的なベンチマークは、この問いをほとんど立てない。きれいに完走した記録は、そのエージェントが一度はタスクをこなせることしか示さない。
2回目にもっとうまくやれるか、すでに直されたはずの失敗を繰り返さないか、そこまでは分からないのだ。
この見落としには、現実的な影響がある。実際のエージェントは、単発テストが取りこぼす場面に何度も出くわす。
- 追加の質問:それまでの答えを踏まえて聞かれるもの
- 見本となる事例:後の似た問題に活かされるべきもの
- ツールからのフィードバック:何がうまくいき、何が失敗だったかを示すもの
- 遅れて表れる結果:ある行動の結果が、ずっと後になって現れるもの
- 状況のずれ:タスクや環境が少しずつ変わっていくもの
どの場面でも、エージェントは過去のやりとりと今の振る舞いをつなぐ必要がある。1回の軌跡しか見ない評価方法では、このつながりがあるかどうかは見えない。
2種類の評価の違いを、下にまとめる。
| 観点 | 単発型の評価 | 学習転移を測る評価 |
|---|---|---|
| 中心の問い | このタスクを解けるか | 経験は後の成績を上げるか |
| タスク間の状態 | リセットされる | 引き継がれる、または意図的に変えられる |
| 採点の対象 | 最終出力や終了時の状態 | 経験を経た後の振る舞いの変化 |
| 記憶頼みへの敏感さ | 低い(繰り返しは試されない) | 高い(表面的な一致と本当の転移を分ける) |
| 長期的な業務への関連性 | 限られる | 直結する |
AhaBenchは、この表の右側の列に立つベンチマークだ。学習転移を、当然備わっているものとしてではなく、測るべき性質として扱う。
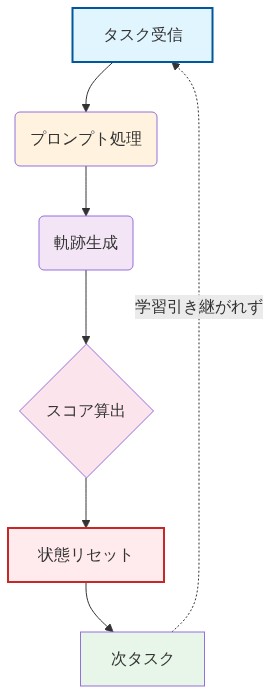
図2:従来のベンチマークにおけるタスク評価フロー(状態リセット)

表1:単一ショット評価と学習転移評価の比較(5次元分析)
変わった条件のもとで転移を試す仕組み
AhaBenchの設計は、条件を対比させることに支えられている。
まずエージェントに役立つ経験を与え、その後、支えとなる情報を取り除いたり変えたり遅らせたりした関連タスクを課す。この切り分けによって、エージェントが本当に使い回せる何かを学んだのか、それとも元の条件にただ当てはまっただけなのかが分かる。
この記事のポイント
- ベンチマークはエージェントに支え(見本、フィードバック、訂正)を与え、その後それを外して試す。パターンの当てはめと本当の学習を見分けるためだ。
- 「経験を与える」「試す」「採点する」という3段階の設計が、記憶頼みと転移の効果を切り分ける。
- 記憶を保持する仕組みは、経験を蓄えるだけで、それを使いこなしているかまでは証明しない。AhaBenchは、この「使いこなす」部分を試す。
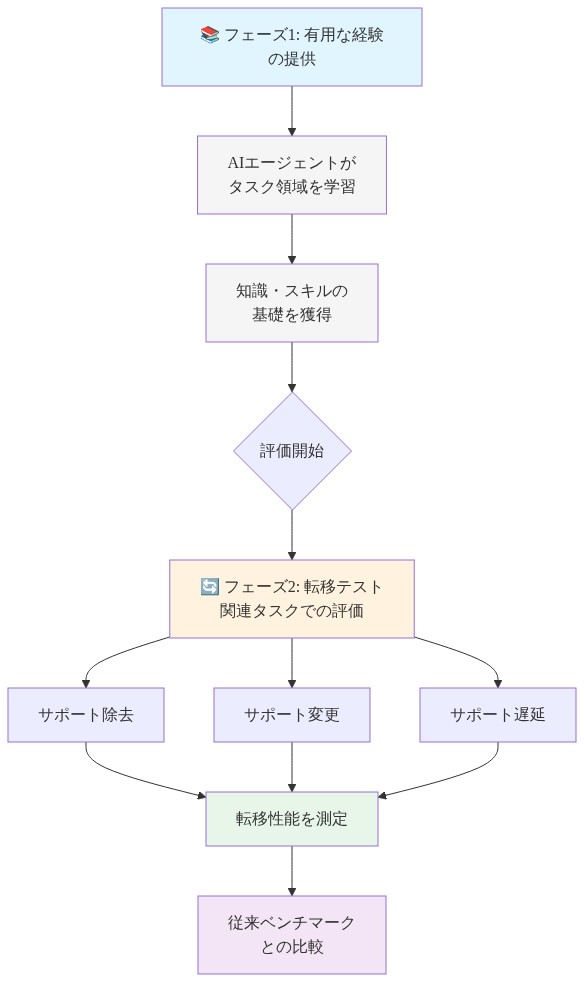
図4:AhaBenchの2段階評価フロー(How AhaBench Tests Transfer Under Altered Conditions)
記憶を持つことと、記憶を使うことの違い
いくつかのツールは、エージェントに持続的な記憶を持たせようとしている。こうした仕組みでは、毎回ゼロから始めるのではなく、セッションをまたいで経験を保ち、使い回せる。
だが、記憶の仕組みがあることと、学習が転移していることは同じではない。この違いが大事なのは、次の3つが別々に成り立たなければならないからだ。
- 保存:経験が記録され、取り出せる状態にあること。
- アクセス:エージェントが関連する記録を見つけ、読めること。
- 利用:その記録のおかげで振る舞いが変わること。元の状況と違う場面でも変わること。
いま出回っている持続的な記憶ツールは、主に最初の2つを扱っている。だが利用者が本当に気にしているのは3つ目であり、そこはまだ証明されていない。
過去の失敗をすべて完璧に記録しているエージェントを考えてみよう。以前の文脈がそのままそっくり再現されないと同じ失敗を繰り返すなら、それは学んでいない。記憶はあっても、振る舞いは変わっていないのだ。
AhaBenchの評価の考え方は、まさにこの隙間を突く。条件を変えたときに、ある記憶の仕組みが測れるほどの改善を生むかどうかを試せる。保存した情報を取り出せるかを確認するよりも、はるかに厳しい基準だ。
ここから、記憶の仕組みを比べる実践的な方法も見えてくる。同じ経験を保存する2つの仕組みがあったとしよう。
後で条件が変わったタスクで、エージェントの成績が良い方が、より役に立つ仕組みだということになる。取り出す速さや保存できる容量よりも、この結果のほうがものを言う。
実際の運用で転移が問われる場面
学習転移は、机上の話ではない。すでにエージェントが使われている、あるいは導入が計画されている2つの分野に直結する。セキュリティのツールと、人間による監視だ。
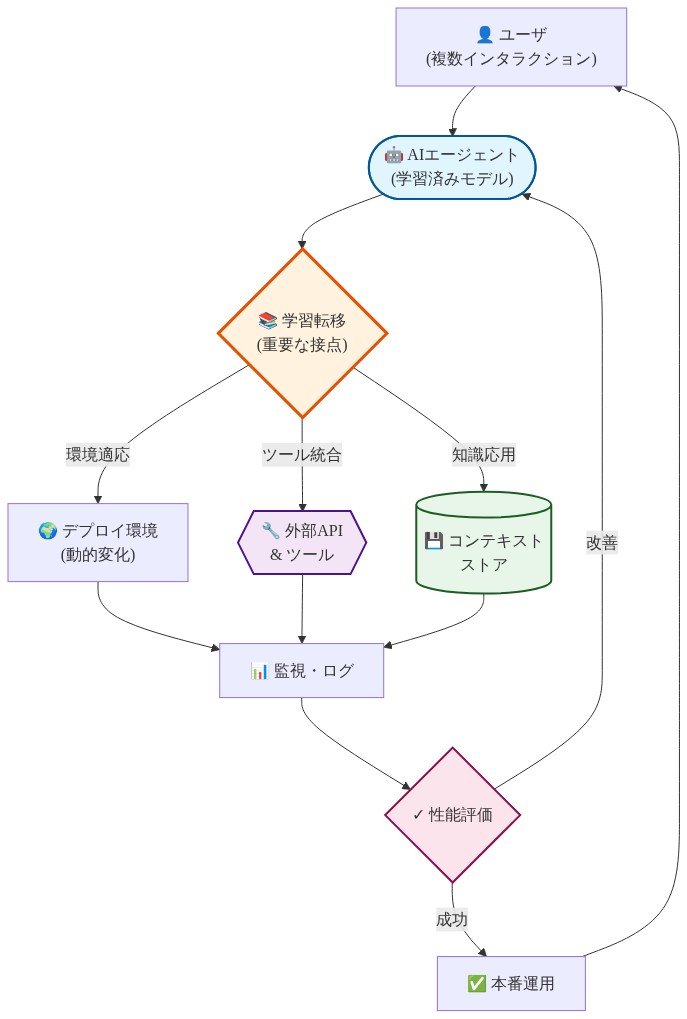
図9:デプロイメント環境におけるエージェント運用と学習転移の接点
セキュリティ診断と誤検知
エージェントによる脆弱性診断は、長期的な学習がなぜ実務で大事なのかをよく示している。
目標は誤検知、つまり実際の脅威ではないのに解析担当者の時間を奪ってしまう警告を減らすことだ。この目標を果たすには、エージェントが一度だけでなく、何度も繰り返しフィードバックを活かす必要がある。
学習するスキャン用エージェントには、次の3つが求められる。
- 指摘された問題が以前も確認され、問題なしと判断されたものかを見分ける
- 特定のコードベースのパターンに応じて、確信の度合いを調整する
- すでに訂正された失敗を繰り返さない
1回のスキャンではうまくやれても、次のスキャンで前提をリセットしてしまうエージェントは、学んでいない。
能力の高い手順を、何度も実行しているだけだ。その代償は、同じ誤警報を何度も確認し直す解析担当者の時間として現れる。そして、その雑音の中で本当の脅威が見逃されるという形でも現れる。
AhaBenchの考え方は、この場面にそのまま当てはまる。 大事な問いは、エージェントが一度だけ脆弱性を指摘できるかではない。
あるスキャナーとコードベースについて経験を積むにつれ、誤検知の割合が下がっていくかどうかだ。その改善は、以前の文脈がそっくり再現されない場合でも、成り立っている必要がある。
フィードバックに支えられた監視
いくつかのグループは、暴走したモデルの振る舞いを防ぐために、人間とAIが組み合わさった監視の仕組みを計画している。こうした設計は、ある1つの前提に支えられている。
エージェントは時間をかけたフィードバックによって導けるという前提だ。今与えられた結果が、後の振る舞いを形づくるという前提でもある。
AhaBenchの手法は、この前提を当たり前として扱うのではなく、試すことができる。その論理は、次のように鎖状につながっている。
- 監視の仕組みは、エージェントに訂正のフィードバックを与える。
- この仕組みが機能するには、その訂正がその場だけでなく、後まで残っていなければならない。
- 残っているかどうかは、条件を変えた後の振る舞いを見れば試せる。
- その条件のもとで振る舞いが改善していないなら、訂正は転移していなかったことになる。
訂正を受けた後、条件を変えても振る舞いが良くならないなら、フィードバックに頼った監視は、確かめられていない前提の上に立っていることになる。
そこにあるリスクは、その場だけの従順さだ。訂正のための文脈がある間はうまく振る舞い、それが消えると元に戻ってしまう。
これは、こうした監視の設計が必ず失敗するという意味ではない。ただ、その成否が、本来測るべき性質にかかっているという話だ。転移を測るタイプのベンチマークは、それを測る一つの手段になる。
2つの場面を比べる
| 分野 | 前提としていること | 転移を試す評価が確かめること |
|---|---|---|
| 脆弱性診断 | フィードバックによって、後の誤検知が減る | 後の変化したスキャンで、誤検知の割合が本当に下がるか |
| 人間による監視 | 訂正が後の振る舞いを形づくる | 訂正のための文脈がなくなっても、訂正後の振る舞いが残るか |
どちらの場合も、1回きりのきれいな実行では足りない。このシステムの価値は、複数回の実行を通じて何が起きるかにかかっている。
エージェント開発にとっての意味
AhaBenchのような評価方法が広まれば、エージェントの作り方や売り方の動機づけも変わっていくだろう。
「経験から学ぶ」という宣伝文句は、条件を変えても成り立つことを示さなければならなくなる。一度きりのデモは、以前ほどの説得力を持たなくなるはずだ。
この記事のポイント
- 学習転移を試すベンチマークは、データを蓄えるだけでなく、教訓を汎用化できる仕組みに報いることになる。
- 現在のエージェントの向上ぶりは、狭くて決まりきった状況でしか効かないプロンプトの工夫を、一部反映しているだけかもしれない。
- エージェントを評価する側には、記憶と本当の学習を切り分ける実践的な方法が求められる。
ちょっと立ち止まって
いま自分が使っているエージェントやAIツールを思い出してみてほしい。
先週何かを訂正したとき、そのツールは新しい場面でもその教訓を覚えていただろうか。それとも、同じことを繰り返し言ったときだけ効いていたのだろうか。
もしその答えがはっきり分かったら、そのツールへの信頼はどれくらい変わるだろうか。
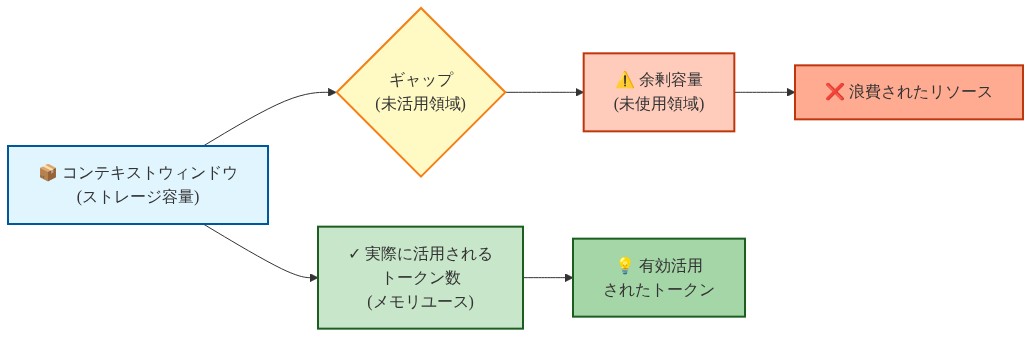
図6:メモリストレージ vs メモリユース - コンテキストウィンドウの容量と実際の活用状況の関係
図8:エージェントによる過去経験の活用プロセス