ローカルで動かすAIエージェントの「記憶のしかた」を比べる研究の多くは、いちばん大事な条件を抜かしている。1回の呼び出しで使える入力トークンの上限(予算)だ。
エージェントがどう覚えておくかを、研究者は評価する。切り捨て、要約、検索、それらの組み合わせなどがある。
たいていは品質スコアを1つだけ報告する。各方式が入力トークンをいくつまで使ってよかったのかは、ほとんど書かれない。
この抜けが結果をゆがめる。ある方式は積極的に検索して8Kの枠をいっぱいに使う。
別の方式はすべてを2Kに圧縮する。品質だけで採点すると、その差は方式の良し悪しとして扱われる。
だが差の多くは、使えたトークンの多さから来ているのかもしれない。
この記事のポイント
- 記憶方式の比較では、入力トークンの予算を隠れた設定にせず、独立変数として扱うべきだ。
- BudgetBenchの手順は、モデル、タスク、サンプラー、デコード設定を固定し、予算だけを2Kから32Kまでの5段階で変える。
- 測るのは4つの結果で、品質、予算の使い切り具合、遅延、予算超過の率である。
ローカル環境で予算が効く理由
予算の上限を決める理由は、ローカルのハードウェアでは3つの制約が同時にかかることにある。
- メモリ容量:文脈が長いほど、キー・バリュー(KV)キャッシュのためにRAMやVRAMがよけいに要る。
- プリフィルの遅延:最初の出力が出る前に、入力トークンをすべて処理しなければならない。
- キャッシュの膨張:長いセッションでは状態がたまり、限られたメモリの中でモデルと場所を奪い合う。
こうした制約があるため、予算を変えると順位がひっくり返ることがある。
32Kトークンで最良に見える方式が、4Kでは崩れるかもしれない。 逆に、2Kで生き残るよう作った方式は、予算が増えても余った容量を使いこなせないかもしれない。スコアが1つだけでは、どちらの振る舞いも見えない。
最近のエージェント向けデータ層の研究では、エージェントが情報にアクセスする仕組みを組み替えて、トークンを最大76%減らしたと報告されている。1 こうした数字を見ると、疑問が3つ浮かぶ。
- 何と比べた削減なのか。
- どの予算での話なのか。
- 答えの品質はどれだけ犠牲になったのか。
これらが分からないと、その数字はほかの結果と比べようがない。
似た問題に、予算の使いすぎがある。
ときどき上限を超えることで高い品質に届く方式は、決められた条件の課題を解いたことにならない。実際のサービスなら、超えた分は入力を切り捨てるか、エラーを返して上限を守らせるだろう。
これまでの研究では、長期にわたるタスクで学び続けられるかは、過去の経験を保持して取り出せるかにかかっていることが示されてきた。
足りていなかったのは、その学びが現実のハードウェア上で限られた文脈ウィンドウに収まるのかを、系統立てて確かめる試験だ。
予算の段階別評価はその試験になる。予算をはっきり示し、現実的な範囲で振り、各方式が上限を守れたかを記録する。
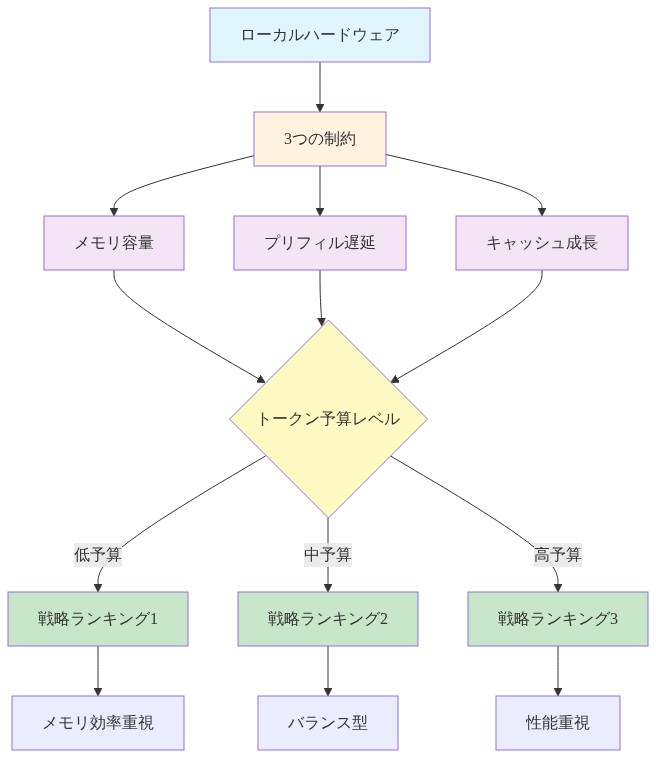
図2:ローカルハードウェアの3つの制約とメモリ戦略への影響
予算の段階別に評価する手順の設計
BudgetBenchは、ほかの条件を固定することで、記憶方式の違いだけを取り出す。モデル、タスク、サンプラー、デコード設定は、すべての実行で同じにする。変えるのは、そのとき使える入力予算だけだ。
手順では、等比数列に並べた5段階を使う。それぞれの段階は、ハードウェアの種類と遅延の環境が違う場面を表す。
| 段階 | 想定する場面 | 中心の問い |
|---|---|---|
| 2K | 性能の限られた個人向け機器、遅延に敏感な対話 | 何を残し、何を捨てられるか |
| 4K | モバイルやエッジでの運用 | 圧力の下でも大事な文脈を保てるか |
| 8K | モバイルやエッジの上限あたり | 余裕が増えた分、品質も上がるか |
| 16K | 高性能なハードウェア上の長文脈モデル | 単純な方式も競えるようになるか |
| 32K | 余裕のある長文脈の運用 | 効率がよいのか、生き延びているだけか |
段階ごとに予算を倍にすると、1方式あたり5回の実行で桁ひとつ分をカバーできる。予算が小さい側では、わずかな変化が性能を大きく動かす。この間隔なら、そこでの差も意味のある刻みになる。
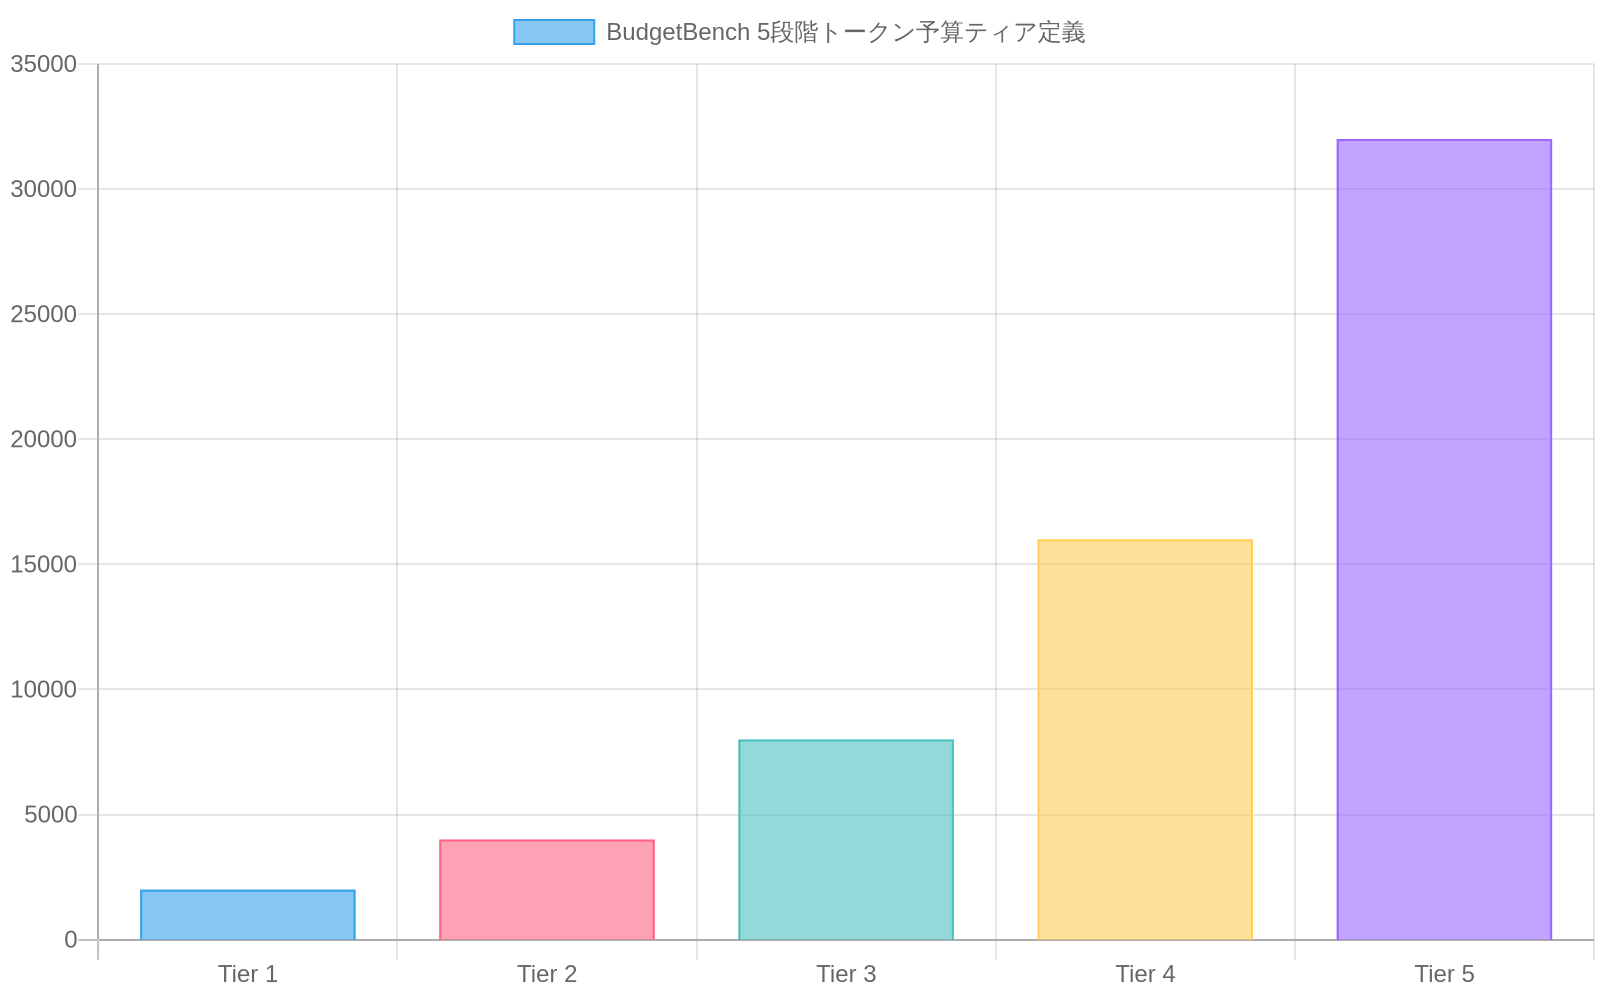
図6:BudgetBench 5段階トークン予算ティア定義(出典:BudgetBench protocol specification)
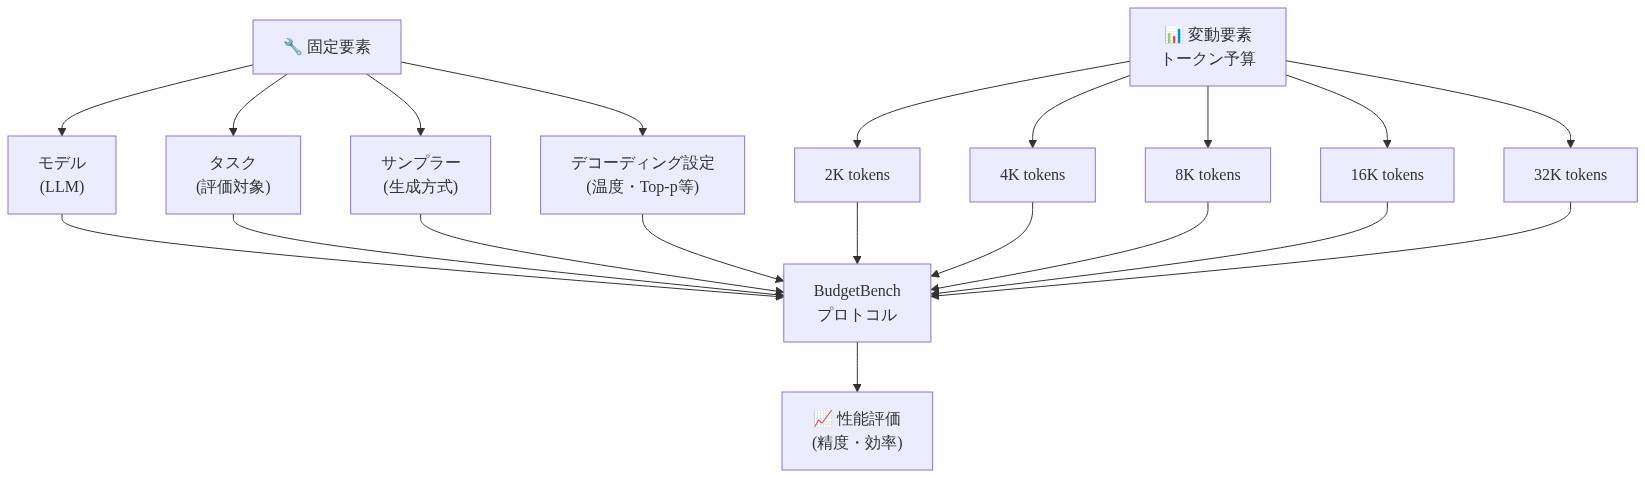
図5:BudgetBenchプロトコルの設計構造
ほかの条件を固定する意味
ほかの要因を一定にしておけば、性能の差を記憶方式のせいだと直接たどれる。品質が変わっても、モデルの選び方やタスクの違いのせいにはできない。
この設計には代償がある。ひとつのモデル系列に合わせて調整した方式は、別の系列では違う振る舞いをするかもしれない。
試作の段階では、分かりやすさを得るほうが代償より大きい。対象を広げるのはあとからでも、中心の比較は損なわれない。
1つの数字から性能の曲線へ
5段階の掃引を行うと、方式ごとに曲線ができる。
曲線を見れば、順位が入れ替わる点、早い段階での頭打ち、劣化が徐々に起きるのか急に起きるのかが分かる。 実際の判断では、こうした形のほうが、1つの順位表より役に立つ。
16Kを超えたときだけ良い成績を出す方式は、高い予算で1位でも、限られたハードウェアには向かない。曲線を描けば、このずれが見えてくる。
予算を守るべき上限として扱う
文脈を管理すると言いながら、範囲内に収まっているかを確かめない記憶方式は多い。BudgetBenchは、予算を超えてはならない上限として扱う。
すると、上限を確実に守る方式と、ときどき破る方式の違いが見えてくる。あふれが許されない運用では、この違いが効く。
何を測るのか
この評価の枠組みは、4種類の結果を記録する。品質は分かりやすい指標だが、残りの3つのほうが全体像をよく語ることも多い。
| 指標 | 捉えるもの | 大切な理由 |
|---|---|---|
| 品質 | 各段階でのタスク成績 | 主な結果だが、それだけでは足りない |
| 予算の使い切り具合 | 許された枠のうち実際に使った割合 | 意図した圧縮と、広い枠に合わせられない方式を見分ける |
| 遅延 | プリフィルとキャッシュ膨張にかかる実時間 | トークン数では見えない負荷が出る |
| 予算超過の率 | 方式が枠を超えた頻度 | 品質が制約の内側で出たのかが分かる |
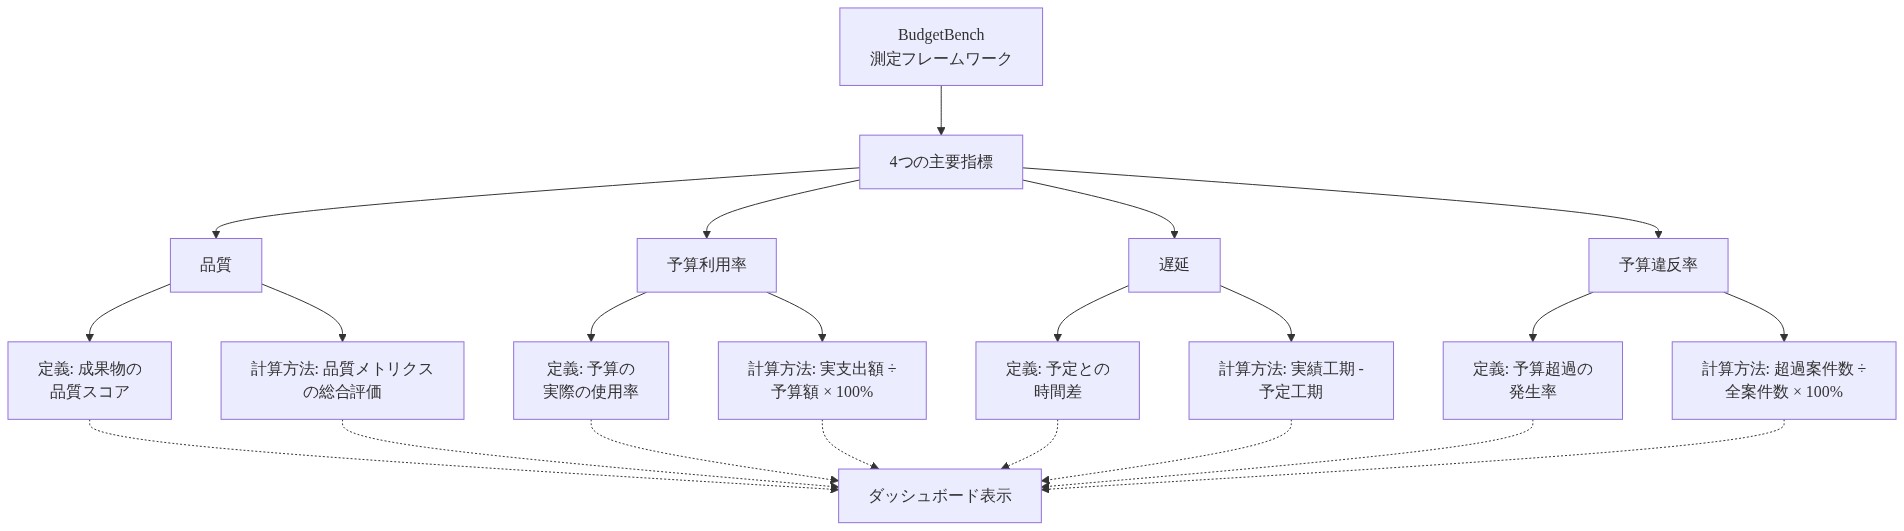
図7:BudgetBenchの4つの測定指標と定義・計算方法
使い切り具合
使い切り具合を見ると、その方式が使える余地を実際に使っているかが分かる。たとえば、4K以上のどの段階でも約1.5Kトークンしか使わない方式があるとする。それは、広いウィンドウに合わせて動く設計ではないというしるしだ。
高い段階で容量が余っていることは、低い段階であふれることと同じくらい、多くを語る。
遅延
トークン数が同じでも、コストが同じとは限らない。検索を多用する仕組みは、埋め込み、検索、再ランキングの手間が加わる。これらはトークン数には現れない。
実時間を測れば、プリフィルやキャッシュ膨張と並んで、こうした見えない負荷も捉えられる。
予算超過
超過の率は、補足ではなく主要な結果だ。品質と並べて数えれば、各方式を「上限をいつも守れたか」で評価できる。
超過の出方にも意味がある。特定の段階に超過が集中していれば、その方式のトークン計算が、あるウィンドウの大きさに合わせて調整されていたことを疑える。その前提が崩れると、計算が破綻するのだ。
指標どうしの関係
4つをそろえて報告すると、順位が入れ替わることがある。品質が1位の方式が、超過を数えに入れると最下位になることもあり得る。
8Kで品質85%、超過なしの方式と、品質90%だが8%の確率で予算を超える方式があるとしよう。前者のほうが望ましいことがある。どちらがよいかは、運用側があふれをどう扱うかで決まる。
大きすぎるリクエストを拒否するサービスなら、超過はそのまま失敗になる。黙って切り捨てる仕組みなら、予測しにくい品質低下になる。曲線全体を見れば、このトレードオフが見えてくる。
顕微鏡で見る記憶方式
この手順では、4系統の記憶方式を比べる。予算が減ったとき、それぞれ違う反応を示すと予想される。次の表に、各設計の予想される振る舞いをまとめた。
| 方式 | 仕組み | 各段階での予想される振る舞い |
|---|---|---|
| 切り捨て/スライディングウィンドウ | 直近のトークンを残し、古いものを捨てる | 予算が大きければ十分だが、小さいと崩れやすい。関連の有無にかかわらず情報を捨てるため |
| ローリング要約 | 履歴を、定期的に更新する要約に圧縮する | 精度と引き換えにコンパクトになる。圧縮が品質を損ない始める予算の境目が、曲線に出るはずだ |
| 保存メモの検索 | メモを外部に保存し、質問ごとに関連するものを取り出す | 質問や指示が枠を使ったあとの残りに、とても敏感 |
| ハイブリッド(作業セット+想起) | 小さな作業セットを保ち、必要に応じてさらに取り出す | 作業セットがよく設計されていれば強い。作業セットと有用な検索結果の両方を入れられない予算では、急に落ちやすい |
こうした予想を確かめるには、特定のモデルとタスクで掃引を実行する必要がある。曲線を見れば、圧力に耐える方式と、壊れる方式が分かる。
コーディングエージェントの永続メモリ
コーディングエージェントは、永続メモリを試す具体的な題材になる。こうした仕組みは、耐久性のある知識を文脈ウィンドウの外に保存し、必要なときに選んで読み込み直す。
価値が決まるのは、読み込み直しがトークンの上限を守るかという1点だ。32Kでうまく読み込める設計でも、読み込みの処理が予算を無視していれば、4Kでは失敗するかもしれない。
BudgetBenchは、永続性についての設計上の主張を、各段階での測れる振る舞いに変える。 同じ設計を2Kと32Kで直接比べられるので、適応するのか壊れるのかが見えてくる。
曲線から見えるはずのこと
主な違いは、曲線が分かれるところに出る。
- 低い段階(2K〜4K):何を残すかを選ぶ方式が先に出る。無差別な方式は遅れる。
- 中間の段階(8K):余裕を品質に変えられる方式と、頭打ちになる方式が分かれる。
- 高い段階(16K〜32K):差は縮まる。そこでは効率、遅延、使い切り具合が決め手になる。
時間をまたぐ学習のベンチマークとの補い合い
予算の段階別評価は、経験を重視するベンチマークが答えを出していない問いに答える。
そうしたベンチマークは、長いタスクの連なりのなかで、エージェントが過去の経験から上達するかを試す。
ただ、たまった経験のうち、1回の呼び出しに再生してよい量までは、たいてい制限しない。ローカルのハードウェアでは、その制限が、学んだ教訓を使えるかどうかを左右する。
2つの手法は、同じトレードオフの反対側を測っている。
| 評価の型 | 中心の問い | 見落としうること |
|---|---|---|
| 経験を重視するベンチマーク | 覚えていることは、エージェントの上達に役立つか | 役立つ記憶が、現実の文脈ウィンドウに収まるか |
| 予算の段階別評価 | 限られたウィンドウに記憶を持ち込むと、何を失うか | 多くのセッションを通じて、記憶が有用な教訓を築くか |
2つを組み合わせれば、エージェントの継続学習らしさが、想起を小さな段階に押し込んでも保たれるかが分かる。経験をためるのがうまい方式が、圧縮を強いられて劣化しないかも見えてくる。
今回の試作は、複数セッションにわたる蓄積には及んでいない。多くのセッションで記憶を築き、増えていく知識の蓄えを管理する場面のことだ。
ここが、両方を合わせた評価の次の一歩になる。2つの問いが交わる地点を試すことになる。記憶は増えるのに、ウィンドウの大きさは変わらないという状況だ。
試作の評価ツールから実用の指針へ
参照実装は、みんなで使える共通の物差しになる。別々のグループが同じ手順を使えば、比べにくい単発の結果ではなく、比較できる性能の曲線を報告できる。
実務の担当者は、手間をかける前に、自分のハードウェアの制約で記憶方式を試せる。
この手順は、ほかのモデル、タスクの種類、もっと細かい予算の刻みにも、自然に広げられる。ローカルでの運用が進むほど、使えるメモリの幅は狭まる。
すると、記憶方式の選択は、予算そのものと切り離せなくなる。評価も、最初からその依存関係を反映させたほうがよい。
この記事のポイント
- どの方式がうまくいくかは予算の段階で決まり、1つのスコアはその依存を隠す。
- 段階をまたぐ曲線が、トレードオフを見せる。ある予算で強い方式が、別の予算では失敗しうる。
- 実用の指針は、一般的なベンチマークではなく、自分のハードウェアの上限から始まる。
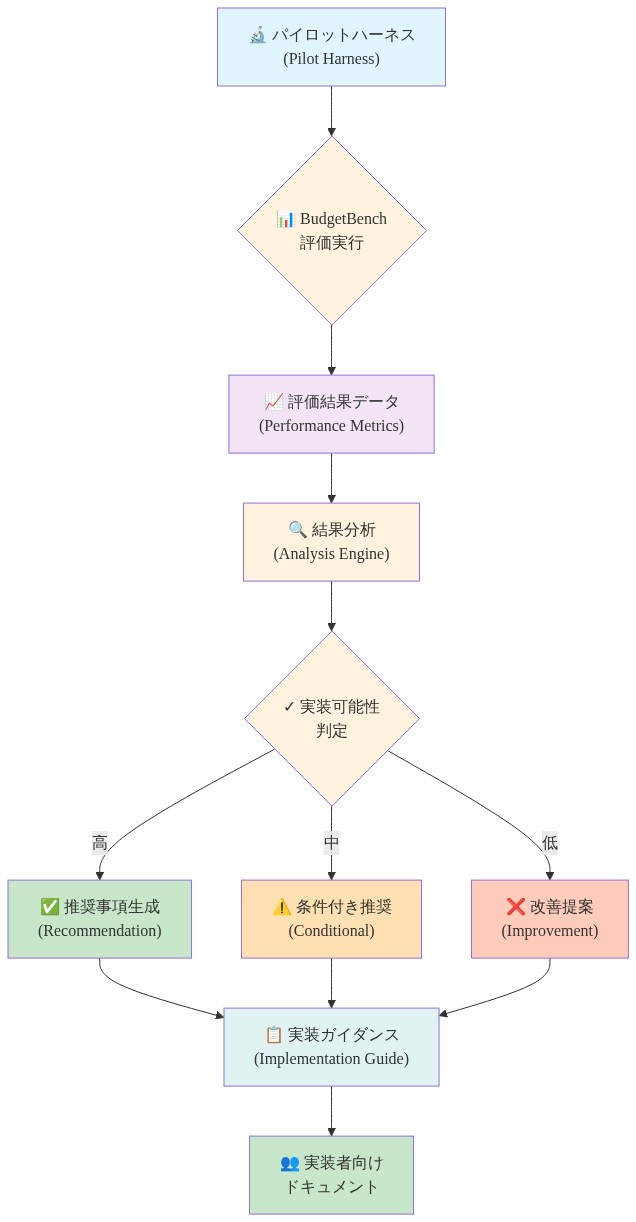
図12:パイロットハーネスから実装ガイダンスへのプロセス
ちょっと立ち止まって
記憶方式は、どれも「エージェントに何を持たせてよいか」を選んでいる。32Kトークンなら、その選択は気前がよく感じられる。2Kになると厳しくなり、方式の優先順位が見えてくる。
スコアが1つだけだと、その優先順位は隠れてしまう。曲線なら、段階ごとに見える。方式を評価するとき、こう自問してみてはどうだろう。
「より良い方式」に見えているものは、どこまでが、ただ予算が大きかったせいなのだろうか。
脚注
-
Recent work on agent data layers reports token reductions of up to 76% from restructuring how agents access information. ↩