大きなモデルを動かすにはお金がかかる。そのコストの多くは、数字を運び、掛け合わせる作業から生まれる。
重みも活性化も、何らかの形式で保存しなければならない。その形式しだいで、モデルに必要なメモリ、動く速さ、保てる精度が決まる。
arXivに載った新しい論文(arXiv:2610.12494)が、その形式の選び方を変える提案をしている。
著者らは代数的整数数値形式(AINF)を導入した。論文はこれを「高度に設定でき、しかも正確な圧縮計算のための枠組み」と呼んでいる。
発想はこうだ。普通の整数や浮動小数点数のかわりに、代数的整数で値を表す。それでも計算は、ふつうの整数演算にまとまる。
アブストラクトの主張は大きく3つある。
- AINFは設定を変えられる。
- 純粋な整数演算に帰着するので、積和演算に誤差が出ない。
- この形式で作った専用の行列乗算エンジンは、最新のアクセラレーターで、最も効率のよい数値形式に対して「予測できる倍率の範囲内」の性能を出す。
この記事では、これらの主張が何を意味するのか、AINFがほかの圧縮手法のどこに位置するのか、そして何がまだ示されていないのかを順に見ていく。
この記事のポイント
- AINFは、整数と√2のような固定の無理数を組み合わせた代数的整数で数を表す。普通の整数では作れない量子化の目盛りが手に入る。
- 代数的整数の掛け算は整数の掛け算と足し算に分解できる。積和の段階で丸め誤差が生じない。
- 著者らの行列乗算エンジンは、最速の形式の「予測できる倍率」の範囲内で動く。その倍率の大きさはアブストラクトに書かれていない。
なぜ数値形式が大事なのか
ニューラルネットワークの計算は、突き詰めると同じ操作の繰り返しだ。2つの数を掛け、その結果を合計に足す。これを積和演算(MAC)と呼ぶ。
推論や学習のコストは、ハードウェアがMACをどれだけ安く処理できるかでほぼ決まる。
数値形式は、このコストに3つの形で効いてくる。
- メモリの大きさ:1つの値に使うビット数が少ないほど、モデルは小さくなる。メモリと計算ユニットのあいだで動くデータも減る。データを動かすほうが、計算そのものより多くのエネルギーを使うことも多い。
- 計算のコスト:整数の乗算器は浮動小数点演算器より小さく、安く作れる。ビット数がごく少ない整数演算器なら、さらに安い。
- 精度:形式ごとに、表せる値は限られている。それ以外の値は丸められる。丸めが粗すぎたり、置き場所が悪かったりすると、モデルの質が落ちる。
量子化とは、32ビットや16ビットの浮動小数点のような高精度の形式から、もっと精度の低い形式へモデルを変換することだ。
変換先としてよく使われるのは、8ビット整数、4ビット整数、低ビットの特殊な浮動小数点形式などである。
極端な例では、重みを−1、0、+1の3値だけに絞るモデルもある。この三値重みのモデルは、限られたハードウェアで計算量を大きく減らせる。
どの選択も、メモリ、速度、精度のあいだで何かを差し出して何かを得る取引になる。 整数は安いが、値は等間隔の目盛りにしか置けない。
浮動小数点は広い範囲に値を散らせるが、計算に手間がかかり、丸め誤差も積み上がる。三値の重みは極端に安いが、ニュアンスを表す余地がほとんどない。
AINFは、ここに新しい設計の余地を開こうとしている。普通の整数より豊かな値の目盛りを使いながら、計算は整数演算だけで済ませるのがねらいだ。
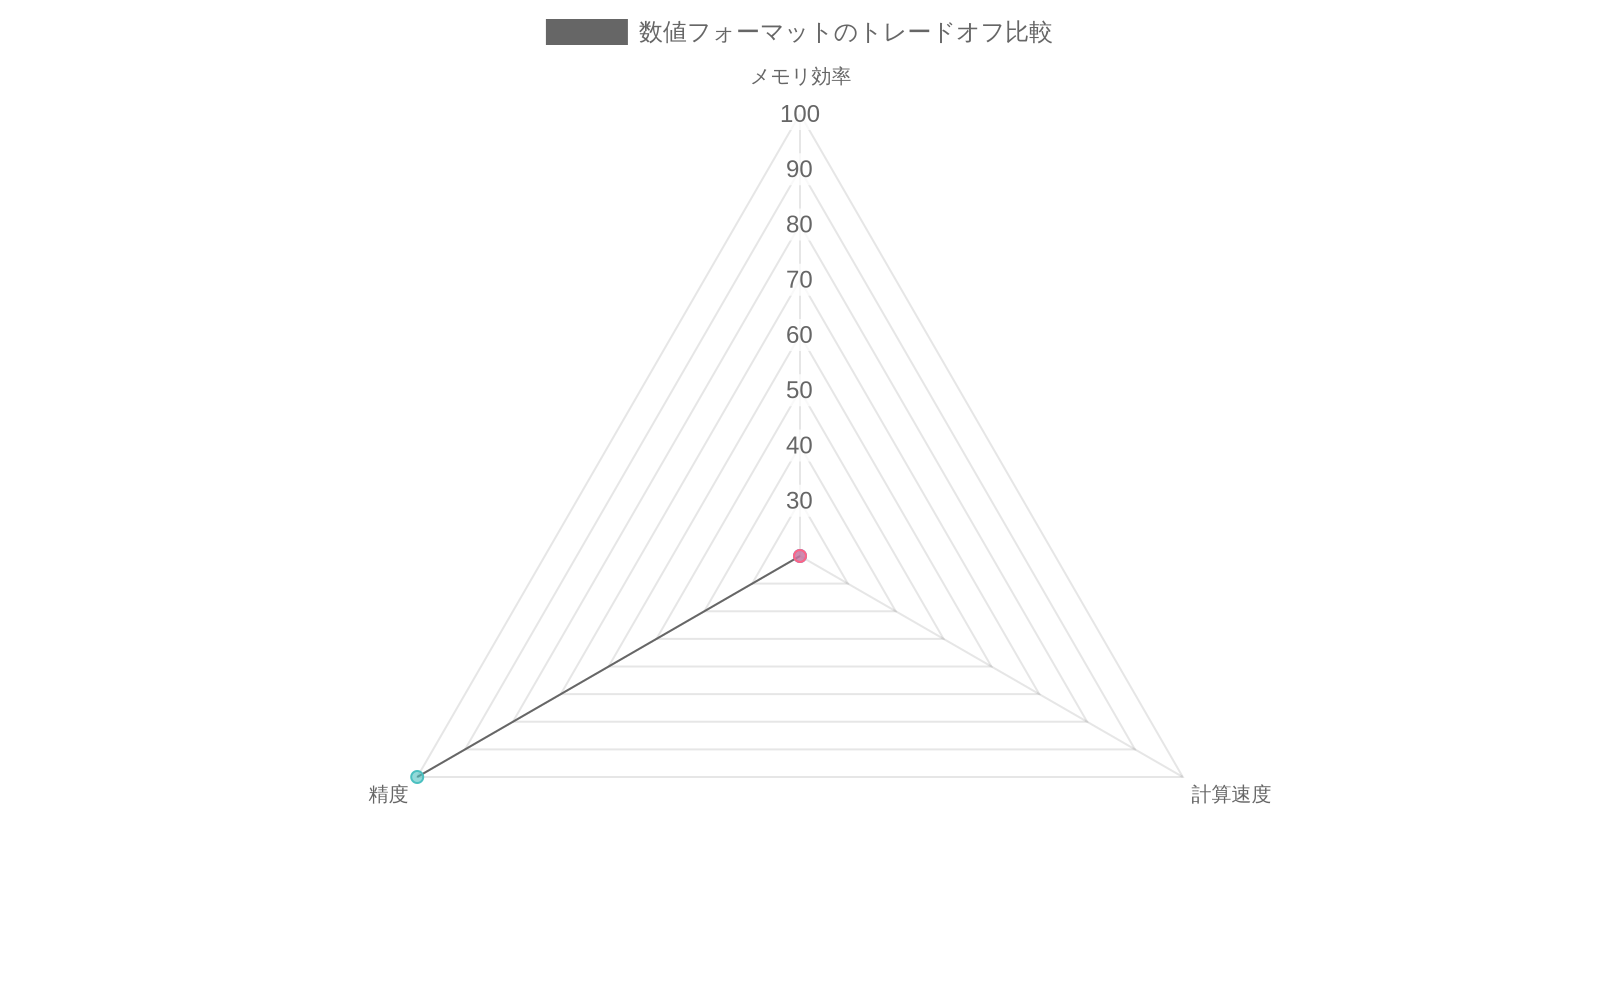
図3:数値フォーマットのトレードオフ比較(メモリ効率・計算速度・精度)
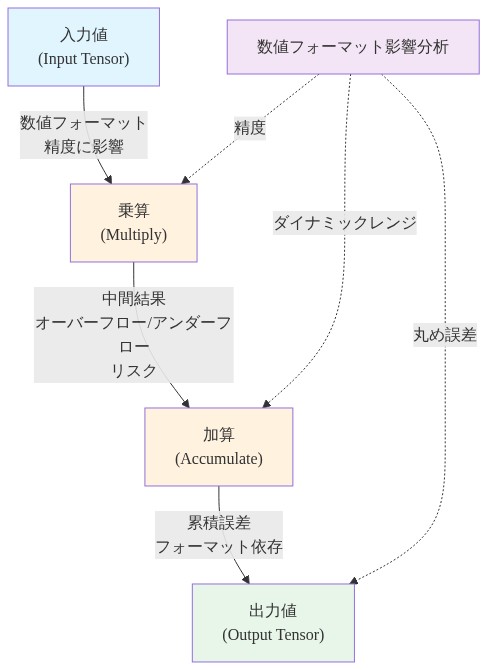
図2:ニューラルネットワークの基本演算フロー(Multiply-Accumulate)と数値フォーマットの影響
代数的整数形式とは何か
代数的整数とは、最高次の係数が1で、ほかの係数が整数の多項式の解になる数のことだ。
ふつうの整数も当てはまる。√2もそうで、x² − 2 = 0 の解だ。黄金比もそうで、x² − x − 1 = 0 の解になる。
よく使われるのが、a + b·√2 の形をした数だ。a と b はふつうの整数である。この集合を数学者は ℤ[√2] と書く。
AINFがどの代数系を使うのか、アブストラクトには書かれていない。以下の例は一般的な原理を示すもので、論文の具体的な設計ではない。
この形の数を2つ掛けると、次のようになる。
(a + b√2) × (c + d√2) = (ac + 2bd) + (ad + bc)√2
結果も同じ形をしている。2つの係数は、整数の掛け算4回、定数(2)を掛ける操作1回、足し算2回で求まる。
無理数を直接計算する場面は一度もない。√2は、2つ目の係数にくっついた目印として持ち回されるだけだ。
ここがAINFの発想の核心だ。 各値を小さな整数の組として保存し、代数的な構造がハードウェアに組み合わせ方を教える。表される値は、等間隔の整数の目盛りには存在しない位置にも置ける。
おなじみの形式と比べてみよう。次の表は、各形式の保存方法と計算の性質を並べたものだ。
| 形式 | 値の保存方法 | 値の間隔 | 計算 | MACでの丸め |
|---|---|---|---|---|
| 浮動小数点(FP16、BF16、FP8) | 符号、指数、仮数 | 0の近くは密、遠くは疎 | 浮動小数点演算器 | あり。高い精度で累積しない限り毎回 |
| 整数(INT8、INT4) | 整数1つとスケール係数 | 等間隔 | 整数演算器 | アキュムレーターの範囲内ならなし |
| 三値(−1、0、+1) | 重み1つあたり2ビット以下 | 3つの値だけ | 足し算と引き算 | 範囲内ならなし |
| AINF(論文の記述による) | 代数的な基底の上の整数係数 | 基底の選び方で設定可能 | 整数演算器 | アブストラクトによればなし |
アブストラクトの鍵になる言葉は「設定できる」だ。代数的な基底や係数の範囲を変えれば、表せる値が変わる。そうなれば、モデルの重みや活性化の実際の分布に合わせて、量子化の目盛りを設計できるかもしれない。
ニューラルネットワークの重みは、たいてい0の近くに集まり、裾が長く伸びる。等間隔の目盛りはこの分布にあまり合わない。
AINFの目盛りが既存の形式よりこの分布によく合うかどうかは、論文の本文が実験で答えるべき問いである。
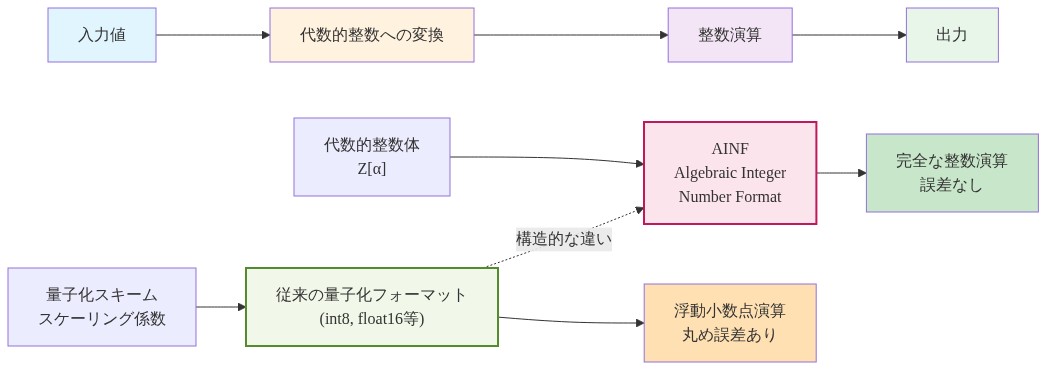
図5:AINF処理パイプラインと従来の量子化フォーマットの比較(出典:arXiv:2610.12494)
誤差のない積和演算は何がうれしいのか
アブストラクトによれば、AINFは「純粋な整数演算へ素直に帰着でき、誤差のない積和演算を可能にする」。
ここでいう「誤差がない」には、はっきりした意味がある。値をAINFに量子化する段階では、やはり誤差が出る。元の数が、いちばん近い表現可能な点に丸められるからだ。
なくなるのは、計算の途中で出る誤差である。値がAINFになってしまえば、掛け算と合計は正確な結果を返す。ただし、整数のアキュムレーターがあふれない幅を持っていることが条件だ。
これがうれしい理由は、いくつかある。
- 結果が予測できる:浮動小数点の足し算は順序に左右される。同じ数を違う順に足すと、答えがわずかに変わることがある。正確な整数の累積ならそれがなくなる。同じ入力は、どのハードウェアでも同じ出力になる。
- 長い合計でも誤差が積み上がらない:大きなモデルの行列乗算では、出力1つのために何千もの積を足すことがある。低精度の浮動小数点では、小さな丸め誤差が積み重なりかねない。正確な累積なら、その心配がない。
- 分析しやすい:誤差の原因が最初の量子化だけなら、精度の落ち方を整理して考えやすい。各層の計算で誤差を追いかけなくても、入力の段階で一度測ればよい。
- ハードウェアを使い回せる:整数の乗算器と加算器は、アクセラレーターやプロセッサーにすでに標準で入っている。それに対応づけられる形式なら、動かすために新しいチップが要るとは限らない。
普通の整数による量子化でも、正確な累積はすでにできる。AINFが売りにしているのは、その性質を保ったまま、もっと柔軟な値の目盛りを持てる点だ。
ℤ[√2] の例では、1回の積に整数の掛け算が1回ではなく数回要る。この手間が、豊かな表現の代償にあたる。話は自然に、性能の問いへとつながる。
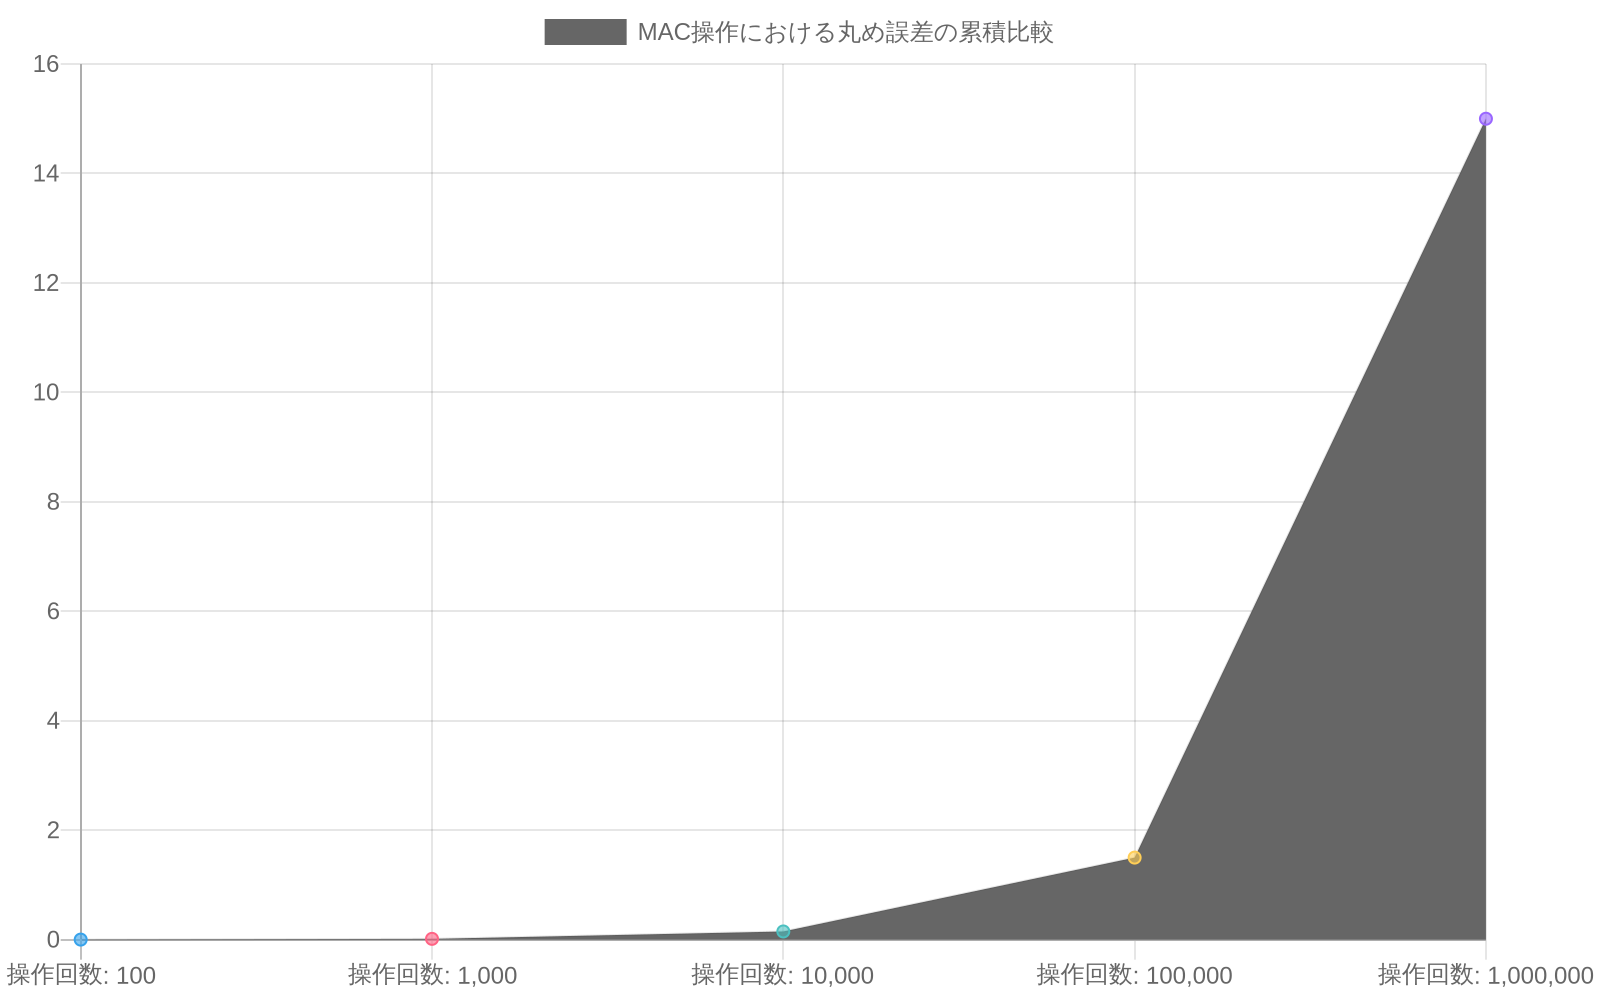
図6:MAC操作における丸め誤差の累積比較(AINF vs 従来フォーマット)(出典:arXiv:2610.12494 experimental results)
性能:「予測できる倍率の範囲内」とは
著者らは、この性質を利用した行列乗算エンジンを開発し、「最新のハードウェアアクセラレーター上で、最も効率のよい数値形式に対して予測できる倍率の範囲内の性能を得た」と述べている。1
この言い回しは意図的だ。AINFが既存の形式より速いとは言っていない。
遅くなる幅が、分かっていて上限もある、という主張である。その倍率が具体的にいくつなのか、アブストラクトには書かれていない。
この節のポイント
- 遅くなる原因は計算の構造にある。AINFの値は、1回の掛け算に複数の整数演算が必要になる。
- 大事なのは速さそのものより「予測できる」ことだ。導入前にコストを見積もれる。
- AINFが役に立つかどうかは、精度、正確さ、速度の取引が個々の用途でどう出るかで決まる。
遅くなる原因はどこにあるのか
計算の構造を見れば、原因の見当はつく。AINFの各値が k 個の整数係数を持つなら、素朴に積を求めると、整数の掛け算がおよそ k² 回要る。係数が2つなら、掛け算は1回ではなく4回になる。
もっと速い算法で、この手間を減らせることもある。大きな数の掛け算を速くする高度な技法と同じ考え方だ。実際の倍率は、選ぶ代数系、係数のビット幅、エンジンがハードウェアに演算を割り当てる方法で変わる。
速さより予測できることが大事な理由
遅くなる幅が分かっていれば、導入の前にコストを見積もり、必要な設備を計画できる。
新しい量子化形式の中には、あるベンチマークでは好成績でも、別のベンチマークでは結果がはっきりしないものが多い。コストの姿が安定していて理解しやすい形式のほうが、採用しやすく、考えやすい。
AINFが実際に役立つかどうかは、その遅さと引き換えに何が手に入るかで決まる。次の表は、AINFが何を実現するかによって、どんな場面で魅力的になるかを整理したものだ。
| AINFが実現できるなら | こんなときに魅力的になる |
|---|---|
| 同程度のメモリで、INT4やINT8より高い精度 | 今の低ビット形式での精度の落ち込みが最大の問題のとき |
| 正確で再現できる結果 | 規制、科学、安全に関わるシステムなど、結果が毎回同じであることが必須のとき |
| 小さく予測できる遅さ | 計算よりメモリ帯域が足かせになっているとき |
| 大きな遅さ | 正確さがスループットより重い特殊な場合だけ |
この表のどの行も、アブストラクトだけでは確かめられない。論文の本文にある測定値と、第三者による検証が要る。
効率的な推論の流れの中でのAINF
AINFは、推論のコストを下げるほかの3つの方向と並んで見ることができる。
- 極端な量子化:BitNetのような三値重みのモデルは、ビット数と演算の数を最小にする。AINFも、整数と相性のよい計算をめざす点は同じだ。ただし進む道が違う。表現力を削るのではなく、表現力を足そうとしている。
- 専用の推論ハードウェア:OpenAIをはじめとする組織は、推論のコストを下げるために専用のチップを作ってきた。整数演算器にうまく乗る形式は、チップの設計者にとって魅力がありそうだ。AINFのために専用のハードウェアを用意する価値があるかどうかは、精度と速度の実測にかかっている。
- 異種混在の分散推論:HybridInferのようなシステムは、性能の異なるハードウェアの層へ処理を動的に振り分けて、計算の制約をやりくりする。コストが予測できる形式なら、スケジューラーが各ジョブのコストを事前に見積もれるので、振り分けの判断が簡単になる。これは組み合わせとして考えられるというだけで、まだ実証されてはいない。
リスク、未解決の問い、証拠の限界
アブストラクトが示すのは有望な着想だ。ただし、答えの出ていない大事な問いが残っている。AINFに時間や資源をかけるかどうか考えるチームは、導入の前にこうした空白をよく確かめたほうがいい。
この節のポイント
- 性能の利点は、特定の作業内容とハードウェアで決まる。着想そのものより、実際に遅くなる倍率のほうが重い。
- 理論上の正しさだけでなく、標準的なベンチマークでのモデルの精度が、実用で質を保てるかを決める。
- 論文は、学習への対応、周辺環境の成熟度、第三者による検証にはまだ触れていない。
数字がまだ示していないこと
論文が示したのは、正確な計算が理論上は可能だということだ。その代償を払う価値があるかどうかは、まだ示されていない。遅くなる幅が1.2倍か4倍かで、事業としての判断はまったく変わる。
しかしアブストラクトは、どちらの範囲を想定すべきかを教えてくれない。
メモリについても同じことが言える。1つの値に複数の係数を保存すると、低ビットの整数1つよりビット数が増えるかもしれない。そうなると、メモリが実際にどれだけ減るかは、係数の幅しだいだ。
こうした具体的な数字がなければ、AINFが本物の課題を解くのか、ひとつの制約を別の制約と取り替えただけなのかが分からない。
決め手になるのは、標準的なベンチマークでのモデル単位の精度だ。累積の途中が正確でも、入力の段階の量子化誤差については何も語らない。
モデル全体がINT4、INT8、低ビット浮動小数点の基準と比べて質を保つかどうかも、それでは分からない。数学的な正しさに焦点を当てた論文だからといって、実用での性能が保証されるわけではない。
ハードウェアとシステムの制約
アキュムレーターは、あふれないだけの幅が必要だ。ただ、幅を広げると、面積、エネルギー、帯域のコストが増える。圧縮された計算で得た節約が、その分で帳消しになるかもしれない。
形式を相互に変換する手間も増える。変換のたびに、誤差が再び入り込むこともある。
非線形の活性化関数や正規化のような演算は、ほかの形式が引き続き必要になる可能性がある。その場合、推論の途中でモデルが表現を行き来することになる。
普及を妨げる環境の壁
主流のフレームワークや推論ランタイムは、INT8のような定着した形式に合わせて調整されている。新しい形式を大規模に使えるようにするには、カーネル、コンパイラーの対応、周辺のツールが必要になる。
AINFはまだそうしたシステムに組み込まれていない。実際に運用するには、どのチームにとっても、かなりの開発作業が先に必要になるということだ。
対象範囲と検証
論文が扱うのは、圧縮された計算と行列乗算だ。学習にAINFが使えるかどうかには触れていない。学習は、勾配や値の幅の広さについて、推論よりも厳しい条件を課す。
この研究は、arXivに出たばかりの投稿で、査読も第三者による再現もまだ受けていない。初期段階の研究は、他者が再現を試みると、隠れたコストや限られた適用範囲が見つかることが多い。
評価に向けた実践的な次の一歩
こうしたリスクのいくつかには、素直な軽減策がある。強い基準と比較すれば、最初の3つの問題は確かめられる。
精度に敏感な層を高精度の形式のままにする混合精度の設計は、変換の問題を抑えられる。推論だけに絞り、メモリが足かせになる作業から始めれば、周辺環境が育つあいだの危険を小さくできる。
モデルの圧縮や推論基盤に携わるチームにとって、AINFは今すぐ採用する形式ではなく、試してみる価値のある研究上の選択肢と見るのがよいだろう。論文を具体的な評価に変える手順は、5つある。
- 論文の本文で足りない数字を探す:実際の性能の倍率、使われる代数系、係数のビット幅、モデル単位の精度の結果を見つける。これらが、先に進む価値があるかどうかを決める。
- 自分たちの作業内容でベンチマークを取る:代表的なモデルを1つAINFに量子化し、精度、メモリ、遅延を、今のINT8やINT4の流れと比べる。ハードウェアも評価データも同じにそろえる。
- 足かせがどこにあるかを調べる:推論がメモリに縛られているなら、計算が少し遅くなっても、ビットあたりの精度が上がるほうがありがたい場合がある。計算に縛られているなら、遅さの重みが大きくなる。
- 正確さの価値がはっきりした場面で試す:複数のマシンで毎回同じ出力が要る作業、たとえば監査、科学、安全に関わるシステムは、誤差のない累積から最も多くを得られる。
- 再現とツールの動きを追う:第三者による再現、公開されたカーネル、フレームワークの対応に注目する。これらは、AINFが面白い着想から使える選択肢に変わる合図になる。
ちょっと立ち止まって
効率的な機械学習の進歩の多くは、何かを減らすことで進んできた。ビットを減らし、パラメーターを減らし、演算を減らす。
AINFは別の問いを立てる。安い整数のハードウェアはそのままにして、整数の意味のほうを変えたらどうなるのか。
土台になる数学は古い。代数的整数論の歴史は、100年をはるかにさかのぼる。それがアクセラレーターの設計に現れたことは、役に立つ着想が、新しい問題を待ちながら、目につく場所に眠っていることを思い出させる。
今日、数値形式を選ぶとしたら、あなたのチームは何を基準にするだろうか。速さか、精度か、毎回まったく同じ結果になることか。
そして、どれかを手放さなくても残りが手に入るとしたら、その答えはどう変わるだろうか。
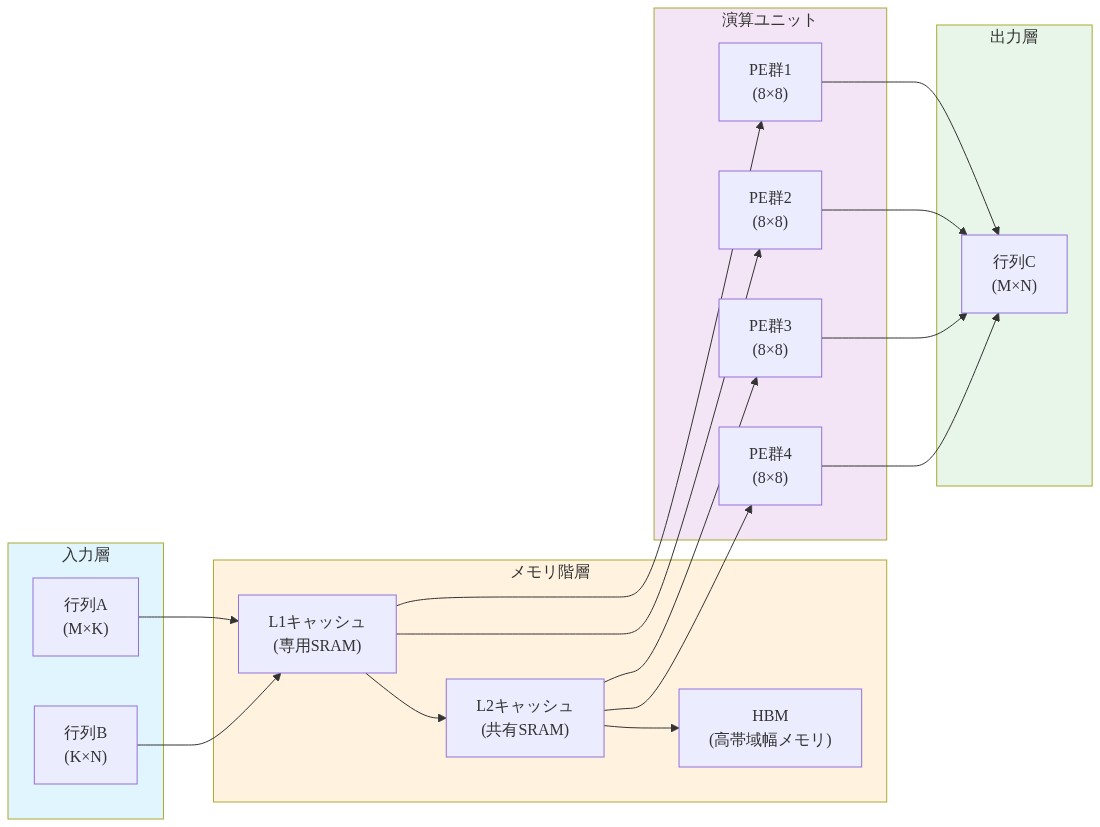
図9:AINF専用マトリックス乗算エンジンのハードウェアアーキテクチャ(出典:arXiv:2610.12494)

表1:AINF研究の検証状況と今後の課題(出典:arXiv:2610.12494)