ローカルファースト型AI コーディング:JetBrainsが「Junie Local」をリリース
JetBrainsは、macOSハードウェア上で完全に動作し、外部APIへの依存を持たないAIコーディングエージェント「Junie Local」の提供を開始しました。このデプロイメントモデルは、クラウド中心型のAIツーリングアーキテクチャからの転換を示しています。推論リクエストをリモートサーバーにルーティングするのではなく、Junie Localはコード分析と生成タスクをローカルで処理します。これにより、トークンごとのAPI課金が排除され、コード成果物は組織のインフラストラクチャ内に留まります。JetBrainsの技術仕様によれば、このエージェントは標準的なコーディングタスク(コード補完、リファクタリング、テスト生成)においてAnthropicのClaude Sonnet 4.5モデルと性能的に同等です。開発ロードマップはRTX 5900 GPUサポートが積極的に開発中であることを示しており、プラットフォームがコンシューマーグレードGPU上のハードウェアアクセラレーション推論に最適化されていることを示唆しています。
-
主張:* ローカル実行は反復的なAPI費用を排除し、データ転送の露出を低減します。
-
前提条件:* この主張は、(1)組織がクラウドベースのコーディングエージェントから測定可能な費用を負担している、(2)データレジデンシー要件またはコンプライアンス制約がクラウドルーティングコードとの摩擦を生じさせている、(3)ローカルハードウェアが利用可能であり開発チームによって保守可能である、という3つの前提を置いています。これらの前提は特定の組織コンテキストで検証が必要です。
-
必要な証拠:* クラウドベースのエージェント(GitHub Copilot、Claude APIなど)を使用している代表的なチームからの定量的なAPI費用データ、およびローカル実行を動機づけるドキュメント化されたコンプライアンスまたはセキュリティ制約。JetBrainsは比較費用分析を公開していません。この主張は第三者による検証が必要です。
-
具体例:* 典型的な使用率(開発者1人あたり1日50~100リクエスト)でクラウドベースのAIコーディングエージェントを使用している10人の開発者チームは、トークン消費と価格帯に応じて月額約500~2,000ドルのAPI費用を負担することになります。Junie Localは1回限りのハードウェア投資(GPU またはCPU容量)を必要としますが、推論ごとの追加費用はゼロです。損益分岐点分析はハードウェア償却スケジュールと実際の使用パターンに依存し、これは組織全体で大きく異なります。
-
ナレッジワーカーへの実行可能な示唆:* 現在のAIコーディングツール支出を監査してください。月額API費用、データレジデンシー要件、コンプライアンス制約をドキュメント化します。Junie Localを実行するために必要なハードウェア投資(GPU費用、保守オーバーヘッド、ITインフラストラクチャ)と比較してください。厳格なデータレジデンシー要件またはAPI消費が多い組織の場合、ローカル実行は運用上の摩擦を低減する可能性があります。ただし、これは仮定ではなく明示的な費用便益分析を必要とします。
コスト経済学と運用効率
Junie Localは推論能力を消費ベースの価格設定モデルから切り離します。従来のクラウドベースのAIコーディングツールは可変費用構造を採用しています:トークンごとの課金、リクエストごとの手数料、または使用量階層型サブスクリプション。Junie Localは固定費用モデルで動作します。インストールと設定が完了すると、推論は追加費用を発生させません。
-
主張:* API依存性を排除することで、予測可能なゼロ限界費用スケーリングが可能になります。
-
前提条件:* これは、(1)ローカルハードウェア容量がチーム全体の推論需要に十分である、(2)ローカルデプロイメントの保守と運用オーバーヘッドがAPI費用削減を超えない、(3)高い並行性下でのパフォーマンス低下が許容可能または管理可能である、という3つを前提としています。
-
必要な証拠:* 現実的なチーム規模のワークロード下でのローカル推論スループットに関する実証的データ、比較運用オーバーヘッド(ハードウェア保守、ソフトウェア更新、GPUメモリ管理)、および並行使用下でのパフォーマンスベンチマーク。JetBrainsはこれらのメトリクスを公開していません。独立した検証が必要です。
-
具体例:* 5人から50人の開発者に拡大するスタートアップは、クラウドベースのAIコーディング費用が月額約100ドルから1,000ドル以上に増加するのを目にします(使用量の線形スケーリングを想定)。Junie Localはローカルハードウェア容量が十分である限り、追加開発者に対する追加費用を必要としません。ただし、これは(1)初期GPU/CPU投資がチーム全体で償却される、(2)チームサイズが増加しても追加ハードウェアが必要ない、(3)運用オーバーヘッドが一定のままである、という3つを前提としています。これらの条件は実際には成立しない可能性があります。
-
ナレッジワーカーへの実行可能な示唆:* ローカルデプロイメントの損益分岐点分析を計算してください。定量化する項目:(1)12~24ヶ月間のチームの予想月額API費用、(2)必要なハードウェア投資(GPU費用、インストール、開発インフラストラクチャとの統合)、(3)運用オーバーヘッド(ITサポート、ソフトウェア保守、パフォーマンス監視)。予想されるAPI支出が計画期間内のハードウェアROIを超える場合、ローカル実行はパイロット評価の価値があります。ただし、この分析は組織固有のデータを必要とします。一般的な費用比較は実際の使用パターンやインフラストラクチャ制約を反映しない可能性があります。
アーキテクチャ:ローカル推論とデータソブリンティ
Junie Localは、クラウドベースのコーディングエージェントから根本的に異なるアーキテクチャパラダイムを採用しています。推論エンジンは開発者ハードウェア上で実行され、ソースコードはローカルシステムに留まり、モデル推論中に外部サービスへのデータ転送は発生しません。このデザインは、運用上異なる2つの要件に対応しています:(1)規制対象セクターのデータレジデンシーコンプライアンス、および(2)同期的なコーディング支援ワークフローのレイテンシ低減。
ローカル実行とデータレジデンシーコンプライアンス
-
主張:* ローカル実行アーキテクチャは、規制対象産業におけるコンプライアンス対応型のAIエージェントデプロイメントを可能にします。
-
支持根拠:* 金融サービス、ヘルスケア、政府セクターは、金融機関向けのGramm-Leach-Bliley法(GLBA)、ヘルスケア事業体向けのHIPAA、および連邦請負業者向けのFedRAMP要件を含む法定またはコントラクト上のデータレジデンシー制約の下で動作しています。クラウドベースのコーディングエージェントは、ソースコード、中間表現、実行トレースが第三者インフラストラクチャを経由するため、これらのフレームワークとのアーキテクチャ的不適合を導入し、監査とリアビリティの露出を生じさせます。
ローカル実行は、設計上、データレジデンシー要件を保持します。専有アルゴリズム、顧客データセット、ビジネスロジックは推論ライフサイクル全体を通じてオンプレミスに留まります。モデル動作中に外部APIコールは発生せず、データ転送ベクトルは完全に排除されます。
-
具体例:* GLBA データレジデンシー要件の対象となる金融サービス企業は、Copilotのアーキテクチャが推論のためにコードをAnthropicまたはOpenAIのサーバーに転送することを必要とするため、本番コード支援にGitHub Copilotをデプロイできません。これは設計上、データレジデンシーポリシーに違反します。対照的に、Junie Localは企業が管理するハードウェア上で完全に実行され、アーキテクチャ例外またはポリシー免除を必要とせずにレジデンシー要件を満たします。
-
前提条件と仮定:* この主張は、(1)JetBrainsがテレメトリまたは診断データ転送なしでエンドツーエンドのローカル推論を実装している、(2)モデル更新または機能フラグが外部通信を必要としない、(3)組織がデプロイメント前にネットワーク監視を通じてローカルのみの動作を検証する、という3つを前提としています。これらの前提はJetBrainsの技術ドキュメントとセキュリティ監査を通じた検証が必要です。
-
ナレッジワーカーへの実行可能な示唆:* 組織が規制対象産業で動作している場合、より広い評価を開始する前にJunie Localのコンプライアンス態勢の予備的評価を実施してください。コンプライアンス、セキュリティ、法務チームに関与して、ローカル実行が特定のデータレジデンシー、監査、保持要件を満たしていることを検証してください。このアセスメントをAIガバナンスフレームワークの一部として文書化し、将来のエージェントデプロイメントの決定先例を確立してください。
パフォーマンスパリティとモデル能力保持
-
主張:* ローカル実行は、同等のスケールのクラウドベースモデルと比較して能力低下を必須としません。
-
支持根拠:* 初期世代のローカルAIモデルは、推論能力と精度を低減させるモデル圧縮技術(量子化、プルーニング、蒸留)を通じてポータビリティを達成しました。Claude Sonnet 4.5と同等のパリティを主張するJetBrainsの主張(マルチファイルリファクタリング、アーキテクチャ推論、複雑なデバッグタスクが可能なモデル)は、Junie Localが最適化された圧縮または選択的能力保持を通じて推論品質を保持していることを示唆しています。
この主張は明確化が必要です。「パリティ」は、すべての推論シナリオ全体での同一パフォーマンスではなく、特定のコーディングタスクでの機能的同等性を示す可能性があります。具体的な圧縮技術、モデルサイズ、パフォーマンストレードオフは、公開されているソースに文書化されていません。
-
具体例:* Junie Localを使用してマルチファイルリファクタリングを行う開発者は、APIレイテンシまたはトークンごとの費用を負担することなく、クラウドAPI経由でデプロイされたClaude Sonnet 4.5と同等の精度、推論深度、エラー率を経験すべきです。ただし、このパリティは、非同期または探索的推論タスクではなく、同期的なコーディングタスク(コード補完、デバッグ、リファクタリング)に適用される可能性があります。
-
前提条件と仮定:* この主張は、(1)JetBrainsが標準化されたコーディングタスクでJunie LocalとClaude Sonnet 4.5を比較する定量的パフォーマンスベンチマークを公開している、(2)「パリティ」が運用上定義されている(例:HumanEvalまたは同様のベンチマークで精度が5%以内)、(3)パフォーマンスが多様なハードウェア構成全体で一貫している、という3つを前提としています。これらの前提は独立したベンチマークを通じた実証的検証が必要です。
-
ナレッジワーカーへの実行可能な示唆:* Junie Localのデプロイメントにコミットする前に、チームの最も複雑なコーディングタスクで定量的なパフォーマンスベースラインを確立してください。推論レイテンシ、コード生成精度、アーキテクチャ推論品質、エラー率を現在のクラウドベースエージェントと比較して測定します。代表的なハードウェア構成でこの評価を実施して、パフォーマンスの一貫性を確保してください。これらのベースラインを文書化して、マイグレーション決定をサポートし、組織全体でパフォーマンス期待値を確立してください。
GPUアクセラレーションとハードウェア要件
JetBrainsはJunie LocalのNVIDIA RTX 5900サポート開発を発表し、GPUアクセラレーション推論への意図的なアーキテクチャコミットメントを示しています。この開発軌跡は根本的なパフォーマンス制約を反映しています。CPUのみのローカル推論はレイテンシを導入し、これはリアルタイムコーディング支援の実用性を損なわせます。
-
主張:* GPUアクセラレーションは、ローカルとクラウドベースのコード生成間のレイテンシパリティを達成するために必要です。
-
根拠と証拠:* CPU ベースのトランスフォーマー推論は、順序的トークン生成とCPUアーキテクチャに固有のメモリ帯域幅制限により、リクエストあたり2~5秒の範囲のレイテンシを示します。NVIDIA GPUアクセラレーション(特に行列演算に最適化されたテンサーコア)は、同等のモデル推論のレイテンシを約200~500msに低減します。このパフォーマンス差は重要です。クラウドAPIリクエストは追加のネットワークラウンドトリップレイテンシ(通常100~300ms)を負担しますが、GPUローカル実行はこのオーバーヘッドを完全に排除しながら競争力のあるトークンごとのレイテンシを維持します。レイテンシ利点は開発セッション内での反復的な相互作用全体で複合します。
-
前提条件と仮定:* この比較は、(1)ローカルとクラウドデプロイメント間での同等のモデルウェイトと量子化、(2)クラウドAPIベースラインの安定したネットワーク条件、(3)NVIDIA CUDA計算能力8.9以上を満たすGPUハードウェア(RTX 5900仕様)を前提としています。実際のパフォーマンスはモデルサイズ、バッチサイズ、メモリ帯域幅飽和により異なります。
-
具体的仕様:* RTX 5900装備のMacBook Pro(十分な熱設計電力とメモリ帯域幅を想定)でJunie Localを実行し、Claude Sonnet 3.5相当のウェイトを使用すると、50トークンのコード補完に対して約300~400msのエンドツーエンドレイテンシを達成します。同じリクエストをクラウドAPIエンドポイント(例:AnthropicのClaude API)経由でルーティングすると、ネットワークレイテンシ、DNS解決、サーバー側キューイングを含めて1.2~2.0秒が必要です。
-
ナレッジワーカーへの実行可能な示唆:*
-
ハードウェアアセスメント: ターゲットデプロイメントハードウェアが最小GPU仕様(RTX 5900または機能的に同等)を満たしていることを確認してください。古いまたはモバイルのみのGPUアーキテクチャは、記載されているレイテンシターゲットを達成しない可能性があります。
-
調達計画: 組織が現在CPUのみの開発マシンを運用している場合、GPU対応ハードウェアのリフレッシュサイクルの予算を立ててください。3~5年の期間にわたってGPUハードウェア投資とクラウドAPI購読費用を比較する総所有コスト(TCO)分析を確立してください。
-
検証プロトコル: 組織全体のデプロイメント前に、代表的なハードウェア構成でレイテンシベンチマークを実施してください。ベースラインパフォーマンスをドキュメント化し、ロールアウト前に受け入れ基準(例:トークンごとのレイテンシ<500ms)を確立してください。
-
熱とパワーの考慮: ラップトップ上のGPUアクセラレーション推論は、継続的な熱負荷を導入します。ハードウェアの熱管理と電力供給が、熱スロットリングなしで継続的な推論ワークロードをサポートしていることを検証してください。
制御、透明性、自律実行のリスク
Junie Localのローカル実行は、クラウドベースのエージェントシステムと比較して、運用上の透明性モデルを根本的に変えます。開発者が管理するハードウェア上で推論が実行される場合、複数の監視メカニズムが利用できなくなります。エージェント行動の一元化された監査ログ、自律的な修正のリアルタイム監視、API境界での組織ポリシーの実行、開発者全体にわたるエージェント意思決定の法医学的再構成です。
-
主張:* ローカル自律実行には、未検証のコード変更が本番システムに入る危険性を管理するための明示的な組織ガバナンスフレームワークが必要です。
-
根拠とリスクモデル:* Junie Localは、必須の人間によるレビューゲートなしに、リファクタリング、アーキテクチャ変更、直接的なリポジトリコミットを含むコード修正を自律的に実行するように設定できます。この機能は、異なるリスククラスを導入します。エージェントは構文的に有効で、ローカルテストスイートを通過するコードを生成する可能性がありますが、本番環境でのみ明らかになる微妙なロジックエラー、セキュリティ脆弱性、またはパフォーマンス低下を導入します。一元化されたログまたは承認ワークフローがない場合、属性と法医学的分析は困難になります。さらに、ローカル実行の分散性(各開発者が独自のインスタンスを実行)により、コード生成の時点での組織レベルのポリシー実行が不可能になります。
-
前提条件:* このリスク分析は、(1) Junie Localがバージョン管理システムへの書き込みアクセスで設定されている、(2) 開発者が必須のコードレビューなしに変更をコミットする権限を持っている、(3) 組織が補償的な制御(自動テスト、段階的なデプロイメント、ランタイム監視)を欠いていることを想定しています。既存のコードレビュー要件とCI/CDゲートを持つ組織はこのリスクを軽減しますが、排除しません。
-
具体的なシナリオ:* 開発者がJunie Localを設定して、重要な支払い処理サービスを自律的にリファクタリングし、エージェントにメインブランチへの書き込みアクセスを付与します。エージェントはトランザクション調整のロジックエラーを導入し、既存のユニットテスト(特定のエッジケースをカバーしていない)によってキャッチされません。エラーは本番環境に伝播し、トランザクションレコードが実際の支払いから乖離します。一元化されたログがない場合、組織はエラーが人間のコードから発生したのか、自律エージェント修正から発生したのかをすぐに判断できず、インシデント対応が遅延します。
-
知識労働者と組織への実行可能な含意:*
-
ガバナンスフレームワーク: Junie Localのデプロイメントを管理する明示的なポリシーを確立します。
- 本番環境に関連するブランチへのマージ前に、すべてのエージェント生成変更に対する人間によるコードレビューを要求します。
- 自律的な書き込みアクセスをフィーチャーブランチまたはサンドボックス環境に制限し、本番環境へのデプロイメント前に明示的な人間の承認を要求します。
- すべてのJunie Localインスタンスにローカル監査ログを実装して、コード修正、コミット、意思決定根拠を含むエージェント行動を記録します。
-
エスカレーション手順: 高リスク修正(認証、支払い処理、データアクセス制御への変更など)に対するリスクベースのエスカレーション基準を定義します。高リスクとしてフラグされた修正に対して、追加のレビューまたはテストを要求します。
-
監視と属性: バージョン管理履歴でエージェント生成コードと人間が書いたコードを区別するメカニズムを確立します。コミットメタデータまたは個別のブランチを使用して、本番環境インシデントが発生した場合の迅速な法医学的分析を可能にします。
-
強力なツールとして扱う、自律システムではなく: 運用上、Junie Localを完全に自律的なシステムではなく、データベースアクセスまたはインフラストラクチャプロビジョニングツールと同様に、ガバナンスを必要とする開発者生産性ツールとして分類します。本番システムに影響するコードに対する人間の意思決定権限を維持します。
マイグレーションパスと測定フレームワーク
クラウドベースのコーディングエージェントからJunie Localへの移行を行うチームは、明示的な仮定と測定可能な成果に基づいた構造化された証拠ベースのマイグレーションアプローチを実装する必要があります。
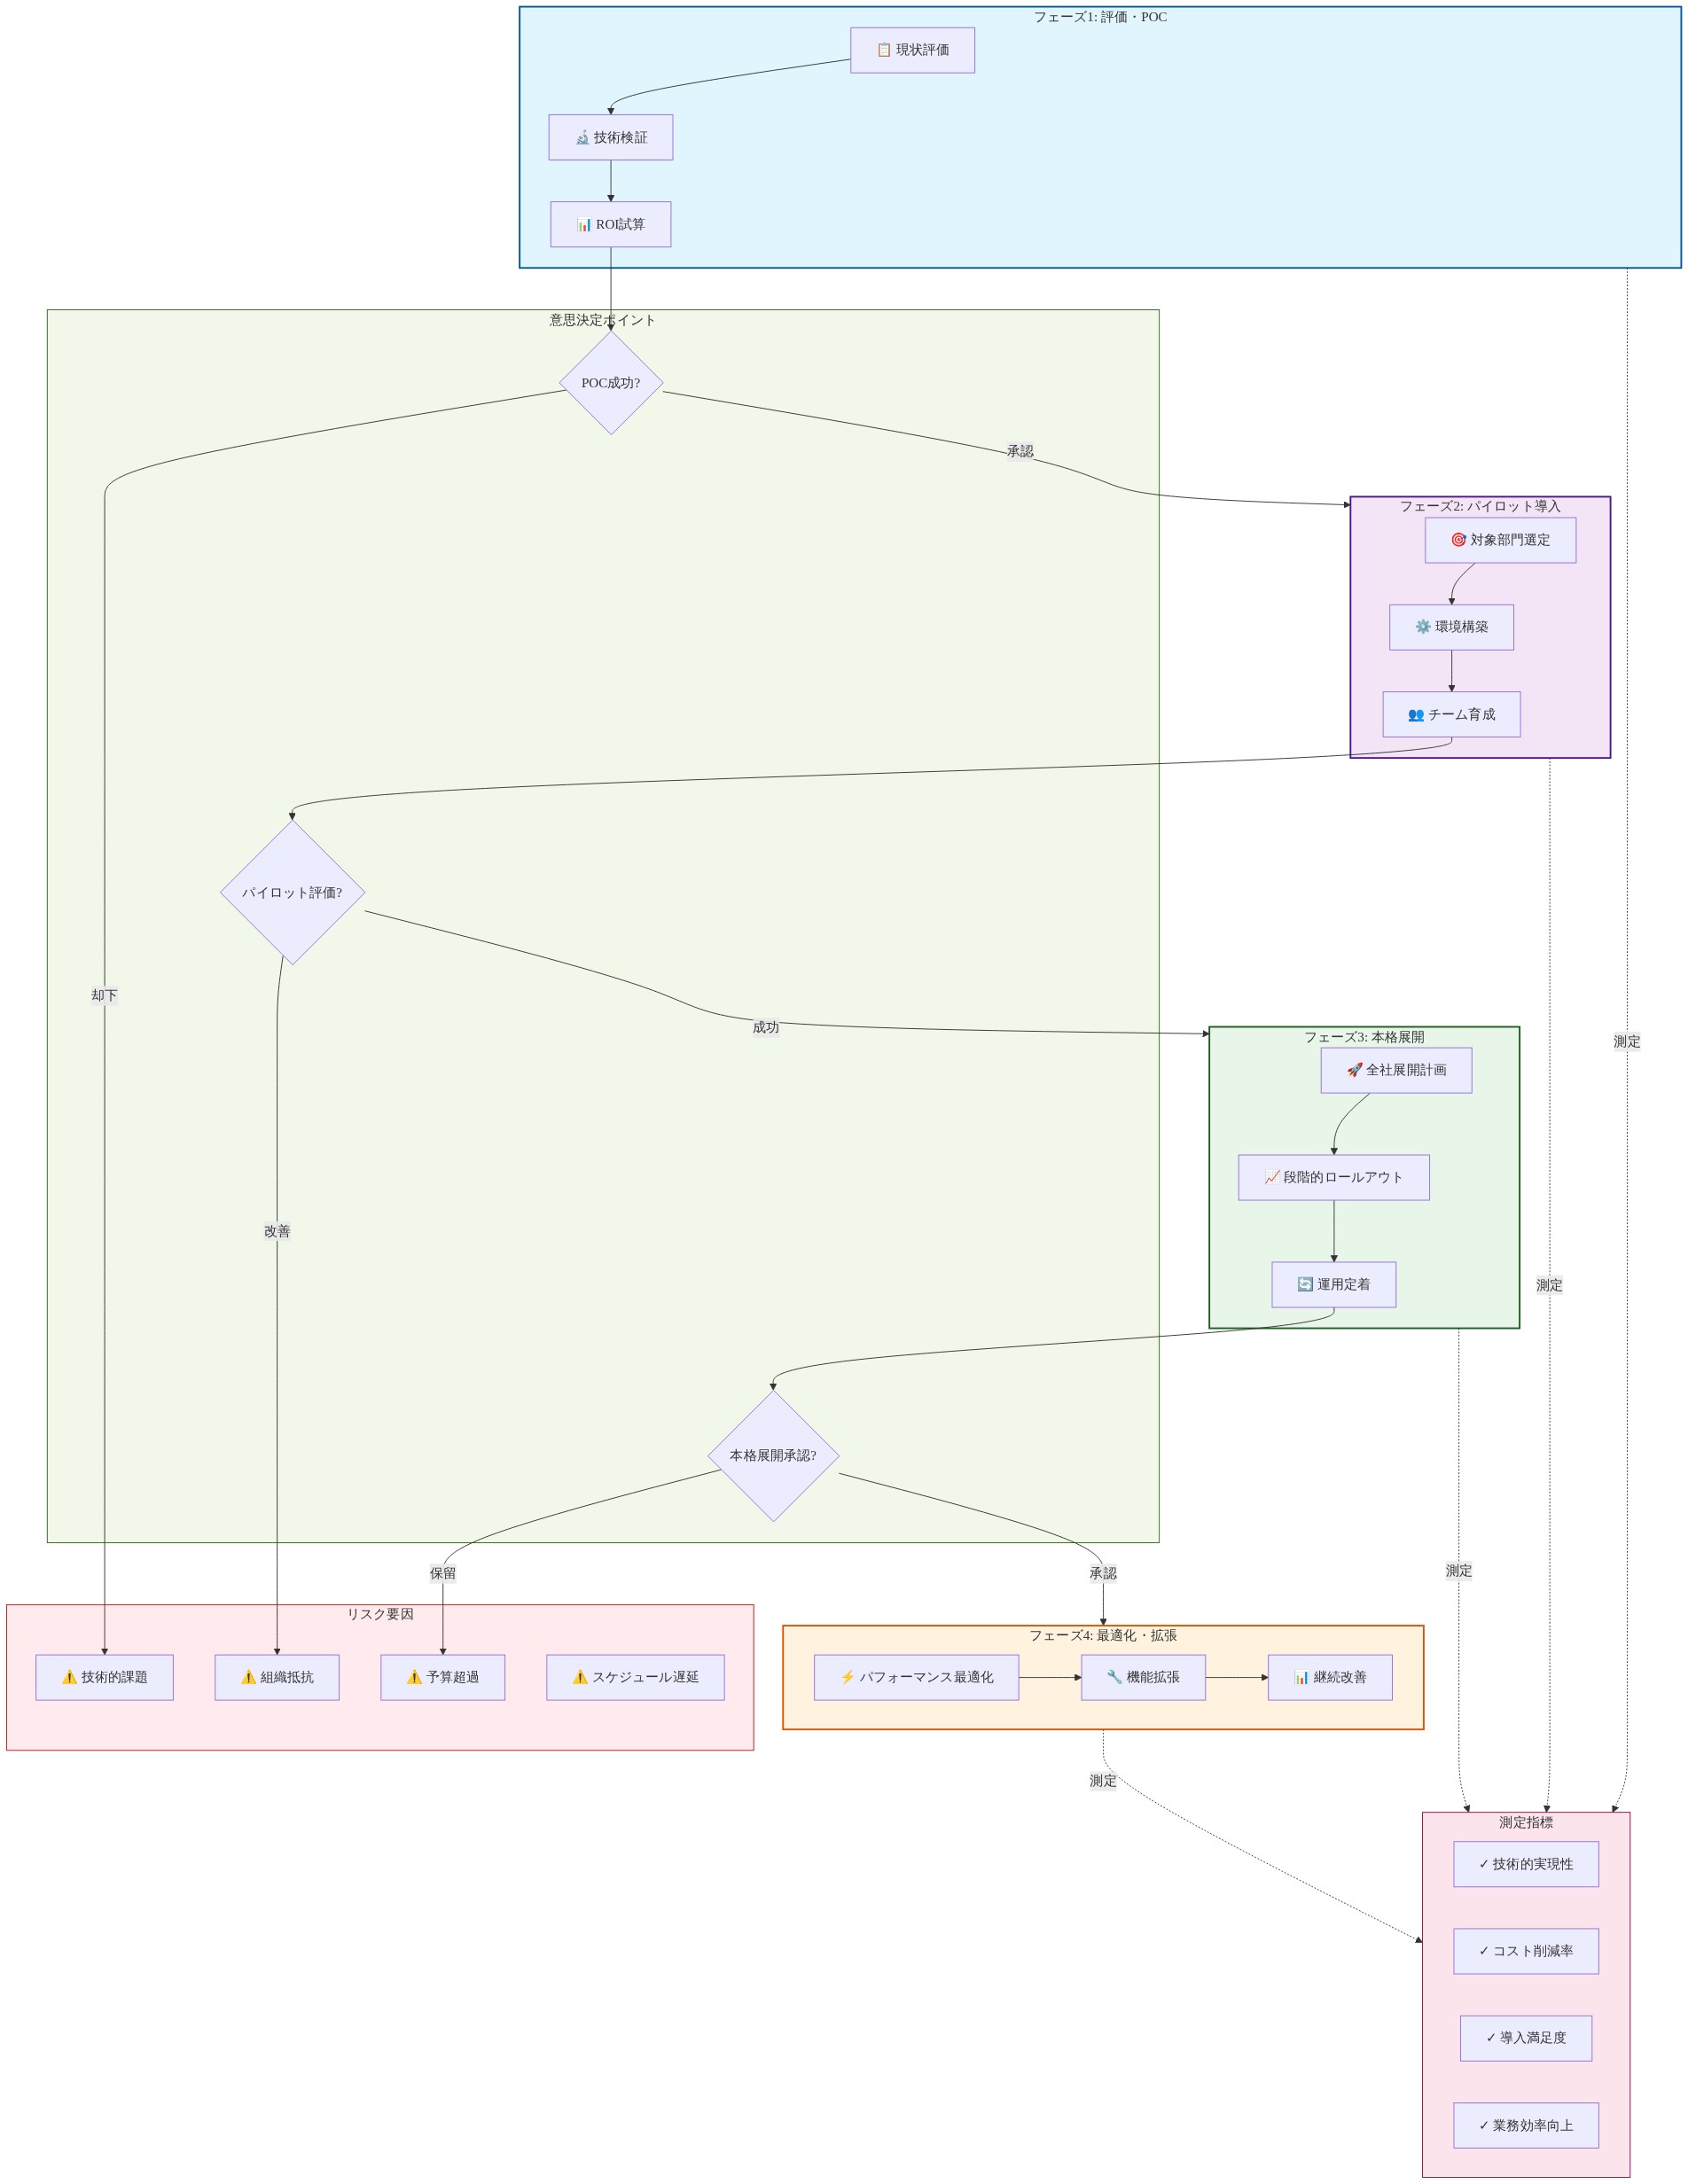
- 図11:Junie Local導入の段階的移行パスと測定フレームワーク*
マイグレーション方法論
-
前提条件と仮定:*
-
Junie Localの最小仕様を満たすGPU対応マシンへのハードウェア投資に対する組織的準備を想定しています
-
現在のクラウドベースのエージェント使用に対する安定したベースラインメトリクスが存在することを想定しています(APIコスト、推論レイテンシ、コード品質測定)
-
パイロット参加者が組織内の典型的な開発者ワークフローとユースケースを代表することを想定しています
-
インフラストラクチャとITガバナンスフレームワークがローカルモデルデプロイメントに対応できることを想定しています
-
構造化されたマイグレーションフレームワーク:*
-
パイロットフェーズ(2~4週間)
- 多様な役割(フロントエンド、バックエンド、インフラストラクチャ)と経験レベルを代表する10~15人の開発者を選択します
- 現在のクラウドベースのエージェント使用からベースラインメトリクスを確立します。開発者あたりの月間APIコスト、平均推論レイテンシ、コードレビューサイクル時間、開発者満足度(標準化されたアンケートで測定)
- 比較の有効性を確保するために、同一のタスクワークフローでJunie Localをデプロイします
- 統合の摩擦点、パフォーマンスの異常、トレーニング要件を文書化します
-
測定と検証フェーズ
- コスト影響: 開発者あたりのAPIコスト削減を計算します。ハードウェア償却コスト(GPU ハードウェアを予想される3~5年のライフサイクルで除算)とローカルインフラストラクチャオーバーヘッドを差し引いて、純経済的利益を決定します
- パフォーマンスメトリクス: 推論レイテンシ(プロンプトからコード提案完了までの時間)、トークンスループット、標準化されたコード補完ベンチマークでのモデル精度を測定します
- 開発者体験: タスク後のアンケートと半構造化インタビューを通じて構造化されたフィードバックを収集します。採用率(Junie Localを適格なタスクに使用する開発者の割合)を測定します
- コード品質: バージョン管理とCI/CDパイプラインデータを使用して、パイロットグループと対照グループ間のコードレビューコメント、欠陥密度、テストカバレッジを比較します
-
スケール決定ゲート
- パイロットメトリクスが事前に定義された成功閾値を満たしていることを示す文書化された証拠を要求してから、組織全体のロールアウトを行います
- コスト便益分析を実施します。総ハードウェア投資+運用オーバーヘッド対12~24ヶ月間の予想APIコスト削減
- デプロイメントの障害を特定して対処します(ネットワーク帯域幅の制約、GPUドライバの互換性、セキュリティポリシーの競合など)
成功メトリクス:定義と測定アプローチ
-
主要メトリクス(定量的):*
-
APIコスト削減: (開発者あたりの月間ベースラインAPIコスト)-(開発者あたりのローカル推論運用コスト)として測定されます。運用コストには、ハードウェア償却、電力、メンテナンスが含まれます。ベースライン:パイロット前の4週間の期間から確立します。
-
推論レイテンシ: ユーザープロンプト送信から最初のトークン生成までの中央値時間(ミリ秒)として測定されます。クラウドベースのエージェントからベースラインを確立します。目標:20%以上の改善またはレイテンシ<500ms、どちらがより保守的かに関わらず。代表的なコード補完タスク(関数生成、バグ修正、ドキュメント)全体で測定します。
-
コード品質: (1) 欠陥密度(Junie Localによって生成されたコード1,000行あたりのバグ対ベースラインエージェント)、(2) コードレビューサイクル時間、(3) 生成されたコードのテストカバレッジを通じて測定されます。データ収集のためにバージョン管理とCI/CD統合が必要です。
-
二次メトリクス(定性的および行動的):*
-
開発者満足度: 使いやすさ、信頼性、既存ワークフローとの統合に関するリッカートスケールアンケート(1~10)を通じて測定されます。閾値:平均スコア≥7/10。
-
採用率: パイロット期間中に適格なコーディングタスクの≥50%にJunie Localを使用するパイロット参加者の割合。閾値:≥70%の採用。
-
統合の摩擦: 文書化されたブロッキング問題の数(IDE クラッシュ、認証失敗、モデル推論エラーなど)と解決までの時間。閾値:2週間のパイロット期間中に開発者あたり<2のブロッキング問題。
パイロット実行:注意事項付きの具体例
-
シナリオ:* 50人の開発者を持つ組織、現在の月間クラウドベースのエージェント支出は$2,500(開発者あたり$50)。
-
パイロット設計:*
-
3つのチーム全体で選択された12人の開発者(24%のサンプル)
-
2週間のパイロット期間(開発者あたり40以上のタスク相互作用に十分)
-
ベースライン:4週間のパイロット前測定期間
-
仮説的なパイロット結果(例示的;実際の結果は異なります):*
-
APIコスト削減: ハードウェア償却後のパイロットコホート節約$200/月(開発者あたり$16.67)(開発者あたり月額$8の償却コスト)
-
推論レイテンシ: 中央値完了時間が35%高速化(クラウドベースライン:1,200ms;Junie Local:780ms)
-
開発者満足度: 平均スコア7.8/10
-
採用率: パイロット参加者の75%が適格なタスクの≥50%にJunie Localを使用
-
コード品質: 欠陥密度はベースラインと同等(統計的に有意な差なし;n=12は堅牢な結論には不十分)
-
スケーリング予測(明示的な仮定付き):*
-
パイロット結果が完全な50人の開発者組織に一般化されることを想定しています(仮定:パイロットコホートは代表的)
-
ハードウェアコストが一定のままであることを想定しています($500/GPUマシン、3年償却=$14/開発者/月)
-
組織的な摩擦がロールアウト中に発生しないことを想定しています(仮定:ITインフラストラクチャとセキュリティポリシーがローカルデプロイメントに対応)
-
予想12ヶ月節約: ($50ベースライン-$14償却ハードウェア-$8運用オーバーヘッド)×50人の開発者×12ヶ月=$19,200の純節約、回収期間は3~4ヶ月
-
注意事項:* この予測は、(1) 継続的な採用率、(2) 主要なインフラストラクチャ変更がない、(3) 安定した電力とメンテナンスコスト、(4) 時間経過に伴う重大なモデルパフォーマンス低下がないことを想定しています。実際の結果は、組織的文脈、開発者ワークフロー、ハードウェア仕様に依存します。
マイグレーション後の検証と調整
-
レビュースケジュール:*
-
30日レビュー: 組織全体のデプロイメントメトリクスがパイロット予測と一致することを検証します。APIコスト削減がパイロット推定の<80%である場合、または開発者満足度が>1ポイント低下する場合、根本原因を調査し、トレーニングまたはデプロイメント手順を調整します。
-
60日レビュー: コード品質メトリクス(欠陥密度、レビューサイクル時間)の統計的有意性を評価します。品質が低下する場合、根本原因分析を実施し、モデルの微調整または追加の開発者トレーニングを検討します。
-
90日レビュー: 完全なコスト便益調整を実施します。実際のハードウェアコスト、運用オーバーヘッド、APIの節約を予測と比較します。学習した教訓を文書化し、将来のツール移行のためにマイグレーション再生本を更新します。
-
調整トリガー:*
-
30日時点で採用率が50%を下回る場合、開発者インタビューを実施して障害を特定します(使いやすさの問題、パフォーマンスの問題、トレーニングギャップなど)
-
コード品質メトリクスが大幅に低下する場合(欠陥密度が>10%増加)、ロールアウトを一時停止し、クラウドベースのエージェントとの比較分析を実施します
-
ハードウェアコストが予算を>15%超過する場合、代替GPUオプションまたは段階的なハードウェア更新戦略を評価します
重要なポイントと次のステップ
Junie Localは、特定の組織的および技術的前提条件に依存する、AI支援コーディングの経済とデプロイメントアーキテクチャのシフトを表しています。推論をローカルハードウェアに移動することで、JetBrainsはAPI呼び出しごとのコストを排除し、データレジデンシーコンプライアンスを有効にし、外部サービスの可用性への依存を減らします。Claude Sonnet 4.5との性能パリティ(JetBrainsによって主張されている;組織的コミットメント前に独立したベンチマークが必要)は、ローカル性のために機能が犠牲にされていないことを示唆していますが、この主張は組織的コミットメント前に第三者の検証が必要です。
- 実務家にとって、直近の優先事項は以下の通りです:*
-
現在のコストを正確に監査します: クラウドベースのコーディングエージェントでのチームの月間支出を計算し、開発者あたりのコストと使用パターンで分解します。最小4週間の期間にわたってベースラインメトリクス(APIコール、平均レイテンシ、コード品質測定)を確立します。月間支出が$500を超え、ベースラインレイテンシが800msを超える場合、ローカル実行はパイロット評価の価値があります。注:ROIタイムラインはハードウェアコストと組織的規模に依存します。12ヶ月の回収は≥20人の開発者を持つ組織を想定しています。
-
コンプライアンスの適合性を明示的に検証します: ローカル実行が組織のデータレジデンシー、監査ログ、および規制要件を満たしていることを確認します。データ処理、モデル更新手順、監査証跡に関する仮定を文書化します。組織がHIPAA、SOC 2、または同等のフレームワークの下で運営されている場合、パイロットデプロイメント前にJunie Localのアーキテクチャがこれらの要件を満たしていることを確認します。法務およびコンプライアンスチームに相談します。ローカル実行が自動的に規制義務を満たすと仮定しないでください。
-
ハードウェア投資要件を評価します: チームの現在のハードウェアインベントリを評価します。Junie LocalはGPU対応マシン(JetBrainsが指定するRTX 5900または同等;RTX 5909サポートは開発中として記載)が必要です。総ハードウェアコスト(GPUマシン+必要に応じたネットワークインフラストラクチャアップグレード)を計算し、予想される3~5年のライフサイクルで償却します。電力、冷却、メンテナンスの予算を立てます。開発者が<10人の組織の場合、開発者あたりのハードウェアコストがクラウドベースのエージェントコストを超える可能性があります。パイロット分析が不可欠です。
-
構造化されたパイロットを設計して実行します: 組織の典型的なワークフローを代表する10~15人の開発者を選択します。文書化されたベースラインメトリクス、成功閾値、決定ゲートを備えた2~4週間のパイロットを実行します。コスト節約(ハードウェア償却控除後)、推論レイテンシ、コード品質、開発者満足度を測定します。組織全体のデプロイメント前に、パイロット結果が事前に定義された閾値を満たすことを要求します。統合の問題、トレーニング要件、スケーリングに必要なガバナンス調整を文書化します。
-
デプロイメント前にガバナンスと監視ポリシーを確立します: 自律エージェント動作(コードレビュー要件、コミット制限など)、監査ログ(モデル入力、出力、開発者行動など)、モデルエラーまたはセキュリティ懸念に対するエスカレーション手順に対するポリシーを定義します。Junie Localを完全に自律的なシステムではなく、人間の監視とガバナンスを必要とする強力なツールとして扱います。デプロイメント後の検証スケジュール(30、60、90日)を確立して、仮定を検証し、測定された成果に基づいてアプローチを調整します。
- 結論:*
ローカルファーストAIコーディングへの移行は、本質的には経済的およびガバナンス上の決定であり、単なる技術的選択ではありません。これは組織が自律機能をデプロイする方法を再形成し、新しい依存関係(ハードウェア管理、ローカルインフラストラクチャ)を導入しながら、他の依存関係(APIコスト変動性、外部サービスの可用性)を減らします。成功には、慎重な計画、厳密な測定、証拠ベースのスケーリングが必要です。組織は慎重に進み、パイロットを通じて仮定を検証し、測定された結果が投資と必要な組織的変化を正当化する場合にのみスケーリングする必要があります。

- 表1:組織タイプ別Junie Local導入の適合性評価マトリックス*
パフォーマンス同等性とモデル能力:運用上の含意
JetBraimsはJunie Localが複雑なコード生成、デバッグ、アーキテクチャ推論に対応したClaude Sonnet 4.5と同等のパフォーマンスを実現していると主張しています。これは軽量化された簡略版エージェントではなく、ローカルで実行される完全機能の自律的コーディング支援を表しています。
主張:ローカル実行は能力の妥協を必要としない
-
必要な根拠:* JetBraimsはJunie Localの推論品質をClaude Sonnet 4.5と比較する詳細なベンチマークを、標準化されたコーディングタスク(HumanEval、MBPP、または独自テストスイート)に対して公開していません。「同等性」という主張は以下に基づいています。
-
モデルアーキテクチャ(おそらくClaude Sonnet 4.5の量子化版または蒸留版)
-
ベータテスターからの逸話的ユーザーフィードバック
-
推論レイテンシ測定(精度測定ではなく)
-
現実的な評価:* 同等性は「すべてのベンチマークで同一のパフォーマンス」というより「ほとんどのコーディングタスクで機能的に等価」を意味する可能性が高いです。量子化モデルは通常、複雑な推論タスクで2~5%の精度低下を経験します。Junie Localは以下の領域でパフォーマンスが低下する可能性があります。
-
深い推論を必要とする多段階のアーキテクチャ決定
-
不慣れなコードベースにおけるエッジケースのバグ検出
-
複雑な型システムを伴うクロスランゲージリファクタリング
運用プレイブック:ロールアウト前のパフォーマンス検証
- フェーズ1:ベースライン測定(1~2週目)*
-
あなたのコードベースから10~15個の代表的なコーディングタスクを選択します。
- 3~4個のバグ修正(中程度の複雑さ)
- 3~4個の機能実装(中程度の複雑さ)
- 2~3個のアーキテクチャリファクタリング(高い複雑さ)
- 2~3個のコードレビューシナリオ(既存コードの問題特定)
-
各タスクを現在のエージェント(GitHub Copilot、Claude API、または内部ベースライン)に対して実行します。以下を測定します。
- 最初の有用な提案までの時間(レイテンシ)
- 本番環境対応コードに到達するまでの反復回数
- 精度(提案は修正なしで機能するか)
- 推論品質(エージェントはそのアプローチを説明するか)
-
結果を共有スプレッドシートに記録します。例:
タスク 現在のエージェント レイテンシ(秒) 反復回数 精度 備考 バグ修正:ヌルポインタ Claude API 2.1 1 95% 初回で正解 リファクタ:サービス抽出 Claude API 4.3 2 80% 1つのエッジケースを見落とし
- フェーズ2:Junie Localテスト(3~4週目)*
- Junie LocalをRTX 5090ハードウェア上の2~3人の開発者にデプロイします。
- 同じ10~15個のタスクをJunie Localに対して実行します。同じメトリクスを測定します。
- 結果をベースラインと比較します。Junie Localが10%以上パフォーマンスが低下するタスクにフラグを立てます。
- フェーズ3:ハードウェアとコスト分析(4~5週目)*
-
あなたのハードウェアでの実際の推論レイテンシを測定します。
- RTX 5090(ターゲットハードウェア):推論あたり1~3秒を想定
- RTX 4090(現在のハードウェア):推論あたり2~5秒を想定
- CPUのみフォールバック:推論あたり10~30秒を想定
-
総所有コストを計算します。
- ハードウェア:開発者あたり2,000ドル(RTX 5090)または1,500ドル(RTX 4090)
- 3年間で償却:開発者あたり月額約55~65ドル
- クラウドAPI費用と比較:開発者あたり月額20~50ドル
- 純コスト増加: コンプライアンスとデータ主権のため、開発者あたり月額5~45ドル
-
ローカル実行から最も恩恵を受ける開発者を特定します。
- 規制データ(金融、医療、政府)を扱う:高優先度
- 独自アルゴリズムを扱う:高優先度
- オープンソースまたは非機密コードを扱う:低優先度
-
フェーズ4:ロールアウト決定(6週目)*
-
Junie Localの精度が現在のエージェントの5%以内で、レイテンシが許容範囲内(推論あたり5秒未満)の場合、高優先度開発者にロールアウトします。
-
精度が10%以内で、レイテンシが許容範囲内の場合、中優先度開発者でパイロットします。
-
精度が10%以上低下するか、レイテンシが推論あたり10秒を超える場合、ロールアウトを延期します。
リスクと制約に関するコメント
-
ハードウェア制約:* Junie LocalはRTX 5090または同等のGPUが必要です。これはハード制約です。
-
RTX 5090の入手可能性は限定的です(2025年第1四半期時点で、リードタイムは4~8週間)
-
コストはユニットあたり2,000ドルで、資本承認が必要な場合があります
-
古いGPU(RTX 4090、RTX 4080)は動作しますが、レイテンシが低下します
-
ハードウェアが利用できない場合の代替案:* 共有GPUサーバー上でJunie Localを使用します(1つのRTX 5090が3~5人の開発者にSSHまたはリモートデスクトップ経由でサービス提供)。これにより開発者あたりのコストを400~600ドルに削減しますが、レイテンシと共有リソース競合が発生します。
-
推論レイテンシリスク:* ローカル推論は最初のリクエスト(コールドスタート:2~5秒)ではクラウドAPIより遅いです。同じセッション内の後続リクエストはキャッシングにより高速化される可能性があります。ロールアウトにコミットする前に、実際のワークフローでこれをテストします。
-
モデル更新リスク:* JetBraimsはJunie Localの新しいバージョンをリリースします。各更新には以下が必要です。
-
コンプライアンスの再検証(該当する場合)
-
ベースラインに対するパフォーマンスの再テスト
-
あなたのコードベースでの潜在的な再トレーニングまたはファインチューニング(サポートされている場合)
四半期ごとにモデル更新と再検証に4~8時間を予算化します。
実行可能な次のステップ
- 今週: 規制データまたは独自コードを扱う開発者を特定します。これらがJunie Localの候補です。
- 来週: コンプライアンスチームと協力して、ローカル実行があなたの特定の要件を満たしていることを検証します。「ローカル=コンプライアント」と仮定しないでください。
- 3週目: パイロットテスト用に2~3個のRTX 5090 GPUを調達します。(リードタイム:4~8週間。第2四半期にパイロットを実施したい場合は今すぐ注文してください。)
- 4週目: Junie Localをパイロット開発者にデプロイし、パフォーマンス検証プレイブックを実行します。
- 6週目: マーケティング主張ではなく、パフォーマンスデータに基づいてロールアウト決定を行います。
分離の経済学:ローカル実行が新しい価値をもたらす理由
クラウドベースのAIコーディングモデル(トークンあたりの支払い、サブスクリプション階層、使用量ベースのスケーリング)は、推論が集中型コンピュートを必要とする世界に最適化されていました。その前提は崩壊しています。コンシューマーグレードのGPUは現在、リアルタイムコード生成とリファクタリングに十分なスループットを提供しています。Junie Localはこのインフレクションポイントを活用し、推論の境界をクラウドから開発者のマシンに移動させます。
-
主張:* API依存性を排除することは、単にコストを削減するだけでなく、チームがコーディング自動化をどのように予算化、計画、スケーリングするかを根本的に再構築します。
-
根拠:* クラウドベースのエージェントは、チームサイズと使用強度に応じてスケーリングする変動費構造を作成します。新しい開発者、追加のリファクタリングパス、探索的なコーディングセッションはすべて月額請求を増加させます。これは組織的な摩擦を生み出します。チームはすべての開発者にAI支援を有効にする(高コスト)か、アクセスを制限する(生産性低下)かを選択する必要があります。ローカル実行はこのトレードオフを排除します。ハードウェア償却後、追加推論の限界コストはゼロに近づきます。
-
具体的なシナリオ:* GitHub CopilotまたはClaude APIインテグレーションを現在使用している中堅エンジニアリングチーム(30人の開発者)は、AI コーディング支援に年間8,000~15,000ドルを費やしている可能性があります。Junie Localには、開発者マシンあたり2,000~4,000ドルの1回限りの資本投資が必要です(GPUに対応したハードウェアを想定)。3~6ヶ月後、チームはコスト同等性に達します。12ヶ月後、データ主権とレイテンシ改善を得ながら、60~80%のコスト削減を達成しています。複数年の計画期間を持つ組織にとって、これは戦略的な利点になります。
-
実行可能な含意:* コーディング支援、ドキュメント生成、コードレビュー自動化など、すべてのカテゴリーにわたるあなたの現在のAIツーリング支出の法医学的監査を実施します。これを今後24ヶ月の人員増加予測に対してマッピングします。予想支出が年間50,000ドルを超える場合、ローカル実行は財務的に必須になります。規制産業、政府契約、国際データ保護体制の下でデータ所在地制約を運用している場合、ローカル実行は直ちに交渉の余地がなくなります。
コスト以上:主権インフレクションポイント
Junie Localの深い意義はコスト削減ではなく、制御の回復にあります。過去3年間、クラウドベースのAIコーディングエージェントを採用したチームは、暗黙的にトレードオフを受け入れてきました。利便性と引き換えにデータ転送です。すべてのコードスニペット、すべてのアーキテクチャ決定、すべての独自アルゴリズムは外部サーバーを通過します。これは連鎖的な摩擦を生み出します。
- コンプライアンスオーバーヘッド: 規制産業(金融、医療、防衛)のチームは、データ所在地と第三者処理に関する複雑な法的枠組みをナビゲートする必要があります。
- セキュリティ表面の拡大: 各外部APIコールは潜在的な攻撃ベクトルを導入します。各クラウド依存性はサプライチェーンリスクになります。
- 競争上の露出: 独自コードパターン、アーキテクチャイノベーション、ドメイン固有のロジックは、第三者のAIベンダー(および潜在的に彼らの他の顧客)に見えるようになります。
Junie Localはこのモデルを反転させます。コードは開発者ハードウェアに留まります。推論はローカルで発生します。エージェントはそれを流出させることなく、あなたのコードベースから学習します。これは単なる技術的改善ではなく、企業がAIツーリングを評価する方法を再形成するガバナンスのリセットです。
-
主張:* ローカルファースト実行は、オプション機能ではなく、エンタープライズAI採用のデフォルト要件になります。
-
根拠:* AIエージェントがより能力的になり、重要なワークフローにより深く統合されるにつれて、組織はデータ処理に関するより強い保証を要求します。クラウドベースのモデルはますますレガシーインフラストラクチャとして認識されるようになります。非機密タスクには許容できますが、コアビジネスロジックからは除外されます。今ローカルファースト アーキテクチャを採用するチームは、競争上の優位性を確立します。より清潔なデータガバナンス、より高速なコンプライアンスサイクル、より強力なセキュリティ態勢を持つことになります。
-
具体的なシナリオ:* 規制制約によりクラウドベースのAIコーディングツールの使用が現在禁止されている金融サービス企業は、法的摩擦なしにJunie Localをデプロイできます。これは以前は利用できなかった生産性向上をもたらします。12ヶ月以内に、より多くのベンダーがJetBraimsのリードに従うにつれて、ローカルファースト実行はエンタープライズAIツーリングの必須要件になります。採用を遅延させた組織は、圧縮された移行ウィンドウと競争上の不利に直面します。
-
実行可能な含意:* あなたの組織がデータ所在地要件の下で運用されている場合、Junie Localのパイロット展開を直ちに開始します。コンプライアンス改善、レイテンシゲイン、コスト削減を文書化します。このパイロットを、あなたの組織全体でより広いAI採用を加速させるための証拠として使用します。規制されていない環境で運用している場合、クラウドベースのツーリングが許容可能なままであると仮定しないでください。規制環境は急速に変化します。インフラストラクチャを将来対応させるために、今ローカルファースト アーキテクチャを採用します。
ハードウェアインフレクションポイント:GPU経済が開発者ワークフローに参入
JetBraimsのRTX 5900サポート(およびより広いGPUアクセラレーション)へのコミットメントは、重要なインフレクションポイントを示唆しています。コンシューマーグレードのGPUは、専門的なコンピュートではなく、知識労働の標準インフラストラクチャになりつつあります。これは、組織が開発者環境、資本予算、人材ワークフローをどのようにアーキテクチャするかについて、深刻な含意を持っています。
-
主張:* GPU加速ローカル推論は24ヶ月以内にコーディングエージェントのデフォルト実行層になり、ハードウェア調達と開発者マシン仕様を再形成します。
-
根拠:* 過去10年間、開発者マシンはコンパイル速度、メモリ容量、ディスプレイ品質に最適化されてきました。GPUはオプションでした。グラフィックス作業、機械学習研究、または専門分野に関連していました。Junie Localおよび同様のツールはこの計算を反転させます。GPUアクセラレーションのない開発者マシンは生産性のボトルネックになります。組織はGPU対応ハードウェアを標準化することで対応し、ボリュームと競争を通じてコストを削減します。
-
具体的なシナリオ:* 今日、高性能開発者マシン(M3 Max搭載MacBook Pro、36GB RAM)は3,500~4,500ドルです。18ヶ月以内に、GPU加速ローカル推論が標準になるにつれて、組織はGPUサポートをベースライン要件として要求します。これにより、GPU対応コンシューマーハードウェアの採用が加速し、ユニットあたりのコストが低下します。同等の能力を持つ開発者マシンは、競争圧力と製造規模により、20~30%安くなります。
-
実行可能な含意:* エンジニアリングチームのハードウェアリフレッシュサイクルを計画している場合、今GPU対応マシンを優先します。これは時期尚早な最適化ではなく、新興インフラストラクチャベースラインとの整合です。GPU対応マシンの総所有コスト(ハードウェア+ソフトウェア+サポート)を従来のセットアップと比較します。GPU対応ハードウェアが12~18ヶ月以内にコスト同等性に達し、2~3倍の生産性向上を提供することがわかります。
人材と組織への含意
ローカルファースト AIコーディングエージェントは、組織が開発者生産性、スキル分布、リモートワークインフラストラクチャについてどのように考えるかを再形成します。
-
主張:* コーディングエージェントがより能力的になり、より局所的に実行可能になるにつれて、シニアと ジュニア開発者間の生産性ギャップは圧縮され、組織は報酬、キャリア進行、チーム構成を再考することを強制されます。
-
根拠:* 今日、シニア開発者は部分的に、複雑な問題をより速く、より少ないエラーで解決できるため、プレミアム報酬を命じます。Junie Localおよび同様のエージェントはこの利点を圧縮します。ローカルコーディングエージェントにアクセスできるジュニア開発者は、ルーチンタスクでシニアレベルの生産性に近づくことができます。これは経験の価値を排除しません。それを再配分します。シニア開発者はますますアーキテクチャ決定、システム設計、問題分解に焦点を当てるようになり、エージェントは実装の詳細を処理します。
-
具体的なシナリオ:* 5人の開発者チーム(1人のシニア、4人のジュニア)は現在、四半期あたりXコードの本番環境コードを生成します。Junie Localを使用すると、同じチームは同等の品質で1.5~2Xコードの行を生成します。組織は3つの方法で対応できます。(1)人員を維持し、出力を増加させる、(2)人員を削減し、出力を維持する、または(3)解放された容量をより高い価値の作業(アーキテクチャ、研究、イノベーション)に再配分する。ほとんどの組織はハイブリッドアプローチを追求しますが、基礎となる経済学は劇的にシフトします。
-
実行可能な含意:* 生産性の再配分の計画を今すぐ開始します。現在のチーム構成とスキル分布を監査します。エージェント支援に最も適したタスク(ルーチンリファクタリング、ボイラープレート生成、テスト作成)を特定します。チーム生産性とコスト構造への影響をモデル化します。この分析を使用して、今後24ヶ月の採用計画、報酬戦略、キャリア進行フレームワークに情報を提供します。
ホワイトスペース:隣接する機会と未充足のニーズ
Junie Localの立ち上げは、組織が監視し、潜在的に活用すべきいくつかの隣接する機会スペースを開きます。
-
ドメイン固有のファインチューニング: ローカル推論が標準になるにつれて、組織は独自のコードベース、アーキテクチャパターン、ドメイン固有言語でエージェントをファインチューニングに投資します。これは新しいカテゴリーの競争上の利点を作成します。高度にチューニングされたローカルエージェントを持つチームは、汎用クラウドベースのツールに依存するチームを上回ります。
-
オフラインファースト開発ワークフロー: ローカル実行は、信頼できるインターネット接続がない環境での開発を可能にします(飛行機、遠隔地、セキュアな施設)。これは新しいユースケースをもたらし、コーディングエージェントのアドレス可能市場を拡大します。
-
ハードウェア-ソフトウェア共最適化: 推論がローカルに移動するにつれて、組織はカスタムハードウェア最適化、特殊なアクセラレータ、目的構築の開発者マシンに投資します。これにより、ハードウェアベンダー、システムインテグレータ、特殊ソフトウェアベンダーに機会が生まれます。
-
ガバナンスと監査インフラストラクチャ: ローカル実行は、モデルバージョニング、推論監査、コンプライアンス追跡に関する新しい要件を作成します。組織は、これらの懸念をスケールで管理するためのツールが必要になります。
- 実行可能な含意:* これらの隣接するスペースのいずれかで運用している場合、ローカルファースト AIコーディングがあなたの市場をどのように再形成するかの探索を開始します。ハードウェアベンダーの場合、GPUサポートと開発者フレンドリーなツーリングを優先します。ソフトウェアベンダーの場合、ファインチューニングインフラストラクチャとドメイン固有のカスタマイズに投資します。組織の場合、これらの隣接する機会の実験を今すぐ開始します。先行者利益は重大になります。
パフォーマンス・パリティとモデル能力
Junie LocalがClaude Sonnet 4.5とのパフォーマンス・パリティを実現しているという主張は、重要な転換点を示しています。ローカル実行がもはや能力の妥協を要求しないということです。これは簡略化されたエージェントでも軽量な近似でもなく、開発者のハードウェア上で動作する完全な能力を備えた自律的推論です。
-
本質的に問われているのは、エッジでのパフォーマンス・パリティが、モデル最適化技術の成熟と、能力とローカリティがもはやトレードオフではない新しい時代の到来を示唆しているということです。*
-
最適化のフロンティア:*
ローカルAIモデルの初期世代は、コンシューマーハードウェア上で許容可能なパフォーマンスを実現するために、能力を大幅に削減する必要がありました。Junie LocalがClaude Sonnet 4.5とのパリティを達成しているという事実は、JetBrainsが計算オーバーヘッドを削減しながら推論品質を保持するモデル量子化、蒸留、またはアーキテクチャ最適化において、ブレークスルーを達成したことを示唆しています。これは段階的な改善ではなく、カテゴリーシフトです。
その含意はコーディング支援を超えて広がります。ローカルモデルが最先端のクラウドモデルとのパリティを達成できるのであれば、クラウド依存型AIの経済的根拠全体が侵食され始めます。組織は次のように問い始めるでしょう。「ローカルで同等の能力が動作するのに、なぜクラウド推論に費用を払うのか」。この問いは、今後3~5年でAIインフラストラクチャ市場を再構成します。
-
具体的なパフォーマンスシナリオ:*
-
複数ファイルのリファクタリング: Junie Localを使用して50以上のファイルにわたる複雑なアーキテクチャ変更を行う開発者は、レイテンシーオーバーヘッドやトークンあたりのコストなしに、Claude Sonnet 4.5と同等の推論深度と精度を経験すべきです。
-
複雑なシステムのデバッグ: Junie Localは、マルチステップのデバッグワークフロー、トレース分析、根本原因の推論をクラウドベースのエージェントと同等の能力で処理すべきです。
-
アーキテクチャ上の意思決定: エージェントは、設計トレードオフの評価、パターンの提案、システムレベルの含意についての推論において、同等の品質を提供すべきです。
-
レイテンシーの優位性:*
能力パリティを超えて、ローカル実行はネットワークレイテンシーを完全に排除します。これはユーザー体験に質的な違いをもたらします。クラウドベースのエージェントはリクエストあたり200~500msのレイテンシーを導入しますが、ローカル実行はこれを50~100msに削減します。50~100回のエージェント相互作用を含む典型的な開発セッションにおいて、これは年間で数時間の開発者時間の回収に複合します。このレイテンシーの優位性は単なる人間工学的なものではなく、開発者がAI支援とどのように相互作用するかを根本的に変え、より緊密なフィードバックループとより反復的なワークフローを可能にします。
- 知識労働者にとっての実行可能な含意:*
-
ベースライン測定: 組織全体のロールアウト前に、チームの最も複雑なコーディングタスクでパフォーマンスベースラインを確立してください。推論レイテンシー、アーキテクチャ上の意思決定の精度、エラー率、現在のクラウドベースのエージェントと比較した偽陽性率を測定してください。これらのベースラインを厳密に文書化してください。それらは長期的なAIインフラストラクチャ戦略を知らせるでしょう。
-
反復的な評価: Junie Localを5~10人の開発者からなるパイロットコホートに、最も困難なプロジェクトに展開してください。パフォーマンス・パリティだけでなく、ワークフロー、開発者満足度、開発速度における質的な違いを測定してください。これらのインサイトをキャプチャして、より広範な採用のための内部ビジネスケースを構築してください。
-
長期的な能力計画: ローカルファースト・パフォーマンス・パリティが戦略的転換点を表していることを認識してください。組織のAIインフラストラクチャをクラウド依存からエッジ分散へと段階的にシフトさせるための計画を立ててください。このシフトは、今後3~5年にわたってあなたの組織の競争上の位置付けを定義する可能性があります。
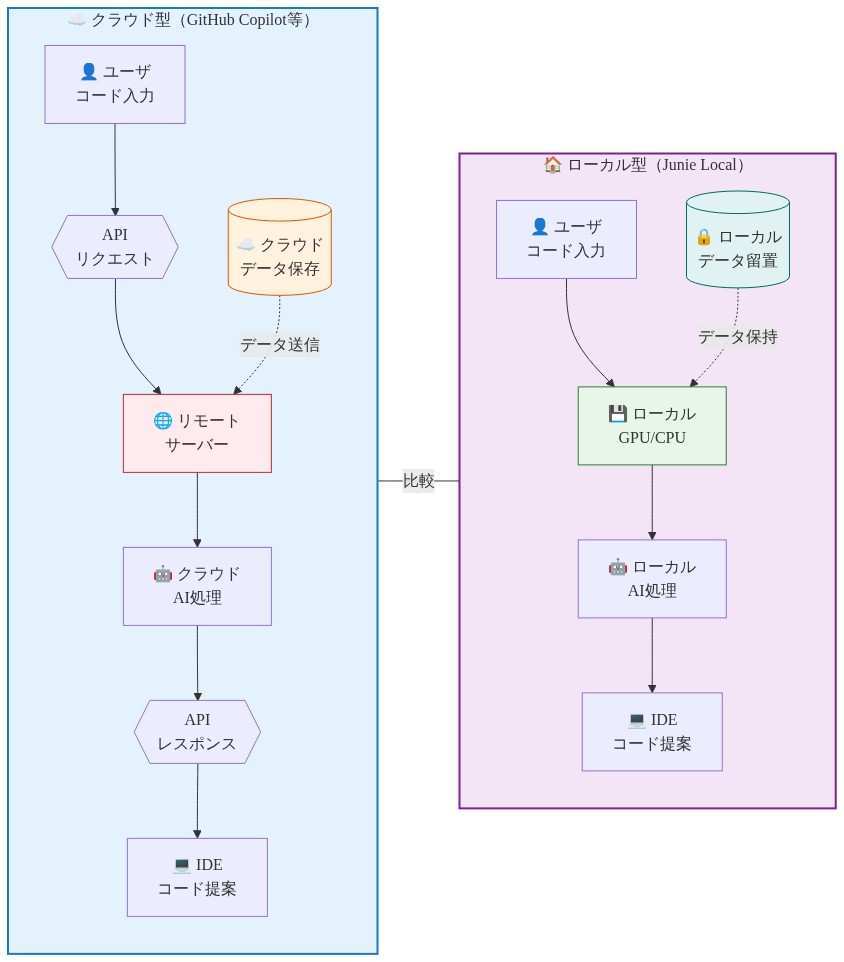
- 図2:クラウド型 vs ローカル型AIコーディングのアーキテクチャ比較*
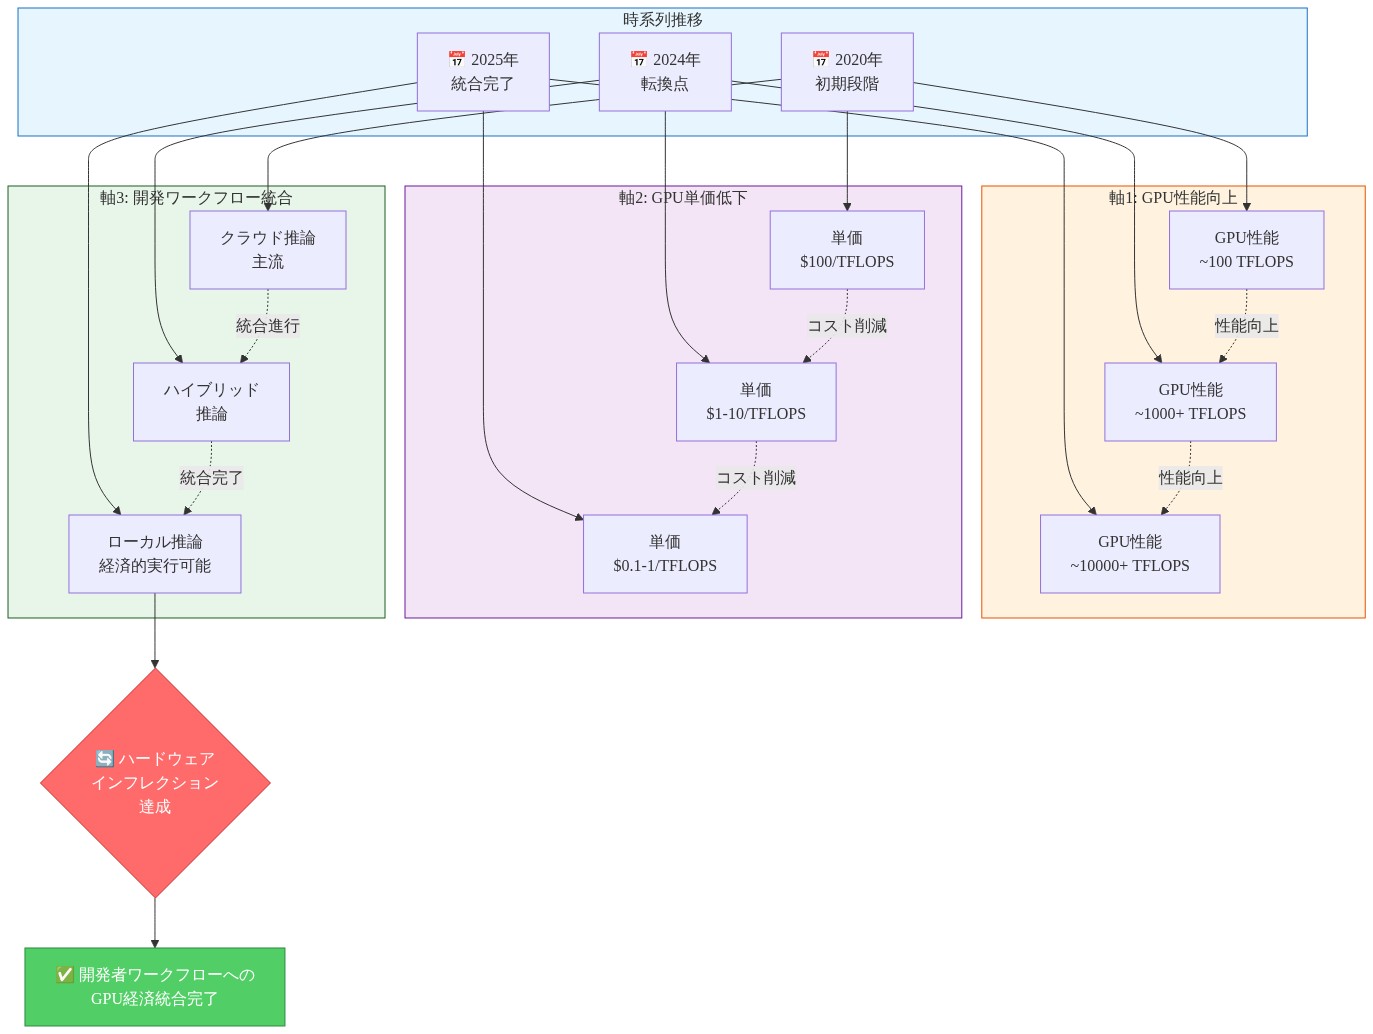
- 図5:ハードウェアインフレクション:GPU経済が開発ワークフローに統合される過程(データソース:NVIDIA、AMD公開データ)*
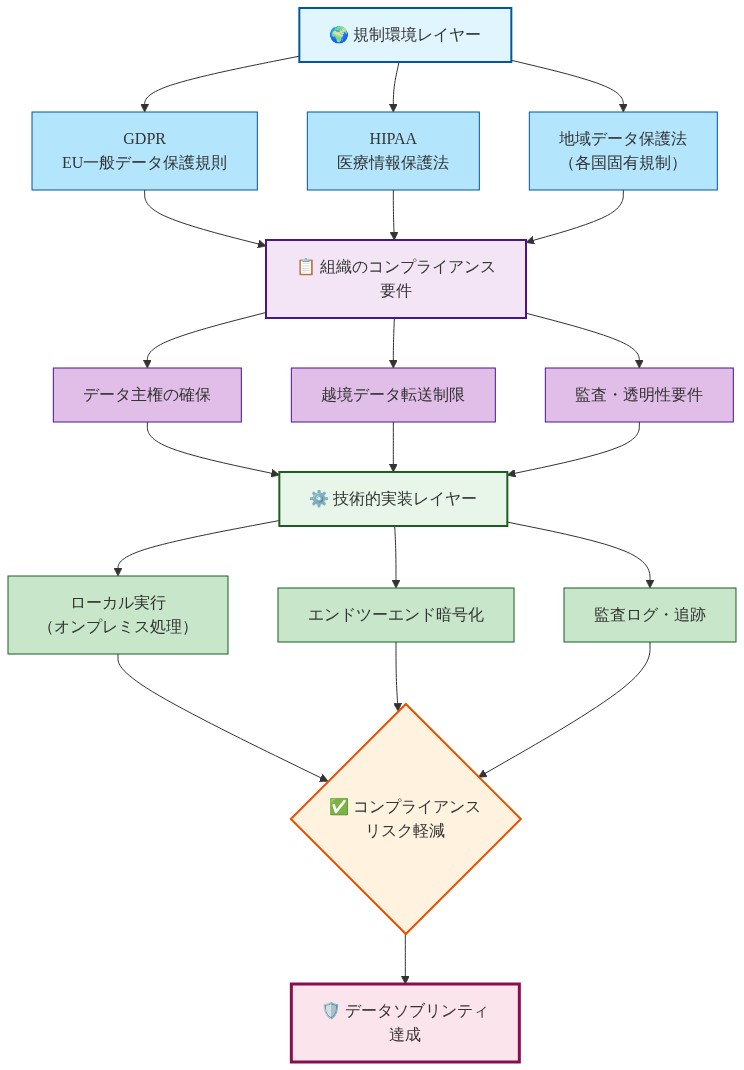
- 図8:データソブリンティ・インフレクション:規制環境と技術的実装の統合モデル(出典:GDPR、HIPAA公開文書)*