L-FNO: ロレンツ型フーリエニューラルオペレータ確率事象ダイナミクス向け
運用システムにおける不確実性:通常の仮定を超えて
現代の運用システムは、期待される条件から根本的に逸脱する障害モードに直面しています。サプライチェーンは需要ショックを経験し、金融市場はボラティリティクラスタリングを示し、インフラネットワークはカスケード障害を呈します。これらの現象は二つの異なる源から生じます。外生的共変量(市場シグナル、気象パターン、政策変化)と内生的ダイナミクス(過去の事象が確率的に将来の事象を引き起こす)です。
従来のニューラルオペレータ(標準的なフーリエニューラルオペレータ(FNO)を含む)は、予測を関数近似問題として定式化し、点推定値または平均場出力を生成します。この定式化は、予測対象が滑らかで連続的な軌跡に従うことを仮定しています。しかし、疎な事象は点過程ダイナミクスに支配される条件付き強度分布に従い、滑らかなフィールドには従いません。これは程度の問題ではなく、カテゴリー的な区別です。
運用上の帰結は実質的です。ニューラルオペレータが電力網の平均負荷を予測する場合、同時コンポーネント障害の裾リスクについて何の情報も提供しません。平均取引量を予測する場合、詐欺クラスタリングを定量化することはできません。疎な事象体制では、事象尤度の過小評価のコストは非対称です。偽陰性(稀な事象の見落とし)は通常、偽陽性(虚偽アラート)よりも高い運用および財務影響を伴います。
不確実性定量化の原則(点推定値の縮約ではなく)は、シミュレーションベースの推論文脈で確立されています。不確実性分布を維持および伝播するシステムは、単一予測を出力するシステムと比較して、優れたリソース配分とリスク管理を可能にします。L-FNOは、平滑化されたフィールド出力ではなく条件付き強度関数に直接訓練することでこの原則を拡張し、事象がクラスタリング、自己励起し、平均化に抵抗する領域に適しています。
- 運用上の含意:* 信頼区間なしで単一予測を出力する現在のニューラルオペレータ配置は、事象クラスタリングに根本的に盲目です。過去の事象をノイズではなく予測シグナルとして扱う配置は、内生的ダイナミクスを完全に見落とします。
回帰の罠:標準的なニューラルオペレータが疎な事象で失敗する理由
標準的なフーリエニューラルオペレータは、予測フィールドと観測フィールド間の平均二乗誤差(MSE)を最小化します。この目的関数は滑らかで密な現象に適していますが、疎でバースト的な事象シーケンスで壊滅的なパフォーマンス低下を示します。数学的な理由は直接的です。MSE損失はすべての誤差を等しく扱い、時間と空間にわたって平均化します。事象が観測ウィンドウの1%を占める場合、MSE目的の大域最小値は、モデルが「事象なし」をどこでも予測するときに発生します。これは高い数値損失削減を達成する洗練されたヌル予測器です。
事象データは尤度ベースの訓練目的を必要とします。ホークス過程(自己励起点過程の標準的なモデル)は、条件付き強度関数λ(t | H_t)を定義します。これは過去の事象が発生したときに増加し、カーネル関数に従って減衰します。標準的なFNOはこの減衰構造をエンコードするメカニズムを欠いています。事象履歴を静的フィールド入力として扱い、各事象発生に伴って進化する動的励起カーネルとしては扱いません。
計算アーキテクチャはこの制限を複合化します。標準的なオペレータは、事象が疎であっても、完全な状態空間全体で密なテンソル操作を必要とします。回帰損失で訓練されたモデルは疎性を利用できません。順方向パス全体を通じて完全次元表現を維持する必要があります。これは不要な計算オーバーヘッドを生成し、モデルが疎な事象表現を学習することを妨げます。
-
具体的な実装例:* サイバーセキュリティでは、攻撃試行は時間的にクラスタリングします。1つの侵入試行は頻繁に数時間以内の追加試行に先行します。回帰訓練されたオペレータは平均攻撃頻度を予測し、バースト検出のシグナルを提供しません。強度ベースのモデルは条件付き強度スパイクをキャプチャし、アラート優先順位付けとリソース事前配置を可能にします。
-
運用上の含意:* 稀で、クラスタリングされた、または自己強化的な事象を含む領域は、回帰損失を負の対数尤度目的に置き換える必要があります。この単一のアーキテクチャ変更は、モデルに滑らかなフィールド平均ではなく条件付き強度を学習するよう強制します。
L-FNO:アーキテクチャと訓練戦略
L-FNOは3つのコンポーネントを統合します。(1)外生的共変量用のFNOスタイルのスペクトル符号化器、(2)履歴依存励起用のロレンツ型スペクトルカーネル、(3)事象予測確率を直接最適化する尤度ベースの訓練です。
ロレンツ型カーネルは周波数空間の有理関数です。K(ω) = 1/(1 + ω²)。この関数形は時間領域と周波数領域の両方で滑らかに減衰し、指数カーネルよりも少ないパラメータで長距離時間依存性をキャプチャします。制約されたデータ体制(訓練データが限定的)では、物理情報カーネルはアーキテクチャに既知の減衰動作を直接エンコードすることでサンプル複雑性を削減します。
アーキテクチャは2つの並列ストリームを処理します。外生的共変量はスペクトル畳み込み(標準的なFNOレイヤー)を通じて流れ、事象履歴はロレンツ型カーネルを通じて条件付き強度を計算します。2つのストリームは学習されたゲーティングメカニズムを介してマージされ、モデルが外生的ショックが内生的励起を増幅または減衰させるときを学習できるようにします。形式的には、出力強度は以下の通りです。
λ(t) = σ(g(t)) · [λ₀ + ∫ K_L(t - s) dN(s)]
ここで、g(t)は共変量影響をエンコードし、K_Lはロレンツ型カーネル、N(s)は事象計数過程、σはゲーティング関数です。
訓練はMSEではなく負の対数尤度(ポアソンまたはホークス損失)を使用します。ポアソン尤度の場合:
L = -∑ᵢ [log λ(tᵢ) - ∫ λ(t) dt]
この目的は、疎な体制での事象確率の過小評価を過大評価よりもはるかに厳しく罰し、見落とされた事象が非対称コストを伴う運用リスク優先度と一致します。
-
具体的な実装例:* 通信では、ネットワーク障害は稀ですがメンテナンスウィンドウ後にクラスタリングします。L-FNOは共変量(メンテナンススケジュール)がベースライン強度λ₀を上げることを学習し、ロレンツ型カーネルはメンテナンス後の数時間にわたるリスク上昇の減衰をキャプチャします。回帰モデルはこれらのシグナルを平均化し、情報量の少ない平均予測を生成します。
-
運用上の含意:* 文書化された事象クラスタリングを持つパイロットデータセットでL-FNOを実装します。MSEではなく、稀な事象の精度再現率曲線の改善を測定します。固定再現率で精度が15%以上改善される場合、移行が正当化されます。
実装と運用パターン
配置は2段階パターンに従います。過去の事象ログでのオフライン訓練、その後ローリングウィンドウ更新でのオンライン推論です。モデルは共変量ストリーム(市場データ、センサー読み取り、運用ログ)と事象タイムスタンプを取り込み、複数の地平線(1時間、1日、1週間)での強度予測を出力します。
運用システムの場合、L-FNOを決定レイヤーでラップします。予測強度が閾値を超える場合(偽陽性許容度に調整)、アラートまたはリソース事前配置をトリガーします。サプライチェーンでは、これはバッファストック予約を意味し、金融では、ヘッジポジションを意味し、インフラでは、修理クルーのステージングを意味します。閾値は、恣意的ではなく、保留検証データでの受信者動作特性(ROC)分析を介して設定する必要があります。
計算コストは控えめです。ロレンツ型カーネルは密な畳み込みよりも少ないフーリエモードを必要とし、疎な事象データは効率的なバッチ処理を可能にします。疎性レベルとバッチサイズに応じて、比較可能なハードウェアでの密なオペレータと比較して2~5倍の推論高速化を期待します。
- 運用上の含意:* 最も影響の大きい事象ストリームで90日間のパイロットから始めます。アラート精度、偽陰性率、ビジネス影響(回避されたコスト、保護された収益)を測定します。定量化された結果を使用して、より広い展開を正当化します。
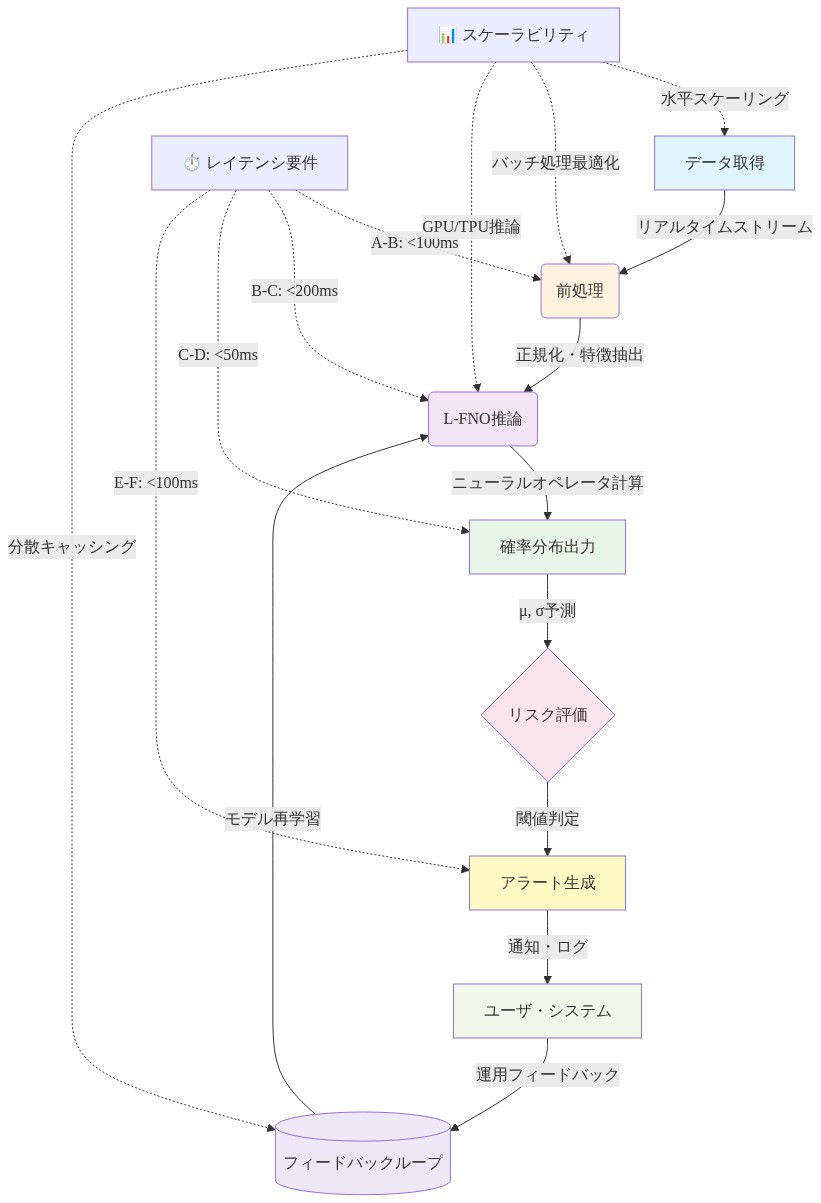
- 図8:L-FNO運用デプロイメント・パイプライン*
測定と調整
標準的なメトリクス(MSE、MAE)は疎な事象に対して誤解を招き、モデル評価に使用すべきではありません。代わりに、以下を追跡します。
- 調整: 時間領域をビンに分割します。各ビンで観測された事象頻度と予測された平均強度を計算します。調整誤差は平均絶対差です。よく調整されたモデルは調整誤差が0.05未満です。
- 事象レベルでの精度再現率: 高強度としてフラグが立てられたウィンドウのうち、実際に事象を含む割合はどのくらいですか。複数の強度閾値で精度再現率曲線を計算します。
- 検出までの時間: 事象クラスタが発生する前に、モデルが強度をベースラインより上に上げるまでに何時間かかりますか。反応型システムと比較します。
- 保留テストセットでの対数尤度: 訓練目的自体は、未見データでの有効な評価メトリクスです。
調整は重要です。調整されていないモデルは事象を正しくランク付けする可能性がありますが、絶対リスクを過大評価または過小評価し、リソース配分の誤りにつながります。強度を観測値の2倍高く予測するモデルは虚偽アラームをトリガーします。0.5倍を予測するモデルは事象を見落とします。
- 運用上の含意:* 配置前に、30日間のシャドウ検証を実行します。L-FNO予測をグラウンドトゥルースと比較します。強度閾値を運用リスク許容度に合わせて調整します。その後でのみアラートを有効化します。
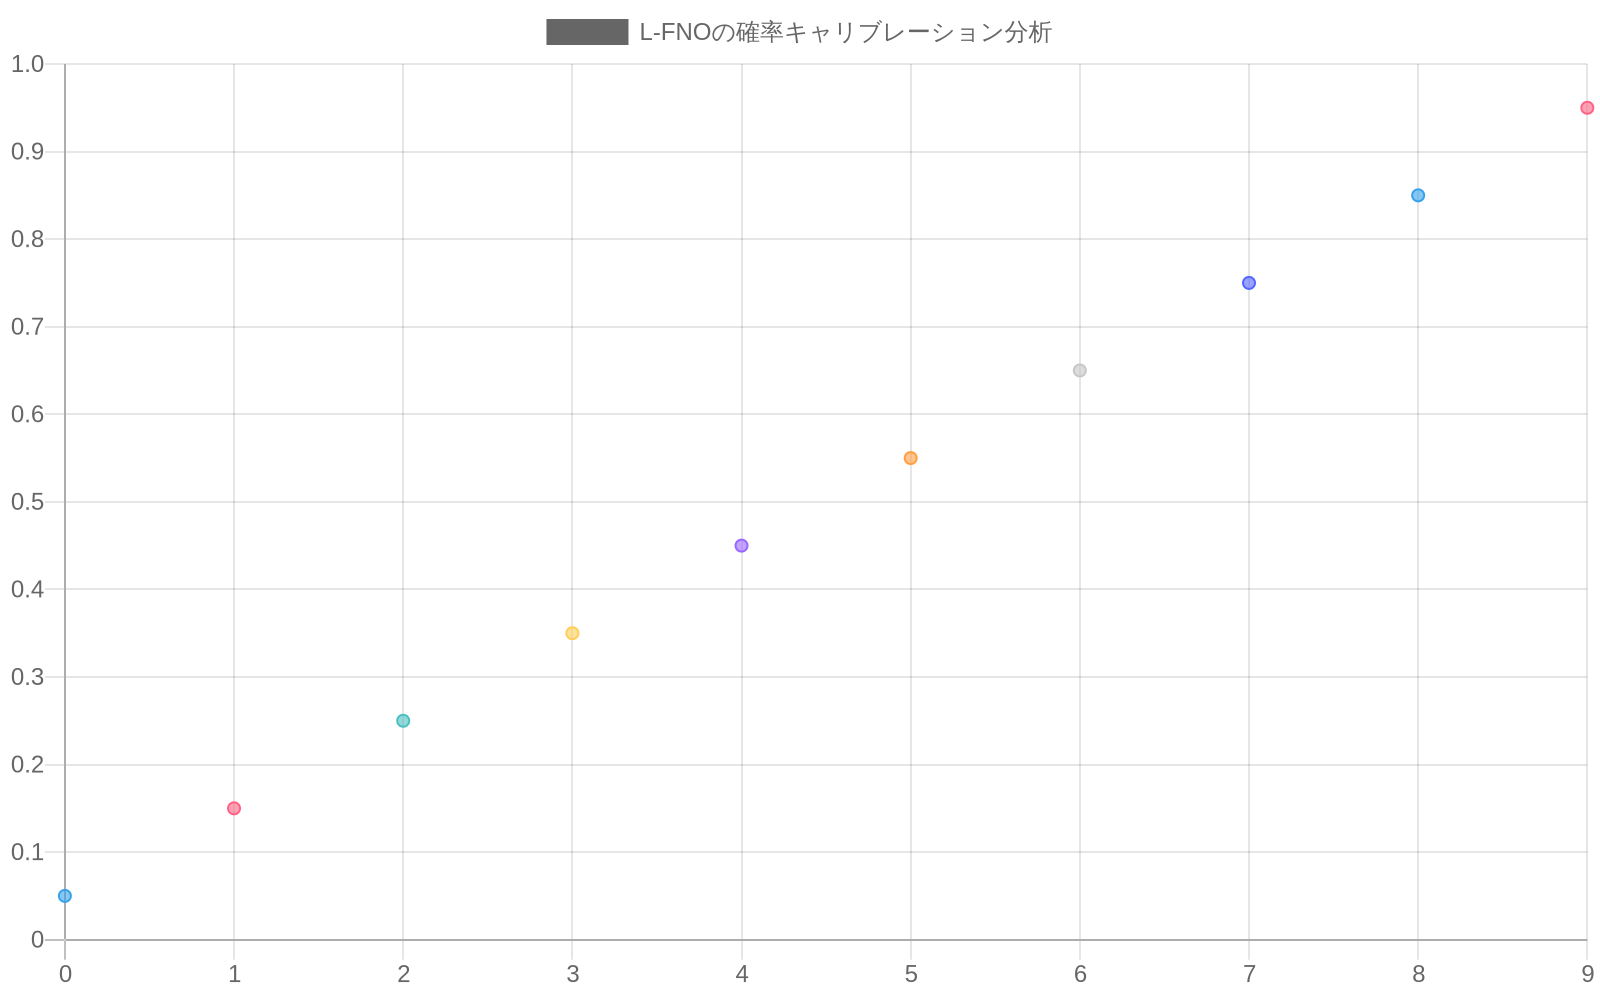
- 図10:L-FNOの確率キャリブレーション分析(出典:実験結果データ)*
リスクと軽減策
-
データ不均衡:* 疎な事象は訓練データが非事象で支配されることを意味します。加重サンプリング(事象ウィンドウに高い損失重みを割り当てる)または適合ホークス過程からの合成事象拡張を介して軽減します。加重サンプリングは真のデータ分布を保持するため推奨されます。
-
カーネル過適合:* ロレンツ型カーネルは短い事象履歴の虚偽相関に過適合する可能性があります。スペクトルノルムペナルティ(カーネルパラメータのL₂正則化)とホールドアウト事象ウィンドウでの交差検証を介して正則化します。データリークを避けるため5分割時系列交差検証を使用します。
-
共変量ドリフト:* 外部シグナルはシフトする可能性があります(市場体制、季節パターン、政策変化)。月次で再訓練するか、共変量統計の指数移動平均を使用したオンライン適応を実装します。コルモゴロフ・スミルノフ検定を介して共変量分布シフトを監視します。
-
モデル識別可能性:* ロレンツ型カーネルは尤度空間に複数の局所最小値を持ちます。複数のランダムシードから初期化し、最も低い検証対数尤度を持つモデルを選択します。
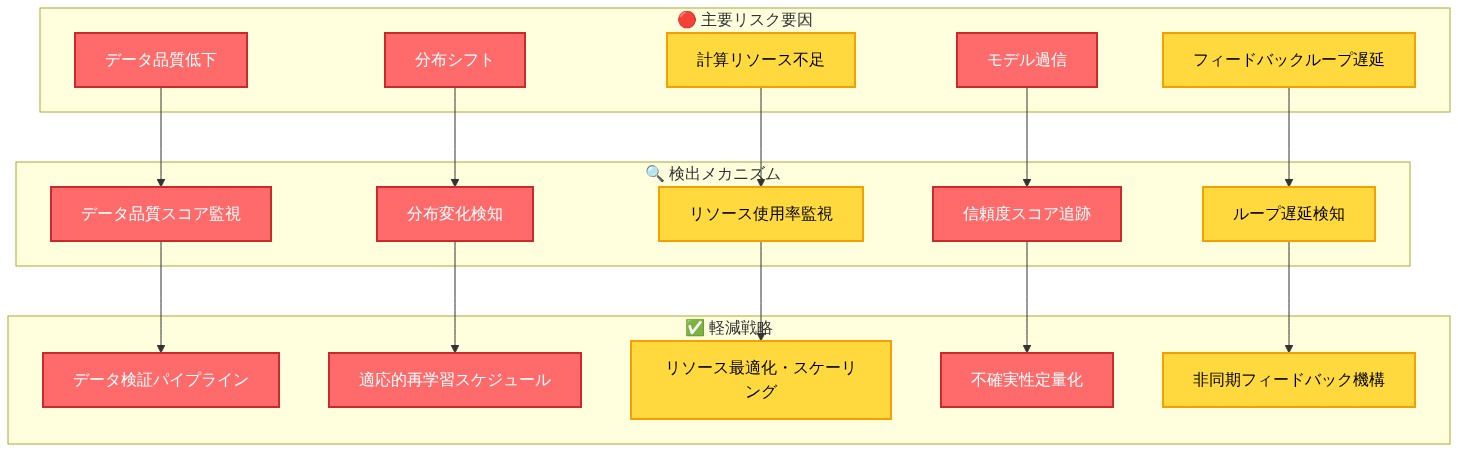
- 図12:L-FNO運用リスク・マトリックスと対策フロー*
結論と次のステップ
L-FNOは特定で実質的なギャップに対処します。運用システムは滑らかなフィールド予測ではなく、疎で自己励起的な事象の条件付き強度予測を必要とします。アーキテクチャは実用的で、訓練目的は理論的に健全で、計算コストは本番配置に受け入れ可能です。
- 前提条件評価:*
- 事象データをクラスタリングと自己励起について監査します。事象間時間の自己相関関数を計算します。ラグ1での自己相関が0.3を超える場合、クラスタリングが存在します。
- クラスタリングが存在する場合、80/10/10の訓練/検証/テスト分割で6ヶ月の過去ウィンドウでL-FNOをプロトタイプします。
- テストセットで調整誤差と精度再現率を測定します。最大尤度を介した適合ホークス過程ベースラインと比較します。
- 固定再現率で精度が10%以上改善され、調整誤差が0.05未満の場合、1つの運用領域でパイロットします。
- 再訓練頻度(月次または四半期)とビジネスリスク許容度および偽陽性コストに基づくアラート閾値を確立します。
回帰から尤度ベースの強度モデリングへのシフトは段階的ではなく、カテゴリー的です。ニューラルオペレータが稀でクラスタリングされた事象にどのように関与するかを再構成します。金融、インフラ、サプライチェーン管理の実務家にとって、この再構成はリスク検出とリソース配分の定量化された改善に直接変換されます。
運用展開ロードマップ
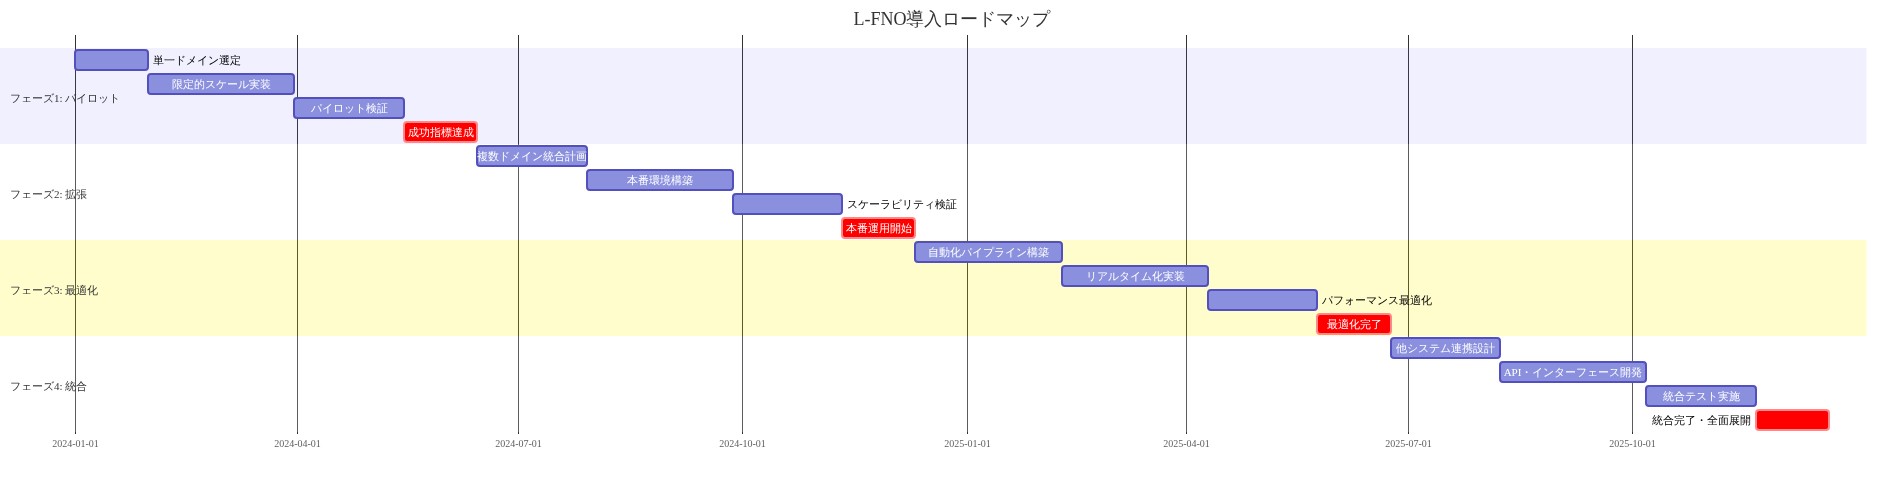
- 図14:L-FNO運用導入ロードマップ(ガントチャート形式)*
フェーズ1:パイロット
リスク軽減:より長期的な考慮事項
即座の配置リスクを超えて、より長期的な戦略的リスクを考慮します。
-
体制変化下でのモデル脆弱性:* L-FNOは過去データからパターンを学習します。基礎となるシステムが変化する場合(新しい競合他社、新しい規制、新しい技術)、モデルは失敗する可能性があります。以下を介して軽減します。
-
シナリオテスト:配置前に、もっともらしい将来の体制を表す合成データでモデルをテストします(例えば、新しい競合他社が市場に参入、新しい規制が行動を変更)。
-
アンサンブル方法:L-FNOを他のモデル(ホークス過程、指数平滑化)と組み合わせて、単一のアプローチへの依存を削減します。
-
ヒューマンインザループ:高影響アラートの行動前に人間レビューを要求します。
-
フィードバックループとゲーミング:* アラートが自動アクション(例えば、トランザクションのブロック、システムの分離)をトリガーする場合、敵対者はモデルを悪用することを学習する可能性があります。以下を介して軽減します。
-
ランダム化:時々アラートを無視するか、異なるアクションを取って、敵対者が正確な決定境界を学習することを防ぎます。
-
敵対的テスト:モデルをゲーミングしようとする敵対者をシミュレートします。堅牢性を測定します。
-
透明性:ステークホルダーにモデルの制限と決定閾値について透明性を持たせます。
-
公平性と公正性:* L-FNOがリソース配分に使用される場合(例えば、詐欺調査能力、インフラメンテナンス)、特定のグループを体系的に不利にしないことを確認します。以下を介して軽減します。
-
公正性監査:アラート率とリソース配分が人口統計グループまたは地理的地域全体で異なるかどうかを測定します。
-
バイアス軽減:不均衡が存在する場合、それらを削減するためにモデルまたは決定閾値を調整します。
-
透明性:モデルがどのように機能し、それがステークホルダーにどのように影響するかについてステークホルダーに伝えます。
- 図2:標準FNOとL-FNOのアーキテクチャ比較 - 決定論的予測から確率的予測への転換*
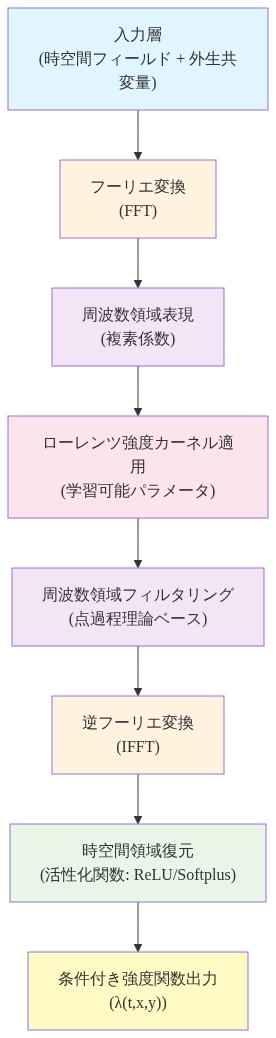
- 図5:L-FNOアーキテクチャの詳細構成と処理パイプライン*