言語と結びついた時系列モデルは、信号を言葉で説明できるように学習する。数値データにキャプション、ラベル、質問と答えのペアを組み合わせて学ぶので、その埋め込みは文章に近い位置に置かれる。
この結びつきは役に立つが、見落としが生まれやすい。文章による教師あり学習は、文章との一致を高く評価する。ある信号を別の信号と分けている細かな特徴を残したかどうかは、評価の対象にならない。
Lotus が提案する解決策が「予測による裏づけ(forecast grounding)」だ。
言語と結びついた表現を下流のタスクに合わせる前に、その表現が信号のこれからの動きを予測できる状態を保つよう求める。予測は、キャプションでは確かめられない点を確かめる検査になる。
この記事のポイント
- 言語による教師あり学習は、文章としてのまとまりを評価し、時間的な正確さは評価しない。
- 同じキャプションに合う信号は多く、文章だけでは動きを一つに絞れない。
- Lotus は事前学習に予測を加え、ラベル不要の自己教師あり学習で、動きが残っているかを確かめる。
言語との結びつきが、失われた動きを隠す理由
キャプションは、信号を数語に縮めてしまう。たとえば「急に上がって、そのあと横ばいになる」という表現を考えてみよう。この言い方は、非常に幅広い信号に当てはまる。
- 上昇にかかる時間が、数分の場合もあれば数か月の場合もある
- 横ばいの部分が、平らな場合も、ゆっくり動く場合も、ばらつく場合もある
- 上昇の仕方が、なめらかな場合も、階段状の場合も、荒れる場合もある
- そのパターンが、季節ごとに繰り返される場合も、一度しか起きない場合もある
こうした信号は、どれもこの先の振る舞いが違う。ところがキャプションから見れば、すべて同じに見える。
ここに、混同しやすい二つの性質のずれがある。
| 性質 | 意味 | 何が高く評価するか |
|---|---|---|
| 言語との一致 | 埋め込みが文章による説明と合っている | キャプション、ラベル、質問応答の目的関数 |
| 情報の保存 | 埋め込みが信号の実際の変化を保っている | 細かな動きに左右される目的関数 |
前者を高めても、後者が守られる保証はない。
学習データのキャプションにすべて合うモデルでも、同じ説明を持つ信号どうしを分ける情報を捨ててしまうことがある。 文章との一致を目指す目的関数は、その損失をとがめない。
その結果、言葉の上では流暢でも、動きの面ではうつろな表現ができあがる。信号をうまく説明できても、その信号がどこへ向かうかは符号化していないかもしれない。
このずれが特に響くのは、下流の仕事がラベルではなく動きに左右される場面だ。次のようなタスクが当てはまる。
- 異常の推論:ずれを見つけるには、正常な変化がどういうものかを知っている必要がある。
- 振る舞いによる分類:クラスによっては、キャプションでの書き分けではなく、ばらつきや局面の構造が違う。
- 時間に関する質問応答:この先どうなるか、パターンがなぜ変わったかを問う質問には、埋め込みに動きが入っていなければならない。
ここで中心の問いが浮かぶ。言語と結びついた埋め込みから、信号の変化を取り出せる状態を保つには、どんな追加の圧力が必要なのだろうか。
Lotus で予測による裏づけが働くしくみ
Lotus は、表現が時系列を本当に理解しているかを確かめる検査として、予測を使う。埋め込みには、過去の信号にキャプションを合わせるだけでなく、この先の値を言い当てることが求められる。
予測が裏づけとして働く理由は、具体的に三つある。
- ラベルがいらない。 将来の値は、すでにデータの中にある。学習は自己教師ありで進む。
- 大事な点をとらえられる。 うまく予測するには、傾向、季節性、ばらつき、局面の切り替わりを保つ必要がある。実際の意思決定を左右する動きだ。
- 客観的である。 予測は、実際に起きたことと合うか合わないかのどちらかだ。解釈の余地はない。
三つ目の点が、予測とキャプションによる教師あり学習の違いを生む。同じ信号を二人が違う言い方で説明しても、どちらも正しいことがある。
予測には、測れる誤差がある。この客観性が、頼れる拠りどころになる。
裏づけを後ではなく早い段階で行う理由
Lotus は、事前学習の段階で、言語との結びつけと並べて予測による裏づけを行う。順番が大事だ。
- テキストと将来の値の両方に同時に合うよう、表現を学習させる。
- 信号の動きと言語の両方に結びついた埋め込みをつくる。
- その埋め込みを、分類、質問応答、異常検知などの下流タスクに合わせて調整する。
裏づけを最後にだけ行うと、テキストだけで事前学習する段階で、時間に関する細部がすでに削り落とされているおそれがある。
あとから予測を加えても、モデルがそもそも保存しなかった情報は取り戻せない。早い段階で裏づけを行えば、下流のタスクは、動きがすでに保たれた表現を受け継げる。
一つの埋め込みに二つの制約
モデルは、二つの目的を同時に満たさなければならない。
- 言語との一致:信号と言葉を結びつける。
- 予測の正確さ:将来を左右する情報を保つ。
この二重の制約は意図的なものだ。もっともらしいキャプションを出しながら、時間に関する情報を捨てることを防ぐ。
埋め込みが動きを失えば予測が外れ、その誤差が学習の信号となって修正する。言語と予測は、同じ方向に引き合う。
予測の正確さは移せるのか、どこで届かないのか
筋道は単純だ。将来を予測するよう迫られた表現は、その将来を左右するものを符号化せざるをえない。同じ動きに左右されるタスクは、その符号化の恩恵を受けるはずだ。
実際の予測の現場も、この見方を支えている。サプライチェーンの移動時間の予測では、量の時間的な変化を保つモデルのほうが、保たないモデルより成績がよい。
日程、在庫、配送ルートの判断はどれも、静的なラベルではなく時間的な動きに左右されるからだ。Lotus は、この発想を一般的な事前学習の目的関数へと広げたものだ。
効果が大きい場面と、小さいかもしれない場面
このしくみから、どのタスクで効果が大きいかが推測できる。以下は仮説であり、測定された結果ではない。
| タスクの種類 | 信号の動きに左右されるか | 予測による裏づけの期待される効果 |
|---|---|---|
| 異常の推論 | 強く左右される | 大きい可能性が高い |
| 予測に近い性質についての質問応答 | 強く左右される | 大きい可能性が高い |
| 振る舞い(ばらつき、局面)による分類 | 中程度から強く左右される | 意味のある効果が出そう |
| 動きと無関係な意味的文脈による分類 | 弱く左右される | 小さいか、ほとんどないかもしれない |
ラベルが信号の外にある文脈に左右されるタスクでは、効果が薄れるかもしれない。分類が、信号の動きよりもメタデータや分野の知識に大きく頼っているなら、動きをうまく符号化しても役に立たない可能性がある。
しくみが本物かどうかを確かめる
ベンチマークの成績が上がっただけでは、しくみが働いている証明にはならない。学習の信号が増えたこと、実質的なデータが増えたこと、目的関数を足したことの別の副作用でも、成績は上がりうる。
より確かな検証は、狙いを絞った除去実験(アブレーション)だ。
- 予測による裏づけを入れてモデルを学習させる。
- それを除いた同じ構成のモデルを学習させる。
- 動きに強く左右されるタスクと、そうでないタスクの両方で、二つのモデルを評価する。
- 裏づけを外したとき、動きに左右されるタスクのほうがより大きく悪化するかを確かめる。
そうなれば、情報が本当に保たれていることの裏づけになる。どちらのタスクも同じだけ悪化するなら、その効果は動きに特有のものではなく、一般的なものかもしれない。
検証できる裏づけという、より広い流れ
予測による裏づけは、もっと大きな動きの中に位置づけられる。研究者たちは、言語モデルを、もっともらしいと評価されるだけの出力ではなく、確かめられる出力に結びつけようとする例を増やしている。
数学が分かりやすい例だ。数学の証明や反例も同じ原理に立っている。証明は成り立つか成り立たないかのどちらかだ。
確かめられることが、表面上の流暢さを超えて、モデルを正直に保つ。時系列では、予測がその役を担う。将来が実際に訪れ、予測に点数をつける。
この記事のポイント
- 裏づけは、流暢に聞こえる文章だけに頼らず、言語モデルを外から確かめられる出力に結びつける。
- 効果的な裏づけは、モデルの外にあり、パターン照合ではごまかしにくく、危うい情報に敏感に反応する。
- 予測による裏づけは三つの条件をすべて満たすが、言語との一致と予測精度のバランスは、設計で決める事柄として残る。
形式化における意味の修正についての研究は、近い危険を扱っている。形式的な翻訳が正しく見えても、気づかないうちに元の問題の意図を変えてしまうことがある。
Lotus が向き合うのは、その時系列版のリスクだ。表現は言語とよく合っているように見えて、信号の動きを捨てている可能性がある。
| 領域 | 表面的な確認 | 隠れた失敗 | 確かめられる拠りどころ |
|---|---|---|---|
| 数学的な推論 | 議論が説得力をもって読める | 証明が実際には成り立たない | 証明の検証、反例 |
| 形式化 | 翻訳が整って見える | 問題の意図が変わってしまう | 意味の修正 |
| 時系列の言語モデル | 埋め込みがキャプションと合う | 信号の動きが失われる | 将来の値の予測 |
効果的な裏づけの条件
これらの例を比べると、役に立つ裏づけの信号には三つの性質があるとわかる。
- 表現の外にある:モデルの出力どうしが矛盾しないかを見るだけではなく、モデルの内部の整合性の外にあるものと照らし合わせる。
- パターン照合では満たしにくい:流暢な出力だけでは通らない。ごまかしがききにくい信号だ。
- 危うい情報に敏感である:失われてはいけない情報が欠けたとき、まさにそこで失敗する。
予測による裏づけは、この三つをすべて満たす。将来は、モデルの学習データの外にある。
傾向についてもっともらしい言葉を並べても、よい予測のふりはできない。また、予測が頼りにする動きが埋め込みから抜け落ちれば、精度が下がる。
二つの目的のバランス
言語との一致と予測精度という二つの目的は、反対方向に引き合うことがある。流暢な説明を出せるのに予測が悪くなることもあれば、その逆もありうる。
Lotus が学習中に二つをどう組み合わせるのか、与えられた資料には書かれていない。
複数の目的を扱う事前学習でよくあるのは同時学習で、二つの損失を重みづけして足し、同じ勾配に流す方法だ。Lotus がこの方式なら、両者が衝突したとき、どちらが勝つかは重みで決まる。
| 重みのかけ方 | 考えられる影響 |
|---|---|
| 言語との一致を重くする | 予測が弱い制約にとどまり、動きの劣化が進む可能性がある |
| 予測を重くする | 時間的な正確さは強まるが、言語としてのまとまりが損なわれるかもしれない |
| 均等にする | 両方が保たれるが、ちょうどよい配分は用途で変わりうる |
最適なバランスは、下流のタスクの構成で決まりそうだ。ほとんどの用途が時間に関する推論を必要とするなら、予測に重みを置くほうがよい。
タスクが多様なら、より均等な配分が理にかなう。これは設計上の選択であり、解決済みの問題ではない。選んだ配分は明示し、理由も述べておくべきだ。
頑健さをめぐる未解決の問い
予測による裏づけが頑健な原理なのか、特定のタスクにだけ効く工夫なのかは、次のような問いで見えてくる。
- 予測の期間で、学ばれる内容は変わるのか。 短い期間では、埋め込みが局所的な動きに偏り、長い範囲の構造を見落とすかもしれない。複数の期間で裏づけを比べれば確かめられる。
- 事前学習に使う信号の多様さは、どれだけ効くのか。 信号の種類が少ないと、埋め込みがもろくなり、新しい分野で通用しないかもしれない。事前学習に含まれない分野での評価が答えになる。
- 成績の向上は、本当に情報が保たれた結果なのか。 ベンチマークでの向上は、偶然のものかもしれない。時間に敏感なタスクとラベルだけのタスクを比べる除去実験で、しくみが本物かどうかがわかる。
- 効果は大きな規模でも続くのか。 規模を大きくするだけで、結びつけのずれが埋まるかもしれない。モデルの大きさを変えて比較を繰り返せば、はっきりする。
これらの答えは、この主張を補強することも、複雑にすることもありうる。原理には説得力がある。ただし、その適用範囲と頑健さは、まだ決着していない。
こうしたモデルをつくる人、評価する人へ
- 埋め込みを予測で調べる。 言語と結びついた表現から、将来の信号の値をまだ予測できるかを確かめる。できないなら、テキストとの一致だけではずれが隠れている。
- 裏づけは後ではなく早く行う。 予測の目的関数を加えるなら事前学習に入れ、下流の調整が、動きに結びついた埋め込みを受け継げるようにする。
- 損失の重みを明示する。 言語と予測の目的をどう釣り合わせたかを記録し、想定するタスクと結びつけて選ぶ。
- 分割した除去実験を行う。 しくみの手柄とする前に、裏づけありとなしのモデルを、時間に敏感なタスクとラベルだけのタスクで比べる。
- 期間と分野を変える。 複数の予測期間と、見たことのない信号の分野で試し、効果が一般化するかを調べる。
ちょっと立ち止まって
よい説明が、そのまま本当の理解になるとは限らない。キャプションは正確でも、いちばん大事なことが抜け落ちていることがある。
予測による裏づけは、モデルに素朴な問いを投げかける。この先どうなるか、言えるだろうか。その答えを、将来は偏りなく返してくれる。
あなたが頼っている仕組みを思い浮かべてみてほしい。実際に起きることと照らし合わせて確かめられるよりも、もっともらしく聞こえることのほうが評価されている場面はないだろうか。
図3:言語アライメントと情報保存のトレードオフ(出典:記事の概念図)
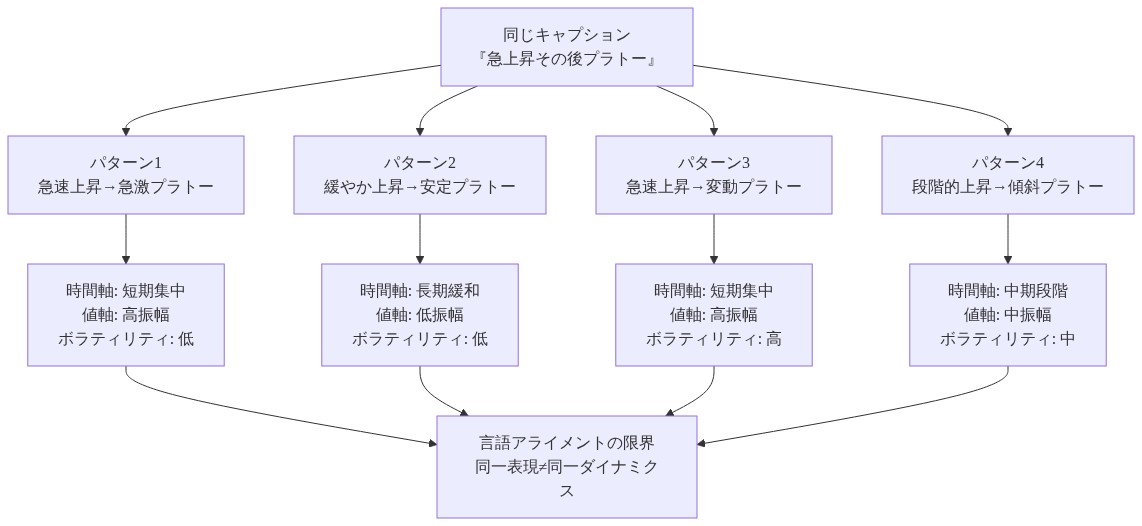
図2:同一キャプションに対応する異なる信号パターン—言語アライメントの限界を示す比較図
図14:時系列モデルの進化と改善(記事の文脈に基づく進化パターン)
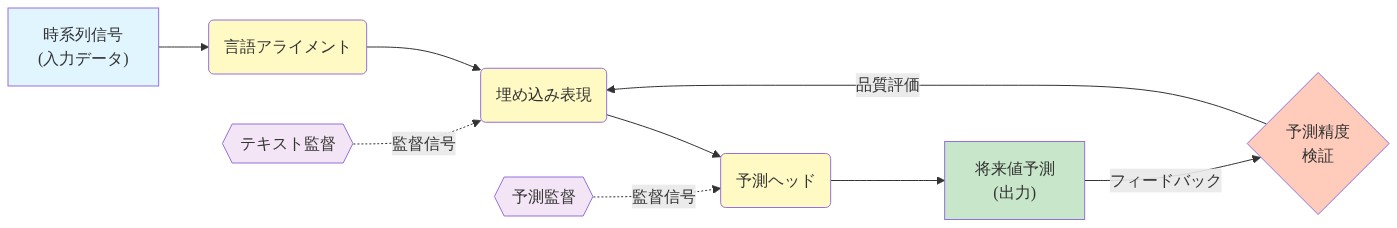
図5:Lotusの予測グラウンディングアーキテクチャ
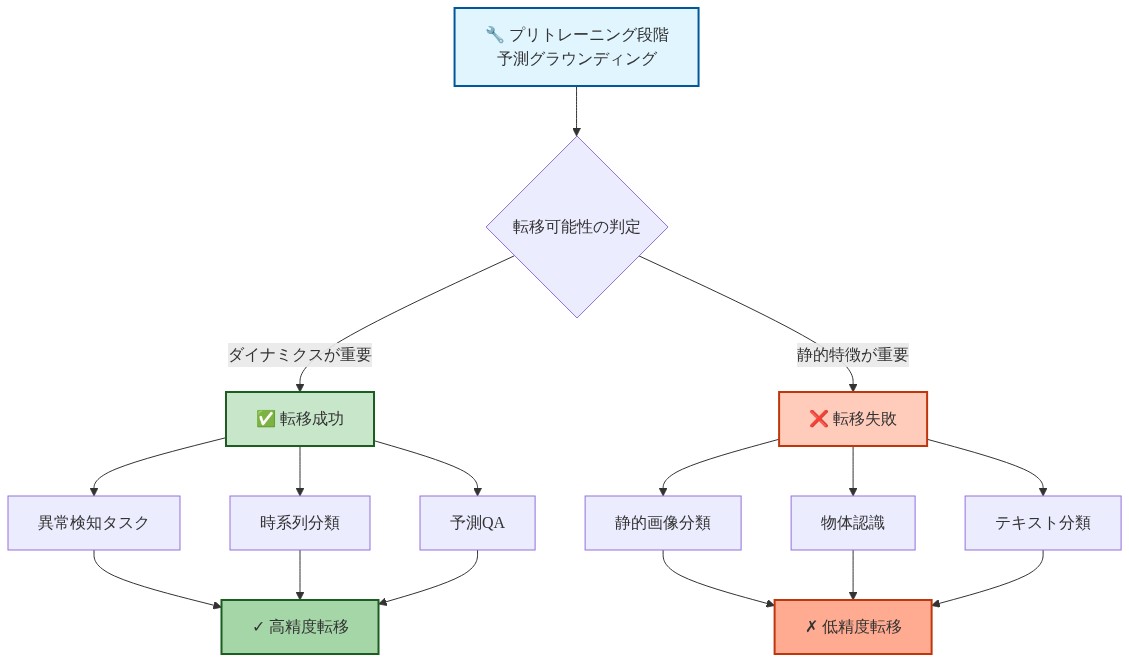
図8:予測忠実度の転移パターン - ダイナミクス依存性による成功・失敗の分岐
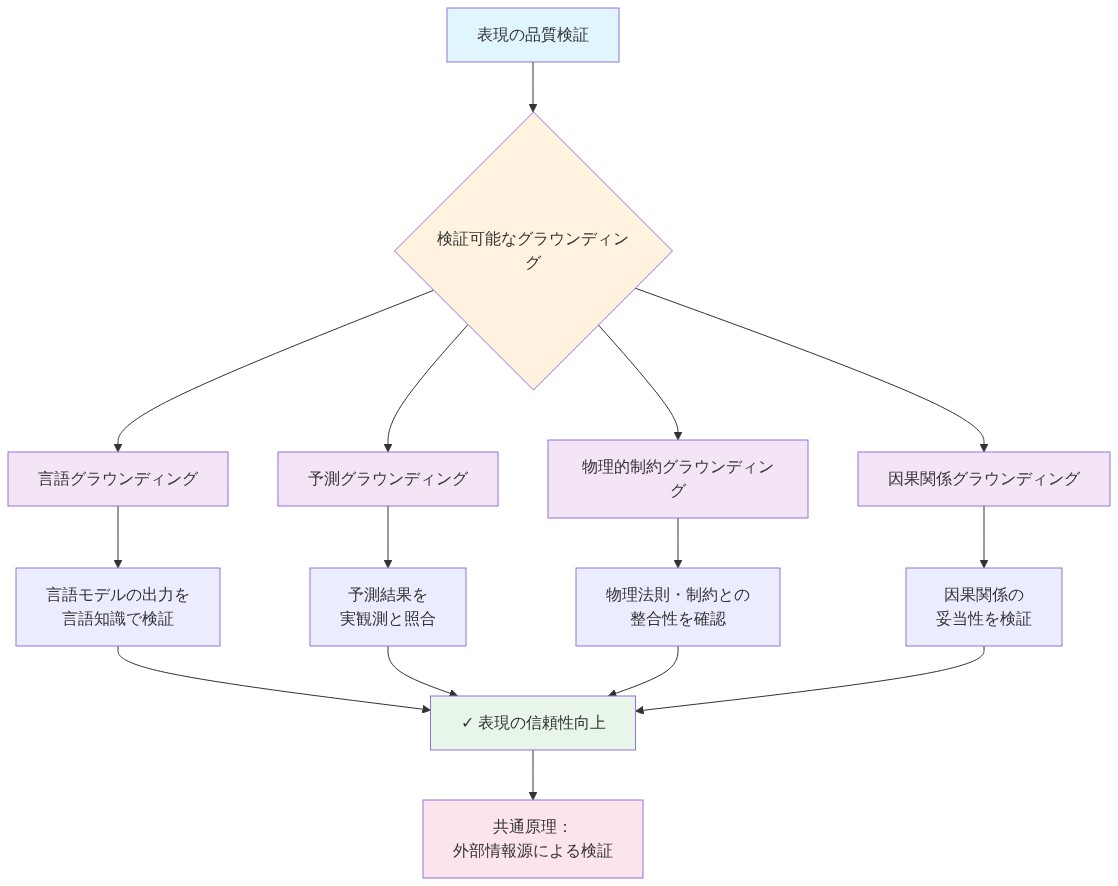
図11:検証可能なグラウンディングの一般的パターン