荷物が遅れて届けば、生産ラインが止まる。早く着きすぎれば、倉庫があふれて保管費がかさむ。到着時間の予測は、見た目は予報の仕事だ。
だが実際には、いくつもの現場の判断を左右している。しかも小さな誤差は、判断を重ねるたびに大きくなっていく。
この記事のポイント
- 予測の誤差は、ひとつの判断で終わらない。連なった判断の全体に広がる。かたよった見積もりは、荷受けの段取り、在庫の置き場所、運送会社の選び方に同時に響く。
- 精度だけでは、予測の良し悪しは測れない。平均を当てることと同じくらい、確率の見積もりが現実に合っているか、結果が安定しているか、不確かさを正直に示しているかが大切だ。
- サプライチェーンの対象ごとに、合うモデルは違う。ドアからドアまでの輸送、港での滞留、ラストマイルの配送では、許される誤差もデータの条件も異なる。
外したときのコスト
誤差のコストは、早い側と遅い側で同じではない。生産の時間枠に間に合わない損失は、早く着いて待つ損失より大きいことが多い。
平均誤差を最小にするように学習したモデルは、2時間早い到着と2時間遅い到着を同じ重さで扱う。ところが現場では、この2つの重みは違う。平均では正確なモデルでも、実際の判断には合わないことがあるのだ。
小さくても一定のかたよりは、小さいままでは終わらない。その見積もりを使うすべての判断に広がっていく。
- 遅れて到着する場合:生産ラインが止まる。急ぎの輸送に切り替えることにもなる。
- 早く到着しすぎる場合:ヤードが混み合い、保管料がかかる。
どちらも高くつく。ただし、金額が同じになることはまずない。
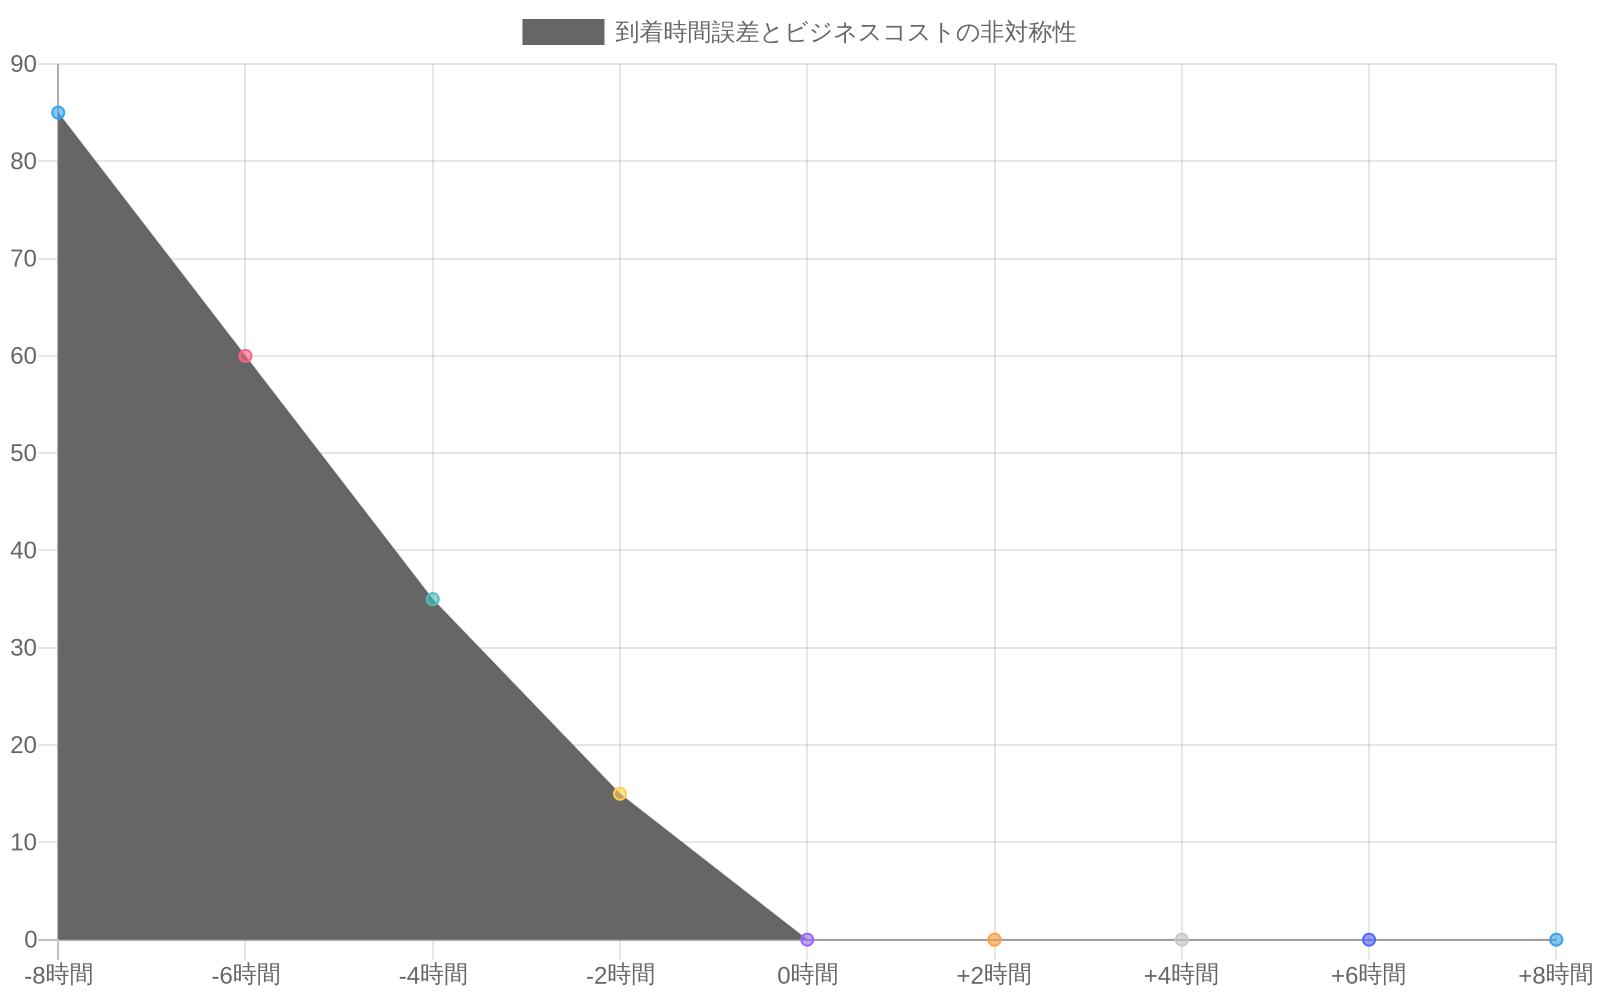
図3:到着時間誤差のコスト非対称性(出典:サプライチェーン管理の一般的なコスト構造)
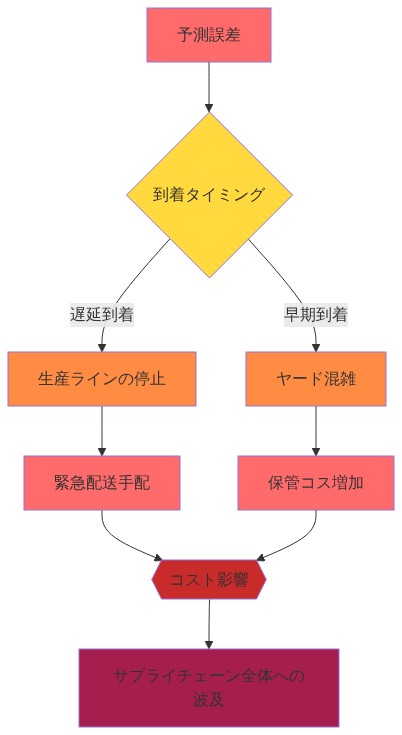
図2:輸送時間予測誤差のコスト影響カスケード
対象ごとに求められるもの
主な予測対象は、受け止められる誤差の大きさも違う。
次の表は、3つの予測対象を比べたものだ。
| 予測の対象 | 典型的なばらつき | 許される誤差 | 難しいところ |
|---|---|---|---|
| 確立した経路のドアからドアまでの輸送 | 中程度 | 幅が広くてもよい。担当者が余裕を足せる | 季節や運送会社が変わっても見積もりをそろえること |
| 港での滞留時間 | 大きい。混雑に左右される | 小さい。12時間の見積もりが数日外れることもある | 混雑や混乱の動き方 |
| ラストマイルの配送時間帯 | 狭い。業務上きわめて重要 | とても小さい | 密集した都市部での細かな時刻 |
対象ごとに、必要なモデルの高度さも、データの深さも違う。ひとつの問題として扱うと、どれにも合わないモデルができやすい。

表1:予測対象別の要件と課題
データの問題:入手元と気づきにくい失敗
実際の到着時間モデルは、アルゴリズムの選び方より、データの質のほうに足を引っ張られる。入力は多くの場所から集まり、それぞれに欠けがある。
この節のポイント
- 予測する時点では存在しない特徴量が混ざると(データリーク)、テストの点数がふくらむ。本番で失敗する原因になる。
- サンプリングが不規則だったり、まれな経路でイベントが抜けていたりすると、データが薄い場所ではモデルが信頼できなくなる。
- アルゴリズムを凝ったものにするより、現場の知識と特徴量の設計のほうが効くことが多い。
代表的な入手元は次のとおりだ。
- トラックやコンテナのGPS軌跡
- 船舶のAIS信号
- 運送会社や貨物取扱業者(フォワーダー)の貨物イベントログ
- 公表されている運航スケジュール
- 気象データ
- 港の混雑指標
どれにも癖があり、学習したモデルをつまずかせる。
時間のリーク:まだ存在しない特徴量
予測を出す時点では分からないはずの特徴量が、学習データにまぎれ込むことがある。たとえば、到着当日の港の実際の混雑だ。貨物が動いてはじめて見えてくる、運送会社の実績もそうだ。
こうしたリークは見落としやすい。履歴ログに入っていて、ほかの列と見分けがつかないからだ。モデルはオフラインでは高得点を出す。
ところが本番では、その値がまだ存在しないため、成績が落ちる。
不規則なサンプリングと抜けたイベント
GPSの記録は、トンネルや密集した市街地で途切れる。運送会社の状況更新は手入力が多く、取引先ごとに書き方が違う。国境の通過時刻が、分単位ではなく日単位でしか報告されないこともある。
利用の少ない経路は、データがほとんどない。全体をまとめて学習したモデルは、総合成績が良く見えても、新しい経路やめったに使わない経路では外すことがある。
モデルの選択より特徴量の設計が効くことが多い
予測の手がかりの多くは、空間と時間の文脈に含まれている。役に立つ特徴量には、次のようなものがある。
- 経路の区間分け(海上区間、港での荷役、内陸の短距離輸送)
- 時間帯の表し方
- 曜日ごとの傾向
- 経路ごとの過去の集計値
こうした特徴量は、生のGPS座標や運送会社の識別子より、予測に役立つことが多い。
本当のボトルネックは、現場の知識と丁寧な前処理であることが多い。 モデルの構造が足かせになることはあまりない。
リークのあるデータや区間分けの甘いデータで学習すると、どんなに高度なモデルでも、間違った教訓を覚えてしまう。
モデルの選び方:勾配ブースティングから系列モデルまで
表形式の特徴量を使う決定木のアンサンブルは、経路ごとの見積もりでは今も強い基準になる。XGBoostやLightGBMのような勾配ブースティングのライブラリは、データが少なく、解釈のしやすさが必要な場面でよく働く。
欠損値をうまく扱え、ハイパーパラメータの調整もあまり要らない。学習も速いので、頻繁な再学習が安く済む。
限界が出るのは、貨物がいま実際にどう動いているかで予測が変わる場面だ。
輸送中の再推定とは、貨物の進み具合に合わせて到着時刻を更新することをいう。これには、ここまでの経路を踏まえて見積もれるモデルが向いている。
LSTMのようなリカレントネットワークや、注意機構を使う構造は、軌跡を一続きの系列として読める。新しい位置やイベントが届くたびに、見積もりを調整できる。
異なる種類の入力が混ざる問題もある。専門家混合(mixture-of-experts)を備えたマルチモーダルなトランスフォーマーは、入力の種類ごとに専用の部分へ振り分ける。この方法は船舶の軌跡予測で試されている。
貨物輸送にも似た構造がある。海上区間、港での荷役、内陸の短距離輸送は、それぞれ動き方の違う別の領域のようなものだ。
領域ごとに専用の経路へ振り分けることを学べるモデルなら、手作業で区間を分けなくても、領域ごとのパターンをつかめるかもしれない。この利点が出やすいのは、各領域の専門家を訓練できるだけのデータがあるときだ。
次の表は、解きたい問題ごとに向いている方法をまとめたものだ。
| 場面 | 向いている方法 | 理由 |
|---|---|---|
| 経路ごとの見積もり、安定した経路、特徴量が少ない | 勾配ブースティング(XGBoost、LightGBM) | 小さな表形式データで精度が高い。速くて解釈しやすい |
| 軌跡データを使った輸送中の再推定 | RNNまたはLSTM | ここまでの経路を踏まえて見積もれる |
| 異なる領域にまたがる複数種類の入力 | 専門家混合のトランスフォーマー | 領域ごとに専用の部分へ振り分ける |
| 解釈のしやすさが最優先 | 線形モデルや単一の決定木 | すべての予測をたどって説明できる |
深い構造ほど表現力は高い。その代わり、データがたくさん必要になり、学習に時間がかかり、中身も調べにくい。
両者を組み合わせた設計のほうが、どちらか一方より強いことも多い。出発前は、ブースティング木で基準になる見積もりを出す。貨物が動き出したら、系列モデルでそれを磨き直す。
点ではなく分布を予測する
到着時刻をひとつだけ示すのは、不完全な答えだ。担当者が知りたいのは、「いつ着くか」より、「自分の時間枠に間に合わない確率はどれくらいか」であることが多い。それに答えるには、点ではなく分布が必要になる。
この節のポイント
- 標準的な回帰は、典型的なケースに合わせて最適化されるため、まれな大遅延のリスクを小さく見積もる。
- 分位点回帰や共形予測を使うと、担当者が自分のリスク許容度に合わせて余裕を決められる。
- 区間の質は、2つの別々の性質で決まる。ひとつは較正で、90%区間が本当に90%の確率で真の値を含むかどうか。もうひとつは鋭さで、区間がどれだけ狭いかだ。
実際の被覆率に見合った区間を出す方法はいくつかある。
- 分位点回帰:特定のパーセンタイルを直接予測するようにモデルを訓練する。
- 共形予測:既存のモデルを包み込み、取り分けておいたデータで区間を較正する。
- 混合密度ネットワーク:確率分布の全体を出力する。複数の起こりうる結果を表せる。
標準的な回帰が遅延に弱い理由
貨物の遅延の分布は、裾が重い。ストライキ、嵐、通関での留め置きなどが、まれだが非常に大きな遅延を生む。こうした出来事は、平均二乗誤差で学習する前提を崩す。
標準的な回帰は、見積もりを典型的なケースへ引き寄せるので、裾のリスクを小さく見積もってしまう。
ライン停止のコストが大きい工場は、最悪の場合を知る必要がある。ヤードに余裕のある倉庫なら、もっと不確かさを許せる。どちらも、点の見積もりだけに頼ることはできない。
分位点回帰で遅れの形を描く
いくつかの水準で分位点回帰を行うと、分布の形が見えてくる。よく使うのは、5、50、95パーセンタイルだ。担当者は、自分のリスク許容度に合わせて余裕を決められる。
ライン停止のコストが大きい工場なら、95パーセンタイルに合わせて計画するかもしれない。
ヤードに余裕のある倉庫なら、中央値に近い値で計画するかもしれない。1つの平均値の代わりに複数のパーセンタイルを示せば、同じモデルで両方を支えられる。
較正と鋭さ:別々の2つの問題
区間の質には2つの側面があり、どちらも確認が必要だ。
| 性質 | 答える問い | 失敗の形 |
|---|---|---|
| 較正 | 90%区間は、本当に約90%の確率で真の値を含むか | 自信ありげな区間なのに、外れる回数が多すぎる |
| 鋭さ | 区間はどれくらい狭いか | 区間が広すぎて、判断の役に立たない |
鋭くても、較正がずれていることはある。狭くて自信満々の区間なのに、よく外れる。区間がないよりも悪いと言えるかもしれない。
ここで共形予測が魅力的なのは、元のモデルの較正が甘くても、被覆率が保証されるからだ。
ただし条件がある。較正に使うデータが、予測時の状況と似ていなければならない。過去に例のない混乱の最中には、この保証が弱まるおそれがある。
不確かさを余裕の決め方に変える
不確かさの見積もりは、そのまま余裕の取り方に変えられる。たとえば、モデルが95%区間として48〜72時間を示したとしよう。
担当者は、72時間の時点に合わせて荷受けの設備を押さえ、支障が出るおおよその確率も把握できる。誤差の幅が分からない点の見積もりでは、こうした判断はできない。
評価し、運用し、信頼を得る
評価は、モデルが実際に動く条件を反映させる必要がある。精度は大事だが、それだけでは足りない。
多くの物流事業者は、使える計算資源が限られている。そのうえで、大量の貨物の見積もりを最新に保たなければならない。精度がわずかに高くても、遅すぎたり高くつきすぎたりするモデルは、かえって悪い選択になる。
予算別の評価では、計算とデータの予算を固定して、候補のモデルを比べる。生の精度だけでは比べない。
たとえば、大きなモデルの95%の精度に届く小さなモデルがあるとする。それが10倍速く、メモリも10分の1で済むこともある。精度だけで大きなモデルより下に置けば、現場が本当に必要としていることを見落とす。
実用的な評価では、次の点を確かめたい。
- 時間で区切った学習・テスト分割:時間のリークを排除する。
- 経路ごとの層別の報告:まれな経路での弱さを明らかにする。
- 混乱期でのストレステスト:ストライキ、悪天候、混雑の急増などを対象にする。
- ピーク時の推論の遅延:モデルが十分な速さで動くかを確認する。
- 再学習の頻度とコスト:更新を続けるための予算を見込む。
- 特徴量が欠けたときの頑健さ:現実のデータの穴に対応できるかを見る。
モデルは、運用を始めたあとに劣化する。概念ドリフトは、いくつもの原因から生じる。
- 新しい経路やレーン
- ターミナルの拡張や国境での新しい手続きといったインフラの変化
- 季節ごとの繁忙期
- ネットワークの動き方を変える突発的な衝撃
ドリフトを見つけるには、継続的な監視と、再学習を始める明確な条件が必要だ。決まった日程で更新するだけでは足りない。
直近の貨物の誤差率を、とくに経路別に分けて見ると、モデルがずれ始めた最初の兆しがつかめることが多い。
データの共有があれば、こうした問題の多くが楽になりうる。荷主、運送会社、フォワーダー、港は、それぞれ全体の一部しか見ていない。商業上の機密があるため、共有できる範囲には限りがある。
連合学習(federated learning)のようなプライバシーを守る仕組みを使えば、生の記録を見せ合わなくても、各社がまとめた信号で学習できるかもしれない。実際にうまくいくかどうかは、技術だけでなく、ルールづくりと各社の動機づけにも左右される。
導入できるかどうかは、最終的には信頼で決まる。担当者は、予測に疑問を投げかけ、不確かさを理解し、修正を返せなければならない。
なぜその見積もりが出たのかを現場が説明できないブラックボックスのモデルは、どれだけ正確でも受け入れられない。目指すのは、単独で最も正確なモデルではない。現場の文脈で最も役に立つモデルだ。
到着時間の予測を自分で作る場合も、買う場合も、ここまでの議論から5つの手順が導ける。
- ベンチマークを信じる前に、時間のリークを点検する。 すべての特徴量が、予測する時点で実際に手に入るかを確かめる。
- まず、よく設計した勾配ブースティングを基準にする。 輸送中の再推定が明らかに必要な場面にだけ、系列モデルを足す。
- 点の見積もりだけでなく、区間も出す。 較正と鋭さを別々に報告し、判断ごとのリスク許容度に余裕を結びつける。
- 予測と最適化は、別々だがつながった部品として保つ。 経路選択や荷まとめのソルバーには、1つの数字ではなく分布を渡す。
- 経路別に性能を監視し、混乱期でストレステストをする。 ドリフトが出たら再学習し、担当者が見積もりに疑問を出して直せるようにしておく。
ちょっと立ち止まって
最後に「予定どおり」に着いたのに、なぜか困ったことが起きた荷物を思い出してみてほしい。荷受けの時間より早すぎたのかもしれない。
あるいは、シフトを乱す程度にだけ遅れたのかもしれない。画面の数字は近かった。その数字をもとにした判断は、そうではなかった。
この話が揺さぶるのは、予測された到着時刻がひとつあれば計画を立てられる、という思い込みだ。機械学習のモデルが出すのは点の見積もり、つまり1つの数字だ。
だが、その数字には見えない不確かさがついている。午後2時という予測は、「おそらく1時45分から2時15分の間」という意味かもしれない。
「正午から4時までのどこか」という意味かもしれない。モデルは、どちらなのかを教えてくれない。現場が推測するしかない。
「いつ着くか」と尋ねるたびに、「どれくらい確かか」も尋ねたら、何が変わるだろうか。
荷受けの人員配置は変わるだろうか。在庫の余裕の持ち方は変わるだろうか。顧客への約束の仕方も変わるのではないだろうか。
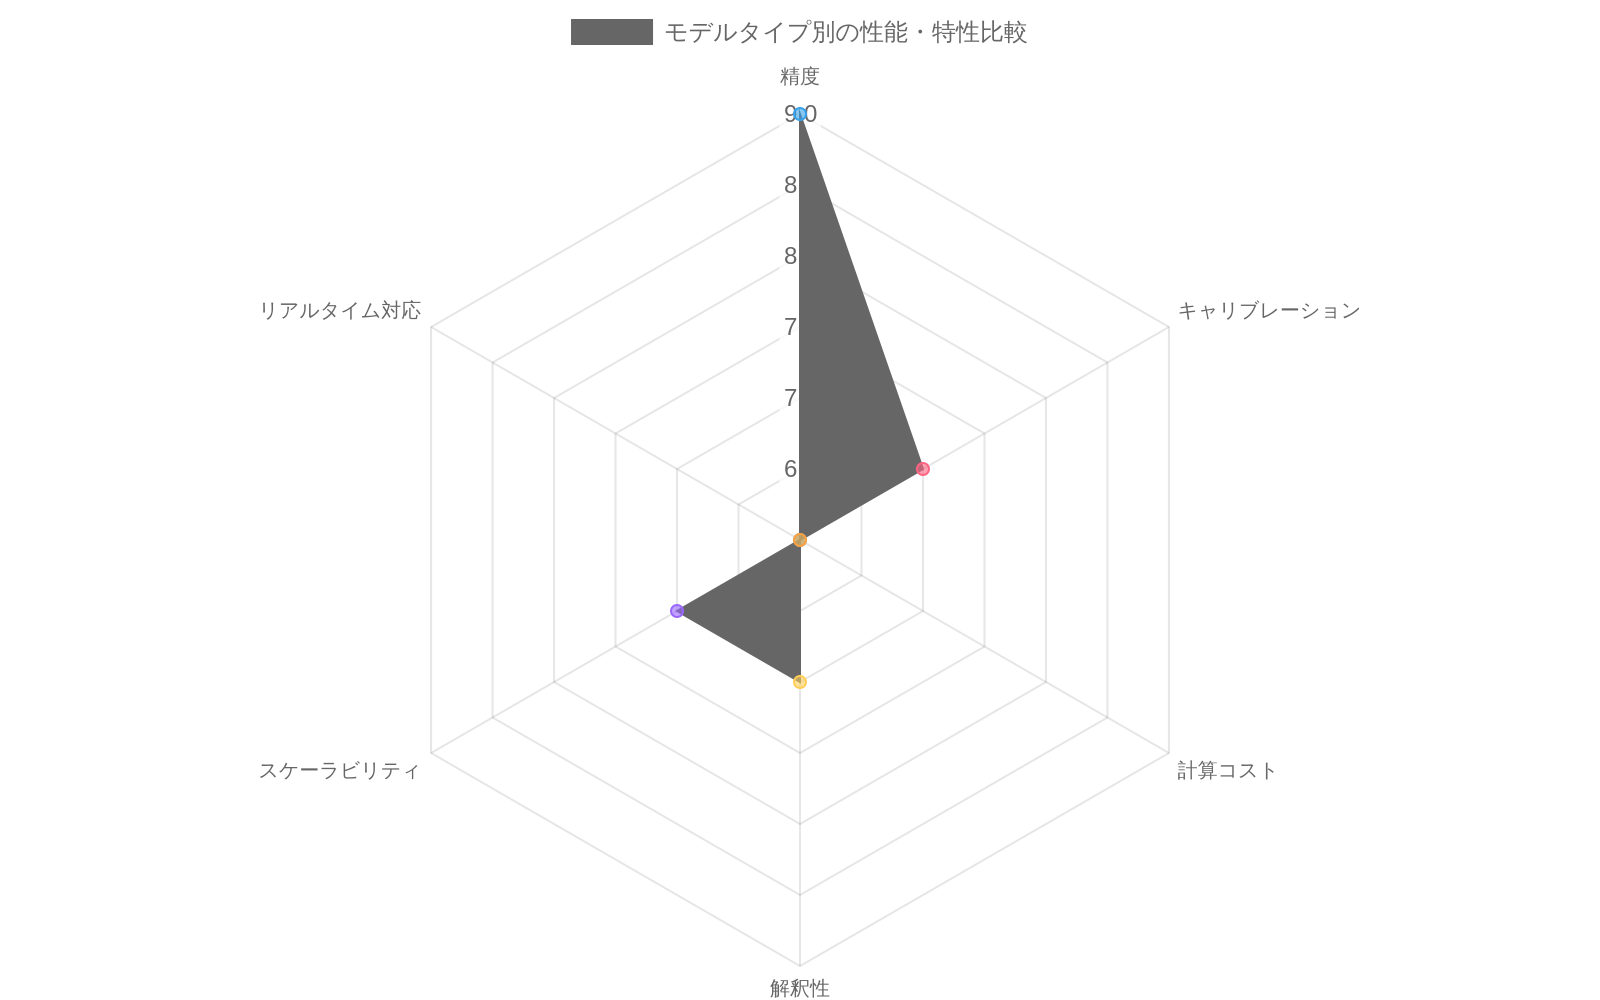
図8:モデルタイプ別の性能・特性比較(出典:機械学習ベストプラクティス)
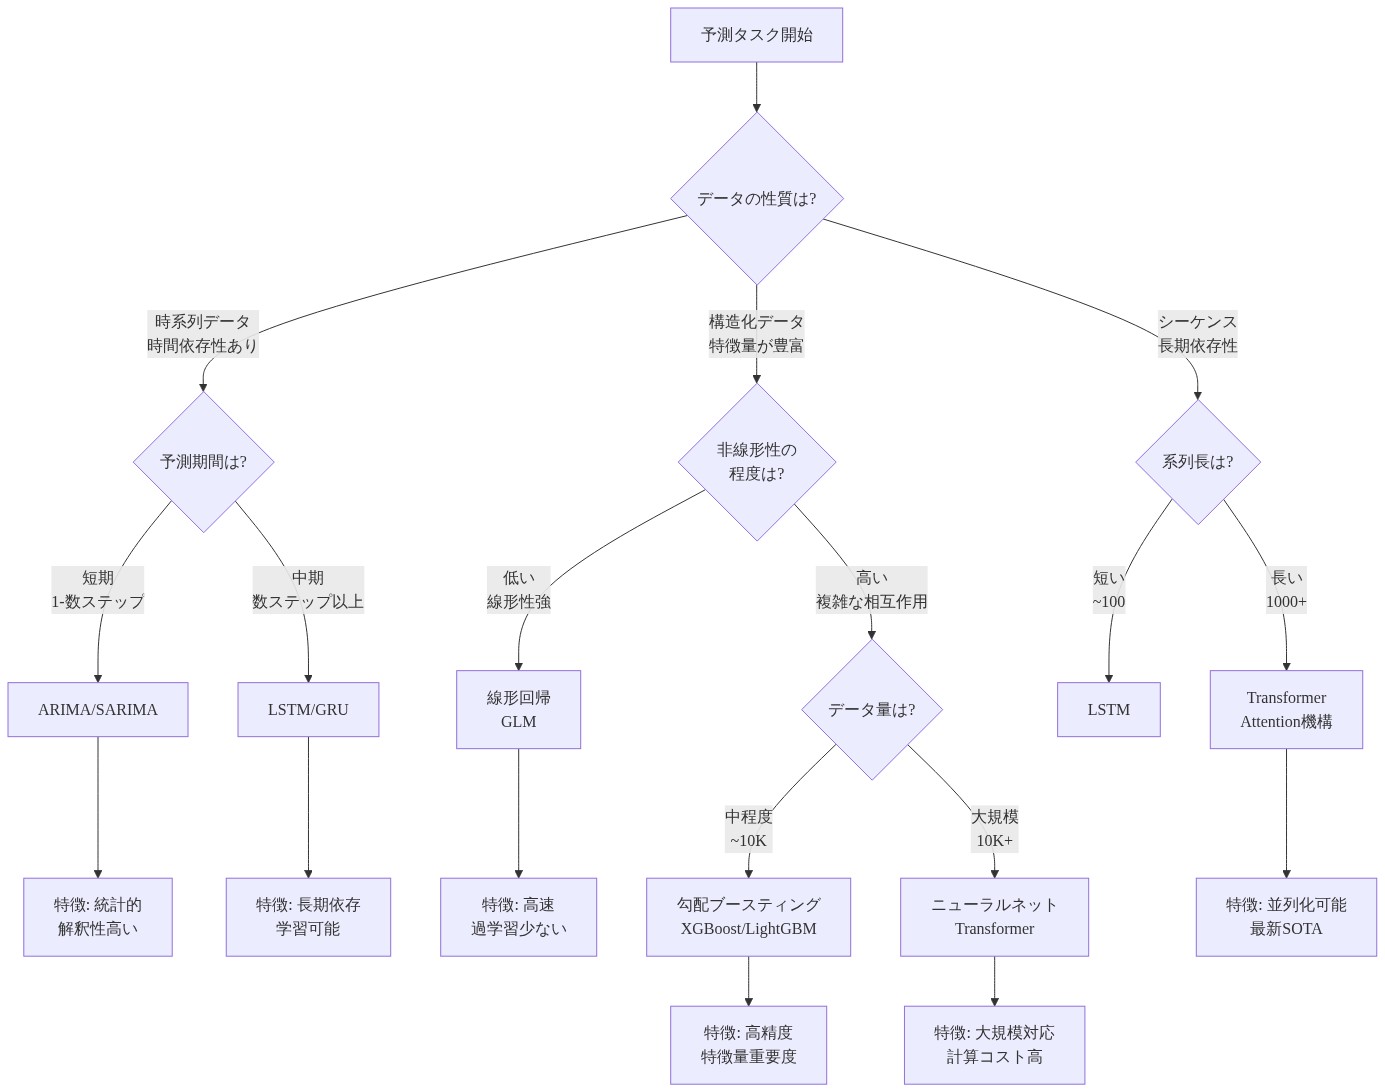
図7:予測対象別のモデル選択フロー(勾配ブースティング・時系列・シーケンスモデルの比較デシジョンツリー)
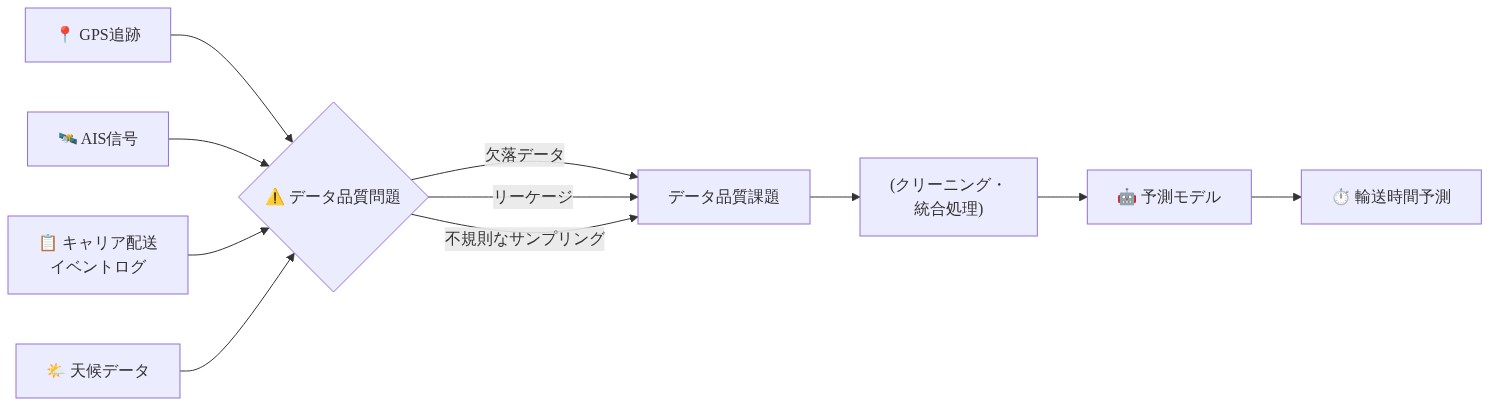
図5:輸送時間予測のデータソースと品質課題のフロー
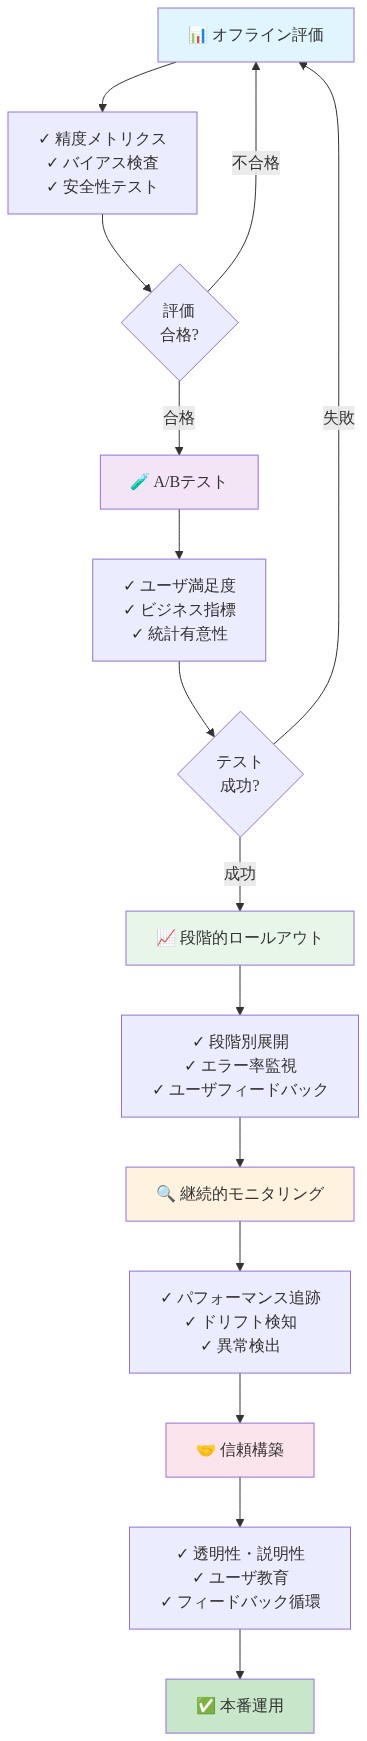
図11:モデルデプロイと信頼構築のプロセスフロー(MLOpsベストプラクティス)