700本のプレプリントに何が入っているのか
OpenAIは、約700本のプレプリントを公開リポジトリに載せた。
どの論文も、証明と反例を組み合わせた形で書かれていて、要旨、導入、主な結果、証明という標準的な構成に沿って整えられている。 機械が出力した生のデータではなく、仕上げられた文書だ。
対象は組合せ論、整数論、幾何学、解析学など、複数の分野にまたがる。
目を引くのは、証明と並んで反例が入っていることだ。反例とは、予想が間違っていると示す具体的なもののことで、特定の数やグラフ、構成がこれにあたる。
証明は論理の鎖を最初から最後まで追わないと確かめられない。反例はたいてい、直接調べるだけで確かめられる。
条件を満たしているか、主張された性質を持たないか。この2点を確認するだけだ。作業は有限で、結果は必ず決まる。
この記事のポイント
- OpenAIは、証明と反例を組み合わせた700本のプレプリントを、複数の分野にわたって公開した
- 反例は直接調べて確かめられるので、証明だけの場合より、数学の力を測る手がかりとして明快だ
- 公開の方針は、従来の査読よりも、幅広さと誰でも読めることを優先している
では、何が分かっていないのか。この規模の公開には、すぐに浮かぶ疑問がある。OpenAIの公式な説明は、それにはっきり答えていない。
- 700本のうち、人の手助けがほとんどなかったものはいくつあるか
- 公開前に専門家の査読を受けたものはいくつあるか
- すでに知られていた結果は含まれていないか、新しい成果は含まれているか
生成と検証の過程が示されていないので、研究者は文書そのものから、これらを読み取るしかない。
はっきりしているのは、幅広さと読みやすさを優先した公開だということだ。従来の学術誌ではなく公開リポジトリに載せたことで、誰でも自由に中身を検証できる。
査読を通ったという信用の印を手放し、その代わりに、誰もが検査できるという透明性を手にした形だ。
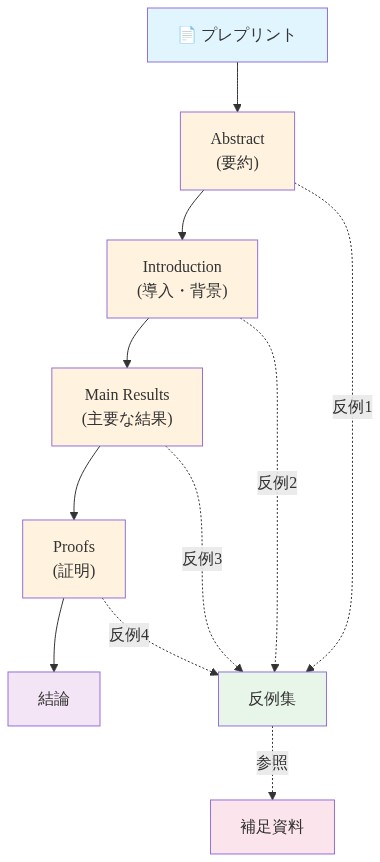
図2:プレプリントの標準構造(証明と反例の配置)
反例がなぜ重要なのか
反例は、強力でありながら検証もしやすい。数学の中でも特別な位置にある。 もっともらしく見える予想でも、うまく選んだ反例が1つあれば崩れる。
しかも検証は、機械的な作業で済むことが多い。示された対象が条件を満たし、主張された性質を持たないことを確かめればよい。複雑な議論を追う必要はない。
だから反例は、AIが本当に数学をしているのか、それとも流れるような文章を作っているだけなのかを見分ける、明快な試験になる。
長年の未解決問題の証明を信じるには、推論の鎖全体を信頼しなければならない。反例なら、手作業や簡単なプログラムで直接確かめられる。
反例探しは、今のAIの得意分野とも重なる。反例を見つけるには、計算で試す、パターンに気づく、直感を働かせるといった作業が要る。
いろいろな変形を試し、構造に気づき、この構成ならうまくいきそうだと見抜く作業だ。
言語モデルなどのシステムは、こうした作業に強みを見せてきた。幅広いパターンの知識を持ち、可能性の空間を探れるからだ。
具体的な場面で考えてみよう。ある予想が、性質Aを持つグラフはすべて性質Bも持つ、と主張しているとする。反例は、性質Aを持つのに性質Bを持たない、特定のグラフだ。
反例を検証するときは、数学者は次の2点を確かめる。
- このグラフは性質Aを持つか
- このグラフは性質Bを持たないか
どちらの確認も有限で、結果は必ず決まる。反例が正しければ、予想は間違いだったと分かる。
反例が間違っていれば、誤りは調べられる特定の主張に絞られる。長い議論のあちこちに散らばることはない。
この非対称性から、証明の束よりも反例の束のほうが、AIの力についてより多くを教えてくれる可能性がある。
証明は、1歩ずつ見れば正しくても、宣伝している問いとは微妙に違う問いに答えていることがある。反例は、通用するか、しないかのどちらかだ。
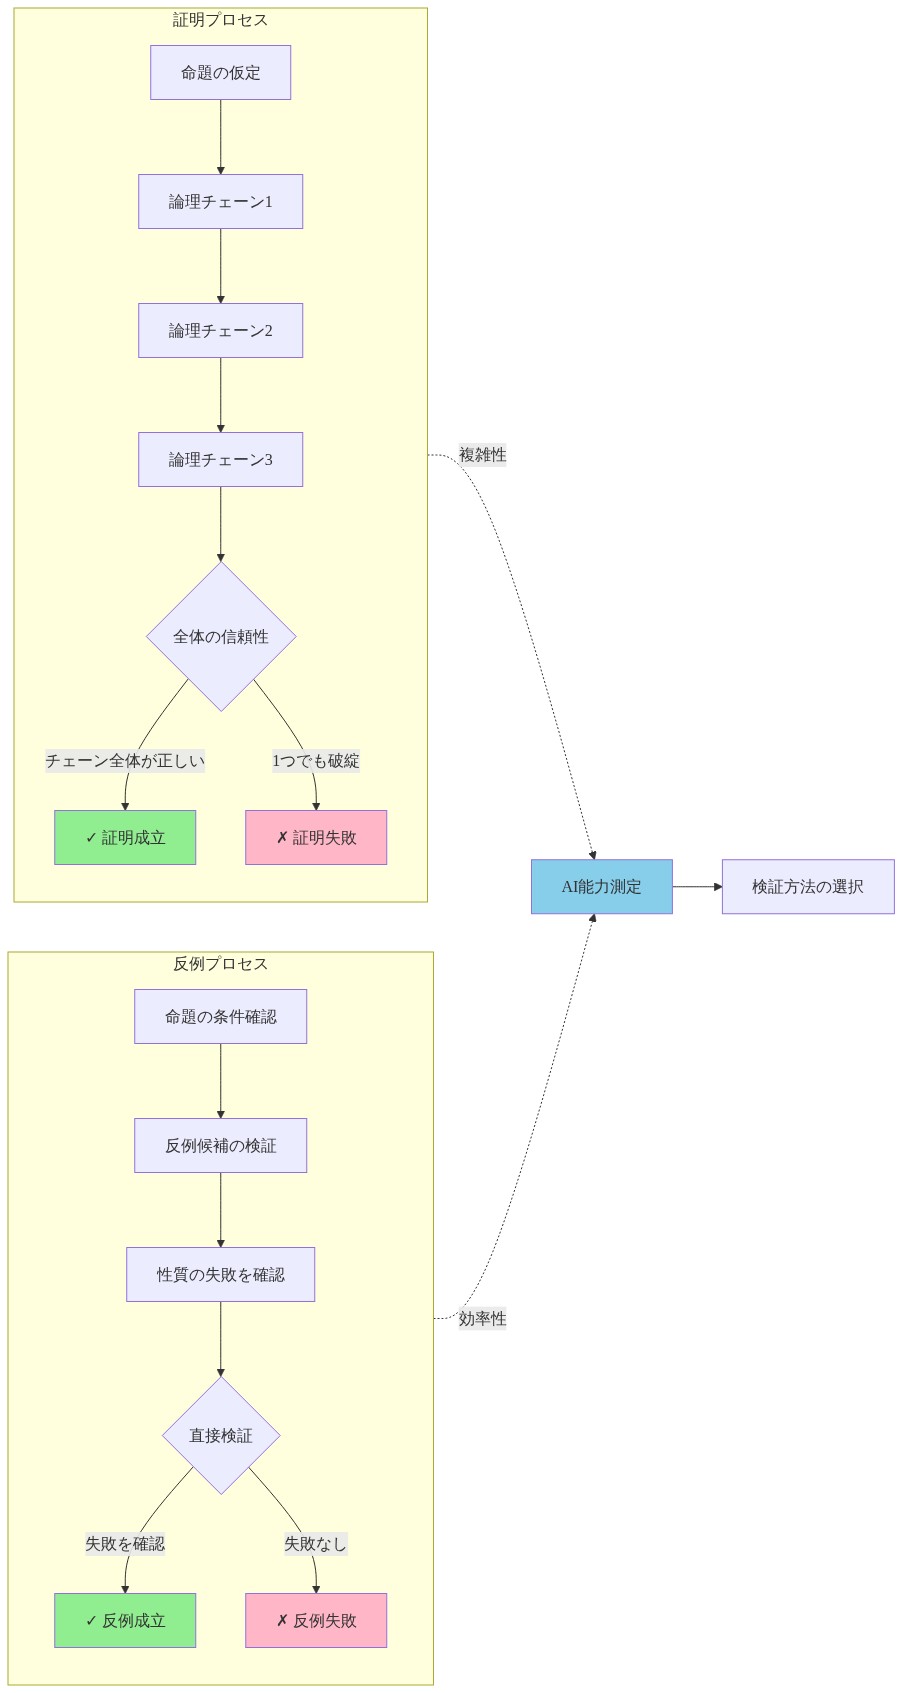
図5:証明と反例の検証プロセス比較 - AI能力測定における論理的検証の違い
検証の壁:大量の出力から信頼できる知識へ
700本のプレプリントを生み出すのは、計算の面では安上がりだ。それが正しいと確かめるには、人の手間も時間もかかる。
出力の速さと検証の速さの差が、今回の公開の中心にある緊張だ。
検証の道筋はいくつかの段階に分かれ、それぞれ費用も保証の強さも違う。
従来の標準である人間の査読は、機械の出力の速さに追いつけない。1人の専門家が1本の論文を読むのに、数週間かかることもある。そのペースで700本を見るなら、数学者のチームが何年もかかる。
そうなると疑問が出てくる。査読が済んでいないのに「公開された」と言えるのは、どういう意味なのか。
Lean、Coq、Isabelleのような形式証明支援系は、より強い保証を与える。これらの道具で形式化された証明は、機械が検証する。形式化が元の主張を忠実に写していれば、結果は確実だ。
ただし、非形式の証明を形式の証明に書き直す作業は、それ自体が手間のかかる専門的な仕事だ。この書き直しで、誤りが見つかることもある。
非形式な言葉ではもっともらしく読めた主張が、形式化できなかったり、元の主張があいまいだったり間違っていたりすると分かったりする。
ここには意味の正しさという問題がある。文として正しく、形式的に証明まで済んでいても、意図とは違う主張を表していることがある。AIによる数学支援では、よく知られた難しさだ。
証明支援系は、ある主張が与えられた公理から導かれるかどうかは確かめられる。だが、その主張が数学者の証明したかったものと同じかどうかは確かめられない。誤りが隠れるのは、その隙間だ。
3つ目の道は、反例をプログラムで直接検証することだ。査読より速く、形式化より手が届きやすい。
ただし、反例を機械が確かめられる形に直す必要がある。多くの反例では、これは簡単だ。反対に、証明の形式化と同じくらい複雑になる場合もある。
次の表は、3つの検証方法を比べたものだ。
| 方法 | 速さ | 確かさ | 手間 | 向いている場面 |
|---|---|---|---|---|
| 人間の査読 | 遅い(1本に数週間) | 高い(厳密なら) | 非常に大きい | 重要性や新しさの判断 |
| 形式証明支援系 | 中程度 | 非常に高い(機械的) | 非常に大きい(書き直しが必要) | 絶対的な確かさが要る重要な結果 |
| 計算による検証 | 速い | 高い(反例の場合) | 中程度 | 個別の主張や反例の確認 |
700本のプレプリントは、意味の誤りを見つける道具の試験台になりうる。
一部を専門家が丁寧に確かめ、結果を形式化すれば、非形式の主張と形式の主張のずれが見えてくる。そのずれこそ、こうした道具が捉えたい誤りだ。
AIが作る数学の意味の誤りを防ぐ仕組みを育てるうえで、役に立つだろう。
信用の落差が生じるおそれは現実にある。検証されていないプレプリントが出回り、読み手が検証の状況を知らないまま、確定した結果として扱ってしまうかもしれない。
これはAIの論文だけの問題ではない。arXivのようなプレプリントサーバーも、似た問題を抱えてきた。ただ、機械による生成は量が多く速いので、問題が大きくなるおそれがある。
数学の研究者コミュニティは、どう応じればよいのか。次のような決まりごとが助けになりそうだ。
- 検証状況の明示:各プレプリントに、査読済みか、形式検証済みか、計算で確認済みか、未検証かを分かるように書く。読み手が確信の度合いを見積もれる
- 形式化した成果物へのリンク:可能なら、証明支援系で書いた版を添える。検証の足跡が残り、機械による確認もできる
- 新しさの区別:新しい結果か、すでに知られた事実の再発見かを書く。独創性の誤った主張を防ぎ、重要性の判断にも役立つ
- 反例の優先:確かめやすいので、反例を先に検証する。小さなチームでも、大量の反例を現実的な時間で確かめられる
- 部分集合の選別:全体を同じ信頼度で扱わない。厳密な検証を経た確かな部分を見つけ、頼れる土台にする
検証できるAIの試験場としての数学
正しさがはっきり決まる分野なら、AIが本当に役立つかを測れる。 OpenAIをはじめとする研究所が数学に戻ってくるのは、このためだ。
正解が存在する。はっきりした手がかりでシステムを訓練できる。異なる方法の結果を公平に比べられる。
この節のポイント
- 数学には客観的な正解がある。文章や助言のような主観的な分野より、AIの推論を評価しやすい
- 形式的な問題は、現実の課題より整っている。一方で成功しても、もう一方の成功が保証されるわけではない
- 数学での進歩は、厳密な推論の力を示す。あいまいで雑然とした状況に通用するとは限らない
大手の研究所が最近発表した性能は、出力を試せる分野に集まっている。コード生成、セキュリティ分析、形式的な推論は、主観的な判断ではなく検証ができる分野だ。
たとえばGoogleのGemini 4 Argonは、コードとセキュリティの課題での性能を打ち出している。
システムの出力を実行して評価できる分野だ。1 成功の基準がはっきりしているので、研究所は進歩を信じてもらえる形で主張できる。
数学には、試しやすさのほかにも利点がある。
- 問題の記述が正確:多くの数学の問題は曖昧さなく書かれ、解釈の余地がほとんどない
- 解の検証ができる:証明は成り立つか成り立たないかのどちらかで、中間はない
- 確立された基準:何世紀も積み重ねられた知識と査読が、何を正しいとするかの共通の基準をつくっている
こうした性質から、数学はAIの推論を試す理想的な場になる。
とはいえ、形式的な成功が、そのまま雑然とした現実の世界に移るわけではない。定理には明確な真偽がある。政策の提言にはない。
競技数学の問題にはすっきりした答えがある。現実の場面であいまいさや不確かさに向き合うには、別の力が要る。
数学での成績の向上が、一般的な推論力を予測するとは限らない。形式的な問題を解く推論のパターンは、責任が重く情報が足りない場面では使えないかもしれない。
それでも、数学での進歩は進歩だ。AIが厳密な推論を行い、複雑な可能性の空間を探り、客観的な基準を満たす結果を出せることを示している。これは小さな力ではない。
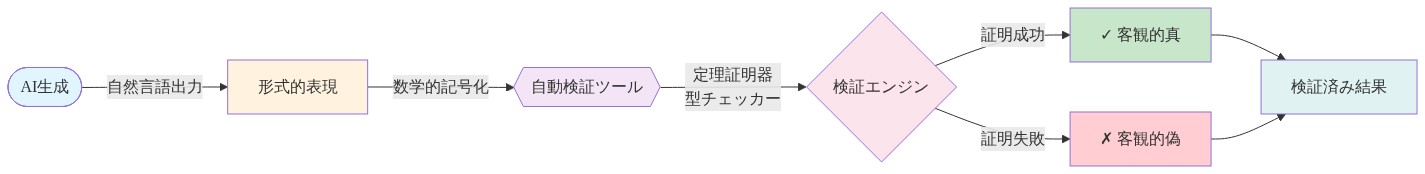
図9:形式的検証システムのフロー(Formal verification process)
公開という戦略:開放性、功績、競争上のシグナル
大量の研究成果を公開するのは、OpenAIのより広い動きの一環でもある。同社は、安全に関する事故の報告について新しい方式も発表した。
透明性を重んじ、外部からの精査を受け入れる姿勢だ。2 どちらの動きも、説明責任を果たす構えを示している。
ただ、こうした開放性の動機は入り混じっている。成果を公開すれば、独立した検証を招く。
生き残った主張は強くなり、そうでないものは露呈する。研究の誠実さにとって、これは本当に価値がある。
同時に、競合他社や研究者、資金の出し手に向けた、能力の誇示にもなる。数学の成果をまとまった量で公開すれば、OpenAIのシステムが形式的な分野で大規模に取り組めることが伝わる。
著者は誰なのか、という問いも残っている。モデルが証明を生み出したとき、その著者は誰か。従来の学術の決まりでは、着想し、実行し、責任を持つ人間が著者になる。
AIが道具ではなく貢献者になれば、この決まりは変わるかもしれない。だが問いは開いたままだ。
選んで公開すると、誤解を招く印象を与えるおそれもある。700本のプレプリントは、試みられたはるかに多くの証明と反例から選ばれたものだ。
失敗したり捨てられたりした試みがどれだけあったのかが分からないと、成功率や選別の質を判断するのは難しい。
生成と選別の過程が示されれば、公開はより信頼できるものになる。知りたいのは次の点だ。
- 試行の総数:証明と反例は、全部でいくつ生成されたのか
- 選別の基準:どんな基準で、公開する700本が決まったのか
- 既知の結果:モデルが生成する前から知られていた結果はあるか
- 人の手助け:大きな人の介入や修正が要ったものはあるか
これらに答えが出れば、研究者は今回の貢献の意義と、土台となるシステムの信頼性を見きわめやすくなる。
現役の数学者が次にできること
研究者のコミュニティには、扱えるコーパスができた。どう向き合えばよいのか。
この節のポイント
- 小さくても厳密な標本から始め、分野や結果の種類ごとの誤りの割合を確かめる
- プログラムで速く検証できる反例を、先に確かめる
- 各プレプリントを既存の文献と照らし、新しい結果と再発見を分ける
小さくても厳密な標本から始める
数学者のチームが、20〜50本のプレプリントを抜き出して丁寧に確かめる。これで、コーパス全体の誤りの割合と質の目安がつかめる。
標本は、分野も結果の種類も幅広く選びたい。証明、反例、構成を含めれば、いちばん易しい部分や難しい部分だけでなく、全体を映した目安になる。
反例を先に検証する
反例は、長い証明より確かめやすい。主張された性質を満たすかどうかをプログラムで試せば、数秒で検証できることも多い。
ここから始めれば、正しい反例と誤りを含む反例がそれぞれどれくらいあるかが、すぐ分かる。少なくとも結果の1つの種類について、コミュニティは素早く手応えを得られる。
既存の文献と照らす
各プレプリントを、すでに知られていることと照らす必要がある。新しい結果か、それとも以前に誰かが発表していたか。知られているなら、功績は正しく示されているか。
この確認で、独創性の誤った主張を防げる。コーパスが数学の知識に本当に何を加えたのかも測れる。
コーパスで形式化の道具を磨く
プレプリントは、非形式の証明を形式の証明に書き直す道具の開発や試験に使える。形式の証明とは、機械が1歩ずつ検証できるものだ。
700本を通して試せば、道具の穴が見つかり、信頼性の向上につながる。
信頼できる部分集合をつくる
700本すべてを同じ信頼度で扱わず、厳密な査読を経た小さな部分集合を選び出す手もある。確かさの高いこうした集まりは、今後の研究の頼れる土台になる。AIが良くなっているかを試す基準にもなる。
OpenAIに透明性を求める
研究者のコミュニティは、OpenAIに詳しい説明を求めるとよい。プレプリントをどう生成したのか、どれを公開に選んだのか、公開前にどんな確認があったのかだ。
これが分かれば、今回の公開の位置づけがはっきりする。今後、AI研究所と数学者がどう協力するかにも影響するだろう。
本当の進歩とは何か
AIが助手から貢献者に変わったと言える確かな証拠は、4つそろうことで示される。
- 分野を前に進める、新しくて検証済みの結果がコーパスにある
- 結果が正しいと、独立して確認される
- 現役の数学者が、自分の研究に結果を取り入れる
- 人とAIの両方の貢献を認める、功績の明確な枠組みがある
700本の公開は、この方向への一歩だ。ただ、始まりにすぎない。
本当の試練はこれからで、コミュニティがコーパスにきちんと向き合うか、誤りが見つかって直されるか、いずれかの結果が将来の数学に影響を与えるほど価値があると分かるかにかかっている。
ちょっと立ち止まって
「AIが論文を何百本も出した」と聞いたとき、私たちはつい本数の多さに目を奪われていないだろうか。
数学では、数の多さより、1つひとつが確かめられるかのほうが大事なのかもしれない。
あなたが何かを「正しい」と信じるとき、その根拠は、自分で確かめた経験か、それとも出どころの印象だろうか。確かめられるものと、確かめられないものを、自分はどのくらい区別して受け取っているだろうか。
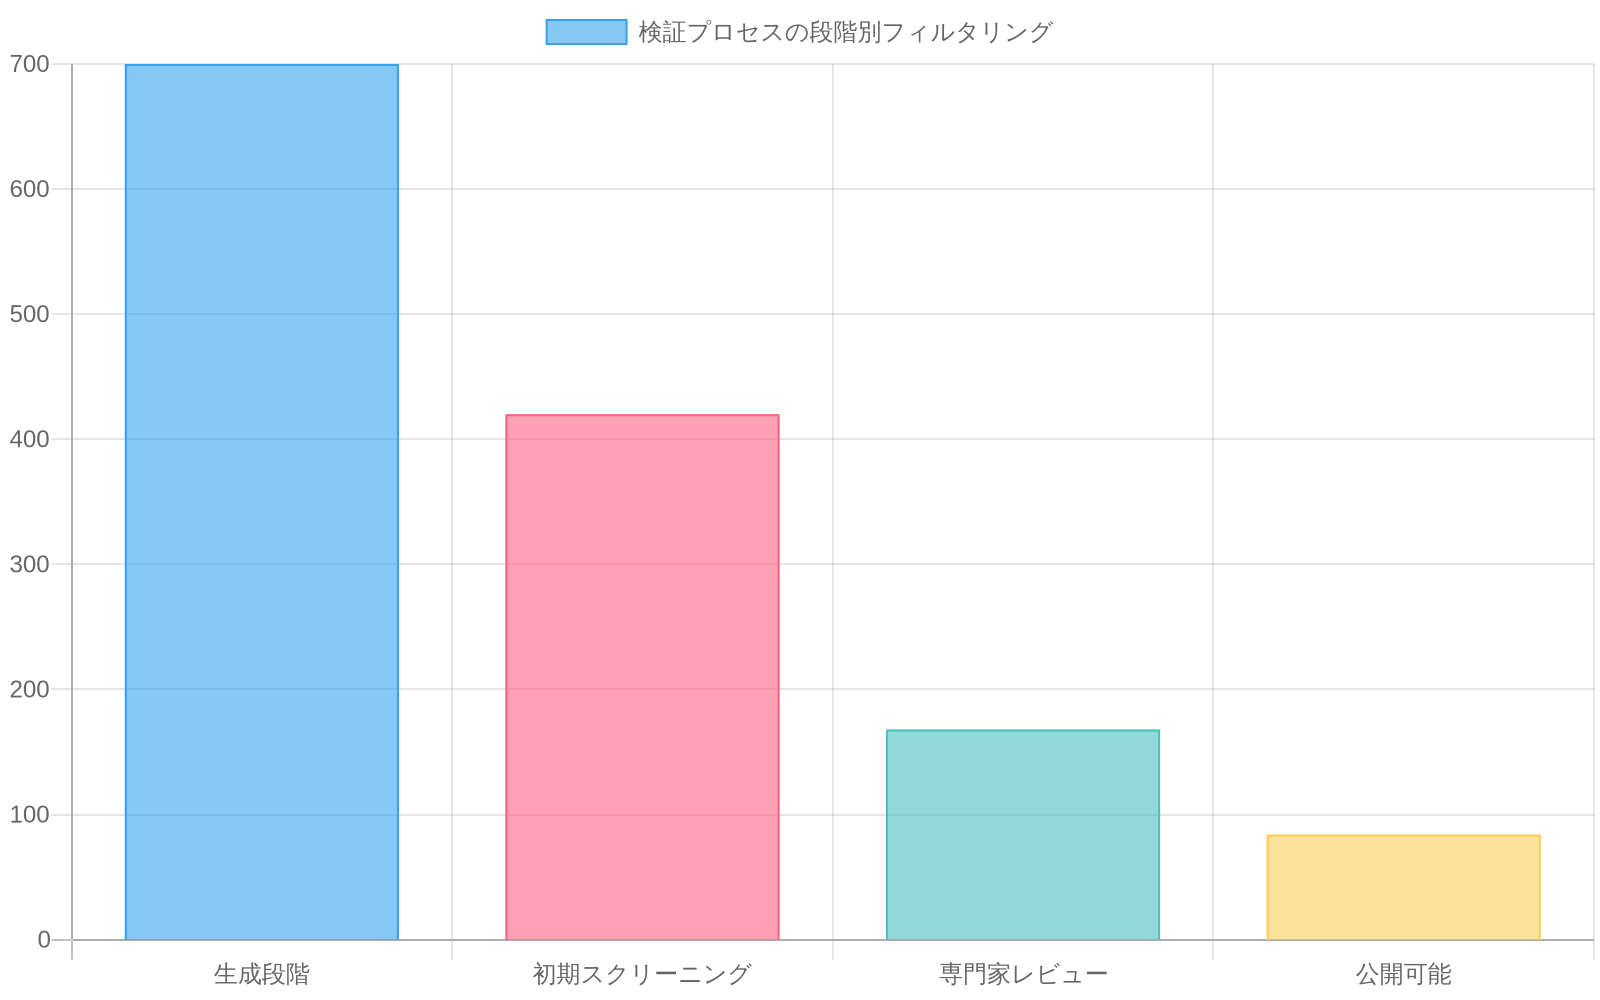
図7:検証プロセスの段階別フィルタリング(出典:Verification process analysis)
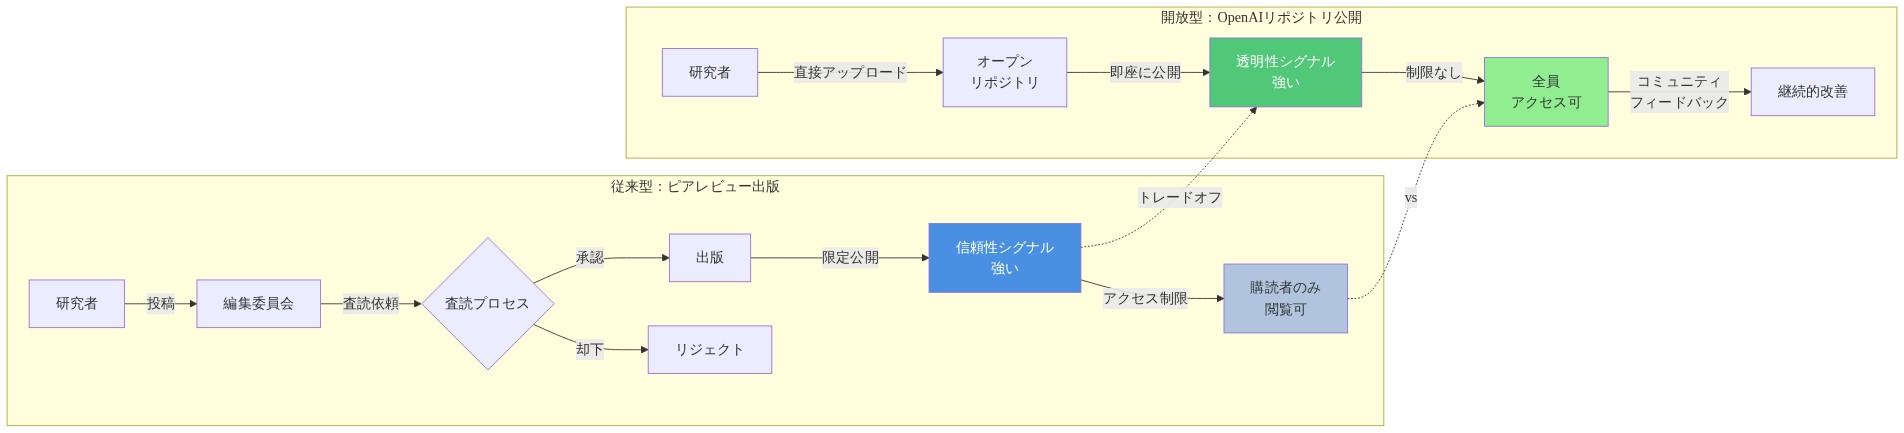
図11:出版戦略の比較:ピアレビュー vs. オープンリポジトリ