がん薬剤スクリーニングのデータベースは、ほとんどのマスが空いた表のように見える。
どの薬をどのがん種に試したかは、研究の歴史や化合物の入手しやすさ、手元にあった細胞株で決まっていて、バランスのとれた実験計画にはもとづいていない。こうした空白を無視して平均をとると、薬が実際にどう効くかではなく、何がスクリーニングされたかを部分的に映した順位ができあがる。
そこで、この問題を「測定の問題」として扱う方法がある。教育テストで使われる統計の道具を借り、その仕組みを逆向きにして、がん種と薬を1つの共通のものさしの上に並べるのだ。
この記事のポイント
- 薬剤反応の表は、ランダムではなく偏った形で欠けている。単純な平均は、薬の本当の効き目と、たまたま当たった細胞株の違いを混ぜてしまう。
- 逆項目反応理論では、がん種を「耐性の能力」をもつ受験者、薬を「かわされにくさ」をもつ問題とみなす。
- モデルは、GDSC2データベースの試験管内の測定24万2,036件に当てはめた。
欠けたデータで平均が当てにならない理由
薬剤反応の表は、がん種と化合物の組み合わせを並べたものだ。完全なスクリーニングなら、すべての薬をすべてのがん種に、同じ条件で試す。現実のスクリーニングはそうなっていない。
空白には偏りがある。ある化合物は、効くと期待されたがん種を中心に試されたかもしれない。
まれながん種は、使える細胞株が少ないかもしれない。スクリーニングの途中から加わった薬は、全体の一部にしか当たっていないこともある。
欠け方に偏りがあると、行や列の平均はその偏りを隠してしまう。すると、次のような問題が起こる。
次の表は、スクリーニングの偏りごとに、平均が示すものと実際に起きているかもしれないことを比べたものだ。
| スクリーニングの偏り | 平均が示すこと | 実際に起きているかもしれないこと |
|---|---|---|
| 感受性の高い系統を中心に試した薬 | 薬が非常によく効くように見える | 相手が弱かったために効き目が高く見えている |
| 強い化合物を中心に試したがん種 | がん種がとても強い耐性をもつように見える | 相手が手ごわかったために耐性が大きく見えている |
| 偏りなくまんべんなく試した薬 | 平均はおおむね公平 | 偏りのある薬との比較では、やはり公平にならない |
それぞれの平均は、自分のデータについては正しいことを言っている。問題が出るのは、平均どうしを比べるときだ。
同じ条件に出会っていない2つの対象を、たまたま見たものの合計で公平に順位づけすることはできない。
同じ問題は、ほかの「まばらなデータでの順位づけ」にも現れる。単純な平均では、どの結果が本当の差で、どの結果が調べ方の偏りなのかがぼやける。
どちらの場合も、解決策は平均を重ねることではない。記述的な要約から、データの構造を補正するモデルへ移ることだ。
考え方は単純である。異なる条件で測られた2つの対象を比べたいなら、それぞれが何に出会ったかをモデルに組み込む必要がある。
平均はこれを無視する。潜在尺度のモデルは、これを最初から組み込んでいる。
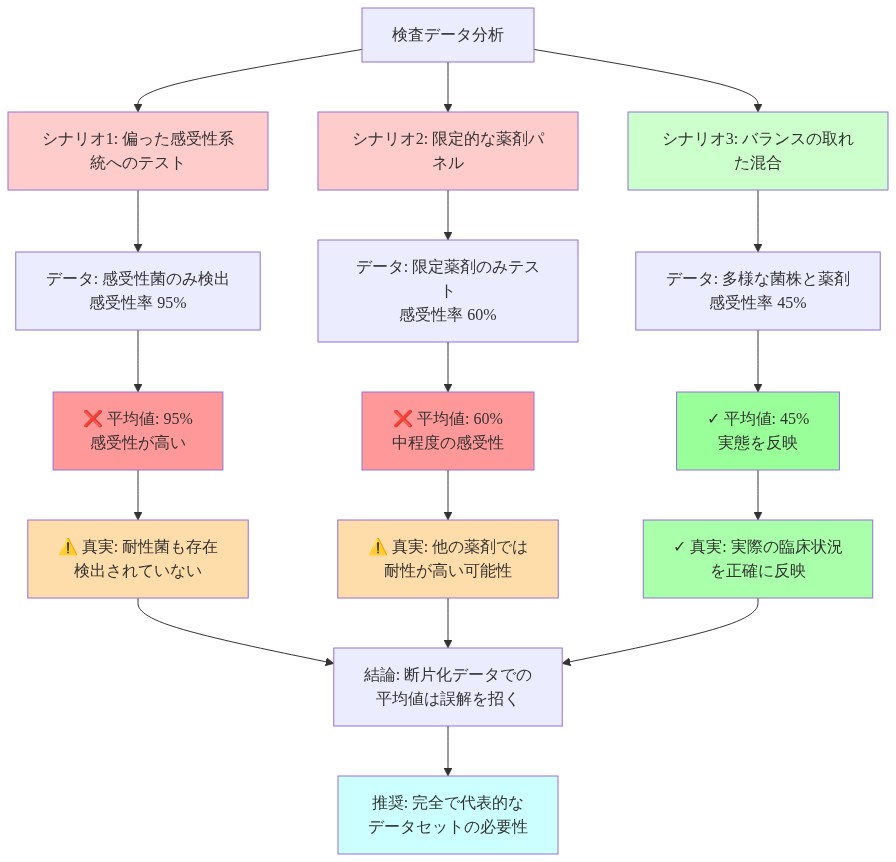
図2:疎データにおける平均値の問題:3つのスクリーニングパターンと隠れた偏り
項目反応理論を逆向きに使う
項目反応理論(IRT)は、教育の現場にある具体的な問題を解くために作られた。生徒ごとに違う問題に答えたとき、どうすれば公平に比べられるか、という問題だ。
難しい問題に当たった優秀な生徒が、易しい問題を引いた力の劣る生徒より下に並んではいけない。IRTは、生徒の能力と問題の難しさを同時に推定する。そのため、各得点は実際に出された問題に合わせて調整される。
逆IRTは、この論理をひっくり返して使う。テストを受ける生徒を比べるのではなく、薬への反応をもとにがん種を比べるのだ。
次の表は、通常のIRTと逆IRTで、何がどの役にあたるかを対応させたものだ。
| 通常のIRT | 薬剤反応の逆IRT |
|---|---|
| 受験者 | がん種 |
| 能力 | 耐性の能力 |
| テストの問題 | 薬 |
| 問題の難しさ | かわされにくさ:腫瘍が薬に耐えるのがどれだけ難しいか |
| 正解 | 腫瘍が薬に耐える |
がん種の耐性も薬の効き目も、1つの潜在尺度の上に置かれる。この共通のものさしには、実用上の利点が3つある。
- 直接の比較ができる。 がん種の耐性と薬の幅広い活性が同じ単位で測られるので、直接比べられる。
- 部分的なデータから推定できる。 表の一部しか観測されていなくても、パラメーターを推定できる。すべての薬に当たったがん種も、すべてのがん種に試された薬も、必要ない。
- 補正が組み込まれている。 各がん種の推定値は、実際に出会った薬の難しさを考慮している。各薬の推定値は、実際に出会ったがん種の耐性を考慮している。単純な平均にはできない補正だ。
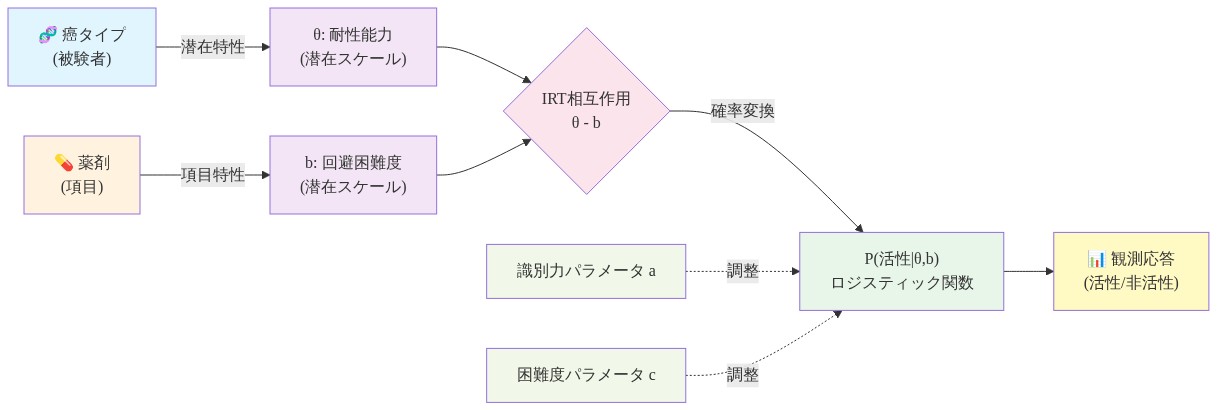
図5:Reverse Item Response Theoryモデルの構造:潜在スケールと観測応答の関係
たとえが当てはまらない所
試験の問題と薬は、重要な点で違う。この対応づけは役に立つ程度には成り立つが、その限界は結果の読み方に影響する。
- 連続的で、用量によって変わる結果。 感受性の測定値は、正解か不正解かではない。用量によって変わり、その関係は二値ではない。
- ラベルの内側にあるばらつき。 1つのがん種にまとめられた腫瘍にも、互いに違いがある。がん種の単位にまとめると、サブタイプ間の違いが隠れ、重要な差が見えなくなることがある。
- 次元が1つだけ。 1本の軸には、多くの作用の仕組みが1つの数字に押し込まれる。まったく異なる経路で働く薬は、この軸だけでは区別できない。
これらの限界のどれも、方法を無効にするものではない。ただ合わせて考えると、潜在尺度は生物学の測定された性質ではなく、結果を伴うモデル上の選択だとわかる。
そう読めば、これは偏ったスクリーニングのもとで公平に比べるための道具であり、薬がどう働くかの説明ではない。
GDSC2の24万2,036件の測定にモデルを当てはめる
実証にはGenomics of Drug Sensitivity in Cancer(GDSC)データベースのGDSC2版を使う。多くのがん種と化合物にわたる、試験管内の薬剤感受性の測定24万2,036件が入っていて、大きな空白もある。
このデータに逆IRTを当てはめると、共通の軸の上に2組の推定値が得られる。1つは各がん種の耐性の能力、もう1つは、各薬のかわされにくさから導いた、幅広い活性の指標だ。
いちばん参考になるのは、周辺平均との比較である。 2つの順位が食い違う所では、平均を動かしていたのは、おそらくスクリーニングの設計だった。
次の表は、平均がどこでミスリードし、逆IRTがそれをどう補正するかをまとめたものだ。
| 対象 | 平均がどうミスリードしたか | 逆IRTでどう補正されるか |
|---|---|---|
| 感受性の高い系統を中心に試された薬 | 非常に強力な薬として上位に並んだ | 易しい相手に当たった分を考慮すると、順位が下がる |
| 強い化合物を中心に試されたがん種 | 非常に強い耐性をもつとして上位に並んだ | 手ごわい相手に当たった分を考慮すると、耐性が低い側に動く |
データがまばらなときの推定
まばらなデータには、それに対応するよう設計されたモデルであっても、固有のリスクがある。
- 識別可能性。 測定がごくわずかなしかないがん種では、モデルがパラメーターを定める手がかりが少ない。推定値は弱くしか定まらず、不安定になるおそれがある。
- 両端の不確実性。 最上位と最下位には、データの薄い対象が入りやすい。こうした位置は、不確実性がもっとも大きい。
- 試験管内での代用。 細胞株の反応は、患者の反応の代わりにはなるが、それを直接予測するものではない。腫瘍の微小環境、薬の代謝、患者ごとの違いは、シャーレの中にはない。
そのため、このモデルは、補正された比較用の要約として使うのが最適だ。スクリーニングの設計と生物学の違いを十分に切り分けて、異なる条件で測られた対象を比べられるようにする。
ただし、臨床の推奨を出す仕組みではない。
4種類の欠け方での検証
順位づけの方法が信頼に値するのは、情報を取り除いたときに真の姿を取り戻せる場合だけだ。この検証では、全データから出した順位を基準とし、観測を系統的に削って、各方法がその順位をどれだけ再現できるかを見る。
削り方は4種類ある。
次の表は、4つの欠け方と、それぞれが何を試すものかをまとめたものだ。
| 欠け方 | 観測の取り除き方 | 何を試すか |
|---|---|---|
| 完全にランダムな欠測(MCAR) | 薬やがん種に関係なく削る | 基本的な頑健さ |
| がん種に偏った欠測 | 一部のがん種だけ、はるかに多くのデータを失う | がん種間の偏ったカバー率 |
| 薬に偏った欠測 | 一部の薬だけ、はるかに多くのデータを失う | 化合物間の偏ったカバー率 |
| 混合 | 偏りのある仕組みを組み合わせる | 現実に近い、重なり合った欠け方 |
とくに大事なのは、偏りのある欠け方である。現実のスクリーニングの空白は、ランダムであることがまれだ。
順位をつけたい対象と欠け方が結びついていることが多い。たとえば、後の薬剤パネルから外された薬や、培養が難しすぎる系統がそうだ。MCARしか扱えない方法は、実際にはあまり役に立たない。
欠測が60%のとき、逆IRTは単純平均よりも全データの順位に近い結果を返した。 順位相関の改善幅は、MCAR、がん種に偏った欠測、薬に偏った欠測の3つの条件で、Δρ = +0.089〜+0.095だった。この差は、どの条件でもほぼ一定だった。
削除が特定のがん種や薬を狙ったときでも、優位は保たれた。
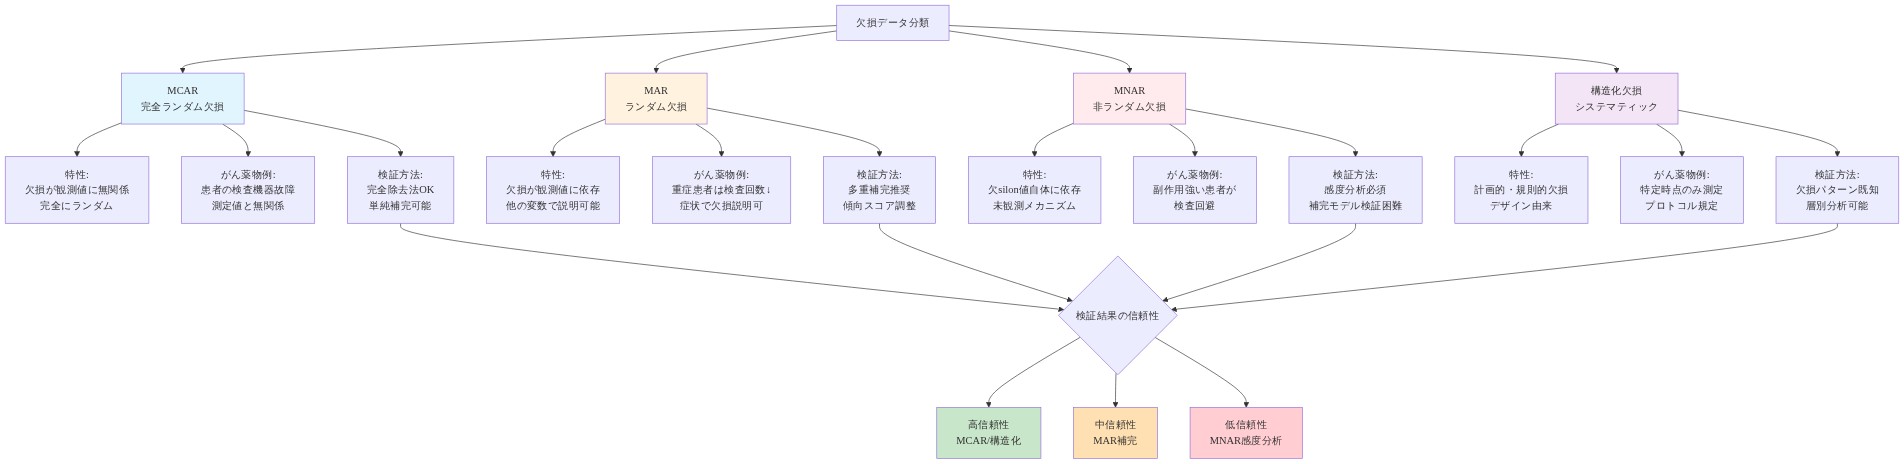
図8:4つの欠損メカニズムと検証戦略の比較:MCAR、MAR、MNAR、構造化欠損(出典:欠損データ分類法および臨床試験検証フレームワーク)
優位が縮むかもしれない所
報告された結果は、この方法の限界を決めるものではない。ただ、モデルの構造から、効果が小さくなりうる場所は推測できる。
- 極端なまばらさ。 欠測がある水準を超えると、共通の尺度の上で対象どうしをつなぐ重なり合った測定が足りなくなるかもしれない。
- 観測が薄い対象。 観測がごく少ないがん種は、全体の欠測率にかかわらず、推定を支えるデータが足りないかもしれない。
これらは、IRTの推定の仕組みにもとづく予想であり、測定された結果ではない。直接検証すれば、この方法がいつ頼れるかの指針がより明確になるだろう。
この教訓は、まばらなデータの上に作られた、解釈できるモデル全般に当てはまる。
検証では、きれいな入力での精度だけでなく、劣化した入力での安定性も確かめなければならない。重大な結果を伴う分野では、出力がいつ信頼できるかを使う人が知る必要がある。
潜在尺度の読み方と使い方
順位を再現できることと、それを説明できることは別だ。使う人は、「耐性の能力」と「かわされにくさ」が何を意味するのか、各推定値にどれだけの信頼を置けるのかを理解する必要がある。
いくつかの確認が、本物の信号と当てはめ上の産物を見分ける助けになる。
- 残したデータへの感度。 残す観測を変えたとき、順位は大きく動くか。
- 部分標本どうしの一致。 独立に部分標本をとって当てはめても、似た順位が出るか。
- 正直な不確実性。 観測の少ない対象では、本来そうなるべきとおり、区間が広がるか。
これらの確認は、不完全なデータに対する解釈可能なモデルの研究で挙がる懸念と重なる。そこでの中心的な問いは、再標本化しても推定値が安定しているか、そして推定値が当てはめの手続きではなくデータに忠実であるか、というものだ。
この尺度がいちばん信頼できるのは、観測数が中程度の対象に対してである。両端の順位は、データが薄いことが多いので、より疑ってかかる必要がある。
また、1本の軸では作用の仕組みを切り分けられず、がん種のラベルがサブタイプの違いを隠すこともある。
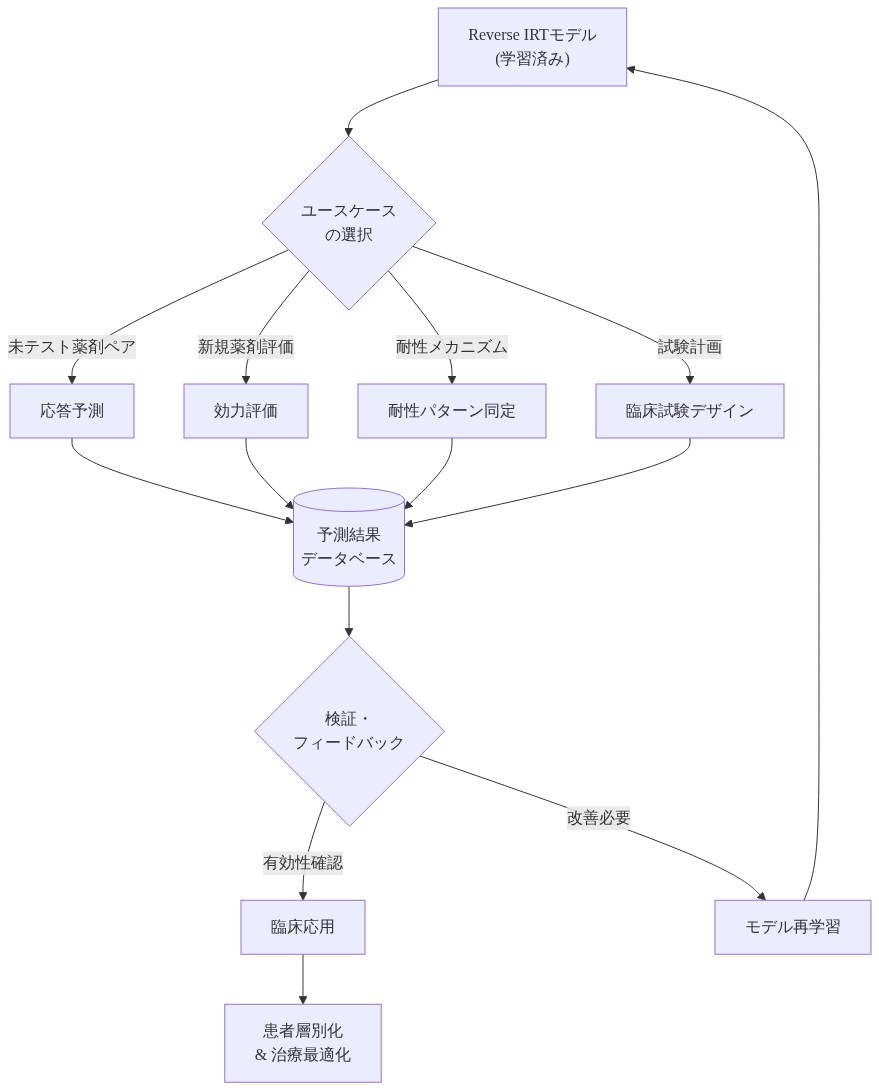
図12:Reverse IRTモデルの実用的応用:予測と臨床活用のフロー
実際の使い道
まばらさを考慮した潜在モデルが平均より確かに順位づけできるなら、実際の使い道が2つ考えられる。1つは、不完全なパネルから、幅広く活性をもつ化合物や、とくに耐性の強い系統を見つけることだ。
もう1つは、新たなスクリーニングが順位の不確実性をいちばん減らせるのはどこかを判断し、最も支えの弱い推定値に労力を向けることだ。
未解決の問いも残っている。
- 薬の作用の仕組みを切り分けられるよう、枠組みを多次元の潜在特性に広げる。
- 単一の要約値の代わりに、用量反応曲線の形を使う。
- がん種のラベルの下にある、細胞株のばらつきをモデル化する。
- スクリーニングの設計が異なるデータベースの間で、効果が移るかを調べる。
分析する人への提案
- 平均をとる前に、欠け方のパターンを確認する。順位をつける対象とカバー率が相関していれば、平均は誤解を招く。
- 潜在尺度での順位と周辺平均を比べる。大きく食い違う所は、スクリーニングの設計が平均を形づくっている場所を示す。
- すべての順位に不確実性を添えて報告する。観測の少ない対象、とくに最上位と最下位には印をつける。
- ランダムな削除だけでなく、偏った削除でも検証する。自分のデータに実際にあるような空白を再現して試す。
- 試験管内の順位を、臨床での主張に使わない。スクリーニング段階の証拠として扱い、さらなる確認を求める。
ちょっと立ち止まって
不完全なデータには、必ず選択の記録が刻まれている。何を試し、何を飛ばし、何が手に入りやすかったか。
平均は、その記録を見えないものとして扱う。それを織り込むモデルは、選択を分析の一部にする。
次に順位表を見るときは、それぞれの項目が実際に何に出会ったのかを考えてみてほしい。全員が同じ条件に当たっていたとしても、この並びは変わらないだろうか。