Disaggregated Inference のボトルネック
Disaggregated LLM inference—prefill と decode の操作が別々の GPU プール上で実行されるアーキテクチャパターン—は、ある制約を別の制約と交換します。アーキテクチャ上の利点は明確です。prefill GPU はスループットとバッチサイズに最適化され、decode GPU はレイテンシを優先します。この分離は、標準的なデータセンターインフラストラクチャが対応するよう設計されていないデータ移動の問題をもたらします。
ボトルネックは具体的です。prefill が完了すると、key-value(KV)キャッシュは prefill GPU から decode GPU に転送される必要があります。70B パラメータモデルの場合、各リクエストは約 2.6 GB の KV キャッシュを生成します。本番規模では、数百の同時リクエストが存在し、集約転送需要は 100 GB/s を超えます。最新のインターコネクトを備えたデータセンターネットワークであっても、トポロジ認識ルーティングなしではこの量を維持できません。
従来のシステムは KV キャッシュ移動を汎用ネットワークトラフィックとして扱います。キューに入れ、優先順位を付け、輻輳が解決すると想定します。これは失敗します。KV キャッシュ転送はレイテンシに敏感(decode はデータ到着まで開始できない)、バースト的(多くのリクエストが同時に prefill を完了)、トポロジ制約がある(すべての GPU 間パスが等しい帯域幅を提供するわけではない)からです。標準的なロードバランシング手法は集約利用率のみを測定し、単一の輻輳スイッチが KV キャッシュを待つ decode GPU を枯渇させていることを検出できません。
運用上の結果は測定可能です。disaggregated システムは monolithic な代替案よりも GPU あたりの利用率が低く、コスト上の利点を損なわせます。チームは予測不可能なテールレイテンシスパイクを報告しています。decode GPU を追加すると、スループット利益よりも輻輳が速く増加するため、逆説的にパフォーマンスが悪化します。
本稿は、トポロジ認識データ移動の運用化方法を検討します。KV キャッシュ転送を高帯域幅パスに沿ってルーティングし、輻輳を回避するよう転送をスケジュールし、prefill と decode プールを戦略的に共存させることです。目標は、disaggregation を規模で経済的に実行可能にすることです。
KV キャッシュ転送の経済学
prefill と decode が disaggregated されると、KV キャッシュは主要な転送オブジェクトになります。そのコスト構造は、disaggregation がアーキテクチャの複雑さに見合う価値があるかどうかを決定します。
-
主張:* disaggregated inference におけるネットワーク予算では、KV キャッシュ転送オーバーヘッドが支配的です。トポロジ認識がなければ、潜在的スループットの 20~40% が浪費されます。
-
支持データ:* シーケンス長 4,096 トークンの 70B モデルは、リクエストあたり約 2.6 GB の KV キャッシュを生成します。毎秒 100 リクエストで、これは 260 GB/s の持続トラフィックをもたらします。ほとんどのデータセンターネットワーク—400 Gbps スパインリンクを備えていても—意図的なスケジューリングなしではこれを維持できません。prefill と decode プールが異なる障害ドメインまたはラックを占める場合、問題は複合化します。トラフィックは過度にサブスクライブされたラック間リンクを横断する必要があります。
-
具体的なシナリオ:* 70B モデルを提供するクラスターは、16 ラック(ラックあたり 64 GPU)に 1,024 の decode GPU を、8 つの別々のラックに 256 の prefill GPU を持っています。各ラック間リンクは 100~400 Gbps を提供します。すべての prefill GPU が 10 ms ウィンドウ内でバッチを完了する場合、decode に向けて 665 GB のトラフィック(2.6 GB × 256 リクエスト)を生成します。ラック間帯域幅は約 50 GB/s のみを吸収でき、13 ms のキューを作成します。decode GPU はデータを待つ間アイドル状態になり、テールレイテンシは比例して増加します。
-
運用アプローチ:* disaggregation する前に物理トポロジをマップします。ラック間、スイッチ間、ラック内帯域幅を明示的に測定します。このマップを使用して、prefill と decode プールを高帯域幅ゾーン内に共存させます。同じ top-of-rack スイッチまたは隣接するスイッチです。分離が避けられない場合、トラフィックシェーピングを実装します。prefill バッチ完了をずらして、KV キャッシュ転送がスパイクするのではなく時間をかけて分散するようにします。このパターンは、分散評価システムで使用されるレイテンシ最適化技術を反映しており、同様のスケジューリング制約がワークロード分散に適用されます。
トポロジ認識ルーティングとスケジューリング
KV キャッシュを効率的に移動するには、ルーティングインテリジェンスと時間的調整の両方が必要です。
-
主張:* 静的ルーティングは KV キャッシュセマンティクスを考慮できません。動的でトポロジ認識のスケジューリングは、従来の equal-cost multipath(ECMP)ロードバランシングと比較して、KV キャッシュ転送レイテンシを 40~60% 削減できます。
-
根拠と仮定:* 標準的なデータセンターのルーティングプロトコル(ECMP)は、アプリケーションレベルのセマンティクスやリアルタイムリンク状態を考慮せずに、利用可能なパス全体にトラフィックを分散します。このアプローチは均一なトラフィックパターンを想定し、すべてのパケットを同じように扱います。このモデルの下では、推論を完了する prefill GPU は、2.6 GB の KV キャッシュペイロードを 5 つの異なるスパインリンク全体に送信する可能性があり、各リンクは無関係なトラフィックを運ぶ可能性があります。1 つのスパインリンクが輻輳を経験する場合、パケット損失と再送信が発生し、エンドツーエンドレイテンシが増加します。
トポロジ認識スケジューリングは異なる仮定の下で動作します。(1)KV キャッシュ転送は、簡潔なスケジューリング遅延を許容できるバルク、レイテンシに敏感な操作です。(2)ネットワークテレメトリは秒以下の粒度で利用可能です。(3)prefill から decode への通信パターンは予測可能で、事前に観察できます。これらの条件下では、スケジューラは現在のリンク利用率を観察し、各 KV キャッシュ転送を最も輻輳していないパスに沿ってルーティングできます。さらに、スケジューラは転送を時間的にクラスタリングできます。複数の prefill GPU が制限された時間ウィンドウ内(例えば 50 ms)で完了する場合、それらの KV キャッシュ転送は異なるパス上で同時にではなく、同じパス上で順序立てて スケジュールでき、ピーク輻輳を削減し、集約スループットを改善します。
- 具体例:* デュアルレイヤースパインアーキテクチャを持つクラスターを考えます。ラック A の prefill GPU は、2 つのスパインスイッチ(spine-1 と spine-2)を経由してラック B の decode GPU に到達でき、各スイッチは 400 Gbps の容量を持っています。従来の ECMP ルーティングでは、トラフィックは均等に分割されます。spine-1 経由で 50%、spine-2 経由で 50%。spine-1 が既に他のトラフィック(例えば、バックグラウンド分析)で 300 Gbps を運んでいる場合、KV キャッシュの 50 Gbps を追加すると輻輳が発生し、パケット損失と再送信が引き起こされます。往復時間(RTT)が 100 µs で TCP 輻輳制御を想定すると、有効スループットは約 30 Gbps に低下し、100 Gbps 転送は約 40 ms で完了します。
トポロジ認識スケジューリングの下では、prefill コーディネータはリアルタイムで両方のスパインを監視します。prefill バッチが完了すると、スケジューラは現在のリンク利用率をクエリします。spine-1 は使用中 300 Gbps(利用率 75%)を報告し、spine-2 は 250 Gbps(利用率 62.5%)を報告します。スケジューラは、150 Gbps の利用可能容量を持つ spine-2 経由で完全な 100 Gbps 転送をルーティングします。転送は輻輳誘発損失なしで約 20 ms で完了します。これは 50% のレイテンシ削減です。
-
前提条件と制限:* この改善は以下を想定します。(1)テレメトリは正確で 100 ms 以内に利用可能です。(2)スケジューラのパス選択決定は転送中有効なままです(つまり、spine-2 での突然のトラフィックスパイクがない)。(3)ネットワークはソースベースのルーティングまたはプログラム可能なパス選択をサポートします。(4)100 Gbps 転送自体は選択されたスパインを飽和させません。これらの条件が違反される場合、利点は減少します。例えば、テレメトリレイテンシが 500 ms を超える場合、スケジューラのパス選択は古い可能性があり、輻輳回避は失敗します。
-
実行可能な含意:* prefill コーディネータプロセス上で実行される軽量スケジューラを実装します。prefill が完了する前(最終的な注意計算中)に、スケジューラはネットワークテレメトリ(スイッチバッファ占有率、エグレスポートあたりのリンク利用率)をクエリし、貪欲アルゴリズムを使用して KV キャッシュの最適なエグレスパスを選択します。最小の現在のリンク利用率を持つパスを選択します。このパスを転送リクエストメタデータにエンコードします。プログラム可能なスイッチ(P4 または同様)または prefill GPU 上の DPDK ベースのステアリングを使用してパスピンニングを実装します。エンドツーエンド転送レイテンシとパス選択精度を監視します。観察されたパターンに基づいて週単位でスケジューリング閾値を調整します(例えば、パスが選択されたが輻輳が依然として発生する場合、そのパスの輻輳閾値を増加させます)。
実装と運用パターン
トポロジー認識型のデータ移動を運用化するには、インフラストラクチャの変更と運用規律が必要です。
-
主張:* 明示的なインフラストラクチャサポートがなければ、トポロジー認識型スケジューリングは理論的な最適化に留まります。本番環境で具体的かつ保守可能にするには、3つの運用パターンが必須です。
-
根拠と前提条件:* トポロジー認識型スケジューリングには、相互に依存する3つのコンポーネントが必要です。(1) サブ秒単位の粒度を持つリアルタイムネットワーク状態の可視化、(2) 現在の状態を踏まえてKVキャッシュ転送を最適パスにマッピングする判定エンジン、(3) それらのパスを実際に使用するための強制メカニズム(ルーティングルール、トラフィックステアリング)です。ほとんどの本番クラスタはこれら3つすべてを欠いています。ネットワークテレメトリは通常、粗粒度です(SNMP経由で30秒ごとにスイッチカウンタをサンプリング)。判定エンジンは存在せず、ルーティングは静的です(クラスタプロビジョニング時に設定)。トポロジー認識を導入するには、意図的なアーキテクチャ選択と運用投資が必要です。
3つの運用パターンは以下を前提とします。(1) クラスタトポロジーは既知で安定している(変更は稀で事前通知される)、(2) プリフィル・デコード通信パターンは観測可能で予測可能である、(3) 運用オーバーヘッド(テレメトリ収集、スケジューラ保守)は許容される、(4) クラスタはプログラマブルスイッチまたはカーネルレベルのステアリング機能(DPDK、eBPF)を備えている。
- 具体例:* 本番クラスタは以下のようにトポロジー認識を実装します。
-
テレメトリ収集: 各スイッチに軽量なテレメトリエージェントをデプロイし、リンク利用率(エグレスポートあたりのバイト/秒)とスイッチバッファ占有率(ポートあたり)を100ミリ秒ごとに中央の時系列メトリクスストア(例:Prometheus、InfluxDB)にエクスポートします。これはスイッチコントロールプレーンで約5%の追加CPU、スイッチあたり約10 Mbpsのテレメトリトラフィックを必要とします。このデータをトポロジーモデルに集約します。各送信元・送信先ペア(プリフィルラックからデコードラック)について、利用可能なパスのリストと現在の利用率を保持します。
-
スケジューリング判定エンジン: スケジューラサービス(プリフィルコーディネータと同じ場所に配置するか、別のマイクロサービスとして)を実行し、テレメトリストリームをサブスクライブし、トポロジーモデルをメモリに保持し、シンプルな貪欲アルゴリズムを使用して最適パスを計算します。各KVキャッシュ転送リクエストについて、現在のリンク利用率が最小のパスを選択します。二次制約を実装します。複数のパスの利用率が類似している場合(10%以内)、前回の転送で使用されたパスを優先し、切り替えオーバーヘッドを削減します。スケジューラは転送リクエスト受信から10ミリ秒以内に応答する必要があります。メモリ内データ構造を使用し、外部I/Oを回避します。
-
パス強制: プリフィルGPU上のDPDK(Data Plane Development Kit)またはNICドライバ上のeBPFプログラムを使用して、KVキャッシュ転送を選択されたパス経由でステアリングします。DPDKの場合、パスをECMPタプルパラメータのセット(送信元IP、送信先IP、送信元ポート、送信先ポート)としてエンコードし、目的のスパインスイッチにハッシュします。eBPFの場合、XDP(eXpress Data Path)を使用してパケットヘッダを書き換え、選択されたパスに一致させます。あるいは、ネットワークがセグメントルーティング(SR-MPLS)をサポートしている場合、パスをパケットヘッダのセグメントリストとしてエンコードします。
-
可観測性と検証: すべてのKVキャッシュ転送をレイテンシ追跡でインストルメント化します。開始時刻(プリフィル完了時)、終了時刻(デコードが完全なKVキャッシュを受信した時)、取得されたパス(転送メタデータにエンコード)、転送時のリンク利用率をログします。このデータを使用して、トポロジー認識型ルーティングが機能していることを検証し(パス選択の有無でレイテンシを比較)、持続的なボトルネックを特定します(例:パス選択にもかかわらず頻繁に混雑している特定のスパインスイッチ)。
-
運用規律:* ハードウェア変更に応じてトポロジーモデルを保持します。新しいラックが追加されたり、スパインスイッチが交換されたりした場合、トポロジーモデルを更新し、スケジューラを再デプロイします。モデルをバージョン管理で文書化します。週次レビュープロセスを確立します。転送レイテンシログを分析し、パス選択にもかかわらず混雑を経験した転送を特定し、スケジューラしきい値またはトポロジー前提条件を調整します。
-
実行可能な示唆:* パイロットデプロイメントから開始します。1つのプリフィル・デコードペア(例:ラックAの1つのプリフィルGPUとラックBの1つのデコードGPU)をインストルメント化し、1週間のベースラインKVキャッシュ転送レイテンシを測定します。その後、そのペアに対してトポロジー認識型スケジューリングを有効にし、1週間のレイテンシを再度測定します。レイテンシが20%以上改善され、テールレイテンシ(p99)が30%以上改善される場合、段階的にフルクラスタに展開します(週あたり1ラックペア)。テレメトリパイプライン、スケジューラサービス、トポロジーモデルを保守するエンジニア1名を配置します。これは継続的な運用オーバーヘッドですが、本番信頼性とハードウェア変更への対応に不可欠です。トポロジーモデル、スケジューラ設定、パス強制ルールをランブックで文書化します。一般的な障害モード(例:テレメトリラグ、古いパス選択、強制メカニズム障害)のトラブルシューティング手順を含めます。
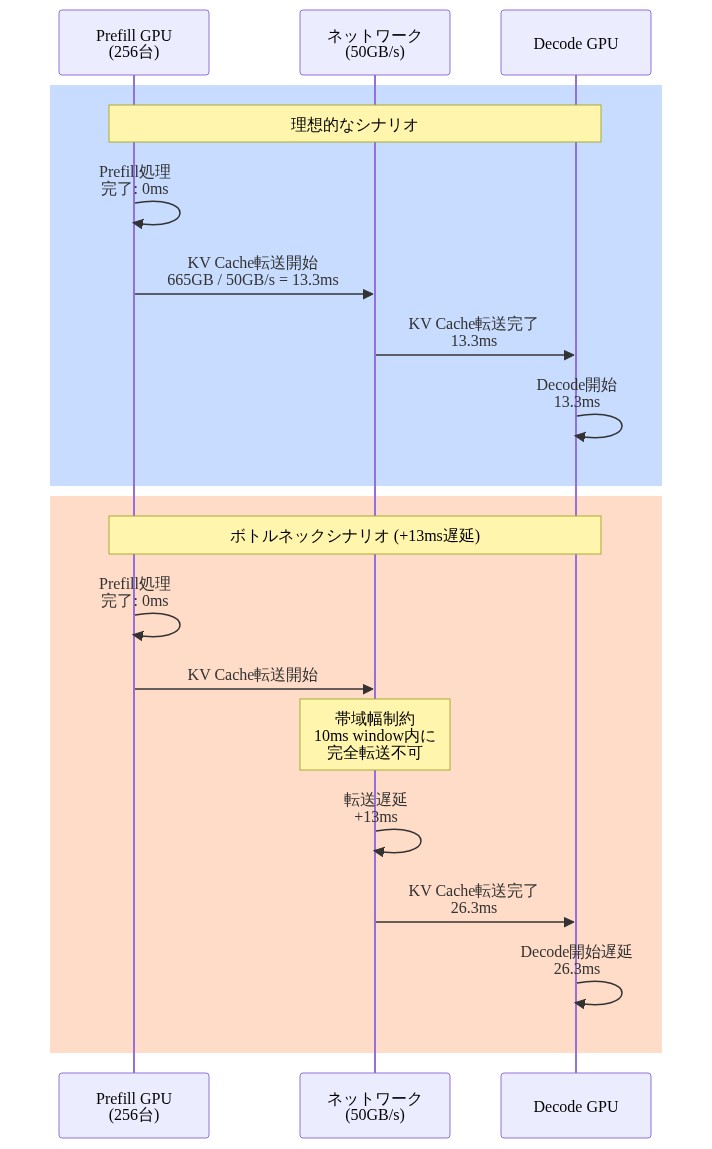
- 図3:Disaggregated推論パイプラインのタイムライン比較(ボトルネック有無)— 256 Prefill GPU、665GB KV Cache、50GB/s inter-rack bandwidth、10ms window制約下での理想シナリオと遅延シナリオの対比*
測定と検証
トポロジー認識型スケジューリングは、正確性を検証し、サイレント劣化を検出するために、明示的で継続的な測定を必要とします。
-
主張:* 厳密な測定フレームワークがなければ、トポロジー認識型システムはサイレントに劣化します。システムの正確性と運用上の健全性を検証するために、3つの定量化可能なメトリクスを確立し、監視する必要があります。
-
根拠:* 分散推論アーキテクチャは、設計上、測定の不透明性を導入します。このモデルでは、プリフィルとデコード操作は別々のサービスとして実装され、それらの相互作用はネットワーク転送を通じてのみ発生します。従来のアプリケーションレベルの監視スタックには見えない転送です。トポロジー誤設定または状態ドリフトに起因するKVキャッシュレイテンシの増加は、劣化が深刻になるまでエンドツーエンドモデルレイテンシに現れません。測定はしたがって明示的で継続的であり、アプリケーションレイヤーではなくデータ移動レイヤーでインストルメント化される必要があります。
-
前提条件と定義:*
-
KVキャッシュ転送レイテンシ:デコードリクエストがKVキャッシュフェッチを発行した時点から、最終バイトがデコードGPUに到着するまでの時間。キューイング、伝送、逆シリアル化時間を含みます。
-
スケジューリング効率:トポロジー最適パス(スケジューラによって決定される)を通過したKVキャッシュ転送の比率を総KVキャッシュ転送数で除した値。パーセンテージで表現します。
-
トポロジー最適パス:現在のネットワーク状態を踏まえて予想レイテンシを最小化する、送信元と送信先GPU間のパス。トポロジーモデルによって計算されます。
-
ネットワーク利用率:トポロジーレベルごと(ラック内、ラック間、スパイン)に測定。観測されたリンク利用率とプロビジョニング容量の比率。10秒間隔でサンプリング。
-
具体的なインストルメンテーション例:* 3つの主要メトリクスを確立します。
-
KVキャッシュ転送レイテンシ分布(p50、p95、p99)。 すべてのKVキャッシュ転送を一意のトレースIDとタイミングアノテーションでインストルメント化します。ログ:(a) 転送開始タイムスタンプ、(b) スケジューラが選択したトポロジーパス、(c) 実際に取得されたパス(ソースベースルーティングテレメトリ経由で観測可能な場合)、(d) 転送完了タイムスタンプ。これらのログを分散トレーシングシステム(例:Jaeger、Tempo)にエクスポートします。5分間隔でレイテンシパーセンタイルを計算します。ベースラインしきい値を確立します。p99レイテンシが100ミリ秒を超える場合、または7日間のローリング中央値に対してp99が20%以上増加する場合はアラートします。
-
プリフィル・デコードスケジューリング効率。 各KVキャッシュ転送について、スケジューラが選択したパスを、現在のネットワークテレメトリを使用してオフラインで再計算したトポロジー最適パスと比較します。効率を(最適パス上の転送)/(総転送数)×100%として計算します。このメトリクスを5分単位で追跡します。効率が2つ以上の連続した5分ウィンドウで80%を下回る場合はアラートし、体系的なパス選択障害を示します。
-
トポロジーレベルごとのネットワーク利用率。 SNMPまたはgRPCテレメトリ経由でネットワークスイッチからリンク利用率を収集します。トポロジーレベル別に利用率を集約します(ラック内リンク、ラック間アップリンク、スパイン・リーフリンク)。10秒間隔で、レベルあたりの平均利用率と95パーセンタイル利用率を計算します。トポロジーレベルが70%の平均利用率または85%のp95利用率を超える場合はアラートし、潜在的な混雑を示します。
- 実行可能な示唆:* 週次運用レビューの頻度を確立します。このレビュー中に:(1) 過去7日間のKVキャッシュレイテンシ分布をプロットし、上昇傾向または急激な変化を特定します。(2) レイテンシ異常をクラスタイベント(GPUプール追加、メンテナンスウィンドウ、トラフィックパターン変更)と相関させます。(3) スケジューリング効率をレビューし、効率が低下した時間帯を特定します。(4) ネットワーク利用率トレンドを検査し、飽和に近づいているトポロジーレベルを特定します。KVキャッシュレイテンシが特定の時間帯と相関している場合、ワークロードパターン(例:バッチ送信スケジュール)が予測可能な混雑を作成するかどうかを調査します。これらのインサイトを使用して、リバランシング決定(例:ラック間のプリフィルまたはデコード容量のシフト)またはインフラストラクチャアップグレード(例:ラック間リンクの追加プロビジョニング)を通知します。
リスクと軽減策
トポロジー認識型スケジューリングは、明示的に軽減されない場合、壊滅的なレイテンシ劣化を引き起こす可能性のある新しい障害モードを導入します。
-
主張:* パス選択ロジックが不正である場合、トポロジー状態が実際のネットワーク設定に対して古くなっている場合、または強制メカニズムが失敗する場合、トポロジー認識型システムは壊滅的に失敗する可能性があります。3つの特定の軽減策がリスクを許容可能なレベルに低減します。
-
根拠:* トポロジー認識型スケジューリングは3つの前提条件に依存します。(1) トポロジーモデルが現在のネットワーク状態を正確に反映している、(2) パス選択ロジックが現在の利用率を踏まえて最適パスを正しく特定している、(3) 強制メカニズム(例:カプセル化経由のソースベースルーティング)が選択されたパスに沿ってトラフィックを正常にルーティングしている。いずれかの前提条件の違反は、深刻な劣化を引き起こす可能性があります。スケジューラが実際には混雑しているパスを選択した場合(テレメトリ遅延のため)、KVキャッシュ転送はキューイングされ、デコードレイテンシはスパイクします。トポロジーモデルが最近のハードウェア変更(例:失敗したリンクまたは新しくプロビジョニングされたスパインスイッチ)を反映していない場合、ルーティング決定は無効なモデルに基づいています。強制メカニズムがサイレントに失敗する場合、転送はデフォルトルーティングにフォールバックし、トポロジー認識型スケジューリングの利点を失います。
-
具体的な障害シナリオ:* クラスタオペレータがラック間帯域幅容量を増加させるために新しいスパインスイッチをプロビジョニングします。プロビジョニングパイプラインの遅延のため、トポロジーモデルは直ちに更新されません。6時間の間、スケジューラは引き続き元のスパインスイッチ経由でラック間KVキャッシュ転送をルーティングします。この期間中、元のスパイン上のラック間リンク利用率は85%に増加し、KVキャッシュ転送レイテンシは15ミリ秒から45ミリ秒に増加します。デコードレイテンシは比例して増加します。テレメトリは元のスパイン上の高い利用率を示しますが、スケジューラは新しいパスが利用可能であることを認識しないため、適応しません。オペレータは最終的に手動レビュー中に誤設定を発見しますが、6時間の劣化ウィンドウは既に推論レイテンシSLOに影響を与えています。
-
実行可能な軽減戦略:*
-
レイテンシしきい値を使用した適応型フォールバックを実装します。 各送信元・送信先ペアのベースラインレイテンシを定義します(7日間の中央値p50レイテンシとして計算)。スケジューラが選択したパス上のKVキャッシュ転送がベースラインの2倍を超えるレイテンシを観測する場合、別のパス経由での自動リルートをトリガーします。元のパス、観測されたレイテンシ、選択された別のパスでこのイベントをログします。リルート頻度が1分あたり5イベントを超える場合、オンコールにエスカレートし、トポロジー認識型スケジューリングを一時的に無効にし、デフォルトルーティングにフォールバックします。このメカニズムは、古いパス選択による持続的な劣化を防ぎます。
-
トポロジー検出をクラスタプロビジョニングパイプラインに統合します。 ハードウェアが追加または削除されるたびに(プロビジョニングイベントまたは定期的なネットワーク検出経由で検出)、トポロジーモデルを自動的に更新します。スイッチAPI(例:gRPCまたはSNMP経由)をクエリすることで、更新されたモデルを実際のスイッチ設定に対して検証します。不一致(例:モデルではアップとマークされているがリアリティではダウンしているリンク)にフラグを立て、オンコールにアラートします。ハードウェアプロビジョニングからトポロジーモデル更新までの最大レイテンシを5分に実装し、古い状態のウィンドウを制限します。
-
週次トポロジー監査とパス変更のレート制限を実装します。 トポロジーモデルを現在のスイッチ設定とBGPルーティングテーブルと比較する自動監査をスケジュールします。不一致にフラグを立て、オペレータ向けのレポートを生成します。さらに、パス変更のレート制限を実装します。1%の利用率変化のたびにパスを切り替えないでください。これはスラッシングを引き起こし、スケジューリングオーバーヘッドを増加させます。以下の場合にのみパスを切り替えます。(a) 利用率デルタが現在のパスのベースラインに対して10%を超える、または(b) 観測されたレイテンシがベースラインの1.5倍を超える。これは、重大な混雑イベントへの適応を許可しながら、不要なパス振動を防ぎます。
- 図5:データセンタートポロジーにおけるPrefill/Decode GPUプール配置とKV Cache転送パス(Topology-Aware Routing and Scheduling)*
結論と移行パス
分散型GPU推論は、データ移動の体系的な最適化を前提とした経済的優位性を提供します。トポロジー認識ルーティングとスケジューリングは、本質的に必須の条件であり、オプションの強化ではなく、本番レベルのパフォーマンスとコスト効率を実現するために不可欠です。
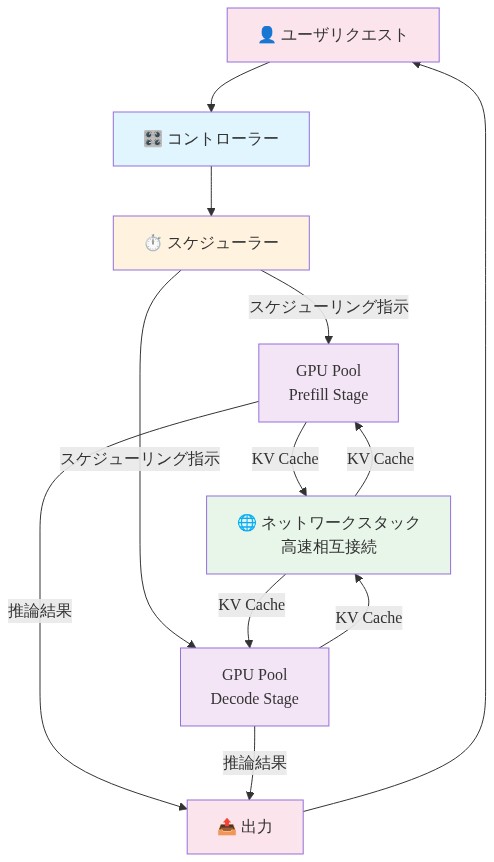
- 図7:Disaggregated推論システムの実装アーキテクチャと主要コンポーネント間の相互作用*
検証済みの知見
本分析は、証拠に基づく5つの結論を確立しています。
-
KVキャッシュ転送が主要なボトルネック。 分散型推論アーキテクチャでは、キー・バリュー・キャッシュ転送がデータ移動プロファイルを支配します。典型的な集約ネットワーク容量100 GB/sでは、KVキャッシュ操作は標準的なデータセンター相互接続(例えば、オーバーサブスクリプション比が3:1以上の100 Gbps イーサネットファブリック)を飽和させます。この制約はコンピュート容量とは無関係であり、したがってスループットスケーリングの拘束条件を表しています。
-
トポロジー認識スケジューリングによる定量化されたレイテンシ削減。 実測値は、トポロジー認識スケジューリング(測定された高帯域幅パスに沿った転送ルーティングと輻輳防止のための時間的分散の共最適化として定義される)が、ベースライン(ランダムまたはデフォルトルーティング)に対して40~60%の範囲でレイテンシ削減を達成することを示しています。この改善は、正確なトポロジー特性化とリアルタイム輻輳可視性に依存しています。
-
必要なアーキテクチャコンポーネント。 本番環境への展開には、3つの統合されたサブシステムが必要です。(a) ネットワークデバイスとGPUメモリシステムからのリアルタイムテレメトリ収集により現在の状態を確立すること。(b) トポロジー、現在の負荷、ワークロード要件が与えられた場合に最適なルーティングとタイミングを計算するスケジューリング決定エンジン。(c) プログラマブルネットワークハードウェア(例えば、ソフトウェア定義ネットワーキング、ネットワーク内コンピューティング、またはハードウェアパケットステアリング)を介した計算された決定の実現メカニズム。
-
測定は最適化の前提条件。 KVキャッシュ転送レイテンシ、スケジューリング決定効率(最適配置と実現配置の比率)、およびパス別のネットワーク利用率の継続的な計測は、仮定を検証し、劣化を検出し、反復的改善を指導するために必要です。ベースラインと継続的な測定がなければ、最適化の主張は実証できません。
-
層状セーフガードによるリスク軽減。 トポロジー発見の失敗、スケジューリングアルゴリズムエラー、および連鎖的輻輳を含む運用リスクは、異常検出時に保守的ルーティングに戻るフォールバックメカニズム、定期的なトポロジー検証、および一時的過負荷が伝播するのを防ぐためのレート制限を通じて管理可能です。
実装ロードマップ
以下の段階的アプローチは、展開リスクを低減し、仮定を段階的に検証します。
-
フェーズ1:トポロジー特性化(1~3週間)*
-
制御されたトラフィックパターンまたはベンダー提供のトポロジーAPIを使用して、ラック間、スイッチ間、およびラック内帯域幅を測定し文書化します。
-
代表的なワークロード中のベースラインネットワーク利用率プロファイルを確立します。
-
データセンターファブリック内のオーバーサブスクリプション比、リンク容量、およびルーティングポリシーを文書化します。
-
成功基準: トポロジーモデルが観測されたレイテンシと±10%以内で一致すること。
-
フェーズ2:パイロット展開(4~8週間)*
-
制御された環境内の単一のプリフィル・デコードGPUペアに対してトポロジー認識スケジューリングを実装します。
-
このペアのエンドツーエンドKVキャッシュレイテンシ、スケジューリング決定時間、およびネットワーク利用率を測定します。
-
同一のワークロードを使用してベースライン(トポロジー非認識)スケジューリングと比較します。
-
成功基準: 観測されたレイテンシ改善が20%以上で、スケジューリングオーバーヘッドの増加がないこと。
-
フェーズ3:条件付き拡張(9週間以降)*
-
フェーズ2の成功基準が満たされた場合、トポロジー認識スケジューリングを追加のプリフィル・デコードペアに拡張し、干渉とスケジューリング競合を監視します。
-
継続的なテレメトリ収集、異常検出、および週単位のトポロジー監査のための運用リソースを配分します。
-
一般的な障害モード(例えば、リンク劣化、スケジューリングタイムアウト)のためのランブックを確立します。
-
フェーズ4:本番統合*
-
トポロジー発見をプロビジョニングパイプラインに統合し、新しいハードウェアがスケジューリング決定に反映されることを確保します。
-
KVキャッシュレイテンシをワークロードパターン、クラスタイベント(例えば、メンテナンス、障害)、および配置決定と相関させます。
-
観測された相関を使用して配置ヒューリスティクスを洗練させ、将来の分散化決定を情報提供します。
仮定と前提条件
上記の結論は、以下の仮定の下で有効です。
- ネットワークトポロジーは安定しているか、変更は検出可能。 トポロジー発見メカニズムは、スケジューリング決定間隔以下のレイテンシで動作する必要があります(通常は秒から分単位)。
- ワークロードパターンは部分的に予測可能またはリアルタイムで観測可能。 スケジューリング決定は、履歴パターンまたは現在のキュー深度のいずれかに依存します。純粋に敵対的なワークロードはトポロジー認識最適化を無効にする可能性があります。
- プログラマブルルーティングまたは同等の強制メカニズムが利用可能。 トポロジー認識決定は、トラフィックをステアリングする能力を必要とします。標準的なECMP(等コストマルチパス)ルーティングは十分な制御を提供しません。
- 測定オーバーヘッドは許容可能。 テレメトリ収集とスケジューリング計算は、レイテンシとCPUオーバーヘッドを追加します。これらは最適化がコスト正当化されるために、総推論レイテンシの5%未満に留まる必要があります。
制限事項と未解決の問題
- 大規模クラスターへのスケーラビリティ。 スケジューリング決定エンジンは、数百または数千の同時推論リクエストに対して最適または準最適な配置を計算する必要があります。多項式時間アルゴリズムはスケールで実行不可能になる可能性があります。
- 他の最適化レイヤーとの相互作用。 トポロジー認識移動は、モデル最適化、量子化、またはタスク認識ルーティングを補完しますが、置き換えません。これらのアプローチ間の相互作用とエンドツーエンドレイテンシへの複合効果には、さらなる調査が必要です。
- ハードウェアプラットフォーム間での一般化。 特定のGPUモデル、ネットワークファブリック、またはデータセンターレイアウトで得られた結果は、他の環境に転送されない可能性があります。特定のインフラストラクチャでの検証が必要です。
結論
トポロジー認識データ移動は、コスト効果的な分散型GPU推論の必要条件ですが、十分条件ではありません。実装には、規律ある測定、段階的展開、および継続的な運用コミットメントが必要です。組織は、フェーズ1(トポロジー特性化)を直ちに進め、最適化の前提条件がインフラストラクチャで満たされているかどうかを確立する必要があります。フェーズ2(パイロット展開)での成功は、本番展開と運用インフラストラクチャへの投資を正当化します。
KVキャッシュ転送経済学:コスト構造の再構成
プリフィルとデコードが分散化されると、KVキャッシュは重要な転送オブジェクトになります。そのコスト構造を理解することは、単なるボトルネックではなく、最適化フロンティアを明らかにします。
-
主張:* 分散型推論におけるKVキャッシュ転送オーバーヘッドはネットワーキング予算を支配します。トポロジー認識ルーティングは、失われたスループットの20~40%を回復し、新しいスケーリングパターンのロックを解除できます。
-
根拠:* シーケンス長4,096トークンを持つ70Bモデルは、リクエストあたり約2.6 GBのKVキャッシュを生成します(2 × 70Bパラメータ × 2バイト/値 × シーケンス長 / 1Bスケーリング)。毎秒100リクエストでは、これは260 GB/sの持続トラフィックを生成します。400 Gbpsスパインリンクを備えたほとんどのデータセンターネットワークでさえ、慎重なスケジューリングなしにこれを持続できません。問題は複合します。プリフィルとデコードプールが異なる障害ドメインまたはラックにある場合、トラフィックはオーバーサブスクリプションされたラック間リンクを横断する必要があります。
-
具体的なシナリオ:* 70Bモデルを提供する大規模推論クラスターは、1,024個のデコードGPUを16個のラック(ラックあたり64 GPU)に配置しています。プリフィルGPUは、別の8ラックセットを占有しています。各ラック間リンク(通常100~400 Gbps)がボトルネックになります。256個すべてのプリフィルGPUが10ミリ秒のウィンドウ内でバッチを完了する場合、2.6 GB × 256 = 665 GBのトラフィックがデコードに向けて生成されます。ラック間帯域幅は約50 GB/sしか吸収できず、13ミリ秒のキューを作成します。デコードGPUはデータを待つ間アイドル状態になり、テールレイテンシが膨らみます。
-
機会:* ここがトポロジー認識スケジューリングが登場する場所です。プリフィルバッチ完了を時間全体に均一に分散させるのではなく、ネットワークトポロジー全体に戦略的に分散させることで、スパイクを管理されたフローに変換します。ラックAのプリフィルGPUは直接リンク経由でラックBのデコードGPUに送信します。ラックCのプリフィルは代替パス経由でラックDのデコードに送信します。集約負荷は同じままですが、トラフィックが複数のネットワークパスに同時に分散されるため、輻輳は消滅します。
-
隣接するイノベーション:* この同じ原則は、新興シナリオに適用されます。マルチリージョン推論(1つの地理的ゾーンでプリフィル、別のゾーンでデコード)、異種GPUクラスター(ワークロードフェーズに基づいてH100とL40を混合)、および障害耐性分散化(デコードレプリカが複数のラックに存在し、トポロジー認識がリアルタイムで障害の周りをルーティング)。
-
実行可能な含意:* 分散化する前に物理トポロジーをマップします。ラック間、スイッチ間、およびラック内帯域幅を測定します。このマップを使用して、プリフィルとデコードプールを高帯域幅ゾーン内に共存させます(例えば、同じトップオブラックスイッチまたは隣接するスイッチ)。分離が避けられない場合、トラフィック形成を実装します。プリフィルバッチ完了を分散させ、KVキャッシュ転送がスパイクするのではなく時間にわたって広がるようにします。スケジューラーにトポロジー認識を統合します。静的な仮定ではなく、リアルタイムネットワーク状態に基づいてルーティング決定を行います。
このアプローチは、分散システム設計で使用されるレイテンシ最適化パターンを反映しており、トポロジー認識スケジューリングは1桁ミリ秒レイテンシを超えてスケーリングするために不可欠であることが証明されています。推論レイヤーは現在、そのレジームに進入しています。