モデルだけがシステムではない
AIの効率といえば、話題はたいていモデルに集まる。アーキテクチャ、量子化の方式、アクセラレーターの世代が議論になる。
どれも大事だ。ただ、システムが1つの仕事を終えるまでに起きることのうち、これらが説明するのは一部にすぎない。
デプロイされたモデルのまわりには、コードの層がある。
モデルに何を見せるか、何回呼び出すか、いつ仕事が終わったとみなすかを決める層だ。これがハーネスである。次のような役目を担う。
- プロンプトの組み立て:システム指示、ユーザーの入力、検索で集めた資料をまとめる
- コンテキストの管理:どの履歴を残し、削り、要約するかを決める
- ツールの呼び出し:検索、コード実行、ファイルアクセスなどの機能を動かす
- リトライの制御:失敗、タイムアウト、形式の崩れた出力に対応する
- 出力の解析:モデルの文章を、構造化された動作に変える
- ループの制御:タスクがいつ終わったかを判断する
ハーネスは、生成されるトークンの数と、推論の呼び出し回数を決める。モデルの効率は、1回の呼び出しにかかるコストを決める。全体のコストは、この2つを掛け合わせたものだ。
同じモデルを動かす2つのハーネスでも、1つのタスクを終えるまでのエネルギーは大きく違うことがある。差は数倍に及ぶ場合もある。
一方のハーネスが毎ターン全文脈を送り直し、もう一方はキャッシュした先頭部分を再利用して古い内容を削っている、といった場合だ。無駄は、ベンチマークがあまり測らない場所にたまっていく。
- 変わっていない文脈を毎ターン送り直す
- タスクに必要な量よりずっと長いシステムプロンプト
- 失敗してやり直しになる、見込みで打ったツール呼び出し
- 後続のどの処理も読まない、冗長な出力
主張のもう半分は、誰が手を入れられるかという点にある。言語モデルを使う組織の多くは、モデルの重みを変えられない。データセンターのハードウェアを握っている組織も少ない。
ところが、オーケストレーションのコードは、ほとんどの組織が自分で書き、自分で管理している。現実のシステムでは、ハーネスがいちばん手を出しやすい場所になる。しかも、効果が大きい場所であることも多い。
この節のポイント
- 効率は、モデルの順伝播だけでなく、タスク全体のパイプラインにかかわる。
- 1トークンあたりのエネルギーより、1つのタスクを終えるまでのエネルギーのほうが実態に近い。リトライ、失敗、重複した呼び出しまで数えるからだ。
- ハーネスの改良は、モデルの圧縮と同じくらい、あるいはそれ以上の効果を生みうる。しかも、ほとんどの導入者に手が届く。
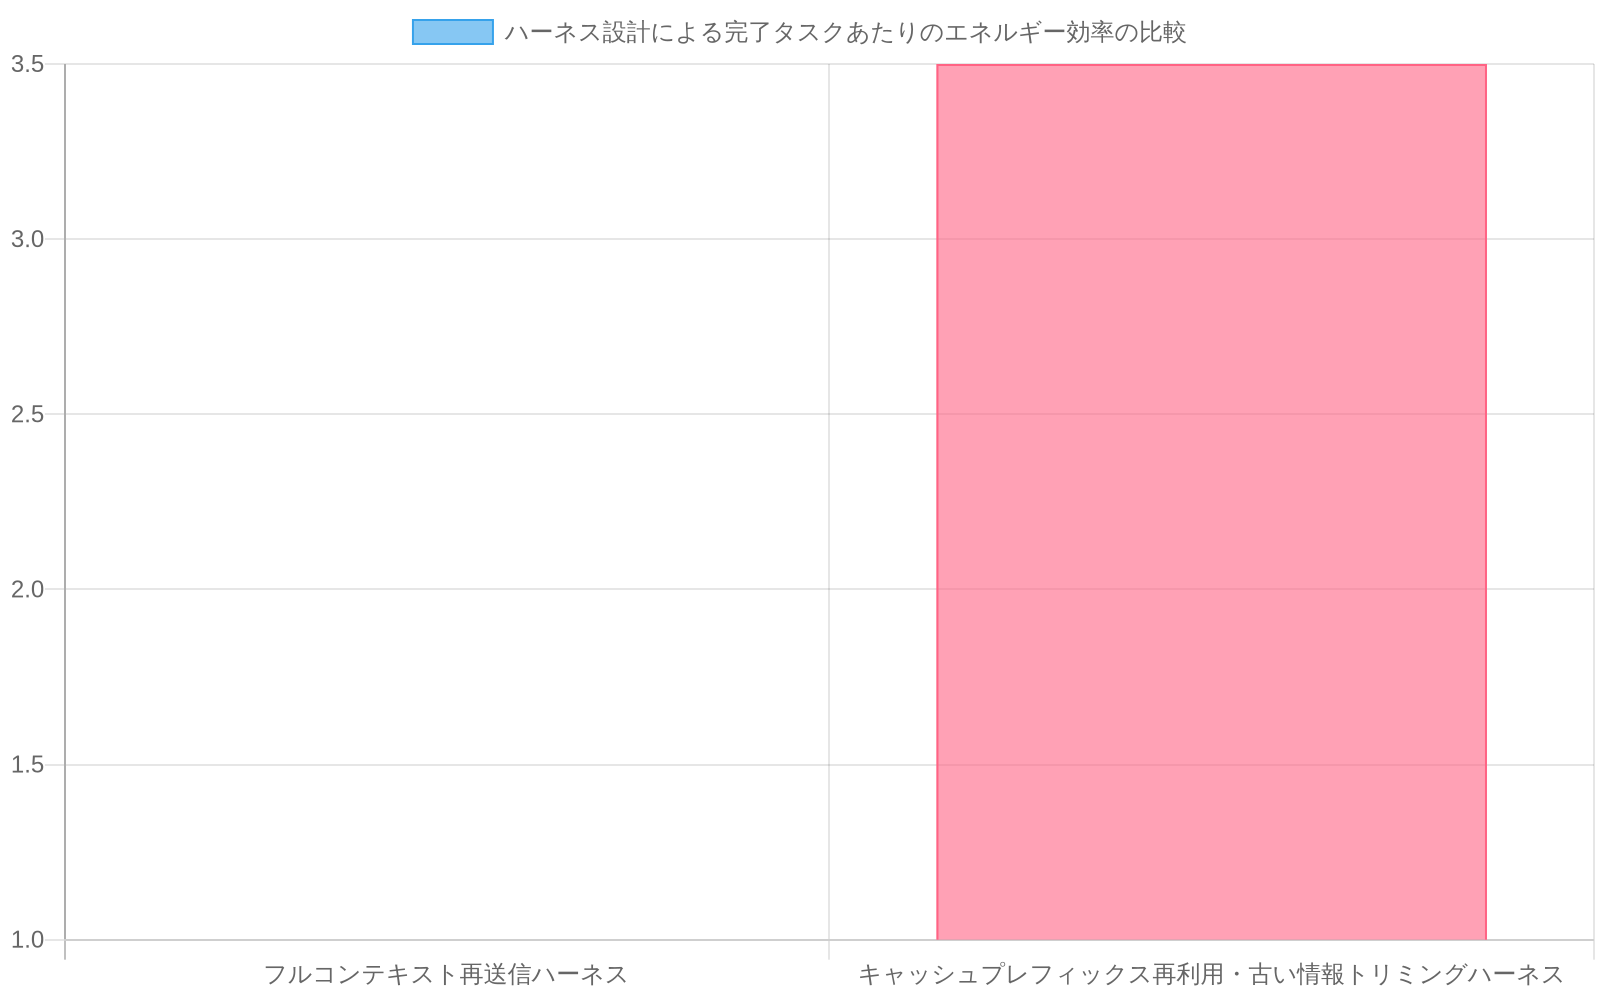
図3:ハーネス設計による完了タスクあたりのエネルギー効率の比較(キャッシュプレフィックス再利用ハーネスは従来手法比で約3.5倍の効率向上を実現)
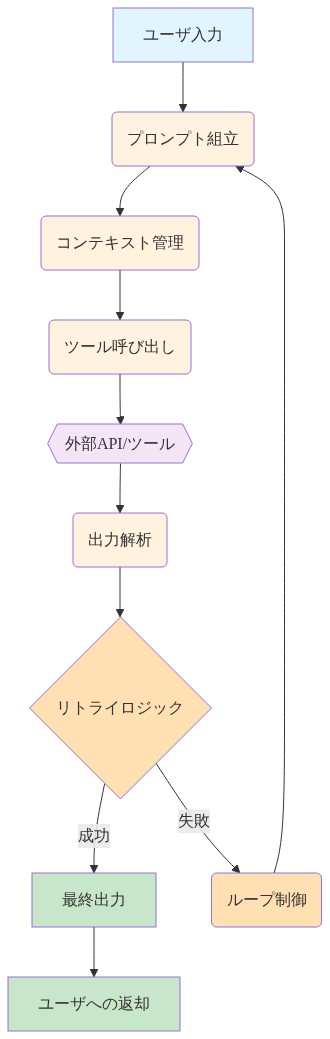
図2:ハーネスが担う6つの主要機能とデータフロー
コンテキストの手入れと、膨らみ続けるコスト
エージェント型のシステムは、ループで動く。モデルが状況を読み、行動し、結果を確かめて、また繰り返す。
1ステップごとに、それまでの会話を読み直すのが普通だ。指示、過去の行動、ツールの出力、途中の推論が、すべて含まれる。
ここで、コストが雪だるま式に増えていく。毎ターン、ほぼ一定の量の新しい内容が加わり、そのたびに履歴全体を送り直すとしよう。1セッションで処理される入力トークンの合計は、ターン数のおよそ2乗で増える。
セッションが2倍長くなれば、入力の処理コストは約4倍になりうる。各ターンが新しい情報をほとんど足さない場合でも、同じことが起きる。
増え方を抑える手段
運ぶ文脈の量を減らすために、ハーネス側でできる工夫がいくつかある。
| 手法 | 内容 | 品質へのリスク |
|---|---|---|
| 先頭が変わらないプロンプト構築 | プロンプトの冒頭を毎回同じにし、キャッシュした計算を再利用できるようにする | なし |
| 重複の除去 | 繰り返されるツール出力や指示を取り除く | なし〜ごく低い |
| 必要な部分だけのファイル読み込み | ファイル全体でなく、関係する行や節だけを読み込む | 低い(関連性の判断が正しければ) |
| 古いツール出力の削除 | タスクがもう頼っていない結果を捨てる | 中程度 |
| 履歴の要約 | 過去のターンを短い文章に圧縮する | 中〜高 |
| 長期メモリと作業用文脈の分離 | 長く使う情報をプロンプトの外に置き、必要なときに取り出す | 検索の質しだい |
情報を残すか、減らすかの綱引き
どの圧縮手法にも、同じトレードオフがつきまとう。強く圧縮すればトークンは減るが、モデルがあとで必要とする情報まで捨ててしまうかもしれない。
そうなると、モデルは前の作業をもう一度やったり、同じ情報をまた尋ねたり、リトライを招くミスをしたりする。そのどれもがトークンを消費し、節約分を帳消しにしかねない。
情報を慎重に残せば、そのリスクは避けられる。その代わり、コストはターンごとに積み上がる。どんな仕事にも合う設定はない。
最適なバランスは、タスクの長さ、序盤の情報があとでどれだけ重要になるか、失敗がどれだけ高くつくかで変わる。
もろいキャッシュ
プロンプトキャッシュには、特に注意が必要だ。壊れても気づかないうちに壊れるからだ。
多くの提供システムは、以前のリクエストと一致するプロンプトの先頭部分について、計算結果を再利用する。この一致は、たいてい完全に一致している必要がある。
ハーネスの小さな判断で、これは簡単に崩れる。
- プロンプトの先頭近くにタイムスタンプを入れる
- 呼び出しのたびに指示の順序を入れ替える
- セッションIDのような動的な内容を、固定部分より前に差し込む
- システムプロンプトの空白や書式を変える
どれか1つでも、キャッシュ済みの先頭部分は無効になる。すると、システムは呼び出しのたびにプロンプト全体を処理し直す。
エラーは出ないし、出力の品質も変わらない。増えるのは計算コストと、その裏にあるエネルギーだけだ。
無料で得られる節約と、代償のある節約
いちばん役に立つ区別は、品質にリスクがない最適化と、コストを下げる代わりに忠実さを手放す最適化とを分けることだ。
- 無料の節約:順序の固定、重複の除去、動的な内容をプロンプトの末尾に置くこと。モデルに見える情報をすべて保ったまま、コストを下げられる。
- 代償のある節約:情報が失われる要約や、強い削除。情報を減らすことでコストを下げるので、タスクの成功率への影響を測る必要がある。
先に無料の節約から手をつければ、新しい失敗の形を持ち込まずに、確かな効果が得られる。
モデルを呼ばないという判断
よく設計されたハーネスは、モデルの呼び出し1回1回を高くつくものとして扱う。判断を言語モデルに回すのは、その判断にモデルが必要なときだけだ。
エージェントがやることの多くは、実はモデルを必要としない。よくある作業の多くは、決まった手順のコードのほうが、生成モデルより速く、安く、確実にこなせる。
- ファイルから、決まった文字列やパターンを探す
- 出力を決まったスキーマに整える
- 構文や構造を検証する
- 計算をする
- テストが通るかどうかを調べる
コストの階段
こうした選択を整理する方法の1つが、コストの階段だ。上の段に行くほどコストは高くなる。だから、確実にこなせる最も低い段に仕事を寄せる。
- 決まった手順のコード:正規表現、パーサー、静的解析、直接の計算
- 小さなモデル:分類、振り分け、単純な情報抽出
- 大きなモデル:自由な推論、情報の統合、あいまいな判断
- 長い推論や複数回のサンプリングを使う大きなモデル:もっと単純な方法では歯が立たない問題にだけ使う
この階段は、止めどきにも当てはまる。テストが通った、コンパイルが成功した、といった検証でタスクの完了が確認できれば、ハーネスはループを終わらせられる。モデルに改良を続けさせる必要はない。
安い道が高くつくとき
この階段には、落とし穴もある。安い道でミスが出ると、高くつくリトライやエスカレーション、修復を招くことがあるのだ。
小さなモデルが振り分けを誤れば、リクエストは大きなモデルの上で、長くて失敗続きの道をたどるかもしれない。
正規表現が例外的なケースを取りこぼせば、壊れた入力がモデルに渡り、モデルはそれを避けるために何ターンも費やすことになる。
こうした場合、節約は見かけだけだ。1回ごとの呼び出しで見ると安く見えても、終わった仕事の単位で見ると消えている。
正しい単位
意味のある指標は、1回の推論あたりのコストではなく、1つのタスクを終えるまでのコストだ。
2つのハーネスを比べてみよう。
| ハーネスA | ハーネスB | |
|---|---|---|
| 省略したモデル呼び出し | 20% | 0% |
| タスク失敗の増加 | 5%増 | 基準 |
| 1回あたりのコスト | 平均で低い | 平均で高い |
| 完了タスクあたりのコスト | 高くなりうる | 低くなりうる |
AとBのどちらが勝つかは、失敗がどれだけ高くつくかで決まる。
失敗したタスクを最初からやり直す必要がある場合や、人が手を貸して直す必要がある場合は、失敗が少し増えるだけで、1回あたりの大きな節約が吹き飛ぶことがある。
モデルを呼ぶ回数が多くても、確実に終わらせるハーネスのほうが、効率的な場合もあるのだ。
トークンの経済は、事業の経済になる
トークンへの支出が利益率や取引先との関係を左右するようになると、効率はもう技術の細かい話ではなくなる。事業を動かす変数になる。
Replitがアンスロピックと袂を分かったと報じられた件は、AI中心のプロダクトでは、消費コストが、どの提供元とどのモデルに頼るかという戦略的な判断まで動かしうることを示している。
エージェントを軸にしたプロダクトでは、推論は脇のほうの出費ではない。プロダクトを届けるための主要なコストになりうる。
請求書の中身
コーディングエージェントは、1回のセッションで非常に多くのトークンを使うことがある。
ファイルを読み、ツールを動かし、出力を調べ、作業を直していくからだ。この過程で何トークン使うかを大きく左右するのが、ハーネスだ。そして、その量が、ある料金プランを維持できるかどうかを左右する。
ここから、「どのモデルがいちばん安いか」よりも鋭い問いが出てくる。請求書のうち、モデルの単価による分はどれだけで、ハーネスが生む量による分はどれだけか。
この2つは、必要な対応が違う。
| コストの出どころ | よくある原因 | 主な対応 |
|---|---|---|
| モデルの単価 | 選んだ提供元の、トークンあたりの料金 | 提供元との交渉、モデルの選び直し |
| ハーネスが生む量 | リトライの連発、重複したファイル読み込み、キャッシュされない先頭部分、膨らんだ文脈 | オーケストレーションの見直し |
| タスクの失敗 | やり直しや人の介入を招くエラー | 信頼性の向上、検証の強化 |
この区別がつかない組織は、目隠しで交渉しているようなものだ。問題が自分のオーケストレーションのコードにあるのに、提供元を乗り換えてしまうかもしれない。
あるいは、必要のないモデルに高い料金を払いながら、ハーネスだけを磨くことにもなりかねない。
金額とエネルギーはずれる
金銭のコストとエネルギーのコストは、関係はあっても同じものではない。
- キャッシュされたトークンは、割引価格で請求されることが多い。それでも提供システムはある程度の処理をするので、エネルギーの減り方が、値引きの幅と一致するとは限らない。
- バッチ料金は、提供元が処理の時間を柔軟に決められる代わりに、コストを下げる。計算そのものは行われる。消費電力は、請求額ほどには下がらない。
- オフピークや地域による料金は、電力網の状況、設備の余裕、事業上の戦略を反映していることがある。そのため、エネルギー使用量との結びつきは一定ではない。
請求額だけに合わせて調整したハーネスが、エネルギーを最小にするとは限らない。逆も同じだ。
両方を気にするチームは、両方を追いかける必要がある。価格の信号は、エネルギーの信号の代わりにはならないからだ。
ハーネスとモデル圧縮の関係
ハーネスの最適化は、低いレベルの効率化と競い合うものではない。それを何倍にもするものだ。
量子化や圧縮の技術は、メモリの必要量を減らし、演算を速くし、モデルをより小さなハードウェアで動かせるようにして、順伝播1回あたりのコストを下げる。
ハーネスは、順伝播が何回起きるか、1回の文脈がどれだけ長くなるかを減らす。全体のコストは両方で決まるので、効果は掛け合わさる。1
この節のポイント
- ハーネスと圧縮の効果は影響し合う。別々に最適化するより、一緒に調整したほうが良い結果が出る。
- ハーネスは、スケジューラーとして働ける。タスクの難しさ、待てる時間、残りの予算に応じて、ふさわしいハードウェアの層にリクエストを振り分ける。
- 端末の温度やネットワークの状態といったシステムの信号が、どこで処理するかの判断に役立つ。
足し算では済まない関係
この2つの層は、完全には独立していない。効果は影響し合い、その影響が最適な設定を動かすことがある。
- 強く量子化されたモデルは、強い文脈の圧縮にあまり耐えられないかもしれない。圧縮によって、足りない情報を推測する力が落ちていれば、要約された履歴は、精度を落としていないモデルよりも多くのミスを招きうる。
- 圧縮されて1回あたりが安くなったモデルなら、呼び出し回数を増やすハーネスにも見合うことがある。たとえば、大きなモデルでは高すぎて使えない検証のステップを入れられる。
- 有効な文脈の窓が短い小さなモデルは、うまく動かすだけでも、文脈をより慎重に手入れする必要がある。
実務への結論はこうだ。ハーネスの方針とモデルの選択は、一緒に調整するのがいちばんよい。あるモデルに合わせて調整したハーネスが、その圧縮版には合わないこともある。
スケジューラーとしてのハーネス
処理する場所を選ぶことも、もう1つの軸になる。端末上、エッジ、クラウドの層から温度を見ながら選ぶ経路制御のシステムは、推論をどこで走らせるかそのものが、効率にかかわる判断であることを示している。2
この判断をするのに、ハーネスは自然な場所だ。下の層にはない情報を持っているからだ。
- タスクの難しさ:大きなモデルが必要か、小さなモデルで足りるか
- 待てる時間:ユーザーが待っているのか、バックグラウンドで動くタスクなのか
- 残りの予算:どれだけ使い、どれだけ残っているか
システムの信号と組み合わせると、ハーネスは、さまざまなハードウェアにまたがるスケジューラーとして働ける。役に立つ入力には、次のようなものがある。
- 端末の温度(端末上で性能を保ち続けられるかに響く)
- モバイル端末やエッジ端末のバッテリーの状態
- 層と層のあいだのネットワークの状態
- 電力網の状況(クラウドで推論する地域の電力の炭素強度など)
こう見ると、ハーネスは、1つのモデルを包むだけのものではない。コスト、速度、エネルギーの特性がそれぞれ違うさまざまな計算資源に、仕事を割り振る役目を持っている。
本当に測るべきもの
いまのリーダーボードは、ほとんどが精度に報酬を与える。その精度に届くまでに使った資源は、ほぼ無視されている。すると、力任せに問題を解くハーネスを作る動機が生まれる。
繰り返しのサンプリング、長い推論の連鎖、何度もの検証を重ねるハーネスだ。こうしたハーネスは、精度のランキングで首位に立てるかもしれない。
しかし、わずかに低いスコアの代替案より、はるかに多くの計算を使っていることがある。
この節のポイント
- 精度だけでは、そこへ届くまでのコストが見えない。コストと品質のフロンティアを描くと、実際の運用で重要なトレードオフが見えてくる。
- API経由で提供されるモデルには、標準的な電力計測の仕組みがない。そのため、トークン数がエネルギーのいちばん現実的な代わりの指標になる。
- 再現できる計測には、固定した乱数シード、複数回の実行、設定の公開、成功と資源使用の両方の透明な報告が必要だ。

表1:システム効率を評価するための主要指標一覧
コストと品質のフロンティア
もっと多くを教えてくれる評価は、ハーネスをコストと品質のフロンティアの上に置くものだ。成功率を、資源の指標に対してプロットする。
- タスクあたりに消費したトークン数
- タスクあたりの実時間
- タスクあたりの実測エネルギー(得られる場合)
こうすると、精度という1つの数字が隠してしまうトレードオフが見えてくる。あるハーネスは、あるコストで成功率92%に届く。
別のハーネスは、3倍のコストで94%に届く。どちらが良いかは、運用の条件によって決まる。
標準的な計測が難しい理由
思ったより難しい理由は、いくつかある。
- API経由のモデルには、標準的な電力計測がない。 ホスト型のモデルを使うチームは、たいてい自分のリクエストが使うエネルギーを測れない。トークン数のような代わりの指標に頼ることになる。
- 軌跡が毎回同じとは限らない。 エージェントは、同じタスクでも、実行のたびに違う道をたどることがある。1回の実行からは、普段の振る舞いがほとんど分からない。
- 設定が見えない。 公表された結果には、リトライの上限、文脈の方針、使うツールの組といったハーネスの詳細が載っていないことが多い。他の人が再現も比較もできない。
再現できる計測をつくる
良いやり方は、それぞれの障害に対応している。
- システムが許す範囲で、乱数シードを固定する。
- 各タスクを何度か実行し、平均だけでなく分布も報告する。
- 結果と並べて、ハーネスの設定を公開する。
- 精度の隣に、トークン数と、可能ならエネルギーの測定値も載せる。
狙いは、1つの指標を最適化することではない。トレードオフの全体を見えるようにして、各チームが自分たちの制約に合う運用点を選べるようにすることだ。
いまチームにできること
いまエージェント型のシステムを動かしているチームに向けて、ここまでの分析から導ける行動をいくつか挙げる。
- タスクごとの会計を入れる。 月ごとの総額だけでなく、完了したタスクごとに、トークン、呼び出し回数、可能ならエネルギーを記録する。
- コストを行動に結びつける。 リトライ、重複した読み込み、キャッシュミス、失敗したツール呼び出しなど、原因ごとに支出にタグを付ける。そうすれば、ハーネスの無駄を、モデルの単価と切り分けられる。
- プロンプトの安定性を点検する。 システムプロンプトと固定の文脈が、呼び出しのたびにバイト単位で同一か確かめる。動的な内容は末尾に置く。
- リスクのない最適化から始める。 情報が失われる要約を試す前に、重複の除去と順序の固定を済ませる。変更のたびに、タスクの成功率を測る。
- フロンティアで評価する。 ハーネスのバージョンは、精度だけでなく、成功率と完了タスクあたりのコストで比べる。
ちょっと立ち止まって
効率というと、どこか遠くで起きていることのように思えてくる。チップの工場、研究所、データセンターの冷却設備といった場所だ。
ハーネスは、その一部をずっと身近な場所に置いてくれる。ごく普通のコードの中にある。
プロンプトの並べ方、ファイルを読む長さ、ループを止める判断。そういうものだ。
すると、責任はどこにあるのか、という静かな問いが出てくる。
同じモデルが同じ仕事をしても、そのまわりのコードしだいでコストが大きく変わるなら、効率は技術だけの性質ではない。それを使って作る人たちが重ねる、たくさんの小さな判断の表れでもある。
あなたがAIを使うとき、あるいは作るとき、効率はモデルの性能表のどこかに書いてあるものだと思っていないだろうか。自分の手元のコードや使い方の中に、実は動かせる部分が残っているのかもしれない。
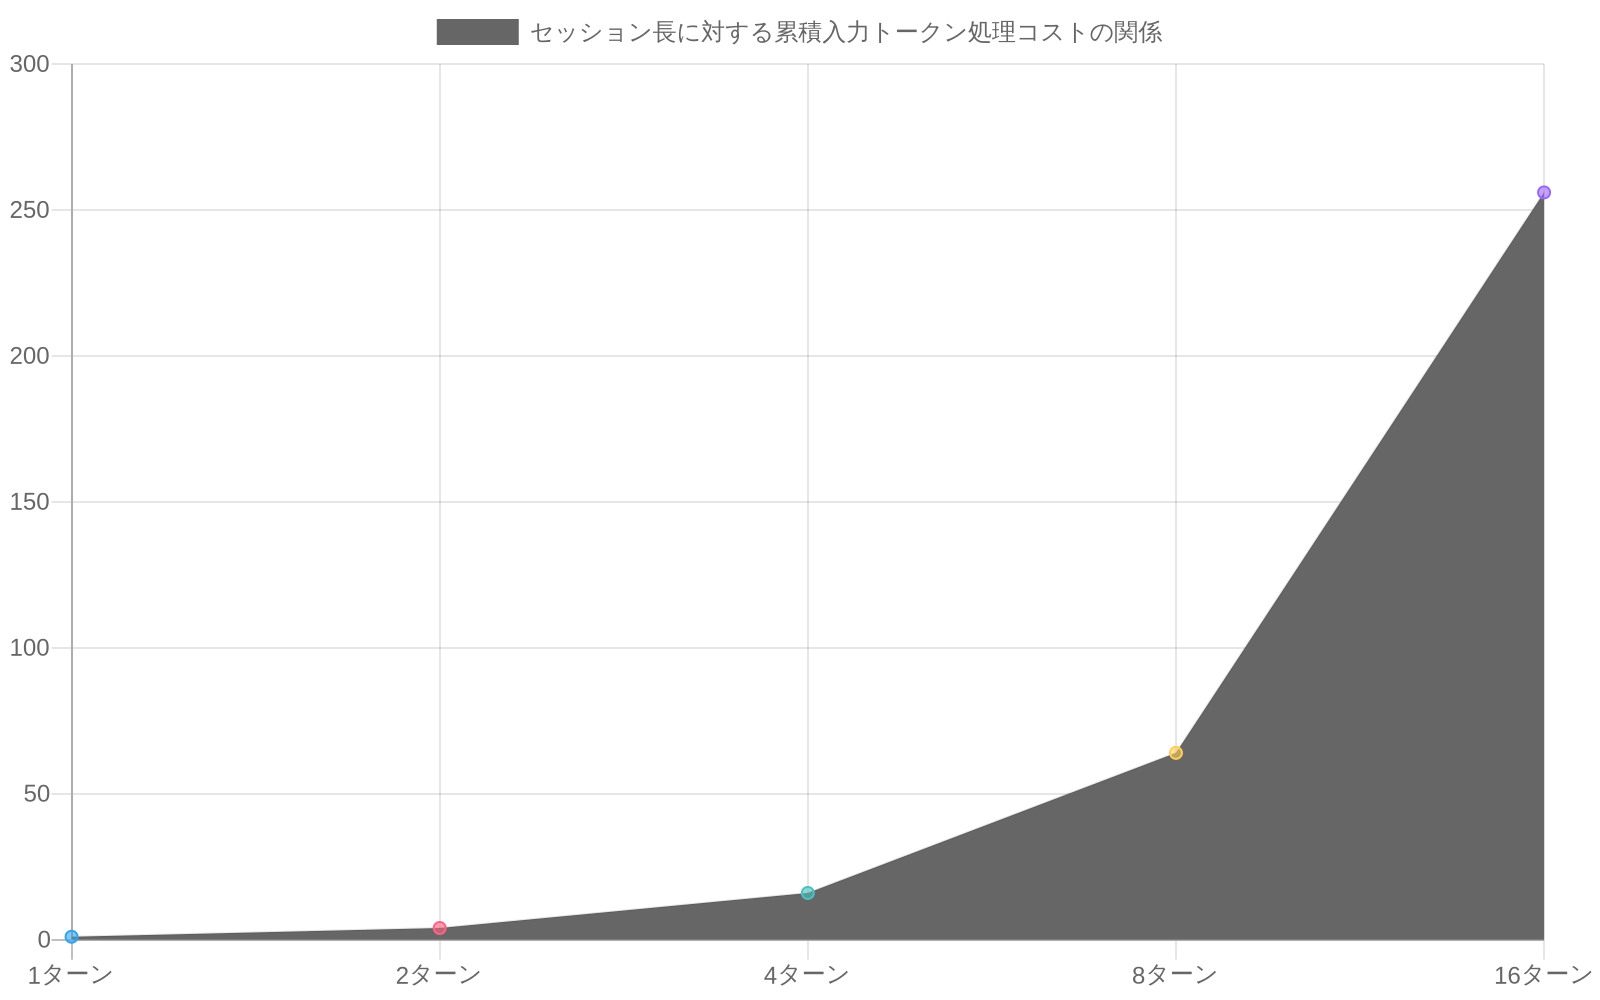
図5:セッション長に対する累積入力トークン処理コストの二次関数的成長(出典:記事本文「grow roughly quadratically」の記述に基づく)
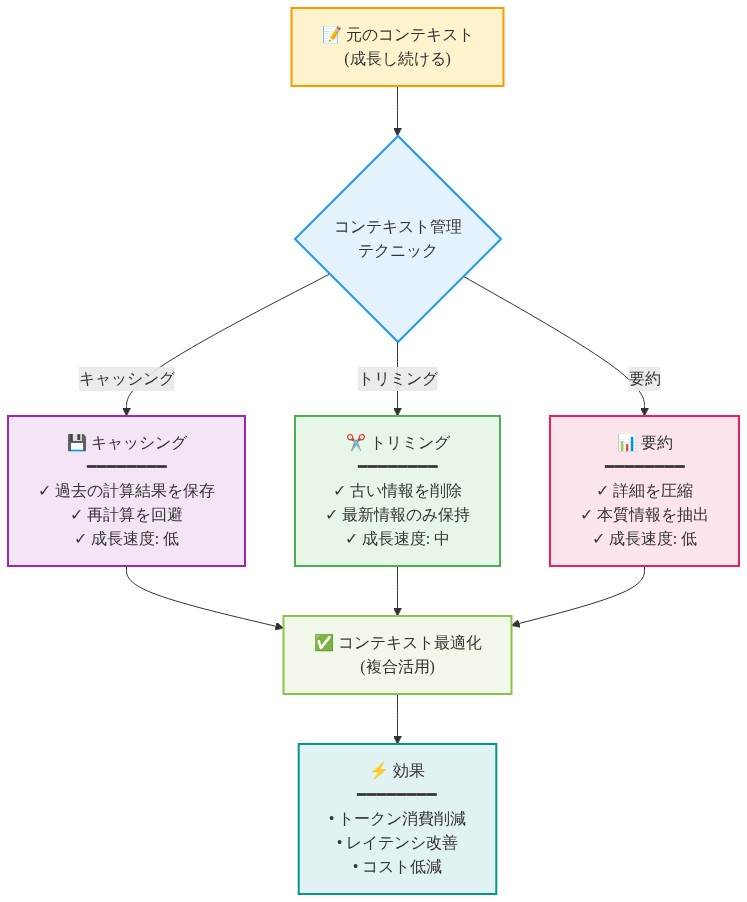
図6:コンテキスト成長を抑制するハーネステクニックの比較
図8:トークン経済からビジネス経済への変換メカニズム(トークン経済指標とビジネス成果の相関関係)