サービスのAPIを呼んでいるのは、もう人間ではないかもしれない。自分で書いたスクリプトでもない。他社のAIアシスタントだ。
たとえば、ユーザーがMuseやInstinctのような、中身の見えない消費者向けアシスタントに頼みごとをしたとしよう。
アシスタントは、どのツールを呼ぶか、どんな引数を送るか、呼び出しに失敗したらどうするかを自分で決める。
サービスを作ったチームには、その判断の中身が見えない。それでも、ユーザーにとってサービスが役に立つかどうかは、その呼び出し役が握っている。
この溝を埋めようとするのが、CATT(Consumer Agent Testing Tool)だ。作った人たちはHacker Newsで、オープンソースのプロジェクトとして紹介した。
目的は「MuseやInstinctのような独自仕様のアシスタントを相手に、チームが改良を重ねるのを助けること」だという。
作った理由も語っている。「これらのエージェントに使ってもらうMCP/APIを作るときの、自分たち自身の苛立ちを減らすため」だそうだ。主な不満は「これらのツールを相手にしたテストは難しい」の一言に尽きる。
考え方はこうだ。MuseやInstinctのようにふるまう代役を用意し、自分のエージェントやサービスをそれに対してテストする。そのテストを、継続的インテグレーション(CI)の中で動かす。
バージョンは0.2.1で、まだ初期のリリースだ。自分のチームに合うかどうかは、いくつかの問いで決まる。以下、順に見ていく。
この記事のポイント
- 閉じたアシスタントが主な呼び出し役なら、中身を見ることも固定することもできない相手と連携することになる。
- 公開ベンチマークはモデル全般の話で、自社のスキーマを正しく読むかどうかは分からない。
- CIで動く代役は、固定した基準点になる。本物のアシスタントでの確認の代わりにはならない。
今、サービスを呼んでいるのは誰か
MuseやInstinctのような独自仕様の消費者向けアシスタントが、多くのサービスとユーザーのあいだに入り始めている。
サービス側のチームはアシスタントの判断を何も操作できないのに、その判断しだいで製品が使われるかどうかが決まる。
典型的なリクエストの流れは、次のようになる。
- ユーザーがアシスタントに何かを頼む。
- アシスタントが、呼ぶツールを選ぶ。
- アシスタントが、送る引数を決める。
- 呼び出しに失敗したときの動きも、アシスタントが決める。
サービスを作ったチームは、この流れを見られない。見えるのは、自分たちのエンドポイントに届いたものだけだ。
CATTが生まれた理由
CATT(Consumer Agent Testing Tool)は、この溝を埋めるためのものだ。作った人たちはHacker Newsで、オープンソースのプロジェクトとして紹介した。
目的は「MuseやInstinctのような独自仕様のアシスタントを相手に、チームが改良を重ねるのを助けること」だという。
きっかけは、自分たちの仕事にあった。本人たちの言葉では、「これらのエージェントに使ってもらうMCP/APIを作るときの、自分たち自身の苛立ちを減らす」ために作ったそうだ。
主な不満は「これらのツールを相手にしたテストは難しい」の一言に尽きる。
バージョン0.2.1が教えてくれること
バージョン番号には意味がある。これは、業界がようやく名前をつけ始めた問題への、初期の挑戦だ。
やり方は説明しやすい。
MuseやInstinctのようにふるまう代役を用意し、自分のエージェントやサービスをそれに対してテストする。そのテストを、コードを変えるたびに自動で走る検査、つまり継続的インテグレーション(CI)の中で動かす。
自分のチームに合うかどうかは、いくつかの問いで決まる。以下、順に見ていく。
困っているのは「テストの難しさ」か、「慣れていないだけ」か
最初にやることは、いまの悩みが生成AI一般の予測しにくさなのか、もっと特有のものなのかを見分けることだ。閉じたアシスタントにサービスを公開するチームでは、4つの難しさが重なりうる。
次の表は、それぞれの難しさと、テストの邪魔になる理由をまとめたものだ。
| 難しさ | 現れ方 | なぜ困るか |
|---|---|---|
| 結果のばらつき | 同じ依頼でも選ぶツールや引数が変わる | 1回通っても、分かることは少ない |
| 見えない思考 | 呼び出しは見えるが、理由は見えない | 原因探しが当て推量になる |
| 気づかないうちのずれ | ベンダーが知らせずにモデルやプロンプトを変える | 動いていた連携が、いつのまにか劣化しうる |
| 現実的な制約 | 消費者向け製品のアクセス規則、費用、速度 | 自動テストが壊れやすい |
普通のやり方で足りるとき、足りないとき
当てはまるのが1行目だけなら、標準的な評価で足りるかもしれない。同じシナリオを何度も動かして、成功する割合を測ればよい。
4つすべてに当てはまるなら、話が変わる。テスト対象を操作できない。判断の中身も見えない。
じっとさせておくこともできない。しかも、安く何度も呼べるとは限らない。
ベンダーのベンチマークでは決着がつかない理由
独自のMuseモデルを評価するときにも、公開ベンチマークと実際の使い心地を見比べる必要がある。この2つは、いつも一致するとは限らない。詳しくはMuse Wonder Puts Meta’s Aggressive AI Push in Focusで扱っている。
外部のサービスでは、このずれがさらに大きくなる。自社のサービスは、アシスタントが呼べる多くのツールの1つにすぎない。そのスキーマは、ほかのスキーマやベンダー自身の指示と並んで置かれる。
ベンチマークの点数からは、アシスタントが自社のエンドポイントを選ぶかどうかも、date_rangeパラメーターを意図どおりに埋めるかどうかも分からない。
自分はどちら側にいるのか
分かれ目は、自社のサービスがいつ呼ばれるかを誰が決めているかだ。
- 呼び出し役が分かっていて、台本どおりに動く場合:従来の契約テストで、おそらく足りる。
- 呼び出し役が閉じたアシスタントの場合:ベンダーのベンチマークや、本番製品へのアクセスだけに頼らない、自前のテストが要る。
CATTのようなツールの出番は、後者だ。
再現するのはモデルか、それを包むハーネスか
代役は、独自仕様のモデルそのものは写せない。写せるのは、モデルを包むコードの層だ。連携の問題の多くは、この層から始まる。
「Muse/Instinct-alike」という言葉には、すぐ思いつく疑問がつきまとう。閉じたモデルは、ベンダーの外の誰にも再現できない。では、代役は何の役に立つのか。
連携が壊れやすい場所
モデルは、ハーネスの中に置かれている。ハーネスとは、モデルを包むコードの層のことだ。エージェントの振る舞いも、かかる費用も、この層が形づくる。
プロンプト、ツールの見つけ方と選び方、再試行の仕組み、コンテキストウィンドウ(モデルが一度に扱える範囲)の管理などが含まれる。
この点はWhy harnesses matter for energy (and token) efficiencyで詳しく論じた。そこでの話は効率についてだった。
連携する側の正しさにも、同じ理屈があてはまる。ハーネスが、モデルに何を見せるかと、モデルが動いたあとに何が起きるかを決めるからだ。
消費者向けアシスタントがサービスをうまく扱えないとき、原因として確かめる価値があるハーネスの挙動は、次のとおりだ。
- ツールの並び順:リストのどこにツールが載るかで、選ばれる頻度が変わりうる。
- 説明文の切り詰め:スキーマの説明の一部しか収まらないと、大事な制約が切れた側にあるかもしれない。
- エラーの伝え方:エラーメッセージをモデルに返すハーネスもある。握りつぶしたり、一般的な失敗の表示に置き換えたりするものもある。
- 再試行の回数:1回の失敗でやめるアシスタントと、引数を直して3回やり直すアシスタントでは、動きが違う。
- 複数ステップのつなぎ方:ある呼び出しの結果のIDが次の呼び出しに渡るかどうかは、ハーネスが途中結果をどう整えるかで決まる。
これらの再現に、独自仕様の本物の重みは要らない。こうした特徴をまねた代役なら、MuseでもInstinctでもないのに、本物の連携バグを表に出せる。
代役はどこまで本物に近づけるべきか
役に立つ近さは、汎用の構成と完全なコピーのあいだにある。次の表は、その幅にある3つの地点を比べたものだ。
| 方法 | 得られるもの | リスク |
|---|---|---|
| 単純すぎる(汎用モデルと自社ツール) | 速くて安いテスト | 本物なら失敗することが通ってしまう |
| 完全な複製 | 理屈の上では完全な網羅 | 終わらない。相手は閉じていて変わり続ける |
| 狙いを絞った模倣 | ツールの発見、引数、つなぎ、失敗時の扱い | モデル固有のくせは写せない |
現実的なのは、真ん中の行だ。見えない部分が残ることは認めたうえで、上に挙げたハーネス層の失敗を押さえにいく。
固定された基準点
シミュレーターには、目立たないもう1つの利点がある。自分で管理できる基準点になり、こちらが変えない限り変わらない。
本物のアシスタントは、そうは約束してくれない。ベンダーは、ある日突然、新しいルーティングの方針を出せる。連携する側には知らされない。
固定した代役があれば、「うちの連携は悪くなったのか」という問いに答えが出せる。 昨日通ったテストが今日は落ち、シミュレーターは変わっていないとする。その場合、原因はこちらの側にある可能性が高い。
ただし条件が1つある。シミュレーター自身が大規模言語モデル(LLM)を呼んでいるなら、そのモデルのバージョンとサンプリング設定も固定する必要がある。
そうしないと、実行ごとのばらつきが、性能の悪化に見えてしまう。
シミュレーターが役に立つとき、立ちにくいとき
代役がどれだけ役に立つかは、よく起きる失敗の種類しだいだ。
- ツールの選び方、引数の形、エラーからの立て直し:ハーネス層の模倣が得意とする領域だ。
- モデル固有の細かい推論:専門分野の言葉の微妙な読み取りなどがそうだ。ここではシミュレーターの助けが小さくなり、本物のアシスタントでの確認が担う部分が大きくなる。
代役の忠実さは、どこまで要るのか
ちょうどよい忠実さは、真ん中にある。足りなければ偽りの安心が生まれ、やりすぎれば終わらないプロジェクトになる。
次の表は、3つの方法を比べたものだ。
| 方法 | 得られるもの | リスク |
|---|---|---|
| 単純すぎる(汎用モデルと自社ツール) | 速くて安いテスト | 本物なら失敗することが通ってしまう |
| 完全な複製 | 理屈の上では完全な網羅 | 終わらない。相手は閉じていて変わり続ける |
| 狙いを絞った模倣 | ツールの発見、引数、つなぎ、失敗を押さえる | モデル固有のくせは写せない |
狙いを絞った模倣は、見えない部分が残ることを受け入れる。その代わり、いちばん起きやすい失敗はきちんと押さえる。
自分で管理できる固定点
あまり目立たないが、もう1つ利点がある。シミュレーターが変わるのは、こちらが変えたときだけだ。
本物のアシスタントは、それを約束できない。ベンダーは、何でもない午後に新しいルーティングの方針を出せる。
固定した代役があれば、「うちの連携は悪くなったのか」に答えが出せる。昨日通ったテストが今日は落ち、シミュレーターは変わっていないとしよう。それなら、性能の悪化はこちらのコードの中にある。
シミュレーターが役に立つとき、立たないとき
代役がどれだけ役に立つかは、見かける失敗の種類しだいだ。
- ツールの選び方、引数の形、エラーからの立て直し:ハーネス層の模倣で、ほとんどは見つけられる。
- モデル固有の細かい推論:専門分野の言葉の微妙な読み取りを思い浮かべてほしい。ここではシミュレーターの助けは小さい。本物のアシスタントでの確認が、より多くを担う。
エージェントとの相性チェックは、CIで続けられるか
エージェントのテストをときどき手で走らせるのと、プルリクエストのたびに走らせるのとでは、難しさが違う。CATTが想定しているのは後者だという。すると、テストの書き方から変わってくる。
ふつうのCIは、同じ入力なら同じ結果になると考える。テストは通るか落ちるかで、落ちたら何かが壊れたことを意味する。
エージェントは、そうは動かない。同じことを2回頼んでも、答えが違うことがある。だから、1回の失敗はただのノイズかもしれない。
1回の成功も、ただの運かもしれない。
エージェントの検査では、1回の実行は弱い証拠にしかならない。
エージェントの検査をCIに入れるチームは、たいてい次の5つの点でテストのやり方を変える。
- シナリオごとに複数回実行する:同じシナリオを何度も動かし、1回の変な結果で勝ち負けが決まらないようにする。
- しきい値つきの成功率を使う:テストは「10回中9回以上、正しいツールが選ばれた」のように読める形にする。数字は一例で、決めるのは各チームだ。
- 文面の一致は見ず、振る舞いを確認する:正しいツールを選んだか、引数がスキーマに合っているか、呼び出しで作業が終わったかを問う。出力の文字列まで一致を求めると、壊れやすすぎる。
- 正しさと一緒にコストも記録する:タスクごとに、使ったトークン(AIが処理する文字の単位)と呼び出し回数を残す。
- マージを止める前に失敗を仕分ける:明らかな失敗と、成功率の小さなずれを分けて扱う。
2つ目の点には注意がある。実行回数が数回しかないと、本当の低下とただの偶然を見分けにくい。
1シナリオあたりの回数を増やすほど、はっきり分かるようになる。その分、費用も増える。
スキーマの変更にこそ目を配る
いちばん危ないのは、害がなさそうに見える変更であることが多い。レビューする人が、うっかり承認してしまいそうな例を挙げる。
- パラメーター名の変更:たとえば
qをqueryにする。 - ツールの説明文の書き直し:読みやすくするための変更だ。
- 広いエンドポイントの分割:1つを、より狭い2つに分ける。
どの場合も、壊れたようには見えない。型は合っているし、単体テストも通る。それでも、これらの変更はどれも、エージェントが選ぶツールや、引数の埋め方に影響しうる。
CIの検査なら、これを見つけられる。差分がツールの説明文に触れたら、そのツールを使うシナリオを走らせる。
エージェントが正しいツールを選ぶ回数が減っていれば、マージの前にレビューする人がその低下を目にできる。
余分な呼び出しも「性能の悪化」だ
模倣したハーネスなら、タスクにどれだけ手間がかかるかも測れる。たとえば、スキーマの変更で、1タスクあたりの呼び出しが平均2回から5回に増えたとしよう。失敗したテストはない。
それでも、往復が1回増えるたびに、トークンと時間がかかる。エージェントが間違える機会も、1回増える。
シナリオごとに呼び出し回数とトークン数を数えれば、この見えにくいコストが、レビューする人にも見える数字になる。
ノイズだらけのテストを無視させない
最大の危険は、false alarm、つまり誤報だ。誤報が多すぎるテストは、信用されなくなる。やがて、誰も結果を読まなくなる。
2種類の失敗には、それぞれ違う扱いが合う。次の表は、その目安だ。
| 失敗の種類 | 例 | 扱いの目安 |
|---|---|---|
| 明らかな失敗 | 引数がスキーマ検証に通らない | マージを止めてよい |
| 小さなずれ | 成功率が少し下がる | 警告として知らせる |
信号を信頼できる状態に保つ習慣が、いくつかある。
- 実測にもとづく基準:チームの期待値は使わず、実測した成功率からしきい値を決める。
- 自動の再実行:ぎりぎりの結果は、誰かに知らせる前にもう一度走らせる。
- 定期的な見直し:しきい値を折に触れて確かめ、古くならないようにする。
検査をどれだけの頻度で走らせるかは、インターフェースがどれだけ変わるかで決まる。
- スキーマや説明文をよく変える場合:プルリクエストごとに検査すれば、原因となった変更のすぐそばで問題が見つかる。
- 安定していて、ほとんど触らない場合:夜間や週1回の実行で、ノイズを抑えつつ、効果の大半が得られるかもしれない。
小さなスキーマ変更が、いちばん大きな驚きを生む
テストする価値がいちばん高いのは、害がなさそうに見える変更だ。壊れたように見えないので、コードレビューをすり抜ける。
典型的な例を挙げる。
- パラメーター名の変更:
qをqueryに変える。 - 説明文の書き直し:読みやすくなるように、ツールの文面を直す。
- エンドポイントの分割:広い1つを、狭い2つにする。
どの場合も、型は合っていて、単体テストも通る。それでも、こうした修正はどれも、エージェントが選ぶツールや、引数の埋め方を変えうる。
この種の気づきにくい破損を見つけられるのが、CIだ。 差分がツールの説明文に触れたら、そのツールを使うシナリオを動かせる。選ばれる割合が下がれば、ユーザーより先にレビューする人が気づける。
余分な呼び出しも「性能の悪化」だ
模倣したハーネスは、本物のアシスタントがほとんど見せてくれないものも見せてくれる。タスクを終えるのに、どれだけ手間がかかるかだ。
たとえば、スキーマの変更で、1タスクあたりの呼び出しが平均2回から5回に増えたとする。厳密には、何も失敗していない。しかし、往復が1回増えるたびに、代償がある。
- トークン:呼び出しのたびに、請求額が積み上がる。
- 待ち時間:ユーザーが待つ時間が延びる。
- リスク:ステップが増えるたび、エージェントが間違える機会も増える。
シナリオごとに呼び出し回数とトークン数を追えば、連携の質が、ハーネスの設計を左右する効率の問題とつながる。
ノイズだらけのテストを無視させない
CIでのエージェントテストにとって、最大の危険は見逃しよりも誤報だ。誤報が多すぎると、人はテストに注意を払わなくなる。
信号を信頼できる状態に保つ工夫が、いくつかある。
- 実測した基準:しきい値は、願望ではなく観測した結果から決める。
- まずは明らかな失敗だけ:最初は、再現できる失敗だけがマージを止める。統計的なずれは警告として出す。
- 自動の再実行:ぎりぎりの結果は、誰かに知らせる前にもう一度走らせる。
- 定期的な見直し:しきい値を定期的に確かめ、知らないうちに古くならないようにする。
検査をどれだけの頻度で走らせるかは、インターフェースがどれだけ変わるかで決まる。次の表は、2つの場合を比べたものだ。
| チームの状況 | 合いそうなやり方 |
|---|---|
| スキーマや説明文をよく変える | プルリクエストごとにエージェントテスト |
| 安定していて、ほとんど触らない | 夜間か週1回の定期実行 |
インターフェースの変更が多いチームなら、プルリクエストごとの検査はすぐに元が取れる。安定したインターフェースなら、定期実行でも、ノイズをかなり減らしながら効果の大半が得られるかもしれない。
ちょっと立ち止まって
自分のサービスを呼ぶのは、仕様書どおりに動く相手だと、どこかで思っていないだろうか。実際には、AIアシスタントがこちらの説明文を読み、そのたびに自分で判断している。
「うちの連携は動いている」という言葉は、いつの時点の、どの相手について言えることなのだろう。昨日通ったテストは、今日のアシスタントにも通じると言えるだろうか。
エージェントのための設計か、シミュレーターのクセに合わせた設計か
チームがエージェントのサービス利用の出来を測れるようになると、その数字に合わせて調整したくなる。そこで考えておきたいのは、何に向けて調整しているのかという点だ。
分かりやすい設計なのか、それとも1つのテストツールのクセなのか。
この引力は、すでにウェブのあちこちで見えている。サイトやサービスは、AIエージェントを中心にAPIやアクセス制御を作り替えている。
ときには人間のユーザーが割を食うこともある。Making the internet better for AI agents might make it worse for everyone elseは、この動きをたどっている。
エージェント向けのテストツールは、この流れを加速させる。連携する側にとっては、たいてい good news だ。
ただ、ここで1つ設計の問いが生まれる。読み手がモデルのとき、よいインターフェースとはどんな形だろうか。
モデルがツールを読みやすくする設計のクセ
次の表は、よく知られたインターフェースの習慣と、それがエージェントの役に立ちそうな理由をまとめたものだ。どれも広く共有されている経験則にすぎない。草稿の出典は、その効果を測っていない。
| 習慣 | エージェントに役立ちそうな理由 |
|---|---|
| 区別しやすいツール名 | 似たツールと取り違えにくい |
| 重要な制約を説明の冒頭に置く | 説明が途中で切れても見える |
| 目的を1つに絞った細いエンドポイント | 混同しやすいパラメーターが減る |
| 形式と例をはっきり示す | 日付、ID、単位を推測せずに済む |
| 直し方が分かるエラー | エラーを見たモデルが軌道修正できる |
このうち多くは、人間の開発者にも役立つ。分かりやすい名前と親切なエラーメッセージは、エージェントが現れるずっと前から良い習慣だった。
1つの代役に合わせすぎるリスク
リスクは過剰適合だ。MuseやInstinctを真似た1つのシミュレーターに合わせて調整すると、そのシミュレーターのクセに合わせて作ってしまうことがある。
仮の例を2つ考えてみよう。代役のシミュレーターが、最初に並んだツールを選びがちだとする。するとチームは、リストの順位争いに力を注ぎ、説明文はそのままにするかもしれない。
もう1つ。代役が、ゆるい引数の型を許してしまうとする。その場合、雑なスキーマでもテストを通る。
本物のアシスタントなら失敗するかもしれないのに、だ。
合格点の価値は、シミュレーターが本物のアシスタントにどれだけ似ているかで決まる。
リスクを下げる確認は2つある。
- 人間のレビュアーによる確認:人間のレビュアーも改善と呼ぶ変更を優先する。シミュレーターにしか意味のない変更は、疑ってかかったほうがいい。
- 複数のプロファイル:複数の動作プロファイルで実行する。Muse風とInstinct風の両方に効く変更は、クセではなく本当の分かりやすさである可能性が高い。
模倣はどこまでで、実機での検証はどこから始まるのか
シミュレーターは、速くて繰り返せる回帰チェックを提供する。ただし、本物の非公開アシスタントが今日どう動くかは教えてくれない。そのため、実機でのチェックと本番の監視も必要になる。
次の表は、3つの層を実行の頻度、答えられること、見逃すことで比べたものだ。
| 層 | 頻度 | 答えられること | 見逃すこと |
|---|---|---|---|
| シミュレーション実行(例:CIでのCATT) | 変更のたび | 自分たちが何か壊したか | ベンダー側の変更、モデルのクセ |
| 実機アシスタントのチェック | 定期的、またはベンダーの更新後 | 本物のアシスタントで今も動くか | 根本原因。遅くて高い |
| 本番の監視 | 常時 | エージェントが今どう呼んでいるか | 理由。しかも事後にしか分からない |
それぞれの層が互いの穴を埋める理由
シミュレーション実行は、自分たちの回帰だけを切り出せる。基準点が固定されているからだ。テストが壊れたなら、原因は自分たち側の変更にある。
実機チェックは、ベンダー側の変更をつかまえる。固定されたシミュレーターには、それが分からない。
本番の監視は、誰もシナリオを書こうと思わなかったパターンを見せてくれる。たとえば次のようなものだ。
- 想定外の引数の形式:スキーマが予想しなかった形の入力。
- 途中で放棄された呼び出しの連鎖:始まったのに終わらないタスク。
- 使われないツール:エージェントがまったく選ばないツール。
実機チェックとシミュレーターの結果が食い違ったときは、むしろ役に立つ。多くの場合、ベンダーの動作が変わり、シミュレーターのプロファイルが古くなったことを意味する。
プロファイルが最初から正確でなかった可能性もある。だから食い違いは、調べ始めるきっかけになる。
オープンソースが加えられるもの
CATTをオープンソースで公開したことは、どの機能よりも大きな意味を持つかもしれない。1つのチームでは、MuseとInstinctのすべての更新を追いきれない。コミュニティなら追えるかもしれない。
共有されたシナリオと、コミュニティが保守する動作プロファイルがあれば、1人で取り組む連携担当者よりも速くベンダーの変更を拾えるだろう。
ただし、それには十分な数のチームが貢献することが前提だ。バージョン0.2.1の時点では、貢献が集まるかどうかはまだ分からない。
それでも動機はある。連携する側は誰もが、同じ非公開の相手に対してテストしているのだから。
なぜ今も手探りなのか
ここまでの話は、すべてリバースエンジニアリング(外から動作を探って再現すること)だ。
連携する側は、ツールの使い方をベンダーが文書にするだけで済むはずの製品の、代役を作っている。公開された仕様があれば、次のような点を押さえられる。
- ツールがモデルにどう一覧で渡されるか
- モデルが各説明のどこまでを保持するか
- エラーメッセージが返されるか
- 再試行が何回行われるか
こうした仕様があっても、テストは要らなくなるわけではない。ただ、相手についての推測が、分かっている事実に置き換わる。
ベンダーが公開するまでは、CATTのようなツールが現実的な回避策だ。残る問いは、コミュニティがこの負担を引き受け続けるのか、それとも共有されたテスト結果を使って、ベンダーに公開を迫るのかである。
連携する側にとっての全体像
ここまでの議論を並べると、おおまかな順序が見えてくる。
- いちばん大事な呼び出し元を見極める。 非公開のアシスタントがトラフィックの大半を動かしているなら、その互換性はリリースの条件になる。
- スキーマの範囲で、固定したシミュレーターを使ったCIを始める。 繰り返し実行し、ツール選択と引数の妥当性を確認する。しきい値は、測った基準値から決める。
- 合格率と並べて、タスクあたりの呼び出し数とトークン数を追う。 失敗がなくても、1タスクの往復が増えたら回帰だ。
- 定期的な実機チェックと本番の監視を加える。 シミュレーターと実機の結果のずれは、更新が必要な動作プロファイルを教えてくれる。
- 変更は分かりやすさで判断する。 人間のレビュアーによる確認、複数のプロファイル、そして見つけたことを公開シナリオへ還元する。
次の表は、よくある状況に合うやり方を並べたものだ。
| あなたの状況 | 主なやり方 |
|---|---|
| スクリプトによる呼び出し元だけ | 従来のコントラクトテスト |
| 非公開アシスタント、スキーマの変更が多い | CIでのシミュレーションテスト+定期的な実機チェック |
| 非公開アシスタント、インターフェースは安定 | 定期的なシミュレーション実行+本番の監視 |
| モデル固有の推論に結びついた失敗 | 実機チェックを頼りにし、シミュレーターは補助にする |
| 複数のアシスタントが重要 | 複数のプロファイル。すべてに効く変更を優先する |
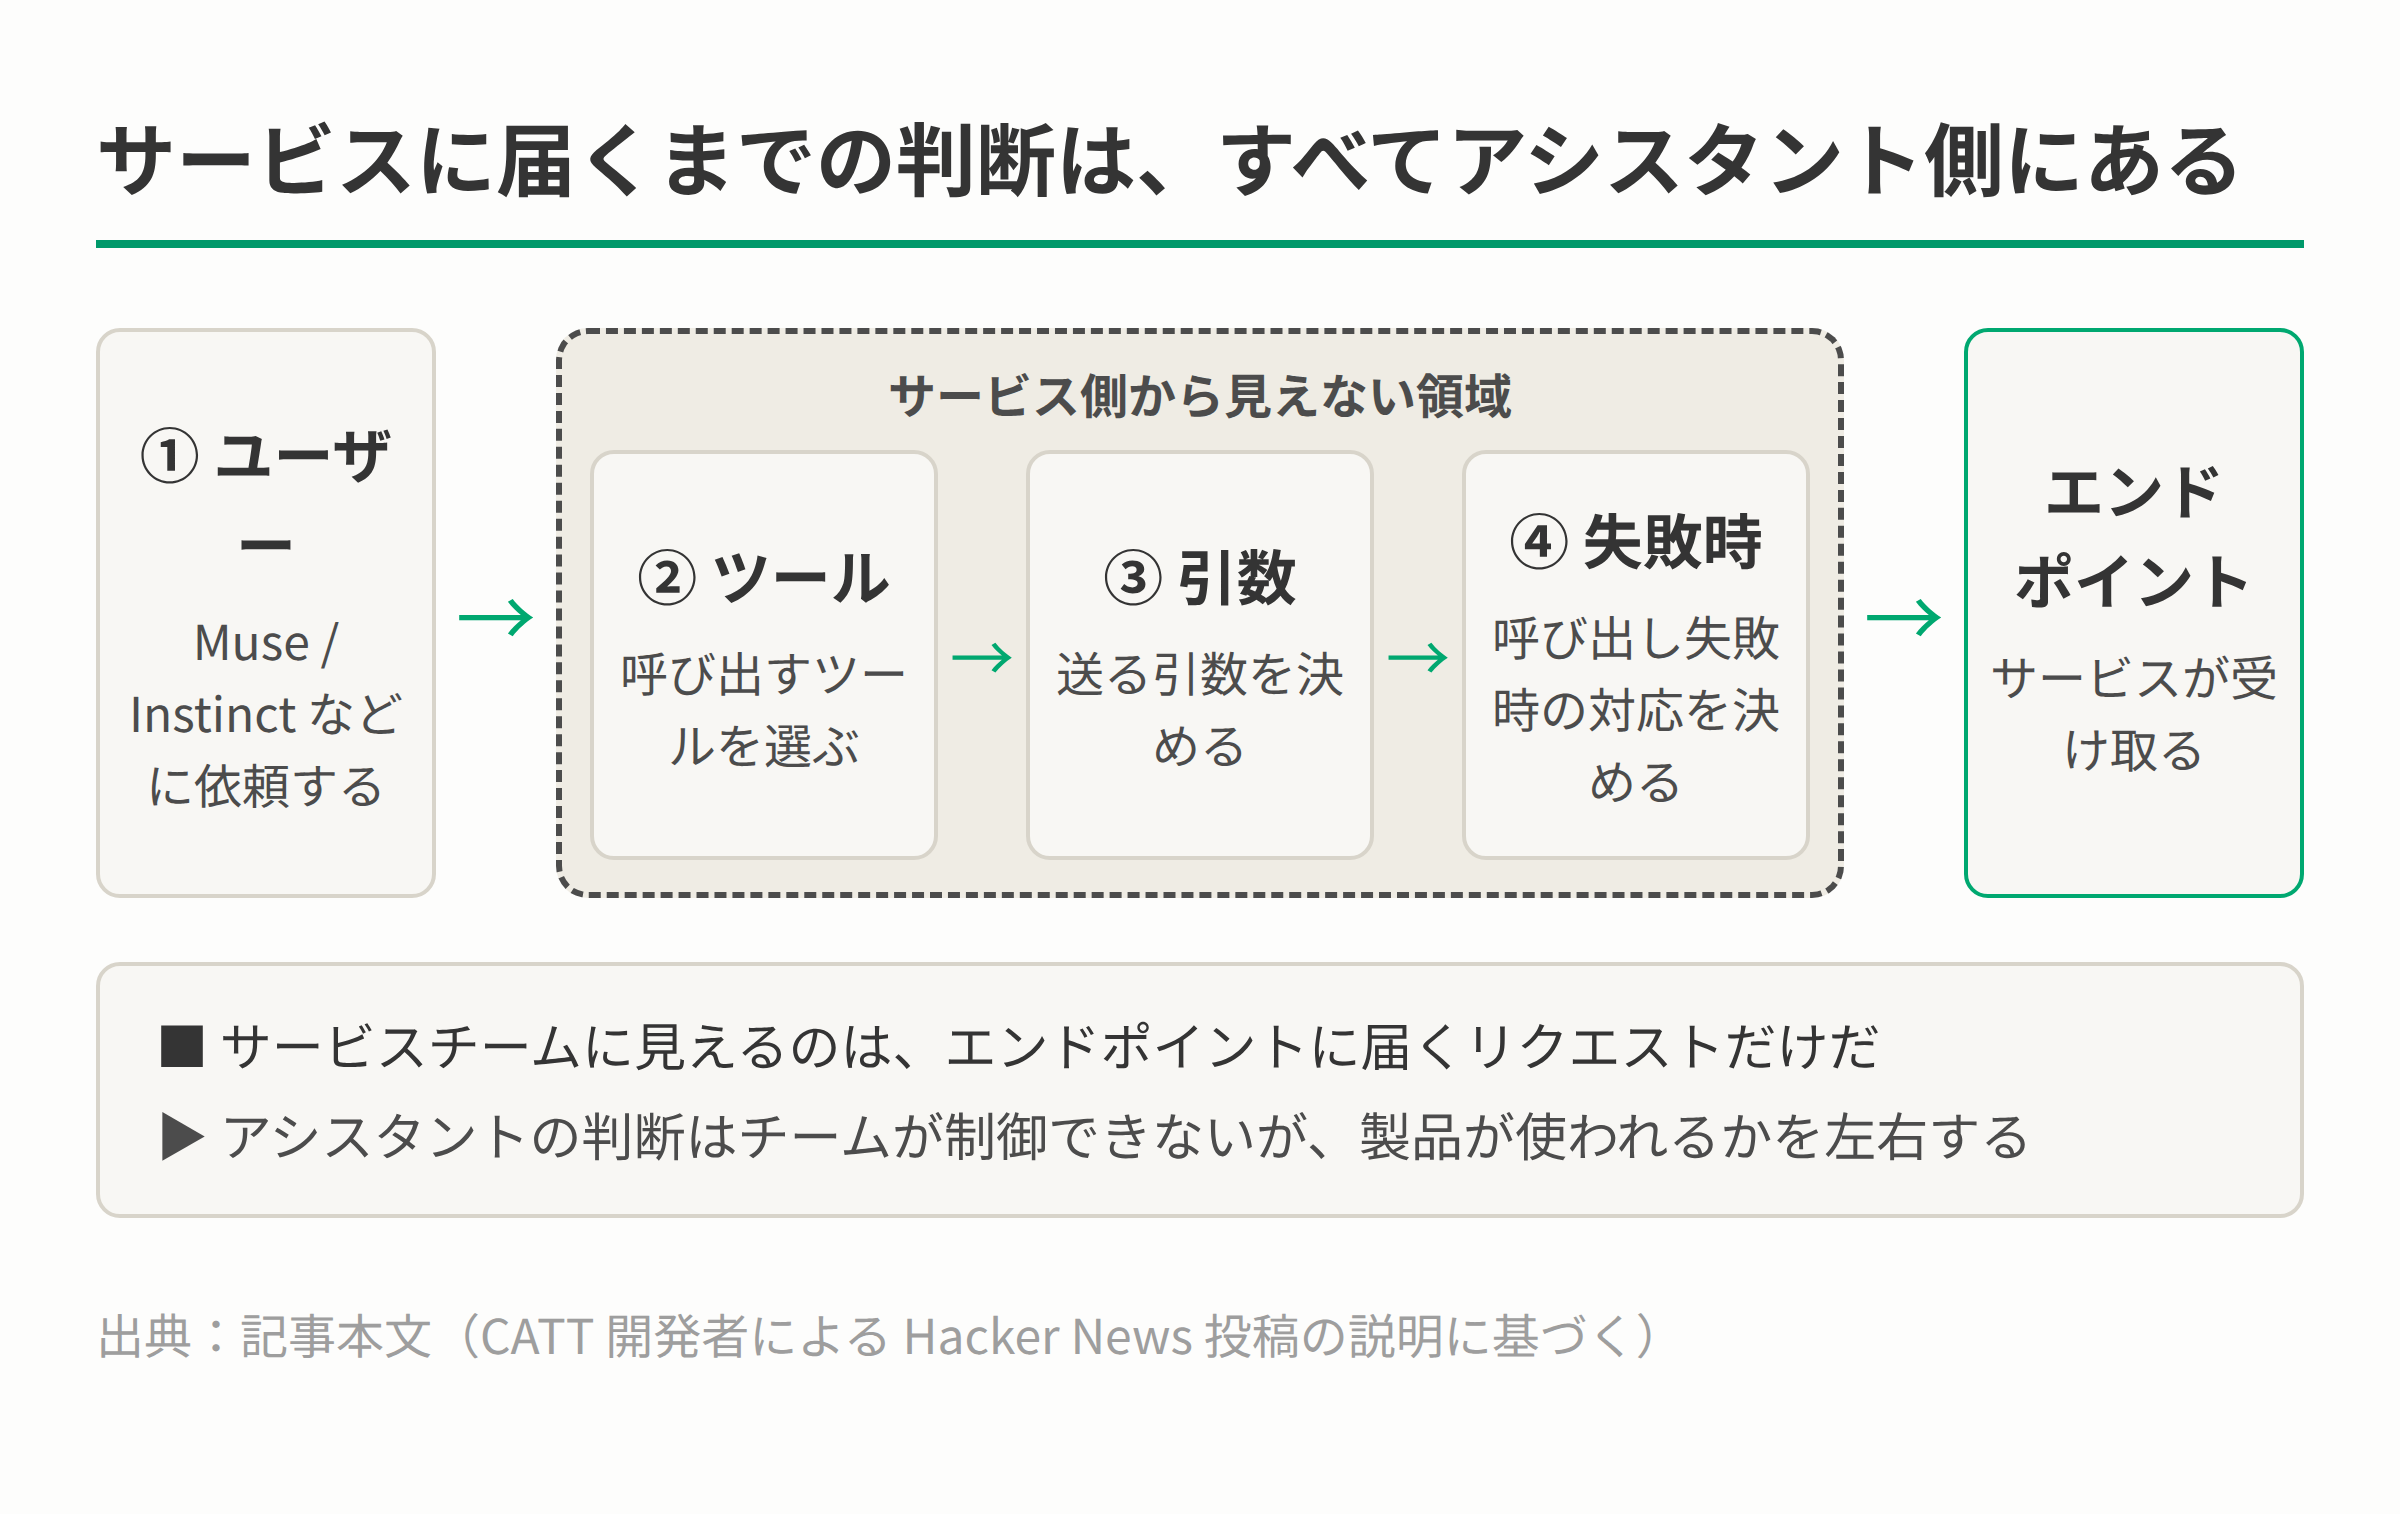
図1:サービスチームに見えないアシスタントの判断(出典:記事本文。CATT 開発者による Hacker News 投稿の説明に基づく)
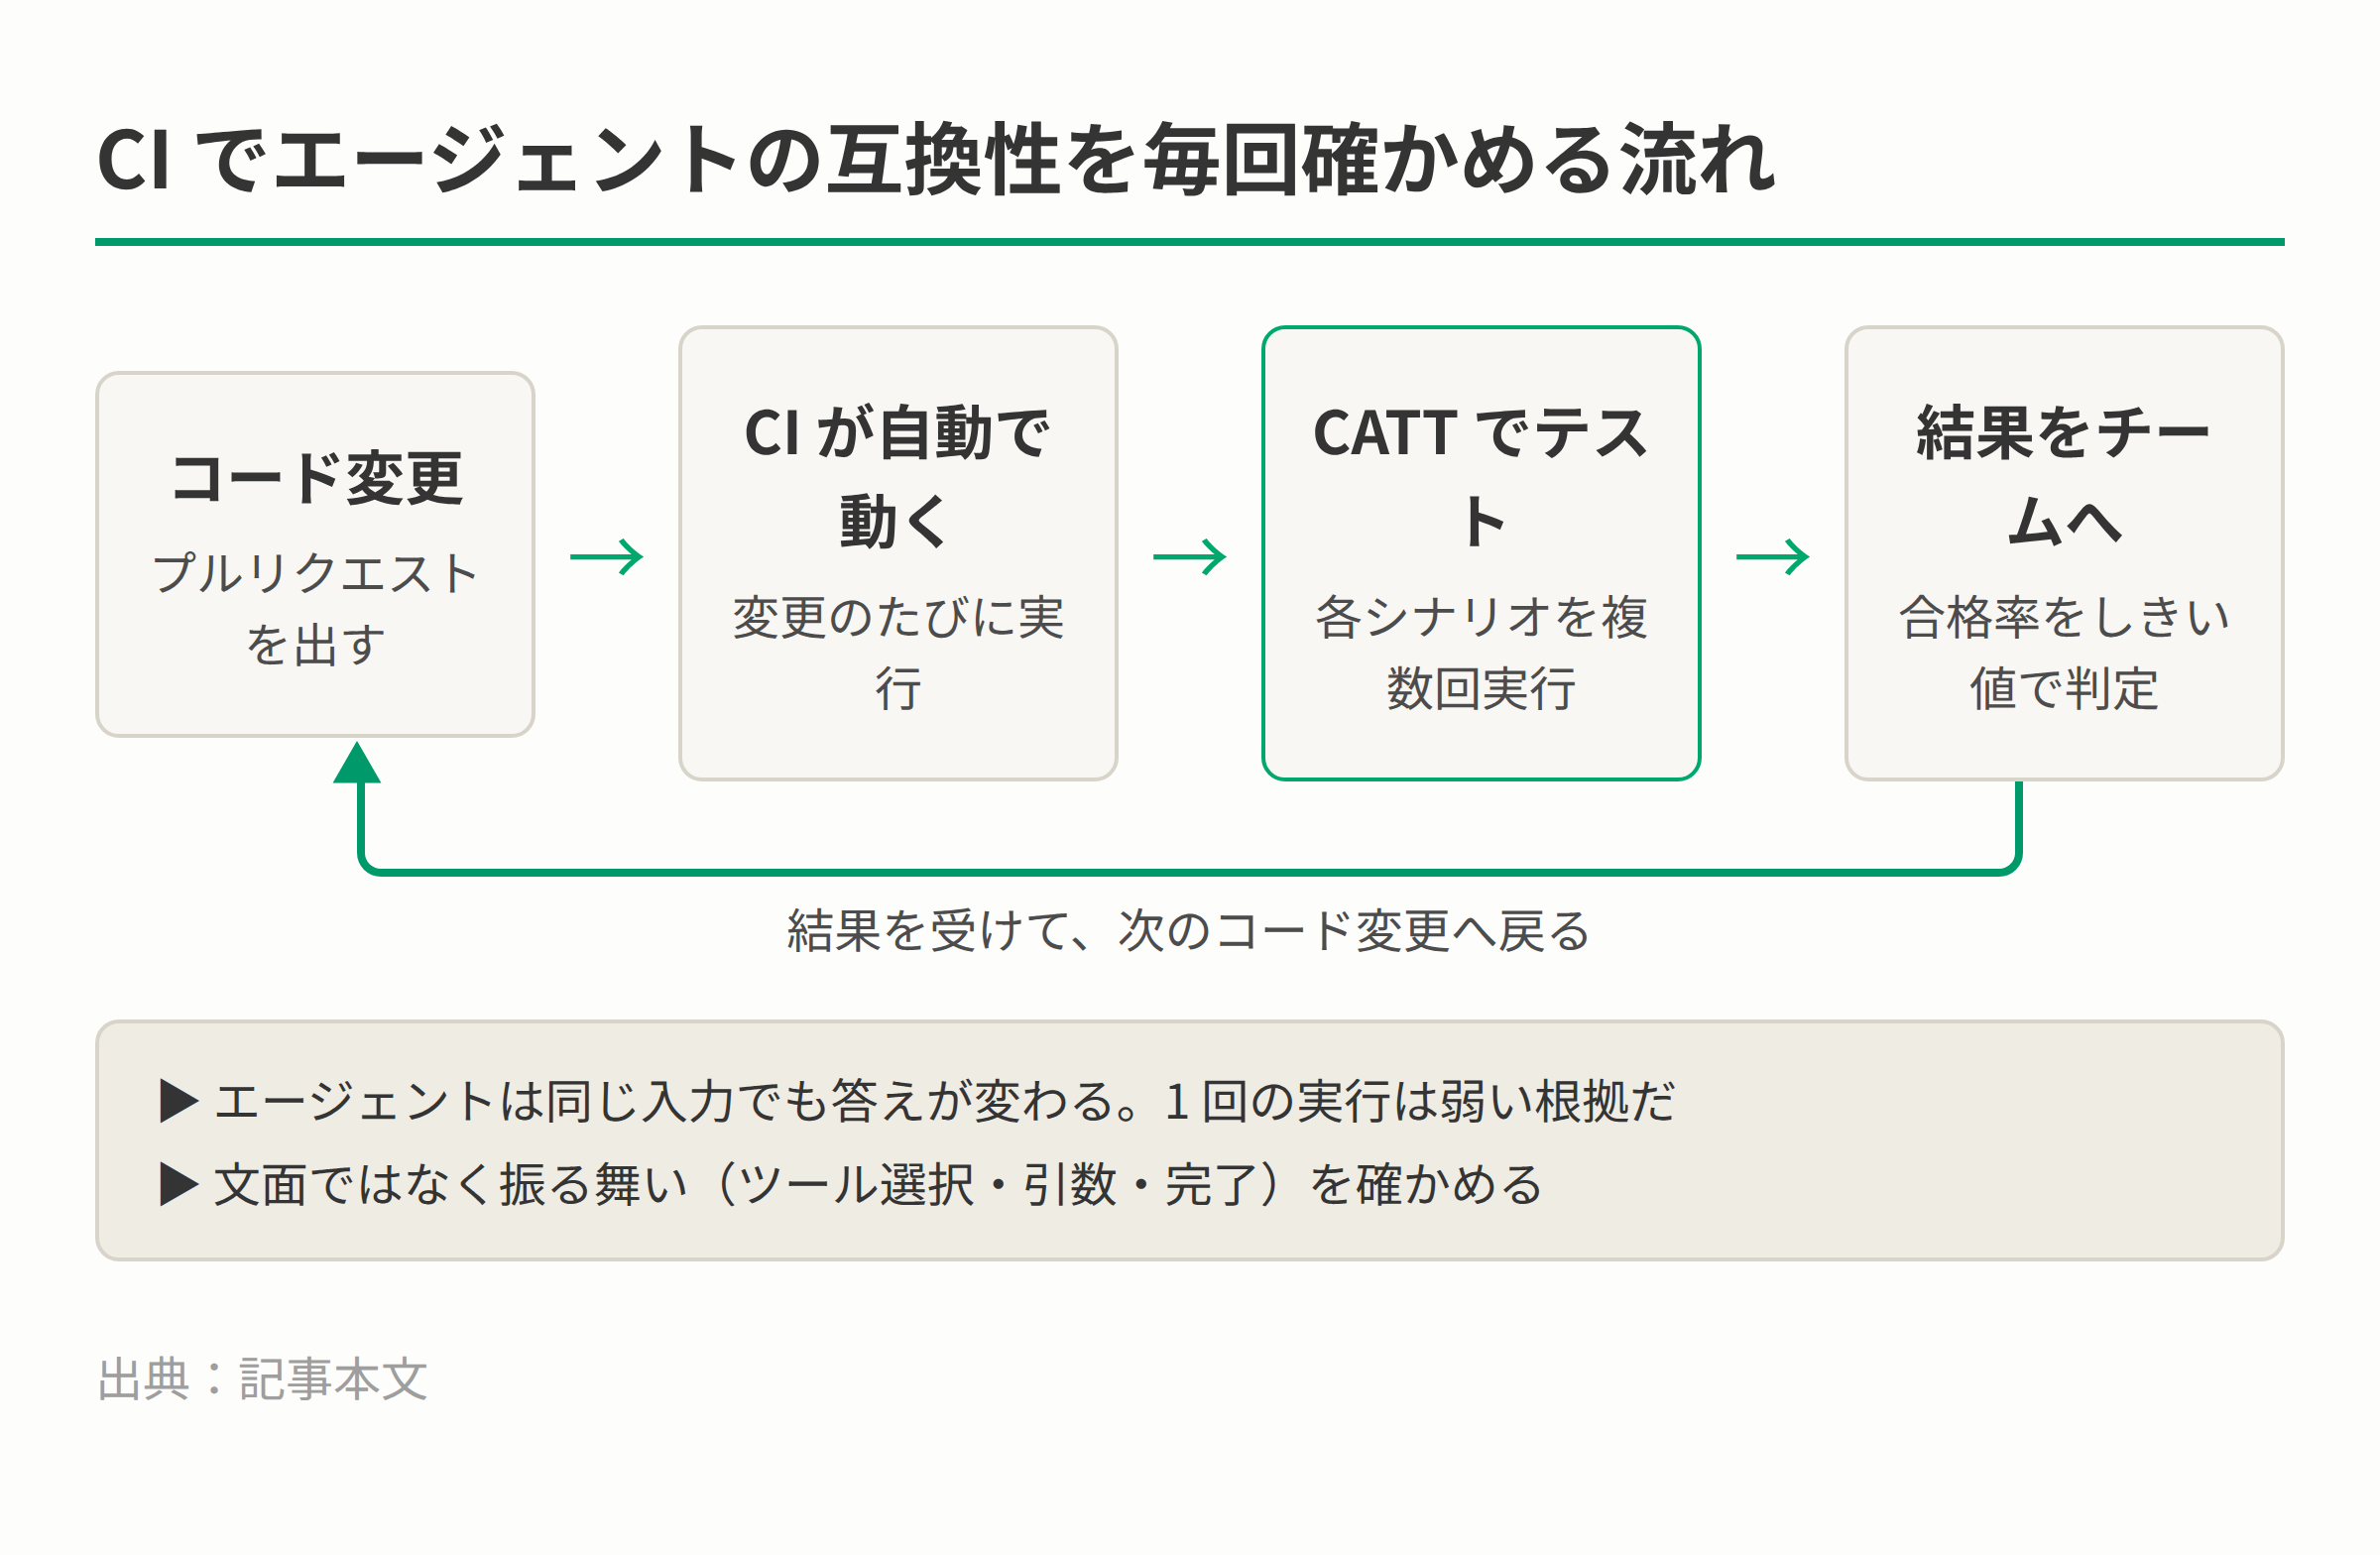
図3:代替アシスタントを使う CI テストの流れ(出典:記事本文)
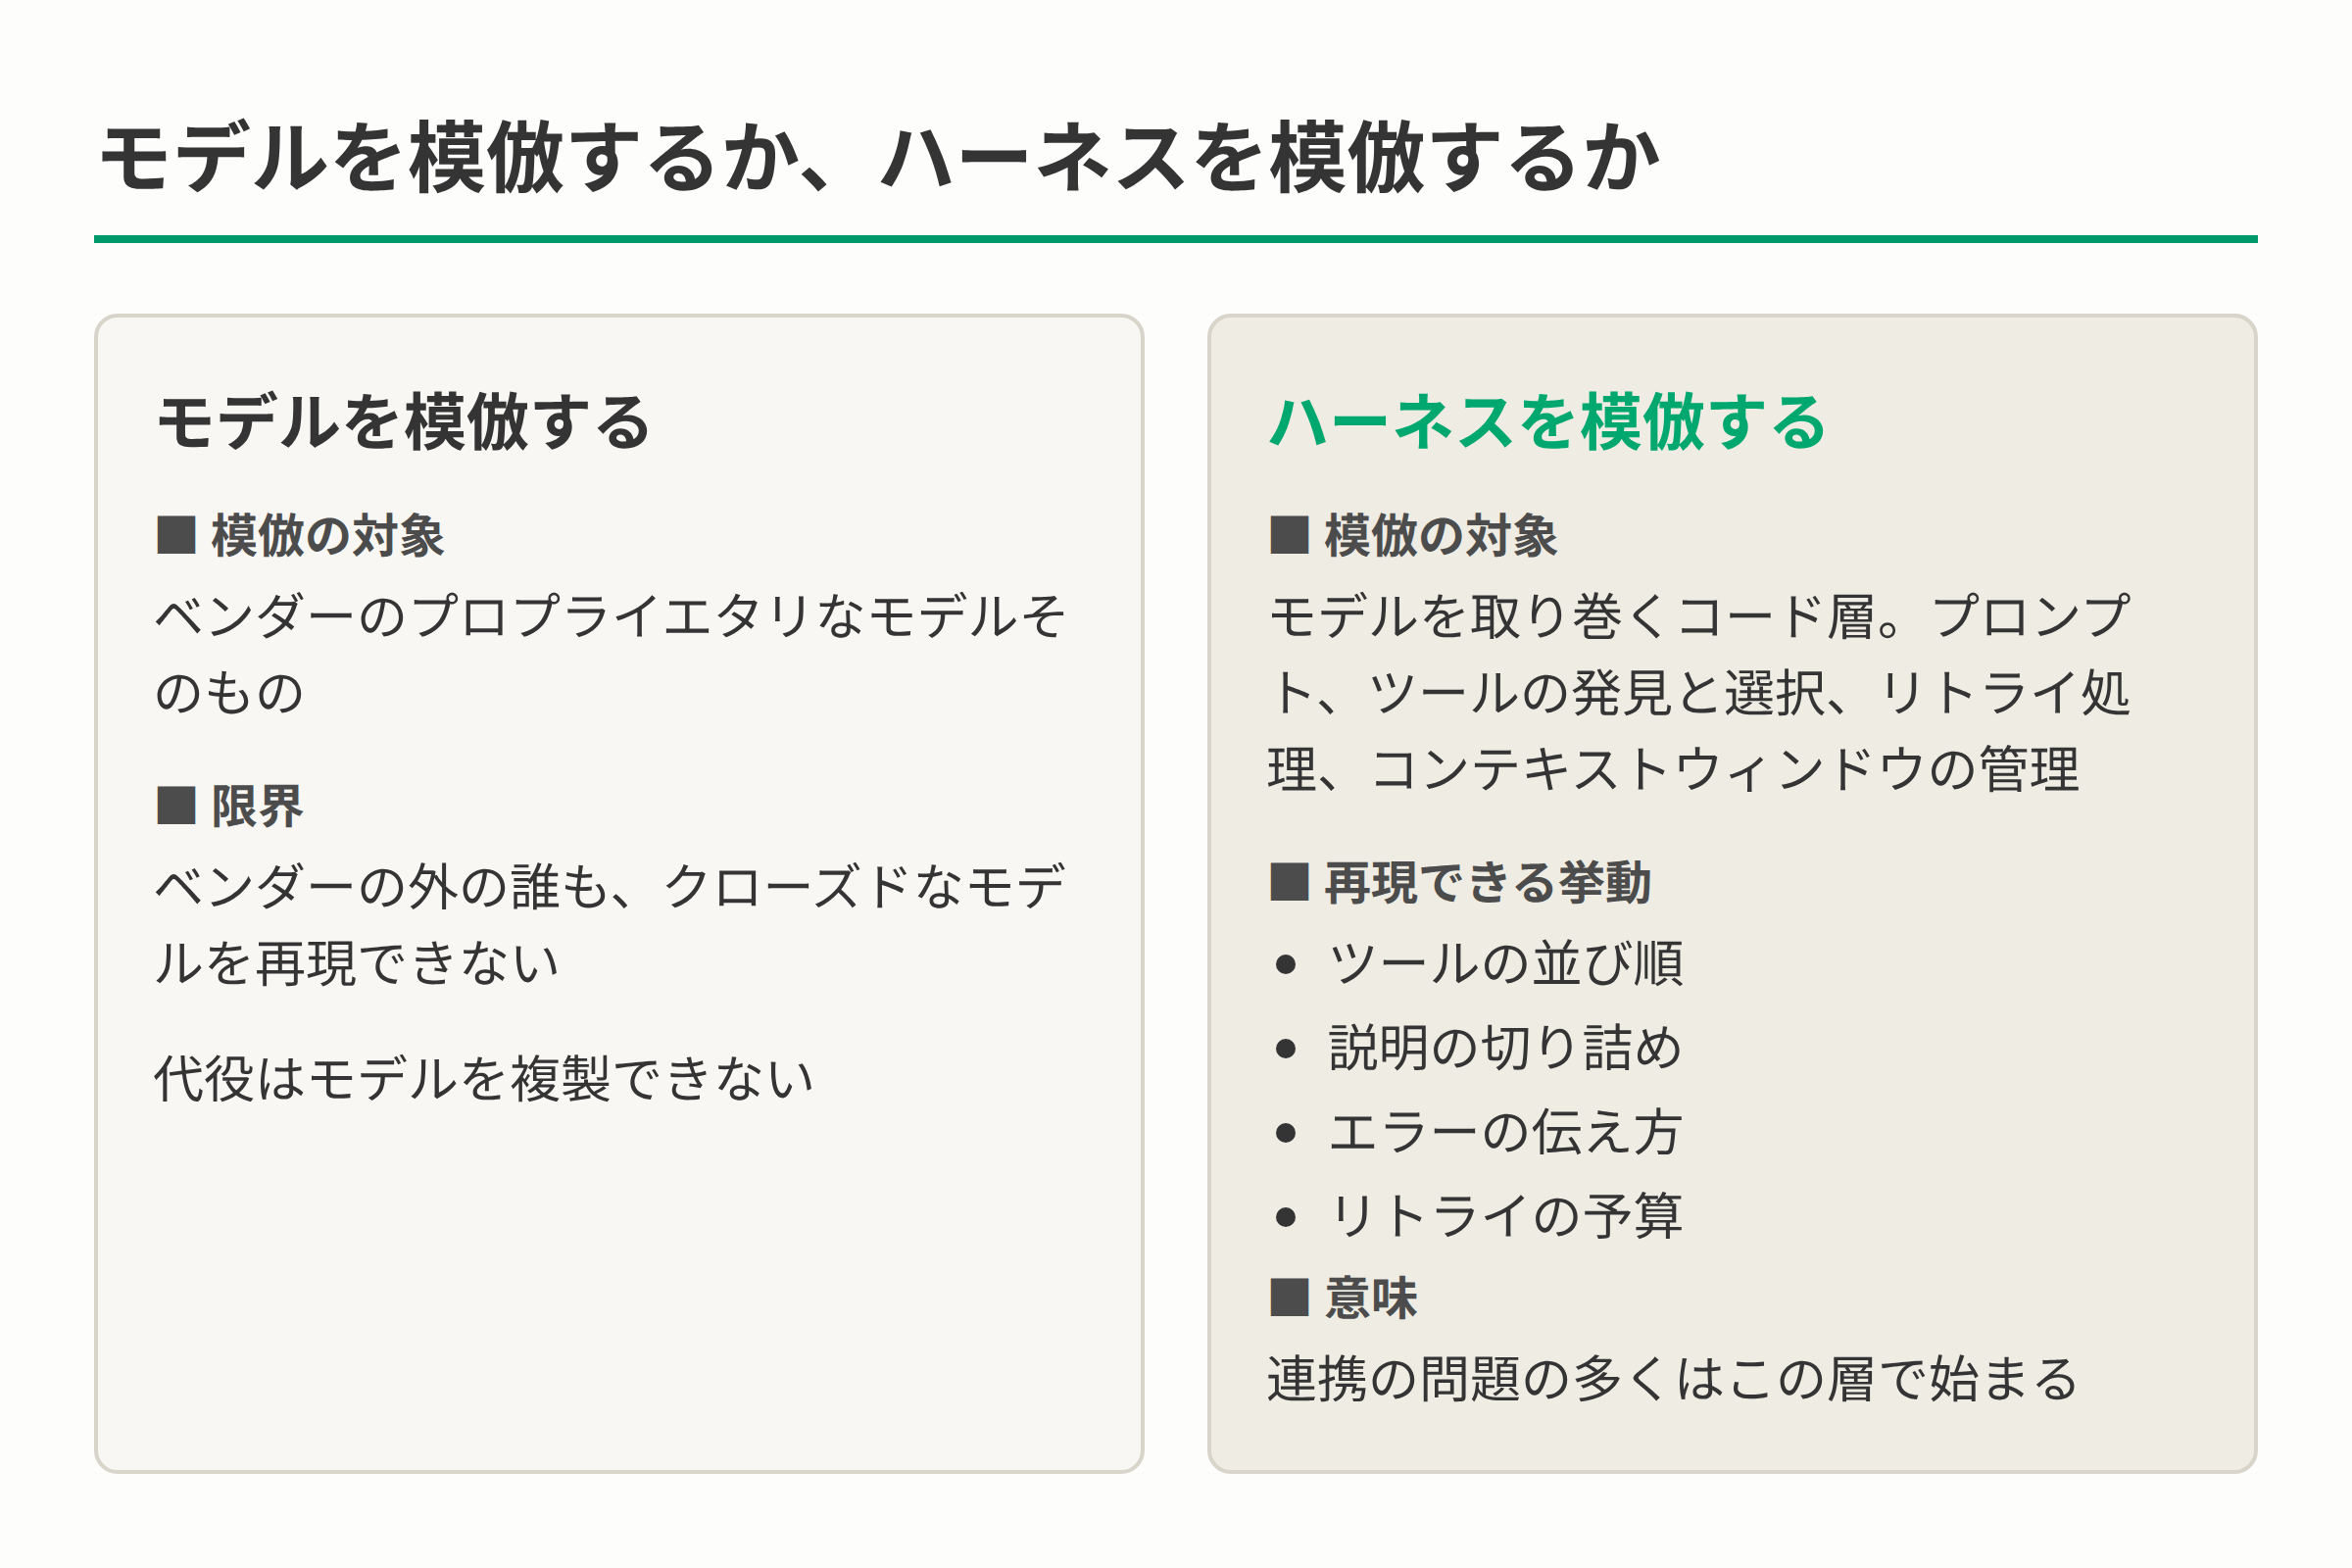
図2:モデルの模倣とハーネスの模倣の違い
図4:模倣による検証と本物での確認の役割分担(出典:記事本文)