数ドルのボードで言語モデルは動くのか
数ドルで買えて、消費電力もLED1個ほどのボードで言語モデルを動かす。SFのような話に聞こえるが、BitNetの3値の重みがそれを可能にする。
ESP32-S3というマイコンを複数つないだクラスターを見ると、何が実際に動き、どこに本当の限界があるのかが分かってくる。限界のほとんどは、最初に思い浮かぶ場所にはない。
この記事のポイント
- BitNet b1.58は、すべての重みを{-1, 0, +1}にする。行列の掛け算が整数の足し算、引き算、読み飛ばしになり、240 MHzのマイコンに向いている。
- ESP32-S3 1枚では、役に立つモデルは入りきらない。複数枚をつなぐと、増えるのは記憶容量であり、速度は上がらない。
- ボード間の通信が遅く、待ち時間も大きいときは、連続する層を1枚ずつ受け持たせるパイプライン並列が、テンソル並列より有利になる。
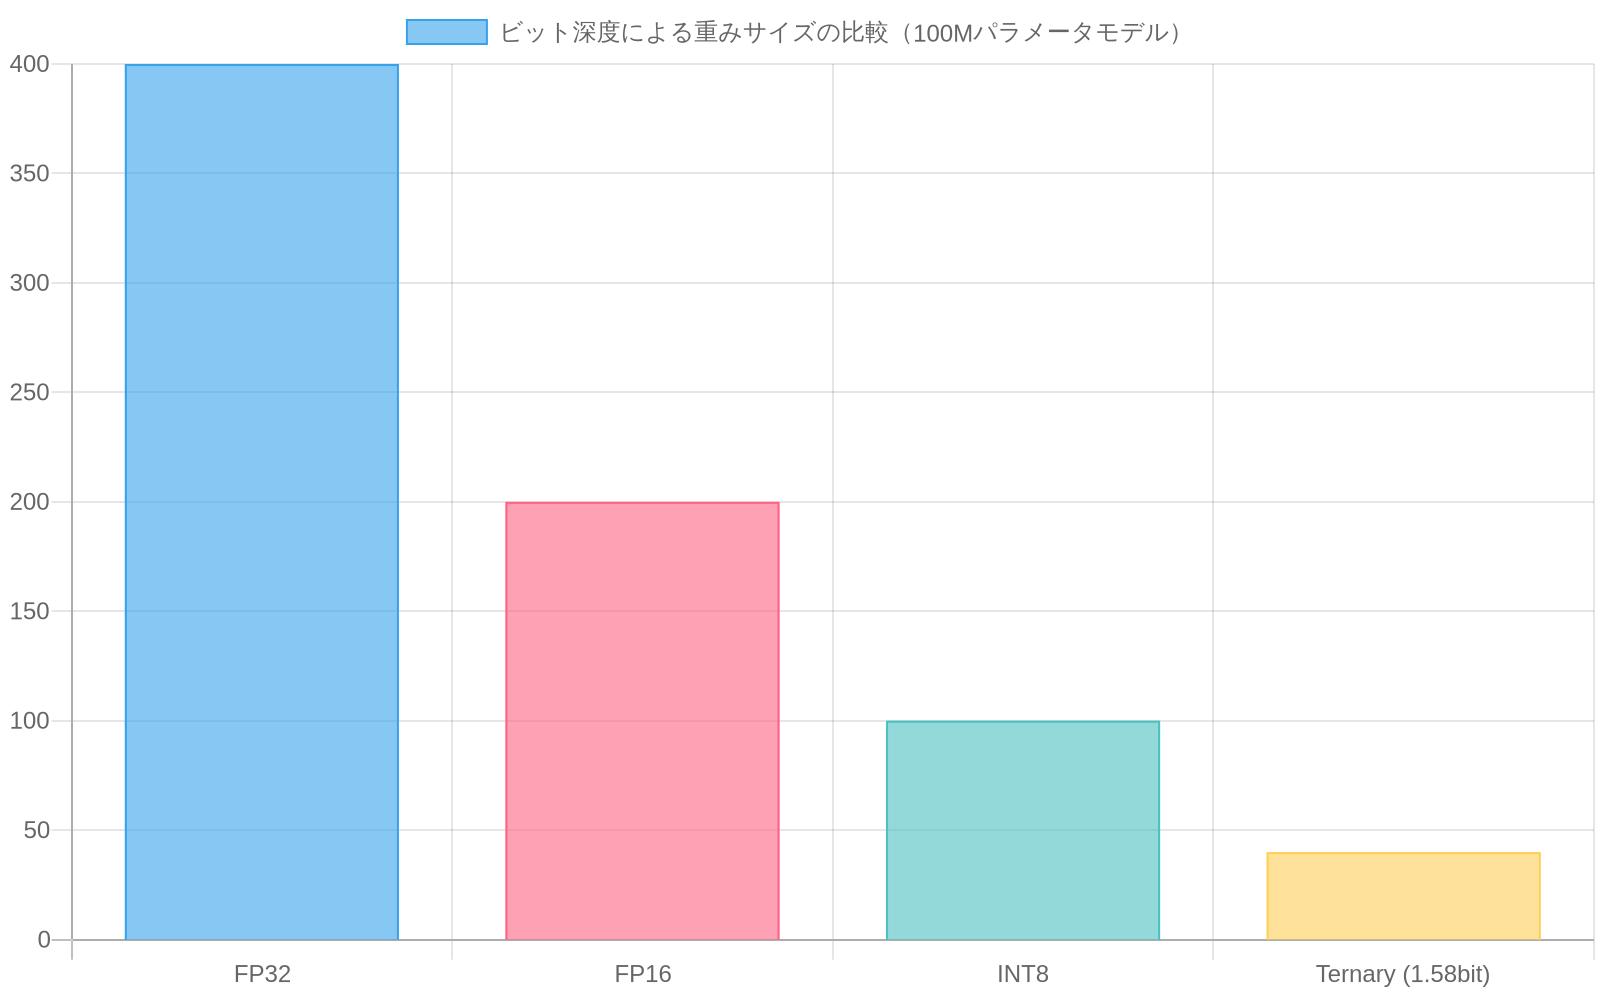
図2:異なる量子化フォーマットにおける重みサイズの比較(100Mパラメータモデル)
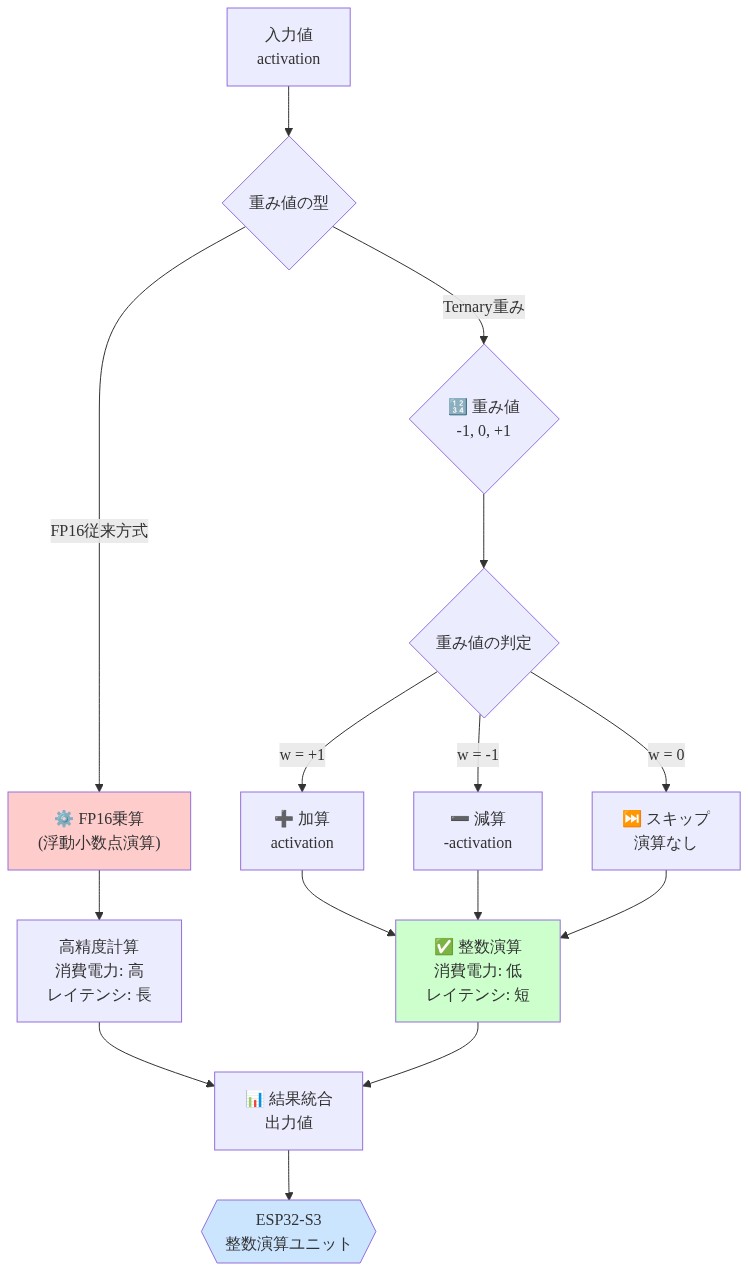
図3:Ternary重みによる行列演算の簡略化(従来のFP16との比較)
3値の重みがマイコンに合う理由
トランスフォーマーの推論は、ほとんどが密な行列の掛け算だ。BitNet b1.58は、重みを-1、0、+1の3つの値だけにする。すると掛け算は、入力を足す、引く、飛ばすの3つの動作で済む。
ESP32-S3は、この処理に向いている。LX7というXtensaのコアが2つあり、240 MHzで動く。8ビット整数用のベクトル命令も備えている。
浮動小数点演算の装置もあるが、処理の速さは控えめだ。このチップが最も得意なのは整数の足し算である。3値の重みは、その演算とよく噛み合う、初めてのモデル形式だ。
サイズの面でも得をする。
3値の重みは1つあたり約1.58ビットの情報を持つ。FP16の16ビットと比べて、およそ10分の1だ。 ただし実際には、取り出しやすさのために1つを2ビットで詰めることが多く、その分だけ節約は目減りする。
メモリを食うのは重みだけではない。活性化値、KVキャッシュ、埋め込みテーブルも大きいままだ。エッジでの運用を縛るのは、たいてい性能そのものよりも、メモリの占有量と帯域である。
3値化は、ボトルネックを消すのではなく、別の場所へ移すだけだ。大事なのは、新しいボトルネックがどこに来るのかという問いである。
ここで扱うモデルは、1億パラメーター前後の小さなものだ。最先端の性能にはほど遠い。それでも、用途が絞られていれば、小さなモデルが役に立つことはある。
- 分類
- 短い文の続きの生成
- コマンドの解釈
マイコン上でこうしたモデルを動かすと、完全にオフラインで推論でき、クラウドにも頼らず、振る舞いも予測しやすい。
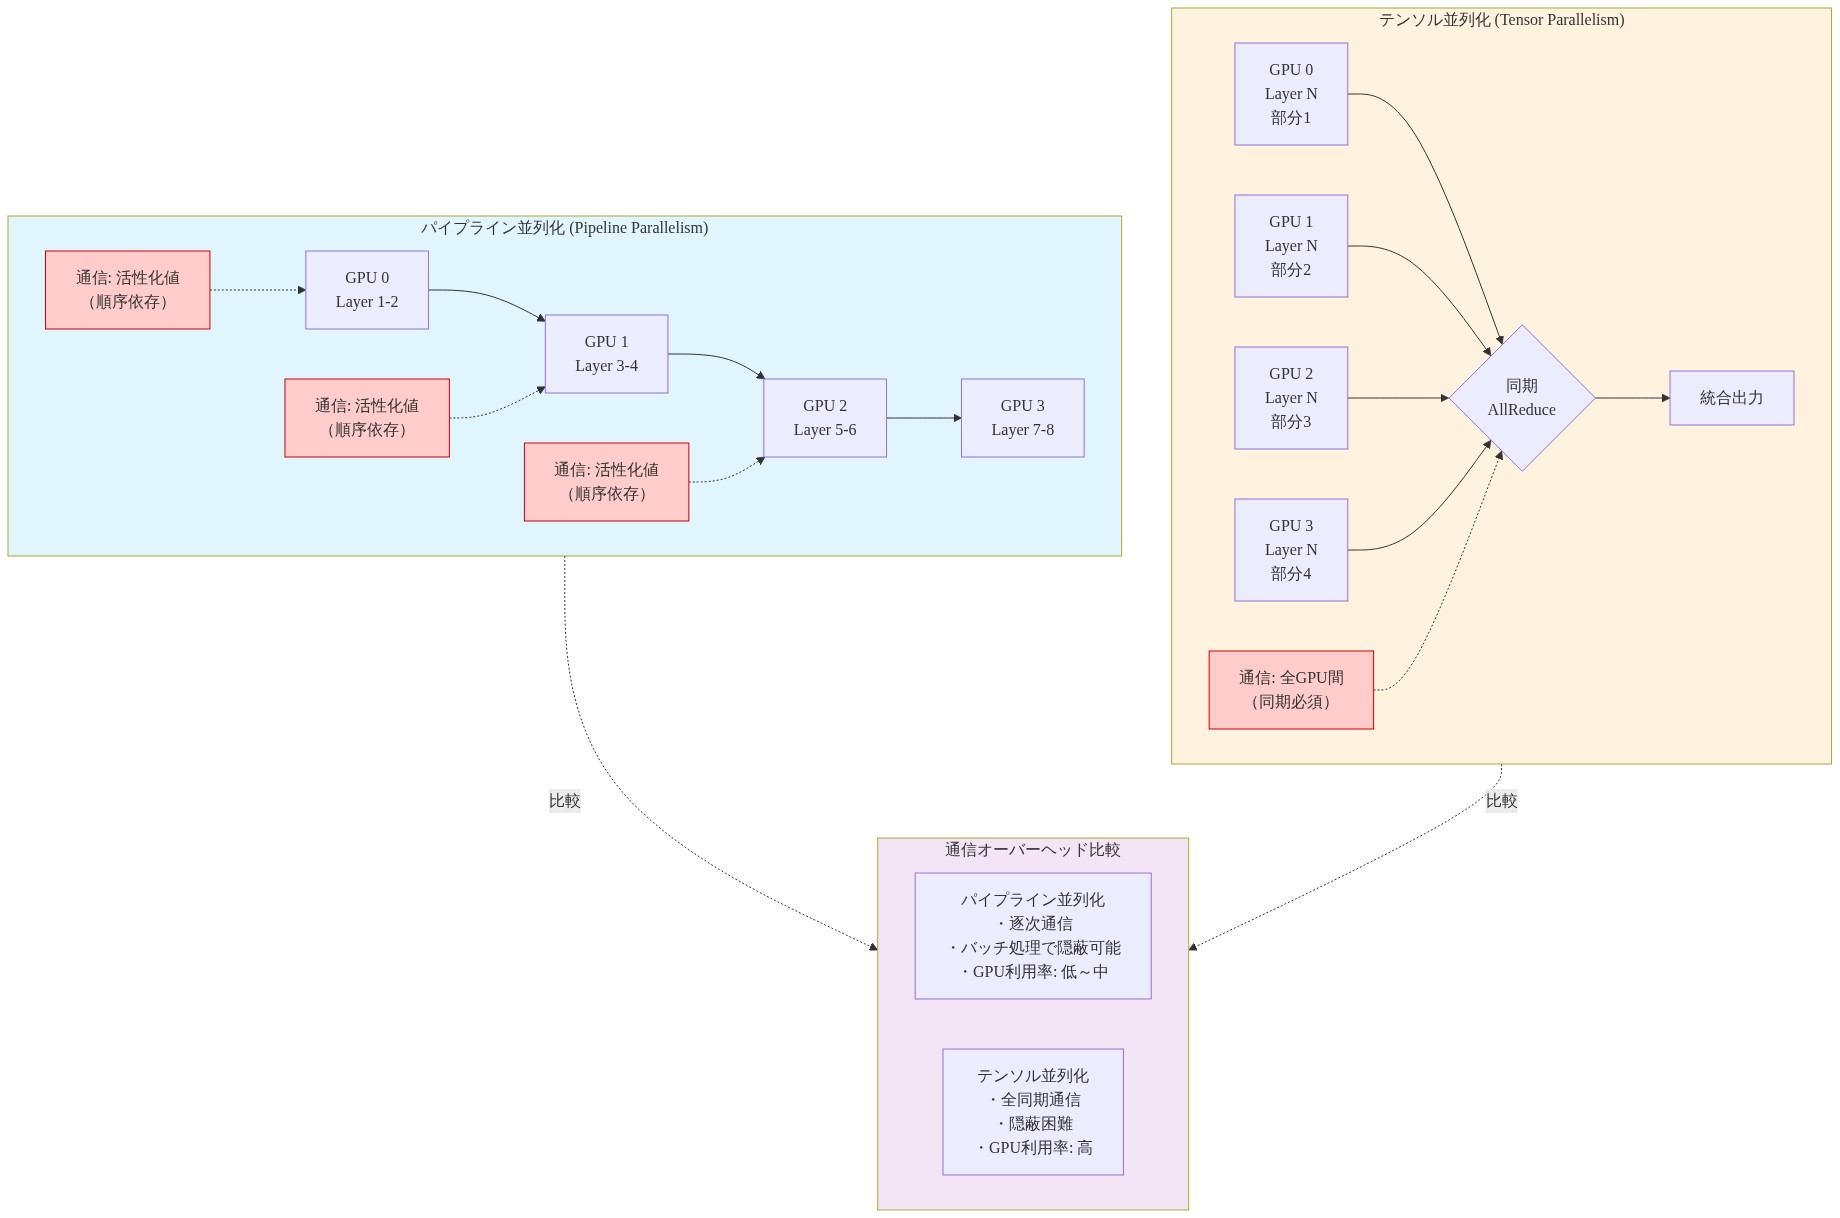
図5:パイプライン並列化 vs テンソル並列化の構成比較 - 通信パターンとGPU利用率の違い
メモリの壁とモデルの分け方
1億パラメーターの3値モデルは、ESP32-S3 1枚にはとても入らない。重みだけで20〜25 MBが必要だが、ボードの内蔵SRAMは512 KBで、外付けのPSRAMも一般に2〜8 MBしかない。
モデルを動かすには、複数のボードに分けて載せ、ボード間でデータをやり取りする必要がある。
この節のポイント
- 1枚では重みが入らない。8 MBのボード4枚で、重み、キャッシュ、バッファーがぎりぎり収まる。
- 連続する層のまとまりを各ボードが持つパイプライン並列は、ほかの分け方より通信が少なくて済む。
- KVキャッシュは系列が長くなるほど増える。メモリの主な制約は、パラメーター数ではなく文脈の長さになる。
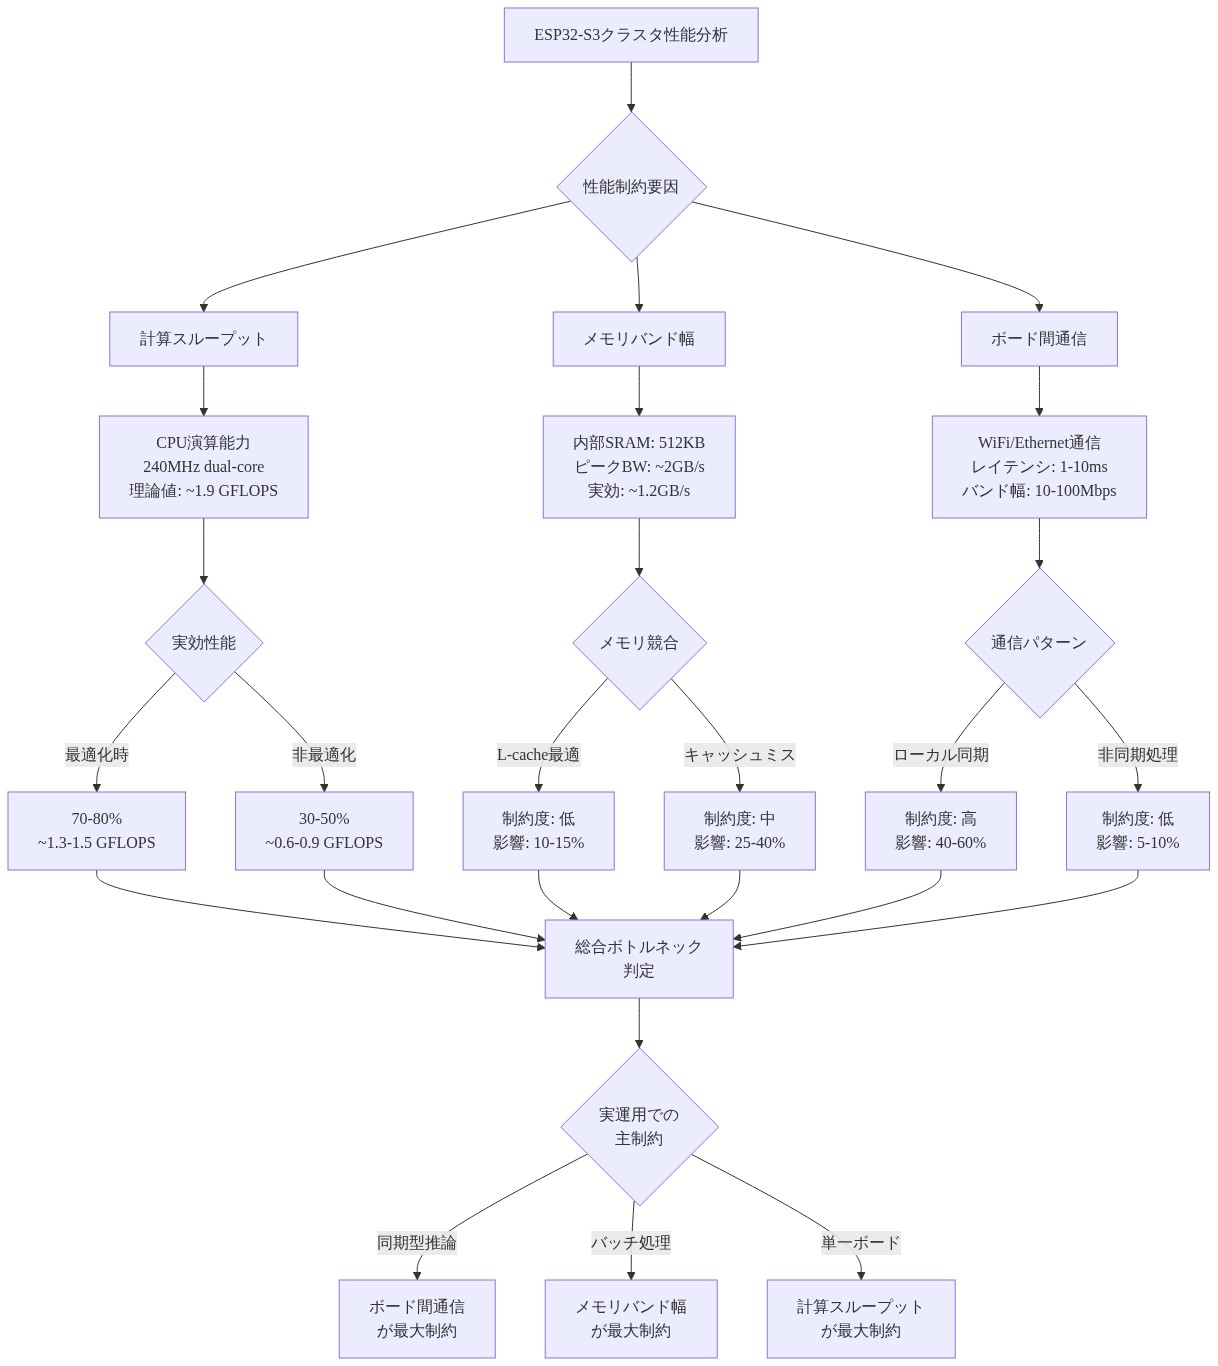
図7:ESP32-S3クラスタにおける性能ボトルネック分析
なぜモデルを分けるのか
1億パラメーターの3値モデルについて、メモリの目安を表にまとめる。
| 項目 | おおよその大きさ | 備考 |
|---|---|---|
| 3値の重み | 20〜25 MB | 1.58ビットなら約20 MB、2ビットで詰めると約25 MB |
| 埋め込みテーブル | 数MB | 語彙の大きさと保存形式で変わる |
| 層ごとのスケール | 小さい | 整数の出力を元の大きさに戻すのに使う |
| KVキャッシュ | 文脈とともに増える | 系列が長くなるほど膨らむ |
ESP32-S3の内蔵SRAMは512 KBで、一部はシステムが使う。外付けのPSRAMは2〜8 MBのものが一般的で、内蔵メモリより遅い。
8 MBのモジュールでも、入るのは重みの3分の1ほどだ。1枚のボードでは、このモデルをそもそも動かせない。
PSRAMが8 MBのボードを4枚そろえると、合計で約32 MBになる。重み、キャッシュ、バッファーを合わせて、ぎりぎり収まる量だ。
パイプライン並列とテンソル並列
モデルを複数のボードに分ける方法は、大きく2つある。
| 方式 | モデルの分け方 | 通信のしかた | このクラスターとの相性 |
|---|---|---|---|
| パイプライン並列 | 連続する層のまとまりを、各ボードが持つ | ボードの受け渡しごとに、活性化ベクトルを1本送る | 良い |
| テンソル並列 | 1つの層を、全ボードで分担する | 層のたびに、途中結果を交換する | 悪い |
このハードウェアには、パイプライン並列が自然な選択だ。テンソル並列では、同期をこまめに取る必要がある。
しかも、やり取りのたびに回線の固定の待ち時間がかかる。パイプライン並列なら、ボードの境目で小さなメッセージを1つ送るだけで済む。
たとえば、24層で隠れ層の大きさが512のモデルを、4枚のボードに分けるとしよう。各ボードは6層ずつ持つ。int8の活性化ベクトルは512バイトで、トークンを1つ生成するたびに、3つのボードの境目を越える。
本当の制約はKVキャッシュ
KVキャッシュには、層ごとに、トークン1つにつきキーとバリューのベクトルが1本ずつ保存される。int8で隠れ層の大きさが512なら、1層あたりトークン1つで約1 KBだ。
文脈の長さが256なら、1層で約256 KBになる。1枚のボードが6層を持てば、キャッシュは約1.5 MBだ。これは内蔵SRAMに収まらないので、キャッシュもPSRAMに置くことになる。
文脈が2倍になれば、キャッシュも2倍になる。モデルを分けたあとの重みの量は変わらない。
一方でキャッシュの需要は、系列が長くなるほど増え続ける。メモリの主な限界は、パラメーター数ではなく文脈の長さになる。
速度を決めているもの
ボード間の接続が足かせに見えるが、計算してみると別の姿が見えてくる。
この節のポイント
- 活性化ベクトルをボード間で送る時間は、数ミリ秒以下だ。効いてくるのは帯域ではなく、受け渡しのたびにかかる固定の手間である。
- 時間の大半は、PSRAMからの重みの読み出しに使われる。トークン1つにつき、すべての重みを1回読む必要がある。
- ボードを増やして伸びるのは、同時に処理できる系列の数であり、1人のユーザーの待ち時間は縮まらない。
通信の負担は小さい
ボード間の通信手段を、大まかに比べてみる。
| 通信手段 | 一般的な帯域 | 512バイトの転送時間(回線上のみ) | 実際の注意点 |
|---|---|---|---|
| SPI | 40〜80 Mbps | 約0.05〜0.1 ms | 転送の準備、DMA、やり取りの確認が加わる |
| UART | 115 kbps〜1 Mbps | 約4〜36 ms | 単純で壊れにくいが、速度が低いと遅い |
| Wi-Fi / ESP-NOW | 実際には数十Mbpsまで | 電波に乗る時間は1 ms未満 | 数ミリ秒単位の遅れ、ばらつき、再送がある |
SPIの速度なら、512バイトの転送は約0.1 msで終わる。隠れ層の大きさが2048でも2 KBで、回線上の時間は0.5 ms足らずだ。帯域は問題にならない。
受け渡しのたびにかかるコストの中身は、主に固定の手間だ。
- 転送の準備と、受け取れる状態であることの通知
- データの変換と検証
- 次のボードが自分の処理を終えるのを待つ時間
無線の接続では、遅れと再送のせいで、1回の受け渡しに数ミリ秒かかることもある。このコストは、トークン1つごとに、ボードの境目のたびに繰り返される。
本当のボトルネックはメモリ帯域
もっと大きな負担は、PSRAMからの重みの読み出しだ。トークンを1つ生成するには、すべての重みを1回ずつ読む必要がある。
4枚構成のクラスターでは、各ボードがトークン1つにつき約6 MBの重みをPSRAMから読み出す。ESP32-S3のPSRAMの帯域はモジュールと設定で変わるが、持続的な読み出しで毎秒数十MBというのが現実的な値だ。
毎秒40 MB程度なら、6 MBの読み出しに約150 msかかる。トークンの流れが1本だけなら、ボードは順番に動く。
4枚がそれぞれ約150 msかかるので、トークン1つに約600 ms、つまり毎秒1〜2トークンになる。これは測定値ではなく見積もりだ。PSRAMが速ければ、キャッシュをうまく使えば、モデルが小さければ、もっと速くなる。
それでも、この構成で1億パラメーターのモデルが毎秒2桁のトークンを出すのは、難しそうだ。
規模を広げたときに分かること
ボードを増やして伸びるのは、容量であり、1人のユーザーにとっての速さではない。トークンの流れが1本だけなら、処理は重ならない。
ボードが1枚増えるたびに受け渡しも1回増えるので、クラスターを大きくすると、トークン1つあたりの待ち時間はむしろ延びやすい。
このシステムを縛っているのは、計算ではなくメモリだ。ペースを決めるのは、PSRAMの帯域と、受け渡しごとの固定の手間である。コアは、時間の多くをデータの到着待ちに費やしている。
独立した系列を複数同時に走らせれば、全体の処理量は増やせる。その場合は、各ボードが別々の系列を同時に受け持つ。まとめて処理する用途には役立つ。
ただし、1人で対話する場面は速くならない。
Xtensaでのカーネルと量子化
LX7で3値の行列の掛け算を行うには、3つの手順を踏む。それぞれに制約がある。順に見ていくと、1.58ビットの重みで期待できるはずの速さが、実際の時間にそのまま表れない理由が分かる。
この節のポイント
- 詰めた重みを取り出す作業には、実際に時間がかかる。理論上の節約の一部は、ここで失われる。
- 活性化値の精度は、学習時の方式とぴったり合わせる必要がある。ずれると、誤差が層を重ねるごとに膨らむ。
- カーネルの最適化には限りがある。計算とメモリアクセスのどちらが支配的かは、計測して初めて分かる。
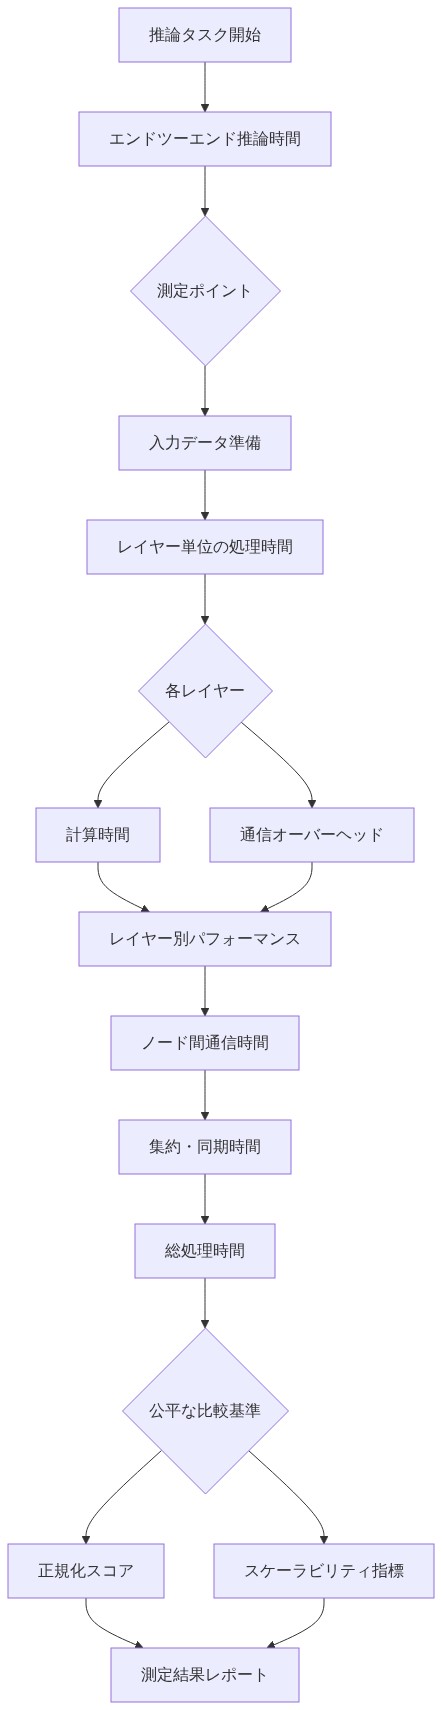
図11:クラスタ性能測定の方法論と測定ポイント
掛け算のしくみ
処理は、取り出し、適用、積算の3つに分かれる。
- 取り出し:詰めた重みを、シフトとマスクで取り出す。2ビットで詰めると、1バイトに重みが4つ入る。
- 適用:重みをint8の活性化値に当てはめ、足す、引く、飛ばすのどれかを行う。
- 積算:結果を幅の広い整数レジスターに足し込み、そのあと層のスケール係数を掛ける。
このチップのベクトル命令は、手順2と3にはかなりうまく合う。一方で、取り出しには余分な手間がかかる。重みが小さくなったことによる理論上の節約は、この手間で一部が失われる。
ベクトル命令の幅に合わせた詰め方にすると、いくらか助かる。よく使う重みを、遅いメモリから取ってくるのではなく、内蔵SRAMに置いておくことも有効だ。
活性化値の精度が大事な理由
BitNet b1.58は、8ビットの活性化値を使って学習される。つまりint8の活性化値は、モデルの設計の一部であり、あとから妥協して入れたものではない。
デバイス上では、学習時の方式にぴったり合わせることが目標になる。
- スケーリングの方法が同じこと
- 丸めの挙動が同じこと
- 外れ値の扱いが同じこと
学習時と推論時の食い違いは、誤差を生み、層を重ねるごとに積み上がる。小さくて深いモデルは、大きなモデルよりも、この食い違いに敏感だと考えられる。
特定のモデルで測らない限り、品質がどれだけ落ちるかは分からない。確実な確認方法は、同じモデルをデスクトップCPUで動かした基準の実装と、出力を比べることだ。
カーネルの最適化には天井がある
1つのカーネルを磨いても、効果はすぐ頭打ちになる。たとえば、アセンブリを丁寧に書いて、ある層の計算時間が10 msから5 msに縮んだとしよう。その層がPSRAMの待ち時間にはるかに長くかかっているなら、あるいはボード間の無線の受け渡しに数ミリ秒かかっているなら、この短縮はほとんど意味を持たない。
まず計測して、時間がどこに使われているかを確かめ、支配的な部分から手を入れる。
クラスターを公平に測る
このシステムを毎秒のトークン数だけで語ると、実態を見誤る。1つの数字だけでは、性能がなだらかに落ちる場所も、いきなり動かなくなる場所も見えない。
この節のポイント
- 文脈の長さ、メモリの使用量、待ち時間は、あとから足す項目ではなく、中心となる変数である。
- 受け渡しごとの待ち時間を測ると、通信のコストと計算の時間を切り分けられる。
- もっと大きなモデルとの順位を競うより、どの用途に向くかを見るほうが大事だ。
複数の軸で測る枠組み
予算の段階ごとに評価する枠組みでは、メモリとトークンの上限を、中心となる変数として扱う。1 この考え方を借りて、クラスターを複数の軸で測る。
| 指標 | 測り方 | なぜ大事か |
|---|---|---|
| 毎秒のトークン数 | 文脈の長さを128、256、512に固定して測る | キャッシュが大きくなると、待ち時間がどう延びるかが分かる |
| ボードごとのメモリ使用量のピーク | 推論中のSRAMとPSRAMの最大使用量 | 各ボードが限界にどれだけ近いかが分かる |
| 受け渡しごとの待ち時間 | 各受け渡しの送信側と受信側で時刻を記録する | 回線の手間と計算時間を切り分けられる |
| トークンあたりの消費エネルギー | 可能なら電源側で消費電力を測る | マイコンを使う最大の理由にあたる |
| 出力の一致度 | 同じモデルをデスクトップCPUで動かした結果と比べる | 量子化やカーネルの誤りを見つけられる |
段階別の手順では、文脈、メモリ、待ち時間に、はっきりした上限を設ける。
すると、性能の本当の境目が見えてくる。たとえば、文脈128までは問題なくても、512ではボードのキャッシュがあふれる、ということがある。その境目が、実際の性能の姿だ。
品質を公平に見る
1億パラメーターのモデルは、分類、意図の判別、短くて決まった形の続きの生成に向いている。自由な雑談には向かない。比べるべきは、はるかに大きなモデルとの順位ではなく、用途への向き不向きだ。
クラスターから学べること
このクラスターは、下限を試す実験になっている。どれだけ小さなハードウェアで、筋の通った言語モデルを動かせるのか。そして、オフラインで、低消費電力で、プライバシーを守れる使い方に、何が開けるのか。
この節のポイント
- 限られたハードウェアでは、速さを決めるのは計算力ではなく、メモリと帯域だ。
- ボード間の通信では、回線の速さよりも、受け渡しごとの手間が効く。
- 公開されたモデルでは、ベンチマークの点数よりも、実際に動かせるかどうかが大事になりつつある。
公開されたモデルのうち、実際に役立つかどうかは、ベンチマークの順位よりも、どこかで実際に動くかどうかに左右されるようになってきた。このクラスターは、ハードウェアの制約を具体的な形で見せてくれる。
- マイコンで推論するには3値化が欠かせないが、解決するのは問題の一部にすぎない。
- ペースを決めるのは、演算の速さではなく、メモリの容量と帯域だ。
- ボード間の受け渡しごとの固定コストは、回線の帯域よりも重い。
- 文脈の長さに応じてKVキャッシュが増え、それが最終的な限界になる。
- ボードを増やすと、大きなモデルを載せる余地は生まれるが、推論は速くならない。
シングルボードコンピューターやスマートフォン向けのチップなら、実用上のほぼすべての指標で、このクラスターを上回るだろう。
消費電力がきわめて小さい環境では、ESP32-S3 1枚で、ずっと小さなモデルを動かすほうが賢い選択かもしれない。このクラスターの価値は、こうしたトレードオフを目に見える形で測れるようにしたことにある。
この分野への入り方
限られたハードウェアでの推論を自分で試すなら、クラスターから見えたことをもとに、次の順で進めるとよい。
- 先にメモリの予算を立てる。 カーネルを書く前に、目標の文脈の長さで、重み、埋め込み、スケール、KVキャッシュを書き出す。
- 受け渡しごとの待ち時間を直接測る。 ボード間の受け渡しのたびに時刻を記録し、通信の手間と計算時間を取り違えないようにする。
- パイプラインの段をつなぐのは、無線よりSPIにする。 無線のばらつきと再送は、トークンごとに、受け渡しを重ねるたびに積み上がる。
- BitNetの学習時の活性化値の量子化と、ぴったり合わせる。 出力をデスクトップの基準と比べて、量子化の誤りを早めに見つける。
- 結果は、文脈の段階ごとに報告する。 ピーク時のメモリ使用量も添えて、毎秒のトークン数という1つの数字だけにしない。
ちょっと立ち止まって
これほど小さな機械には、物事をはっきりさせる力がある。大きなGPUの上では、ハードウェアの限界は「十分に速い」という漠然とした感覚に溶けてしまう。
安いマイコンを数枚、配線でつないだだけの環境では、1ミリ秒も1キロバイトも目に見える。
次のモデルを動かすのに何がかかるのか、バイトとボード間の受け渡しの単位まで正確に分かっていたら、あなたはどの設計の選択を変えるだろうか。