優先したはずの端末内処理が、気づかないうちに止まる
スマホで小さな言語モデルを動かすのは、自然な第一選択だ。しかし負荷がかかると、そのスマホが突然固まることがある。
端末内推論には利点が多い。データは端末の外に出ない。オフラインでも動く。
質問1回ごとの料金もかからない。どの点を見ても、処理はスマホの中で済ませたほうがよさそうに思える。
問題が出るのは、負荷がかかったときだけだ。最上位クラスのSnapdragon搭載機で生成を続けると、動作が遅くなるだけでは済まない。動作そのものが不安定になる。
数回続けて質問すると、GPU推論ランタイムが落ちる。もっと悪いと、気づかないうちに固まる。
固まるほうが、落ちるよりたちが悪い。 アプリにはエラーが何も届かない。
届くはずのない出力を待ち続け、画面は止まったままになる。その間もバッテリーは、むだなループで減っていく。
これは、熱管理でよく言われる緩やかな速度低下とは違う。端末が冷えていても起きる。プロンプトが長いほど、生成が長いほど、ひどくなる。
原因は、半導体が放熱できる限界ではない。モバイル向けツールチェーンが扱える限界のあたりに、失敗が集まっている。
そこで問いが生まれる。優先する処理先が、始めた仕事を最後までやり切れるか分からないとき、各クエリをどこで動かすかを何に基づいて決めればよいのか。
この節のポイント
- 端末内推論は、プライバシー、オフライン動作、コストの面で今も第一選択だ。ただし、負荷が続くとランタイムが不安定になり、頼りきれない。
- 失敗の原因は熱だけではない。GPU向けツールチェーンの弱さが原因で、冷えた端末でも起きる。
- 固まるほうが、落ちるより復旧しにくい。アプリにはっきりしたエラーが届かないからだ。
- 振り分けでは、プライバシーとコストの利点を、ランタイムが固まる危険と比べて決める必要がある。
- 温度だけを見る方針は、冷えているのに落ちやすい状態へクエリを送ってしまう。
冷えた端末でも失敗する理由
調べてみると、混同されやすい2つの問題が分かれて見えてくる。熱による速度低下と、ソフトウェアスタックの弱さだ。
熱による速度低下は、連続的で予測しやすい。端末が熱くなるとGPUの周波数が下がり、消費電力が減り、処理速度がなだらかに落ちる。
温度と電力のテレメトリーがあれば、スケジューラーでモデル化できる。解き方も分かっている。熱設計を良くする、低電力のモデルを使う、周波数を調整する、といった方法だ。
ここで見られた不安定さは、性質が違う。
原因は現在のモバイル向けツールチェーンにあり、とくにOpenCLカーネルのコンパイルと、モバイルGPUでの長いプロンプトのプリフィルで起きる。 端末が冷えていても失敗は繰り返される。
悪化するのは、熱が続いたときではなく、生成が長くなったときだ。長いプロンプトを1回送るだけで、あるいは長い生成を1回するだけで、ランタイムが固まることがある。その端末が40℃を超えたことがなくてもだ。
次の表は、2つの失敗の型を比べたものだ。
| 比べる点 | 熱による速度低下 | ツールチェーンの弱さ |
|---|---|---|
| きっかけ | 半導体の温度上昇 | 長いプロンプト、長い生成、連続クエリ |
| 進み方 | 周波数がなだらかに下がる | 突然落ちる、または固まる |
| 予測しやすさ | 高い(温度と相関する) | 低め(処理内容の形による) |
| 回復 | 自動(冷えれば元の速度に戻る) | 再起動か、別の処理先への切り替えが必要 |
| 見える兆候 | 遅延の増加、電力の低下 | クラッシュログ、または何の兆候もない |

表1:熱的スロットリング vs ツールチェーン脆弱性の特性比較
温度だけでは足りない理由
温度だけを見る制御は、冷えているのに落ちやすいランタイムへ、平気でクエリを送ってしまう。端末が35℃なら安全だと判断する。
しかし本当の危険は、GPUに積まれた長いプロンプトや、そのセッションで処理済みのクエリ数にある。
ランタイムの不安定さは、むしろ離散的な危険に近い。失敗する確率は、シリコンの温度と同じくらい、プロンプトの長さ、生成の長さ、連続クエリの数に左右される。
そのため、振り分けの方針は2つの信号を入力にする必要がある。
- 温度:熱が続くことによる負荷の目安
- 処理内容の形:ツールチェーンが失敗する危険の目安
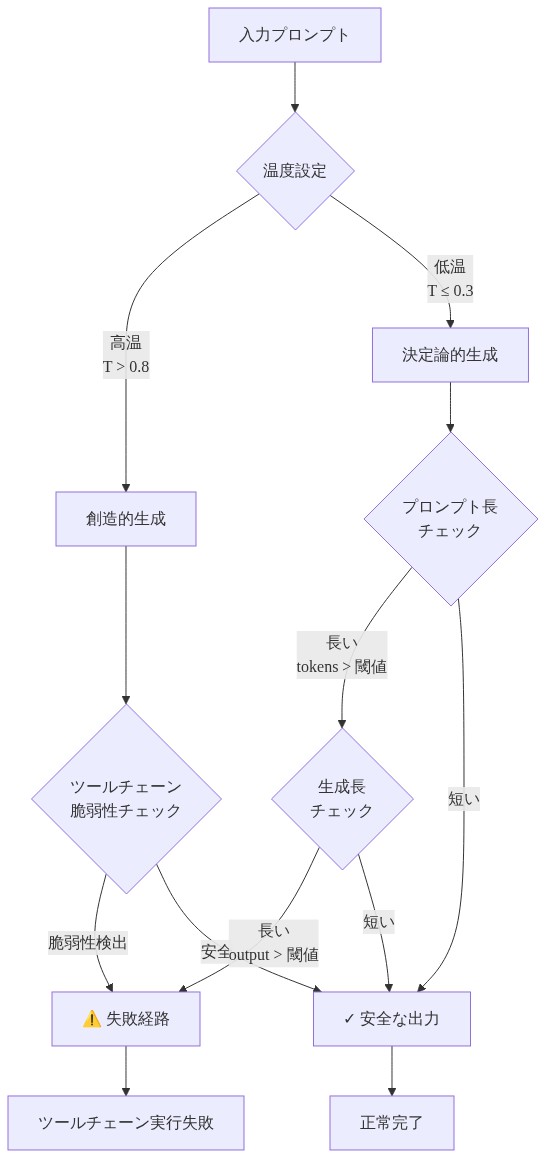
図2:温度のみに基づくルーティングの盲点—クールデバイスでの予期しない失敗経路
なぜ強化学習で処理先を決めるのか
環境が予測しにくく、失敗のコストに偏りがあると、固定のルールは行き詰まる。
「長いプロンプトはクラウドへ送る」というルールは、短いプロンプトでランタイムが固まった時点で破綻する。「50℃を超えたら切り替える」というルールは、35℃で端末が落ちた時点で破綻する。
しきい値を使う方針では、プロンプトの長さ、生成の長さ、セッションの履歴、温度が絡み合った影響に対応できない。
端末内、エッジ、クラウドの振り分けは、選択のコストが時間とともに積み上がる、連続した意思決定の問題だ。
3つの処理先には、それぞれ得意不得意がある。
- 端末内:お金がかからず、データも外に出ない。ただし固まる危険があり、遅延をむだにするうえ、あとのクエリまで巻き込むことがある。ランタイムが固まれば、次のクエリは簡単なものでも失敗する。
- クラウド:安全だが、お金がかかり、データも外に出る。
- エッジサーバー:その中間にあたる。クラウドより遅延が小さく、端末内より信頼できる。ただしネットワークを1回通るし、クエリごとの費用もかかる。
振り分けの影響は、セッションの中で積み重なる。連続したクエリはランタイムに負荷をかける。だから方針は、目の前のリクエストだけでなく、直近の履歴も追う必要がある。
強化学習のエージェントなら、この状態を観察して、相反する目標を天秤にかける方法を学べる。
- 端末内の利用を最大にする(プライバシーとコスト)
- 失敗の確率を最小にする(遅延、データの露出、復旧にかかる時間)
エージェントが何を学ぶかは、報酬の設計で決まる。失敗に重い罰を与え、クラウドに送る遅延より重くすると、エージェントは端末内の利用に慎重になる。
端末が冷えて空いていても、危険なクエリ(長いプロンプト、長い生成、固まった直後のクエリ)はクラウドかエッジへ送る。
逆に、端末内の利用に重い罰を与えると、エージェントはすべてを端末内に回し、失敗してから避け方を学ぶ。ちょうどよい配分は、用途で変わる。
プライバシーを最優先するアプリは、データを端末に残すために高いクラウド費用を許せる。コストを最優先するアプリは、失敗率が高くなっても受け入れられる。
強化学習には、環境の変化に合わせて適応できる良さもある。ドライバーやコンパイラーが良くなれば、失敗が起きる範囲も変わる。
今のツールチェーンで訓練した方針は、ツールチェーンが成熟するにつれて最適でなくなる。強化学習のエージェントは、新しいデータで再訓練したり微調整したりできる。手書きのルール群は、人の手で直すしかない。
資源の予算が、設計の出発点になる
ローカルLLM推論の最近の研究は、運用上の厳しい予算を、避けて通る制約ではなく出発点として扱っている。
トークンの予算が分かりやすい例だ。
総量が決まっているなかで、文脈にいくつ、推論にいくつ、出力にいくつ割り当てるかを決めなければならない。この制約は、なくして済ませる問題ではない。解くべき問題そのものだ。
推論をどこで動かすかを決めるときも、熱と安定性の限界が同じ役割を果たす。端末には、速度が落ちたり失敗したりするまでの熱の予算がある。
ランタイムには、固まるまでの安定性の予算がある。これらは柔らかい目標ではない。超えれば性能が落ちるか、システムが壊れる、実際の上限だ。
違いは、見え方にある。トークンの予算は、明示的で数えられる。
何トークン使えるかが分かる。熱と安定性の予算は、見えないところにある。
テレメトリーと失敗の履歴から推し量るしかない。ランタイムが固まるまでに何回続けて質問できるかは、前もって分からない。観察して学ぶしかない。
この違いがあるから、決まった配分より、学習した振り分けのほうが向いている。固定のスケジュールなら、たとえば「80%を端末内、20%をクラウド」と決めるかもしれない。
だが10回目のクエリごとにランタイムが固まるなら、そのスケジュールは10回に1回失敗する。学習した方針なら、セッションの履歴を見てその規則性に気づき、固まる前に端末内の割合を下げられる。
振り分けは、モデル側の効率化とも補い合う関係にある。積極的な量子化を使えば、クエリ1回あたりの計算量とメモリの使用量が小さくなる。その結果、端末内推論を使える場面が増える。
しかし、軽いモデルでも、弱いランタイムの上で動かすなら、身を引くべき場面を知っている方針は役に立つ。どちらか一方で、もう一方の代わりにはならない。
10回で固まる1.58ビットのモデルは、やはり問題だ。しかも、すべてをクラウドに送る方針は解決策にならない。
大事なのは、効率と信頼性の両方を設計に組み込むことだ。効率化で問題を小さくし、残った場面を振り分けで解く。
信頼性は、あとから当てるパッチではなく、構造で作る
AIシステムの障害は、運用の問題として扱われがちだ。ホスト型のコーディング支援が止まれば、冗長化、フェイルオーバー、インシデント対応で直す。
しかし、端末内推論の失敗は事情が違う。GPUはユーザーの手の中にあり、ランタイムもユーザーのスマホの上にある。サーバー側でどんな手当てをしても、そこには届かない。
信頼性は、後付けのパッチではなく、最初からシステムの構造に組み込んでおく必要がある。
ハイブリッド推論でいえば、フォールバックの経路を、緊急時の対応としてだけでなく、通常の動作の一部として作っておくことになる。
この節のポイント
- フォールバック先は、常に動く状態で試験しておく。必要になって初めて失敗する、冷えた経路にしてはいけない。
- 固まるのは、落ちるより見つけにくい。実際の処理内容に合わせたタイムアウトが要る。
- 生成の途中で止まったときの復旧計画が要る。捨ててやり直すか、チェックポイントから再開するかだ。
- 振り分けの層は、3つの処理先すべてを見て、それぞれの失敗のしかたに応じて動く必要がある。
フォールバックを最初から組み込む
端末内は、プライバシーとコストの面で優先したい処理先だ。
しかし、優先したいことと、信頼できることは別の話だ。端末内が失敗したときだけクラウドに送る仕組みは、フォールバックを冷えた経路として扱っている。一番必要な瞬間まで、一度も試されない経路だ。
そうではなく、端末内がうまく動いているときでも、ごく一部のクエリをクラウドかエッジに送って、フォールバックを温めておく。これには2つの役割がある。
- 実際の条件で、フォールバックの経路を試せる。
- 失敗が起きたとき、フォールバック先に届くか、応答が返るかについて、最近のデータが手元にある。
ローカルのランタイムも、処理が進まなくなったことを検知する必要がある。クラッシュなら分かりやすい。難しいのは、GPUが応答しなくなっているのに、アプリがそれに気づかない固まり方だ。
アプリは、GPU処理にタイムアウトを設けて、期限が切れたらフォールバック先に切り替える必要がある。
タイムアウトは、ユーザーが待てる時間より短く、通常のクエリにかかる時間より長くしなければならない。この釣り合いは、実際の処理内容で調整するしかない。
生成の途中で固まったクエリの出力は、使い物にならない。アプリには2つの選択肢がある。
- 捨ててやり直す:途中までの出力を捨て、クエリをクラウドに送る。
- チェックポイントから再開する:端末内で生成中に状態を保存しておき、そのチェックポイントからクラウドで再開する。
2つ目のほうが効率はよい。ただし、ローカルのランタイムが生成中にチェックポイントを出力できなければならない。今のモバイル向けランタイムの多くは、これをしていない。
フォールバック先も、絶対に安全とは限らない
クラウドが遅い、混んでいる、止まっている、ということはありえる。エッジサーバーに届かないこともある。端末内かリモートかを切り替えるだけの二択では、単純すぎる。
振り分けの層は、3つの処理先すべてを見渡し、それぞれの状態に応じて動く方針を持つ必要がある。
たとえば、次のように動く。
- クラウドが遅ければ、端末内でやり直すか、エッジで待つ。
- エッジに届かなければ、クラウドに切り替える。
- 両方使えなければ、クエリを端末内で順番待ちにして、あとで再試行する。
そのためには、処理先ごとに遅延、エラー率、使えるかどうかを観察して、振り分けの判断を更新していく仕組みが要る。
振り分けの評価:失敗を捉える指標
振り分けの方針は、平均の遅延だけで評価できない。管理しているコストに偏りがあるからだ。
失敗は致命的だ。ユーザーの画面は止まり、バッテリーは減り、アプリが落ちることもある。
クラウドへのクエリは高くつくが、安全だ。平均の遅延は、これらを1つの数字に混ぜてしまい、トレードオフを隠す。
正直な評価では、ユーザーと事業にとって意味のある結果を測る。
| 指標 | 測るもの |
|---|---|
| 端末内の成功率 | 問題なく端末内で完了したクエリの割合 |
| クラッシュと固まりの発生率 | 1,000クエリあたりの失敗数(種類別) |
| 節約できたクラウド費用 | 端末内で処理して浮いた金額 |
| 端末内に残したデータ | クラウドに送らなかったクエリ |
| 末尾の遅延(復旧込み) | 失敗の検知と再試行にかかる時間を含むP99遅延 |
| セッションの安定性 | 最初の失敗までに完了したセッションあたりのクエリ数 |
測る指標と同じくらい、試験に使う処理内容も大事だ。短くて単発のプロンプトは、モバイルのランタイムに有利で、既知の弱点に負荷をかけない。現実的な処理内容には、次のものが含まれる。
- 2,000トークンを超えるプロンプト
- 500トークンを超える生成
- 端末を再起動せずに続ける20回以上の連続クエリ
- バックグラウンドで動く他のアプリによる熱の負荷
比較対象があると、学習の価値が見える
単純なルールと比べると、学習した方針が何を得ているかが分かる。
- 常に端末内:すべてのクエリを端末内で処理する。フォールバックを使わない場合の失敗率が分かる。
- 常にクラウド:すべてのクエリをクラウドへ送る。完全な安全にかかるコストが分かる。
- 温度のしきい値:端末の温度が決めたしきい値(たとえば50℃)を超えたら、クラウドへ送る。単純な経験則の基準だ。
- プロンプト長のしきい値:プロンプトの長さが決めたしきい値(たとえば2,000トークン)を超えたら、クラウドへ送る。処理内容を見る経験則の基準だ。
学習した方針が、温度のしきい値より10%低いクラウド費用で、端末内の成功率95%を達成すれば、価値を足したことになる。
常に端末内と同じ成功率で、しかもクラッシュがゼロなら、信頼性の問題を解いたことになる。比較すれば、学習が何を得ているか、増えた複雑さに見合うかが分かる。
ツールチェーンの隔たりは、エッジAIの実践に何を意味するか
不安定さの主な原因が、物理の限界ではなく、まだ未熟なGPUツールだとすれば、端末内処理の性能の上限は固定されていない。ツールチェーンが良くなれば、その上限も動く。
ドライバーやコンパイラーが良くなるにつれて、失敗が起きる範囲は小さくなる。 今は連続10回の質問で応答しなくなるランタイムが、明日は100回まで耐えるかもしれない。
今のツールチェーンで訓練した振り分けの方針は、ツールチェーンが成熟するにつれて最適でなくなる。
新しいドライバーが出たら、チームは方針を再訓練するか調整し直す必要がある。さもなければ、方針は時間とともに劣化していく。
これは、振り分けという手法の弱点ではない。環境そのものの性質だ。
端末内の処理は、クラウドの処理よりも速いペースで良くなっている。その改善に合わせて適応する方針のほうが、改善を無視する固定のルールよりも価値がある。
小さなモデルをスマホに載せるチームにとって、これは5つの実務上の要件につながる。
-
ランタイムの弱さを設計の入力として見積もる。 端末内推論がうまく動くとは考えない。負荷がかかれば失敗すると考え、その失敗にうまく対処できるようにシステムを設計する。
-
クラッシュだけでなく、気づかない失敗も記録する。 ランタイムを計測して、タイムアウトと固まりを検知する。そのログをバックエンドに送り、時間の経過や端末ごとの失敗率を追う。クラッシュは気づきやすいが、固まりは気づきにくい。
-
クラウドの経路を温めておく。 端末内がうまく動いているときでも、一部のクエリをクラウドへ送る。そうすれば、フォールバックの経路が試験され、使える状態に保たれ、比較の基準も手に入る。
-
現実的な処理内容で試験する。 長いプロンプト、長い生成、連続したクエリが、弱点に負荷をかける。短くて単発のプロンプトでは、それが分からない。
-
再訓練を計画に入れる。 ツールチェーンが良くなったら、その改善を生かすように振り分けの方針を再訓練する。時間が止まったままの方針は、数か月で最適でなくなる。
プライバシー、オフライン動作、コストの面で、端末内推論を支持する理由は今も強い。
ただしそれが成り立つのは、ローカルの処理先が力不足になったことを検知して、うまく引き継げる場合に限られる。
学習による振り分けを組み込んだハイブリッド構成は、あれば便利という程度のものではない。端末内推論を本番で信頼できるものにする、設計の土台だ。
端末内の処理は、これからも良くなっていく。それまでの間、システムは、いつ身を引くべきかを知っておく必要がある。
ちょっと立ち止まって
スマホの中で動くAIと聞くと、つい安心しないだろうか。データは手元にあるし、料金もかからない。それなら、いちばん信頼できる選択肢だと考えたくなる。
けれども、手元にあることと、最後までやり切れることは、別の話かもしれない。
あなたが普段使っているアプリで、画面が止まったまま動かなくなった経験はないだろうか。そのとき、何が起きていたのか。待っていたのは、本当に答えだったのか。
もうひとつ考えてみてほしい。「いちばんいい処理先」を1つ決めておくより、状況を見て切り替えられる仕組みのほうが、あとで効いてくるのではないか。
自分が頼りにしているものは、うまくいかなくなったとき、ちゃんと身を引いてくれるのだろうか。
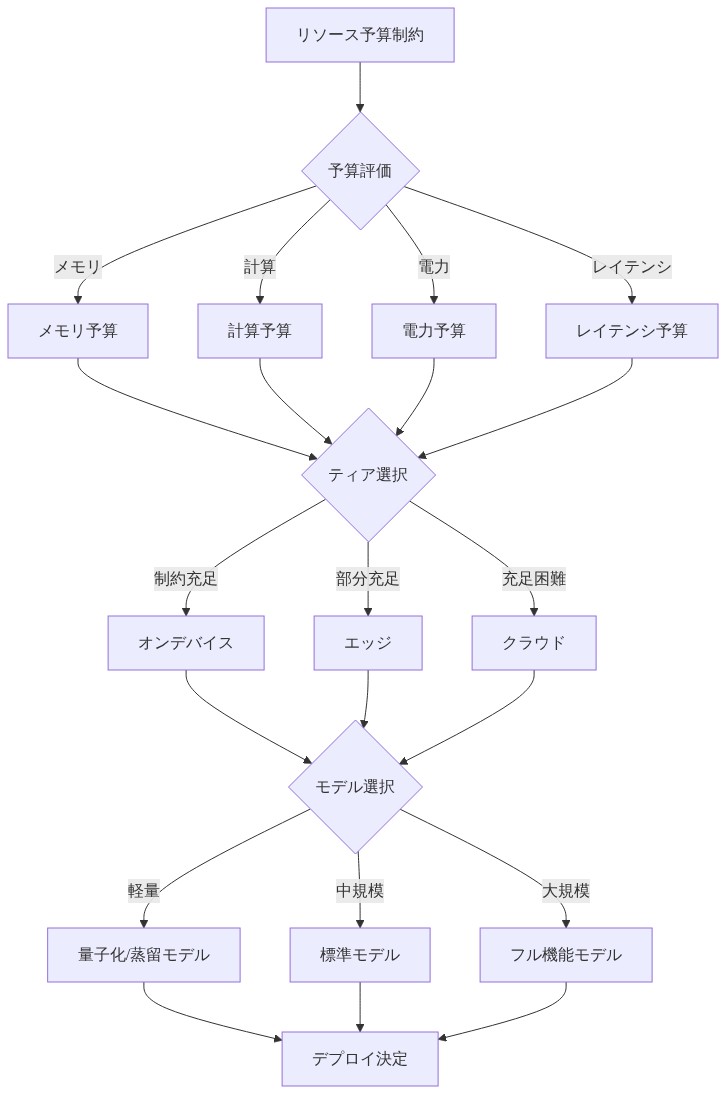
図4:リソース予算を制約とした階層的ルーティング決定フレームワーク
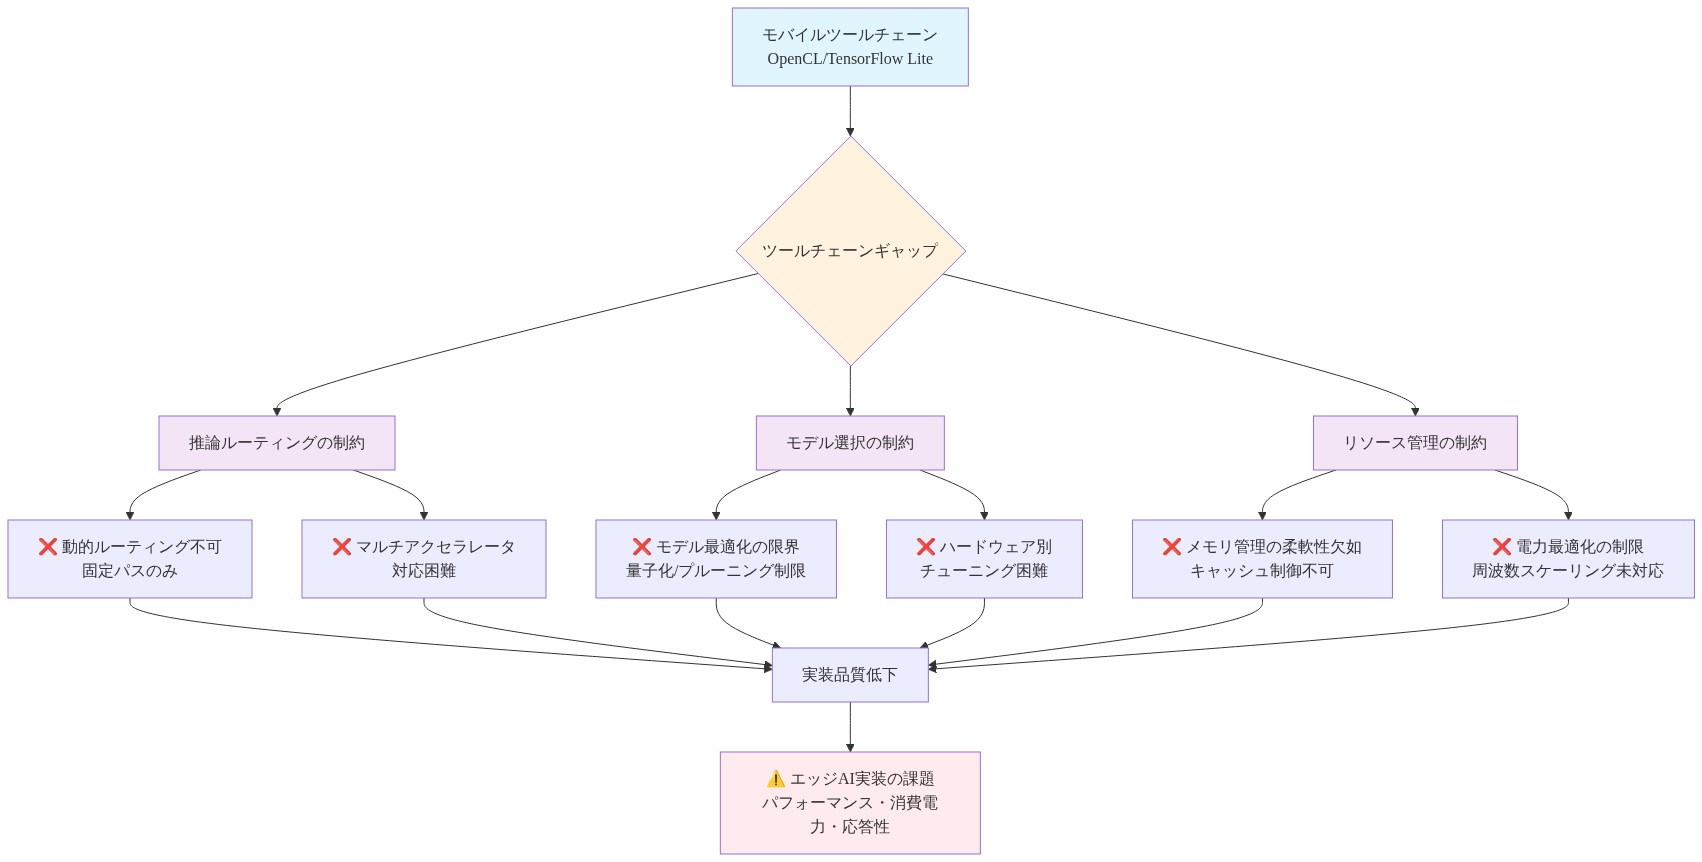
図7:ツールチェーンギャップがエッジAI実装に与える制約