テクノロジー・イノベーション
2026年9月5日 11:11
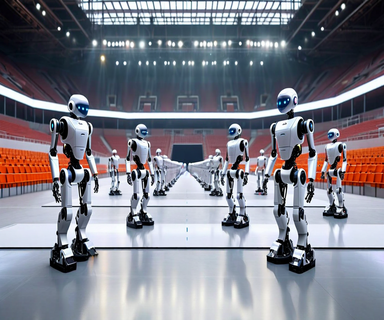
2026年北京世界ヒューマノイドロボットゲームズの現場から
北京のオリンピックスタジアムで2026年初頭に開催された第1回世界ヒューマノイドロボットゲームズは、ヒューマノイドロボティクス産業にとって重要な転換点を示しています。本大会には666チームが参加し、約2,000体のヒューマノイドロボットが競技に臨みました。この規模は、当該分野がまだ発展途上段階にあることを考えると、実証的な記録として重要です。
Tag
北京のオリンピックスタジアムで2026年初頭に開催された第1回世界ヒューマノイドロボットゲームズは、ヒューマノイドロボティクス産業にとって重要な転換点を示しています。本大会には666チームが参加し、約2,000体のヒューマノイドロボットが競技に臨みました。この規模は、当該分野がまだ発展途上段階にあることを考えると、実証的な記録として重要です。
個人トレーダーは、かつて機関投資家のヘッジファンドのみが利用できた計算ツールとデータインフラストラクチャにアクセスできるようになりました。この転換は3つのテクノロジーの収束を反映しています。(1)アクセス可能な機械学習フレームワーク(TensorFlow、PyTorch)、(2)資本要件を削減するクラウドコンピューティングインフラストラクチャ、(3)商品価格でマーケットデータと実行機能を提供するAPI。参入障壁は測定可能な形で低下しています。
深層強化学習は、畳み込みニューラルネットワーク(CNN)が下流の制御ポリシーと共に特徴表現を学習するエンドツーエンド訓練アーキテクチャに大きく依存してきました。このパラダイムは、タスク関連の視覚特徴が教師あり勾配降下最適化を通じて習得されなければならず、過度な計算資源と過学習を軽減するための慎重な正則化が必要であるという仮定に基づいています(Mnih et al., 2015; Schaal et al., 2015)。
無線スペクトラム管理は根本的な制約の下で動作します。チャネル状態の観測は不完全です。占有状態を検出するセンサーは偽陽性(チャネルがアイドル状態であるのに占有状態を示す)と偽陰性(チャネルが占有状態であるのにアイドル状態を示す)を生成します。意思決定者は、直接検証できない真の状態のノイズを含む観測に基づいて、複数のチャネル間で送信スロットを割り当てなければなりません。この運用設定は、二値潜在状態と不完全な二値フィードバックを伴う落ち着きのない盗賊問題を具現化しています。
核融合プラズマ制御は、強化学習の方法論的適用可能性を根本的に再構成する制約の下で動作しています。すなわち、オンライン試行錯誤学習は経済的に禁止的であり、運用上危険です。トカマク施設は1億度を超える温度でプラズマを強力な磁場配置内に維持します。プラズマ不安定性(破壊的放電やエッジ局在モード)は超伝導磁石と構造部品に損傷を与える可能性があり、交換費用は数億ドルを超えます(ITER Organization, 2020)。
短期賃貸物件の価格設定は、ほとんどの商業的価格設定システムとは異なる構造的制約の下で機能しています。各物件は1晩につき最大1件の予約決定を生成し、スパース(疎)で散発的なフィードバックをもたらします。これに対して、数千の客室にわたってレートを調整するホテルチェーンや、商品価格を最適化する電子商取引プラットフォームは、継続的で大量のフィードバックストリームを生成します。このスパース性は、純粋なオンラインバンディット学習アルゴリズムにとって根本的な課題を生み出します。
キリガミメタマテリアルは、体系的な切断と折り畳み操作を通じて作成された平面構造であり、三次元構成へと展開します。逆設計問題は形式的に次のように定義されます。目標となる三次元形状 S_target が与えられたとき、P の展開と F が S_target に近似する幾何学を指定された許容範囲内で生成するような二次元切断パターン P と折り畳み構成 F を決定することです。
現代の機械学習システムはスカラー目的関数を最適化します。つまり、事前に定義されたターゲットからの距離を定量化する損失関数です。この運用上の制約は、基本的な数学的区別を確立します。スカラー既約ダイナミクスは単一のポテンシャル関数φ(θ)の負の勾配として表現できますが、スカラー既約ダイナミクスはそのような還元に抵抗します。定義(スカラー既約性): 学習システムがスカラー既約ダイナミクスを示すのは、パラメータ更新がθ̇ = −∇φ(θ)として表現できる場合です。
大規模言語モデル(LLM)エージェントは根本的なアーキテクチャ上の非効率性を示しています。先行する実行履歴に関わらず、各タスクに対して初期状態からの推論を実行するのです。このステートレス設計は、以前に構造的に同一のタスクが完了していても、すべてのクエリに対して計画、実行、エラー回復に完全なトークン消費を必要とします。計算オーバーヘッドは二つの次元で現れます。第一に、冗長なトークン生成です。
感染症対応チームは、定期的に運用上の判断を迫られています。確立された疫学モデルに固定パラメータを用いて介入戦略を最適化するか、観察された結果に基づいて適応するリインフォースメントラーニング(RL)システムを採用するか、という選択です。この判断は、具体的な文脈要因に左右されます。中核的主張と前提条件: リインフォースメントラーニングが理論的に有利となるのは、三つの条件が同時に満たされる場合です。
従来の安全な強化学習は、安全性をハード制約として定式化します。数学的には、すべての軌跡を通じて不等式制約 g(s,a) ≤ 0 を満たす必要がある状態行動対として表現されます。この二値的な枠組みは、根本的な最適化の対立を生み出します。目的関数は、期待累積報酬を最大化しながら同時に制約違反確率をゼロに保つ必要があるのです。
マルチモーダル大規模言語モデル(MLLM)は確立されたベンチマークで強い性能を示す一方で、視覚的複雑性が増した条件下では体系的な失敗パターンを示しています。文書化された脆弱性には、雑然とした場面での物体の誤認識、根拠のない視覚的詳細の生成(ハルシネーション)、知覚的推論を必要とするタスクにおける推論性能の低下が含まれます。これらの失敗パターンは自動運転や医療画像解析といった安全性が重要な領域で直接的な運用上の影響をもたらします。
テンソルネットワーク生成器強化最適化(TN-GEO)フレームワークは、巡回セールスマン問題(TSP)を離散的な組み合わせ探索タスクから確率的生成問題へと再構成します。局所探索や分枝限定法を通じて候補解を反復的に改善するのではなく、TN-GEOは行列積状態(MPS)—量子多体物理学に由来するテンソルネットワーク構造—を訓練し、高品質な実行可能ツアーに集中した確率分布を学習します。
定義: Codexエージェントループは、言語モデルがコードまたはアクションを生成し、実行結果を観察し、エラーを分類し、改善された出力を再生成するという構造化された反復サイクルであり、タスク完了またはリソース枯渇まで繰り返されます。理論的基礎: 従来のコード生成は単一パス推論として機能します:意図→モデル→出力。エージェントループは、マルチステップの推論を可能にするフィードバックメカニズムを導入します。
多目的強化学習(MORL)は、逐次的意思決定における基本的な課題に取り組む。エージェントは、ユーザーが指定した選好を尊重しながら、複数の、しばしば競合する報酬信号を同時に最適化しなければならない。スカラー報酬関数r(s,a)を仮定する従来の単一目的強化学習とは異なり、MORLはベクトル値報酬関数r(s,a) ∈ ℝᵐで動作する。ここでm ≥ 2は目的の数を表す。この拡張は本質的なトレードオフをもたらす。
人間のフィードバックからの強化学習(RLHF)は、大規模言語モデルを人間の好みに合わせるための標準的なアプローチとなっている。経験的に、RLHFで訓練されたモデルは、指示追従の改善と有害な出力の測定可能な削減を示している(Christiano et al., 2017; Ouyang et al., 2022)。しかし、支配的な実装である近接方策最適化(PPO)などの方策勾配法は、実質的な運用上の複雑さをもたらす。
大規模言語モデル(LLM)は、多様な領域におけるパターン認識と推論タスクにおいて強力な性能を実証してきた(Vaswani et al., 2017; Brown et al., 2020)。しかし、構造ベース創薬(SBDD)への応用は、実用性を制約する2つの十分に文書化された制限に直面している。第一に、LLMはタンパク質構造解釈に必要な堅牢な三次元空間推論能力を欠いている。