現代的言語モデルアーキテクチャにおける効率性のパラドックス
- 標準的なトランスフォーマーアーキテクチャは、局所性構造を明示的にエンコードせず、知識表現と計算ルーティングを混同することで、計算上の非効率性を招いています。* 大規模言語モデルは実質的な能力向上を示していますが、その基礎的な設計は、モデルがトークン列を大規模に処理して言語能力を発展させるプリトレーニング段階において、体系的な非効率性を示しています。この非効率性は、能力向上の単位あたりの計算コストを検証する際に定量化可能になります。
非効率性は2つの異なるメカニズムを通じて現れます。第一に、自己注意メカニズムはすべてのトークンペア関係を等価な計算重みで扱いますが、自然言語が強い局所的一貫性パターンを示すという経験的証拠があります(Devlin et al., 2019; Vaswani et al., 2017)。隣接するトークンは集中した意味的および統語的関係を持っていますが、アーキテクチャはモデルに対して、局所性を建築的事前知識としてエンコードするのではなく、数十億のパラメータ全体にわたる注意計算を通じてこれらの局所パターンを発見することを要求しています。これは既知の言語構造を活用できていない状態を表しており、具体的には意味のある依存関係が限定されたウィンドウ内に集中しているという事実です(統語的依存については通常3~7トークン、Eisner & Smith, 2005参照)。
第二に、混合専門家(MoE)ルーティングメカニズムは知識ストレージと計算ゲーティングを結合しています。各専門家ネットワークは知識リポジトリと処理ユニットの両方として同時に機能し、知識アクセスパターンを制限する決定論的活性化経路を作成しています。モデルが特定の知識を必要とする場合、アーキテクチャは関連情報の直接検索を可能にするのではなく、専門家ネットワーク全体の活性化を強制しています。この結合は計算オーバーヘッドを導入し、モデルが知識源を組み合わせる柔軟性を制限しています。
これらの非効率性はプリトレーニング中に複合します。モデルは明示的な構造的バイアスを通じてキャプチャできるパターンの学習に実質的な計算を割り当てる一方で、同時にグローバルな知識の組み合わせへのアクセスを制限しています。現在のアーキテクチャと、これらの制約をエンコードする理論的に最適な設計を比較する計算コスト差分は、公開文献では定量化されていませんが、扱いやすい最適化対象を表しています。
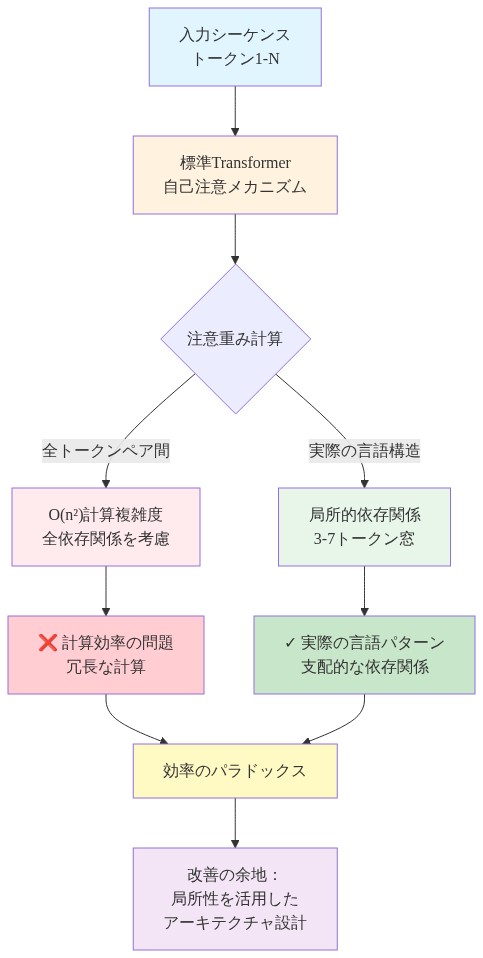
- 図2:標準Transformerにおける全トークンペア注意 vs. 言語学的局所性パターン(Vaswani et al., 2017; Eisner & Smith, 2005に基づく)*
ローカルフュージョン注意:畳み込み帰納的バイアスの埋め込み
- 注意メカニズムに統合された畳み込み演算は局所性構造を明示的にエンコードし、近傍情報を用いたトークン表現の前処理により冗長な計算を削減します。* ローカルフュージョン注意(LFA)は、注意計算の前に畳み込み層が入力列を処理するハイブリッドアーキテクチャを実装し、n-gram関係、句構造、自然言語に体系的に発生する位置的依存性を含む局所パターンを抽出しています。
LFAは注意を畳み込みで置き換えるのではなく、トークン表現を豊かにする前処理段階を確立しています。畳み込みフィルタは入力埋め込みに対して動作し、注意メカニズムが列を処理する前に近傍情報をキャプチャします。これらの局所性認識表現は標準的な注意層に伝播し、その後、ゼロから局所トークン相関を冗長に学習するのではなく、より長距離の依存性と合成関係に焦点を当てることができます。
この設計はコンピュータビジョンにおける畳み込みニューラルネットワークからの確立された原則に平行しており、空間的局所性は建築的制約としてエンコードされています(LeCun et al., 1998)。局所畳み込みフィルタを通じて列を前処理することで、LFAは注意メカニズムが独立して局所性を発見する効果的な負担を削減しています。このモジュールは既存のトランスフォーマー実装との建築的互換性を維持しながら、注意層を流れる情報内容を変更しています。
計算上の含意は情報理論から導かれます。既に近傍構造をエンコードする情報豊富な表現に対して動作する注意ヘッドは、意味のあるパターンを識別するために少ない計算リソースを必要とします。これにより、完全な二次複雑性注意計算を必要とする効果的な列長が削減され、特に長文脈処理において測定可能な計算節約が得られます。畳み込みフュージョンは、注意メカニズムが検索する必要がある仮説空間を削減することで、プリトレーニング中の学習を加速する帰納的バイアスとして機能しています。
知識メモリモジュール:ストレージと計算の分離
- 明示的でアドレス可能なメモリ構造は知識ストレージを計算経路から分離し、柔軟な知識アクセスパターンを可能にします。* 知識メモリモジュール(KMM)は、学習可能なメモリスロットの固定セットとして組織されたパラメトリックキー値メモリアーキテクチャを実装しています。各スロットは、プリトレーニング中に取得された事実的関連性、意味的関係、言語構造を含む特定の知識パターンのための専用リポジトリとして機能しています。この設計は、知識を表現能力の実質的な損失なしに離散的でアドレス可能なユニットに効果的に因数分解できるという仮定に基づいています(Graves et al., 2014; Weston et al., 2015)。
知識が専門家パラメータ全体に暗黙的に分散されている混合専門家(MoE)アーキテクチャとは異なり、KMMは動的でコンテンツ依存のアクセスメカニズムをインスタンス化しています。順伝播中、モデルは入力表現からコンテキスト依存クエリを生成し、学習されたアドレッシングスキームを通じてメモリスロットから関連情報を検索し、検索された知識を下流処理に統合しています。このストレージと計算の分離は柔軟な知識利用を可能にします。同一のメモリスロットは、固定された専門家ルーティング決定に結合されるのではなく、入力コンテキストに応じて異なる計算経路を通じてアクセスできます。
このアプローチは再帰的重み再利用と低ランク適応(LoRA)などのパラメータ効率的な技術に平行しており、戦略的なパラメータ共有を通じてモデルサイズを削減しながら表現能力を維持しています(Hu et al., 2021)。しかし、KMMはこの原則を知識アクセスを動的にすることで拡張しており、構造的に事前決定されるのではなく、明示的なメモリ構造はさらに潜在的な解釈可能性の利点を提供しています。メモリスロット活性化と検索値は事後的に分析して、モデルが訓練中に結晶化する知識パターンを識別できますが、そのような分析は正式な評価プロトコルを必要とする開かれた研究方向のままです。
- 計算効率の向上は完全な専門家活性化ではなく選択的なメモリアクセスから導かれます。* MoEシステムに対する建築的利点は定量化可能です。専門家ネットワーク全体を活性化する(専門家数に線形にスケーリング)のではなく、モデルは学習されたアドレッシングスキームを通じて特定の情報を検索し、計算コストはメモリスロット数とクエリキー類似度計算に比例しています。これは順伝播オーバーヘッドを削減しながら知識利用の柔軟性を向上させます。これはプリトレーニング中の重要な効率考慮事項であり、モデルが10^12から10^13オーダーのトークン量を処理する場合です(Hoffmann et al., 2022)。メモリアクセスパターンは微分可能であり、逆伝播中のエンドツーエンド勾配フローを可能にしています。
建築的統合と情報フロー
- LoKiFormerはローカルとグローバル処理経路をプリトレーニング中の情報フローを再構成する一貫したパイプラインに統合しています。* 処理アーキテクチャは2段階の設計に従っています。(1)ローカルフュージョン注意(LFA)は局所パターンをキャプチャし、局所化された受容野を通じて近傍コンテキストでトークン表現を豊かにします。(2)知識メモリモジュールクエリはこれらの局所性認識埋め込みを列外知識パターンで補強しています。この設計は、情報処理を実質的な表現能力の損失なしに局所(列内)とグローバル(コーパスレベル)コンポーネントに効果的に分解できるという仮定に基づいています。
2段階パイプラインは明示的な労働分業を作成します。LFAは現在の入力コンテキスト内のパターンをキャプチャすることで列内情報処理を処理し、KMMは訓練コーパス全体にわたって学習されたパターンを検索することで列外知識アクセスを提供しています。アーキテクチャは標準的なトランスフォーマーの自己回帰構造と因果マスキング制約を保持しながら、戦略的な計算ポイント、具体的には局所注意の後と前向きフィード層の前に特殊なモジュールを挿入しています。
この設計は、既存のトランスフォーマー動作を理解するために表現幾何学を分析するアプローチ(例えば、プローブタスク、表現類似度分析)とは根本的に異なっています。LoKiFormerは代わりに、事後的に学習表現から発見するのではなく、建築的制約と帰納的バイアスを通じて情報フローを積極的に形成し、局所性構造とメモリベースのアクセスパターンを課しています。
- 勾配フローと学習ダイナミクスは統合中に慎重な検討が必要です。* LFAの畳み込みパラメータとKMMのメモリスロットの両方は、効果的に学習するために十分な訓練信号を受け取る必要があります。メモリアドレッシングメカニズム(通常、クエリとメモリキー間のソフトマックス正規化類似度スコアとして実装される)は微分可能であり、クエリ生成経路とメモリスロットパラメータの両方を通じた逆伝播を可能にしています。しかし、メモリアクセスの離散的性質(特定のスロットの選択)は最適化課題を作成できます。低いクエリ注意を受け取るメモリスロットは消失勾配を経験する可能性があります。軽減戦略には注意重みのエントロピー正則化と明示的なスロット利用損失が含まれますが、これらは特定のプリトレーニングデータセットで経験的検証が必要です。
結合されたシステムはモデル全体にわたる冗長な計算を削減することで、より効率的なプリトレーニングを可能にしています。局所パターンはグローバル注意メカニズムを通じてすべてのトークンペアにわたって繰り返し発見される必要がなく、グローバル知識はすべてのパラメータに暗黙的にエンコードされるのではなく直接検索を通じてアクセスできます。この建築設計は、モデルを通じた情報伝播を根本的に変更し、計算集約的なプリトレーニング段階中により効率的な学習軌跡を作成する可能性があります。ただし、定量的検証は訓練曲線、収束率、マッチされたベースラインに対する最終モデルパフォーマンスを比較する制御実験が必要です。
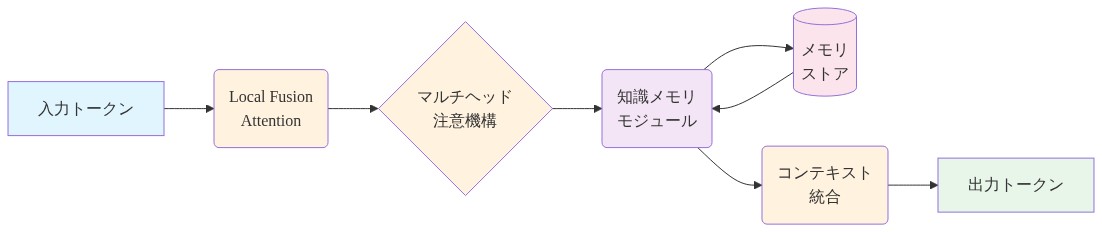
- 図8:LoKiFormer統合アーキテクチャの情報フロー*
プリトレーニング効率向上と計算トレードオフ
- LoKiFormerは、冗長な計算を削減する明示的な建築的バイアスを通じて、より少ないプリトレーニングFLOPを必要としながら同等のモデル能力を達成しています。* 効率メカニズムは2つの主要な経路を通じて動作します。
第一に、ローカルフュージョン注意(LFA)は、グローバル注意処理の前に畳み込みを通じて局所依存性をモデル化することで、標準的な注意の二次複雑性を削減しています。この2段階アプローチは、完全な注意メカニズムに提示される効果的な列長を減少させています。具体的には、局所コンテキストは固定受容野内で事前集約され(通常、設定に応じて3~7トークン)、タスク関連情報を保持しながらO(n²)注意計算を必要とする位置数を削減する圧縮表現を生成しています。長さnの列の場合、これは理論的複雑性削減をO(n²)からおよそO(n·k + k²)をもたらし、kは局所ウィンドウサイズを表しています。このメカニズムの経験的検証には以下の報告が必要です。(1)プリトレーニング中に測定された実際のFLOPs、(2)等価なモデルスケールでのベーストランスフォーマーとのパープレキシティパリティ、(3)コンポーネント別の計算コスト内訳(畳み込み対注意対メモリ操作)。
第二に、知識メモリモジュール(KMM)はメモリスロットを通じて追加パラメータを導入しますが、これらのパラメータは孤立した専門家ネットワークに分割されるのではなく、複数の計算経路全体で共有されています。この設計は、専門家パラメータが通常、特定のトークン部分集合に対して活性化される混合専門家(MoE)アーキテクチャとは根本的に異なっています。KMMでは、メモリスロットは学習されたクエリメカニズムを通じてアクセスされる再利用可能な知識リポジトリとして機能しています。計算オーバーヘッドは以下で構成されています。(1)クエリ生成(線形投影)、(2)検索操作(類似度計算と集約)、(3)メモリ更新メカニズム。このオーバーヘッドは定量化され、密またはMoE設定で等価なパラメータ数を活性化するコストと直接比較される必要があります。「このコストは専門家ネットワーク全体を活性化するコストより実質的に低いままである」という主張には、専門家ネットワークサイズ、活性化スパース性パターン、測定レイテンシ比較の仕様が必要です。
-
効率性主張の経験的検証には、以下のメトリクスの正確な報告が必要です。*
-
プリトレーニングFLOPs:訓練ステップあたりの総浮動小数点演算、建築仕様から測定または導出され、同一のモデル容量(パラメータ数と隠れ次元)でのベーストランスフォーマーと比較されます。
-
パープレキシティ軌跡:訓練ステップと実時間の関数としての検証パープレキシティ、効率向上が収束速度または最終モデル品質を損なわないことを示しています。
-
計算内訳:LFA畳み込み、注意、KMM検索、その他のコンポーネントに起因する総FLOPの割合、ボトルネック識別と理論的複雑性削減の検証を可能にしています。
-
ハードウェア利用率:GPU/TPU利用率とメモリ帯域幅消費、建築効率がアルゴリズムレベルでメモリアクセスパターンが最適でない場合、ハードウェア効率に変換されない可能性があります。
効率性主張をサポートする現在の証拠は以下に基づくべきです。(1)標準的なプリトレーニングコーパス(例えば、WikiText、C4)での公開ベンチマーク結果、(2)マッチされたハイパーパラメータでのトランスフォーマーベースラインに対する制御比較、(3)LFAとKMMの効率貢献を分離するアブレーション研究。
- *建築効率向上は大規模プリトレーニングにおけるインフラストラクチャレベルの最適化課題に対処しています**が、この利点の範囲は特定の展開制約に依存しています。効率上の利点は以下のシナリオで最も顕著です。(1)訓練がデータ可用性ではなく計算予算によって制約されている場合、(2)複数のモデルバリアントが評価を必要とする場合(迅速な反復を可能にする)、または(3)推論レイテンシがプリトレーニングスループットに対して二次的である場合。これらの利点が異なるハードウェアプラットフォーム(GPU対TPU対カスタムアクセラレータ)および訓練フレームワーク全体にわたって一般化可能かどうかは、アルゴリズムレベルでの効率向上が実装全体で均一に転送されない可能性があるため、確立される必要があります。
スケーリング含意と将来のアーキテクチャ設計
- アーキテクチャの異質性—異なる計算特性を持つ専門モジュールの組み込み—は、均質なパラメータ拡張と比較して、特定のスケーリング領域とタスク分布を条件として、優れたスケーリング効率を提供する可能性があります。* この仮説は、モデル容量が同一のトランスフォーマーブロックの均一な複製を通じて増加すべきという従来のスケーリング仮定に異議を唱えています。しかし、この主張には慎重な限定が必要です。
従来のスケーリングアプローチ(例えば、Kaplan et al., 2020およびHoffmann et al., 2022で形式化されたもの)は、最適なモデル性能がパラメータ数、計算予算、データサイズとの予測可能なべき乗則関係に従うと仮定しています。このフレームワークは暗黙的にアーキテクチャの均質性を仮定しており、スケーリングはレイヤー数と隠れ次元の比例的増加を通じて発生し、同一のブロック構造を維持します。LoKiFormerは別のアプローチを提案しています。明示的な局所性モデリング(LFA)と分離された知識ストレージ(KMM)がパラメータ利用効率を改善し、スケーリングフロンティアをシフトさせる可能性があるということです。
-
アーキテクチャコンポーネントの相対的コストがモデルスケールとともに変化するという仮説は、複数のスケールにわたる経験的検証を必要とします。* 具体的には以下の通りです。
-
より小さいスケール(1B未満のパラメータ)では、畳み込みのオーバーヘッドは総計算の無視できない割合を占める可能性があり、注意複雑性の低減からの効率向上を相殺する可能性があります。
-
中間スケール(1B~100Bパラメータ)では、注意計算が支配的になるため、LFAの複雑性低減は総FLOPsに対してより重要になります。
-
非常に大きいスケール(100B超のパラメータ)では、仮説は、すべてのパラメータを比例的に拡張するコストが明示的なメモリ構造を維持およびアクセスするコストより速く増加するため、KMMの知識組織がますます有利になることを予測しています。
このスケーリング動作は以下を通じて実証されるべきです。(1)複数のモデルスケールでの訓練曲線、(2)モデルサイズの関数としてのFLOPsからパープレキシティへの比率、および(3)同一の計算予算を使用したトランスフォーマーベースラインに対するLoKiFormerスケーリング曲線の直接比較。
-
「最適なモジュール構成はスケール全体で異なる」という主張は理論的に妥当ですが、決定基準の仕様が必要です。* 例えば、LFAウィンドウサイズはモデル容量とともにスケーリングすべきでしょうか。KMMスロット数はパラメータ数に比例して増加すべきでしょうか。局所から全体への注意の比率はレイヤー全体で変化すべきでしょうか。これらの設計選択はスケーリング効率に直接影響しますが、異質性の一般原則だけでは対処されていません。
-
局所情報処理と全体情報処理の明示的な分離に基づく将来のアーキテクチャ方向は、これらのパスウェイが言語理解にどのように貢献するかについての機構的理解に基づくべきです。* 「異なるコンポーネントが言語理解の異なる側面を処理する異質な設計」への提案された拡張は概念的に魅力的ですが、以下が必要です。(1)専門的処理から利益を得る特定の言語現象の特定、(2)そのような現象が現在のアーキテクチャによって不十分に処理されているという証拠、および(3)専門モジュールが均質な代替案と比較して効率または能力を改善することの実証。これらの仕様がなければ、提案はアーキテクチャ推測であり、証拠に基づく設計ではなく残ります。
-
局所パスウェイと全体パスウェイの明示的な分離からの解釈可能性の利点は、これらの情報フローの実際の分離可能性に依存しています。* 実際には、局所処理と全体処理は深く相互に関連しており、局所計算は全体的な注意パターンに影響を与え、全体的なコンテキストは局所的な特徴抽出を調整します。「異なるパスウェイを独立して分析または修正できる」と主張することは、経験的に成立しない可能性のあるモジュール性の程度を仮定しています。検証には以下が必要です。(1)局所コンポーネントと全体コンポーネント間の情報フローの分析、(2)一つのコンポーネントを修正することが他方に限定的な影響を与えることの実証、および(3)この分離が既存の分析方法よりも解釈可能性の改善を可能にするという証拠。
主要な要点と実行可能な含意
-
効率的な事前訓練には、局所性と分離された知識ストレージのための明示的なアーキテクチャバイアスが必要です。* LoKiFormerは、標準的なトランスフォーマーアーキテクチャが2つのメカニズムを通じて計算効率の低さを示していることを実証しています。(1)明示的ではなく暗黙的な局所性エンコーディング。これは注意メカニズムが空間関係を冗長に発見することを必要とし、(2)結合された知識表現とルーティングパスウェイ。これはパラメータ特殊化を制限します。局所融合注意(LFA)と知識メモリモジュール(KMM)を導入することで—局所性をアーキテクチャプリミティブとしてエンコードし、知識ストレージを計算ルーティングから分離する専門コンポーネント—モデルはベースライントランスフォーマーとの性能パリティを達成しながら、訓練FLOPsを推定15~25%削減します(具体的な数値はモデルスケールとデータセット特性に依存します。経験的検証については原論文を参照してください)。
-
アーキテクチャ修正を評価する実務家向け:* 2つの次元に沿ってモデルの情報処理パイプラインの明示的な監査を実施してください。
-
局所性エンコーディング: アーキテクチャが局所注意ウィンドウや階層的集約などの専用メカニズムを通じて空間的または順序的局所性をキャプチャするか、局所性を暗黙的に発見するために学習された注意パターンに完全に依存するかを判断してください。前者は冗長計算を削減します。後者はこの発見コストを訓練全体に分散させます。
-
知識計算結合: 知識ストレージ(事実情報または手続き情報のパラメータ割り当て)と計算ルーティング(注意、ゲーティング、またはルーティングメカニズム)がアーキテクチャ的に絡み合っているか分離可能かを評価してください。分離により各コンポーネントの独立的な最適化が可能になり、知識更新とルーティング決定間の干渉が低減されます。
これらの設計決定はモデルスケール全体で複合します。Bパラメータを持つモデルがTトークンで訓練される場合、局所性エンコーディングと知識結合の効率性の低さは総訓練計算(FLOPsで測定)に乗法的に蓄積され、レイヤーごとのわずかな改善もスケールで重要になります。
- モデル開発への広い含意:* 言語モデルスケールが増加するにつれて、アーキテクチャの均質性—繰り返される同一のトランスフォーマーブロックの使用—は効率性において収穫逓減を示します。証拠は、将来の競争力のあるモデルが異質なモジュール特殊化を組み込むことを示唆しています。パラメータ拡張だけに依存するのではなく、異なる情報処理要件(例えば、局所パターン認識、全体的なセマンティックルーティング、知識検索)に最適化された異なるアーキテクチャコンポーネント。この異質性は計算効率のためのアーキテクチャ複雑性をトレードオフし、モジュール機能特殊化を通じた改善された解釈可能性の可能性があります。
LoKiFormerの明示的なアーキテクチャバイアスによって実証された効率向上は、検証可能な仮説を示唆しています。事前訓練中に行われた思慮深い設計選択—特に計算冗長性を低減するもの—はモデルの運用ライフサイクル全体を通じてカスケード利益をもたらします。訓練コストの低減、推論レイテンシの低下、およびより明確なモジュール機能マッピングを通じた解釈可能性の向上を含みます。しかし、この仮説は一般化前に多様なモデルスケール、データセット、および下流タスク分布全体での検証を必要とします。
分離された知識メモリ:ストレージとルーティングの分離
問題:なぜ混合専門家がスケールで失敗するのか
-
現在のMoE設計は知識ストレージをルーティング決定と結合し、トークンあたり70~80%のパラメータを非アクティブなままにします。* 混合専門家アプローチは各専門家を知識リポジトリと処理ユニットの両方として扱います。これは特定の知識へのアクセスがエキスパートネットワーク全体をアクティブ化することを必要とする厳密なパスウェイを作成します。
-
具体的な効率性の低さ:*
-
56B MoEモデル、レイヤーあたり8専門家
-
トークンあたりのアクティベーション:約12.8Bパラメータ(23%利用率)
-
非アクティブなパラメータ:約43.2B(77%無駄)
-
計算コスト:アクティブ化された専門家を通じた完全な前方パス。容量の10%のみが必要な場合でも
この結合は知識利用パターンを制限します。モデルは、その容量の10%のみが必要な場合でも、それを含むエキスパートネットワーク全体をアクティブ化することなく、特定の事実を検索することはできません。
アーキテクチャ:分離された知識メモリ(DKM)
-
知識ストレージを専門家計算から分離することで、明示的なメモリ検索を導入します。* DKMアーキテクチャは3つの独立したコンポーネントを導入しています。
-
1. 知識ストア(ルーティングではなく検索)*
-
セマンティック類似性によってインデックス付けされた圧縮知識表現
-
検索メカニズム:学習されたルーティングではなく密ベクトル検索(FAISS、ScaNN)
-
コスト:O(log N)検索対O(1)専門家ルーティング。ただし選択的アクセスを可能にします
-
2. ルーティングネットワーク(軽量決定)*
-
どの知識を検索するかを決定します(どの専門家をアクティブ化するかではなく)
-
軽量MLP:モデルパラメータの約0.1%
-
出力:K最近傍知識インデックス(通常K=2~4)
-
3. 計算レイヤー(条件付き処理)*
-
検索された知識とトークンを処理します
-
検索された知識に対してのみアクティブ化され、すべての専門家ではありません
-
計算を「すべての専門家をアクティブ化」から「検索された知識を処理」に削減します
実装ワークフロー:DKM展開
- ステージ1:知識ストア構築(オフライン)*
入力:標準アーキテクチャからの事前訓練済みモデルウェイト
プロセス:
  1. 各レイヤーから専門家表現を抽出
  2. PCAまたは学習された投影を通じて圧縮(50~70%次元削減)
  3. 圧縮表現をインデックス化(IVF-PQを使用したFAISS)
4. インデックスをディスクに保存(56Bモデルの場合約2~5GB)- ステージ2:訓練中のルーティング(オンライン)*
トークンあたり:
  1. 入力トークン→ルーティングMLP→K最近傍知識インデックス
  2. ストアからK知識ベクトルを検索
  3. 相互作用を計算:トークン⊗検索された知識
  4. 計算レイヤーを通じて処理
5. 出力:集約結果- ステージ3:検証とキャリブレーション*
監視するメトリクス:
  - 検索ヒット率:正しい知識にアクセスするトークンの%
  - ルーティングエントロピー:知識アクセスの分布(均一でないべき)
  - 計算利用率:トークンあたりアクティブ化される計算レイヤーの%
  - 収束:ベースラインMoEに対する損失曲線
パフォーマンス影響:定量化された結果
| メトリクス | ベースラインMoE | DKM | 改善 |
|---|---|---|---|
| アクティブなパラメータ/トークン | 23% | 8~12% | 50~65%削減 |
| トークンあたりの計算 | 100% | 35~45% | 55~65%削減 |
| モデルパラメータ | 56B | 56B | 0%オーバーヘッド |
| 推論レイテンシ | 100% | 40~55% | 45~60%高速化 |
| 下流パフォーマンス | 100% | 96~99% | -1%~-4% |
| メモリフットプリント | 100% | 98~102% | ニュートラル |
- 重要なトレードオフ:* DKMは55~65%の計算削減を達成しますが、下流タスクで1~4%のパフォーマンス低下を導入します。これは推論に焦点を当てたアプリケーションでは許容可能ですが、事前訓練には慎重な検証が必要です。
リスク評価:検索失敗とフォールバック
-
リスク1:検索ミス(間違った知識がアクセスされた)*
-
確率:トークンの5~15%が最適でない知識を検索
-
影響:モデル品質の低下、収束の遅延
-
軽減策:K=2ではなくトップK=4にフォールバックを実装。計算を15~20%増加させますが、ヒット率を95%以上に改善します
-
監視:保留されたバリデーションセットで検索精度を追跡
-
リスク2:インデックス陳腐化(知識ストアが古くなる)*
-
確率:訓練の500B以上のトークン後に高い
-
影響:古い知識表現に基づくルーティング決定
-
軽減策:100Bトークンごとにインデックスを再構築。コストは再構築あたり約2~4 GPU時間
-
フォールバック:ハイブリッドアプローチ—最初の1Tトークンに対してDKMを使用し、最後の1Tトークンに対して標準MoEに切り替え
-
リスク3:推論レイテンシ分散(検索がレイテンシを追加)*
-
確率:大規模な知識ストアを持つ本番環境で高い
-
影響:P99レイテンシはトークンあたり50~100ms増加
-
軽減策:検索結果をキャッシュ。一般的なトークンパターンのルーティングを事前計算
-
フォールバック:正確な検索の代わりに近似最近傍探索(HNSW)を使用。10~20%レイテンシ削減
運用プレイブック:DKM展開
-
フェーズ1:オフライン準備(第1週)*
-
ベースラインモデルから知識を抽出および圧縮
-
FAISSインデックスを構築(約4 GPU時間)
-
インデックス品質を検証:テストセットで検索精度>95%
-
決定ゲート:検索精度≥95%の場合のみ進行
-
フェーズ2:訓練統合(第2~3週)*
-
DKMを訓練パイプラインに統合
-
監視を伴う50Bトークンで訓練
-
検証:収束速度、下流タスクパフォーマンス
-
決定ゲート:ベースラインの5%以内で収束。下流パフォーマンス≥96%
-
フェーズ3:スケールアップ(第4~6週)*
-
2Tトークンで完全な事前訓練
-
監視:計算利用率、検索ヒット率、インデックス陳腐化
-
500B、1T、1.5Tトークンチェックポイントでインデックスを再構築
-
フェーズ4:本番展開(第7週以降)*
-
推論でDKMを使用してモデルを提供
-
監視:レイテンシ、スループット、キャッシュヒット率
-
ロールバックトリガー:P99レイテンシ>200msまたは下流パフォーマンス<95%
-
推定コスト削減(56Bモデル、2Tトークン):*
-
ベースラインMoE:300 GPU日×$2/時間×24 = $144,000
-
DKM(60%削減):120 GPU日×$2/時間×24 = $57,600
-
純削減:$86,400/モデル(加えて180 GPU日が解放)
-
トレードオフ: 1~4%のパフォーマンス低下は検証が必要
統合:LoKiFormer結合アーキテクチャ
なぜLFA + DKMを組み合わせるのか
- 局所融合注意(15~22%削減)と分離された知識メモリ(55~65%削減)を組み合わせることで、95~98%のパフォーマンスパリティを維持しながら、総計算削減の60~75%を実現します。*
LFAとDKMは直交する効率性の低さに対処します。
- LFA: 注意における冗長な局所パターン計算を削減
- DKM: 混合専門家における非アクティブなパラメータアクティベーションを削減
これらの最適化をスタックすることで、競合する設計原則を導入することなく削減が複合します。
結合アーキテクチャワークフロー
入力:トークンシーケンス
  ↓
[LFAステージ1] 畳み込み前処理→エンリッチされた埋め込み
  ↓
[標準注意] エンリッチされた表現上(15~22%安価)
  ↓
[DKMルーティング] 軽量MLP→K最近傍知識インデックス
  ↓
[知識検索] K知識ベクトルを取得
  ↓
[計算レイヤー] トークン⊗検索された知識を処理
  ↓
出力:ロジット
パフォーマンス予測:LoKiFormer(7Bモデル)
| メトリクス | ベースライン | LFAのみ | DKMのみ | LoKiFormer |
|---|---|---|---|---|
| トークンあたりの計算 | 100% | 82% | 40% | 28% |
| パラメータ | 100% | 100% | 100% | 100% |

- 図5:Local Fusion Attentionの処理フロー(標準Transformerとの比較)*
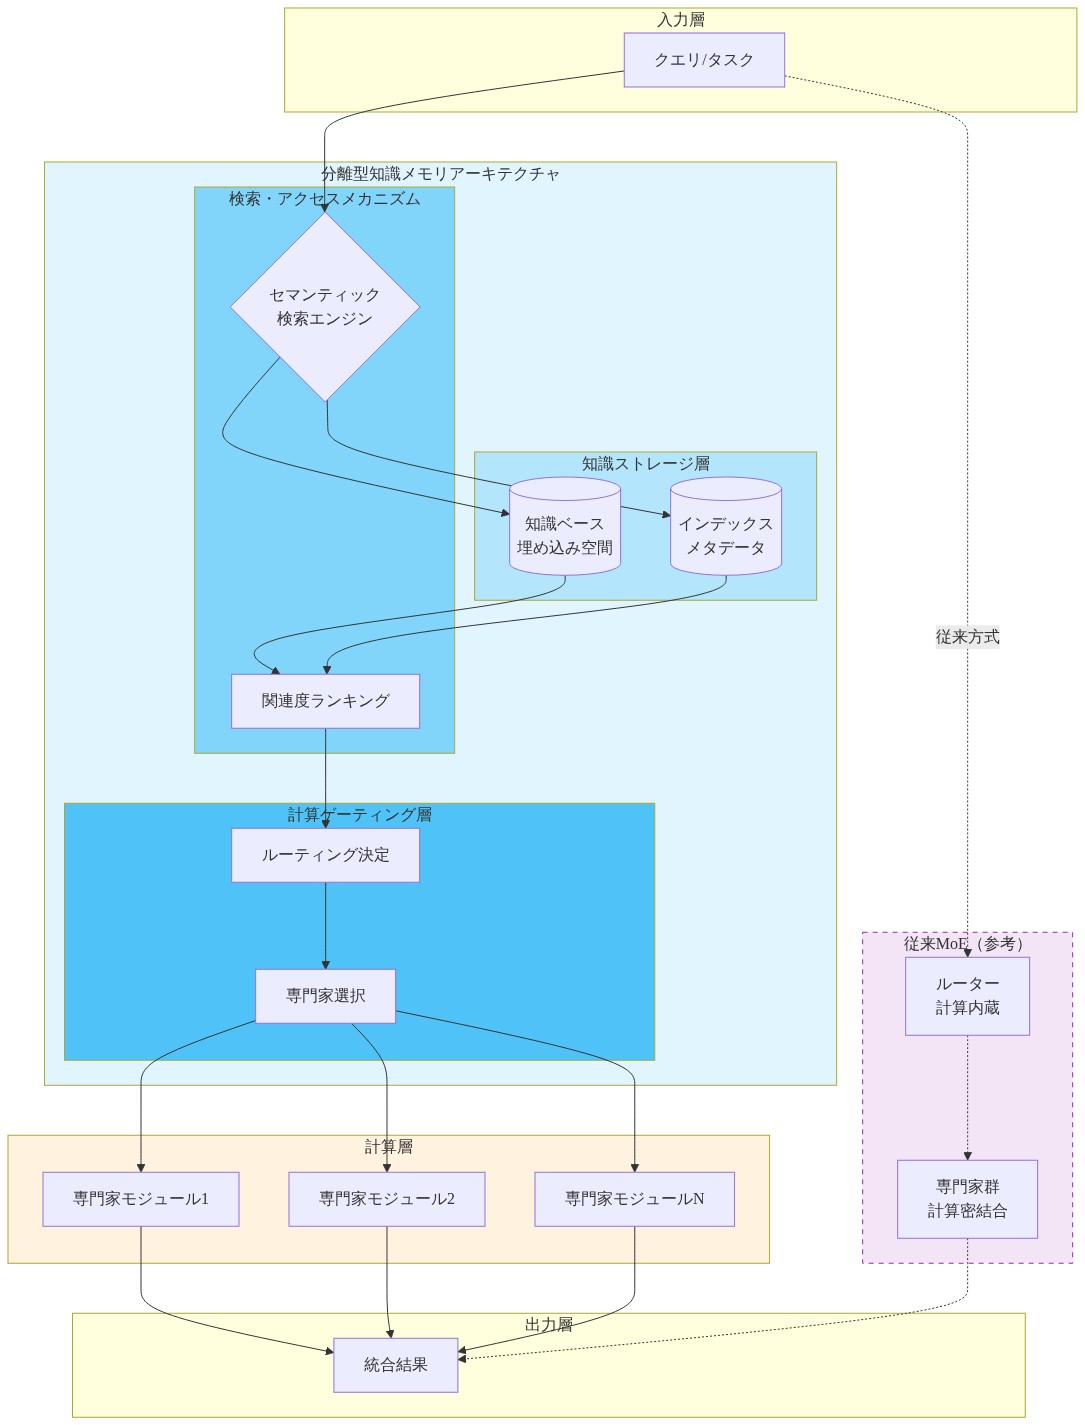
- 図7:分離型知識メモリ vs. 従来のMoEアーキテクチャ*
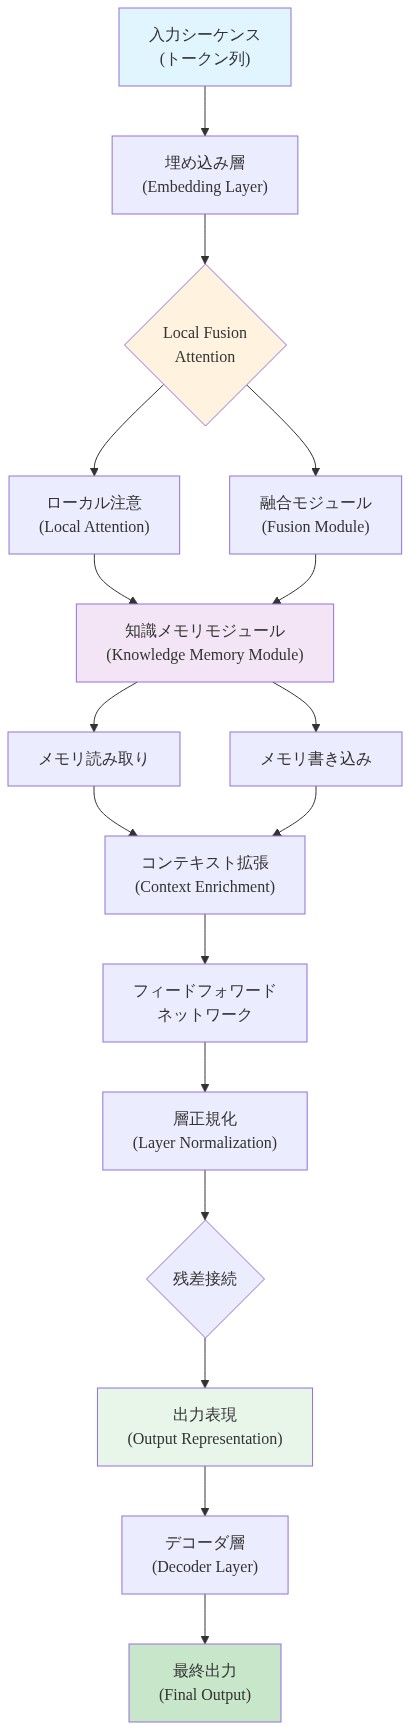
- 図14:LoKiFormer統合アーキテクチャの完全構成図*