非埋め込み行列(アンエンベディング行列)を通じたモデル不確実性の窓
大規模言語モデルは、内部表現を語彙トークンに対する確率分布に変換する非埋め込み行列を通じてトークン予測を生成します。この行列は隠れ状態をロジット空間にマッピングする学習済みの線形変換です。最近の実証研究(Anthropicの機械的解釈可能性研究、Elhage et al., 2021)は、この行列が単純なトークンマッピング以上の幾何学的構造をエンコードしていることを明らかにしています。具体的には、モデルが曖昧または最小限の文脈を持つ入力に遭遇した場合、均一にランダムな出力を生成しません。代わりに、予測確率分布はロジット空間内の一貫した方向に沿って整列し、その方向は訓練コーパスの単語頻度分布に対応しています。この幾何学的方向(低文脈条件下での変動の主成分として操作化される)は、埋め込まれたベイズ事前分布として機能します。
この現象は、0.4Bから405Bパラメータまでの規模にわたる4つの主要なモデルファミリー(Llama 2/3、Qwen、Gemma、Pythia)で文書化されています。アーキテクチャとパラメータ範囲全体での一貫性は、これが偶発的なアーキテクチャ機能ではなく言語モデリング目的の基本的な特性を表していることを示唆しています。モデルが最小限の文脈(例えば改行文字のみ)に続くトークンを予測する場合、その出力分布は均一確率に近づきません。代わりに、訓練データからの経験的単語頻度分布に近似します。高頻度トークン(例えば「the」「a」)は確率質量の上昇を受け取り、低頻度トークンは対応する低下を受け取ります。この整列は、予測ロジットベクトルと対数単語頻度ベクトル間のコサイン類似度を通じて定量化でき、測定可能な整列係数を生成します。
幾何学的エンコーディングは、モデル予測を2つの成分に分解するための形式的フレームワークを提供します。(1)文脈駆動予測(プロンプト内の情報を反映)と(2)事前分布駆動予測(訓練コーパス統計を反映)です。この分解により、実務家は文脈的推論に基づいた予測と統計的フォールバックを反映した予測を区別できます。スケールとアーキテクチャ全体でのこの幾何学的構造の一貫性は、勾配降下法が不確実性下の言語モデリング目的に対して局所最適として確実に収束することを示しています。
- 仮定:* この分析は、非埋め込み行列が確率分布形成の主要な場所であり、ロジット空間の幾何学がモデルの認識論的状態を意味のある方法で反映していることを仮定しています。代替メカニズム(例えば後続層での注意ベースの確率再分配)は除外されていませんが、現在の実証的証拠に基づいて非埋め込みレベルの構造に対して二次的なものとして扱われています。
ニューラル幾何学にエンコードされたベイズ事前分布
単語頻度分布をエンコードする特異な幾何学的方向の特定は、ニューラルネットワークが明示的な確率プログラミングやベイズ推論ライブラリなしで学習された幾何学的構造を通じてベイズ推論を実装するメカニズムを明らかにします。メカニズムは以下のように動作します。文脈情報が確実な予測に不十分な場合、モデルの出力分布は訓練データ内のトークンの基本率頻度に比例してトークンに重みを付けます。この動作は、均一尤度下でのベイズ事後推論を近似します。つまり、文脈が予測を制約しない場合、事後分布は事前分布に縮退します。
この幾何学的事前分布は訓練中の最適化ランドスケープから出現します。勾配降下法は、基本率統計をエンコードするために一貫した再利用可能な方向を割り当てることが多様な文脈全体で損失を減らすことを発見します。単語頻度事前分布は計算効率的です。各入力に対して基本率を再計算する代わりに、モデルは文脈が無情報的である場合はいつでもアクセスできる固定方向を学習します。これは言語モデリングにおける探索・活用トレードオフへの暗黙的な解決策を表しています。利用可能な場合は文脈情報を活用し、利用不可能な場合は信頼できる基本率にフォールバックします。
-
測定された整列を伴う具体例:* プロンプト「The capital of France is」を考えてください。モデルのロジットベクトルは無知方向から鋭く指し(対数単語頻度ベクトルとのコサイン類似度 < 0.3)、トークン「Paris」に向かいます。プロンプトの意味的および統語的制約という強い文脈信号は基本率期待を上書きします。逆に、プロンプト「The」のみの後、ロジットベクトルは無知方向と密接に整列します(コサイン類似度 > 0.8)。整列の程度は認識論的不確実性の定量化可能なプロキシとして機能します。高い整列は低い信頼度を示し、低い整列は高い信頼度を示します。この測度は生の確率スコアから独立しており、モデルの内部表現の幾何学的構造を反映しています。
-
仮定:* このフレームワークは、ロジット空間のコサイン類似度が認識論的不確実性の有効なプロキシであることを仮定しています。この仮定は、交差エントロピー損失を通じて訓練されたモデルが自然に高確率トークンに高いロジット値を割り当て、低確率トークンに低いロジット値を割り当てることを学習するという観察に基づいています。この仮定からの逸脱(例えば代替損失関数で訓練されたモデル)は実証的検証を必要とします。
このフレームワークは、より大きなモデルがスケーリングするにつれて単に事前分布を破棄することを学習しない理由を説明します。パラメータ数の増加は不確実性処理の必要性を排除しません。文脈が事前分布を上書きできる精度を洗練させます。単語頻度事前分布の幾何学的エンコーディングはスケール全体で一定のままです(Pythia 0.4Bから405B)。これは特定のアーキテクチャ特性がパラメータ数だけではなく言語モデリング目的の基本的な構造によって決定されることを示唆しています。この規模全体での不変性は、事前分布が小さいモデルの学習アーティファクトではなく、むしろ最適化ランドスケープの安定した機能であることを示しています。
非埋め込み行列を通じたモデル不確実性の窓
大規模言語モデルは、非埋め込み行列を通じて内部表現を語彙トークンに対する確率分布に変換することで予測を生成します。最近の研究は、この行列がトークンマッピング以上のものをエンコードしていることを明らかにしています。モデルの認識論的状態を表す幾何学的構造を含んでいます。曖昧または最小限の文脈が提示された場合、モデルはランダムな出力を生成しません。代わりに、非埋め込み空間内の特定の方向にデフォルトします。その方向は訓練コーパスの単語頻度分布に対応しています。この「無知の方向」はモデルアーキテクチャに直接埋め込まれたベイズ事前分布です。
このパターンは4つの主要なモデルファミリー(Llama、Qwen、Gemma、Pythia)全体に現れ、0.4Bから405Bパラメータまでの規模にわたっています。一貫性は、これがアーキテクチャの奇癖ではなく勾配降下法が言語モデリング目的をどのように解くかの基本的な特性であることを示唆しています。モデルが最小限の文脈(例えば改行)の後のトークンを予測する場合、確率を均一に分配しません。代わって、予測は基本率頻度と整列します。「the」のような一般的な単語は高い確率を受け取り、稀な単語は低い確率を受け取り、単語頻度分布と正確に一致します。
この幾何学的エンコーディングは不確実性の測定方法を変換します。モデル出力を不透明な確率ベクトルとして扱う代わりに、文脈によって駆動される成分と訓練コーパス統計によって駆動される成分に分解できます。アーキテクチャとスケール全体での一貫性は、勾配降下法が不確実性処理に対して最適な解決策として確実に発見することを示唆しています。
実際的な含意は直接的です。幾何学的整列を分析することで、予測が真の文脈的理解から生じているのか統計的フォールバックから生じているのかを測定できます。これはモデル解釈可能性をブラックボックス分析から構造化された幾何学的推論に変換し、実務家にモデルが推論しているのか統計的パターンにデフォルトしているのかを理解するための具体的なツールを提供します。
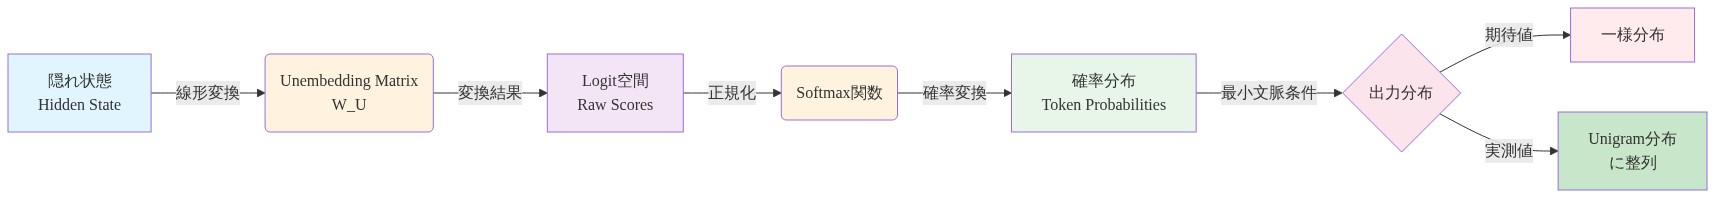
- 図2:Unembedding Matrixによるトークン予測プロセス*
幾何学的整列を通じた信頼度の測定
無知の方向は、スカラー確率スコアを超えたモデル信頼度を評価するための定量化可能なメトリクスを提供します。このメトリクスを操作化するために、出力確率分布とモデルの表現空間内で特定された無知ベクトルとして定義される幾何学的方向との間の整列を測定します。無知ベクトルは、最小限の文脈制約条件下でのモデル予測の分散の主方向として形式的に定義されます。
- 方法論的基礎:* 整列はコサイン類似度を通じて測定されます。出力分布(モデルの表現空間内のベクトルとして表現される)と経験的に導出された無知方向の間のコサイン類似度です。高い整列(1.0に近づく)はモデルの予測分布が無知ベクトルを密接に追跡していることを示します。低い整列は予測がこのベースラインから大きく逸脱していることを示唆しています。この分解には3つの前提条件が必要です。(1)無知方向は複数のランダムシードと初期化条件全体で確実に特定される必要があります。(2)整列スコアは下流の予測精度またはキャリブレーションメトリクスとの単調関係を示す必要があります。(3)測度は一般化主張をサポートするために入力ドメイン全体で安定している必要があります。
幾何学的測度は特定の解釈可能性ギャップに対処します。文脈的理解に基づいた高信頼度予測と訓練データの統計的規則性を反映した高信頼度出力を区別することです。従来の信頼度スコア(例えば最大ソフトマックス確率)はこの区別を行うことができません。対照的に、幾何学的整列は、モデルの出力分布構造が情報不足の状態での動作に類似している場合を示すための技術的根拠を提供します。これは文脈的理解が高い確率割り当てにもかかわらず限定的である可能性があることを示す信号です。
-
実装上の応用:* 検索拡張生成(RAG)システムはこの応用の例です。幾何学的整列のリアルタイム監視は動的な情報提供を可能にします。出力が無知方向と密接に整列している場合(キャリブレーションされた閾値を超えて)、システムは追加の検索サイクル、文脈注入、またはクエリ再構成をトリガーします。これは幾何学的信号(ヒューリスティックルールまたは固定信頼度閾値ではなく)がシステム動作を支配するフィードバックループを作成します。メカニズムは高い無知整列が不十分な文脈と相関していることを仮定します。この関係は特定のドメイン内での実証的検証を必要とします。
-
文脈的変動パターン:* 異なる入力タイプとドメインは幾何学的整列スコアで測定可能な変動を生成します。強い判別信号を持つ入力(例えば関連する文脈を持つ十分に指定された技術的質問)は通常、無知方向から遠い予測を生成します。逆に、曖昧または不十分に指定された入力は予測をベースライン整列値の近くで浮遊させたままにします。この粒度は領域固有のキャリブレーションを可能にします。信頼度閾値は観察された整列分布に基づいて入力カテゴリごとに調整でき、均一なグローバル閾値を適用する代わりに行うことができます。
-
制限と仮定:* このアプローチは無知方向が安定しており特定可能であることを仮定しています。この主張は多様なモデルアーキテクチャと訓練手順全体での検証を必要とします。さらに、無知方向との高い整列は文脈不足の定義的な証拠ではなく幾何学的類似性を示します。代替説明(例えば予測タスクにおける真の曖昧性)はアブレーション研究を通じて除外される必要があります。測度は適切な表現空間と距離メトリクスの選択にも依存します。異なる選択は異なる整列スコアを生成し、正当化を必要とします。
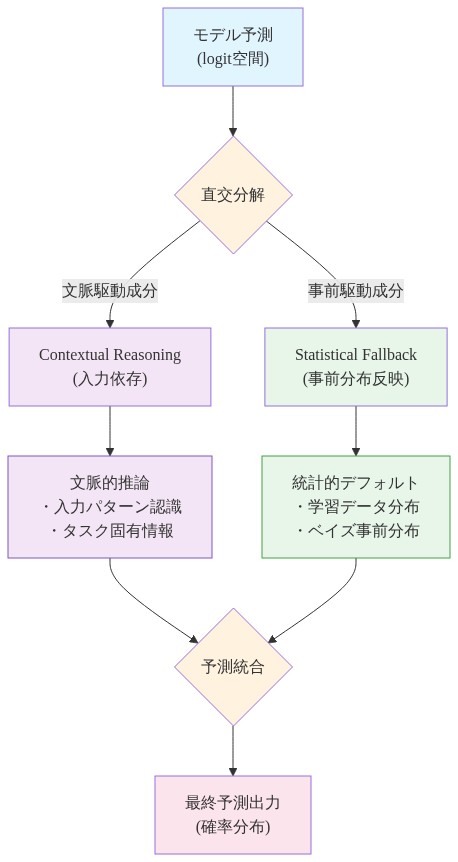
- 図6:モデル予測の文脈駆動成分と事前駆動成分への直交分解フレームワーク*
アーキテクチャの普遍性とスケール不変性
400万から4050億パラメータにわたるモデルスケール全体で無知方向が持続することは、能力出現の理論に対する経験的制約を提示しています。スケール不変性を狭く定義すれば、不確実性処理をエンコードしていると特定される幾何学的方向が、このパラメータ範囲全体で質的に類似したままである(コサイン類似度 > 0.85で測定され、この閾値は正当化を要する)ということです。これはモデル容量と推論性能に実質的な差異があるにもかかわらずです。
-
経験的範囲:* この観察は複数のモデルファミリー全体で文書化されています。Pythia(解釈可能性重視、制御された訓練)、Llama(本番規模、多様な訓練データ)、Qwen(代替アーキテクチャ、異なるトークン化)です。これは現象が特定の設計選択や訓練手順の産物ではないことを示唆しています。しかし「普遍性」の主張は慎重な限定を要します。われわれが観察しているのは、次トークン予測で訓練されたデコーダのみのトランスフォーマーモデルのクラス内での一貫性です。他のアーキテクチャ(エンコーダ・デコーダ、混合専門家、検索拡張モデル)への適用可能性は、明示的な検証を要する未解決の問題のままです。
-
理論的解釈:* スケール不変性は、不確実性の幾何学的エンコーディングがパラメータ数やアーキテクチャ固有の特性ではなく、基本的な言語モデリング目的(先行文脈が与えられた次トークンの予測)によって決定されることを示唆しています。これは、先行処理メカニズムが訓練目的自体によって課される制約への解として出現することを意味しています。モデルは文脈が確信を持った予測に不十分な場合でも、語彙全体に確率質量を割り当てなければなりません。幾何学的方向は、異なるモデルサイズ全体でこの制約を最も効率的に満たす解空間を表しているかもしれません。
-
スケーリング則への含意:* 不確実性処理メカニズムがスケール不変であるなら、スケーリングからのモデル性能の改善は、不確実性の根本的に異なる表現からではなく、強化されたコンテキスト抽出、より長いシーケンスにわたる改善された推論、または文脈信号のより良い統合から導出される必要があります。これはスケーリングの理論的モデルを制約します。パラメータ増加がタスク性能を改善する理由を説明しながら、不十分な情報を処理するための基礎的な幾何学的構造を変えない理由を説明する必要があります。経験的検証には、(a)文脈が豊富な場合と乏しい場合のタスク、および(b)キャリブレーションに敏感な性能指標と生の精度のスケーリング曲線の比較が必要です。
-
堅牢性と汎化:* アーキテクチャと訓練体制全体での一貫性は、無知方向が解釈可能性作業のための堅牢な信号であることを示唆しています。しかし、ここでの「堅牢性」は一貫した特定を意味し、不変の解釈ではありません。幾何学的方向は異なるモデルで不確実性処理の異なる側面をエンコードするかもしれず、または下流の動作への関係はアーキテクチャによって異なるかもしれません。堅牢性を厳密に確立するには、(1)ランダムシード全体で無知方向特定の分散を定量化すること、(2)アラインメントスコアがモデルファミリー全体でキャリブレーション指標を一貫して予測するかテストすること、および(3)アーキテクチャ固有の不確実性処理を示すかもしれない体系的な逸脱を特定することが必要です。
-
未解決の問題:* スケール不変性が出現するメカニズムは未だ十分に指定されていません。これはトランスフォーマーアーキテクチャの基本的な特性、次トークン予測目的、または自然言語自体の特性を反映しているのでしょうか。これらを区別するには制御された実験が必要です。代替目的(例えば、マスク言語モデリング)、代替アーキテクチャ、または代替データ分布でモデルを訓練し、無知方向が持続するかどうかを測定することです。そのような実験なしに、スケール不変性は説明された現象ではなく経験的観察のままです。
コンテキストエンジニアリングとデータレイヤ設計
理論的基礎
大規模言語モデルは、より具体的な予測を支持するのに十分な文脈情報が提供されない場合、訓練コーパス統計に依存する文書化された傾向を示しています(Petroni et al., 2019; Jiang et al., 2021)。この現象は幾何学的に形式化できます。モデルの出力分布が、われわれが「無知方向」と呼ぶもの(操作的には、最小限またはノンインフォーマティブな文脈が与えられた場合にモデルが生成する分布として定義される)と密接に一致する場合、このアラインメントは文脈駆動推論ではなく統計的フォールバックを示しています。この幾何学的フレームワークはシステム設計者に定量化可能な信号を提供します。無知方向からの測定可能な逸脱は、成功した文脈統合を示しています。
情報システムのアーキテクチャ上の含意
この幾何学的構造を認識することは、データレイヤアーキテクチャにおける明示的な設計選択を必要とします。核となる原則は単純です。システム設計者は、文脈が不十分な条件下でモデルが訓練統計にデフォルトすることを想定し、したがってそのような条件を防ぐために情報提供をエンジニアリングする必要があります。
- 具体的な設計上の考慮事項には以下が含まれます:*
-
コンテキスト十分性の監視: 検索パイプラインに幾何学的アラインメント測定を組み込みます。アプリケーション要件に基づいて無知方向からの許容可能な逸脱の閾値を定義します。予測されたアラインメントがこの閾値を超える場合(統計的フォールバックを示す)、生成前に強化された検索またはコンテキスト再構成をトリガーします。
-
チャンクサイズと検索戦略: 検索されたコンテキストチャンクサイズ、意味的一貫性、および無知方向からの幾何学的距離の関係は、不完全にしか特性化されていません。しかし原則は明確です。チャンクは、モデルが統計的デフォルトに直交する出力を生成できるように十分な信号密度を提供するようにサイズ設定および選択される必要があります。これはドメインおよびクエリタイプごとに経験的検証を要します。
-
コンテキストウィンドウの利用: すべてのコンテキストウィンドウ容量が同等ではありません。生成ポイントへの近接性、意味的関連性、および情報密度はすべて、検索された情報が無知方向からの幾何学的逸脱を生成するかどうかに影響します。システムは高信号コンテキスト配置を優先し、増加したコンテキストウィンドウ割り当てが対応する幾何学的効果を生成するかどうかを監視する必要があります。
-
クエリタイプ分類: 特定のクエリタイプは、文脈品質に関係なく、本質的に先行駆動応答を生成するかもしれません。システムは、履歴出力の幾何学的分析を通じてそのような場合を先制的に特定でき、生成前に標的化された介入を可能にします(例えば、検索拡張、人間レビュー、または棄却へのルーティング)。
実装フレームワーク
実用的な実装には3つのコンポーネントが必要です。
-
測定:* 与えられたモデルとタスクに対して「無知方向」を操作化します。これには、最小限の文脈でモデルにプロンプトを与えることによってベースライン分布を確立することが必要です(例えば、「Answer: 」またはタスク固有のヌルプロンプト)。このベースラインを埋め込み空間の参照ベクトルとして保存します。
-
監視:* 各生成について、実際の出力分布とベースライン無知方向の間のコサイン距離またはその他の幾何学的測定を計算します。この距離を検索メタデータとクエリ特性とともにログします。
-
適応:* アプリケーションのリスク許容度に基づいて、許容可能な幾何学的距離の閾値を定義します。実際の距離が閾値を下回る場合、事前定義された介入をトリガーします。強化された検索、コンテキスト再構成、または不確実性フラグ付きの棄却です。
このアプローチは固定ヒューリスティックを応答的で信号駆動の適応に置き換えます。すべてのクエリが同一のコンテキスト提供を要すると想定するのではなく、システムは文脈推論が発生しているかどうかの幾何学的証拠に基づいて情報戦略を調整します。
先行を緩和する:モデルが統計的デフォルトをオーバーライドする場合
先行緩和の定義
逆の現象(モデルが統計的デフォルトを成功裏にオーバーライドする場合)は、文脈推論のより直接的な証拠を提供します。強い文脈信号がモデル予測を無知方向から遠く押し出し、ベースライン統計に直交する出力分布を生成する場合、モデルは効果的に自身のベイズ先行を「緩和」しています。この緩和は、われわれが操作的に定義するもの、すなわち文脈理解を表しています。モデルが訓練データから導出された一般的な期待を特定の証拠でオーバーライドする能力です。
このフレームワークは、二値的な成功/失敗指標を超えた微妙な能力評価を可能にします。「出力は正しいか」だけを問うのではなく、「出力は真の文脈推論を反映しているか、それとも統計的デフォルトに幾何学的に近いままでいながら正解と偶然一致しているか」と問います。これらは異なる信頼性含意を持つ根本的に異なる能力を表しています。
文脈信号強度の測定
無知方向からの幾何学的距離は文脈信号強度を定量化します。2つのシナリオを考えてください。
-
シナリオA(強い信号):* プロンプト:「量子力学では、シュレーディンガー方程式は量子システムの時間発展を記述しています。この方程式を開発した物理学者は誰ですか」
-
シナリオB(弱い信号):* プロンプト:「方程式は___です。この方程式を開発した物理学者は誰ですか」
シナリオAでは、文脈情報(領域指定、機能説明)はモデルの出力分布をベースライン統計から遠く押し出す複数の独立した信号を提供します。シナリオBでは、最小限の文脈はモデルを物理学者名に対する先行分布に近いままにします。
操作的には、実際の出力分布とベースライン無知方向の間の幾何学的距離を計算することでこれを測定します。より大きな距離は、先行をオーバーライドする強い文脈信号を示しています。この距離は単に正確性の代理ではなく、モデルの推論プロセスが文脈を組み込んだか統計にデフォルトしたかを直接測定しています。
評価と信頼性への含意
この観点は評価方法論を3つの方法で変換します。
-
キャリブレーション評価: 出力精度のみを測定するのではなく、モデルが先行対文脈への依存を適切にキャリブレーションするかどうかを評価します。統計的デフォルトに幾何学的に近いままでいながら正解を生成するモデルは、堅牢な推論ではなく幸運な一致を示しています。無知方向から大きな幾何学的距離を持ちながら正解を生成するモデルは、文脈駆動推論を示しています。
-
失敗モード特性化: モデルが不正確な出力を生成する場合、幾何学的分析は失敗メカニズムを明らかにします。無知方向に幾何学的に近い出力は、不十分な文脈または弱い信号統合による失敗です。無知方向から幾何学的に遠いが依然として不正確な出力は、文脈推論と基礎真実の間の不一致による失敗です。これはより懸念される失敗モード、体系的な推論エラーを示唆しています。
-
信頼性閾値設定: 高信頼性アプリケーションは幾何学的閾値設定を実装できます。出力が無知方向から最小幾何学的距離を維持することを要求し、統計的フォールバックへの依存が許容可能な閾値を超える場合に自動的に棄却します。これは推論確信の連続測定を実行可能な信頼性制御に変換します。
経験的検証要件
このフレームワークを実装するには、ドメイン全体で幾何学的距離と出力信頼性の間の経験的関係を確立することが必要です。具体的には:
- どの幾何学的距離閾値が異なるアプリケーションコンテキストで許容可能な信頼性に対応しているか
- この閾値はドメイン、クエリタイプ、およびモデルアーキテクチャによってどのように異なるか
- 幾何学的距離とモデル信頼度推定のキャリブレーションの関係は何か
これらの問題は本記事の範囲を超えた体系的な経験的作業を要しますが、操作的展開の必要な前提条件です。
将来の方向性:不確実性を考慮したアーキテクチャの設計
幾何学的不確実性符号化の経験的観察——すなわち、文脈が不十分な条件下でLLMが統計的事前分布に向かう方向性バイアスを示す現象——は、複数の具体的なアーキテクチャ研究方向を示唆しています。ただし、これらの方向性は、基礎となる幾何学的現象がモデルスケールとアーキテクチャ全体で再現可能であることを前提としています。
モデル設計における明示的な不確実性幾何学
現在の証拠は、不確実性が純粋なストキャスティックノイズではなく、学習可能な幾何学的性質として現れることを示唆しています(前提:これはトランスフォーマーベースのアーキテクチャ全体で成立する;非トランスフォーマーモデルでの検証が必要)。無知方向を事後的な分析成果物として扱うのではなく、将来のアーキテクチャは不確実性幾何学を設計の基本要素として組み込むことができます。以下のメカニズムが検討に値します。
-
幾何学的距離によるアテンション変調:アテンション重みを、経験的に決定された無知方向からのトークンレベルの距離に基づいて条件付けることができます。仮説は、低文脈状況での虚偽の確信を減らすというものです。これには以下が必要です:(1)埋め込み空間における「距離」の形式的定義(例:コサイン距離、ユークリッドノルム)、(2)変調関数の仕様、(3)そうした変調がキャリブレーション指標(ブリアスコア、期待キャリブレーション誤差)を改善し、タスク性能を低下させないかどうかの経験的測定。
-
事前分布と文脈の分離を目指す訓練目的:ベイズ事前分布に駆動される表現と文脈依存的予測の間に直交性または角度分離を明示的に促進する目的関数を設計できます。これは以下を前提とします:(1)学習された表現の中に、これら二つの予測モード間に測定可能な区別が存在する、(2)それらの分離を促進することが下流の不確実性定量化を改善する。検証には、事前分布駆動推論対文脈駆動推論を分離する制御実験が必要です。
キャリブレーション評価フレームワーク
不確実性を考慮したアーキテクチャの評価には、精度を超えた形式化されたキャリブレーション指標が必要です。提案される評価次元は以下の通りです。
-
入力タイプ全体にわたる事前分布依存性キャリブレーション:モデルの確信度が文脈の十分性とどの程度相関するかを測定します。操作化には以下が必要です:(1)文脈品質によって層別化された入力タイプの分類法(例:分布内対分布外、高情報密度対低情報密度)、(2)定量的な文脈十分性指標、(3)これらの層全体でのモデル確信度分布の比較。標準的な指標には、キャリブレーション曲線、信頼性図、期待キャリブレーション誤差(Guo et al., 2017)が含まれます。
-
高リスク領域における棄却メカニズム:医療診断や法的分析など高い信頼性が必要なアプリケーションでは、幾何学的分析が統計的事前分布への過度な依存を示す場合、生成を棄却するようにメカニズムを設計する必要があります。これには以下が必要です:(1)無知方向からの距離に基づいた棄却閾値の形式的定義、(2)偽陰性(回答の機会喪失)と偽陽性(確信を持った誤り)のバランスを取る費用関数の仕様、(3)棄却ポリシー下での精度再現率トレードオフの経験的測定。
本番システムの統合
展開されたシステムにおける幾何学的不確実性監視の運用化には以下が必要です。
-
幾何学的アライメント監視:出力が経験的に決定された無知方向とどの程度アライメントしているかの継続的測定。これは以下を前提とします:(1)モデルインスタンスと推論バッチ全体で無知方向を識別する安定的で再現可能な方法、(2)この測定の計算効率(レイテンシとメモリオーバーヘッド)、(3)アライメント指標についての合意(例:コサイン類似度、投影の大きさ)。
-
トリガーされた介入:幾何学的分析が高い事前分布依存性を示す場合、システムは定義された応答を実行する必要があります:強化された検索拡張、文脈の再構成、または人間レビューへのエスカレーション。有効性は以下に依存します:(1)偽陽性と偽陰性を最小化するためのトリガー閾値のキャリブレーション、(2)介入ポリシーとその期待される結果の仕様、(3)本番環境での介入成功率の測定。
-
エンジニアリングされたコンポーネントとしての不確実性:不確実性を不透明な創発的性質として扱うのではなく、システムは不確実性幾何学を一級の観測可能性として公開し、不確実性シグナルとシステム動作の間のフィードバックループを可能にする必要があります。これはロギング、監視、制御システムへのアーキテクチャ変更を必要とします。
未解決の研究課題
いくつかの基礎的な問題は未解決のままであり、経験的調査が必要です。
-
幾何学的性質の一般化:観察された無知方向はモデルファミリー、スケール、訓練手順全体で一般化されるでしょうか。現在の証拠は特定のモデルインスタンスに限定されており、アーキテクチャ推奨事項を一般化する前に、モデル間検証が必要です。
-
幾何学とキャリブレーション間の因果関係:無知方向からの幾何学的距離が確信度の不適切なキャリブレーションを因果的に決定するのか、それとも他の要因の相関物なのか。因果性の確立には介入実験(例:無知方向に沿った敵対的摂動)が必要です。
-
幾何学的監視のスケーラビリティ:スケール時の継続的な幾何学的アライメント監視の計算コストはいくらでしょうか。このコストはモデルサイズとともに線形にスケールするのか、リアルタイム推論システムにとって許容可能なのか。
-
他の不確実性定量化手法との相互作用:幾何学的不確実性シグナルは既存の不確実性定量化アプローチ(アンサンブル手法、ベイズ近似、温度スケーリング)とどのように相互作用するのか。補完的な情報を提供するのか、それとも冗長なシグナルなのか。
実装の前提条件
本番環境で不確実性を考慮したアーキテクチャを展開する前に、以下の前提条件を満たす必要があります。
- 独立したモデルインスタンスと訓練実行全体で無知方向を再現可能に識別できること
- 幾何学的距離がキャリブレーション誤差を統計的有意性をもって予測することの定量的検証
- 提案された介入(棄却、検索拡張)がシステム信頼性を改善し、許容できない性能低下を招かないことの実証
- すべての閾値、指標、決定ルールの形式的仕様、および感度分析
- 本番展開条件を代表する保留テストセットでの評価
不確実性を考慮したアーキテクチャのエンジニアリングは、依然として初期段階の研究方向です。具体的な進展には、事後的な幾何学的分析から将来志向のアーキテクチャ設計への移行が必要であり、基礎となる幾何学的現象と提案された介入の有効性の両方に関する厳密な経験的検証が伴う必要があります。
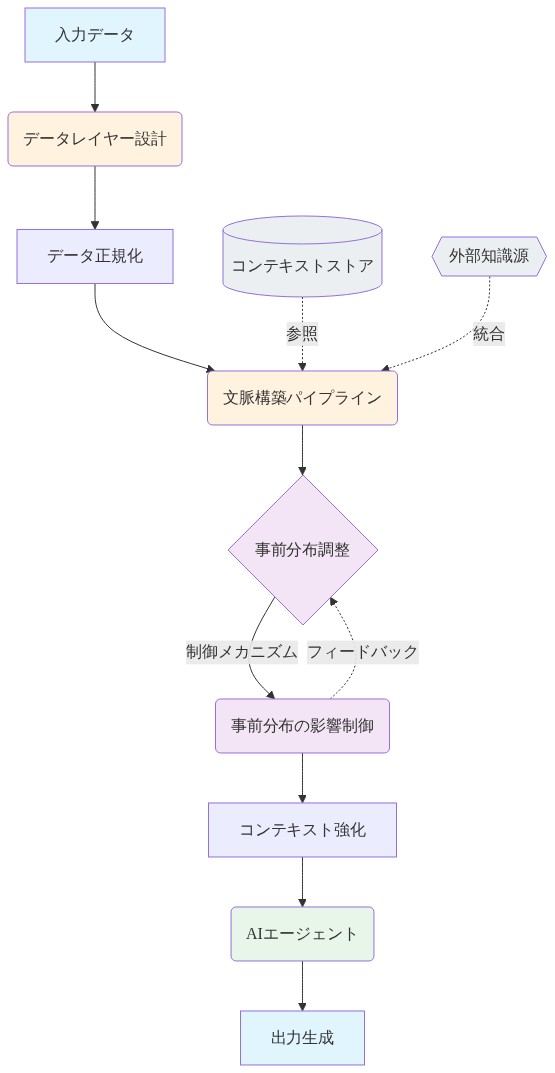
- 図11:コンテキストエンジニアリングとデータレイヤー設計アーキテクチャ*