AIエージェントに調べものを頼んだとしよう。エージェントは検索をかけ、ページを読み、数字を確かめ、もう一度検索する。その結果は、作業が終わるまでどこかに覚えておかなければならない。
覚えておく方法しだいで、エージェントにかかるお金も、考える力も変わってくる。これが、大規模言語モデル(LLM)を使ったエージェントの「作業用メモリ」の問題だ。
1つのエージェントにすべてを任せる方式では、結果が1本の長い記録に積み上がっていく。
複数のエージェントで分担する方式では、サブエージェントごとに独立した文脈(コンテキストウィンドウ)を持たせる。どちらにも代償がある。
Octopusは、第3の設計を提案している。1 1つのモデルを土台にした、マルチエージェント強化学習(RL)の枠組みだ。すべてのスレッドが、共通の土台(バックボーン)の上で動く。
スレッド同士は、GPU上に置いたKV状態の有向非巡回グラフ(DAG)でやり取りする。KV状態とは、モデルがすでに読んだ文章について内部に残している記録のことだ。モデルは、次の5つの操作でこのグラフを扱う。
forkread_threadwait_threadsrewindcommit
この設計の根にある問いは、並列の探索が1つの頭脳のように働けるのか、ということだ。もう一方の姿は、メモを回し合う委員会である。
この記事のポイント
- 著者らは、今のマルチエージェントの枠組みにある3つのむだを挙げている。共通部分のキャッシュが重複する。調べた内容は文章の要約で渡され、受け取る側が処理し直す。RLの訓練では、枝どうしの依存関係が平らにされるか、捨てられる。1
- Octopusでは、全スレッドが1つのバックボーンと1つのKV状態のグラフを共有する。共通部分を枝ごとにコピーしなくてよい。連携のしかたは、5つの操作を通じてポリシーが学ぶ。外部の指揮役が決まった台本を動かすわけではない。
- グラフを残すと、RLが本当の依存関係を使える。これは、どの手順が成果につながったかを見分ける助けになりうる。一方で、新しい負担や未解決の問いも増える。資源の取り合い、枝の刈り込み、複数の機器にまたがる運用、訓練のばらつき、巻き戻した枝の扱いなどだ。
エージェントに記憶を持たせる第3の道
Octopusは、エージェントの記憶について別の設計を示している。1つのモデルの上で複数のエージェントを動かす強化学習(RL)の枠組みで、すべてのスレッドが同じバックボーンを使う。
スレッドは、GPU上の作業用メモリを共有する。技術的には、このメモリにはキャッシュされたアテンションの状態、つまりKV状態が入っている。これを有向非巡回グラフ(DAG)の形に整理する。
どの作業からどの作業が生まれたかを示す地図のようなものだ。
モデルは、5つの操作でこの地図を動かす。
fork:作業の新しい枝を始める。read_thread:別の枝の作業を直接見る。wait_threads:ほかの枝が終わるまで待つ。rewind:前の時点に戻る。commit:結果を確定させる。
設計の背後にある問いは、単純だ。並列の探索は、1つの頭が同時に何通りも考えるように動けるのか。それとも、メモを回し合う委員会のようにしか動けないのか。
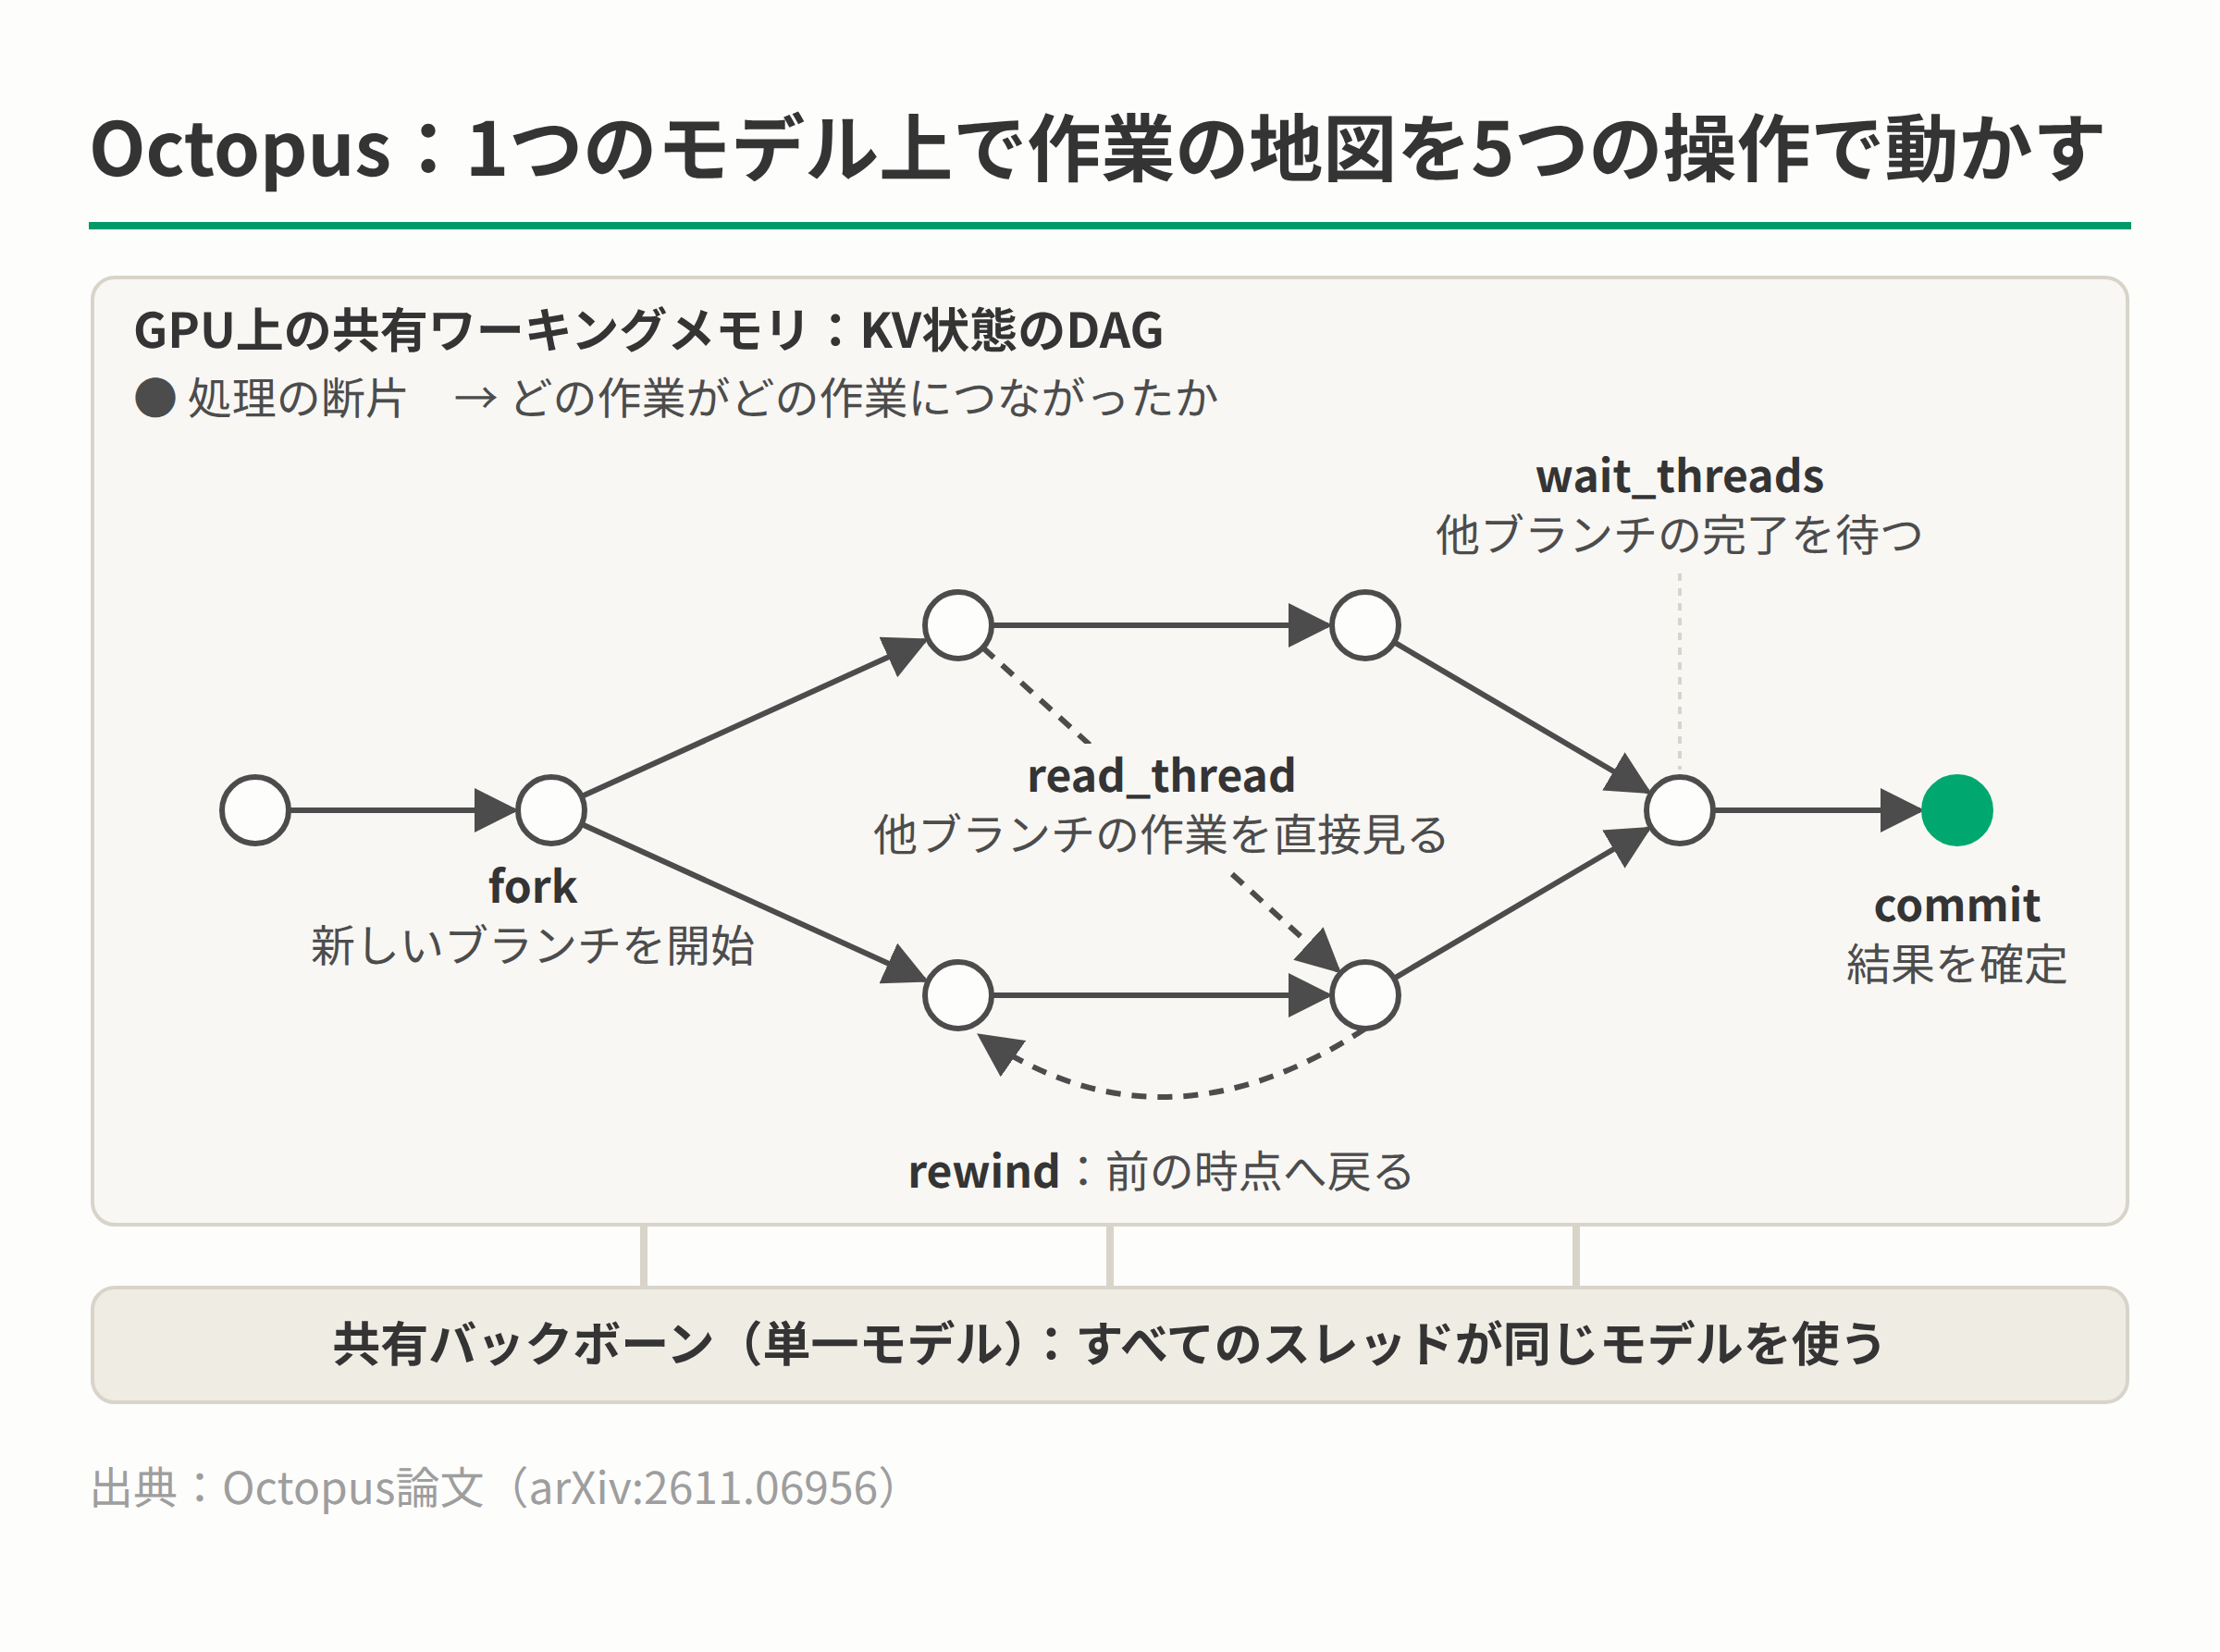
図1:共有バックボーン上のKV状態DAGと5つの操作(出典:Octopus論文(arXiv:2611.06956))
Octopusが直したいこと
著者らは、今のマルチエージェントの仕組みに3種類のむだがあると指摘している。
| 今の問題 | Octopusのやり方 |
|---|---|
| 各エージェントが、共通の出発点の文脈を自分用にキャッシュする | 枝どうしで1つのコピーを共有する |
| 調べた内容を文章の要約で渡し、受け取る側が処理し直す | 枝どうしが互いのメモリを直接読む |
| RLの訓練中に、枝どうしのつながりが平らにされるか捨てられる | 訓練でも依存関係の全体像を残す |
最後の点は、学習にとって大事だ。どの枝がどの枝に頼ったかを訓練で見られれば、正しい手順により正確に評価を割り振れるかもしれない。
同時に、未解決の問いも生まれる。1つはばらつき(分散)の問題だ。もう1つは、巻き戻した枝をどう扱うかである。
節約には代償もある。枝どうしが同じ資源を取り合う。古い枝は刈り込まなければならない。
複数の機器にまたがってシステムを動かすのも、難しくなる。
1本の記録か、複数の枝か:エージェントが場所に困る2つの道
基本的な悩みは、話のつながりを保つか、文脈をきれいに保つかの選びにある。よく知られた設計は、どちらか一方を得て、もう一方で代償を払う。
1本の長い記録に積み上げる方式は、すべてを1か所に置く。だから、各ステップが過去のすべてのステップを見られる。
問題は、長くなるほどアテンションのコストが増えることだ。気が散るおそれも増える。序盤の間違いも、最後まで目の前に残る。
独立したサブエージェントは、それぞれの文脈をきれいに保つ。並列に探索でき、各枝は自分の作業だけを見る。その代わり、枝どうしが互いの内容を安く見ることはできない。
第3の選択肢:1本のまま小さくする
1本のスレッドを保ち、進めながら圧縮する方式もある。たとえば、チャット履歴を節目ごとの状態に圧縮する手法は、入力トークンを91.9%減らしながら、推論の筋道は1本のまま保った。
2 細部が少し失われるのは、承知のうえの取引だ。
4つの方式を比べる
次の表は、4つの方式を並べたものだ。何を保ち、何を手放し、どんな場面に合うかを示している。
| 方式 | 保てるもの | 手放すもの | 向く場面 |
|---|---|---|---|
| 1本の長い記録 | 話のつながりすべて | きれいな文脈、アテンションの余裕 | 短くて、ほぼ一本道の作業 |
| 節目での圧縮 | 筋の通った1本の流れ | 圧縮で失う細部 | 区切りがはっきりした長い作業 |
| 独立したサブエージェント | 枝ごとの細部すべて | 枝どうしの安い共有 | 互いに独立した並列の小作業 |
| OctopusのKV共有グラフ | 基本は分離し、必要なときだけ参照 | 単純さ。実行時と学習の負担が増える | 枝どうしが依存し合う作業 |
どこでも勝てる設計は1つもない。向き不向きは、作業の各部分がどうつながっているかで決まる。
小作業が本当に独立しているなら、分離してもほとんど損はない。推論が一本道なら、圧縮に勝つのは難しい。
Octopusが狙うのは、その中間だ。いったん枝分かれして、あとでまた合流しなければならない作業である。
共有とコピー:マルチエージェントに隠れたコスト
多くのマルチエージェントの仕組みは、共通の文脈を枝ごとにコピーしている。そのコピーにはコストがかかる。
Octopusの概要は、ここから生じる3つの非効率を挙げている。1
2つは実行のしかたに、1つは訓練のしかたにある。やさしく言うと、次のとおりだ。
- 先頭部分のKVキャッシュの重複:親のエージェントがサブエージェントを呼び出すと、それぞれが同じシステムプロンプト、課題、過去の文脈を、通常はもう一度符号化する。枝が増えるほど、メモリの使用量とプレフィル(入力の先読み処理)の計算量が増える。
- 調べた内容が文章で渡される:サブエージェントが要約を書き、受け取る側がその文章をもう一度処理する。要約に残るのは、書き手が大事だと判断したことだけだ。KVの形ではすでに存在していたものを作り直すので、作業の重複も起きる。
- 訓練で依存関係が消える:強化学習(RL)では、枝分かれした実行が1本の列に平らにされるか、別々のエピソードに分けられる。どちらでも、どの枝があとの判断に影響したかという記録が失われる。
キャッシュは無料ではない
最初の2つの問題は、サービング用のインフラを運用している人にはなじみがあるだろう。
分散型サービングでのKVキャッシュの保持を調べた研究では、KV状態を保持する、追い出す、移すといった操作が、レイテンシーと帯域のコストを生むことが分かった。
KVキャッシュはほかの資源と同じように管理しなければならない。先頭部分をコピーする枠組みは、枝のたびにそのコピーの代金を払うことになる。
では、コピーしたあとで圧縮すればよいのではないか。それは可能だが、万能の解決策ではない。
混合エキスパートモデル向けの、ルーティングを考慮したKV圧縮の研究は、よい圧縮がモデルのアーキテクチャに左右されうることを示している。Octopusは別の道を取る。むだな状態を、最初から作らないのだ。
コピーにも意味がある場面
コピーには、1つだけ本物の利点がある。単純なことだ。独立したキャッシュなら、互いにほとんど調整しなくても、スケジュール、追い出し、別の機器への配置ができる。
次の表は、それぞれの方式がどんな条件に合いそうかを整理したものだ。上の説明から導いたもので、Octopusの論文での測定結果ではない。
| 条件 | 共有に有利 | コピーに有利 |
|---|---|---|
| 共通の先頭部分の長さ | 長い | 短い |
| 枝どうしが結果を交換する頻度 | 多い | 少ない |
| 枝の寿命 | 長く、互いに依存する | 短く、それだけで完結する |
| 配置 | 1台、または密に結んだ機器群 | 多くの機器に分散 |
近さと届く範囲:1つのバックボーンと1つの状態グラフ
Octopusは、すべてのスレッドを1つの共有バックボーンの上で動かす。概要によると、スレッドはGPUメモリ上にあるKV状態の有向非巡回グラフ(DAG)を通じて連携する。1
グラフを思い浮かべる
各ノードが、キャッシュされたアテンション状態のひとまとまりを持っていると考えてみよう。各エッジは、あるスレッドがどのスレッドから生まれたか、またはどのスレッドに頼ったかを記録する。
共有ノードから枝分かれした枝は、そのノードをコピーせず、指し示せばよい。すると共通の先頭部分は1回だけ保存され、何度も使い回される。
オペレーティングシステムのコピーオンライト方式のメモリと、よく似た働きだ。
ここで1つ注意がある。概要が説明しているのはDAGとその操作で、メモリ上の配置までは書いていない。
コピーオンライトとの比較は、この設計が何をめざすかを示すものだ。確認された実装の詳細ではない。
1つの構造が担う2つの役目
同じグラフが、2つの別々の仕事をしている。
- 実行時の構造:スレッドが読み出し、書き足す作業用メモリになる。
- 実行の記録:枝分かれ、合流、捨てた道筋など、推論が実際にどう進んだかが分かる。
2つ目の役目は、前の節で述べた訓練の問題に答えるものだ。グラフを残しておけば、訓練が始まるときに枝どうしのつながりが捨てられずに済む。
GPUに置くことで得るものと失うもの
グラフをGPU上に置くのが、この設計の肝だ。原理上、スレッドはほかの枝の状態に直接手が届く。文章として書き出し、受け渡し、もう一度符号化する必要はない。
そのかわり、近さと届く範囲の兼ね合いが生じる。次の表は、この設計から浮かぶ点で2つの方式を比べたものだ。
| 独立した文脈 | 共有グラフ | |
|---|---|---|
| 各スレッドが見られるもの | 自分の文脈 | 理屈の上ではほかのすべてのスレッド |
| 動かせる場所 | どこでも | グラフが置かれている場所 |
| 主な限界 | 作業の重複 | グラフを持つ機器のメモリ |
共有グラフがうまく働くのは、1台の機器か、密に結んだ機器群に収まっているあいだだ。そのメモリを超えると、すべてのスレッドを互いに手の届く範囲に置くのが難しくなる。その場合にOctopusがどうするかは、概要には書かれていない。
表現の自由度と学びやすさ:語彙としての5つの操作
Octopusは、モデルが自分の枝を連携させるための操作を5つ与える。一覧は短いが、多くの探索の戦略を表せる。ただし、モデルはそれぞれをいつ使う価値があるのか、学ばなければならなくなる。
各操作が何をして、何を可能にするのかを見てみよう。
| 操作 | 内容 | 可能になること |
|---|---|---|
fork | 親のKV状態を引き継いだ子スレッドを始める | 安く並列に仮説を試せる |
read_thread | あるスレッドが別のスレッドのキャッシュ状態を使う | 要約や再プレフィルなしで直接読める |
wait_threads | 選んだ枝が終わるまで待つ | 「まずこの手がかりを確かめる」といった依存関係 |
rewind | スレッドを前の状態に戻す | 行き止まりをきれいに捨てられる |
commit | ある状態を確定済みとして印をつける | 後続の作業の安定した足場 |
会話というより、プロセスの制御
まとめて眺めると、これはエージェントどうしのおしゃべりよりも、オペレーティングシステムがプログラムを扱う操作に近い。作業を始め、終わるのを待ち、チェックポイントを保存し、巻き戻す。
実用上の変化は、連携のしかたを誰が決めるかだ。 この設計では、構造化された一連の行動として、ポリシーが連携を学ぶ。外部の指揮役が決まった台本として書くわけではない。
少ない語彙で多くをこなす
おなじみの戦略のいくつかは、この5つの操作だけで組み立てられる。
- 木探索:
forkを繰り返し、残す価値のある枝にcommitをする。 - 投機的な検証:確認用に
forkし、先に進む前にwait_threadsをする。 - バックトラック:前の状態まで
rewindする。
モデルがこれから学ぶこと
自由度が増えれば、学ぶ負担も増える。決まった買い物リストではなく、会社のクレジットカードを渡された人を想像してほしい。できることは増えるが、使いすぎるかもしれない。
モデルは、資源の扱いについて、妥当な習慣を身につけなければならない。
- forkの使い方:枝を際限なく増やさない。
- 待ち方:永遠に終わらない枝を待ち続けない。
- 読み方:兄弟の枝の状態は、本当に役に立つときだけ使う。
- 巻き戻し方:計算を節約できる早さで切り上げつつ、使える手がかりは捨てない。
台本どおりに動く指揮役は、エンジニアがこうした決まりを書き込むので、決まりを持っている。学習したポリシーは、報酬を通じてしか決まりを見つけられない。
だから、報酬の設計は重い意味を持つ。むだな計算に罰がなければ、むだの多い習慣を学ぶのを止めるものがない。計算の予算が厳しいほど、この点は大きくなる。
忠実さとばらつき:推論が枝分かれするときの評価の割り振り
Octopusが取り組む問題のうち、最も気づきにくいのは訓練にある。推論の段階ではない。
枝分かれした実行が平らにされるか別々のエピソードに分けられると、どの枝がどの枝に依存したかという記録が失われる。その記録がなければ、ポリシーは、枝を作ったことも、待ったことも、捨てたことも、正しい判断だったのか分からない。
グラフの記録が大事な理由
Octopusは、各実行を有向グラフ(DAG)として記録する。操作を呼ぶたびにそれを記録し、そのあとに何が起きたかも残す。これで、訓練が追えるものができる。
原理上は、最終的な報酬を、実際の出来事の連なりにそってさかのぼれる。答えを生んだcommit、read_thread、wait_threadsを通る道筋だ。答えに寄与した枝と、探索したあとで巻き戻された枝を、区別できるだろう。
この区別があれば、ポリシーは連携のしかたを自分で学べるようになる。
- forkが成果につながるのはいつか。
- 兄弟の枝の状態を読むほうが、その作業をやり直すより良いのはいつか。
- 枝を切るのはいつか。
「原理上は」という言葉に注意してほしい。グラフがあれば、この種の評価のさかのぼりができるようになる。実際にどこまでうまくいくかは、概要に書かれていない選択に左右される。
1つのモデル、1組の習慣
Octopusは、すべてのスレッドに1つのモデルを使う。考えられる利点の1つは、作業の引き継ぎに関わる。
別々に訓練したエージェントは、報告や引き渡しのしかたが、それぞれ違う方向へずれていくかもしれない。共有のバックボーンなら、少なくとも全スレッドが同じ習慣から出発できる。
概要が残している問い
設計をめぐる問いがいくつか残っていて、概要では決着がついていない。
- 並列の枝への評価の分け方:3つの枝が1つの
commitに寄与したとき、報酬を3つの枝でどう分けるのか。 - 巻き戻した道筋の扱い:罰なのか、中立の探索なのか、何かを除外した役に立つ証拠なのか。どれを選ぶかで、ポリシーの探索の癖は違う方向に向かう。
- 訓練の信号のノイズ:グラフにもとづく評価は、実際に起きたことにより忠実だが、系列単位のRLよりノイズが多いかもしれない。エピソードごとにグラフの形が大きく変わると、そのおそれは大きくなる。
複雑さを増やす価値がありそうなとき
こうした未解決の問いは、はっきりした勝者よりも、兼ね合いがあることを示している。次は、概要で報告された結果ではなく、理屈から考えた見通しだ。
| 枝分かれのパターン | 向いていそうな方式 |
|---|---|
| 浅く、依存関係が少ない | 平らにした、系列単位の訓練 |
| 深く、互いに強く依存する | グラフを考慮した評価の割り振り |
枝分かれが浅ければ、平らにしても失う構造は少ない。単純な信号のほうが、訓練が安定するかもしれない。
枝どうしが強く依存し合うなら、平らにすると、ポリシーが必要とする情報そのものを捨てることになる。その場合は、増える複雑さに見合う成果が出やすいだろう。
ちょっと立ち止まって
AIエージェントの「賢さ」というと、モデルそのものの性能ばかりを思い浮かべていないだろうか。けれど、結果をどこにどう覚えておくかという、地味な設計のほうが、コストや推論の質を左右しているのかもしれない。
複数のAIが力を合わせる場面を想像するとき、あなたは「別々の担当者がメモを渡し合う姿」を当たり前だと思っていないだろうか。
1つの頭が枝分かれして考える形が成り立つなら、その当たり前は何を前提にしていたのだろう。
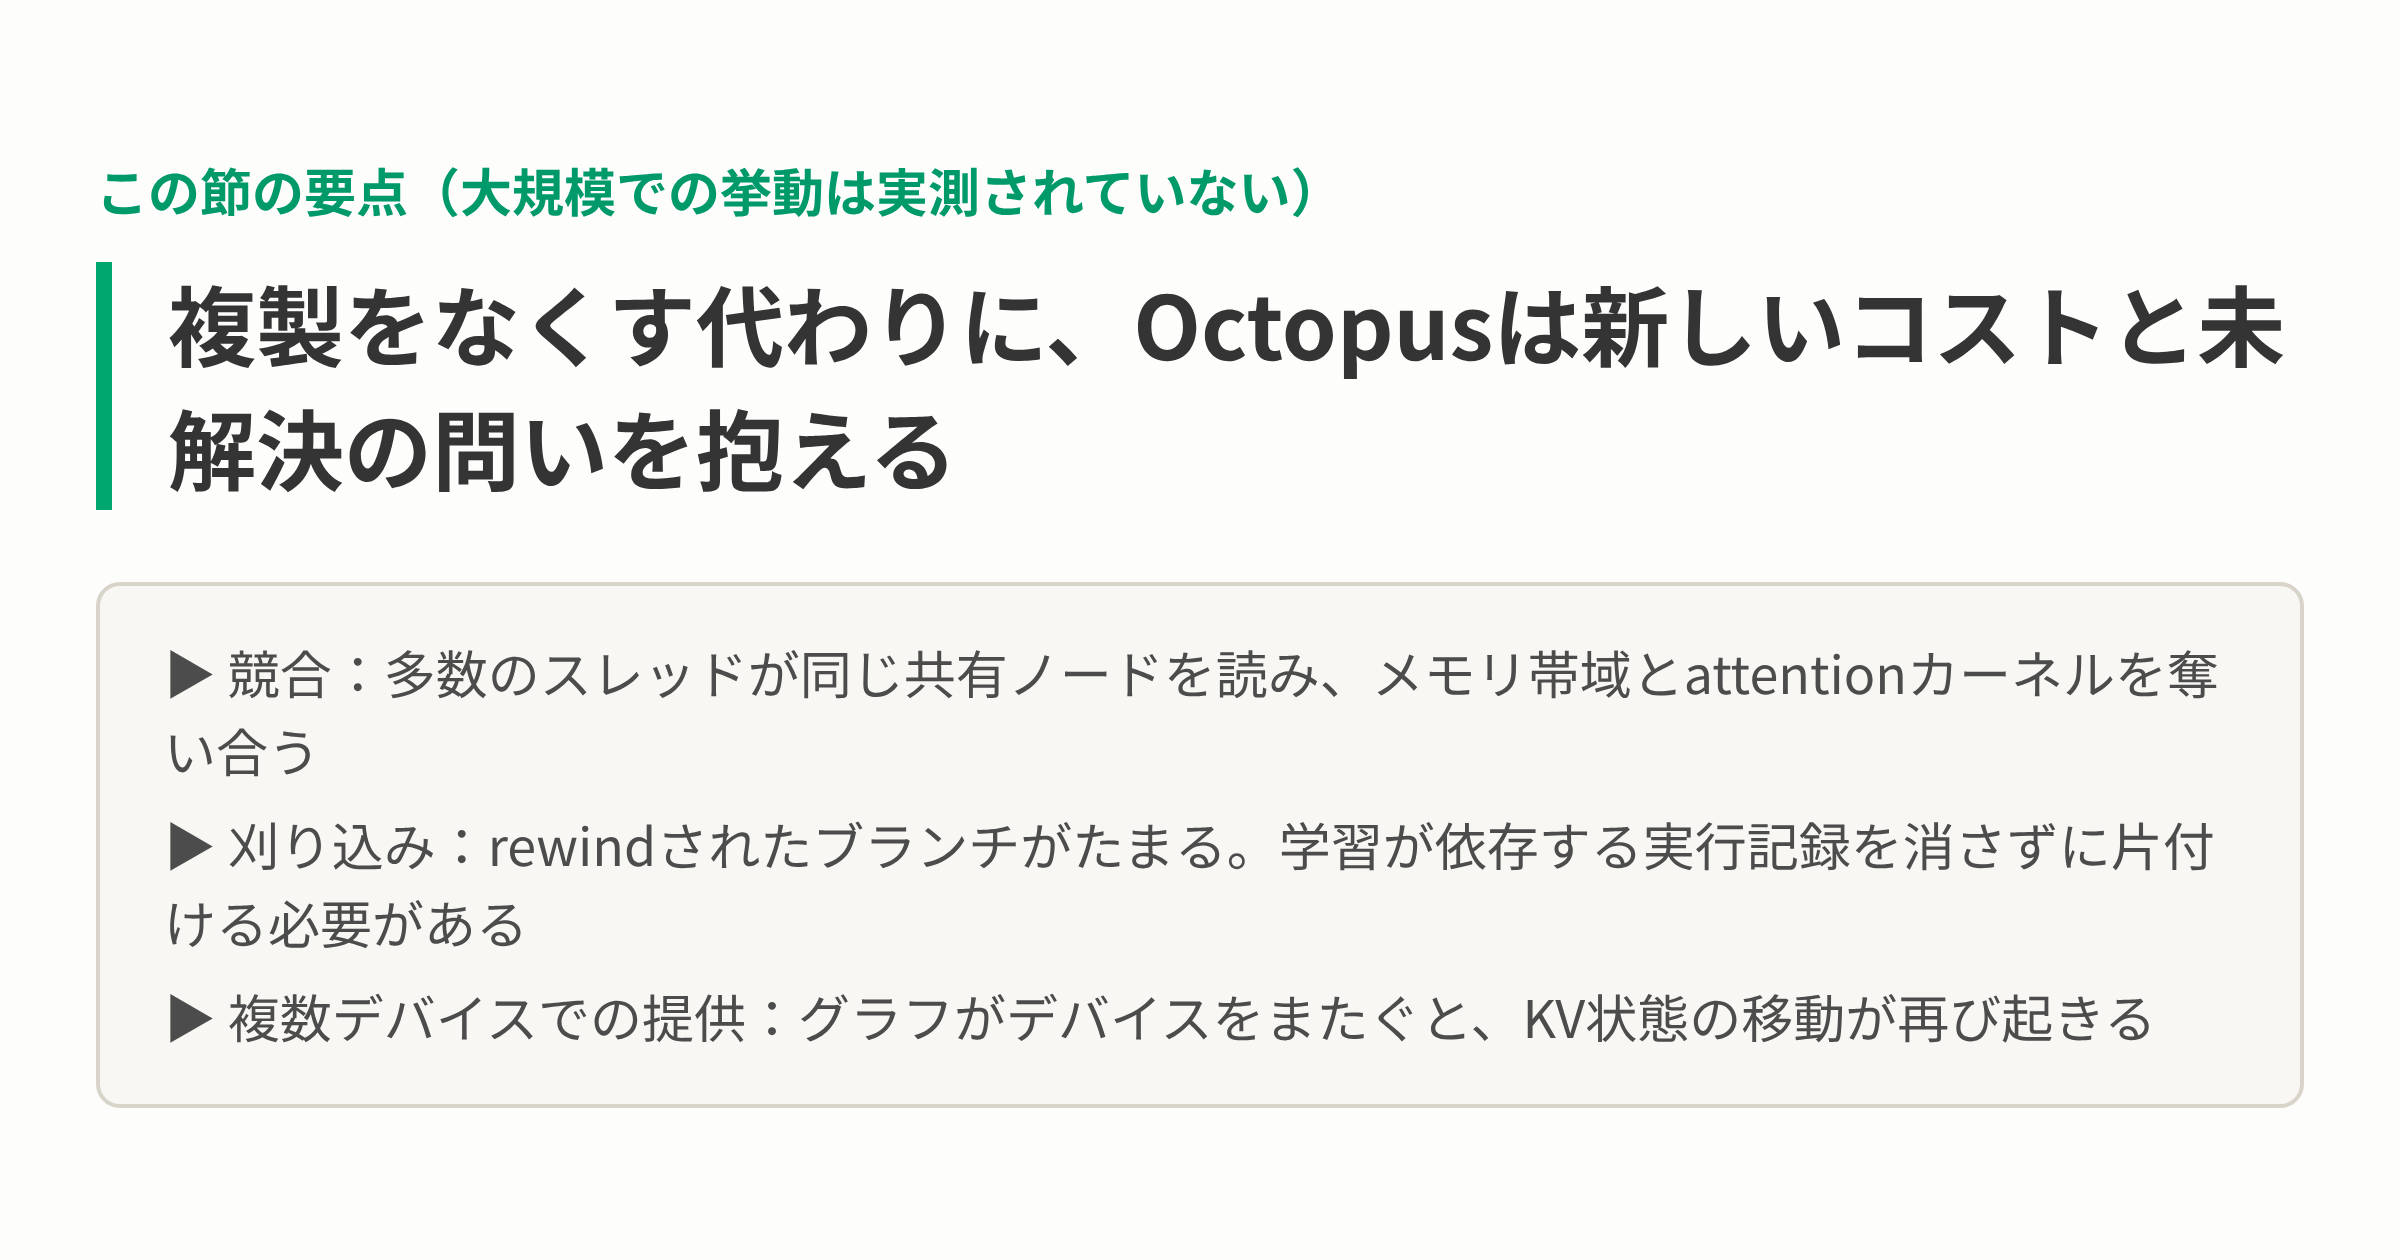
図7:Octopusの設計が試される論点
重複をやめると、取り合いが起きる:設計が試される場面
Octopusは、ひとつの問題を別の問題に置き換えている。ブランチは同じメモリをコピーしなくなるが、そのメモリへのアクセスを取り合うようになる。
共用のキッチンを思い浮かべてほしい。2台目の冷蔵庫を買う人はいないが、夕食の時間になると全員が同じ冷蔵庫に手を伸ばす。この取引が得かどうかは、キッチンがどれだけ混むかで決まる。
取引に無理が出そうな4つの場面
GPUが1台で、ブランチの数がそれほど多くなければ、この取引は妥当に見える。
規模が大きくなったときにどうなるかは、草稿の出典のどこにも示されていない。以下は未解決の問いであり、測定された結果ではない。
- スケジューリング:多くのスレッドが同じ共有ノードを読むと、同じメモリ帯域とアテンションカーネルを取り合う。
- 断片化:グラフとして保存したKVの区間は、平らなキャッシュならしないような形で、GPUメモリを細切れにするかもしれない。
- 剪定(枝の整理):巻き戻されたブランチは溜まっていく。学習が頼りにする実行の記録は消さずに、それらを片づける方法が要る。
- 複数デバイスでの提供:グラフが複数のデバイスにまたがると、ブランチをまたいで読むたびにKV状態をデバイス間で動かすことになる。共有状態が避けようとしていたコストが、また戻ってくる。
KVキャッシュの見方が変わる
大きな変化は、KVキャッシュを何のためのものと考えるかにある。Octopusは、KVキャッシュをひとつの推論過程が共有する作業用のメモリとして扱う。従来のシステムでは、リクエストごとのキャッシュだ。
この見方が成り立つなら、推論エンジンとAIエージェントのフレームワークは重なり始める。スケジューラーは、リクエストをさばくだけの存在ではなくなる。
エージェントがどう推論するかに関わるようになるだろう。これは設計に対する解釈であり、これまでの根拠は限られた条件のものだ。
エージェントを作るチームのための確認項目
以下の確認項目は、どれも上のトレードオフのひとつから導かれる。Octopusそのものがなくても使える。
- サブエージェント間のプレフィックスの重なり:サブエージェントが長いプレフィックスを共有しているなら、重複したKV状態が見えにくい大きなコストになっている可能性が高い。
- ブランチ同士が発見を交換する頻度:要約を何度もプリフィルし直しているなら、共有状態の設計に分がある。交換がまれなら、ブランチを分けたままにするほうが向いている。
- ブランチの依存関係の記録:どのブランチがどの判断に影響したかを、従来型のフレームワークでも記録しておく。そうすれば、グラフを意識した貢献度の割り当てを、あとからでもできる。
- 協調にかかるコストの信号:
forkとwaitを学習する方針で、forkしてもコストがかからないなら、forkを減らす理由がない。 - 複数デバイスでの早めのテスト:1台のGPUで測った節約は、KV状態をデバイス間で動かす必要が出ると、小さくなるかもしれない。
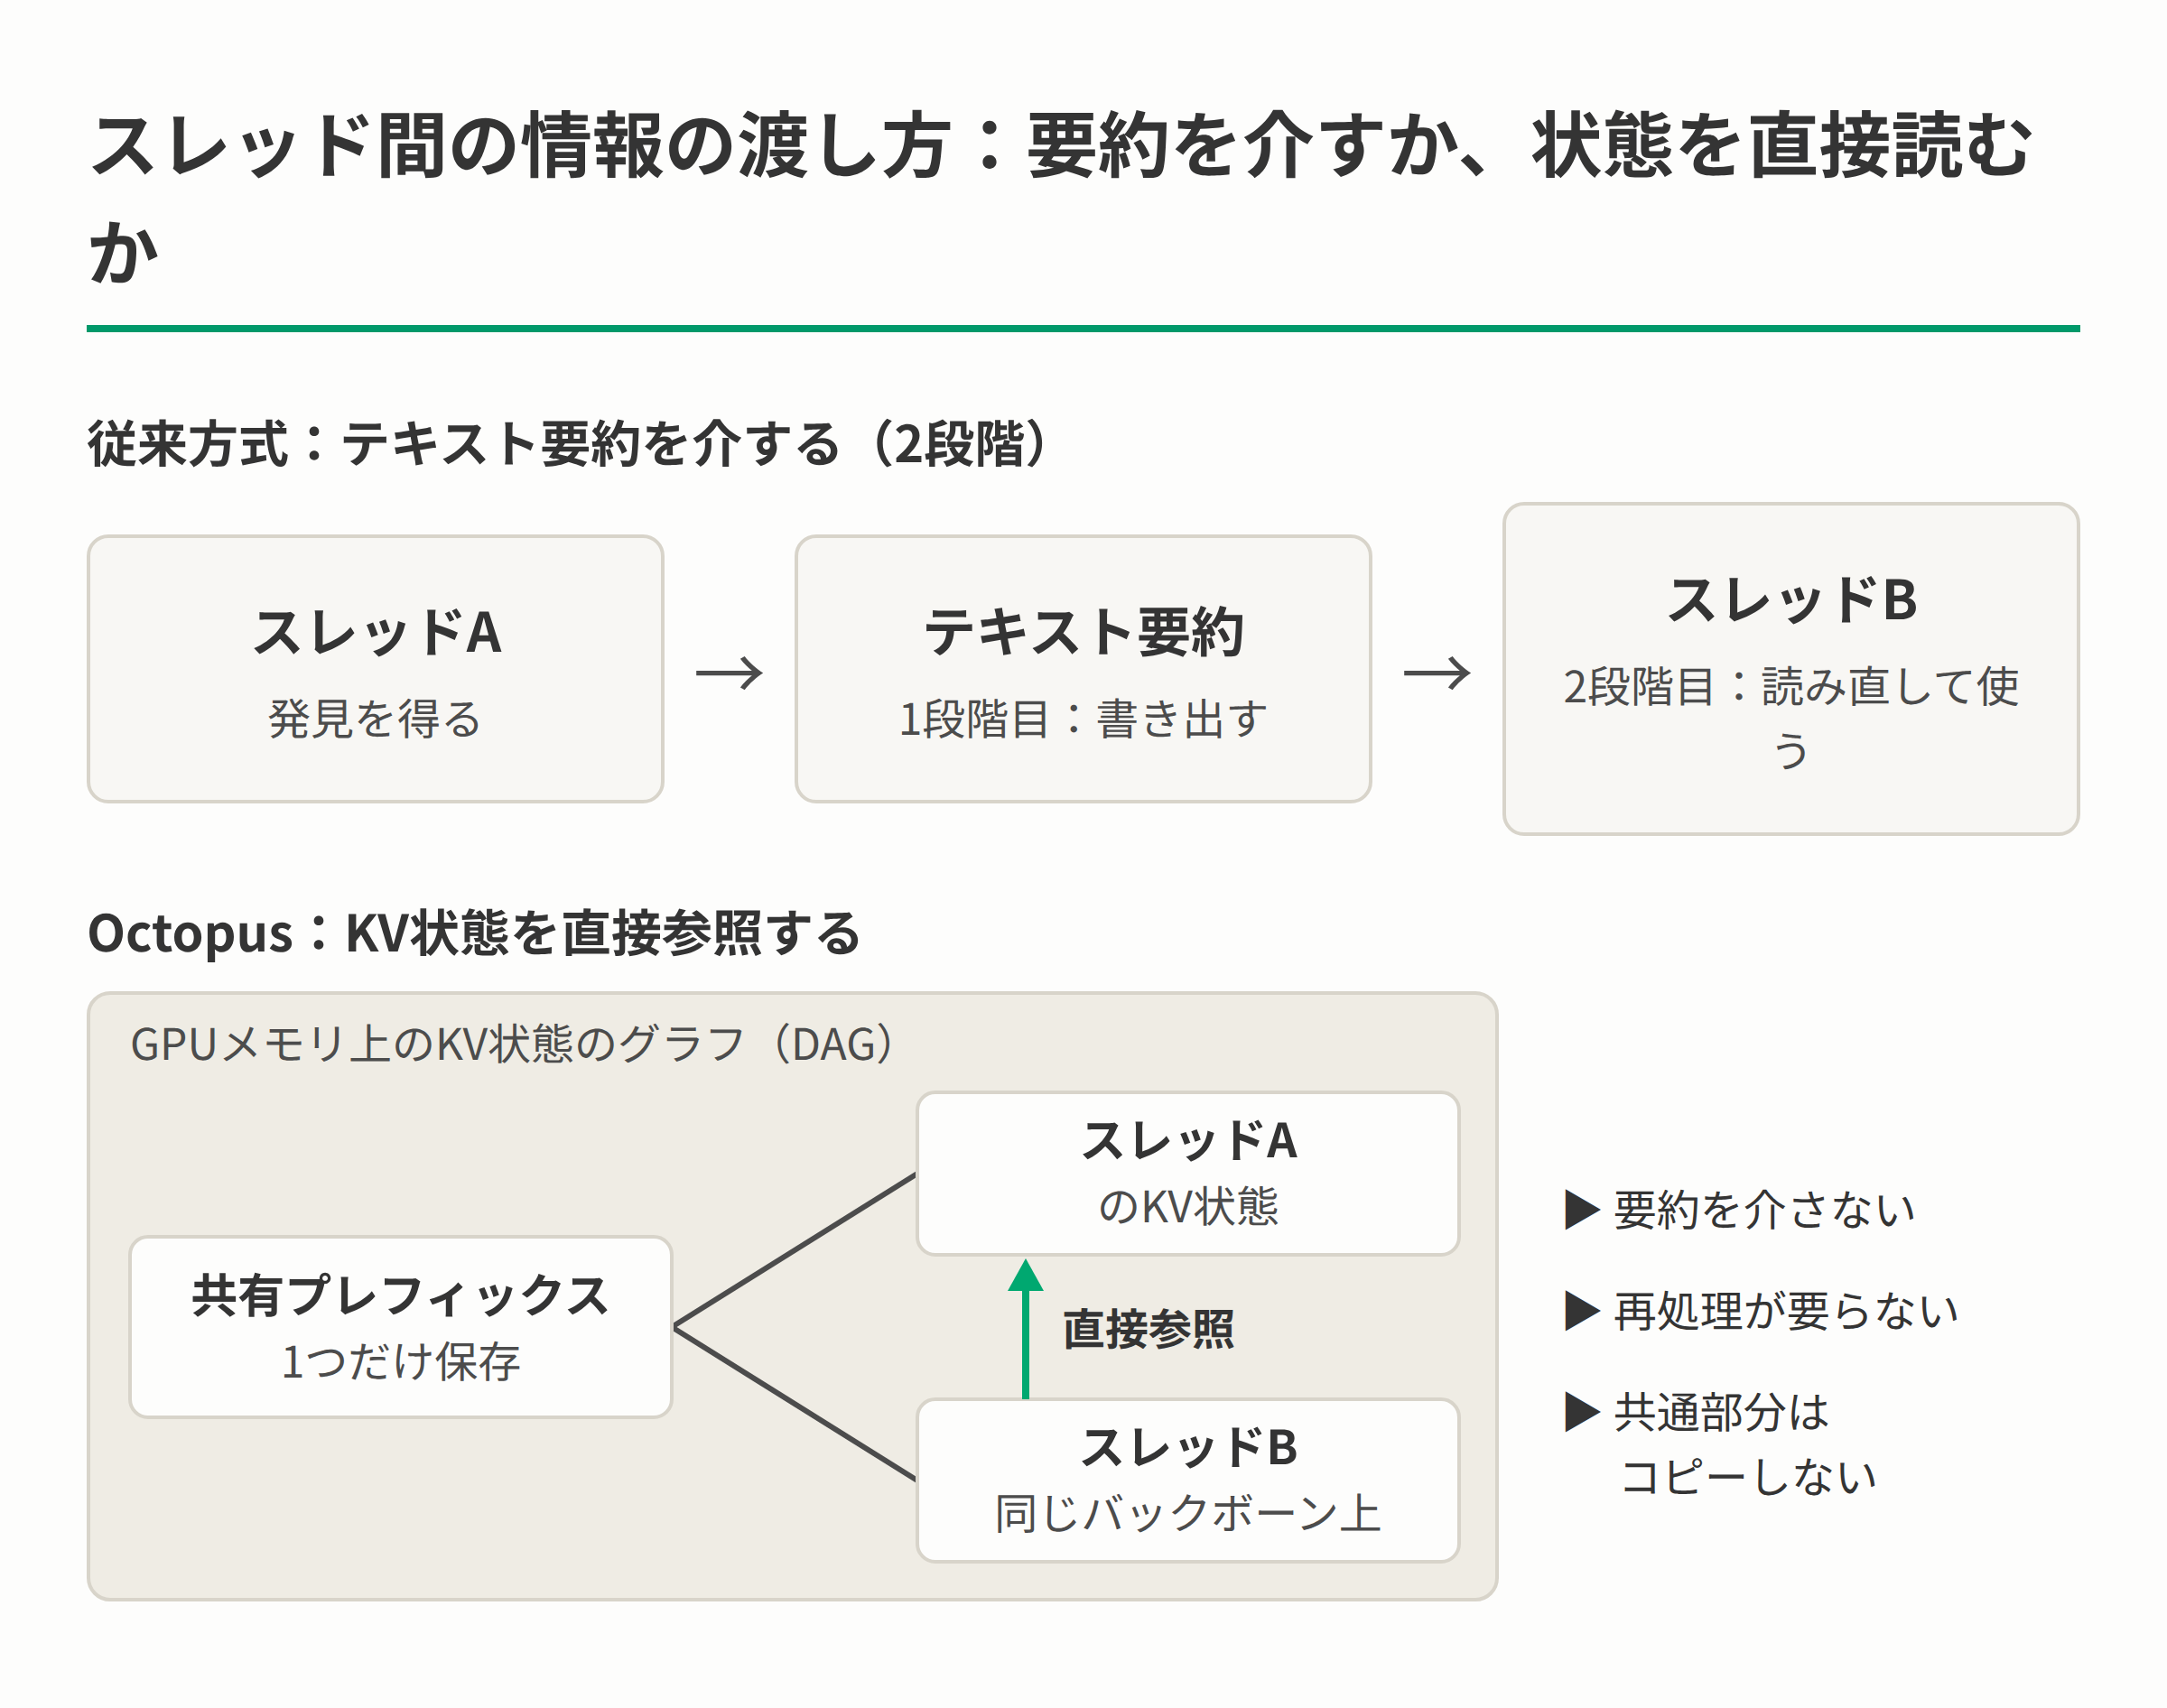
図4:テキスト要約を介する受け渡しとKV状態の直接参照
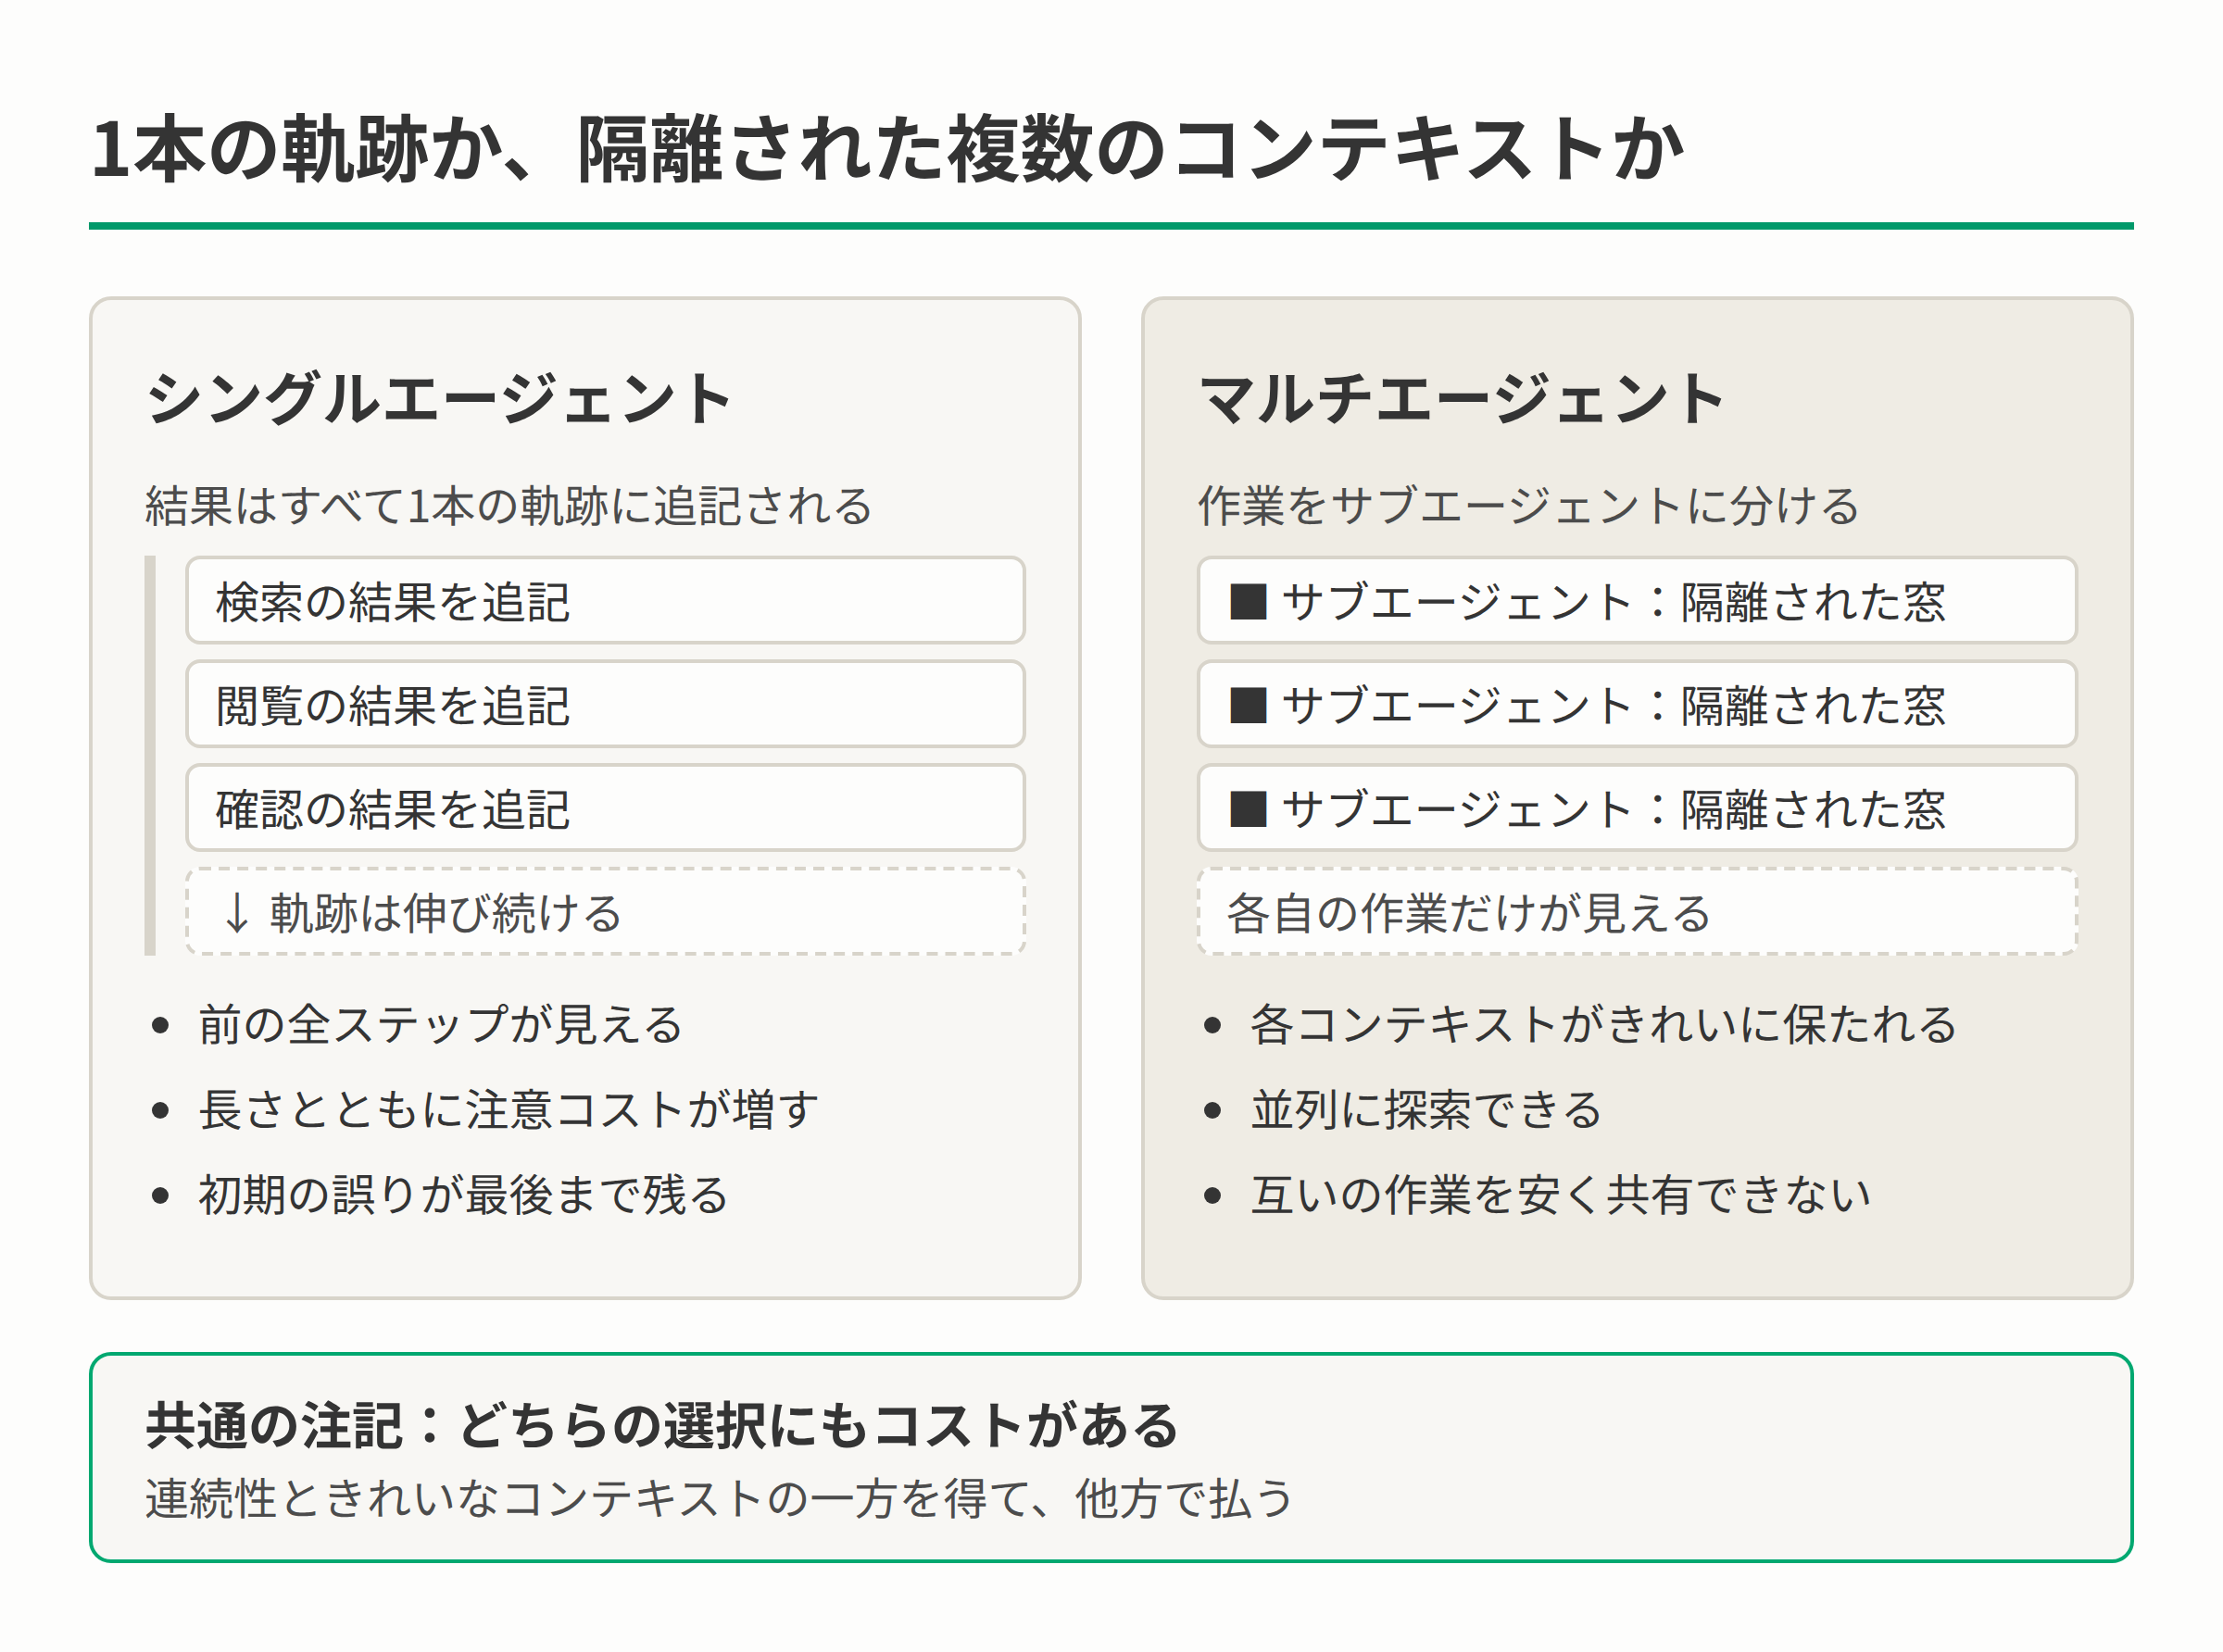
図2:1本の軌跡と隔離された複数コンテキストの違い
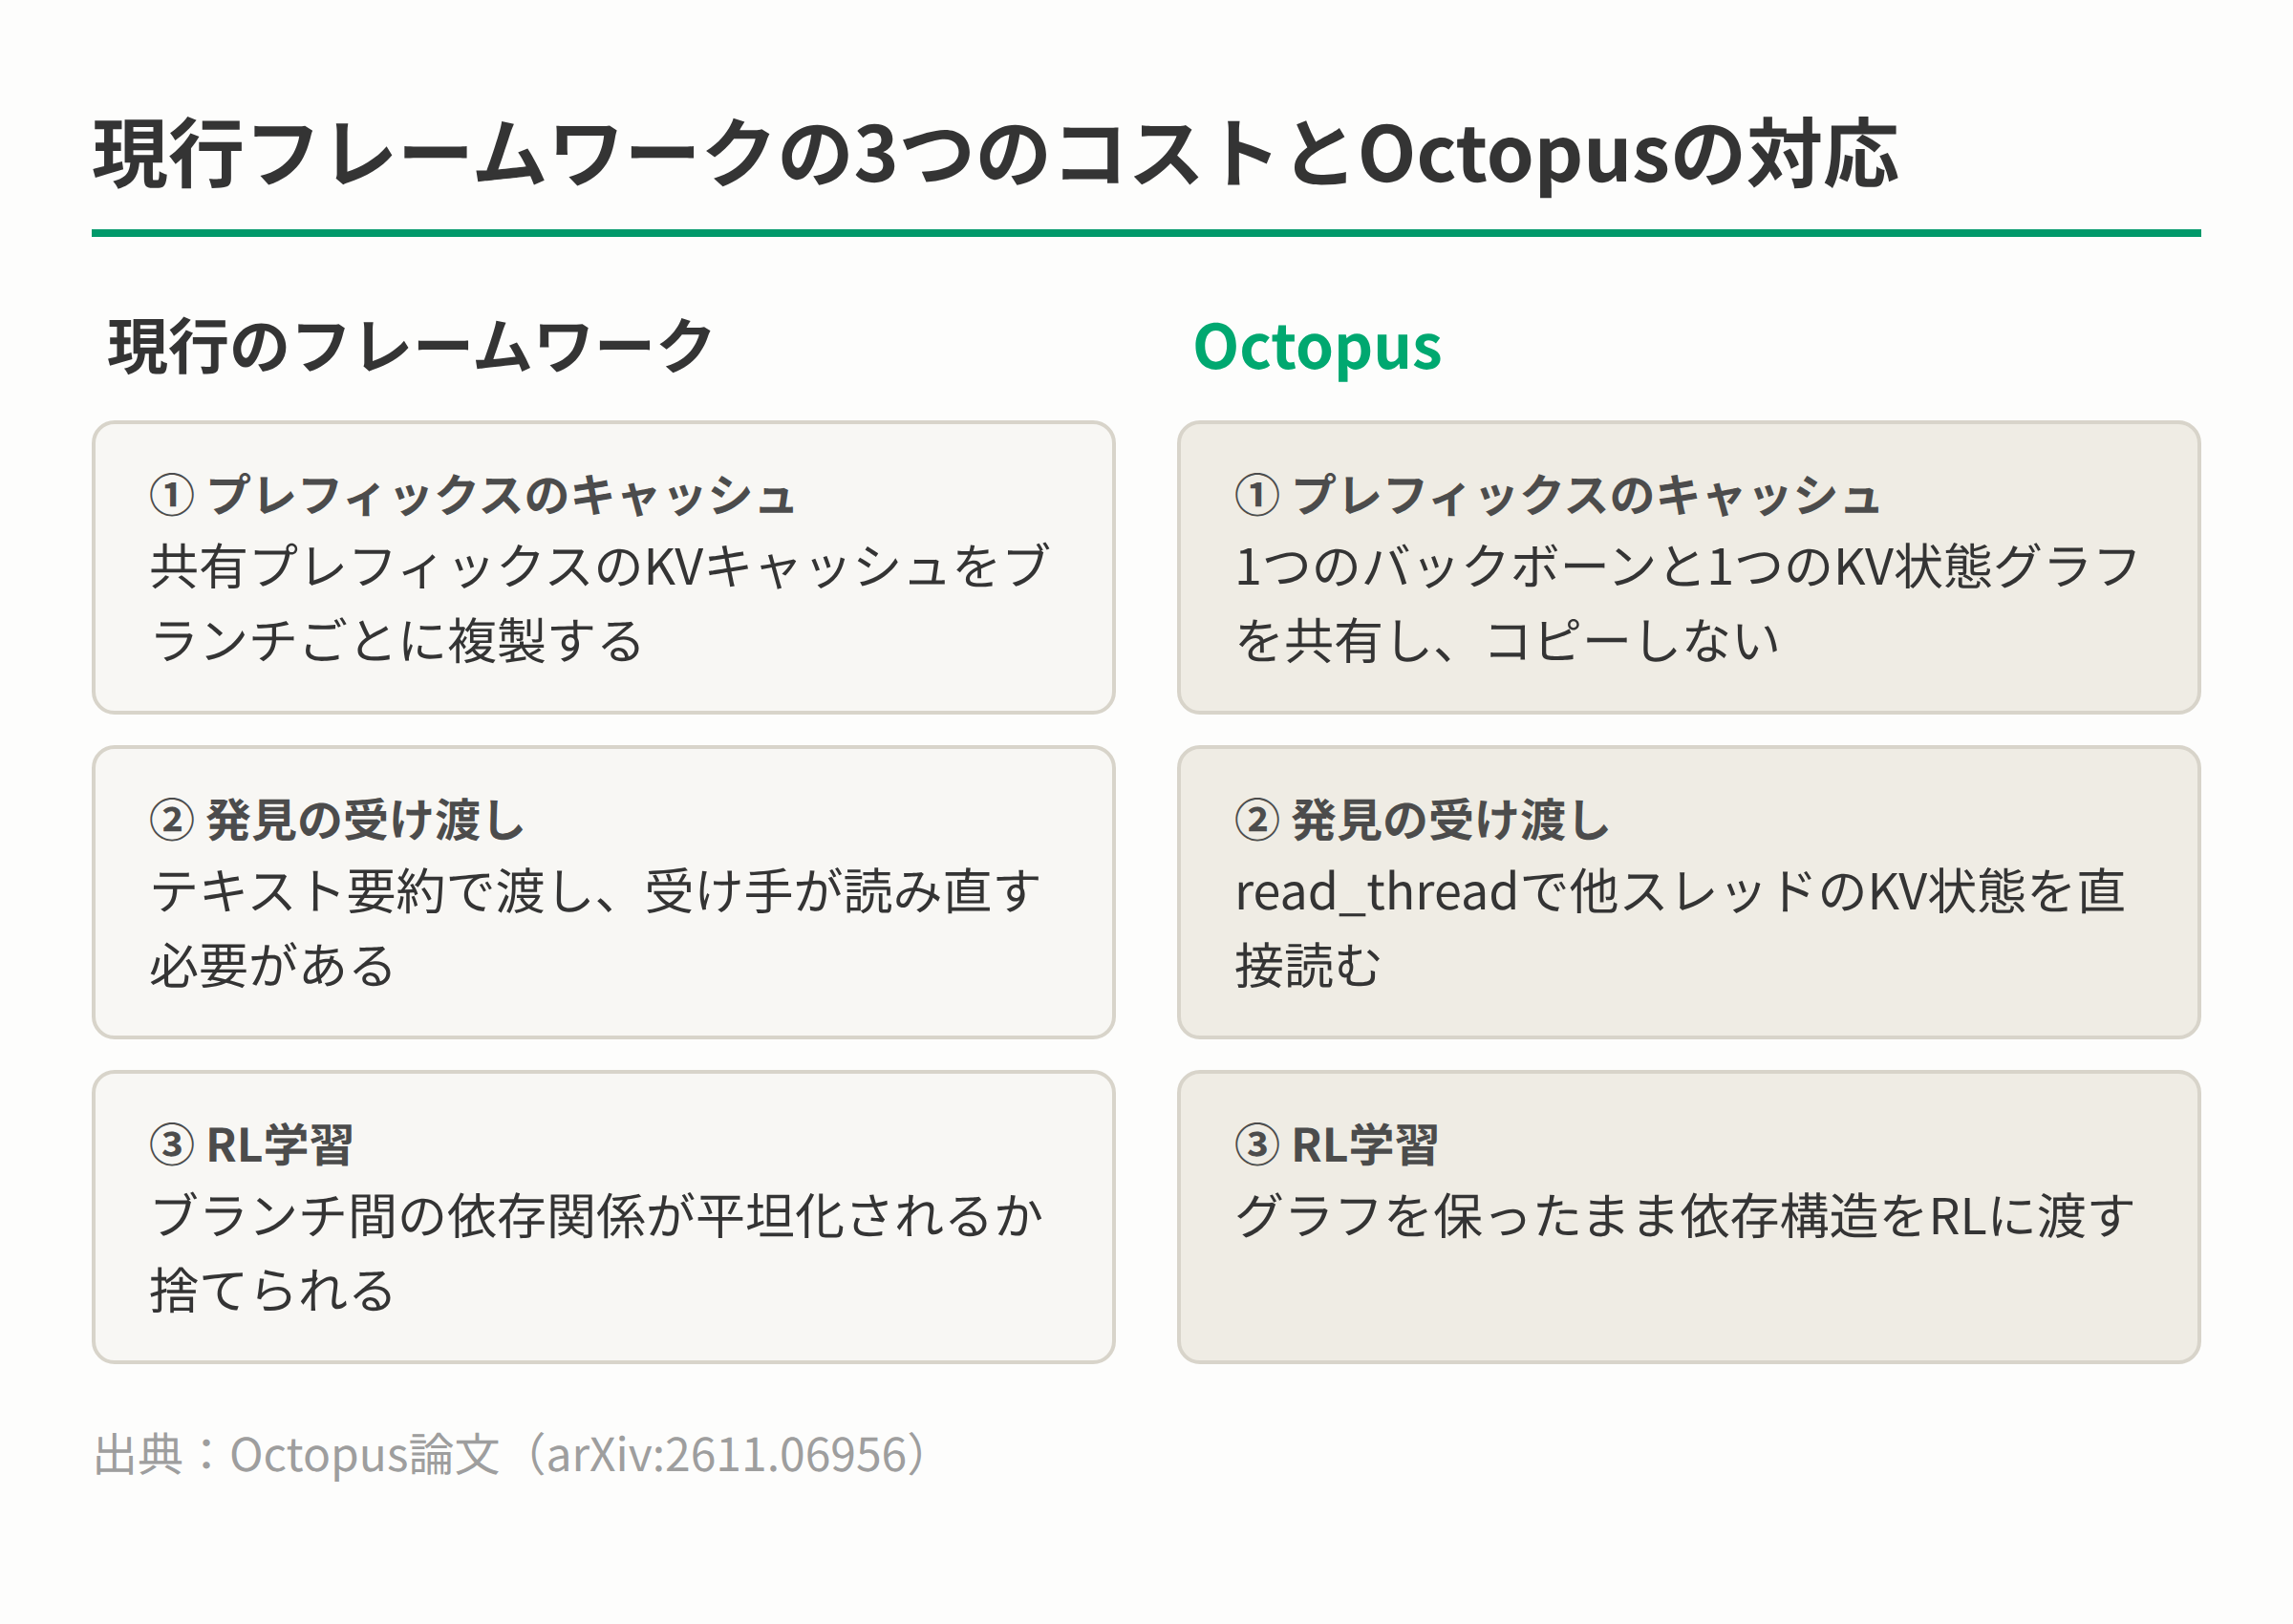
図3:現行フレームワークの3つのコストとOctopusの対応(出典:Octopus論文(arXiv:2611.06956))
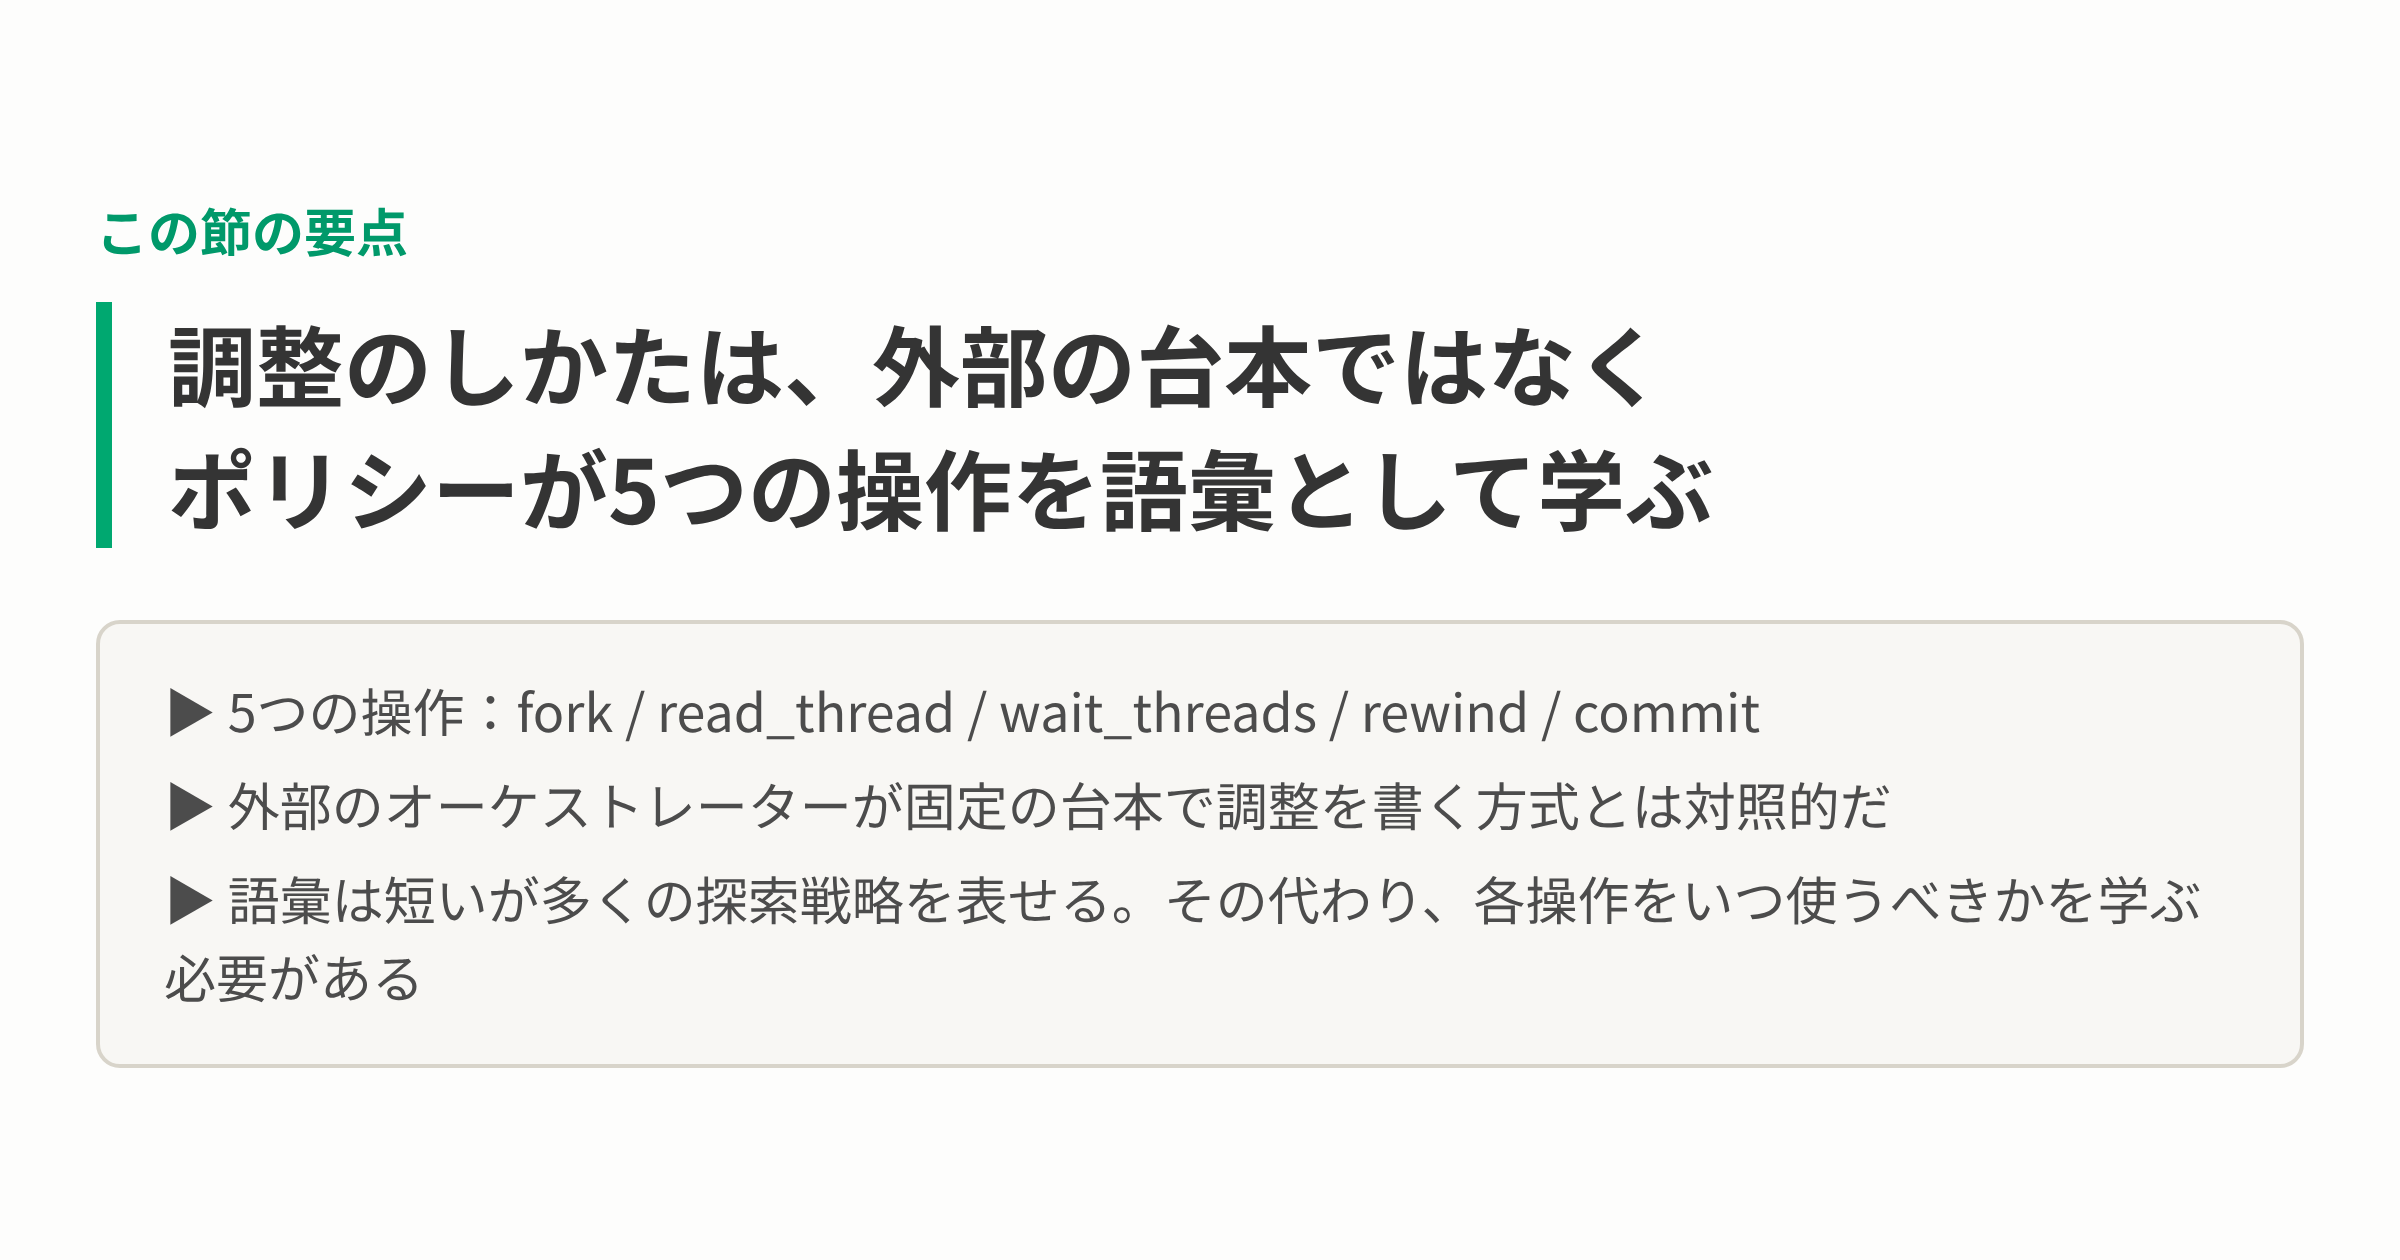
図5:5つの操作で調整を学ぶポリシー