長いレポートをチャットボットに貼りつけて、そのあとに5つ質問を重ねたとしよう。どの質問にも、同じ長い書き出しがついてくる。
システムがその書き出しを覚えているか、毎回やり直すか。それしだいで、答えが返ってくる速さも、あなたに応えるためのコストも変わってくる。
この「覚えておく仕組み」の裏には、いま多くの大規模なAIサービスが選んでいる設計がある。答えるまでの仕事を2つに分け、その間で記憶を受け渡すという設計だ。
この記事のポイント
- 2つの仕事を別のマシンで動かすと、作業メモを作る側と使う側の間にネットワークが入る。キャッシュを失うと、作り直すだけでなく、運び直す手間も生じる。
- 従来のキャッシュのルールは「失う損はどれも同じ」「保存はただ」と考える。データを運ぶ構成では、どちらも成り立たない。
- 学習で動く方針は、残したブロックがどれだけ節約になるかを見積もる。軽く動き、フィードバックが遅れたり届かなかったりしても働き、見積もりが外れても安全に動く必要がある。
2つのマシン群、1つのキャッシュ
分離型の構成では、プロンプトを読む仕事とトークンを書く仕事を、別のマシン群が受け持つ。その間でキャッシュを運ぶ必要が出てくる。
分離型(disaggregated)の構成では、あるマシン群がプレフィルを担当する。プレフィルはプロンプト全体を読み、キー・バリュー(KV)キャッシュを作る仕事だ。
KVキャッシュとは、モデルがそのプロンプトについて持つ作業メモのことである。
別のマシン群はデコードを担当する。デコードは答えを1トークンずつ書き、そのたびにこのキャッシュを読む。
こうすれば、それぞれのマシン群を、自分のボトルネックに合わせた大きさにできる。ただし、見落としやすい落とし穴がある。
分離型サービングでのKVキャッシュ保持の学習を扱った新しい論文は、この分離によって「KVキャッシュの計算と消費の間にネットワークファブリックが入る」と述べている。1
キャッシュのブロックには、置き場所ができる。動かすにはコストがかかる。どのブロックを残すかは、1台のマシンの片づけではなくなった。
多くのマシンが同じ記憶と同じネットワーク回線を使う。残すかどうかの判断のたびに、それらを奪い合うことになる。
この記事では、次の3つを見ていく。
- なぜ従来のルールが崩れるのか:よく使われるキャッシュの経験則は、分離型で成り立たなくなる前提に頼っている。
- 学習で動く方針は何を押さえるべきか:コストを考えに入れ、先が読めない中で動く必要がある。
- 運用する側は何が変わるのか:成功の測り方と、容量の計画が変わる。
2つの仕事、2つのマシン群
プロンプトに答えるには、性質の違う2種類の仕事がある。いまの構成では、これを別々のマシン群で動かす。
1つめの仕事はプレフィルだ。プロンプト全体を読み、KVキャッシュを作る。KVキャッシュは、モデルがその文章について取る作業メモにあたる。
2つめの仕事はデコードだ。答えを1トークンずつ書き、そのたびにメモを確かめる。
この2つは、ハードウェアへの負担のかかり方が違う。次の表で比べてみよう。
| 段階 | 何をするか | 主なボトルネック |
|---|---|---|
| プレフィル | プロンプト全体を読み、KVブロックを作る | 計算 |
| デコード | トークンを1つずつ書き、キャッシュを読む | メモリ帯域 |
なぜ分けるようになったのか
1台のマシンでは、2つの仕事が互いの邪魔をする。大きなプレフィルが1つ走ると、同じGPUで他の人の答えを書く作業が止まってしまうことがある。
別々のマシン群で動かせば、これは解決する。それぞれを自分のペースで増やせるからだ。運用する側は、計算に強いハードウェアと帯域に強いハードウェアを、仕事に合った比率で買える。
- プレフィル用のマシン群:長いプロンプトを素早くさばき、文章の生成を遅らせない。
- デコード用のマシン群:トークンを途切れなく、安定した間隔で出し続ける。
キャッシュが旅をするとき
分離には見落としやすい副作用がある。キャッシュのブロックに「届け先」ができ、運ぶのにコストがかかるようになる。
論文は、段階を分けると「KVキャッシュの計算と消費の間にネットワークファブリックが入る」と述べている。1
KVブロックは、プレフィルのマシンで書かれ、デコードのマシンで読まれる。そこへ行くには、ネットワークを渡らなければならない。
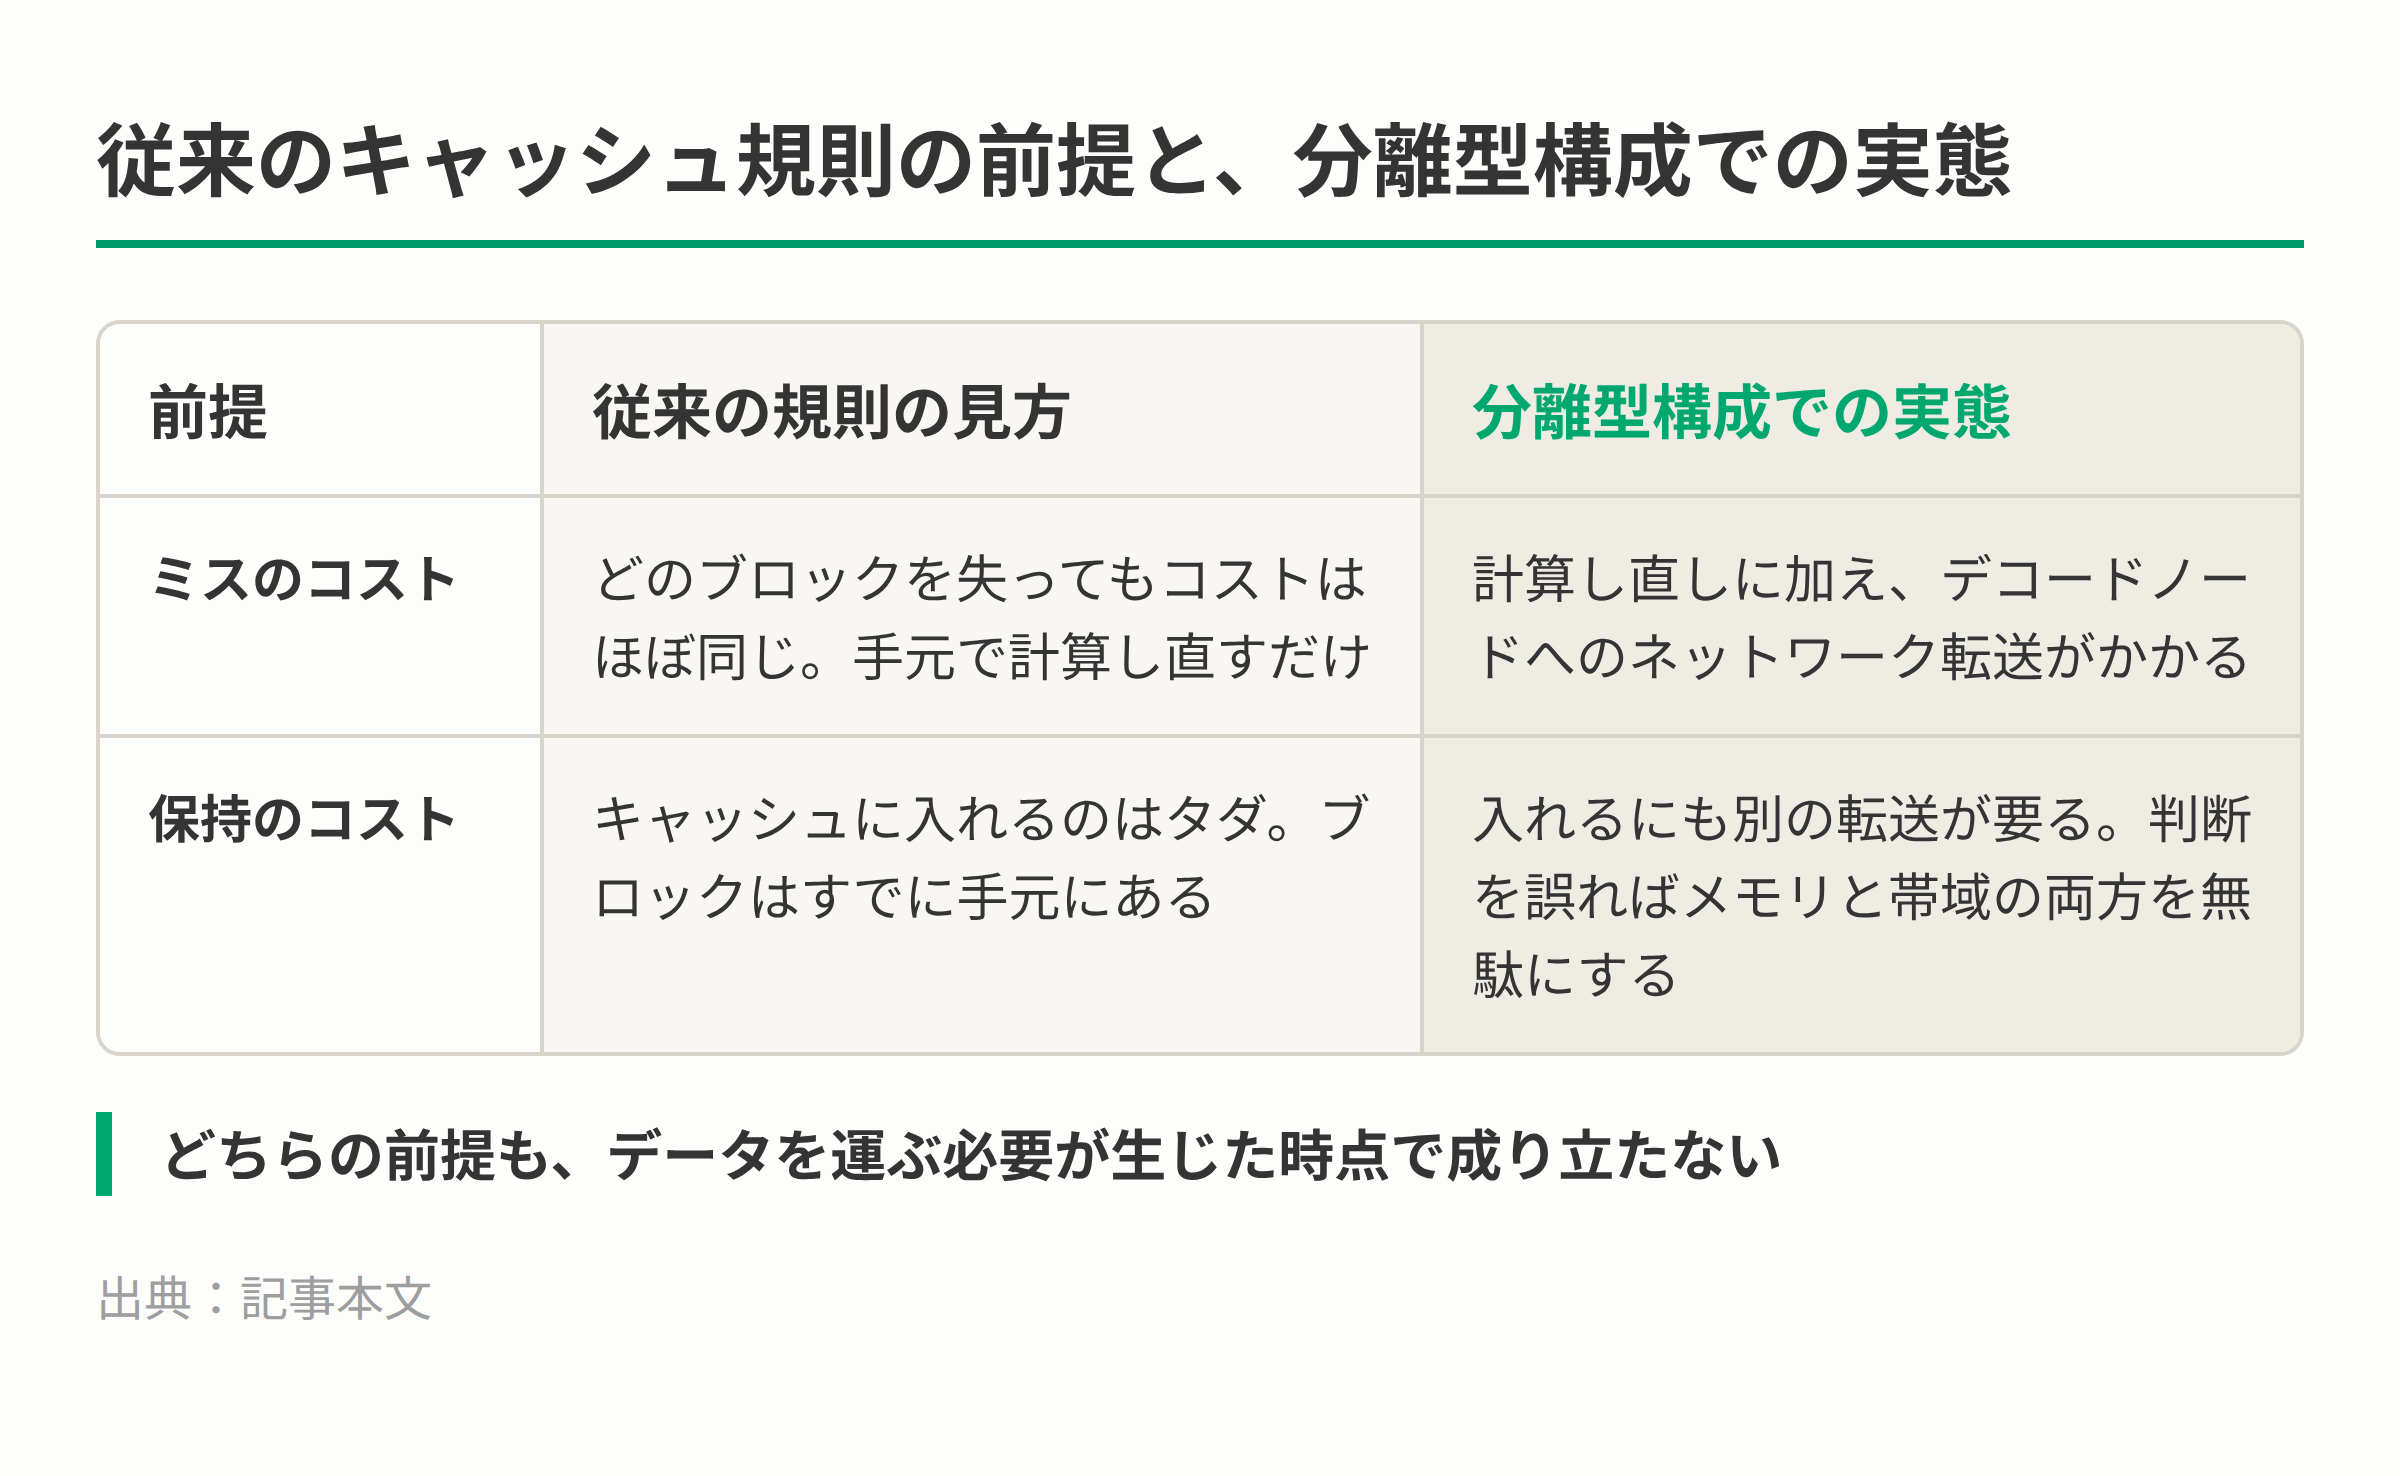
図3:従来のキャッシュ規則の前提と分離型構成での実態(出典:記事本文)
以前の作業を再利用する3つの道
では、新しいリクエストが以前のものと同じ書き出しで始まったら、どうなるのか。システムには選択肢が3つある。
- 手の届く場所にすでにあるブロックを見つけて使う。
- ブロックのある場所からコピーして持ってくる。
- プレフィルのマシンで作り直してから、コピーして持ってくる。
どの道も、共有の資源を使う。あるブロックを置いたメモリには、別のブロックを置けない。あるブロックを運ぶのに使った帯域は、後ろで待つ転送すべてを遅らせる。
片づけから、やりくりへ
ここが大きな変化だ。1台のサーバーなら、キャッシュは手元の片づけにすぎない。
再利用されそうなものを残し、残りは捨てる。間違えても、余分な計算が少し増えるだけだ。
分離したクラスターでは、残すか捨てるかを決めるたびに、メモリと帯域を使う。同じ瞬間に、ほかのリクエストもそれを欲しがっている。机の上を片づけるというより、みんなで使う家計をやりくりするのに近い。
従来の追い出しルールがコストを読み違える理由
従来のキャッシュのルールは、ブロックが最近使われたか、よく使われたかで残すものを決める。分離型では失ったときの損が変わるが、このルールにはそれが見えない。
最近使われたか、よく使われたか、あるいはその組み合わせか。そうしたルールがうまく働くのは、2つの前提が成り立つときだ。
- 失う損はどれも同じくらい:どのブロックを失っても、損はほぼ同じ大きさになる。
- 入れるのはただ:ブロックをキャッシュに入れるのに、追加のコストはかからない。
論文の要旨によれば、分離は「従来のキャッシュ方針の重要な前提を崩す。ミスはもはやローカルでの再計算だけで済まず、デコードノードへのネットワーク転送も必要になる」という。
さらに「ブロックをグローバルキャッシュに入れるには追加の転送が要るため、保持の判断が悪いとメモリと帯域の両方を無駄にする」とも述べている。
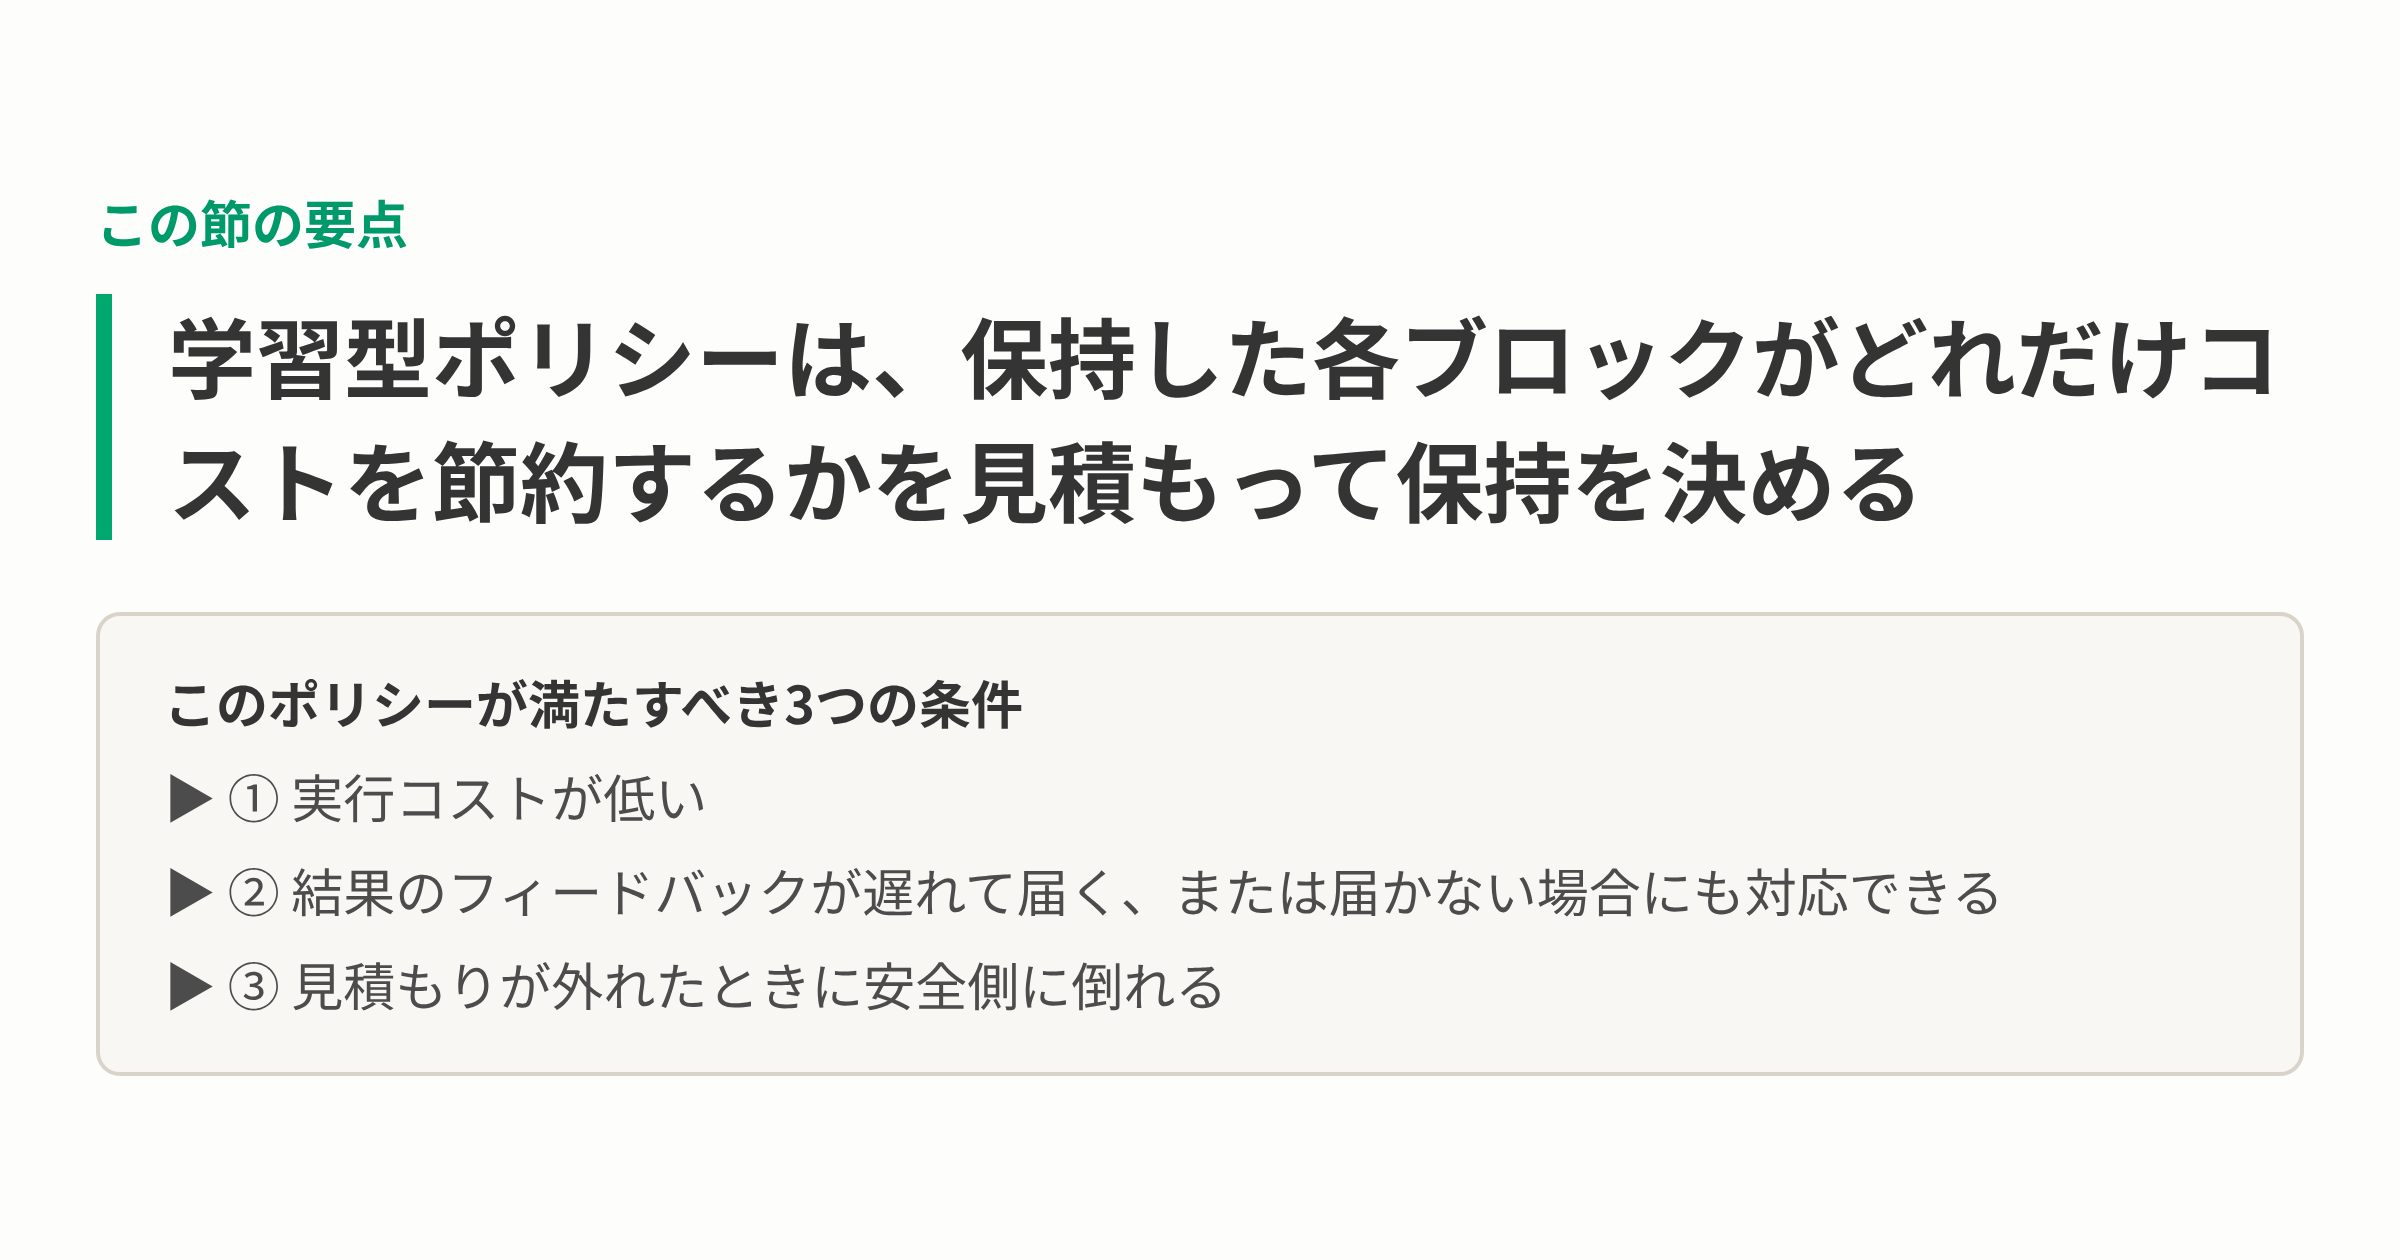
図4:学習型の保持ポリシーが満たすべき3つの条件
2つの前提はどう崩れるか
次の表は、2つの構成で各前提がどうなるかを比べたものだ。
| 前提 | 一体型のサービング | 分離型のサービング |
|---|---|---|
| 失う損はどれも同じくらい | おおむね成り立つ(手元で再計算) | 成り立たない(再計算に加え、ネットワーク転送) |
| 入れるのはただ | おおむね成り立つ(すでに手元にある) | 成り立たない(入れるのに別の転送が要る) |
| 足りないのはメモリだけ | ほぼそのとおり | メモリもネットワーク帯域も数える |
最初の2つの崩れは、要旨にそのまま書かれている。3行めはそこから導ける。ミスも、入れる操作も、ネットワークを使うなら、帯域はメモリと並ぶコストになる。
「最近使われたか」では見えない3つの違い
同じ瞬間に使われた2つのブロックでも、価値は大きく違うことがある。ところが「最近使われたか」の順位では、同じ扱いになる。 仮の例で考えてみよう。
1つめのブロックは、多くのリクエストが共有する長いシステムプロンプトのものだとする。2つめは、二度と戻ってこない1回きりのユーザーメッセージのものだ。
LRU(最も長く使われていないものから捨てる方式)は、どちらも同じくらい新しいので、同じ順位をつける。
けれども、本当の価値は大きく離れている。共有プロンプトを失えば、これから来る多くのリクエストのために、作り直して送り直すことになる。
1回きりのメッセージを失っても、損はない。誰も二度と求めないからだ。
「最近」は、見えない部分の1つめにすぎない。全部で3つある。
- 再利用:同じくらい新しいブロックでも、また必要になる可能性は大きく違う。
- 入れる操作:何でも入れるキャッシュは、人気のブロックがいつもあるので、ヒット率が悪くなさそうに見える。しかし、再利用の少ないブロックを入れるたびに転送が1回かかる。その転送は、デコードのノードが待っている転送と取り合いになる。だから、利用者が待つ時間全体は、かえって悪くなることがある。
- 負荷:トラフィックが軽いときは、ネットワークに余裕がある。不要な転送も安くすむ。急な集中が来ると、同じ転送が混み合ったネットワークで順番を争い、ユーザーの最初のトークンを遅らせることがある。
つまり、正しい保持の判断は、そのときのトラフィックしだいで変わる。最近さや頻度による固定の順位づけでは、これに合わせられない。
ソフトウェアの選択から、インフラのコストへ
キャッシュとコンテキストの扱いが、モデルの動く効率にすでに影響することは、ハーネスがエネルギーとトークン効率に影響する理由で論じられている。
分離型は、この話をインフラの層まで掘り下げる。
キャッシュを作るノードと使うノードの間にネットワークが入ると、保持の判断を誤るたびにメモリと帯域を失う。だから保持の方針は、遅延にも、トークン1つを届けるコストにも響いてくる。
保持を、学習で動くコスト意識の判断として捉える
ブロックの価値は、ワークロード、ブロック自体、システムの状態で決まる。固定のルールはこの3つをすべて無視するので、間違い方も予想がつく。
別のやり方は、候補のブロックごとに、残した場合にどれだけコストを節約できるかを見積もることだ。その節約分を、ブロックが占めるメモリと、必要になる転送と比べて考える。
論文のタイトルが指しているのは、この捉え方である。
先へ進む前に、1つ断っておく。以下で見るのは、この種の方針が何を扱わなければならないかという話だ。論文自身のモデルを説明しているわけではない。
再利用を予測できそうな手がかり
学習で動く方針には、将来の再利用について何かを教えてくれる入力が要る。実際のトラフィックで、次のようなものが候補になる。
- プレフィックスの共有:このブロックと同じ先頭のトークン列を、いまのリクエストや最近のリクエストがいくつ共有しているか。
- セッションの継続:複数ターンのチャットや、エージェントのループに属していて、すぐ次のリクエストが来そうか。
- プロンプト内の位置:システムプロンプトやツール定義のような前のほうのブロックは、後ろのユーザー固有のブロックより、共有される回数が多そうだ。
- テナントやアプリケーションの識別:製品によって、再利用のパターンは大きく違うことがある。
- いまのファブリックの負荷:ネットワークの混み具合で、これからのミスや、いまの転送がどれだけ高くつくかが決まる。
どれも、特別なものではない。LRUが使うような単純な「最近さ」のカウンターは、このうちのどれも見ていない。
入れる判断と追い出す判断は別物
保持は、実際には2つの判断でできている。起きる場面が違い、かかるコストも違う。
- 入れる判断(アドミッション):新しく計算したブロックを、そもそもグローバルキャッシュに入れるべきか。
- 追い出す判断(エビクション):空きがなくなったとき、すでに入っているどのブロックを出すか。
この区別は、ふつうのキャッシュよりも、ここでのほうが重い。追い出しは、後から場所を空けるだけだ。転送の支払いそのものを避けられるのは、入れる判断のときだけである。
家計にたとえてみよう。追い出しは、すでに払った定期購読を解約することにあたる。入れる判断は、そもそも契約しないことだ。
追い出しだけを学習する方針は、価値の低いブロックをキャッシュに運ぶ費用を払ったうえで、それを捨てることになる。
学習がやっかいな理由
これは、白黒のはっきりした答えがある、ふつうの予測の問題ではない。次の3つが邪魔をする。
- 遅れて届くフィードバック:ブロックを残す価値があったかどうかは、あとのリクエストが再利用したときにしか分からない。それは数秒後かもしれないし、数時間後かもしれない。
- 見えない結果:再利用が起きる前にブロックを追い出すと、システムはその再利用を見ることがない。方針の選択が、その選択がよかったかどうかの証拠を隠してしまう。
- ずれ(ドリフト):プロンプトも製品もユーザーの習慣も変わる。新しいシステムプロンプトや新しいエージェントの枠組み、製品の公開で、再利用のパターンは急に変わりうる。
2つめは、もう一度考えてみる価値がある。追い出しに積極的すぎる方針は、自分では正しく見える。取りこぼした再利用を、見ることがないからだ。
本番で動かせるかを分ける条件
学習で動く方針は、精度が高いだけでは、動かす価値があるとは言えない。実用上の性質がいくつかあり、同じくらい大切だ。次の表にまとめた。
| 条件 | なぜ大切か |
|---|---|
| 軽く動く | サービングの経路で、ブロックごとに採点するから |
| 安全な代わりの手段 | 自信がないときは、無難な既定のルールを使う |
| 誤差があっても安定 | 1回の外れが、ミスの連鎖を起こさないように |
| ずれに合わせられる | 学習し直さなくても、変化についていく |
1行めについて言えば、ブロックの採点が運ぶのと同じくらいかかるなら、得るものはない。
3行めについては、見積もりが外れるとミスや再計算、さらなる転送につながる。そうなると、方針が守ろうとしているネットワークの負荷をさらに増やしてしまう。
だから、役に立つ検証はもっと絞られる。「学習したほうが平均でLRUに勝つか」ではない。
コストを見ないルールが繰り返してしまう高くつく間違いを、確実に避けられるかを問うのだ。たとえば、共有のシステムプロンプトを追い出して、1回きりの末尾の部分に場所を譲ったとする。その直後に、そのプロンプトを必要とするリクエストが集中して来る。こうした間違いが一例だ。
本当に大事なものを測る
キャッシュの採点表といえばヒット率だ。しかし、ミスと入れる操作でコストが別々にかかるようになると、ヒット率は逆の方向を指すことがある。
通勤を、座れた回数だけで評価するようなものだ。遅い電車に乗るほうが、座れる回数は増えるかもしれない。
ヒット率が上がっても答えが遅くなる場合
ほとんどのブロックを入れてしまう方針を考えてみよう。人気のプレフィックスはほぼいつもあるので、ヒット率は上がる。
しかし、入れる操作はただではない。1回ごとに、マシン同士をつなぐネットワーク(ファブリック)を通して、データが動く。
リクエストが集中すると、入れるための転送が、デコードのノードがいますぐ必要とする転送と取り合いになる。
問題は、次のように積み上がっていく。
- リクエストが集中して届く。
- 積極的な方針は新しいブロックを入れつづけ、ファブリックの通信が増える。
- 実際に動いているリクエストの急ぎの転送が、その通信の後ろで待たされる。
- いちばん混んでいる時に届いたリクエストで、最初のトークンまでの時間が延びる。
ダッシュボードでは、キャッシュが良くなったのに、サービスは遅くなったという状態が同時に起こりうる。
逆の場合もある。選り好みする方針は、ヒット率が少し下がっても、ファブリックを空けておける。すると、利用者がいちばん気づきやすい、いちばん遅い応答(テールレイテンシ)を減らせる可能性がある。
これは仕組みの話であり、測った結果ではない。どれだけ効くかは、ファブリックがどのくらい混んでいるか、入れる通信がどのくらい重いかで決まる。
コストと体験を追える指標
次の指標は、どれもヒット率が取りこぼすものを拾う。何を追うのかを、表で比べてみよう。
| 指標 | 何を捉えるか | ヒット率が見逃すもの |
|---|---|---|
| 最初のトークンまでの時間(TTFT) | 応答が始まるまでの待ち | どのミスが利用者を待たせたか |
| テールレイテンシ(p95/p99) | 集中時のいちばん遅い応答 | 平均に隠れる、取り合いによる急な悪化 |
| 配信したトークン1つあたりの転送量 | 入れる操作を含むファブリックの通信 | 入れる転送にかかるコスト |
| キャッシュのメモリ効率 | 保持した1バイトあたりの再利用 | 価値の低いブロックが、よいブロックを押しのけること |
これらを合わせると、利用者が感じることと、システムを動かすコストの両方を追える。
配信したトークン1つあたりの転送量は、とくに役に立つ。保持の方針を、ファブリックの負荷に直接つなげてくれる。ファブリックの負荷は、インフラのコストの一部である。
本物らしいトラフィックで試す
保持の方針が役に立つのは、トラフィックに学ぶ価値のあるパターンがあるときだけだ。均一で、互いに独立したリクエストで作った合成のワークロードは、そのパターンを取り除いてしまう。
合成のトラフィックで調整した方針は、2通りの失敗をしうる。テストではうまく見えるのに、本物のトラフィックでは苦戦するかもしれない。
あるいは、学ぶものがそもそもなかったために、LRU(最も長く使われていないブロックを追い出す単純なルール)に対して何の優位も示さないかもしれない。
説得力のある評価は、次の特徴を残したリクエストのトレースを再生する。
- プレフィックスの重なり:同じ書き出しを共有するリクエストやテナント。
- セッションの構造:会話の区切りと、ターンの間の現実的な間隔。
- 集中して届く到着:ファブリックに本物の負荷をかけるほど強い急増。
- 混ざった文脈の長さ:短いプロンプトも長いプロンプトも。
これがなければ、ベンチマークの結果から、本番での方針の動きはほとんど分からない。
違う規模で現れる同じトレードオフ
KVの状態をどこに置くかを決めるのは、もっと広い問いの一例だ。計算とメモリとデータの移動をあわせたコストが最も小さくなるように、計算とデータをどこに置くべきか。
まったく違う規模でも、似た問いが出てくる。
HybridInferの、熱を考慮した強化学習によるティアのルーティングがその例だ。そこでは、コントローラーが、リクエストを端末で動かすか、エッジで動かすか、クラウドで動かすかを決める。
判断の材料は、端末の温度、回線の品質、遅延の目標である。
2つの問題を並べて、表にした。
| 観点 | ティアのルーティング | KVの保持 |
|---|---|---|
| 判断すること | どのティアがリクエストを処理するか | どのブロックが貴重なメモリを保つか |
| 変わり続けるもの | 端末の熱、回線の品質、負荷 | ファブリックの負荷、再利用、キャッシュへの圧力 |
| 動かすコスト | ティア間の遅延とエネルギー | 転送の時間と帯域 |
| 固定のルールが苦しい理由 | 最適なティアが条件で変わる | 最適なブロックがトラフィックで変わる |
| 学習に必要なもの | 軽い判断、安全な代わりの手段 | 軽い採点、安全な代わりの手段 |
2つの問題が共有するもの、まだ確かめられていないこと
共通する形は本物だ。どちらも、正しい答えが変わり続ける条件で決まる。だから固定のルールでは足りない。
どちらも、学習するコントローラーが役に立つのは、動かすコストが軽く、予測が外れたときに安全な動きへ戻れる場合だけである。
形が似ていても、同じ解決策がどちらにも通用するとは限らない。それは仮説であり、どちらの研究もまだ試していない。
引き継げるかもしれない材料はいくつかある。
- 取り合いを意識した入力:共有の資源がどれだけ混んでいるかを、コントローラーに伝える特徴量。
- テールに注目した報酬:平均のわずかな遅れより、遅い外れ値を重く見るペナルティ。
- 自信に基づく切り替え:モデルに自信がないときは、保守的なルールに制御を渡すこと。
これらが本当に引き継げるかは、両方の場面で、本物のトレースを使って確かめる必要がある。
ちょっと立ち止まって
キャッシュのよしあしを、ヒット率で判断していないだろうか。数字が高ければ、仕組みもうまく働いている。そう思い込んでいないか、一度考えてみたい。
ヒット率が上がっても、答えが遅くなることがある。入れるための転送が、本当に急ぐ転送を待たせるからだ。あなたが使っているサービスの「速さ」は、見えるところにある数字だけで決まっているのだろうか。
もう1つ、自分に問うてみたい。何かを「残しておく」ことに、コストはかからないと考えていないだろうか。
保存はただで、捨てるときだけ損をする。そんな見方が、見えない場所で支払いを生んでいないだろうか。
サービング設計への影響
分散型の推論基盤を運用するなら、キャッシュの方針とネットワークの設計は、もう別々には決められない。片方の選択が、もう片方に求められる役割を変えてしまうからだ。
三つをまとめて見積もる
互いに引き換えになる資源が三つある。ファブリックの帯域、キャッシュの容量、保持ポリシーだ。
住む場所を選ぶときの家賃、通勤時間、車の大きさに似ている。どれかを節約すると、たいてい別のどこかで負担が増える。
- 賢い保持ポリシー:帯域の不足を一部補える。無駄な転送を生む受け入れを省き、高くつくミスを避けるからだ。
- 帯域の増強:粗いポリシーの穴埋めになる。ミスは起きるが、1回あたりの痛手は小さくなる。
- キャッシュ容量の増強:追い出しの圧力をやわらげる。ただし、二度と使われないブロックを受け入れてしまう癖までは直らない。
どれがどれをどれだけ肩代わりできるかは、ワークロード次第だ。それぞれを単独で計画すると、別の資源の弱点を隠すために、どれかを買いすぎてしまうおそれがある。
ワークロードの知識が価値を持つ
コストを考えて保持を決める方式は、運用者が自分のトラフィックをよく知っているほどうまくいく。頻繁に、しかも予想どおりに再利用される内容があるからだ。
代表的な例は次のとおりだ。
- 長いシステムプロンプト
- エージェントの足場(スキャフォールド)
- ツールのスキーマ
- 検索(リトリーバル)用のテンプレート
運用者はこうした知識をポリシーに渡せる。たとえば、再利用されそうなブロックにタグを付ける方法がある。これで学習済みモデルは、先に手がかりを持って始められる。
では、なぜそれが助けになるのか。モデルが頼るフィードバックは、届くのが遅く、しかも不完全なことが多いからだ。早く追い出しすぎたブロックは、もう一度使われたはずかどうかが、あとからも分からない。
まだ決着していない設計上の問い
分散化は、今の運用ではまだ答えが出ていない問いをいくつも生む。どれも、1台のマシンで完結するキャッシュには要らなかった判断を増やす。
- ルーティングと保持:必要なブロックをすでに持っているデコードノードへ、リクエストを送る方法がある。すると、どこへ送るかと何を残すかが、ひとつの判断になる。両者をどこまで密に結びつけるかは、まだ決まっていない。
- プレフィルノードの温かいキャッシュ:プレフィルノードが、最近計算したブロックを持っておく方法がある。ミスが起きても、全部を計算し直さず、転送で済む。代わりに、管理するキャッシュの層がひとつ増える。
- より長いコンテキスト:コンテキストウィンドウが大きくなると、1リクエストあたりのブロックが増え、動かすデータも増える。長いコンテキストのうち、再利用されやすい部分だけを残し、残りは捨てるポリシーが必要になるかもしれない。
- テナント間の公平性:コストだけに合わせたポリシーは、内容がいちばん再利用されるテナントを優遇し続けるかもしれない。それを認めてよいかは、技術の問題であると同時に、プロダクトとしての判断でもある。
まず取り組めること
学習型のポリシーを採用するかどうかにかかわらず、意味のある手順がいくつかある。中心は、きちんと測ることと、リスクを低く保つことだ。
- キャッシュの結果ごとに、二つの数字を記録する。 提供したトークン1つあたりの転送バイト数と、最初のトークンが出るまでの時間(TTFT)だ。これがないと、ネットワークが絡んだときにキャッシュが役立っているのか逆効果なのか、判断できない。
- ポリシーの中で、受け入れと追い出しを分ける。 当面はどちらも単純なルールのままでよい。受け入れの制御だけでも、二度と使われないブロックに使う帯域を減らせる。
- 新しいポリシーを試す前に、現実的なトラフィックの記録をそろえる。 共有されるプレフィックス、複数ターンのセッション、急な集中を含めておく。
- よく再利用されると分かっている内容にタグを付ける。 システムプロンプトやエージェントの足場が典型だ。学習型かどうかを問わず、どのポリシーもこのタグを使える。
- 学習型のコントローラーには、必ず安全な代替手段を用意する。 本番の経路に入れる前に、わざと外した予測を与えて試す。
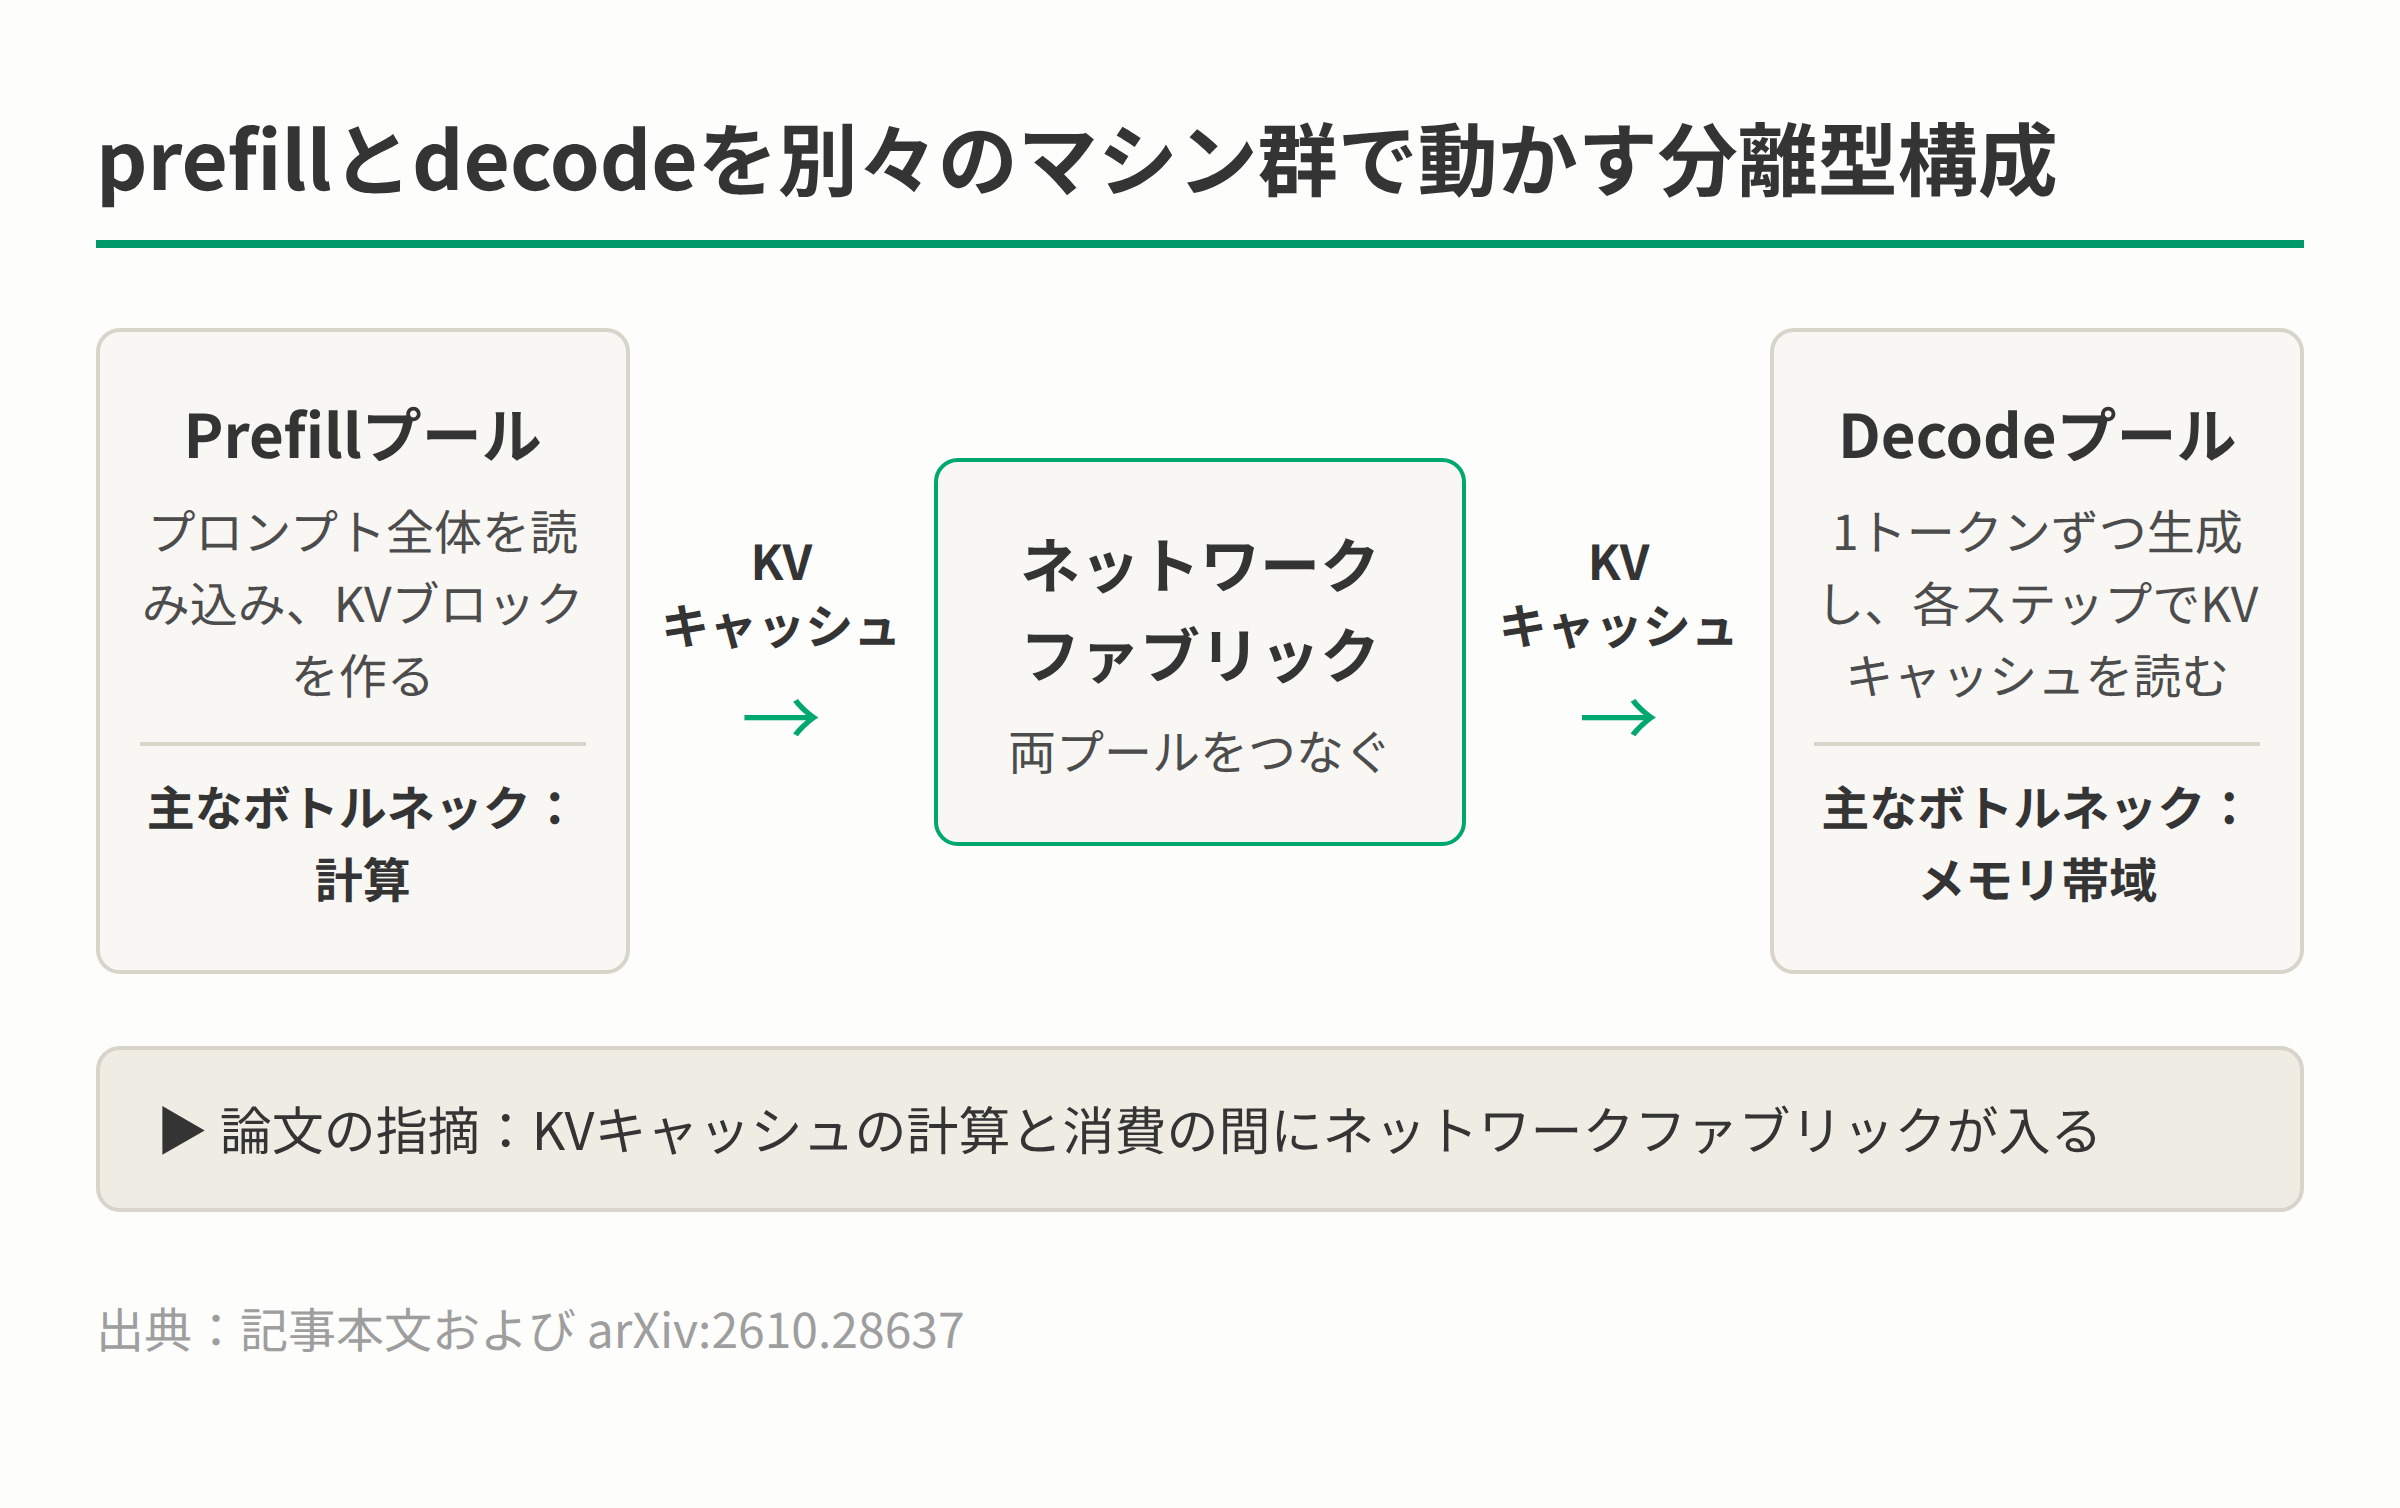
図1:prefillとdecodeを別々のマシン群に分けた構成とKVキャッシュの経路(出典:記事本文および arXiv:2610.28637)
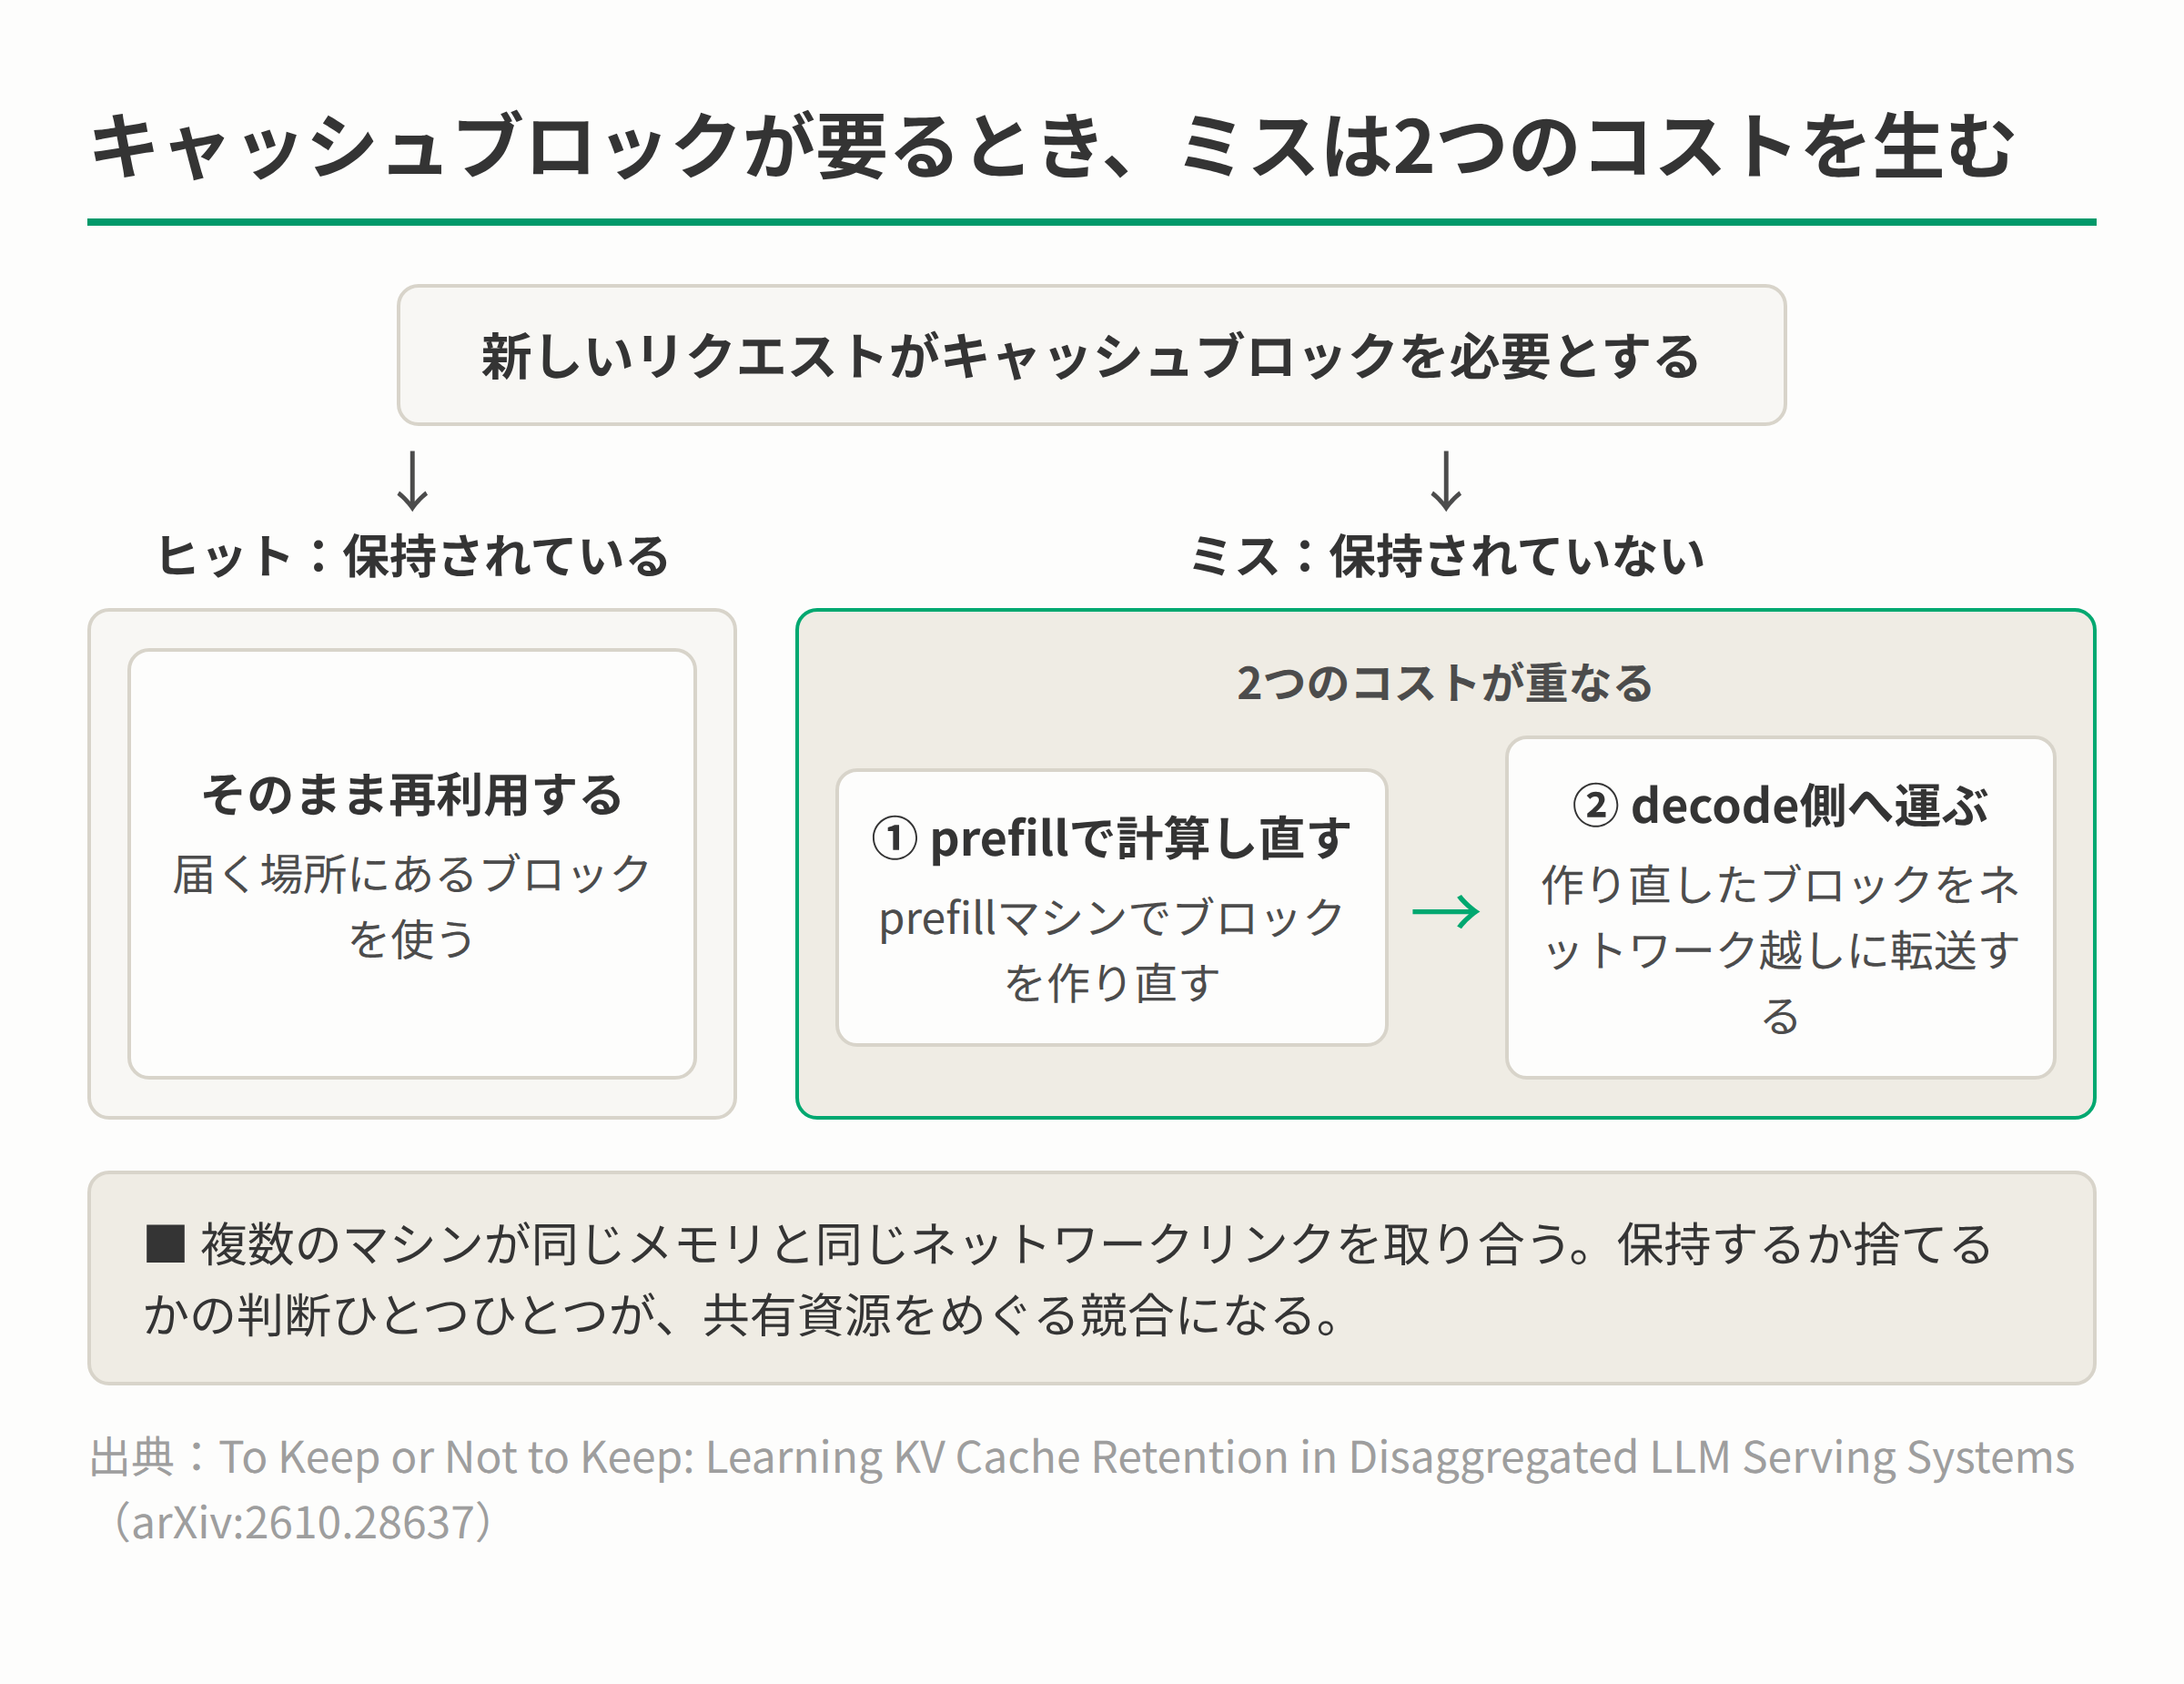
図2:分離型構成でキャッシュミスが生む2つのコスト(出典:To Keep or Not to Keep: Learning KV Cache Retention in Disaggregated LLM Serving Systems、arXiv:2610.28637)