練習問題の数字だけを少し変えた問題が本番に出たとする。生徒はその試験で満点を取った。成績は立派に見えるが、初めて見る問題を解けるかどうかは、ほとんど分からない。
鉄鋼の強度を予測するモデルも、同じ落とし穴にはまることがある。新しいプレプリント「SteelAgent(arXiv:2611.06953)」は、この問題をはっきり指摘している。
鉄鋼の特性モデルは「ランダムな分割では良い成績を出せても、見慣れない合金への外挿は苦手なことがある」というのだ。1
この話は、こうしたモデルをつくる人にも、買う人にも、使う人にも関わってくる。金属の研究者が必要とするのは、すでに手元にある合金の予測ではない。
まだ誰も試していない成分や製造工程の予測だ。新しい合金は、そこから生まれるからである。
SteelAgentは、金属学の知識にもとづく特徴量(記述子)と機械学習の回帰モデルを組み合わせ、言語モデルのインターフェースを付けたものだ。このインターフェースが受け持つのは、特性の予測、不確かさの報告、逆設計の3つである。
著者らは、何を評価から外す(ホールドアウトする)かによって、SteelBenchの引張強度評価から引き出せる結論がどう変わるかも調べている。1
この記事も、その流れに沿って進む。各段階で、読み手がどんな状況にいるのか、そこから何が言えるのかを考えていく。
この記事のポイント
- ランダム分割の成績は、そっくりな合金の隙間を埋める力を主に測っている。見慣れない合金への強さは、あまり分からない。
- SteelAgentでは、言語モデルは道具の調整役だ。強度の値そのものは出さない。
- 何を評価から外すかは、モデル設計の選択である。1件の記録、合金の系統、成分のまとまり、製造工程のどれにするかで、ベンチマークから言える結論が変わる。
試験の合金が訓練の合金に似ているとき:ランダム分割の錯覚
ランダム分割は、モデルを実力以上によく見せてしまうことがある。鉄鋼のデータには近い親戚のような記録がたくさんあり、ランダム分割ではその親戚が境界の両側に入るからだ。
近い親戚は、たとえば次のような形で現れる。
- 同じ成分で、焼き戻しが違う:1つの基本成分が、いくつもの熱処理を経て登場する。
- 同じ鋼種で、溶解(ヒート)が違う:1つの鋼種が、複数の製造バッチから登場する。
- 同じ成分で、圧延が違う:1つの合金が、少しずつ違う圧延工程を経て登場する。
ランダム分割は、こうした親戚を訓練用とテスト用にばらまく。すると、テスト用の記録にはたいてい訓練データの中にそっくりな相手がいる。
モデルは、すでに見た近所の合金の隙間を埋められるかどうかで、主に採点されることになる。
では、ランダム分割の点数はまったく役に立たないのか。そうとは限らない。
価値は、実際の問い合わせが訓練データにどれだけ近いかで決まる。次の表で、よくある使い方ごとに比べてみよう。
| 状況 | ランダム分割の点数から分かること |
|---|---|
| 確立した鋼種の品質管理 | かなり多い。問い合わせが既知データに似ている |
| 既知の系統内での小さな工程調整 | ある程度ある。変化が既知データの近くにとどまる場合 |
| 新しい成分や工程のふるい分け | 少ない。既知の近所を反映しているだけ |
| 新しい合金の逆設計 | 誤解を招くかもしれない。探索が既知データから外れうる |
最後の行には、条件を1つ書き添えておきたい。逆設計の探索は、予測された特性が最も良くなる場所を探す。
モデルの近くに例が1つもない場所にたどり着いても、止めるものはない。そこでは、ランダム分割の点数が良くても守りにはならない。
ベンチマークの数字は、モデルの力と同じくらい、テストセットの作り方を映している。 そう考えると、問いの立て方が変わってくる。
「このモデルはどれだけ正確か」よりも、「このモデルは何を学んだのか、それをどうやって確かめるのか」のほうが役に立つ。
SteelAgentの中身:記述子、学習器、言語インターフェース
SteelAgentは3つの層でできていて、それぞれ役割が分かれている。設計の要は、言語モデルが作業の指揮はとるが、数値は出さないことだ。
3つの層は次のように働く。
- 物理にもとづく記述子:入力は、元素の割合そのままではなく、金属学の知識から作る。固溶強化の項、炭素当量、変態温度の推定値などがその例だ。どれも、既知の強化メカニズムに結びついている。
- 機械学習の回帰モデル:記述子から、引張特性の予測値を出す。
- 言語モデルのインターフェース:依頼を読み取り、適切な道具に渡し、数値の結果を不確かさも含めて説明する。
強度の値はすべて回帰モデルから出る。生成された文章から出ることはない。
言語モデルに数値を触らせない理由
この分業によって、言語モデルが間違える場所は限られる。誤りはインターフェースの中にとどまるのだ。
2種類の失敗は、危険の大きさがかなり違う。もっともらしい降伏強度を、言語モデルが勝手に作ったとしよう。その誤りは、見た目におかしなところがないぶん危ない。
問い合わせを違う道具に送ってしまう間違いは、もっと小さく、気づきやすい。言語モデルが計算に関わらなければ、どの数字も回帰モデルまでたどって確かめられる。
記述子に込められた賭け
記述子の背後には、1つの仮説がある。物理的なメカニズムに結びついた特徴は、相関をなぞっただけの特徴より、見慣れない成分にもうまく通用するはずだ、という仮説だ。
理屈はこうである。固溶強化の項は、新しい合金でも古い合金でも同じ意味を持つ。
一方、ニッケルの割合そのままでは、訓練データでたまたまニッケルと一緒に出てきたものの代わりにすぎないかもしれない。だから、よりよく通用すると期待できる。
ただし、これは証明ではない。合金のグループをまるごと外した評価だけが、この仮説を試せる。
同じ層でできる3つのこと
同じ3つの層で、3つの作業ができる。
- 順方向の予測:成分と工程を入れると、引張特性が出てくる。
- 不確かさの報告:どの推定にも区間が付く。
- 逆設計:目標の特性をねらって、エージェントが成分や工程を提案する。
どの単位を評価から外すか
テストが「未知」をどう定義するかで、結果の意味は変わる。SteelBenchの引張強度タスクで、SteelAgentの著者らは、どの単位を外すかによって答えが変わることを示している。
外す単位を変えるたびに、問いも変わる。次の表で、主な4つの選び方を比べてみよう。
| 外す単位 | 答えが分かる問い | 情報漏れの危険 |
|---|---|---|
| 1件の記録(ランダム) | 既知の合金の隙間を埋められるか | 高い。そっくりな記録が境界をまたぐ |
| 合金の系統 | 見たことのない系統を予測できるか | 系統がきれいに定義できれば低い |
| 成分のまとまり | 見慣れない成分に届くか | まとまりの大きさしだい |
| 製造工程 | 新しい工程に対応できるか | 成分の漏れは残る |
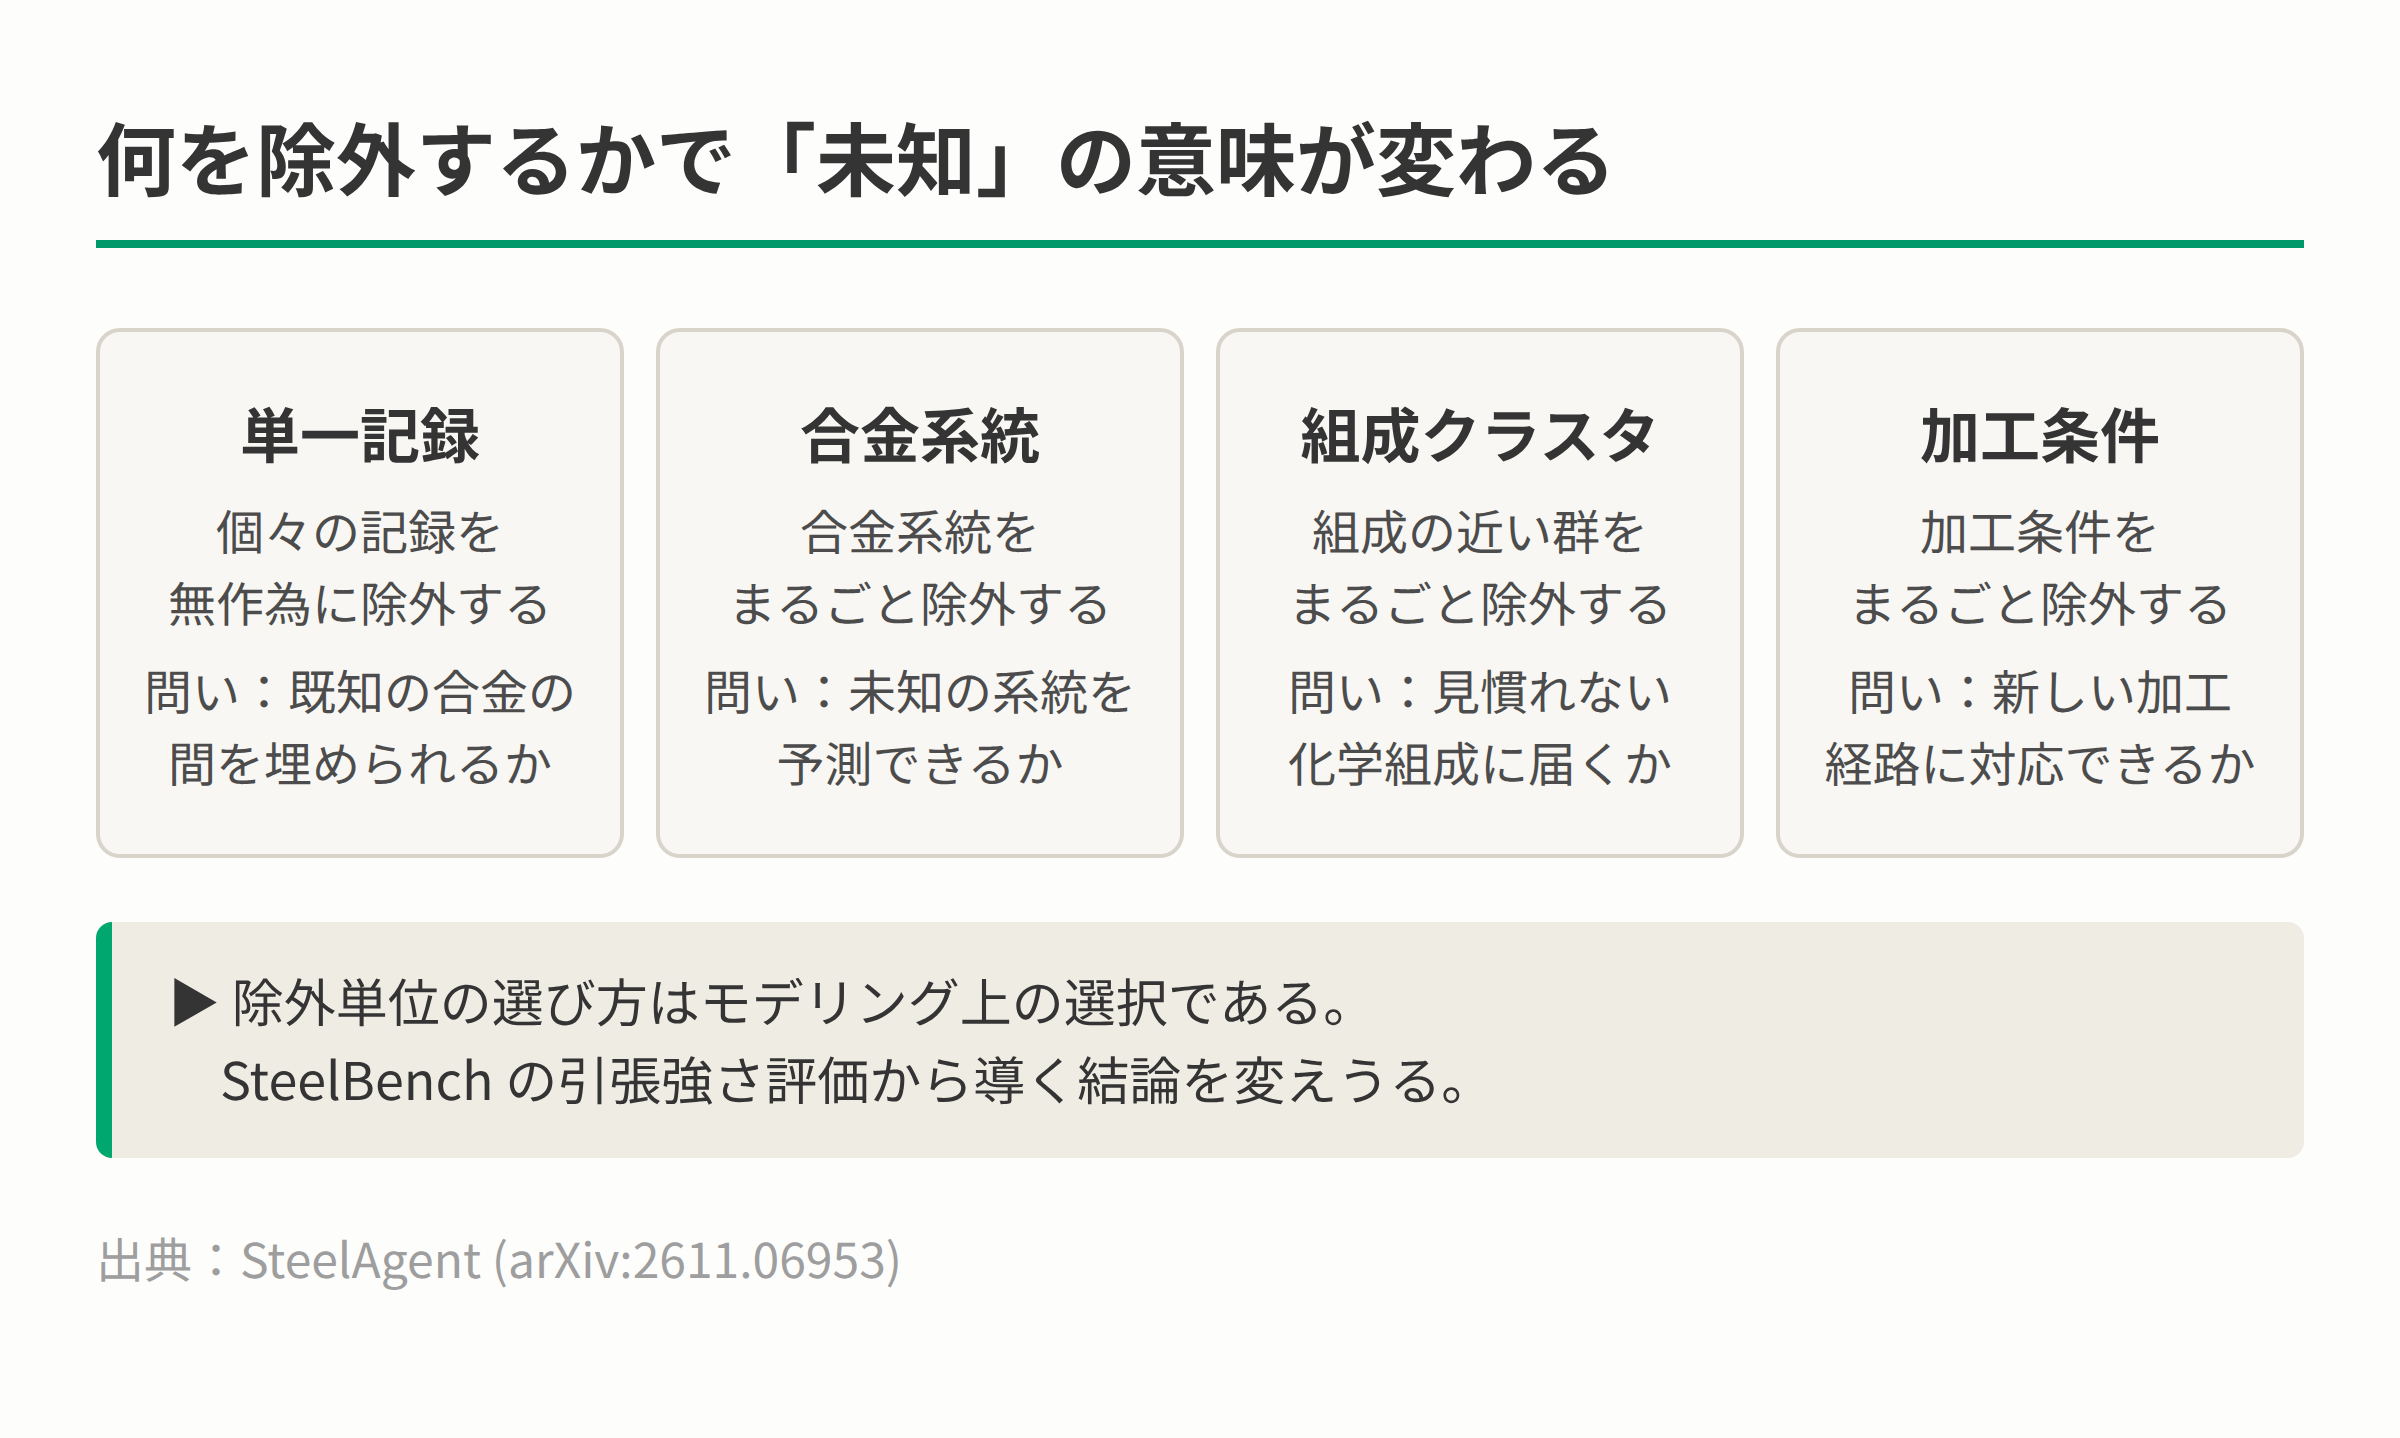
図3:何を除外するかで変わる評価単位(単一記録・合金系統・組成クラスタ・加工条件)(出典:SteelAgent (arXiv:2611.06953))
同じモデルでも順位が変わる
こうした問いによって、同じモデルの順位が入れ替わることがある。ランダム分割で最も良く見えたモデルが、合金のグループをまるごと外すと、首位から落ちることがある。場合によっては、まったく崩れてしまう。
物理にもとづく記述子で作ったモデルは、グループ単位の分割でも比較的持ちこたえるかもしれない。メカニズムに結びついた特徴が本当に通用するなら、そうなると予想できる。
それでも、データセットごとにグループ分割の結果で確かめる必要がある。1つの結果で、次のデータセットのことまで決まるわけではない。
点数の差から分かること
ランダム分割の誤差とグループ分割の誤差の差は、それ自体を報告する価値がある。モデルの見かけの実力が、訓練データの近い仲間にどれだけ頼っているかの、おおまかな目安になるからだ。
差が小さければ、モデルは通用する何かを学んだと考えられる。差が大きければ、目立つ点数の大半は内挿で稼いだものだと考えられる。
ただし、目安はおおまかだ。グループ分割のテストセットは、単に難しいだけの場合もあるからである。
差は、調べるべき点があることを示す。丸暗記の証明にはならない。
電波マップとの比較
別の分野を見ると、鉄鋼の分割がなぜ難しいかが分かる。屋内電波マップのための協調的な文脈内学習の研究では、新しい建物や場所が、自然な未知の単位になる。
わずかな測定値から適応していく手法だ。この分野では、地理がほぼ自動的に境界を決めてくれる。
鉄鋼には、これほどはっきりした境界がない。合金の系統、成分のまとまり、製造工程は、どれも筋の通った選び方だ。
単位を選ぶのは分析する人なので、都合のよい選び方をすればモデルをよく見せられる。粗くて境界から情報が漏れるまとまりを使うと、結果はランダム分割に近いのに、厳密そうに聞こえてしまう。
分割を使い方に合わせる
適切に外す単位は、その予測がどんな判断を支えるかで決まる。
- 新しい成分のふるい分け:成分のまとまりや系統を外す方法が、問いに合っている。
- 既存の鋼種の工程変更:製造工程を外す方法が、ふさわしいテストになる。
- 公表されたモデルの比較:2つの研究で同じ単位を外していなければ、数字は比べられない。
外した単位が書かれていない精度の数字は、読み解くのが難しい。その情報は、評価指標そのものと同じくらい大事だ。
誤差が増えても誤差範囲が狭いままなら
予測の価値は、誤差範囲の信頼性しだいだ。その誤差範囲がとくに大事になるのは、モデルがデータの外で推測しているときである。 SteelAgentは、推定値ごとに不確かさを報告する。
問題は、その不確かさを信頼してよいかどうかだ。
「降水確率70パーセント」と出る天気アプリを考えてみよう。そう表示された日のおよそ10日に7日、実際に雨が降るなら、そのアプリは頼りにできる。ここでの較正(キャリブレーション)も同じ意味だ。
モデルが90パーセント区間を出すとする。その区間は、真の値を約90パーセントの確率で含んでいなければならない。これは、合金の系統をまるごと外したグループ分割でも成り立つ必要がある。
ランダム分割だけでは足りない。
では、ランダム分割ではなぜ足りないのか。ランダム分割では、テスト用の合金の近い親戚が訓練データに残っている。その方法で測った較正には、同じ方法で測った精度と同じ欠点がある。
要約では同じに見える2つの結果
問い合わせが訓練データから離れていくとき、区間の振る舞いは大きく2通りに分かれうる。
- 区間が広がる:不確かさが、見慣れない合金を知らせる検知器の役割を果たす。広い区間は、「ここは自分の経験の外だ」と言っているのと同じだ。
- 誤差が増えても区間が狭いまま:モデルは自信たっぷりに間違えている。材料の分野では、これが最悪のケースだ。間違った推測をもとに、試験鋳造や圧延試験、引張試験を重ねると、そのたびに時間とお金がかかる。
本物の較正と見せかけを分ける2つの確認
どちらの結果が起きているかは、2つの区別で分かる。
- ばらつきは較正ではない。 不確かさが、複数のモデルの意見の食い違いから来ているとしよう。そのばらつきは、目安にすぎない。同じ偏ったデータで訓練したモデルどうしは、一致したまま間違うことがある。較正は、モデル間の一致度ではなく、外しておいた真の値と照らして確かめる必要がある。
- 全体の平均は、局所的な失敗を隠す。 データセット全体で被覆率が90パーセントでも、それは2つの違う状況の平均かもしれない。なじみのある系統では区間が広すぎ、見慣れない系統では狭すぎる、ということがありうる。外したグループごとに被覆率を測って初めて、どちらが起きているかが分かる。
グループごとに被覆率が保たれていれば、その不確かさは判断の助けになる。いちばん難しいグループで崩れるなら、その区間は飾りにすぎない。
エージェントに推論と設計を任せるなら:仲介役か、新しい失敗の場か
物理にもとづく予測器の前に置いたLLMは、予測器を使いやすくしてくれる。一方で、間違いの起こる新しい場所も増やしてしまう。精度の表では、その増えた分は見えない。
参考になる先例がある。
工学シミュレーターの較正役としてのLLMの研究では、物理的な意味を添えたプロンプトが、決まった評価回数の範囲で言語モデルのパラメーターの推論を助けた。その効果は、プロンプトが物理的な意味をどれだけはっきり示したかによって決まっていた。
SteelAgentは、この考え方をシミュレーターの調整から特性モデルへの問い合わせに移したものだ。同じ依存関係が引き継がれると考えるのは、無理のない予想である。
エージェントの信頼性は、受け取る記述子と道具の出力の信頼性を超えられない。これは先の研究からの推論であり、SteelAgentについて報告された結果ではない。
言語モデルが役立つところ、害になりうるところ
次の表で、エージェントが貢献できる点と、それに対応するリスクを並べてみよう。
| 価値を足すところ | リスクを足すところ |
|---|---|
| ゆるい目標(「もっと強く、溶接しやすく」)を構造化した問い合わせにする | 単位、制約、特性の定義を読み違える |
| 予測の道具と不確かさの道具をつなぐ | 不確かな予測を、確かなものとして示す |
| 機械学習の専門外の技術者に結果を説明する | モデルの有効範囲の外にある候補を提案する |
歯止めとしての監査結果
監査された汎化性能は歯止めになりうる。
ただし、エージェントがそれを見られる場合に限る。エージェントが、成分空間の領域ごとに、外して試した結果を持っているとしよう。すると、答えに但し書きを付けられる。
たとえば、「この系統はグループ分割のテストでも良好だった」と言える。
あるいは、「この領域には検証された裏づけがない」とも言える。この情報がなければ、モデルが報告する自信を、根拠があってもなくてもそのまま伝えるしかない。
逆設計で賭け金が上がる理由
逆設計は、こうした問題の代償がもっとも大きくなる場面だ。高強度の成分を探す最適化は、モデルが強度を過大に見積もる場所へ流れていきやすい。そうした場所には、データが少ないことが多い。
レビューがいちばん少ない商品ばかりに惹かれる掘り出し物探しに似ている。いちばん良く見える候補が、いちばん外れやすい候補かもしれない。
較正された不確かさと、監査で分かった限界があれば、探索を直す方法は3つある。
- 不確かさに罰則を付ける。 候補は、1つの最良の推定値ではなく、慎重に見た下限値や期待される見返りで採点する。
- 信頼できる範囲の近くにとどまる。 提案は、グループ評価で許容できる誤差だったと分かっている領域の中に置く。そこから出るときは、はっきり印を付ける。
- 実験の価値で順位を付ける。 少し弱くても、きっちり較正された狭い区間を持つ候補のほうが、誤差が分からない華々しい候補より、よい賭けになることがある。
これらの修正がSteelBenchでどれだけ効くかは、1つの条件にかかっている。区間がグループごとに較正されていることだ。
そうでなければ、不確かさへの罰則は、見当違いのものを罰していることになる。設計の理屈は、どちらの場合でも成り立つ。成果が出るかどうかが、その条件しだいなのである。
判断の早見表:あなたに当てはまる道はどれか
必要なテストは、モデルで何をするつもりかによって変わる。日常的な品質チェックなら問題のない点数でも、モデルが見たことのない成分をふるい分けるときには、誤解のもとになる。
次の表は、よくある状況ごとに、向いている評価の分割、不確かさを信頼してよい目安、エージェントの役割を対応させたものだ。
| あなたの状況 | 評価の方法 | 不確かさを信頼してよいとき | エージェントの役割 |
|---|---|---|---|
| 確立した鋼種の品質管理 | ランダム分割で足りる | 全体の被覆率が保たれる | 説明と報告 |
| 既知の系統内で工程を調整 | 製造工程を外す | 工程ごとの被覆率が保たれる | 問い合わせの構造化と道具の連結 |
| 新しい成分のふるい分け | 系統またはまとまりを外す | 分布の外で区間が広がる | 領域ごとに答えへ但し書きを付ける |
| 逆設計 | まとまりを外す。適用範囲の確認も行う | いちばん難しいグループでも、グループごとの被覆率が保たれる | 制約付きの提案役。必ず検証する |
| 公表モデルの比較 | すべて同じ単位を外す | 同じ較正の手順 | 分割がそろうまでは関係ない |
「区間が広がる」の行には、限界がある。見慣れない合金で区間が広がるのは、よい兆候だ。
ただし、区間が十分に広いことの証明にはならない。それが分かるのは、グループごとの被覆率の確認だけである。
似たシステムをつくるチームにとっての意味
この監査から、5つの実践が導かれる。どれも、モデルが実際より信頼できるように見える特定のパターンを狙ったものだ。
- グループ分割での評価を標準にする:ランダム分割の数字にも使い道はある。主な成果ではなく、内挿の力を示す副次的な基準として使う。
- どの指標にも、外した単位を並べる:読み手が、何を訓練から外したのかを知れるようにする。ランダム分割とグループ分割の誤差の差も報告する。
- グループごとに較正を確認する:全体の被覆率は正しく見えても、一部のグループでは大きく足りないことがある。外したグループごとに調べると、それが見えてくる。
- 予測のたびに不確かさを示す:エージェントは区間を出し、該当する領域について監査で分かった信頼性にも触れる。
- LLMには数値予測をさせない:言語の層は、モデルの限界を見えるようにするためにある。限界をぼかすために使ってはならない。
ちょっと立ち止まって
精度の高いモデルなら、新しい材料でもうまくいくはずだと考える人は多い。それが成り立つのは、テストセットが本当にモデルにとって初めてのものだった場合だけだ。
最近、精度に感心した鉄鋼のモデル、あるいは材料のモデルを思い出してみてほしい。そのテストで何が外されていたか、あなたは知っているだろうか。
見たことのない合金の系統でも使えるのかと聞かれたら、証拠を挙げて答えられるだろうか。それとも、そうであればいいと願っているだけだろうか。
モデルが報告できるいちばん正直な数字は、近いそっくりな仲間を取り除いたとき、どれだけ成績が下がるかを示す数字なのかもしれない。
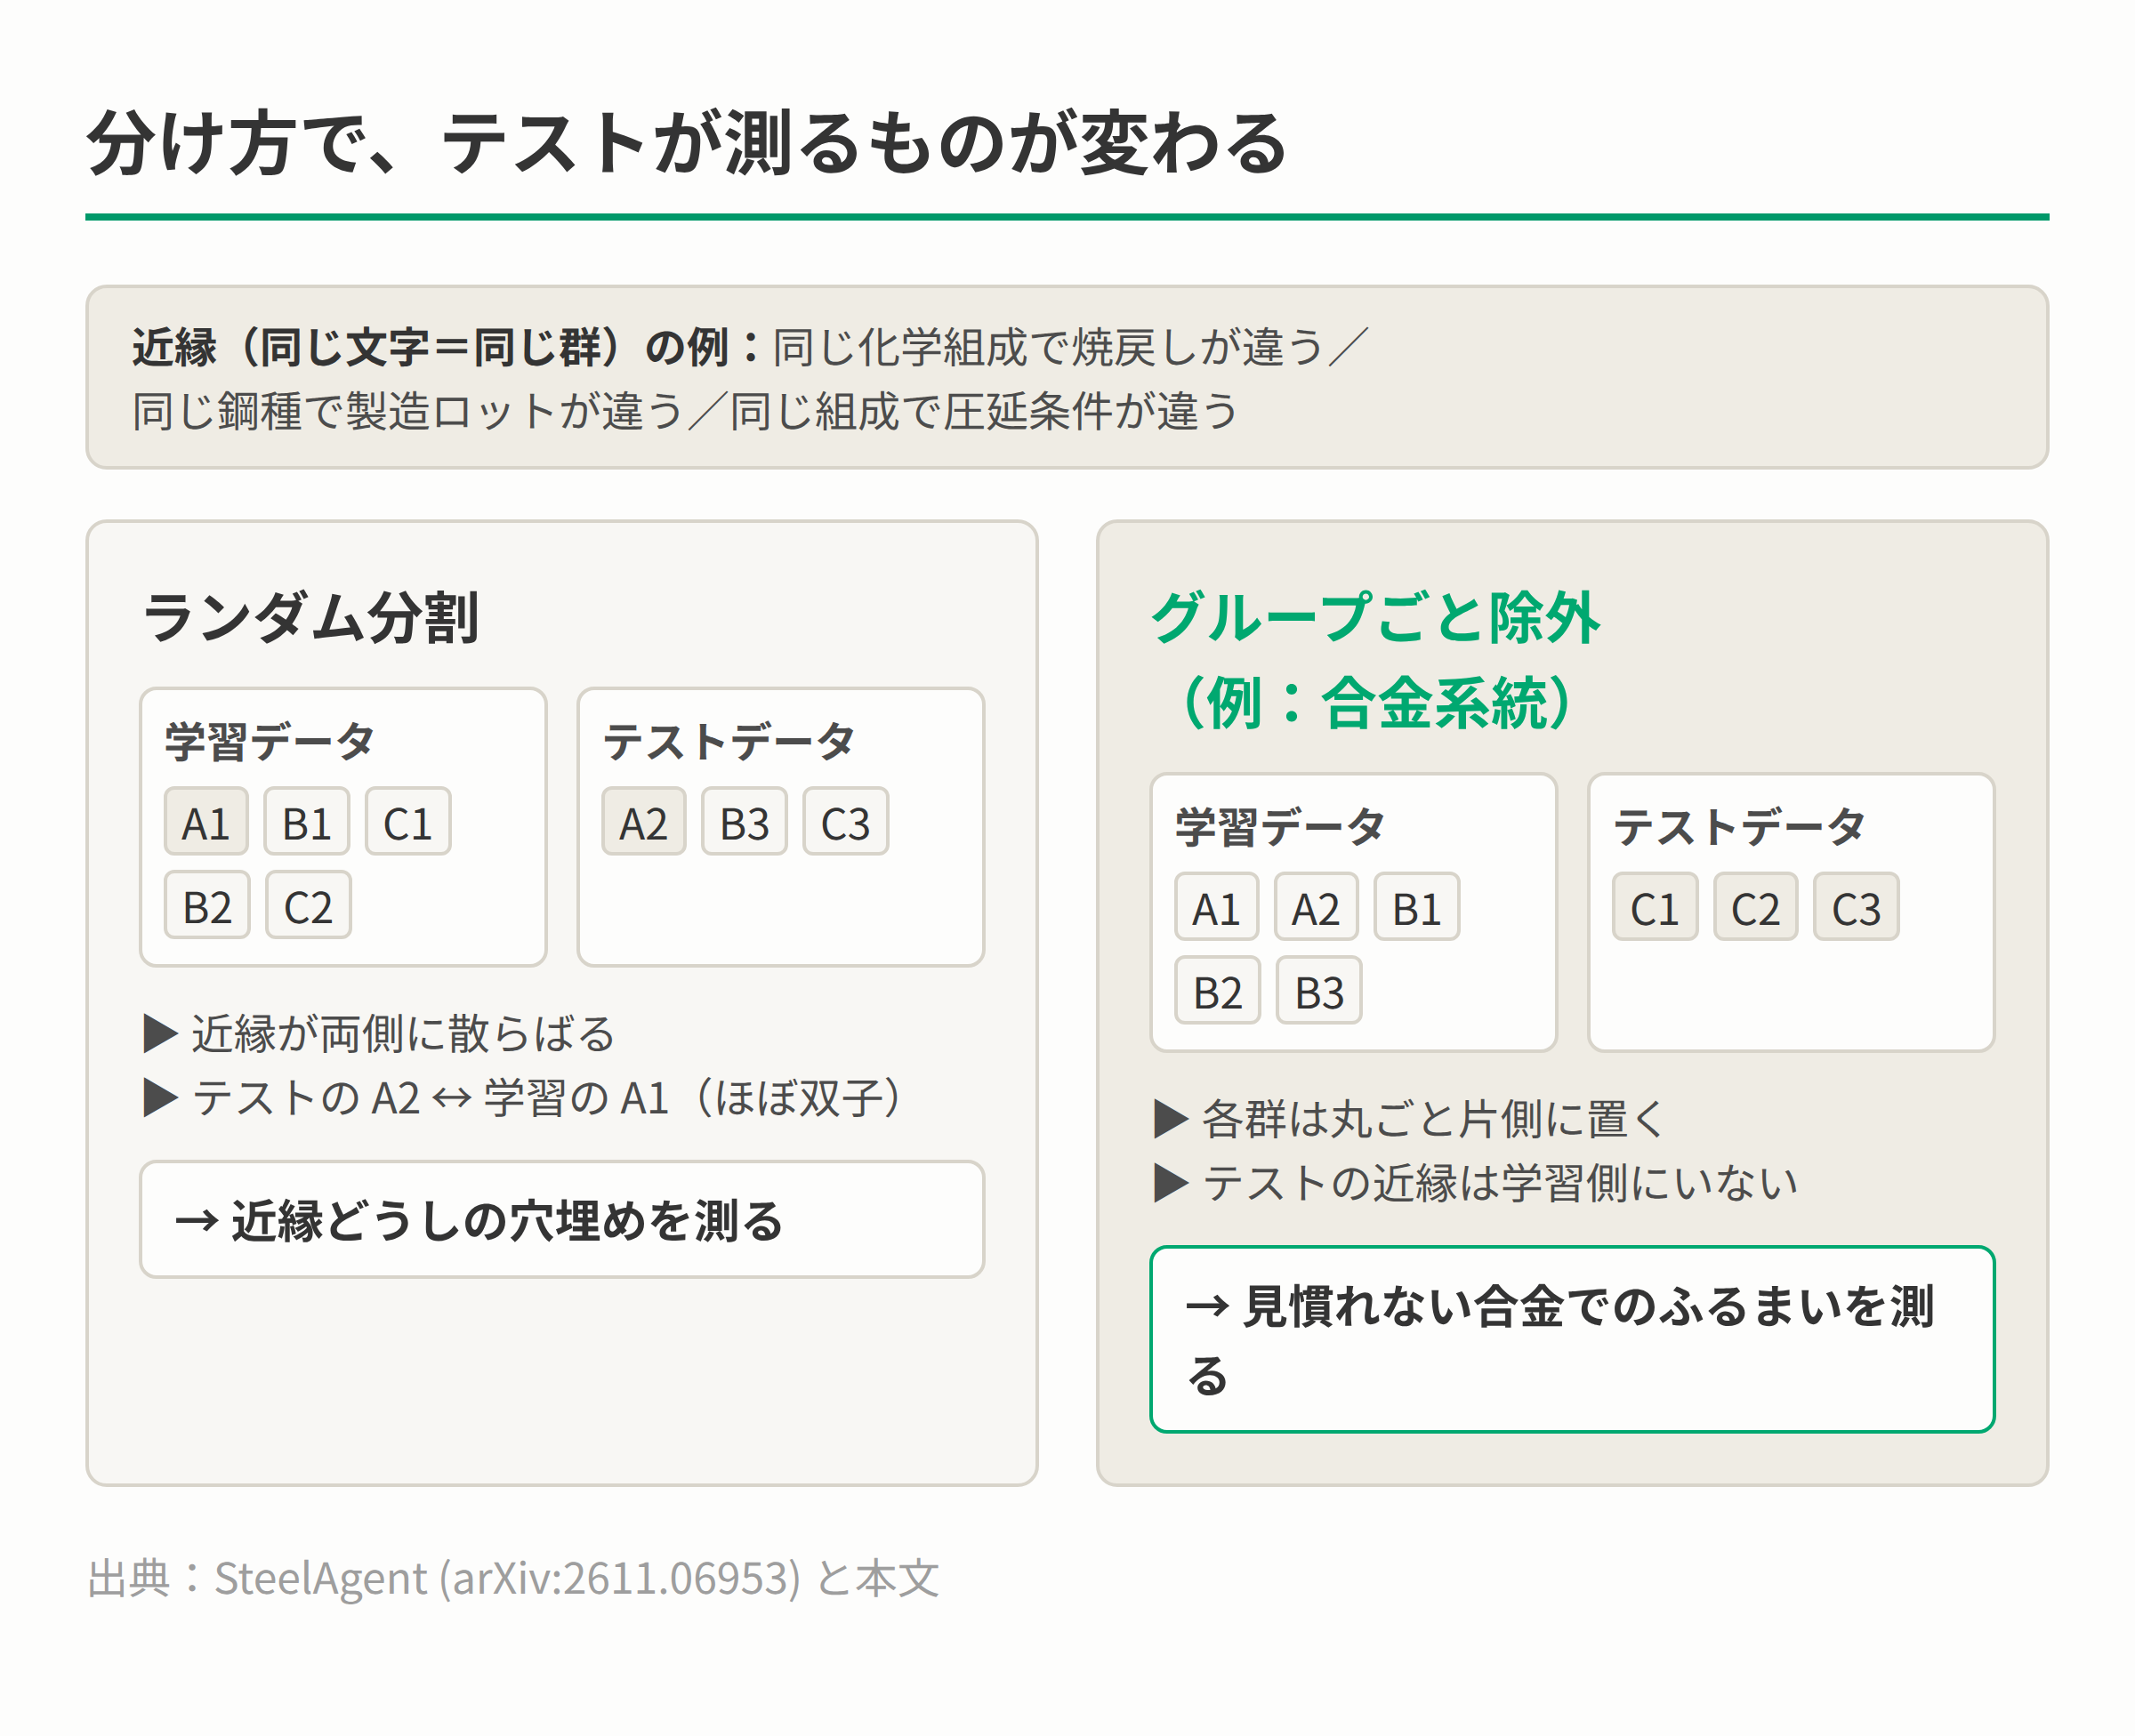
図1:ランダム分割とグループ単位の除外で、テストが測るものの違い(出典:SteelAgent (arXiv:2611.06953) と本文)
脚注
-
SteelAgentプレプリント、arXiv:2611.06953。 ↩ ↩2