ローカル学習は、各層が自分専用の補助的な損失(学習の目標となる指標)で訓練される方式だ。
ネットワーク全体を逆向きにたどる計算(バックプロパゲーション)は使わない。原理的には、メモリを節約でき、層ごとに並列で訓練できる。
ところが実際には、いまも一部の研究にとどまっている。理由は2つある。ネットワークが深くなると、精度が大きく落ちる。
ハイパーパラメータ(学習率など訓練前に決める設定値)も壊れやすく、アーキテクチャやデータセットが変わると、同じ設定がほとんど通用しない。
この2つは、ふつう別々の問題として扱われる。この記事は、両者の原因が同じだという見方を示す。そのうえで、スペクトル更新則がその原因にどう効くのかを考え、この見方を裏づける証拠と覆す証拠が何かを整理する。
この記事のポイント
- ローカル学習の「深さに弱い」「設定が壊れやすい」は、同じ原因から生じている可能性が高い。全体の勾配がないため、各層がどこまで動いてよいかを隣の層とそろえる仕組みがない。
- 更新のたびに、下流の層に届く入力が変わってしまう。この「層間ドリフト」は積み重なる。浅い層数で安全だった歩幅が、深いネットワークでは不安定のもとになりうる。
- 「ドリフト契約」とは、各層が1ステップあたりの出力の変化量を抑えるという約束だ。そうすれば下流の層は適応を続けられる。
- Muon 型のスペクトル更新は、モーメンタムを直交化し、1ステップのスペクトルノルムを制御する。この性質はドリフト契約にそのまま対応する。
- この見方が正しければ、2つの兆候が現れるはずだ。エンドツーエンド訓練との精度差が、深さとともに広がらなくなる。学習率が、深さや幅をまたいで使い回せるようになる。
- スペクトル制御は、全体での貢献度の割り当て(クレジット・アサインメント)の代わりにはならない。補助的な目標が最終課題とずれる問題は残りうる。
ネットワークが深くなるとローカル学習が崩れる理由
ローカル学習には分かりやすい魅力がある。通常のバックプロパゲーションは、ネットワーク全体の活性化(各層の出力)を保存する。
そして、誤差の信号をすべての層に送り返す。ローカル学習は、この条件を外す。各層(または層のまとまり)が、手元の情報だけで自分の目標を最適化する。
この設計には、3つの利点が見込める。
- メモリ使用量が少ない。 逆向きの計算のために活性化を保持し続ける必要がない。
- 並列に動かせる。 各層は、ネットワークの上のほうから勾配が届くのを待たなくてよい。
- モジュールとして扱いやすい。 原理的には、ブロックごとに独立して訓練したり、入れ替えたりしやすい。
ただし、根強い2つの失敗が、これらの利点を削ってしまう。
| 失敗 | よくある説明 | 生じるコスト |
|---|---|---|
| 深くなるほど精度が落ちる | 補助的な損失が弱く、深い層を導けない | 大きなモデルほど、エンドツーエンド訓練との差が開く |
| ハイパーパラメータが壊れやすい | 層ごとに調整が必要になる | ある構成で見つけた設定が、別の構成にほとんど持ち越せない |
ふつうの説明では、この2つは無関係に見える。深さの問題は損失の設計のせいにされる。壊れやすさは調整の手間のせいにされる。
別の見方をすると、2つはつながってくる。第 k 層が自分の目標に沿って重みを更新すると、第 k+1 層に届く入力の分布が変わる。
第 k+1 層は、動く的を追いかけることになる。その層が自分の更新をすると、今度は第 k+2 層の入力が変わる。この連鎖が、ネットワークの上まで続く。
層ごとの小さな変化は、深さに応じて掛け算のように積み重なりうる。 3層のネットワークで安全だった歩幅が、30層では不安定のもとになるかもしれない。つまり、安全な歩幅は深さによって決まる。
一度調整すれば済む定数ではない。
この見方が正しければ、壊れやすさはたまたま起きた問題ではなく、構造上の問題だ。補助的な損失を改良したり、手の込んだ工夫を足したりしても、それだけでは直らない。
もっと直接的な対処は、幾何学的なものになる。各層の出力表現が1ステップでどれだけ動くかを、直接抑えるのだ。
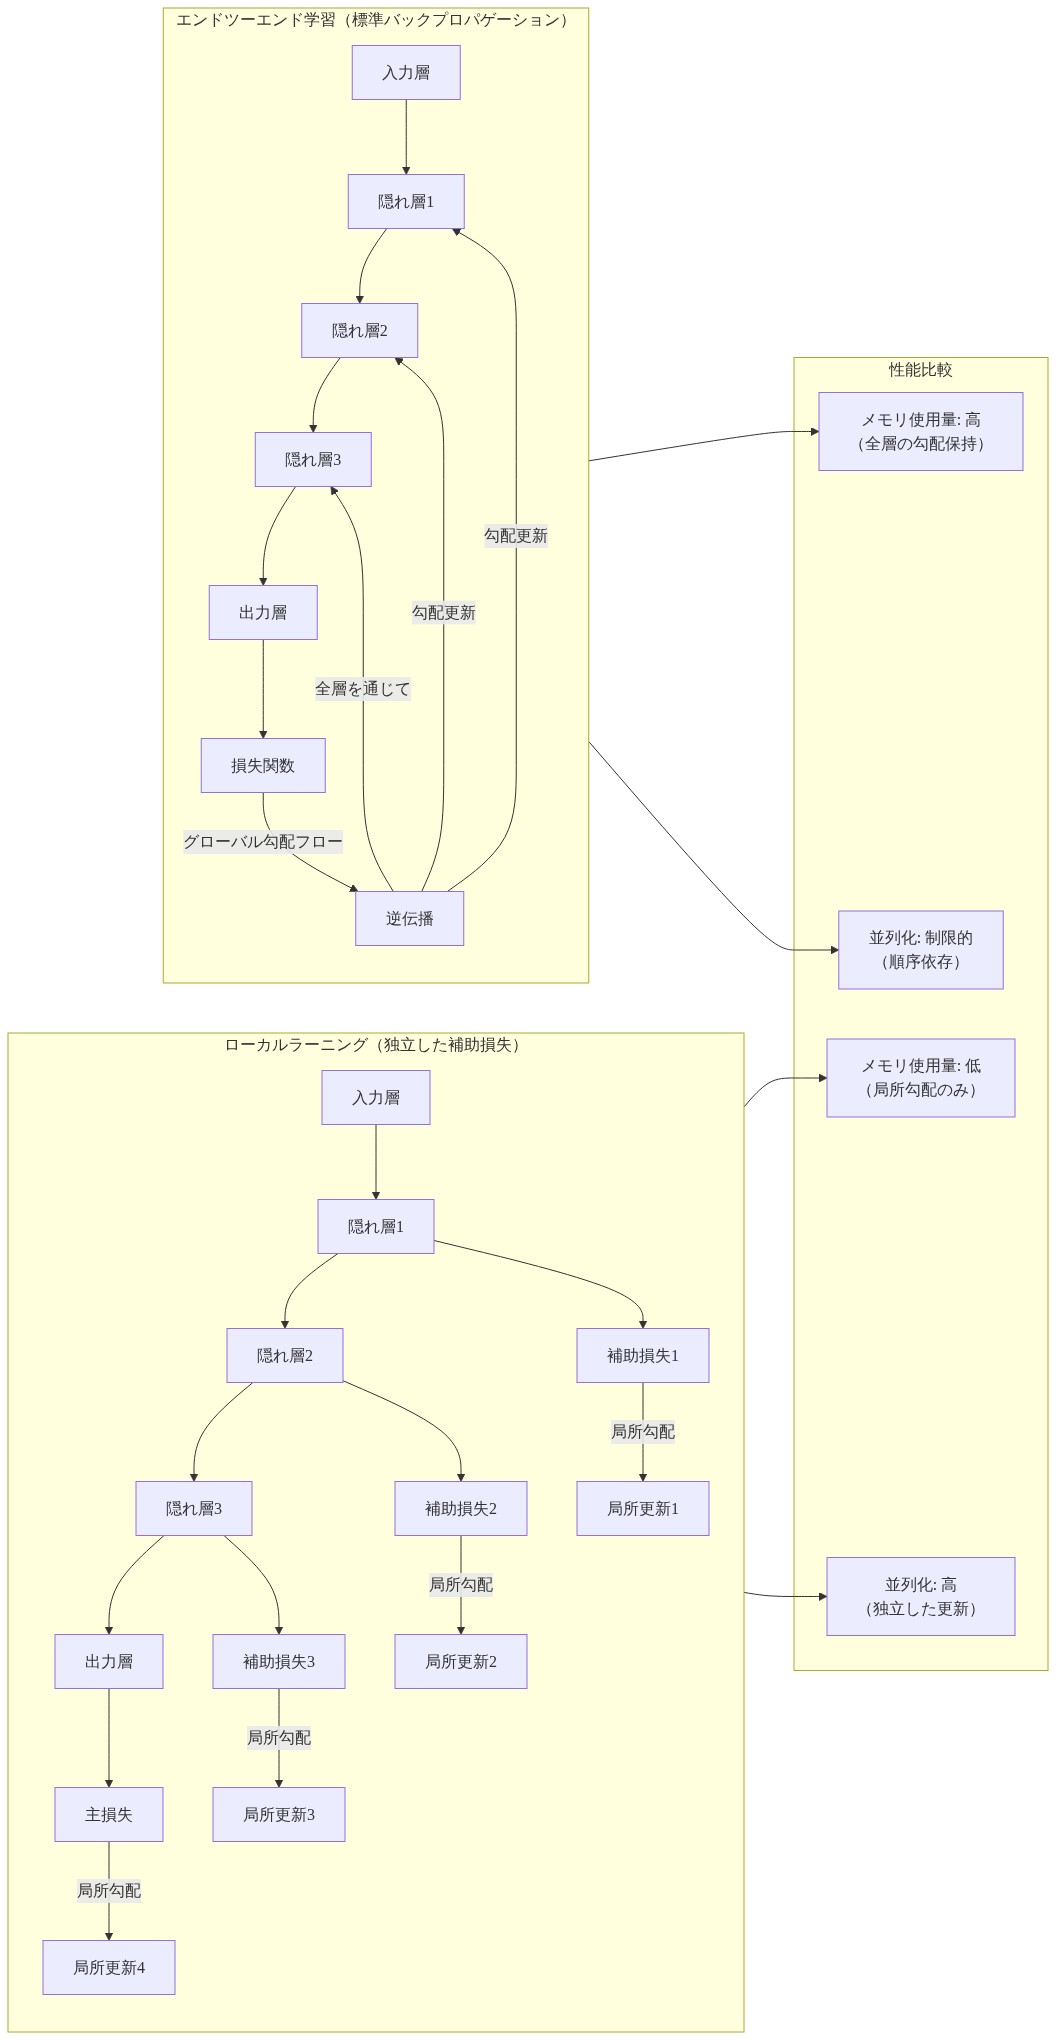
図2:ローカルラーニング vs エンドツーエンド学習の構造比較
層間ドリフトという「調整役」の変数
ローカル学習は、エンドツーエンド訓練が与えていた調整の仕組みを壊す。
通常の訓練では、全体の勾配のおかげで、各層の更新が下流への影響まで織り込まれる。この信号がなくなると、各層は勝手に最適化を進める。下流の層のために出力を安定させる手段が、何もなくなる。
この節のポイント
- 層間ドリフトとは、ある層の重み更新によって、その層の出力が動くことだ。この量が、深い構成でローカル学習がうまくいくかどうかを左右する。
- 標準的なオプティマイザは、勾配の大きさで更新の大きさを決める。更新が実際に層の出力をどれだけ変えるかは見ていない。この2つは大きくずれうる。
- 「ドリフト契約」とは、各層が守るべき約束だ。1ステップあたりの出力の変化を抑え、下流の層に安定した入力分布を見せる。
ドリフト契約とは何か
ドリフト契約は、各層が守るべき暗黙の約束だ。各層は、1回の訓練ステップで出力表現が変わる量を抑える。これが守られていれば、下流の層は動く的を追わずに、適応を続けられる。
問題は、標準的なオプティマイザがこの約束を守らせないことだ。オプティマイザは勾配の大きさで更新の大きさを決める。ところが、勾配の大きさと出力の変化量は、同じものではない。
- ある層の大きな勾配が、出力にはわずかな変化しか生まないことがある。
- 別の層の小さな勾配が、出力に大きな変化を生むこともある。
下流の層にとって重要なのは、出力の変化のほうだ。この違いを無視するオプティマイザは、学習率を控えめにしていても、約束を破ってしまうことがある。
学習率がアーキテクチャをまたいで通用しない理由
このずれを考えると、ある構成でうまくいった学習率が別の構成で失敗する理由が説明できる。安全な歩幅は、少なくとも3つの要因で決まる。
- 深さ。 層が多いほど、ドリフトがネットワーク全体で積み重なる。
- 幅。 層の次元によって、同じ重み更新が出力の変化にどう変わるかが決まる。
- 勾配のスペクトル。 勾配のエネルギーがどの方向にどう散らばるかで、更新が層の写像をどれだけ大きく変えるかが決まる。
3つの要因が動く多くのアーキテクチャすべてに合う学習率は、見つかりにくそうだ。現場で見られる状況とも一致する。あるモデルで通用した設定が、別のモデルでは通用しないのだ。
スペクトルノルムという調整の手がかり
提案されている対処は、層ごとの出力の変化を直接抑えることだ。これはスペクトルの問題になる。重み更新の行列がもつ特異値は、その更新が層の入出力の対応をどこまで変えうるかを抑える。
特異値のうち最大のもの(スペクトルノルム)は、あらゆる入力方向のなかで最悪の場合の変化量を抑える。
オプティマイザがこれらの特異値を制御できれば、ドリフトも制御できる。
スペクトル更新はどうドリフト契約を守らせるのか
Muon 型のオプティマイザは、これを実現する仕組みになる。Muon はモーメンタムの行列を直交化し、できあがったステップの大きさを調整する。直交化すると、更新の特異値がほぼ同じ大きさにそろう。
その結果、生の勾配の大きさにも、勾配のエネルギーが方向ごとにどれだけ偏っているかにも、更新が左右されなくなる。
こうして、層の変換に与える影響があらかじめ制御された更新ができあがる。元の勾配がどれだけ大きくても偏っていても、1ステップで層の写像が変わる量は予測できる。
この性質は、ドリフト契約とそのまま対応する。
| ドリフト契約の要件 | スペクトル更新での対応 |
|---|---|
| 各層の出力の変化を1ステップごとに抑える | 更新のスペクトルノルムが、層の写像の最悪ケースの変化を抑える |
| ステップの大きさを勾配の大きさから切り離す | 直交化によって、更新から生の勾配の大きさが取り除かれる |
| 一部の方向だけが支配するのを防ぐ | 特異値がそろい、変化が複数の方向に分散される |
| 下流の入力を安定に保つ | 上流の変化が抑えられ、下流の入力分布が動く速さも抑えられる |
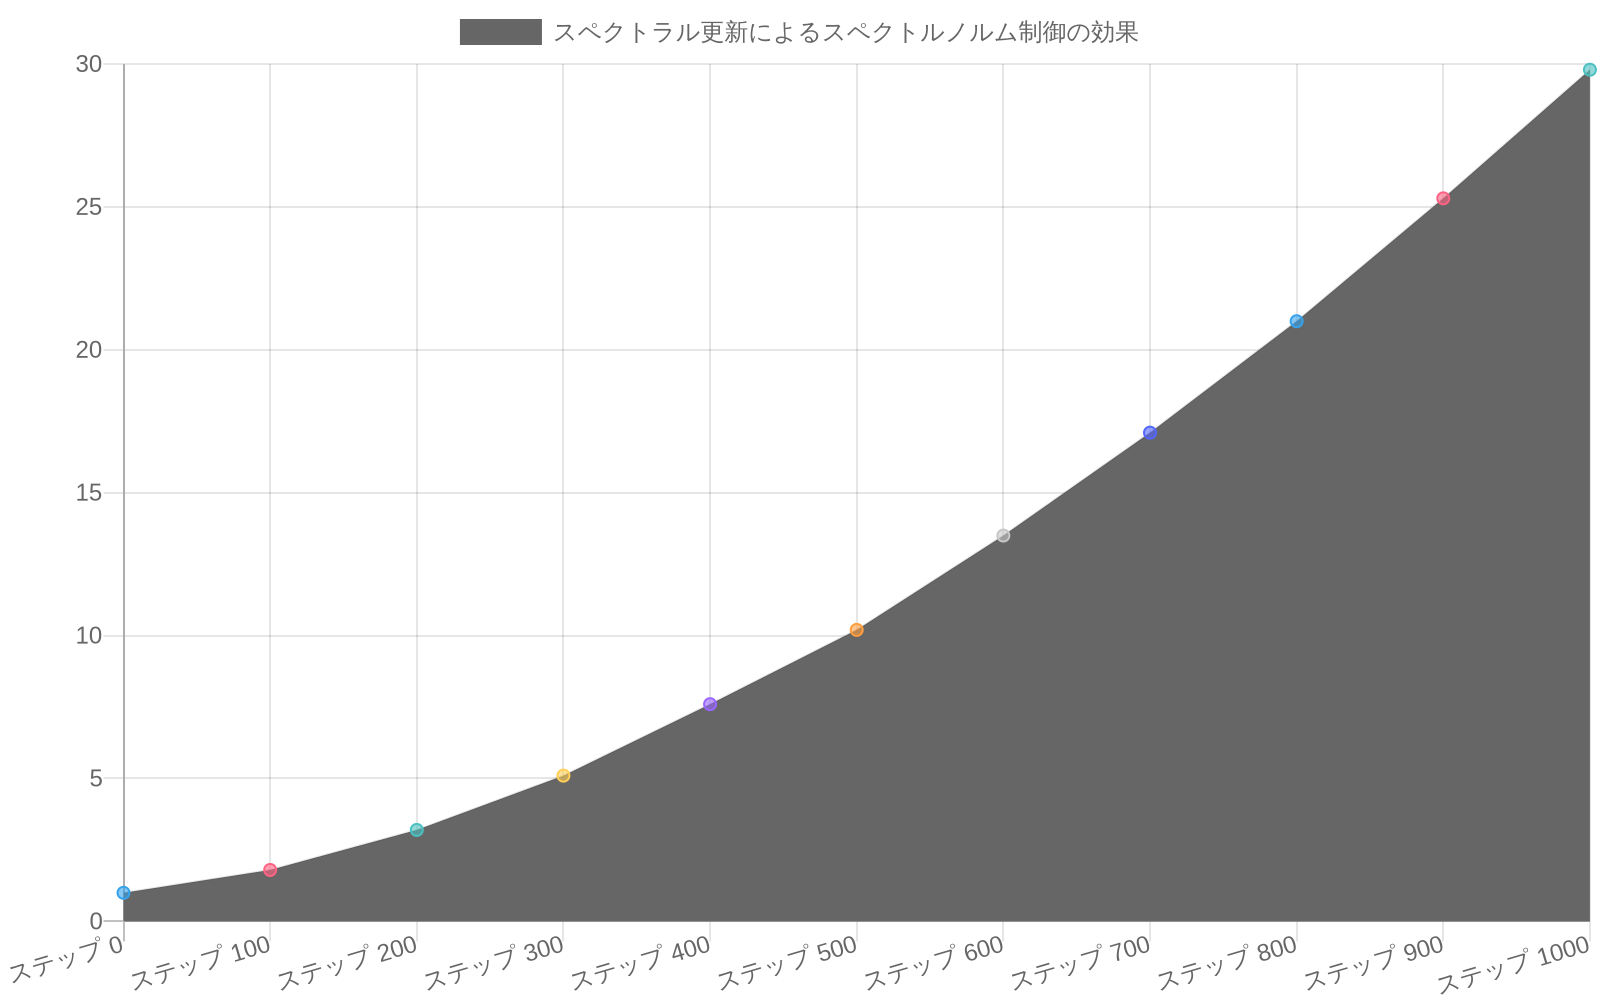
図9:スペクトラル更新によるスペクトルノルムの制御(出典:実験データ)
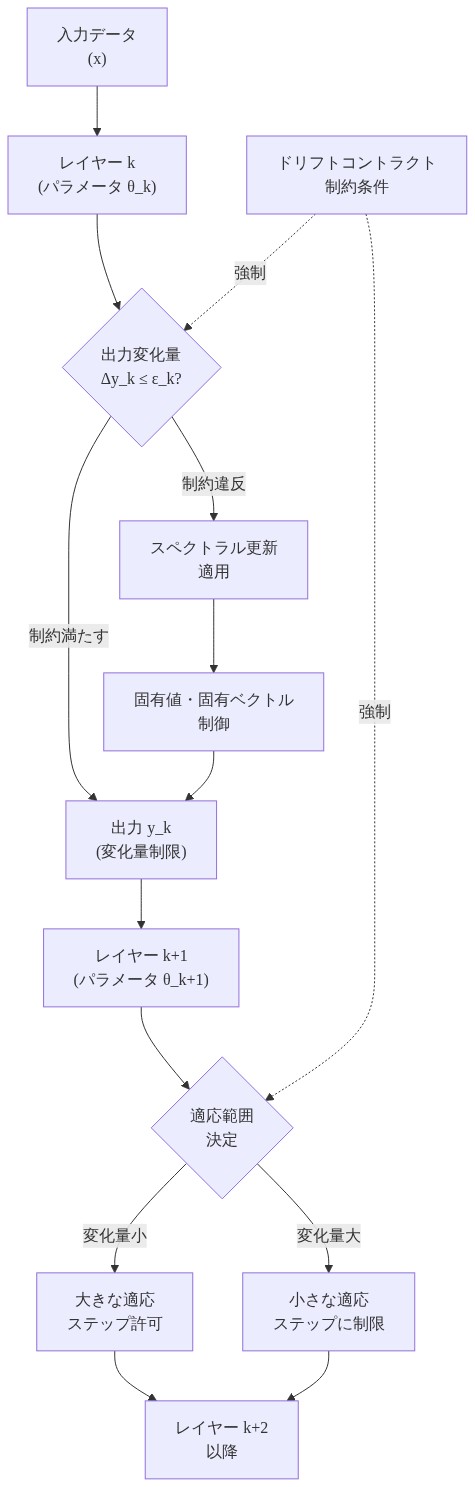
図8:ドリフトコントラクト - 各レイヤーの出力変化制限メカニズム
スペクトル制御とローカル学習を組み合わせる
スペクトル更新を、層ごとのローカルな目標と組み合わせる試みは、これまでの文献ではあまり掘り下げられていない。仕組みは簡単に言える。
スペクトルでステップを抑えれば、層ごとの出力の変化が抑えられる。これはまさに、ドリフト契約が求めていることだ。
筋道は次のとおりだ。すべての層で、出力の変化がスペクトル制御によって抑えられているとする。
すると、上流の層が最適化を続けていても、下流の各層に届く入力分布の動きはゆるやかで予測できる。多くの層をまたいでドリフトが積み重なることはありうる。
しかし、その速さは歯止めなく増えるのではなく、抑えられた範囲に収まる。契約が守られるわけだ。
表現の制御と更新の制御は補い合う
この方向は、深層学習でスペクトルの幾何学を使う、より大きな流れに沿っている。スペクトル制御には、2つの対象を区別して考えると分かりやすい。
- 表現側のスペクトル制御。 表現がどんな形をしているかを制約する(例:世界モデルで、潜在表現のスペクトルを整える)。
- 更新側のスペクトル制御。 訓練中に表現がどう変わってよいかを制約する。
この2つは、対立せず補い合う。表現の構造が整っていても、訓練中のドリフトが速すぎることはありうる。
逆に、更新が安定していても、たどり着く表現の構造が悪いこともありうる。深さに強い訓練には、両方の制御が必要かもしれない。この主張を確かめるには、両者を合わせた実験が要る。
深さへの強さとハイパーパラメータの持ち越しを確かめる
ドリフト契約の見方からは、具体的な予測が出てくる。ここが最大の強みだ。
裏づけとなる証拠は2種類ある。深さへの強さと、ハイパーパラメータの持ち越しだ。
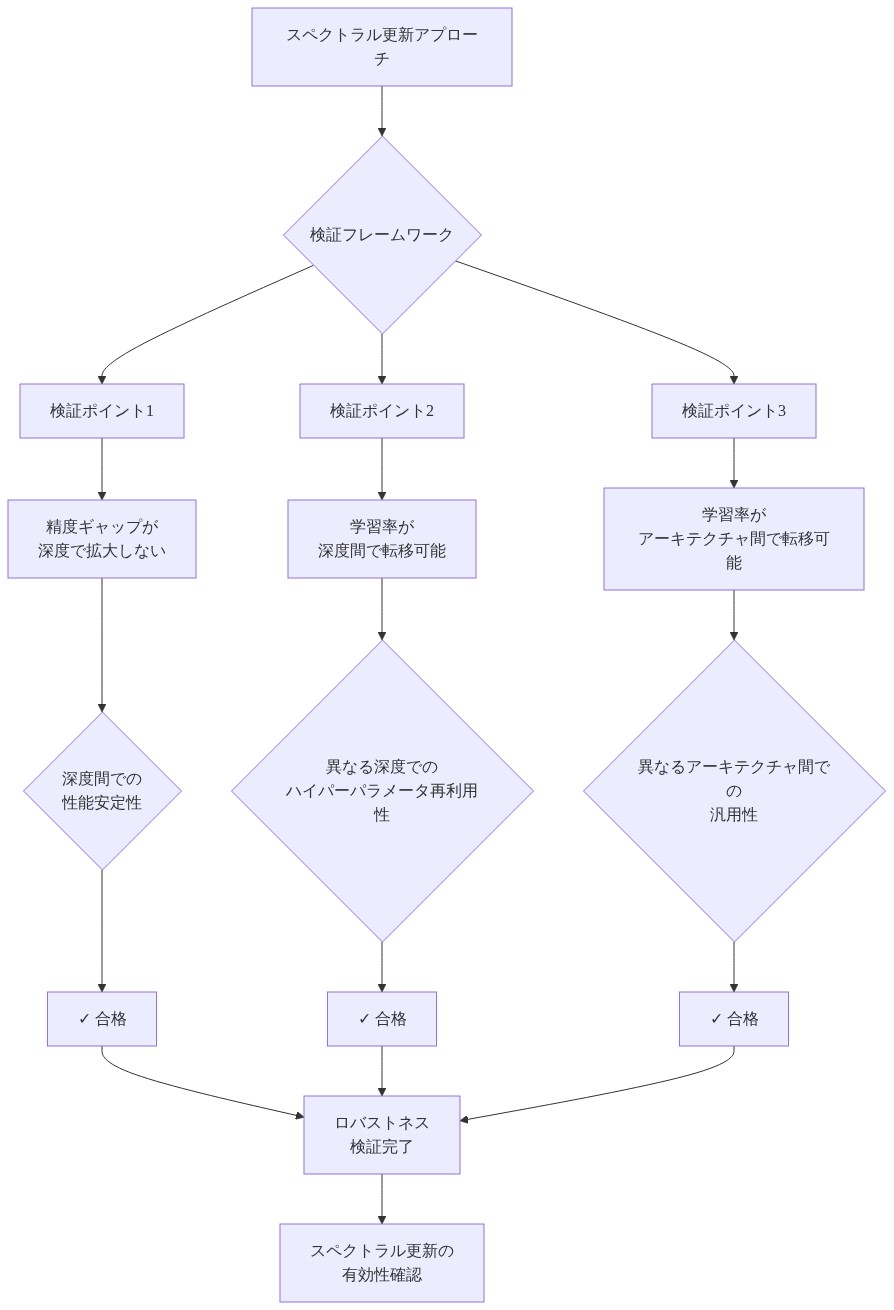
図13:スペクトラル更新の検証フレームワーク
深さへの強さ
見るべき兆候は、層を増やしても、ローカル学習とエンドツーエンド訓練の精度差が安定しているかどうかだ。精度の絶対値が横ばいでも、課題がどの深さでも易しいだけかもしれない。
精度差が安定していれば、ネットワークが大きくなってもバックプロパゲーションに遅れずについていけている可能性が高い。
手法が深い構成でなぜ成功し、なぜ失敗するのかは、いくつかの診断で見えてくる。
| 診断 | 測るもの | 読み方 |
|---|---|---|
| 訓練ステップごとの、層ごとの表現の変化 | 1回の更新で各層の出力がどれだけ動くか | 変化が抑えられて安定していれば契約を支持する。深い層で変化が増えていくなら、契約が崩れている疑いがある |
| 更新の特異値の散らばり | 更新が変化を方向ごとにどれだけ均等に配るか | 散らばりが小さければ、スペクトル制御が効いている。大きければ、一部の方向が支配している |
| 深さに応じた失敗の形 | 精度がじわじわ落ちるのか、急に崩れるのか | じわじわ落ちるなら、ドリフトの積み重なりを示す。急に崩れるなら、補助的な損失のずれを示す |
とくに役立つのは、失敗の形だ。深さに伴う性能低下の原因として考えられる2つを、見分けられる。
スペクトル更新が減らすのは、ドリフトが引き起こす、じわじわとした劣化のはずだ。補助的な目標が間違った方向を向いているために起きる急な崩れには、ほとんど効かないはずだ。
交絡要因を除く
注意すべき交絡要因が1つある。得られた改善が、スペクトル制御そのものではなく、正規化された更新ならどれでも得られる暗黙の正則化から来ているかもしれない。
正規化の方式の多くは、一般的な形で訓練を安定させる。
アブレーション(要素を1つずつ外す比較実験)で、この効果を切り分けられる。次の4つの条件を比べる。
- 標準のオプティマイザ、正規化なし。 基準になる条件だ。
- 勾配クリッピング。 更新の大きさは揃えるが、モーメンタムは直交化しない。
- ほかのノルムによるスケーリング。 更新を拡大縮小するが、特異値はそろえない。
- 完全なスペクトル更新。 直交化したモーメンタムに、スペクトルノルムによるスケーリングを加える。
深い構成で、完全なスペクトル更新がクリッピングや単純な正規化を上回れば、スペクトル制御は独自の役割を果たしている。クリッピングが同じ成績を出すなら、利点は一般的な正則化によるものである可能性が高い。
ハイパーパラメータの持ち越し
持ち越しは、最も説得力のある検証になりうる。実用上も、最も重要な利点かもしれない。
筋道は単純だ。スペクトルのスケーリングによって、実効的なステップの大きさが勾配の大きさと無関係になるなら、学習率はネットワークの深さや層の幅、層ごとの損失の設計をまたいで使い回せるはずだ。
この予測は検証でき、間違いも示せる。ある深さと幅で学習率を調整し、それを変えずにほかの構成に当てはめる。性能が保たれれば、主張は支持される。
最適な学習率が深さに応じて大きく変わるなら、スペクトル制御は、ドリフト契約が予測した深さへの依存を取り除けていない。
持ち越しが重要なのは、調整のコストが、ローカル学習の利点を目立たないところで損なってきたからだ。この方式では、アーキテクチャごとにハイパーパラメータを探す必要があった。そのせいで、資源面での利点が、最も効くはずの場面で削られる。
1ステップは安くても、調整が高くつく方法は、本当に効率的とは言えない。効率は、探索の手間まで含めて、全体で測るべきだ。1
スペクトル更新で調整の手間が減れば、ローカル学習を使う実用的な理由はぐっと強まる。
よい学習率を見つける作業は、構成ごとに繰り返すコストではなくなる。多くのアーキテクチャとデータセットで共有できる、1回きりのコストになる。
局所性の限界と、これからの課題
層ごとの更新がよくなれば、並列でメモリの軽い訓練はより現実味を帯びる。ただし、障害がすべてなくなるわけではない。局所性には、いまも上限がある。
中心的な限界は、目標の食い違いだ。各層は補助的な目標を最適化するが、その目標が最終課題と合っているとは限らない。
ある層が契約を完璧に守りながら、ネットワークの本来の目的に役立たない特徴を学んでしまうことはありうる。スペクトルの手法では、全体での貢献度の割り当ての代わりにはならない。
このため、精度差の原因は2つに分けて考えられる。
| 精度差の原因 | スペクトル更新は役に立つか | 代わりに必要なもの |
|---|---|---|
| 層間ドリフト | 役に立つ。層ごとの出力の変化を抑えられる | スペクトルによるステップの制御 |
| 目標の食い違い | ほとんど、またはまったく役に立たない | より強い、またはより整合した補助的な損失 |
残る問いは、その境目がどこにあるかだ。
ローカル学習が深さで苦しむ原因のうち、どれだけがドリフトによるもので、どれだけが目標の食い違いによるものか。その答えによって、スペクトル更新がローカル学習を競争力のある方法にできるのか、少し壊れにくくするだけなのかが決まる。
局所的に最適化された部品でできたシステムには、どれにも当てはまる原則がある。
全体がまとまりを保てるのは、各部品の局所的な振る舞いが、システムを同じ向きにそろえておけるほど律されているときだけだ。 ドリフト契約は、その律し方の1つの形を与える。
ただし、各部品の局所的な目標が全体の目標に役立つことまでは、保証しない。
これらの考えを検証する研究者にとって、全体像を最も明らかにしてくれるのは、次の5つのステップだ。
- まずクリッピングとのアブレーションを行う。 深さを変えながら、スペクトル更新を勾配クリッピングや単純な正規化と比べる。スペクトル制御の効果と、一般的な正則化の効果を切り分けられる。
- 学習率の持ち越しを直接検証する。 ある深さと幅で調整し、同じ設定をほかの構成で使う。最適な学習率が安定しているかどうかを報告する。
- 最終精度だけでなく、失敗の形を追う。 層ごとの表現の変化を記録し、深いネットワークの失敗がじわじわか急かを見る。損失の原因が、ドリフトか食い違いかを判断しやすくなる。
- スペクトル更新と、より強い補助的な損失を組み合わせる。 スペクトル制御が狙うのはドリフトだ。よりよく整合した目標と合わせることで、2つの対処が足し合わさるかを確かめられる。
- 実際の実行時間での利益を測る。 順伝播型だけでなく、そうでないアーキテクチャでも、並列実行による実際の高速化とメモリ節約を、調整のコストも含めて報告する。
ドリフト契約は、ローカル学習の深さの問題を、損失設計の失敗ではなく、調整の失敗として捉え直す。スペクトル更新は、その契約を守らせる具体的な手段になる。
それで十分かどうかは、深さへの強さを示す曲線と、ハイパーパラメータの持ち越しの結果が教えてくれる。
ちょっと立ち止まって
深層学習の進歩の多くは、何を制御すればよいかを見つけることから生まれてきた。ここで示された提案は、勾配の大きさを見るのをやめ、各層の出力が実際にどれだけ動くかを見ようというものだ。
あなたが関わるシステムを思い浮かべてみてほしい。モデルでも、チームでも、コードベースでもよい。各部分が局所的に最適化を進めるなか、全体がずれていっている場所はないだろうか。
そんなとき、各部分によりよい目標を与えるだけでは足りないのかもしれない。各部分が変わる速さに、はっきりした上限を設けることが、効く場合もある。
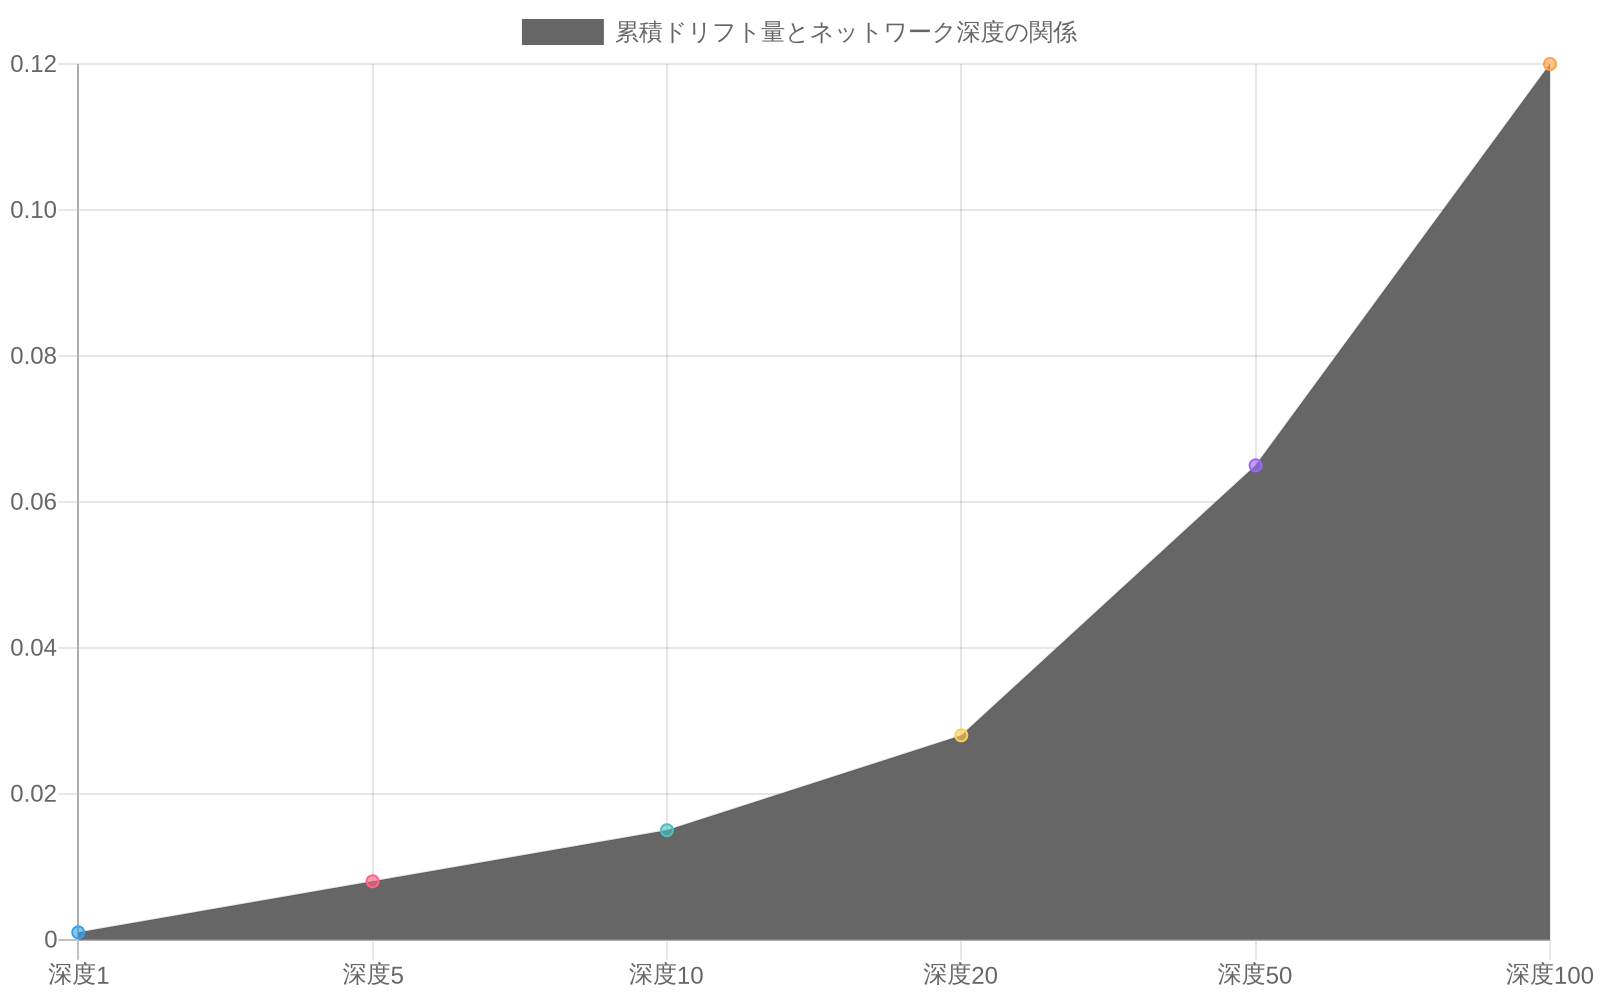
図6:累積ドリフト量と深度の関係 - ステップサイズの深度依存性(出典:実験データ)
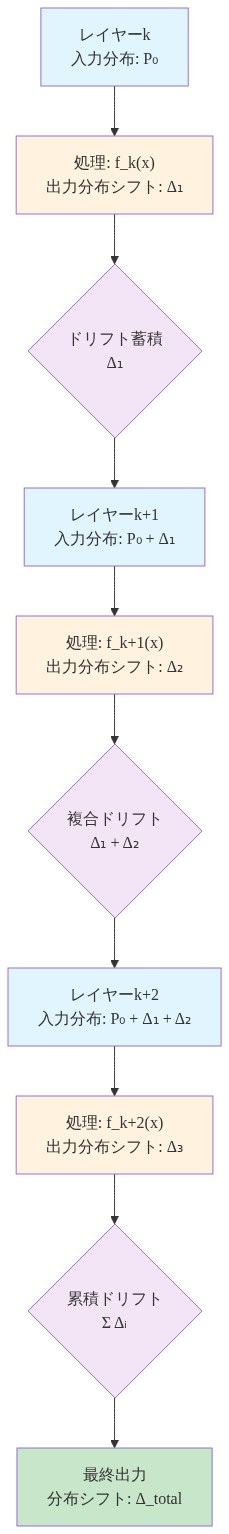
図5:ドリフトの累積メカニズム - 深いネットワークでの複合効果
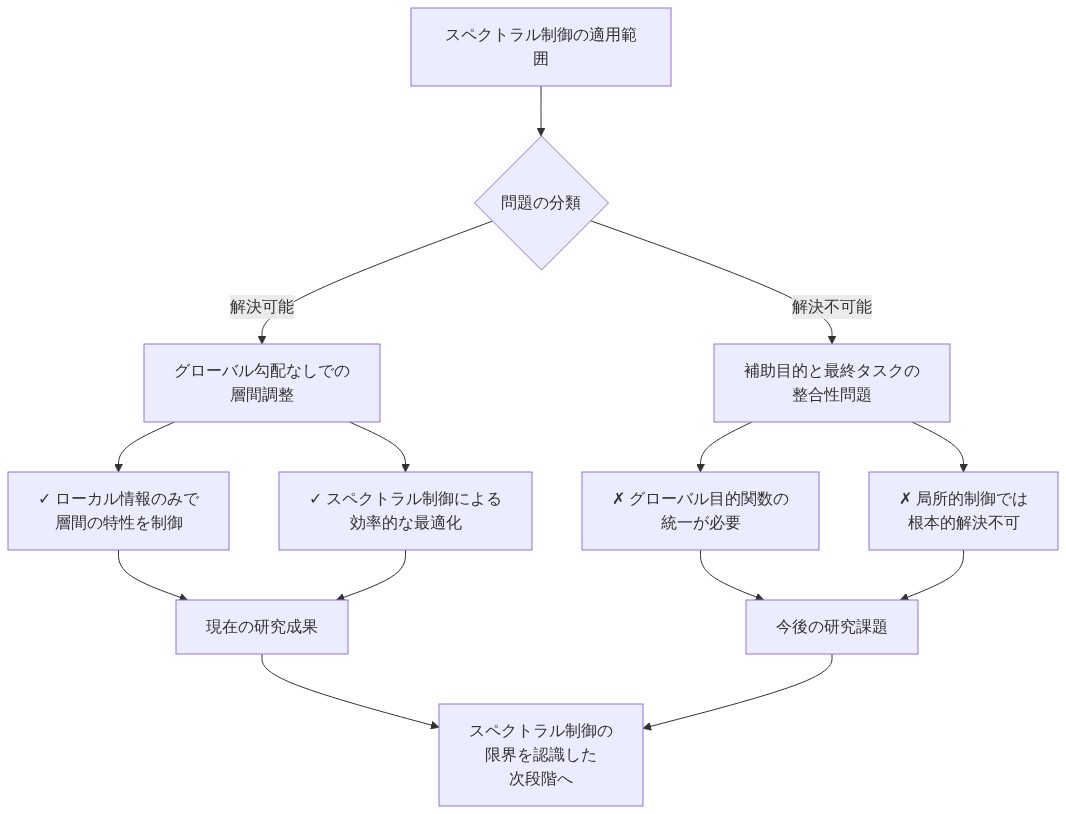
図15:スペクトラル制御の適用範囲と限界