検索ボックスに、次に試せる検索候補が5つ並んでいる。どれも的外れではなく、言い回しも自然だ。
ところが5つとも、同じことを言葉だけ変えて聞いている。別のことを知りたかった人は、クリックしたくなる候補を見つけられない。
これは、検索候補の「まとまり」で起きる問題だ。システムは、たいてい候補を1つずつ採点される。
けれども、ユーザーが目にするのは候補のまとまり全体である。ここで紹介する枠組みは、そのまとまりを評価の単位にする。
まず、ユーザーの意図を軸に候補を作る。次に、学習を2段階に分ける。そのうえで、ログから得た反応を1つ1つの候補に割り振り直す。
この記事のポイント
- 1つ1つは優れた候補でも、すべてが同じ意図を狙っていると、全体としては役に立たない。
- 生成モデルは、いちばん多い意図に寄っていきやすい。検索の時代に使われた多様化の手法は、自由に文を作る生成にはそのまま使えない。
- この枠組みは、まず考えられる意図を推定する。次に、意図ごとに1つずつ候補を作る。こうすると、カバー範囲を測って学習に使える。
- 学習は2段階で進む。1段階目は意図のカバー範囲を、2段階目は候補ごとの有用さをねらう。
- クリックのログは、候補のまとまり全体の反応を表す。これを候補ごとの信号にするには、表示位置の偏りを補正し、各候補の追加的な貢献を推定する必要がある。
- 評価では、カバー範囲と候補ごとの質を分けて報告したい。混ぜると、片方の改善をもう片方の改善と取り違えやすい。
良い候補の集まりは、良い候補を集めただけではない
検索候補の仕組みは、ふつう候補1つずつの信号で評価される。
- 関連性:入力した内容と候補が関係しているか。
- クリック率:どれくらいの頻度で選ばれるか。
- 滞在時間:選んだあとも読み続けているか。
どれも役に立つ指標だが、見落としている点が共通している。候補を1つずつ切り離して見ているのだ。ユーザーが実際に目にするのは、限られた場所で注目を競う、数個の候補のまとまりである。
このまとまりの価値は、候補どうしの関係で決まる。同じ意図を言い換えただけの優れた候補が5つ並んでも、ユーザーに見える選択肢は実質1つだけだ。
関連する別の作業がしたい人や、もっと絞った質問をしたい人、あいまいな言葉を別の意味で使った人は、置き去りになる。
生成モデルで問題が悪化する理由
いまの検索候補の仕組みでは、生成モデルを使うことが増えている。モデルがまとまりを作る方法は2通りあり、どちらも同じ結果に流れていく。
| 生成の方法 | 仕組み | よくある失敗 |
|---|---|---|
| 自己回帰的なデコード | 候補を1本の系列として順に作る | 最初の候補が決めた中心的な意図から、後の候補が離れない |
| 独立したサンプリング | 同じ分布から、候補を1つずつ別々に引く | いちばん多い意図の、確率が高い言い回しが何度も出てくる |
どちらの場合も、出力は「最頻の意図」に引き寄せられる。最頻の意図とは、ユーザーの要求に対していちばん可能性が高い読み方のことだ。
1回の検索候補としては、それで妥当なことも多い。けれども、まとまり全体で見ると、枠がむだになる。
検索の時代には、決まった対処法があった。
最大限界関連性(MMR)は、候補の集まりをあらかじめ用意しておき、関連性と、すでに選んだ候補との似かたのバランスを見て並べ替える。この方法は、選ぶ元になる候補の集まりがあることが前提だ。
自由に文を作る生成には、その集まりがない。モデルが候補そのものを作るので、多様さは作り方の中に組み込まなければならない。
根っこにある食い違い
難しさは、次の食い違いに行き着く。
- 関連性は、候補1つ1つの性質だ。
- カバー範囲は、候補の集まりの性質だ。
片方を最適化しても、もう片方は最適化されない。候補ごとの関連性だけで学習したモデルには、意図を散らす理由がない。逆に、多様さだけを押しつけると、誰も求めていない候補で枠が埋まるかもしれない。
フィードバックの問題
利用データには、さらに別の厄介な点がある。反応が観察されるのは、候補のまとまり全体に対してだ。
ユーザーが候補の1つをクリックすると、ログにはそのクリックが残る。けれども、理由までは残らない。
いちばん上の候補を選んだのは、それが最良だったからだろうか。それとも、最初に目に入ったからだろうか。残りの4つは、選択肢を見せることで何か貢献していたのだろうか。
ログだけでは分からない。このあいまいさが、クレジット割り当て(貢献の割り振り)の問題だ。この枠組みの設計の多くは、この問題から決まっている。
意図を最適化の単位にする
多くの検索候補の仕組みは、いろいろな検索語を作ろうとして、その多様さがユーザーのさまざまな要求に自然に広がると期待している。この枠組みはその逆をいく。
まずユーザーが本当に何を求めているかを見きわめ、その要求のまわりに多様さを組み立てる。
この節のポイント
- 現在の検索語と一連の検索の流れから、ありそうなユーザーの意図を推定する。候補は、意図ごとに1つずつ割り当てる。
- 意図を明示すると、カバー範囲を測れる。うまくいかないときも、原因を調べやすい。
- 引き換えに、システムが提案できるのは、知っている意図だけになる。意図が欠けていたら、後の段階で取り戻せない。
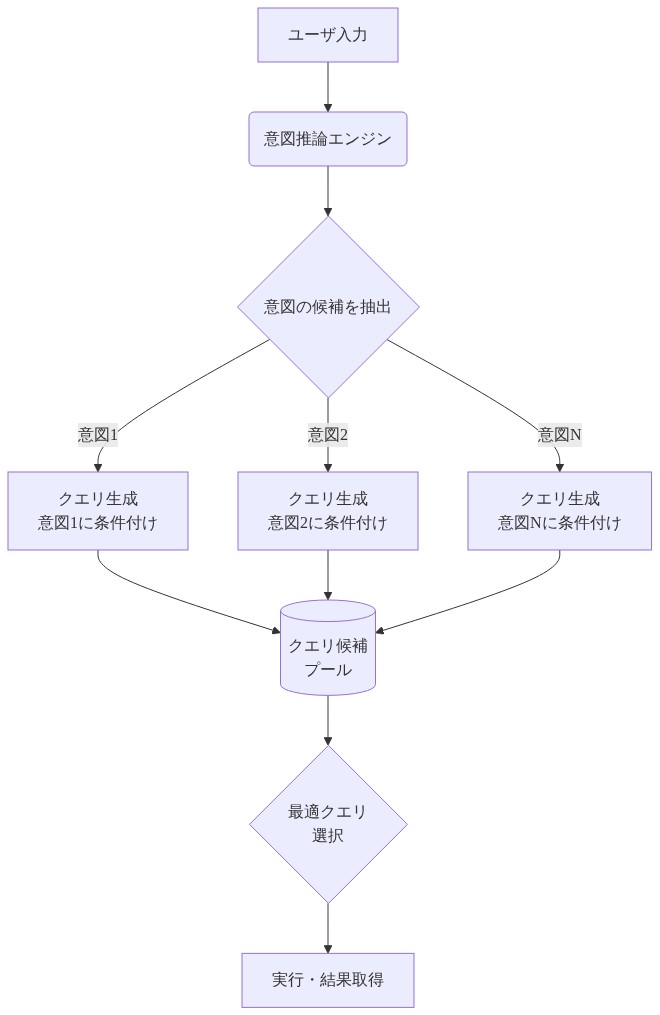
図4:意図ベースのクエリ生成フロー
枠組みの流れ
処理は3つのステップで進む。
- 意図を推定する。 現在の検索語と一連の流れをもとに、ユーザーが持ちそうな別々の要求をモデルが見積もる。
- 意図を枠に割り当てる。 候補リストの各位置に、推定した別々の意図を1つずつ当てる。
- 意図を条件にして検索語を作る。 割り当てられた意図を明示的な条件として、候補を1つずつ作る。
結果として、候補のまとまりは、偶然ではなく設計によって、それぞれ別の要求を狙うことになる。
意図を明示することの意味
意図を明示すると、測れる目標ができる。
候補がそれぞれ既知の意図に対応していれば、まとまりがいくつの別々の意図をカバーしているか数えられる。測れるものは、学習の信号になる。
構造が見えると、失敗の原因もたどりやすい。候補のまとまりが期待外れだったとき、次のように問える。
- 必要な意図が、推定した意図の集まりに入っていなかったのか。
- 意図はあったのに、弱い検索語と組み合わさったのか。
- 2つの枠が、同じ意図を取り合ってしまったのか。
それぞれの答えは、直すべき部分を具体的に指し示す。システム全体を手探りで疑う必要はなくなる。
意図を明示するコスト
この設計には、現実的な制約がある。
- 意図の抜け。 推定できる意図の集まりが、ロングテール(まれだが確かにある要求)を取りこぼすと、後の最適化では拾えない。意図の一覧がボトルネックになる。
- 粒度の調整。 意図は、粗すぎることも細かすぎることもある。粗い意図では、別々の要求が1つにまとまってしまい、同じ区分の中で多様さが失われる。細かい意図では、学習の信号が多くの小さな区分に分かれ、各区分のデータが少なくなる。
ちょうどよい粒度は、実験で見つけるしかない。分野によっても、検索語のあいまいさの度合いによっても、変わりそうだ。
明示的な多様さと暗黙の多様さ
別のやり方もある。意図に名前をつけず、多様さが自然に出てくるのを待つ方法だ。サンプリングの温度を上げたり、似た出力に罰則をつけたりして、モデルが別々の要求に散らばってくれることを期待する。
| 観点 | 意図を明示して条件にする | 暗黙の多様性圧力 |
|---|---|---|
| 準備のコスト | 意図のモデルか一覧が必要 | なし |
| カバー範囲 | モデルがめざして学習する制約 | 出てきてほしい結果 |
| 測りやすさ | 直接測れる(カバーした意図を数える) | 間接的(似ている度合いの代わりの指標) |
| 原因の調べやすさ | 特定の部品までたどれる | 場所を絞りにくい |
| ロングテールのリスク | 意図の一覧に左右される | サンプリングの挙動に左右される |
暗黙の方法は、意図の一覧という問題を避けられる。その代わり、中身が見えにくくなる。表面的なバリエーションと、意図のバリエーションは、同じではない。
言い回しが違っても、同じ要求に応えているだけの検索語は作れる。意図を明示すると、その違いが見えるようになる。
2段階の学習
この枠組みは、学習を2つの段階に分け、それぞれに別の目標を置く。
1段階目では、推定した別々の意図に候補が散らばるよう、方策(ポリシー)を整える。2段階目では、割り当てられた意図の範囲で、個々の検索語をできるだけ役に立つものに磨く。
この節のポイント
- 2段階に分けると、カバー範囲と候補ごとの質が、気づかないうちに引き換えになることを防げる。
- 順番に学習すると、別々の最適化の圧力が互いに混ざらない。
- 2段階目が1段階目の成果を打ち消すおそれがある。反応の信号を慎重に読み解く必要がある。
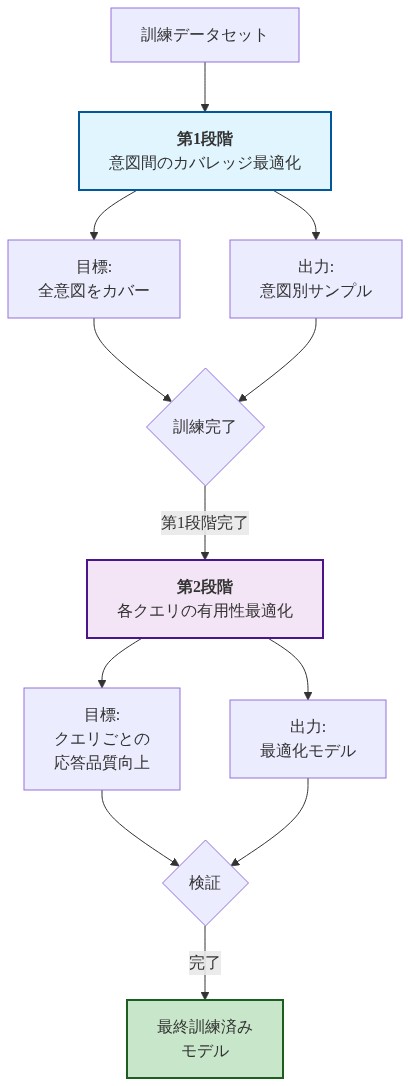
図5:2段階の訓練プロセス
2つの目標を1つの報酬にまとめないのはなぜか
カバー範囲と候補ごとの有用さを混ぜた1つの報酬のほうが、単純に見える。けれども、2つの目標は逆向きに引き合う。
多くの意図をカバーするには、個別の魅力が低い候補を入れなければならないことが多い。個別の魅力を最大にすると、たいてい最も多い意図、つまり大多数のユーザーが聞く内容に寄っていく。
2つの圧力を1つの数字に畳み込むと、モデルは片方をもう片方と引き換えにできてしまう。しかも、その様子は見えにくい。
報酬が上がっても、カバー範囲が良くなったのか、検索語が良くなったのか、両者のあいだで移動が起きただけなのか分からない。
ユーザーにも開発者にも、得にならないことがある。順番に学習すれば、この圧力を分けておける。各段階の目標がはっきりしているので、学習は安定しやすく、何が変わったのかも読み取りやすい。
機械学習の設計に共通するパターン
この分け方は、もっと広い原則の表れだ。レベルの違う信号どうしが、互いを押しつぶさないようにする。グローバルな文脈を持つタスク別プロンプトによるマルチタスクのグラフ事前学習も、似た考え方に立っている。
タスク固有の信号が、グローバルな文脈に埋もれないよう守られている。ここでは、候補のまとまり全体にかかる圧力と、検索語1つにかかる圧力が、互いに混ざらないよう分けてある。
原則は同じだ。2つのことを同時に最適化すると、分けておかない限り、片方がもう片方をかき消しやすい。
2段階目が1段階目を打ち消すリスク
順番に学習する方式には、よく知られた弱点がある。2段階目が、1段階目の成果を打ち消すことがあるのだ。
2段階目で反応ばかりを最適化すると、検索語が少しずつ最頻の意図に戻っていく。すると、1段階目で得たカバー範囲が削られる。
信号を丁寧に設計すれば、このリスクは減らせる。
- 1段階目は、意図のラベルとカバー範囲の指標を使い、推定した意図に候補を散らす。
- 2段階目は、ログに残った反応を使う。その際、各検索語に割り当てられた意図との関係で読み解き、個々の候補を磨く。
どちらの信号も、きれいではない。意図のラベルはモデルが推定したもので、その誤りを引きずるかもしれない。反応のログには、表示位置の影響や選択バイアスが入る。
ユーザーは、表示されたものを、表示された場所でしかクリックできないからだ。2つの段階が逆らわずに協力するには、どちらの信号も慎重に扱う必要がある。
個々の検索語に貢献を割り当てる
候補のまとまりに対する反応がある。クリックされたか、どれくらい読まれたか、会話が続いたか。これらは、まとまり全体についての信号であり、1つ1つの検索語についての信号ではない。
2段階目の学習では、どの検索語がその反応を生んだのかを知る必要がある。まとまり全体の信号を、検索語ごとの貢献に変える、この変換のところで、情報は失われやすい。
この節のポイント
- 表示位置の偏りと、反事実(別の候補を見せていたらどうなったか)の欠落のせいで、単純な貢献の割り当ては信頼できない。
- 限界貢献の手法は、その検索語を取り除いたらまとまり全体の価値がどう変わるかを問い、各検索語の固有の役割を推定する。
- このやり方では、多様さが別個の罰則にならず、学習の信号そのものに結びつく。
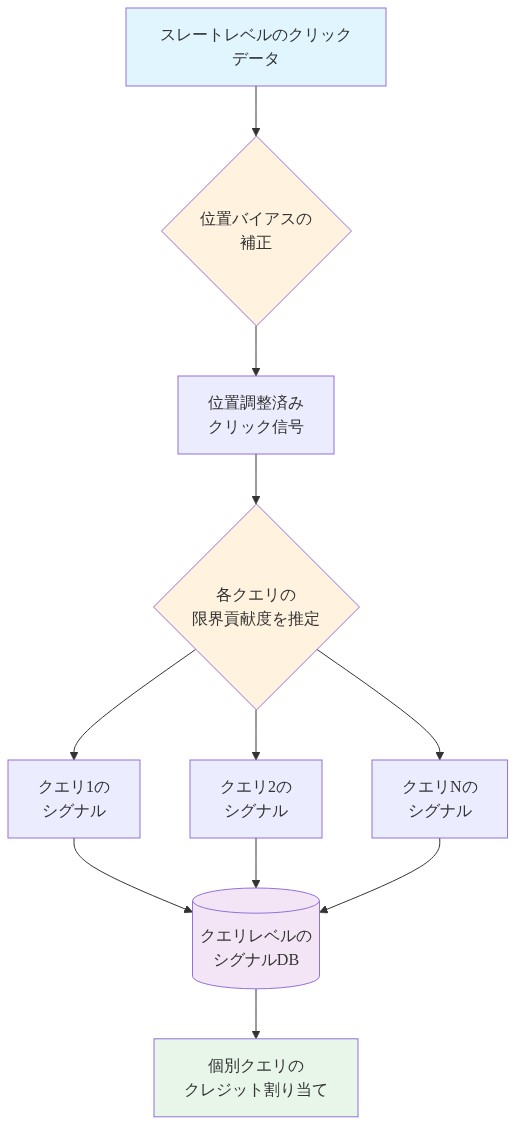
図7:スレートレベルのクリックからクエリレベルのシグナルへの変換プロセス
割り当てが難しい理由
単純な方法は、2つの問題でつまずく。
- 表示位置の偏り。 まとまりの上のほうにある候補は、質に関係なくクリックされやすい。同じ検索語でも、1番目にあるときは、5番目にあるときより良く見える。
- 反事実の欠落。 大事なのは、まとまりに別の候補が並んでいても、クリックされた検索語が選ばれたかどうかだ。ログに残るのは、実際に起きたことだけで、代わりに何が起きたかには答えられない。
クリックされた検索語すべてに満点を与え、それ以外にはゼロを与えると、質と同じくらい表示位置を報いることになる。
クリックされなかった候補が、まとまり全体の価値にどう貢献したか(あるいは貢献しなかったか)も無視される。
手法の幅
検索語ごとの貢献を割り当てる手法は、段階的に並べられる。
| 手法 | 基本の考え方 | 扱える問題 |
|---|---|---|
| 位置の偏りを補正したクリックモデル | 各位置をユーザーが見た確率を推定し、「見られたこと」と「魅力」を分ける | 表示位置の偏り |
| 限界貢献の推定 | ある検索語を取り除いたら、まとまりの価値がどう変わるかを見積もる | 重複と、各検索語の固有の役割 |
限界貢献がカバー範囲に効く理由
限界貢献にもとづく割り当ては、同時に2つのことをする。
- まとまりの残りでは得られなかったはずの反応を生んだ検索語には、報酬を与える。
- 重複した検索語には、罰を与える。ある検索語を取り除いても、まとまりの価値がほとんど変わらないなら、その限界貢献はほぼゼロで、割り当てられる貢献もほぼゼロになる。
これで、カバー範囲が学習の信号に入る形が変わる。多様さは、目的関数に外から足される罰則ではなくなる。貢献の割り当てそのものから、自然に出てくる。
別の検索語と同じ意図を重ねる検索語は、ほとんど貢献を得られない。まとまりにとって、それは必要なかったからだ。カバー範囲は、手で調整する重みではなく、学習された原理的な土台を持つことになる。
この信号の強さは、ログからまとまりの価値をどれだけうまく見積もれるかにかかっている。
ログが少ない場合や、表示位置で大きく偏っている場合、限界貢献の推定にはノイズが混ざる。利点が生きるのは、その推定が信頼できる範囲に限られる。
カバー範囲を関連性と分けて測る
意図を軸にしたまとまりを進歩させるには、カバー範囲と関連性を分けた評価が要る。いまのやり方では、両者を1つの反応スコアや品質スコアにまとめることが多い。
すると、改善の理由が、多様さの向上なのか、個々の検索語の向上なのか、その両方なのか、見分けにくい。
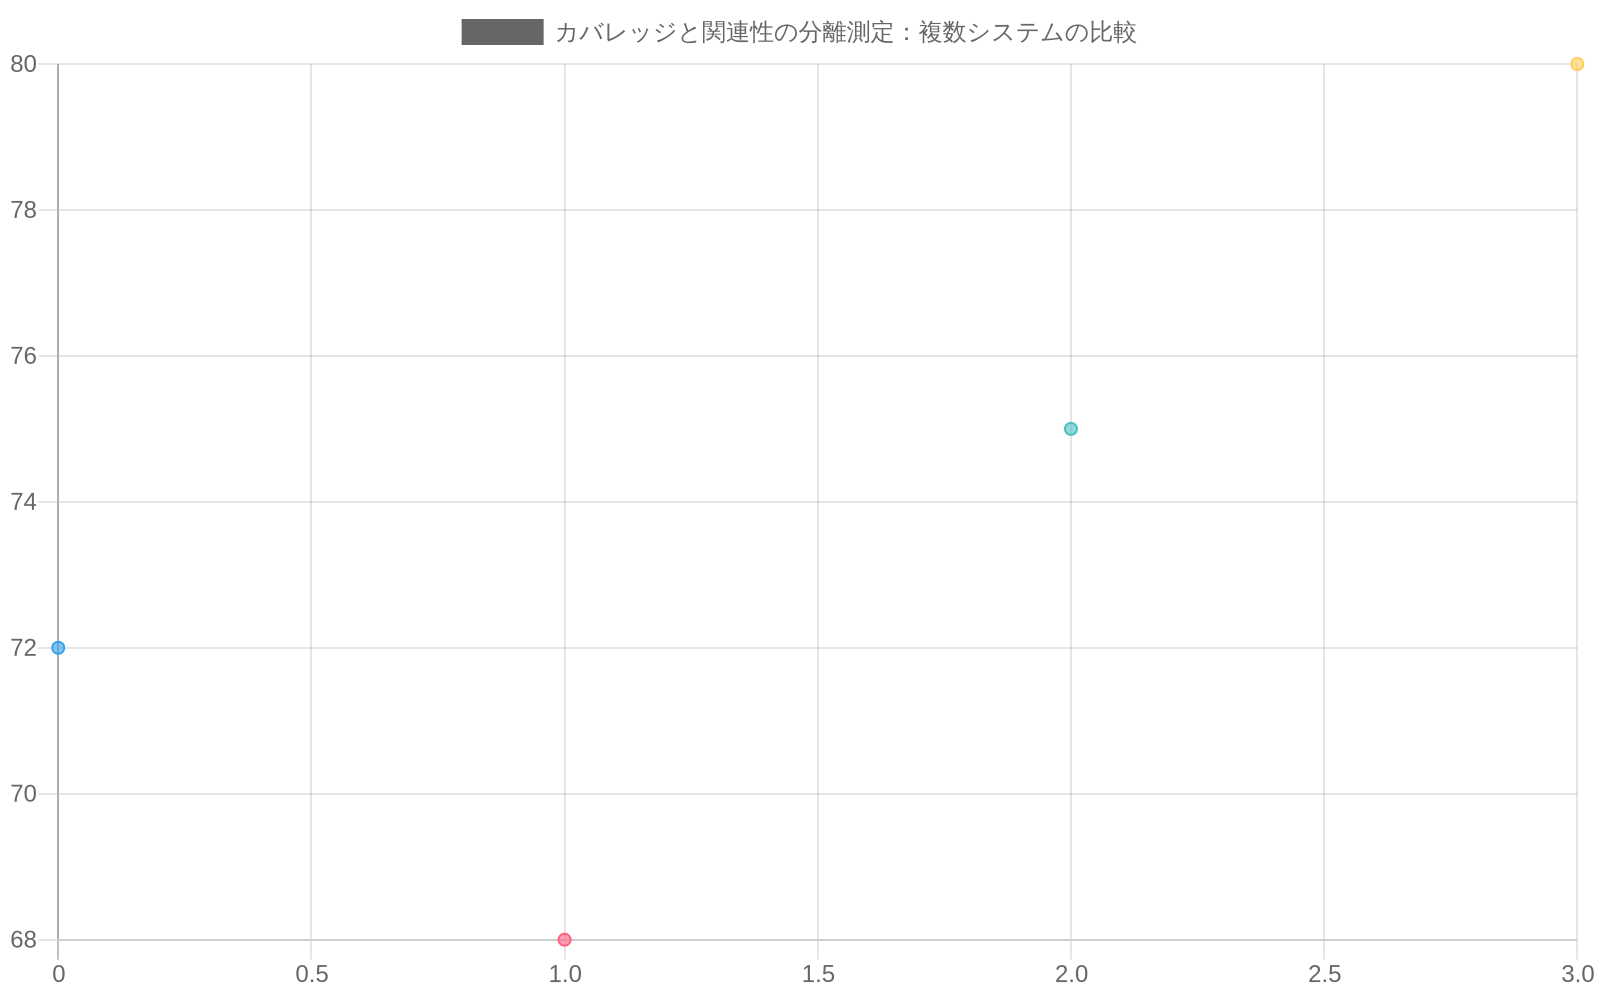
図9:カバレッジと関連性の分離測定 - 複数システムの比較
カバー範囲の測定に含まれること
カバー範囲の評価には、ふつう次の3つのステップがある。
- 意図の対応づけ。 各候補を、注釈をつけた意図の集まり、またはモデルが推定した意図に対応づける。
- まとまりの中の重複。 同じ意図を共有する候補がいくつあるか、まとまりがいくつの別々の意図をカバーしているかを数える。
- 独立性の確認。 学習と評価で同じ意図のモデルを使っていることによる、見かけ上の改善ではないことを確かめる。
3つ目のステップは、つい省かれやすい。1つの意図モデルが学習の目標と評価の指標の両方を決めていると、システムはそのモデルと一致するだけで高得点を取れる。
ユーザーがより良く役立てられているかどうかは、別の話だ。独立した注釈をつけるか、少なくとも評価用に別の意図モデルを使えば、このリスクは減る。
能力を切り分ける
ここでの教訓は、検索候補に限らず当てはまる。
AhaBenchのようなベンチマークは、全体の成功率に頼らず、特定の能力だけを切り出して測る。この切り分けによって、手法が実際に何をしているかが分かる。意図のカバー範囲にも、同じ扱いが役に立つ。
報告のチェックリスト
- カバー範囲と候補ごとの質を、並べて報告する。 1つの数字にまとめない。
- 検索語のあいまいさで層に分ける。 カバー範囲が重要なのは、読み方がいくつもあるあいまいな検索語だ。あいまいでない検索語では、ほとんど効かない。両方を平均すると、手法が効いている場所が隠れてしまう。
- まとまりの大きさと遅延の予算をそろえる。 まとまりが大きければ、多くの意図を楽にカバーできる。遅いシステムは、より多くの計算をかけられる。この2つをそろえて比べて初めて、公平な比較になる。
この切り分けがないと、ある種の改善を別の種類の改善と取り違えやすい。そして、間違った理由で変更を出荷してしまうことになる。
ちょっと立ち止まって
検索候補が「良い」とは、どういうことだろう。つい、候補が1つ1つ的を射ているかどうかで考えてしまわないだろうか。
ところが、実際に目にするのは、並んだ数個の候補全体だ。自分が検索候補を見るとき、5つのうち4つが同じ意味だったら、それは「役に立っている」と言えるだろうか。
もう1つ、気になる点がある。クリックされた候補は、本当に「いちばん良い」候補だったのだろうか。それとも、上のほうにあっただけなのだろうか。
ふだん目にしている「人気」や「よく使われている」という数字を、自分はどこまで信じているだろう。
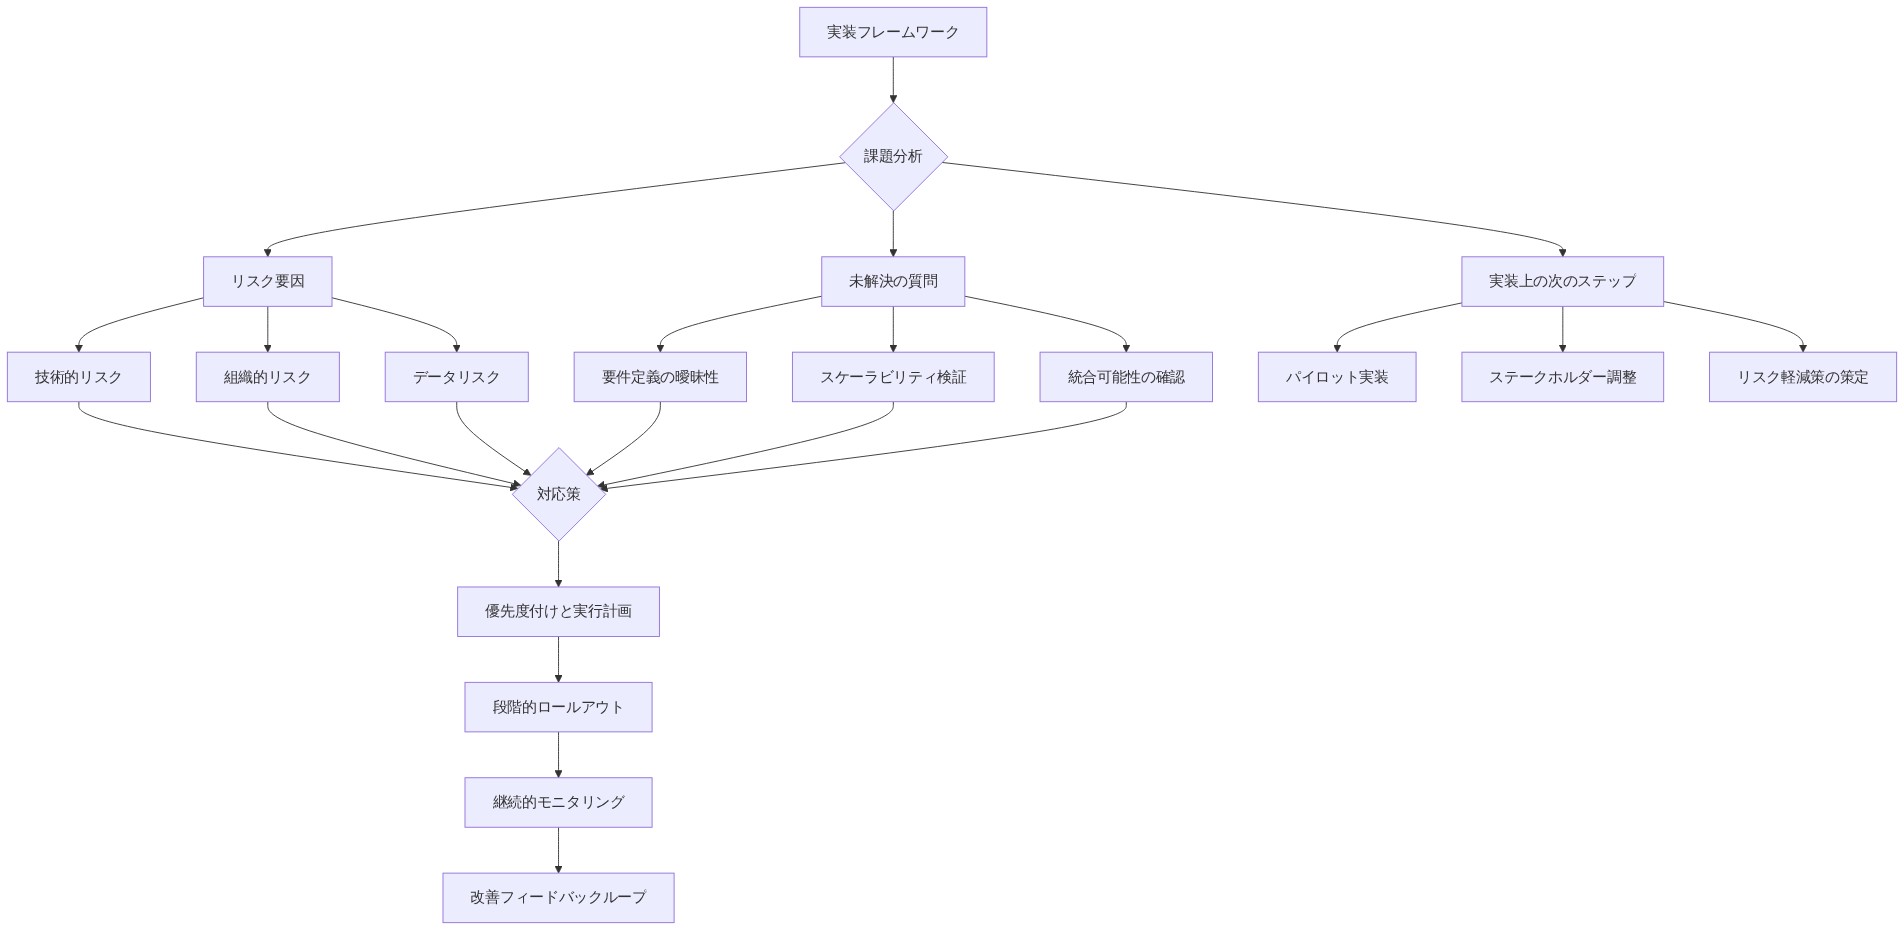
図11:実装上の課題と対応策のマトリックス
リスク、未解決の問い、今日からできること
意図ごとに候補を並べる方式は、ひとつの問題を解く代わりに、別の問題を持ち込む。
起こりうる失敗
- 使われない枠。 意図の網羅を求めると、起こる確率の低い意図まで候補に入れてしまうことがある。その意図を持つユーザーが少なければ、枠は使われない。もっと有力な候補を望んでいた大多数のユーザーにとっては、使い勝手が落ちる。
- 意図のずれ。 ユーザーの行動は時間とともに変わる。過去のデータで作った意図の一覧は、少しずつ古くなる。新しいニーズは拾われず、古いニーズだけが残り続ける。
- クリック狙いの強化。 クリックなどの反応を手がかりに貢献度を測ると、クリックは集めても、ユーザーの目的には役立たない候補が報われてしまうことがある。短期の指標は上がるのに、役に立つ度合いは変わらない。
導入前に考えておきたいこと
この枠組みを取り入れようとするチームには、現実的な問いがいくつかある。
- 学習のコスト。 学習の段階がもうひとつ増えると、計算資源と開発の手間も増える。元が取れるかどうかは、あいまいな検索語で訪れるユーザーがどのくらいいるかによるだろう。
- 個人ごとの意図か、全体の意図か。 個人向けの意図モデルは、ニーズをより正確に読み取れるかもしれない。ただし仕組みは複雑になり、プライバシーへの配慮も必要になる。全体向けのモデルは単純だが、個人の違いがぼやける。
- テストの幅。 ふつうのA/Bテストは、クリック率を見る。幅広さが利点の変更は、クリック率が横ばいか、わずかに下がって見えることがある。それでも、より多くのユーザーの二番目のニーズには応えている。この効果を測れる指標が、実験には必要になる。
未解決の研究課題
この枠組みの行方は、主に次の2つの問いで決まる。
- 学習した限界的な貢献度は、別の分野でも通用するか。 あるサービスのログで学習した貢献度の推定値は、ユーザーの行動が違う別のサービスには当てはまらないかもしれない。
- 幅広い網羅は、ユーザーの本当の利益になるか。 反応の指標は代わりの物差しにすぎない。より深い試金石は、二番目以降のニーズを持つユーザーが、探していたものを実際に見つける回数が増えるかどうかだ。
答えがどちらも前向きなら、意図ごとに候補を並べる方式は標準的なやり方になりうる。そうでなければ、あいまいさの大きい分野向けの専用の道具にとどまるかもしれない。
今日からできること
- 既存の候補一覧で、意図の重なりを調べる。 実際の候補一覧を抜き出し、候補ごとに意図のラベルを付けて、重複を数える。手を打つ前に、問題がどれほど大きいかが分かる。
- ダッシュボードで、網羅と関連性を分けて見る。 モデルを変えなくても、2つを別々に報告すれば、今の変更が何を達成しているかが見えやすくなる。
- クリックを信じる前に、表示位置の影響を補正する。 反応を学習の報酬に使う前に、位置の偏りを取り除いたクリックモデルをかける。
- 検索語を層に分けて評価する。 結果をあいまいさの度合いで分ければ、あいまいな検索語での改善が、そうでない検索語に埋もれずにすむ。
- 意図のずれに備える。 意図の一覧を定期的に見直す予定を組み、一覧に入らないトラフィックがどれくらいあるかを監視する。
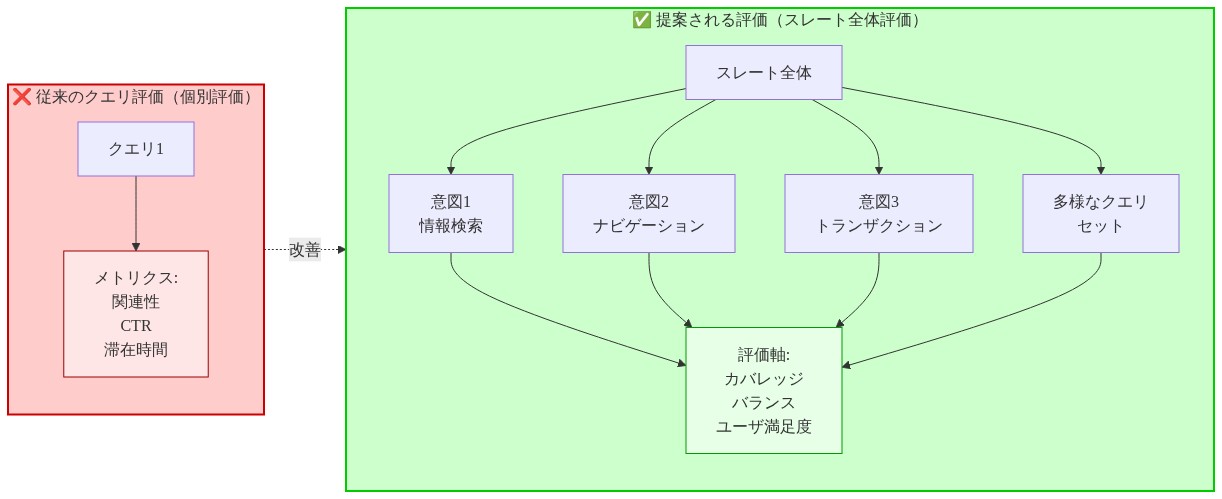
図2:個別クエリ評価 vs スレート全体評価の違い

表1:生成方法と典型的な失敗パターンの比較