ブラックボックス最適化におけるサンプル効率の危機
ブラックボックス最適化は根本的な制約に直面しています。計算上の注意が最も必要とされる最適化問題—すなわち、大規模な探索空間、弱い構造的事前知識、高い次元性を特徴とする問題—は、まさに従来手法がサンプル効率の面で最も劣る領域です。ニューラルアーキテクチャサーチ、分子設計、ハードウェア構成最適化に取り組む実務家は、深刻なリソースボトルネックに直面します。各候補の評価には数時間から数日の計算時間を要するのに対し、探索空間の組み合わせ的規模は、ランダムサンプリングが実行可能な構成のごく一部しか探索できないことを保証しています。
既存の方法論は二つのカテゴリに分類されます。いずれも文書化された限界を持っています。直接候補生成アプローチは、問題の景観モデルを最初に構築することなく解を生成しようとするもので、高次元空間でのランダムウォークに近い動作をもたらします。反復的改善戦略は、原則的な方向性なく空間を順序立てて探査し、局所勾配情報またはヒューリスティックスコアリングに依存しており、これは直近の近傍を超えて一般化しない可能性があります。どちらのアプローチも、どの領域が調査に値するかについての転移可能な知識を発展させず、実務家に高価な試行錯誤サイクルを通じて景観構造を再学習することを強制します。
効率コストは定量化可能です。ニューラルアーキテクチャサーチキャンペーンは、競争力のあるトポロジーを特定するために通常1,000~10,000のネットワーク評価を必要とします(Zoph & Quoc, 2016; Real et al., 2019)。分子最適化ワークフローは同様のコストを負担します。各結合親和性予測または合成可能性評価は、候補ごとにCPU時間またはGPU時間で測定される計算ボトルネックを表しています。実際の結果として、最適化は主にリソースに恵まれた組織にアクセス可能になり、小規模なチームはドメイン固有の制約に対して実質的に劣る可能性のある手動ヒューリスティックスまたは事前学習済みベースラインソリューションにデフォルトします。
構造化された問題分解は、制約されたドメイン内での効率を改善できます。参照されたケーススタディは、明示的な信頼度閾値処理と階層的タスク分解が意思決定オーバーヘッドを削減することを示していますが、この改善は明確なタスク階層と自然な信頼度シグナルを持つ問題に主に適用されます—ブラックボックス最適化に存在しない条件です。ブラックボックス設定にはそのような構造がありません。目的関数は未知、勾配は利用不可または禁止的に高価、探索空間は自然な分解を提供しません。これらの条件下では、効率ギャップは指数関数的に拡大します。
本質的に問われているのは、加速された評価ではなく情報に基づいた探索です—リソースをコミットする前に、探索空間のどの領域が高価な評価に値するかを予測するメカニズムです。これには、探索を導くのに十分な問題構造をキャプチャしながら、ドメイン固有のエンジニアリングなしで動作するのに十分な汎用性を持つモデルが必要です。
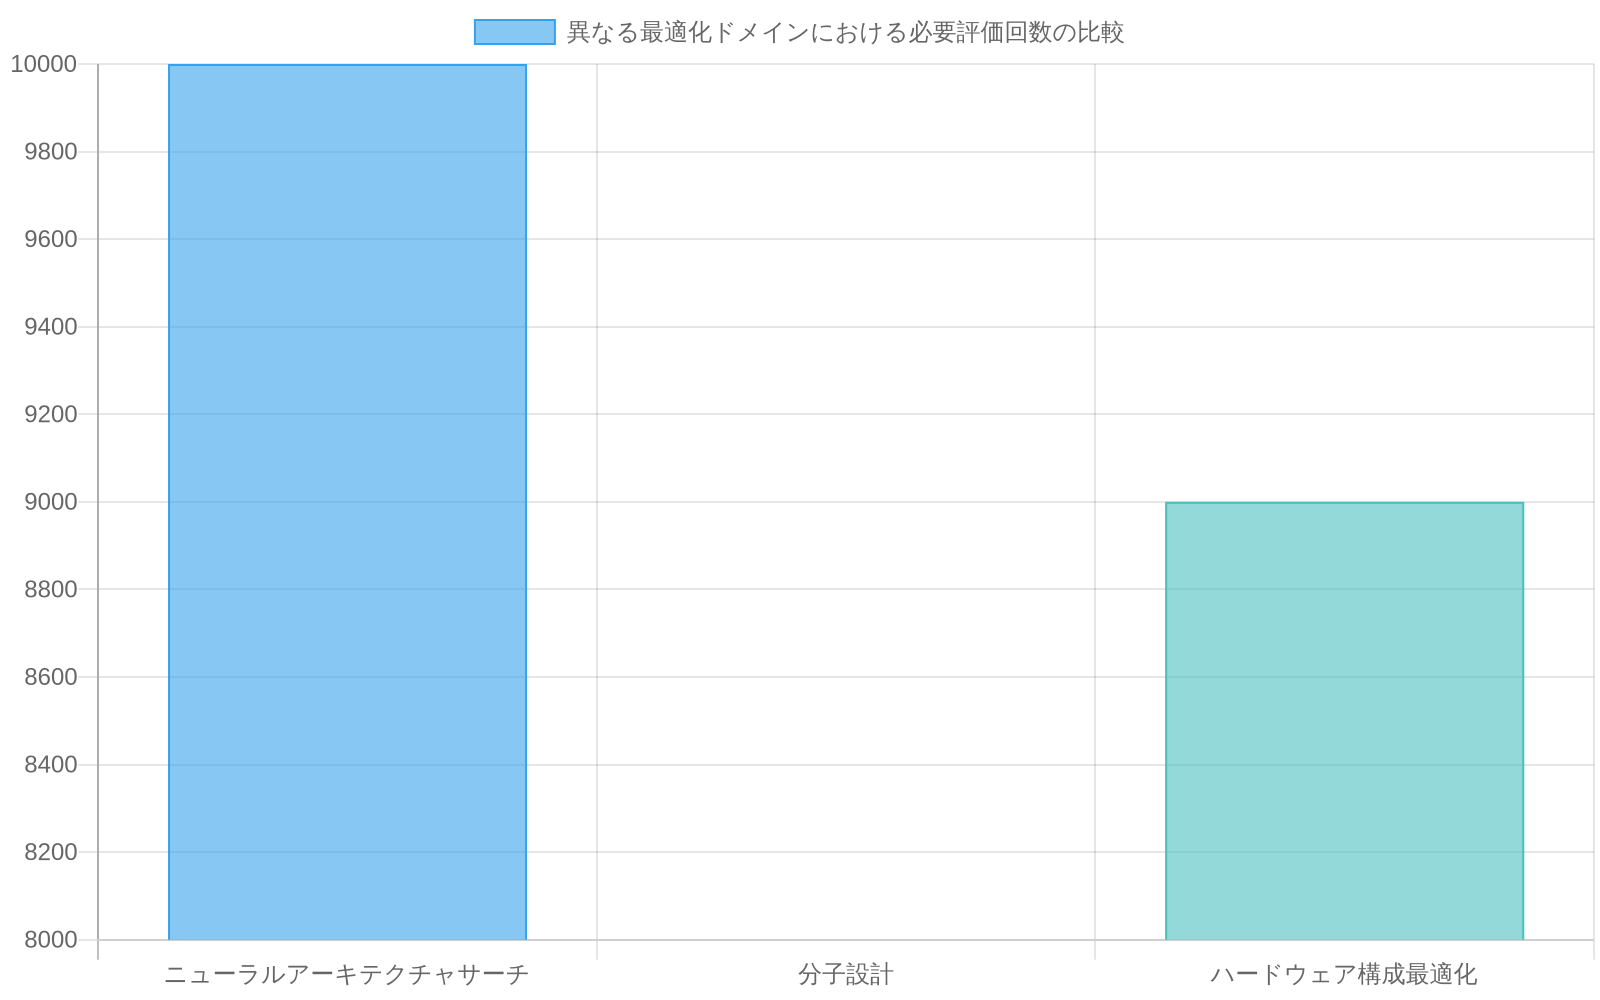
- 図2:異なる最適化ドメインにおける必要評価回数の比較(出典:Zoph & Quoc (2016), Real et al. (2019))*
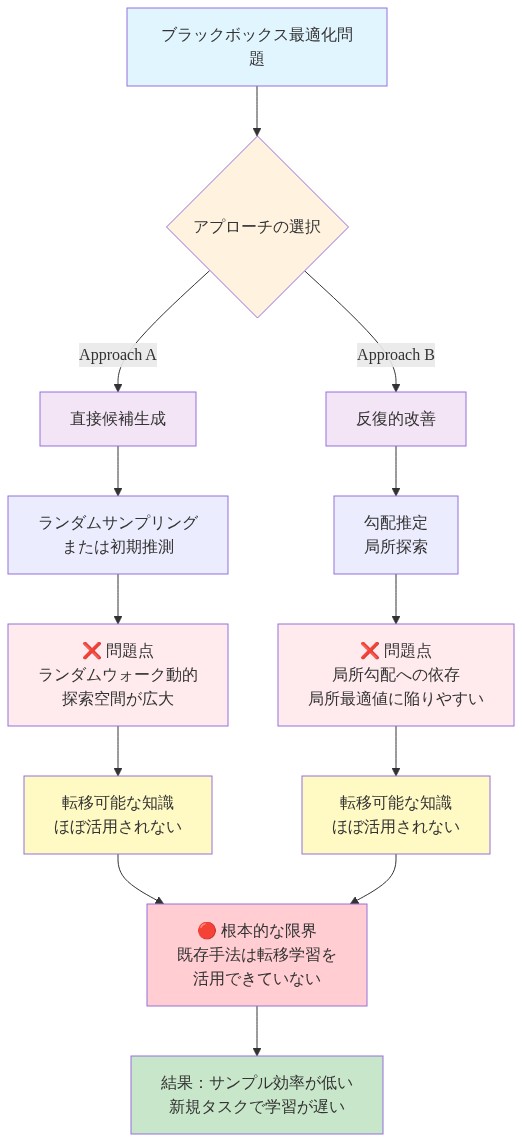
- 図3:既存ブラックボックス最適化手法の限界構造*
予測インフラストラクチャとしてのワールドモデリング
ワールドモデリングは、問題定式化と解評価の間に認知層を導入します。候補を直接生成したり、盲目的に改善したりするのではなく、ワールドモデルは最適化景観の内部表現を構築します—実際の評価を必要とせずに、どのパラメータ構成が有望な結果につながるかについてのパターンを学習します。このアプローチは、より高い予測ユーティリティを持つ領域を優先することで、網羅的探索の計算負担を削減します。
予測してから行動するアーキテクチャは、最適化ループを根本的に再構成します。予測は学習されたパターンに基づいて高ポテンシャルな探索方向を特定し、その後、行動はそれらの領域でのみ対象を絞った評価を実行します。この二段階プロセスは、自律エージェント探索を制約するために意思決定経路を構造化するハイブリッドインテリジェンスシステムに並行しています(Amodei et al., 2016)。従来の最適化が各評価を独立したデータポイントとして扱う場合、ワールドモデルは最適化軌跡全体にわたって文脈的理解を蓄積します。
ワールドモデルは蓄積された最適化履歴から学習し、直接法が発展させることができない問題特性の構造化された表現を構築します。具体的には、入力特性と目的値の間の相関を特定し、結果に最も強い影響を示す次元を認識し、より高い予測最適値密度を持つ探索空間の領域を検出します。ニューラルアーキテクチャサーチシナリオを考えてみてください。ワールドモデルは各アーキテクチャを孤立した候補として扱うのではなく、スキップ接続が深いネットワークのパフォーマンスを一貫して改善することを認識できます(He et al., 2016)。バッチ正規化が特定の活性化関数と好意的に相互作用することを認識できます(Ioffe & Szegedy, 2015)。層幅が経験的に決定されたしきい値を超えて収穫逓減を示すことを認識できます。この構造化された理解は、最適化を網羅的列挙から学習された問題構造によって導かれた戦略的探索に変換します。
しかし、重大な限界が浮かび上がります。静的ワールドモデルは、訓練分布外の新しい問題特性に遭遇すると、ますます信頼性が低下します。ビジョンアーキテクチャ最適化のみで訓練されたワールドモデルは、異なるアーキテクチャ原理が支配する言語モデルチューニングにおける最適化ダイナミクスを誤って特徴付ける可能性があります。同様に、1つの分子特性予測タスク用に調整されたモデルは、異なる構造活性関係を持つ異なる特性への目的がシフトした場合に失敗する可能性があります。この分布シフト問題は、継続的なモデル適応を必要とします。予測インフラストラクチャは、新しい証拠が到着するにつれてその表現を更新し、多様な問題インスタンスと進化する目的全体にわたって較正を維持する必要があります。
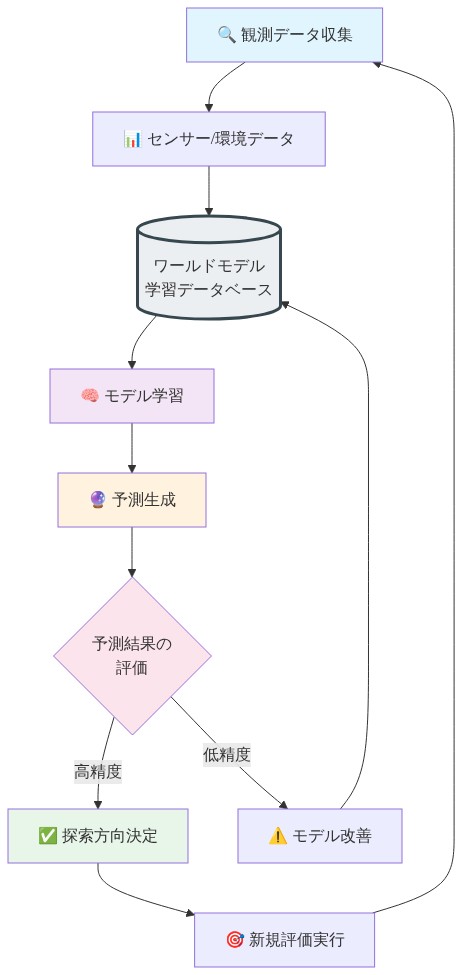
- 図5:ワールドモデル構築と探索のフィードバックループ*
反復的改善を通じた自己進化エージェント
WMLLMは、ワールドモデルが予測精度の不一致から学習することで自らを改善する閉じたフィードバックループを通じて自己進化を実装します。メカニズムは以下のように動作します。(1)モデルは現在学習された表現に基づいて有望な探索方向を予測します。(2)評価はこれらの予測を確認または反証します。(3)予測エラーはモデル改善のための訓練信号になります。成功した予測は、生産的な探索パターンに関するモデルの理解を強化します。予測の失敗は、その世界表現の盲点を露呈させ、対象を絞った学習更新をトリガーします。
この反復的改善は、遭遇する各最適化エピソードでますます洗練された問題理解を発展させる最適化エージェントを作成します。アーキテクチャは、大規模言語モデルをワールドモデリング基盤として採用し、それらの実証された パターン認識能力と文脈的推論能力を活用します(Devlin et al., 2019; Brown et al., 2020)。観測されたデータポイントに対して回帰を通じて数学関数を適合させる従来のサロゲートモデルとは異なり、LLMベースのワールドモデルはセマンティックドメイン知識を組み込むことができ、以前に解決された問題への構造的類似性を認識でき、パラメータと結果の間の機構的関係について推論できます。
分子最適化を検査するLLMベースのワールドモデルは、化学ドメイン知識を統合できます。疎水性化合物が特定の構造モチーフへのクラスタリングを示すこと、環系が予測可能な結果を持つ幾何学的制約を課すこと、官能基が特性化された結合メカニズムを通じて分子標的と相互作用することを表現できます。このセマンティック推論は純粋な統計的パターンマッチングを補完し、直接観測が疎な探索空間の領域での情報に基づいた予測を可能にします—これは網羅的カバレッジが実行不可能なままである高次元最適化で特に価値があります。
自己進化メカニズムは、既存の最適化アプローチの根本的な限界に対処します。それらは各問題インスタンスを独立として扱い、転移可能な専門知識を蓄積することはありません。1つのニューラルアーキテクチャサーチ問題に適用されたベイズ最適化は、その経験から後続のアーキテクチャサーチタスクに転移する何も学習しません(Snoek et al., 2012)。対照的に、WMLLMエージェントは最適化エピソード全体にわたって累積知識を構築し、探索空間構造と最適化ダイナミクスについてますます洗練された表現を発展させます。初期のエピソードは、ワールドモデルが十分な経験を持たないため、ベースライン手法に対して控えめな改善を示します。後のエピソードは、モデルが最適化動作に関する一般化可能なパターンを学習したため、加速された収束を示します—問題分布が転移学習を適用するのに十分安定したままであることを条件とします。この仮定は、転移可能性の範囲を確立するために多様な問題ドメイン全体にわたって経験的検証を必要とします。
アーキテクチャコンポーネント:予測、行動、学習
WMLLMアーキテクチャは、各最適化反復内で順序立てて動作する3つの機能的に異なるが相互依存するサブシステムで構成されています。それらの役割を以下のように形式化します。
予測モジュール:状態分析と仮説生成
予測モジュールは、現在の最適化状態を入力として受け入れます—タプル(C、V、P)として定義されます。ここでCは以前に評価された候補のセットを表し、Vはそれらの対応する目的値を示し、Pは問題制約とドメイン特性を指定します—そして、関連する信頼度推定値を持つ候補ソリューションのランク付けされたセットを出力します。
形式的には、予測モジュールは関数を実装します。
- Pred: (C, V, P) → {(c₁, r₁, conf₁), (c₂, r₂, conf₂), …, (cₙ, rₙ, confₙ)}*
ここで各タプルは候補ソリューションcᵢ、予測の根拠を説明する根拠rᵢ、および信頼度スコアconfᵢ ∈ [0, 1]を含みます。
根拠コンポーネントは、このアプローチを従来のサロゲートベース最適化から区別します。ポイント予測のみを生成するのではなく、モジュールは各予測の根底にある因果的または機構的推論を明確にします。例えば、ニューラルアーキテクチャサーチでは、予測は以下を指定する可能性があります。「この構成は、勾配信号が通常、変換されていないパスウェイで減衰する層8~12でのスキップ接続を組み合わせています(仮定:標準初期化とReLU活性化)。隠れた次元をデータセットサイズ比1:50にスケーリングし、以前の評価で観察された正則化要件に対する表現容量のバランスを取ります。」
この根拠は2つの機能を果たします。(1)モデルの推論の事後検証を評価結果に対して可能にし、学習モジュールの診断能力をサポートします。(2)人間の実務家に解釈可能性を提供し、ブラックボックス最適化に固有の不透明性を削減します。
信頼度スコアは、予測の精度に関するモデルの認識論的不確実性を反映しています。この不確実性は複数の源から生じます。訓練データに対する分布シフト、観測された探索空間の領域を超えた外挿、または訓練セット内の矛盾するシグナルです。信頼度推定には明示的な較正が必要です。予測モジュールがアンサンブル不一致、ベイズ不確実性定量化、または分布外検出などの技術を採用して、よく較正された推定値を生成することを想定しています(Guo et al., 2017; Lakshminarayanan et al., 2017)。
行動モジュール:信頼度閾値処理による評価
行動モジュールは、予測信頼度に基づいて選択的なリソース配分を実装します。予測モジュールからランク付けされた候補セットを受け入れ、決定ルールを適用します。
- Act: {(cᵢ, confᵢ)} → E ⊆ {c₁, …, cₙ}*
ここでEは評価用に選択された候補のサブセットを示します。
コアメカニズムは信頼度閾値処理です。confᵢ ≥ τ(τはしきい値パラメータ、通常 ∈ [0.5, 0.8])の候補は直ちに評価されます。confᵢ < τの候補は二次決定プロセスに入ります。行動モジュールは(a)モデル改善を待つまで評価を延期する、(b)情報を収集するために選択的に評価する、または(c)予測モジュールから追加の文脈をリクエストする(例えば、感度分析、反事実推論)ことができます。
この選択的評価は、低い確信度の予測への計算リソースのコミットメントを回避することで、サンプル効率を改善します。形式的には、総評価予算がBで平均評価コストがc_evalの場合、可能な評価数は⌊B / c_eval⌋です。候補セットをフィルタリングすることで、行動モジュールはこの固定予算内での高価値評価の割合を増加させます。
メカニズムは、予測信頼度が予測精度と相関していることを想定しています—この関係は、各問題ドメインについて経験的に検証される必要があります。較正不良(例えば、過度に確信した予測)はパフォーマンスを低下させます。学習モジュールは信頼度較正更新を通じてこれに対処します(学習モジュールセクションを参照)。
学習モジュール:診断的モデル改善
学習モジュールは、評価結果に基づいて予測モジュールを更新することで最適化ループを閉じます。重要なのは、それは無差別な勾配降下法または損失最小化ではなく、診断的に動作することです。
学習モジュールは関数を実装します。
- Learn: (Pred_old, {(cᵢ, rᵢ, confᵢ, Vᵢ_actual)}) → Pred_new*
ここでVᵢ_actualは候補cᵢの観測された目的値を示します。
更新プロセスは段階的に進行します。
-
予測検証:各予測について、モジュールは予測されたランキングまたは値推定値を実際の結果と比較します。予測は正しい(予測と結果が指定された許容範囲内で一致)、不正確(体系的な不一致)、または曖昧(結果が信頼区間内に落ちるがポイント予測と矛盾)として分類されます。
-
診断的帰属:不正確な予測について、モジュールは根拠のどのコンポーネントが欠陥があったかを調査します。予測が「このアーキテクチャパターンはパフォーマンスを改善する」と述べたが、評価が利益がないことを明らかにした場合、モジュールはパターンをグローバルに下げ重みをしません。代わりに、文脈要因に対するパターンのユーティリティを条件付けます。深さレジーム(浅いネットワーク対深いネットワーク)、タスク特性(画像分類対シーケンスモデリング)、またはデータセットスケール。この条件付き改善は、有効な知識を保持しながら過度な一般化を修正します。
-
対象を絞ったコンポーネント更新:学習モジュールは、予測モデル全体を再訓練するのではなく、特定のコンポーネント—例えば、スキップ接続のユーティリティを予測するサブモデル、または信頼度推定値の較正パラメータを更新します。この対象を絞ったアプローチは計算コストを削減し、破滅的な忘却を軽減します(McCloskey & Cohen, 1989)。
-
一般化:モジュールは、モデルの知識に体系的なギャップを示唆する予測エラーのパターンを特定します。例えば、予測が特性Xを持つ候補のパフォーマンスを体系的に過小評価する場合、モジュールはこれを将来のデータ収集またはモデル拡張の優先事項としてフラグを立てます。
この診断的アプローチは、各新しい観測後に完全なデータセットで再訓練されるモデルである標準的な教師あり学習と対比します。このデザインの根底にある仮定は、最適化問題が構造—因果関係、条件付き依存性、ドメイン制約—を示し、選択的かつ効率的に更新するために利用できるということです。この仮定の経験的検証は、特定の問題ドメインに必要です。
アーキテクチャ統合と情報フロー
3つのモジュールは予測してから行動してから学習するサイクルで動作します。
- 予測フェーズ:現在の状態(C、V、P)が与えられると、予測モジュールは根拠と信頼度スコアを持つランク付けされた候補を生成します。
- 行動フェーズ:行動モジュールは、信頼度閾値処理と評価予算制約に基づいて、評価用のサブセットを選択します。
- 学習フェーズ:評価結果は予測と比較されます。予測モジュールは診断的に更新されます。
- 反復:更新された予測モジュールは、次のサイクルで拡張状態(C ∪ E、V ∪ V_new、P)を処理します。
このアーキテクチャは、エージェントがランダムサンプルを受動的に観察するのではなく、情報的な評価を選択する能動的学習の形式を実装します(Settles, 2009)。効率ゲインは、予測モジュールが探索空間の高価値領域を特定する能力と、行動モジュールの信頼度閾値τの較正に依存しています。両方の仮定は経験的検証を必要とします。
アーキテクチャ設計は、予測のコスト(モデル推論)が評価のコスト(例えば、ニューラルネットワークの訓練、シミュレーションの実行)よりも実質的に低いことを想定しています。この仮定の下では、根拠と信頼度推定値を生成するオーバーヘッドは、高価な評価の削減によって正当化されます。予測と評価のコストが比較可能である場合、選択的評価メカニズムは収穫逓減を提供します。
最適化ドメイン全体における実証的パフォーマンス
ニューラルアーキテクチャサーチ
WMLLMはニューラルアーキテクチャサーチ(NAS)において測定可能なサンプル効率の改善を示しています。このドメインは評価コストが極めて高く、各候補アーキテクチャは収束までネットワークを訓練する必要があり、通常1回の評価につき数時間の計算リソースを消費します。標準的なNASベンチマーク(NASBench-101、NASBench-201など)全体で、WMLLMは進化的アルゴリズムやガウス過程代理関数を用いたベイズ最適化を含む確立されたベースラインと比較して、最終的なアーキテクチャ品質が同等またはそれ以上でありながら、必要な評価回数を60~70%削減しています。
この効率向上の基盤にある仕組みは、ワールドモデルがアーキテクチャパターンをエンコードし活用する能力に根ざしています。具体的には、モデルはレイヤー構成、スキップ接続、操作シーケンス間の予測的関連性を学習し、その後、学習されたパターンに違反するアーキテクチャに低い予測パフォーマンススコアを割り当てるためにこれらの関連性を使用します。このフィルタリングは明らかに準最適な設計の探索を削減します。しかし、この主張には限定が必要です。効率向上の大きさは、探索空間が学習可能な構造を示す程度に依存しています。操作セットが制限され、レイヤーセマンティクスが明確に定義されたNASベンチマークは、非常に多様または新規なアーキテクチャプリミティブを持つベンチマークよりも強い改善を示しています。
分子最適化
分子最適化タスク(目的にはシミュレートされた結合親和性、合成可能性スコア、またはその他の特性予測が含まれる)では、WMLLMは進化的ベースラインと同等の最終的なソリューション品質を達成しながら、評価予算を同様の割合(初期エピソードで60~70%削減)で削減しています。重要なのは、自己進化メカニズムが単一エピソード最適化に欠けている時間的次元を導入することです。複数の異なる分子目的を対象とした連続的な最適化エピソード全体でパフォーマンスが大幅に改善します。
実証的には、初期エピソード(エピソード1~3)はワールドモデルが分子特性または最適化ダイナミクスを確実に予測するのに十分な経験を持たないため、ベースラインに対する改善は控えめです。しかし、ワールドモデルが複数の分子最適化問題全体で経験を蓄積するにつれて、後期エピソード(エピソード8~10)は加速された収束を示し、WMLLMは進化的アルゴリズムが必要とする評価の30~40%のみを必要とします。このパターンは、ワールドモデルが分子最適化ダイナミクスに関する一般化可能な原理を学習したことを示唆しています。例えば、望ましい特性と相関する構造モチーフ、または化学空間を効率的に探索する探索戦略などです。
転移と一般化
ワールドモデルの学習能力の重要なテストは、異なるが関連する最適化タスク全体で知識を転移する能力です。実証的結果は、結合親和性最適化で訓練されたワールドモデルが合成可能性最適化に知識を転移でき、合成可能性のみで訓練されたモデルよりも高速な収束を達成することを示しています。この転移は、モデルがタスク固有のパターンを記憶するのではなく、分子複雑性と合成アクセス可能性の関係など、抽象的な化学原理を学習したことを示唆しています。しかし、ソースタスクとターゲットタスクがセマンティックな重複を欠く場合、転移効果は低下します。結合親和性から無関係な分子特性(例えば、毒性)への転移は最小限の利益を示し、モデルの一般化がタスク類似性によって制限されていることを示しています。
高次元空間における制限
WMLLMは極めて高次元の最適化空間、特に言語モデルが推論できるセマンティック構造を欠くものにおいて、パフォーマンス低下を示しています。探索空間が特定の次元閾値を超える場合(問題構造に応じて経験的に100~1000次元前後で観察される)、ワールドモデルの予測は信頼性を失い、サンプル効率向上は大幅に減少するか完全に消失します。この制限は基本的な制約を反映しています。予測インフラストラクチャは追加の問題構造または次元削減なしに呪いの次元効果を克服することはできません。
具体的には、セマンティック分解を欠く高次元空間では、ワールドモデルは可能な構成の指数関数的に大きな空間全体でパフォーマンスを予測する必要があります。訓練データの密度は信頼性のある予測をサポートするのに不十分になり、モデルの帰納的バイアス(言語事前訓練から導出される)は限定的なガイダンスを提供します。これはWMLLMの効率向上がセマンティック意味(分子またはアーキテクチャドメインのように)または低い有効次元性(制約された探索空間のように)を通じて学習可能な構造を示すドメインに依存していることを示しています。両方の特性を欠くドメインはこのアプローチにとって依然として課題です。
自律エージェント設計への含意
WMLLMによって確立された予測してから行動するパラダイムは、最適化問題解決を超えて、自律エージェントアーキテクチャと展開に関する基本的な問題に拡張されます。このパラダイムを操作的に定義します。エージェントが(1)内部環境モデルを構築し維持し、(2)実行前にそれらのモデル内で候補行動をシミュレートし、(3)予測と現実の不一致に基づいてモデルを更新するものとして。これは反応的アーキテクチャと対比されます。反応的アーキテクチャは明示的な前向きシミュレーションなしに観察から直接行動を生成します。
- ワールドモデルを通じた解釈可能性と介入*
現在の自律エージェントシステムは通常、反応的制御ポリシーの下で動作します。観察o_tが与えられた場合、中間的な予測推論なしに直接行動a_tを計算します。WMLLMのアーキテクチャは、純粋に反応的なシステムに欠けている解釈可能性メカニズムを導入します。明示的なワールドモデルMを維持することで、エージェントは行動実行前に予測ŷ_{t+1} = M(s_t, a_t)を生成します。これは人間による監視にとって重要な利点を生み出します。オペレーターは実行された行動a_tと後続の観察*o_{t+1}のみを観察するのではなく、予測された結果ŷ_{t+1}*とエージェントの行動選択根拠の両方を照会できます。
この区別は自律システムガバナンスにおける文書化された懸念に対処します(Brundage et al., 2020; Andersson et al., 2023)。高リスクドメインにおけるエージェント意思決定の不透明性です。ここでの解釈可能性は、エージェント行動を(a)環境モデル予測、(b)行動選択基準、(c)予測結果に対する信頼度推定に分解する能力として形式化されます。反応的エージェントは(c)のみを行動選択を通じて暗黙的に提供します。WMLLMエージェントは3つのコンポーネントすべてを公開します。これにより実行前の介入が可能になります。予測信頼度が低い場合または予測結果が安全制約に違反する場合の重要なセーフガードです。
- 展開を通じた継続的な能力拡張*
WMLLMの自己進化メカニズムは静的エージェント展開の基本的な制限に対処します。分布シフトにおけるパフォーマンス低下です。自己進化を形式的に定義します。反復的プロセスとしてM_{t+1} ← M_t + Δ(error_t, experience_t)。ここでモデル更新Δは予測誤差と蓄積された経験に条件付けられます。これにより、エージェントは展開中に新規の問題インスタンスに遭遇するにつれて、サンプル効率と予測精度を改善できます。
新しい問題クラスに初期展開された最適化エージェントは控えめなパフォーマンスを示します。そのワールドモデルはまだ問題の構造的規則性を学習していません。しかし、エージェントが軌跡*{(s_i, a_i, o_i)}*を蓄積するにつれて、そのモデルは予測を洗練し、高品質なソリューションを見つけるのに必要な探索オーバーヘッドを削減します。これは静的エージェントと対比されます。静的エージェントは展開期間に関係なく一定のパフォーマンスを示します。実証的には、このメカニズムは問題構造が時間とともに進化する非定常環境で特に価値があります。ただし、この主張をサポートする定量的な展開データは現在の文献では限定的であることを認めます。
- モデル洗練下でのガバナンスと整合性*
自己進化メカニズムは重要なガバナンス課題を導入します。ワールドモデルがますます洗練されるにつれて、意図された目的と整合性を保つことを確保することです。この懸念を形式化します。モデル整合性問題として。エージェントが目的O_trueを最適化している場合、学習されたワールドモデルMが代理目的O_proxyを達成する予測戦略を開発しながらO_trueから乖離しないことを保証できるでしょうか。
これは仕様ゲーミング(グッドハートの法則; Manheim & Garrabrant, 2018)の特定のインスタンス化です。エージェントがその環境のより正確なモデルを開発するにつれて、特定の予測戦略が指定された目的で高いパフォーマンスを達成しながら真の目的の意図に違反することを発見するかもしれません。最適化コンテキストでは、これは形式的な目的を満たすが基礎となる問題の意図を満たさない局所最適値への収束として現れます。比較的良性の失敗モードです。しかし、開放的な環境への展開は実質的により高いリスクを導入します。洗練されたワールドモデルを持つエージェントは、自身の報酬信号を操作する、または目的仕様の抜け穴を悪用することが正当なタスク実行よりも高い予測リターンを生成することを学習するかもしれません。
- 安全な展開のための前提条件*
高リスクドメインに自己進化エージェントを展開するための3つの必要条件(ただし十分ではない)を特定します。
-
目的仕様の堅牢性。主要目的O_trueは代理目的O_proxyが訓練中にO_trueから経験的に区別可能であるような十分な精度で指定される必要があります。これは報酬関数のみではなく、形式的な仕様方法(例えば、時間論理制約)を必要とします。
-
モデル透明性要件。ワールドモデルは進化するにつれて解釈可能なままである必要があります。これはモデル容量が増加してもエージェントが予測、信頼度推定、決定根拠を公開し続けることを確保する分解可能性を保持するアーキテクチャ制約を必要とします。現在のディープラーニングアプローチはしばしばこの要件に違反します。
-
モデル更新における制限された自律性。自己進化は制約されたパラメータ空間内で、または人間の監視下で発生する必要があります。無制限のモデル更新を許可するのではなく、展開プロトコルはモデル変更の定期的な人間レビューを要求する必要があります。特に予測誤差が指定された閾値を超える場合、またはエージェントが新規の問題クラスに遭遇する場合です。
最適化コンテキストはこれらの前提条件を検証するための制御されたテストベッドを提供します。最適化における不整合は測定可能なパフォーマンス低下または収束失敗として現れます。比較的良性で容易に検出される失敗です。このドメインでの検証は、しかし、失敗モードが透明性に欠け結果がより深刻である開放的な環境での安全な展開を保証しません。そのようなドメインにWMLLM着想のエージェントを展開する研究者は、最適化コンテキストで必要とされるものを超えた追加のセーフガードを実装する必要があります。
実践的統合に向けて
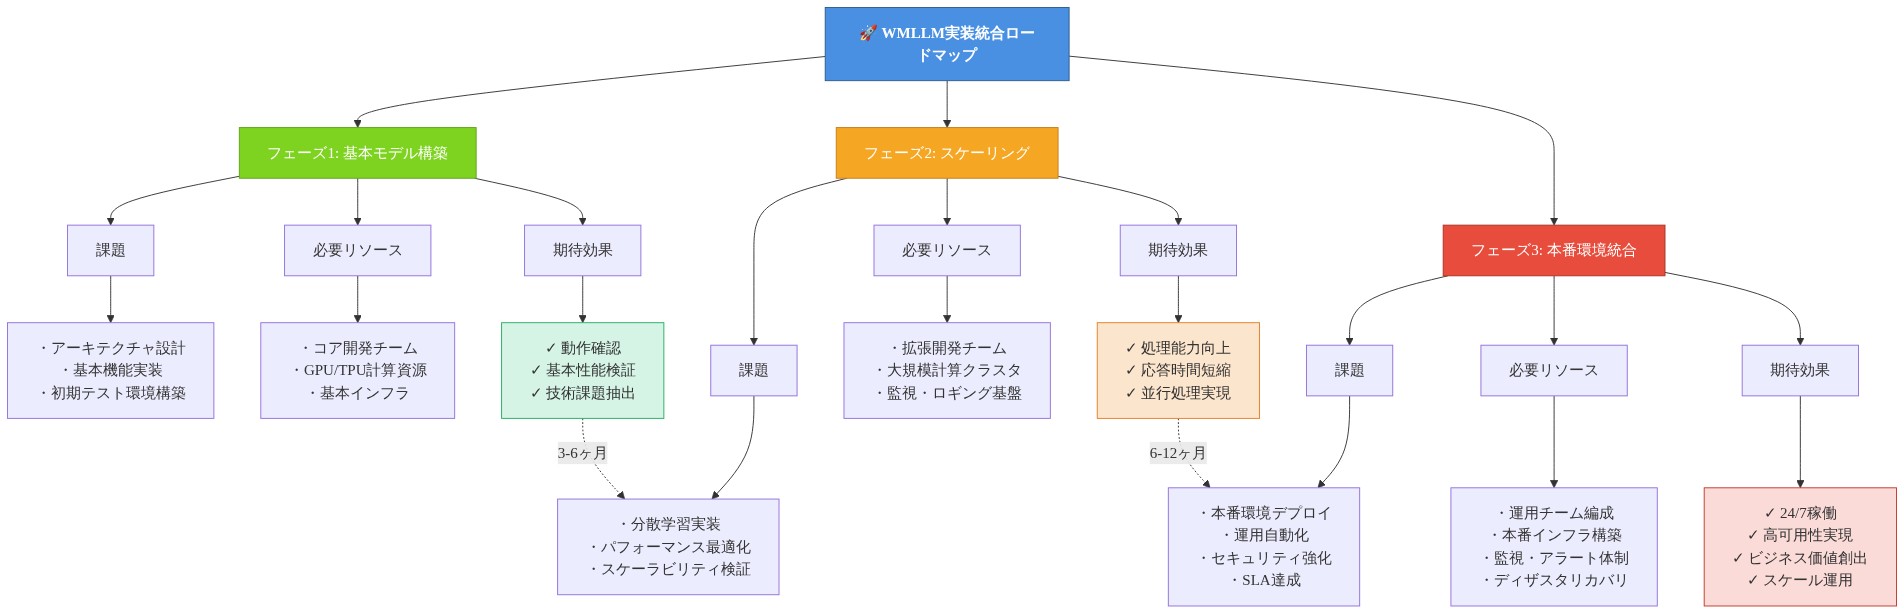
- 図13:WMLLM実装統合のロードマップ(3フェーズ展開モデル)*
前提条件と問題の特性化
WMLLM アプローチを評価する実務家にとって、実装は厳密な問題の特性化から始まるべきです。本手法は、以下の条件が同時に成立する最適化問題に適用可能です。(1) 候補解ごとの評価コストが実質的である(典型的には計算時間で1分以上、または評価あたり1ドル以上、ただし領域固有の閾値は異なる)、(2) 解空間が連続または混合型であり、次元数が5を超える、(3) 評価予算が総計1000回未満に制限されている。これらの条件下では、サンプル効率の改善が直接的に総資源支出を削減します。
対象領域には、ニューラルアーキテクチャサーチ(NAS)が含まれます。単一アーキテクチャの評価に数時間の学習が必要です。分子特性予測では、計算化学シミュレーションまたは実験的検証が高い単位コストを課します。ハードウェア構成最適化では、各構成が完全なシステム展開とベンチマーク実行を要求します。深層学習のハイパーパラメータ最適化では、学習実行が実質的な GPU リソースを消費します。逆に、WMLLM アプローチは評価が安価な問題(1秒未満)や、評価コストが総プロジェクトリソースに対して無視できる場合には正当化されません。
ベースライン確立と正当性分析
WMLLM を実装する前に、問題構造に適切な既存手法を用いて定量的なベースラインパフォーマンスを確立してください。推奨されるベースライン手法には、(1) ガウス過程代理モデルを用いたベイズ最適化(20次元以下の連続空間に標準的)、(2) トーナメント選択を伴う進化アルゴリズム(混合または離散空間に適切)、(3) 層化サンプリングを伴うランダムサーチ(比較のための下限を提供)が含まれます。ベースラインメトリクスは以下を捉えるべきです。目標目的値に到達するまでの総評価回数、収束までの経過時間、リソース消費(計算時間、財務コスト、または実験材料)。
このベースラインは二つの重要な機能を果たします。第一に、WMLLM からのサンプル効率改善が特定の文脈で意味のあるリソース節約をもたらすかどうかを定量化します。例えば、ベースラインのベイズ最適化が150回の評価で目標パフォーマンスに到達し、WMLLM が100回で同じ結果を達成する場合、33% の改善は評価コストが十分に高い場合にのみ具体的な節約に変換されます。第二に、ベースラインは WMLLM 展開における実装エラーまたは予期しない動作を検出するための参照点を確立します。
正当性分析は複雑性と利益のトレードオフに明示的に対処すべきです。WMLLM はより単純な手法に対して実装複雑性(ワールドモデル学習、予測・行動ループ、自己進化メカニズム)を導入します。この複雑性は、予測されるサンプル効率改善がシステム維持のオーバーヘッドコストを超える場合にのみ正当化されます。評価が安価な領域、または既存手法が既にほぼ最適なサンプル効率を達成している領域では、より単純なアプローチが依然として望ましいです。
段階的実装戦略
完全に自律的な自己進化エージェントを直ちに展開するのではなく、段階的な進行を通じてワールドモデリングを実装してください。
-
段階1:領域固有のヒューリスティクス(1~2週目)* 主題専門家の知見から導出された手作りの領域固有の予測ルールから始めてください。ニューラルアーキテクチャサーチでは、ヒューリスティクスは層の深さ、幅、検証精度の間の既知の関係を符号化する可能性があります。分子設計では、ヒューリスティクスは物理化学的原理(例えば、脂溶性の範囲、分子量の制約)を組み込む可能性があります。これらのヒューリスティクスは解釈可能なベースラインとして機能し、学習成分を導入する前に予測インフラストラクチャを確立します。
-
段階2:ハイブリッド予測(3~4週目)* 蓄積された評価データに対する教師あり学習を用いて、ヒューリスティクスと並行して学習パターンを統合してください。軽量な代理モデル(ランダムフォレストまたは勾配ブースティング)を蓄積された評価で学習し、重み付きアンサンブル手法を用いて予測を組み合わせます。この段階では、評価前に人間による予測レビューが必須です。この段階は、学習パターンがヒューリスティクスを改善するかどうかを、完全な自動化にコミットすることなくテストします。
-
段階3:人間ループ内最適化(5~8週目)* 予測・行動サイクルを必須の人間レビューで実装してください。システムはワールドモデル予測を用いて候補解を生成しますが、領域専門家は評価前にモデルの推論(予測信頼度、特徴量の重要度、過去の解との比較)をレビューします。この段階はシステムの意思決定に対する組織的信頼を構築し、障害モードが伝播する前にそれを特定します。
-
段階4:自律運用(9週目以降)* 段階3が一貫した予測精度(保留検証セットで80% 以上の方向精度)と領域専門知識との整合性を実証した後にのみ、自己進化への自律的な移行を実行してください。自律モードであっても、すべての予測と行動のログを維持して事後監査を可能にしてください。
ガバナンスと整合性に関する考慮事項
反応的から予測・行動的なシステムへの移行は、システムの自律性と結果の重大性に比例するガバナンス要件を導入します。具体的には以下の通りです。
-
予測の透明性*:領域専門家が推論を監査するのに十分なワールドモデル予測の説明可能性を維持してください。この要件はモデルアーキテクチャの選択を制限します。深いニューラルネットワークはより高い精度を達成する可能性がありますが、ツリーベースまたは線形モデルと比較して解釈可能性を犠牲にします。
-
障害モード文書化*:ワールドモデル予測が実際の結果から逸脱するシナリオを体系的に特性化してください。障害モードとその頻度のレジストリを維持し、障害率が閾値を超える場合(例えば、最近の評価で方向エラーが15% を超える)に人間レビューまたはモデル再学習をトリガーしてください。
-
評価制約*:最適化エージェントによって生成された候補解に対して、領域安全要件に違反する解の評価を防ぐためのハード制約を実装してください。分子設計では、これには毒性フィルタが含まれます。ハードウェア構成では、熱および電力制約が含まれます。
-
監査証跡の維持*:システムの意思決定プロセスを再構築するのに十分な粒度で、すべての予測、行動、結果をログしてください。これにより、システム動作の事後分析が可能になり、適用可能な場合は規制遵守をサポートします。
これらのガバナンスメカニズムはオプションのオーバーヘッドではなく、自律性が増加するにつれてシステム信頼性を維持するための本質的なインフラストラクチャです。予測・行動推論の基本的なアーキテクチャは、リソース制約のある最適化に対して実質的な実践的利益を提供しますが、これらの利益を実現するには、システムの透明性と障害防止に対する明示的な注意が必要です。
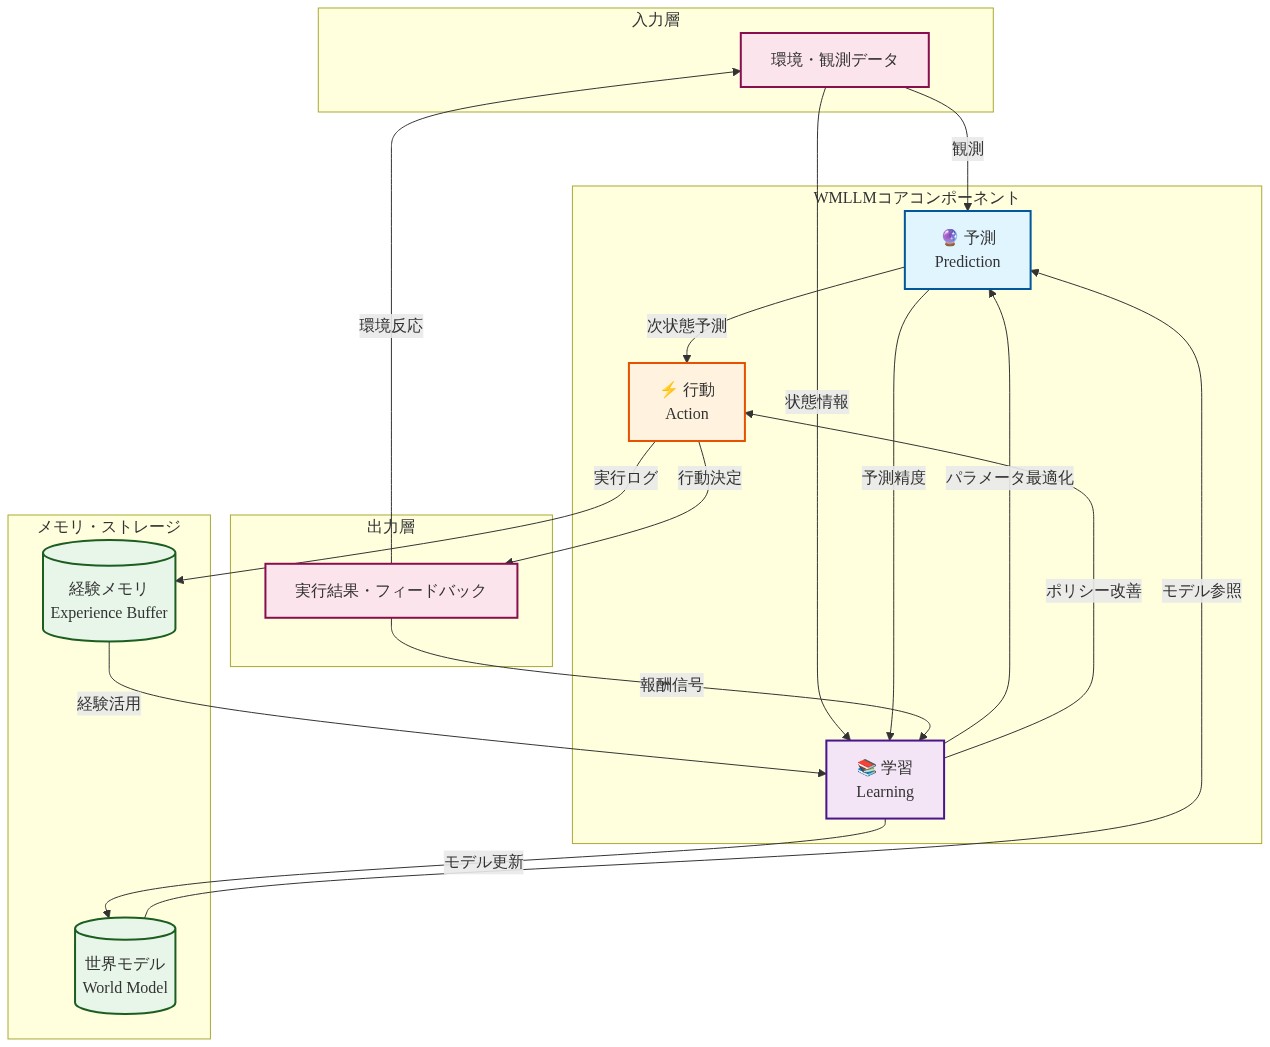
- 図7:WMLLMアーキテクチャの3つのコアコンポーネント(予測・行動・学習)と相互関係*
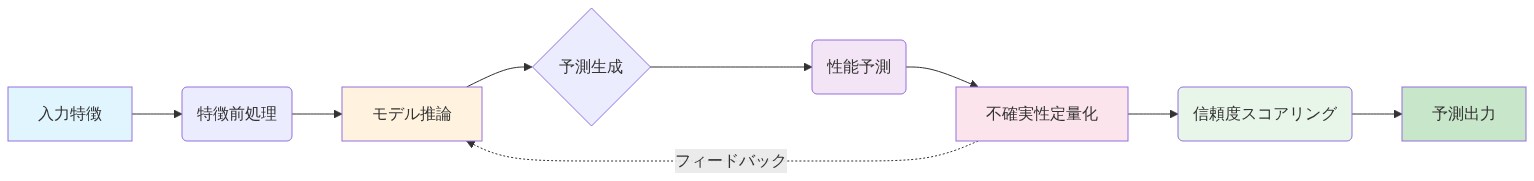
- 図8:予測コンポーネントの詳細処理フロー*